Zgodność sędziów: co właściwie mierzysz
Gdy dane nie pochodzą z kwestionariusza, lecz z oceny człowieka, ich jakość zależy od tego, kto oceniał. Tak jest przy kodowaniu nagrań wywiadów, obserwacji zachowania dzieci, ocenie wypracowań czy klasyfikowaniu odpowiedzi otwartych. Recenzent zapyta wtedy, czy inna osoba, pracując z tą samą instrukcją, doszłaby do tych samych wyników. Odpowiedzią jest badanie zgodności sędziów (ang. interrater agreement) albo rzetelności międzysędziowskiej (ang. interrater reliability). Oba pojęcia dotyczą obiektywności pomiaru, ale nie są tożsame.
- Zgodność pyta, czy sędziowie przypisują obiektom te same wartości.
- Rzetelność pyta, czy sędziowie tak samo porządkują obiekty, czyli czy zmienność ocen odzwierciedla różnice między obiektami, a nie między sędziami.
Dwaj egzaminatorzy, z których jeden zawsze daje o 5 punktów więcej, są w pełni zgodni co do kolejności, ale nie co do wartości. To rozróżnienie wraca przy wyborze formy ICC. Sam procent zgodności nie wystarcza z innego powodu: część zgodności jest przypadkowa. Dwie osoby rzucające monetą „zgodzą się” w połowie przypadków. Kappa Cohena (Cohen, 1960) i jej następcy odejmują tę część od zgodności obserwowanej.
W tym wpisie przechodzimy przez wszystkie popularne miary na jednym przykładzie: kappę Cohena, kappę ważoną, kappę Fleissa, współczynnik korelacji wewnątrzklasowej (ICC) i alfę Krippendorffa. Pokazujemy, kiedy którą wybrać, skąd biorą się paradoksy kappy przy rzadkich kategoriach i jak zaplanować oraz opisać całą procedurę. Definicje i wzory podstawowych miar są w hasłach słownika. Tutaj skupiamy się na decyzjach, które musisz podjąć w badaniu, i na tym, jak je uzasadnić w artykule.
Którą miarę wybrać
O wyborze decydują trzy pytania. Na jakiej skali są oceny: nominalnej, porządkowej czy ilościowej? Ilu jest sędziów? Czy każdy sędzia ocenił każdy obiekt?
| Sytuacja | Miara | Uwagi |
|---|---|---|
| Dwóch sędziów, kategorie nominalne | Kappa Cohena | Podaj też procent zgodności i tabelę zgodności |
| Dwóch sędziów, kategorie uporządkowane (np. nasilenie 1–5) | Kappa ważona (wagi liniowe lub kwadratowe) | Rodzaj wag wybierz przed analizą i zgłoś |
| Trzech sędziów lub więcej, kategorie nominalne, komplet ocen | Kappa Fleissa | Dopuszcza różnych sędziów dla różnych obiektów |
| Oceny ilościowe (punkty, skale ocen), dwóch sędziów lub więcej | ICC w formie dobranej do planu | Podaj model, typ i definicję (zgodność absolutna czy spójność) |
| Braki ocen, dowolna liczba sędziów, dowolny poziom pomiaru | Alfa Krippendorffa | Metrykę (nominalną, porządkową, interwałową) dobierz do skali |
| Rzadka kategoria (np. 5% obiektów) | Kappa razem z ppos i pneg | Sama kappa wprowadza w błąd; zob. paradoksy kappy |
Jedno zastrzeżenie: korelacja Pearsona między ocenami dwóch sędziów nie jest miarą zgodności. Mierzy tylko, czy oceny rosną razem, a jest ślepa na systematyczne przesunięcia (przykład na rysunku 2). Nie myl też alfy Krippendorffa z alfą Cronbacha, która mierzy spójność wewnętrzną pozycji skali, a nie zgodność sędziów.
Przykład: trzech sędziów i 80 nagrań wywiadów
W badaniu radzenia sobie ze stresem szkolnym nagrano 80 wywiadów z nastolatkami. Trzech przeszkolonych sędziów (A, B, C) kodowało niezależnie, bez wiedzy o ocenach pozostałych, cztery zmienne:
- dominującą strategię radzenia sobie – cztery kategorie nominalne: skupienie na problemie, skupienie na emocjach, szukanie wsparcia, unikanie;
- nasilenie lęku w wypowiedzi – skala porządkowa 1–5;
- zaangażowanie w rozmowę – ocena ilościowa 0–100;
- wzmiankę o przemocy rówieśniczej – tak lub nie, kategoria rzadka.
Sędzia C nie zdążył zakodować 20 ostatnich nagrań, więc komplet ocen trzech sędziów jest dla 60 nagrań. Dane są symulowane (set.seed(5151)). Możesz je pobrać jako plik CSV (80 wierszy, po jednej kolumnie na zmienną i sędziego, puste pola oznaczają brak oceny) i powtórzyć obliczenia z kodem z sekcji Przykład w R.
Kappa Cohena: dwóch sędziów, kategorie nominalne
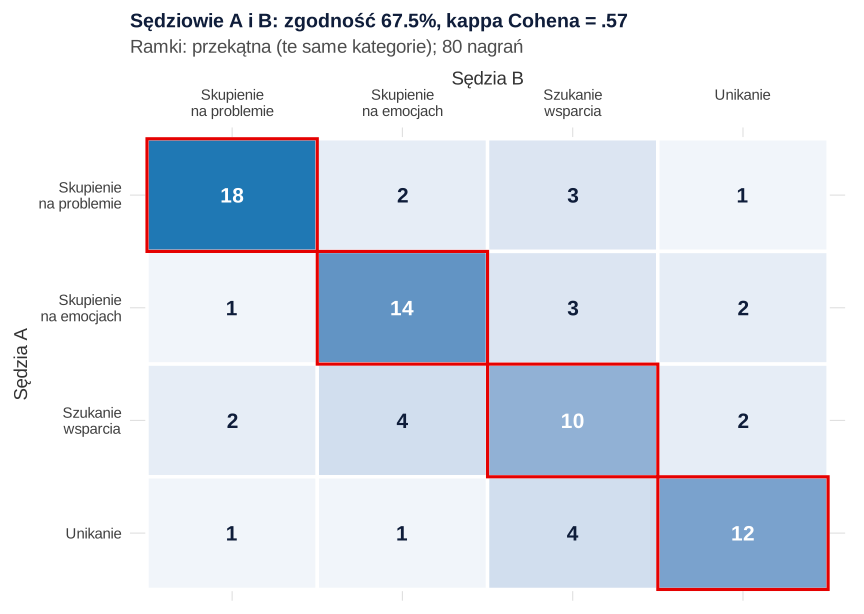
Zacznij od tabeli zgodności, czyli tabeli krzyżowej ocen obu sędziów. Na przekątnej są przypadki zgodne, poza nią widać, które kategorie się mylą. Sędziowie A i B przypisali tę samą strategię w 54 z 80 nagrań, więc zgodność obserwowana wynosi po = .675. Zgodność oczekiwana przy losowym przyporządkowaniu, wyliczona z rozkładów brzegowych, to pe = .252.
Pakiet psych daje tę samą wartość z przedziałem ufności: κ = .57, 95% CI [.43, .70]. Kappa mówi, jaką część zgodności możliwej ponad przypadek sędziowie faktycznie osiągnęli. Tu jest to nieco ponad połowa. Rysunek 1 pokazuje, gdzie leży problem: „szukanie wsparcia” najczęściej myli się z „unikaniem” i ze „skupieniem na emocjach”. To wskazówka dla instrukcji kodowania, a nie tylko liczba do raportu.
Czy .57 to dużo? W literaturze krążą słowne skale („umiarkowana”, „dobra”), ale ich progi są umowne, a wielkość kappy zależy między innymi od częstości kategorii, stronniczości sędziów i niezależności ocen (Sim i Wright, 2005). Dlatego interpretuj przede wszystkim przedział ufności i porównuj wynik z kryterium ustalonym przed kodowaniem, zapisanym w prerejestracji albo w protokole. Dolna granica .43 wskazuje, że przy tej instrukcji kodowania zgodność może być naprawdę przeciętna.
Kappa ważona: kategorie uporządkowane
Przy nasileniu lęku (1–5) pomyłka o jeden stopień jest mniej poważna niż pomyłka o trzy. Zwykła kappa traktuje obie tak samo. Kappa ważona (Cohen, 1968) przypisuje każdej komórce tabeli stopień niezgodności. Przy wagach liniowych kara rośnie proporcjonalnie do odległości między kategoriami, przy kwadratowych – z kwadratem odległości. W przykładzie sędziowie A i B wybrali dokładnie ten sam stopień tylko w 46.3% nagrań, ale prawie wszystkie niezgodności dotyczą sąsiednich stopni:
| Miara (sędziowie A i B, 80 nagrań) | κ | 95% CI |
|---|---|---|
| Kappa bez wag | .30 | [.16, .45] |
| Kappa ważona, wagi liniowe | .57 | [.47, .67] |
| Kappa ważona, wagi kwadratowe | .78 | [.70, .85] |
Rozpiętość od .30 do .78 dla tych samych danych pokazuje, dlaczego rodzaj wag musisz wybrać przed analizą i zawsze podać w raporcie. Wagi kwadratowe są łagodne dla drobnych rozbieżności, więc nadają się, gdy różnica jednego stopnia nie ma znaczenia praktycznego. Gdy każdy krok skali ma znaczenie, na przykład przy decyzji o skierowaniu na konsultację, lepsze są wagi liniowe albo kappa bez wag. Wartości z psych::cohen.kappa() i DescTools::CohenKappa() są identyczne, co warto sprawdzić, bo pakiety różnią się domyślnymi wagami.
Kappa Fleissa: trzech sędziów i więcej
Gdy sędziów jest więcej niż dwóch, kappa Cohena dla każdej pary daje kilka liczb. W przykładzie dla 60 nagrań z kompletem ocen wynoszą one .60 (A–B), .53 (A–C) i .58 (B–C). Kappa Fleissa (Fleiss, 1971) daje jeden wskaźnik dla wszystkich sędziów. Dla każdego nagrania liczy odsetek zgodnych par ocen, uśrednia go po nagraniach (.678) i porównuje ze zgodnością oczekiwaną z ogólnych częstości kategorii (.259). Wynik: κF = .57, 95% CI [.48, .65].
Kappa Fleissa nie wymaga, żeby te same osoby oceniały wszystkie obiekty. Każde nagranie może ocenić inna trójka sędziów z większego zespołu. Wymaga jednak tej samej liczby ocen dla każdego obiektu, więc 20 nagrań bez oceny sędziego C musiało wypaść z obliczeń. To jeden z powodów, dla których warto znać alfę Krippendorffa.
ICC: oceny ilościowe i wybór modelu
Dla ocen ilościowych miarą z wyboru jest współczynnik korelacji wewnątrzklasowej. ICC to stosunek wariancji między obiektami do wariancji całkowitej, liczony z tabeli ANOVA nagranie × sędzia. Nie ma jednak jednego ICC. Shrout i Fleiss (1979) opisali sześć form, a McGraw i Wong (1996) uporządkowali rozróżnienia między nimi i podali procedury wnioskowania. Koo i Li (2016) wymieniają dziesięć form i wymagają, żeby w raporcie zawsze podać trzy elementy:
| Decyzja | Możliwości | Kiedy |
|---|---|---|
| Model | jednoczynnikowy losowy; dwuczynnikowy losowy; dwuczynnikowy mieszany | Jednoczynnikowy, gdy każdy obiekt oceniają inni sędziowie. Losowy (zob. efekty stałe i losowe), gdy sędziowie są próbą z populacji sędziów i wynik ma się uogólniać. Mieszany, gdy interesują Cię tylko ci konkretni sędziowie. |
| Typ | pojedynczy sędzia (k = 1); średnia z k sędziów | Pojedynczy, gdy w badaniu właściwym każdy obiekt oceni jedna osoba. Średnia, gdy analizujesz średnią z kilku ocen. |
| Definicja | zgodność absolutna; spójność | Zgodność absolutna, gdy liczą się same wartości (np. próg kwalifikacji). Spójność, gdy liczy się tylko kolejność obiektów. |
W przykładzie średnie ocen zaangażowania wynoszą 62.43 (A), 64.28 (B) i 69.18 (C): sędzia C ocenia wyraźnie łagodniej. Korelacje między sędziami są wysokie i podobne (.84–.86). Formy ICC dla trzech sędziów i 60 nagrań, policzone ze średnich kwadratów i sprawdzone funkcją psych::ICC(), różnią się jednak wyraźnie:
| Forma (McGraw i Wong / Shrout i Fleiss) | ICC | 95% CI |
|---|---|---|
| Jednoczynnikowy losowy, pojedynczy sędzia – ICC(1) | .80 | [.72, .87] |
| Dwuczynnikowy losowy, zgodność absolutna, pojedynczy – ICC(A,1) = ICC(2,1) | .81 | [.67, .89] |
| Dwuczynnikowy mieszany, spójność, pojedynczy – ICC(C,1) = ICC(3,1) | .85 | [.77, .90] |
| Dwuczynnikowy losowy, zgodność absolutna, średnia z 3 – ICC(A,3) = ICC(2,3) | .93 | [.86, .96] |
| Dwuczynnikowy mieszany, spójność, średnia z 3 – ICC(C,3) = ICC(3,3) | .94 | [.91, .96] |
Różnica między spójnością (.85) a zgodnością absolutną (.81) to ślad systematycznego przesunięcia sędziego C. Liljequist i in. (2019) zalecają właśnie takie porównanie: zbliżone wartości jednopomiarowych ICC wskazują brak błędu systematycznego, a wyraźnie wyższy ICC spójności sygnalizuje obciążenie. Na parach sędziów widać to jeszcze lepiej (rysunek 2). Dla A i B, którzy różnią się średnio o 1.85 pkt, obie formy wynoszą .83. Dla A i C, gdzie przesunięcie wynosi 6.75 pkt, ICC spójności to .86, a ICC zgodności absolutnej .79, z dolną granicą przedziału ufności zaledwie .42.
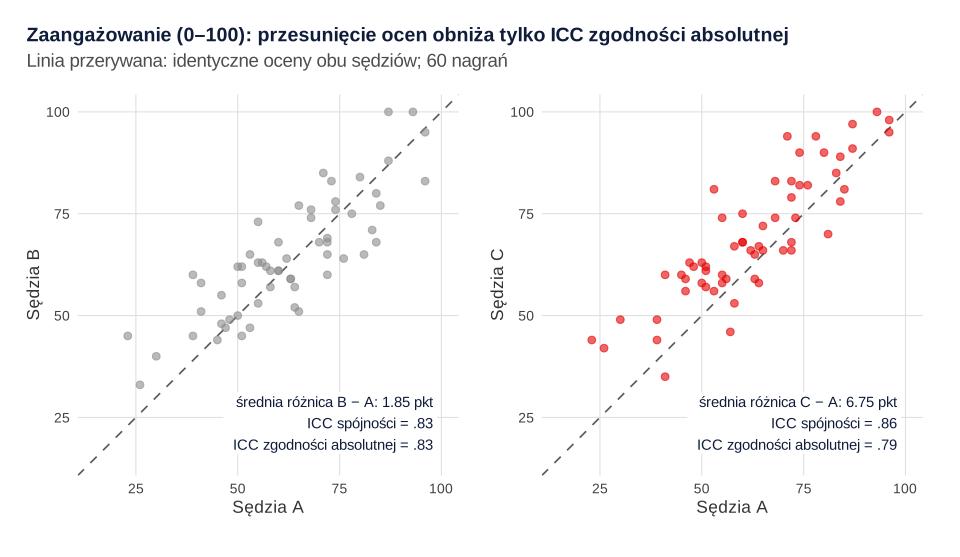
Którą formę wybrać? Jeśli w badaniu właściwym każde nagranie oceni jeden z tych sędziów, a wynik ma znaczyć to samo niezależnie od tego, kto oceniał, właściwy jest ICC(A,1). Do interpretacji Koo i Li (2016) proponują użyć przedziału ufności, a nie samej wartości punktowej: poniżej .50 rzetelność słaba, .50–.75 umiarkowana, .75–.90 dobra, powyżej .90 doskonała. Przy ICC(A,1) = .81, 95% CI [.67, .89] uczciwy opis brzmi więc „umiarkowana do dobrej”. Dopiero średnia z trzech ocen, ICC(A,3) = .93 [.86, .96], daje rzetelność dobrą do doskonałej. Zanim zaczniesz kodowanie właściwe, możesz też dać sędziemu C informację zwrotną o jego przesunięciu. Ta sama logika ICC, tylko z grupami zamiast sędziów, występuje w modelach wielopoziomowych.
Alfa Krippendorffa: braki ocen i różne poziomy pomiaru
Hayes i Krippendorff (2007) proponują alfę Krippendorffa jako standardową miarę rzetelności kodowania. Działa przy dowolnej liczbie sędziów, każdym poziomie pomiaru, dowolnej liczebności próby oraz przy brakach danych. Alfa porównuje niezgodność obserwowaną z niezgodnością oczekiwaną: α = 1 − Do/De. Różnica między wersjami polega tylko na tym, jak liczy się „odległość” między dwiema ocenami. W wersji nominalnej każda niezgodność waży tyle samo, w interwałowej kara rośnie z kwadratem różnicy wartości.
W przykładzie alfa wykorzystuje wszystkie 80 nagrań. Nagrania 61–80 wnoszą pary ocen sędziów A i B, łącznie 220 wartości zamiast 180 przy samych kompletnych nagraniach. Wartości z własnej funkcji (macierz koincydencji) i z DescTools::KrippAlpha() są identyczne:
| Zmienna (metryka) | α Krippendorffa | Dla porównania |
|---|---|---|
| Strategia radzenia sobie (nominalna), 80 nagrań | .55, 95% CI bootstrap [.43, .66] | Na 60 kompletnych nagraniach: α = .57; kappa Fleissa = .57 |
| Nasilenie lęku (porządkowa), 80 nagrań | .77 | Kappa ważona A–B: .57 (liniowe), .78 (kwadratowe) |
| Zaangażowanie (interwałowa), 80 nagrań | .81 | ICC(A,1) na 60 nagraniach: .81 |
Dwie rzeczy warto zauważyć. Na kompletnych danych alfa nominalna jest praktycznie równa kappie Fleissa, a alfa interwałowa – ICC zgodności absolutnej dla pojedynczego sędziego. Alfa nie jest więc „lepszą liczbą”, tylko ogólniejszą konstrukcją, która pozwala wykorzystać niepełne dane. Przedział ufności dla alfy policzyliśmy metodą bootstrap, losując nagrania ze zwracaniem (2000 powtórzeń). Pamiętaj przy tym, że alfa liczona przy brakach zakłada, że brakujące oceny nie są systematycznie „trudniejsze” od pozostałych (zob. mechanizmy braków danych).
Paradoksy kappy przy rzadkich kategoriach
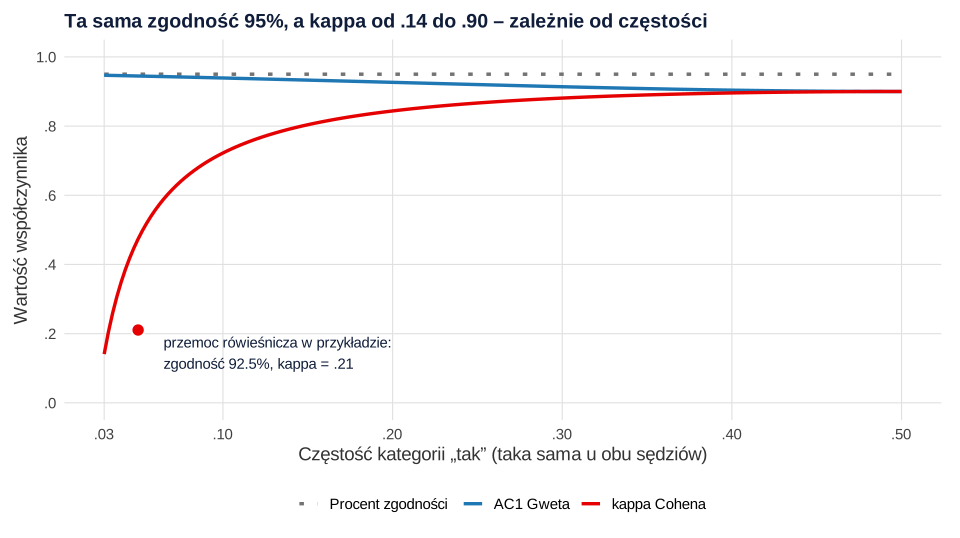
Wzmianka o przemocy rówieśniczej pojawiła się w kilku nagraniach. Sędziowie A i B zgodzili się w 74 z 80 przypadków, czyli w 92.5%. Kappa wynosi jednak tylko .21, 95% CI [−.20, .62]. Z tabeli widać dlaczego: obaj powiedzieli „tak” tylko raz, a w sześciu nagraniach jeden powiedział „tak”, a drugi „nie”.
| Sędzia A \ Sędzia B | nie | tak |
|---|---|---|
| nie | 73 | 3 |
| tak | 3 | 1 |
Przy tak rzadkiej kategorii zgodność oczekiwana z przypadku jest bardzo wysoka (pe = .905). Dwóch sędziów, którzy prawie zawsze mówią „nie”, zgadza się „za darmo”. Feinstein i Cicchetti (1990) opisali to jako pierwszy paradoks kappy: wysoki odsetek zgodności zostaje drastycznie obniżony, gdy rozkłady brzegowe są silnie niezrównoważone. Rysunek 3 pokazuje skalę zjawiska. Przy tej samej zgodności 95% kappa wynosi .90, gdy kategoria występuje w połowie przypadków, i spada do .14 przy częstości .03.
Co z tym zrobić? Są dwie drogi i warto znać obie.
- Rozbij zgodność na części. Cicchetti i Feinstein (1990) zalecają, żeby kappie zawsze towarzyszyły dwa osobne wskaźniki: zgodność w ocenach pozytywnych ppos = 2a/(2a + b + c) i negatywnych pneg = 2d/(2d + b + c). Działają podobnie jak czułość i swoistość. W przykładzie pneg = .96, ale ppos = .25. Sędziowie zgadzają się, że przemocy zwykle nie ma, ale nie zgadzają się, gdzie jest.
- Użyj współczynnika mniej wrażliwego na częstość. Gwet (2008) zaproponował współczynnik AC1, stabilniejszy przy wysokiej zgodności. W przykładzie AC1 = .92.
Uwaga: AC1 = .92 nie oznacza, że kodowanie przemocy jest rzetelne. Przy jednej wspólnej ocenie „tak” na siedem nagrań, w których ktokolwiek ją wskazał, ta zmienna nie nadaje się do analizy. Niska kappa przy rzadkiej kategorii często mówi prawdę o tym, co dla badania najważniejsze. Dlatego nie zastępuj kappy innym współczynnikiem tylko po to, żeby wynik ładniej wyglądał. Podaj tabelę, ppos i pneg. Jeśli to możliwe, zaplanuj próbę do oceny zgodności tak, żeby rzadkich przypadków było w niej więcej, i opisz to w raporcie. Na wielkość kappy wpływa nie tylko częstość kategorii, ale też stronniczość sędziów, co omawiają Sim i Wright (2005).
Procedura: od instrukcji kodowania do raportu
Liczba, którą podasz w artykule, jest tylko tak dobra jak procedura, z której pochodzi. Dobrze zaplanowane badanie zgodności przebiega w kilku krokach:
- Instrukcja kodowania. Definicje kategorii, przykłady graniczne („co, jeśli wypowiedź zawiera dwie strategie?”) i reguły rozstrzygania. Zapisz ją w książce kodowej razem z wersją i datą.
- Trening sędziów. Wspólne kodowanie materiałów spoza próby badawczej, omówienie rozbieżności, doprecyzowanie instrukcji.
- Próba pilotażowa. Niezależne kodowanie osobnego zestawu materiałów i obliczenie zgodności. Jeśli nie osiąga kryterium ustalonego z góry, wróć do instrukcji i treningu. Materiałów z pilotażu nie włączaj potem do oceny zgodności w badaniu właściwym (zob. badanie pilotażowe).
- Kodowanie właściwe. Sędziowie pracują niezależnie, bez wiedzy o hipotezach i o przydziale do grup (zob. zaślepienie badania). Losowo wybrana część materiału, a najlepiej całość, jest kodowana podwójnie.
- Obliczenie zgodności przed uzgodnieniami. Raportowana miara dotyczy ocen niezależnych. Rozbieżności rozstrzygasz potem przez dyskusję albo trzeciego sędziego i opisujesz ten sposób.
- Kontrola dryfu. W długich projektach sprawdzaj zgodność także w trakcie kodowania, bo sędziowie z czasem odchodzą od instrukcji.
Ile obiektów kodować podwójnie? Zależy to od oczekiwanej wartości miary, liczby kategorii i ich częstości. Sim i Wright (2005) omawiają wymaganą liczebność próby w badaniach z kappą. Przy rzadkich kategoriach, jak pokazał przykład, nawet 80 obiektów daje przedział ufności szerszy niż cała skala interpretacyjna.
Jak opisać zgodność sędziów w artykule
Wytyczne GRRAS (Kottner i in., 2011) wymieniają 15 zagadnień, które powinien obejmować raport z badania rzetelności i zgodności: od opisu sędziów i obiektów, przez sposób doboru próby i przebieg oceniania, po analizę statystyczną z miarą niepewności. W praktyce akapit w części „Metoda” musi odpowiadać na pytania: kto oceniał, co, ile obiektów, niezależnie czy nie, jaką miarą (z formą ICC albo rodzajem wag) i z jakim wynikiem.
Gdy kodowanych zmiennych jest kilka, zbierz wyniki w tabeli. Wzór poniżej możesz skopiować do Worda, a ogólne zasady formatowania opisuje wpis tabele APA w pracy. Podobną tabelę dla rzetelności skal kwestionariuszowych znajdziesz w haśle tabela rzetelności skal w APA.
Tabela 1
Zgodność trojga sędziów w kodowaniu nagrań wywiadów
| Zmienna | Poziom pomiaru | Miara | Wartość [95% CI] | α Krippendorffa |
|---|---|---|---|---|
| Strategia radzenia sobie | nominalny | κ Fleissa | .57 [.48, .65] | .55 |
| Nasilenie lęku | porządkowy | κw (liniowe), A–B | .57 [.47, .67] | .77 |
| Zaangażowanie (0–100) | ilościowy | ICC(A,1) | .81 [.67, .89] | .81 |
Uwaga. Kappa Fleissa i ICC(A,1) obliczone dla 60 nagrań ocenionych przez trojga sędziów; kappa ważona dla 80 nagrań ocenionych przez sędziów A i B; α Krippendorffa dla wszystkich 80 nagrań (metryka odpowiednia do poziomu pomiaru). ICC(A,1) = dwuczynnikowy model losowy, zgodność absolutna, pojedynczy sędzia. CI = przedział ufności. Dane symulowane.
Jeśli zgodność oceniasz w ramach budowy nowego narzędzia obserwacyjnego, wpisz ją w szerszy plan walidacji (zob. budowa i walidacja skali psychometrycznej). Gdy recenzent kwestionuje wybór formy ICC albo wag kappy, możesz skorzystać ze wsparcia przy analizach i odpowiedziach na recenzje.
ICC w SPSS i inne programy
W SPSS ICC policzysz w oknie Analyze > Scale > Reliability Analysis, po przejściu do Statistics. Dokumentacja wymienia tam modele Two-Way Mixed, Two-Way Random i One-Way Random oraz typy Consistency i Absolute Agreement (IBM, b.d.). Odpowiadają one modelom i definicjom z tabeli wyżej. Zaznacz je świadomie, bo ustawienia domyślne nie muszą pasować do Twojego planu. Do alfy Krippendorffa Hayes i Krippendorff (2007) opisali bezpłatne makro dla SPSS i SAS. W R wszystkie miary z tego wpisu policzysz pakietami psych i DescTools (kod niżej). Popularny pakiet irr nie jest konieczny.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji (przepisy 2–4 korzystają z obiektów z przepisu 1). Kappę, ICC i alfę Krippendorffa liczymy dwa razy: ze wzoru i funkcjami pakietów, żeby było widać, że wyniki są te same. Pierwszy przepis zapisuje plik zgodnosc-sedziow-dane.csv, który możesz też pobrać tutaj.
1. Dane, kappa Cohena, kappa ważona i kappa Fleissa
R
# Dane symulowane: trzech przeszkolonych sędziów (A, B, C) koduje 80 nagranych wywiadów z nastolatkami.
# Kodowane zmienne: dominująca strategia radzenia sobie (4 kategorie nominalne), nasilenie lęku (1–5, porządkowa),
# zaangażowanie w rozmowę (0–100, ilościowa) i wzmianka o przemocy rówieśniczej (tak/nie, rzadka).
# Sędzia C nie zdążył zakodować 20 ostatnich nagrań.
library(psych)       # cohen.kappa()
library(DescTools)   # KappaM(): kappa Fleissa

set.seed(5151)
n <- 80
sedziowie <- c("A", "B", "C")
kat <- c("problem", "emocje", "wsparcie", "unikanie")
prawda_strategia <- sample(kat, n, replace = TRUE, prob = c(.35, .30, .20, .15))
koduj_strategie <- function(trafnosc) sapply(prawda_strategia, function(k)
  if (runif(1) < trafnosc) k else sample(setdiff(kat, k), 1))
strategia <- data.frame(A = koduj_strategie(.82), B = koduj_strategie(.80), C = koduj_strategie(.78))
strategia[] <- lapply(strategia, factor, levels = kat)

prawda_lek <- rnorm(n)
koduj_lek <- function() as.integer(cut(prawda_lek + rnorm(n, sd = 0.45), c(-Inf, -1.2, -0.4, 0.4, 1.2, Inf)))
lek <- data.frame(A = koduj_lek(), B = koduj_lek(), C = koduj_lek())

prawda_zaang <- rnorm(n, 60, 15)
zaang <- data.frame(A = prawda_zaang + rnorm(n, 0, 6), B = prawda_zaang + rnorm(n, 0, 6),
                    C = prawda_zaang + 6 + rnorm(n, 0, 6))      # C ocenia systematycznie łagodniej (+6 pkt)
zaang[] <- lapply(zaang, function(x) pmin(pmax(round(x), 0), 100))

prawda_przemoc <- runif(n) < .06
koduj_przemoc <- function() as.integer(ifelse(prawda_przemoc, runif(n) < .80, runif(n) < .02))
przemoc <- data.frame(A = koduj_przemoc(), B = koduj_przemoc(), C = koduj_przemoc())

# braki: C nie zakodował nagrań 61–80
strategia$C[61:80] <- NA; lek$C[61:80] <- NA; zaang$C[61:80] <- NA; przemoc$C[61:80] <- NA
dane <- data.frame(nagranie = 1:n, setNames(strategia, paste0("strategia_", sedziowie)),
                   setNames(lek, paste0("lek_", sedziowie)), setNames(zaang, paste0("zaang_", sedziowie)),
                   setNames(przemoc, paste0("przemoc_", sedziowie)))
write.csv(dane, "zgodnosc-sedziow-dane.csv", row.names = FALSE, na = "")
head(dane, 3)

# 1. Kappa Cohena dla sędziów A i B (strategia) – ze wzoru
tab <- table(A = strategia$A, B = strategia$B)
tab
p_o <- sum(diag(tab)) / sum(tab)
p_e <- sum(rowSums(tab) * colSums(tab)) / sum(tab)^2
round(c(p_o = p_o, p_e = p_e, kappa = (p_o - p_e) / (1 - p_e)), 3)
# ...i z pakietu psych (wiersz unweighted kappa)
ck <- cohen.kappa(cbind(strategia$A, strategia$B))
round(ck$confid["unweighted kappa", ], 3)   # wiersz weighted kappa nie ma sensu dla kategorii nominalnych

# 2. Ważona kappa dla porządkowego nasilenia lęku (A i B)
table(A = lek$A, B = lek$B)
mean(lek$A == lek$B)
ckw <- cohen.kappa(cbind(lek$A, lek$B))                 # wagi kwadratowe (domyślne w psych)
round(ckw$confid, 3)
ckl <- cohen.kappa(cbind(lek$A, lek$B), w.exp = 1)      # wagi liniowe
round(ckl$confid["weighted kappa", ], 3)
tab_lek <- table(factor(lek$A, 1:5), factor(lek$B, 1:5))
round(c(liniowe = CohenKappa(tab_lek, weights = "Equal-Spacing"),
        kwadratowe = CohenKappa(tab_lek, weights = "Fleiss-Cohen")), 3)   # kontrola w DescTools

# 3. Kappa Fleissa: trzech sędziów, 60 nagrań z kompletem ocen
komplet <- strategia[1:60, ]
oceny_n <- t(apply(komplet, 1, function(w) table(factor(w, levels = kat))))   # nagranie × kategoria
m <- 3
P_i <- (rowSums(oceny_n^2) - m) / (m * (m - 1))
p_j <- colSums(oceny_n) / (nrow(komplet) * m)
round(c(P_srednie = mean(P_i), P_e = sum(p_j^2),
        kappa_Fleissa = (mean(P_i) - sum(p_j^2)) / (1 - sum(p_j^2))), 3)
KappaM(komplet, method = "Fleiss", conf.level = .95)
# kappa Cohena dla wszystkich par sędziów (60 nagrań)
round(sapply(list(AB = c("A", "B"), AC = c("A", "C"), BC = c("B", "C")),
             function(p) cohen.kappa(cbind(komplet[[p[1]]], komplet[[p[2]]]))$kappa), 3)
Wynik w R
  nagranie strategia_A strategia_B strategia_C lek_A lek_B lek_C zaang_A zaang_B zaang_C przemoc_A przemoc_B
1        1      emocje    wsparcie    wsparcie     2     3     1      70      68      66         0         0
2        2     problem    wsparcie     problem     3     4     4      26      33      42         0         0
3        3    unikanie    unikanie    unikanie     4     4     3      85      77      81         0         0
  przemoc_C
1         0
2         0
3         0
          B
A          problem emocje wsparcie unikanie
  problem       18      2        3        1
  emocje         1     14        3        2
  wsparcie       2      4       10        2
  unikanie       1      1        4       12
  p_o   p_e kappa
0.675 0.252 0.565
   lower estimate    upper
   0.429    0.565    0.702
   B
A    1  2  3  4  5
  1  5  1  0  0  0
  2  5 13  5  0  0
  3  1  6 10  5  0
  4  0  1  9  5  4
  5  0  0  0  6  4
[1] 0.4625
                 lower estimate upper
unweighted kappa 0.161    0.304 0.446
weighted kappa   0.704    0.777 0.851
   lower estimate    upper
   0.467    0.570    0.674
   liniowe kwadratowe
     0.570      0.777
    P_srednie           P_e kappa_Fleissa
        0.678         0.259         0.565
    kappa    lwr.ci    upr.ci
0.5650725 0.4798275 0.6503174
   AB    AC    BC
0.597 0.525 0.576
2. ICC: wzory McGraw i Wong i funkcja psych::ICC()
R
# ICC dla zaangażowania (0–100): trzech sędziów, 60 nagrań z kompletem ocen (obiekty z przepisu 1)
library(psych)   # ICC()
z <- zaang[1:60, ]
round(colMeans(z), 2)                 # średnie sędziów: C ocenia wyżej
round(cor(z), 3)                      # korelacje Pearsona: same w sobie nie widzą przesunięcia

# Średnie kwadraty z dwuczynnikowej ANOVA (nagranie × sędzia) i wzory McGraw i Wong (1996)
n_ob <- nrow(z); k <- ncol(z)
x <- as.matrix(z); M <- mean(x)
SSR <- k * sum((rowMeans(x) - M)^2); SSC <- n_ob * sum((colMeans(x) - M)^2)
SSE <- sum((x - M)^2) - SSR - SSC; SSW <- sum((x - rowMeans(x))^2)
MSR <- SSR / (n_ob - 1); MSC <- SSC / (k - 1); MSE <- SSE / ((n_ob - 1) * (k - 1)); MSW <- SSW / (n_ob * (k - 1))
round(c(MSR = MSR, MSC = MSC, MSE = MSE, MSW = MSW), 2)
round(c(`ICC(1)`   = (MSR - MSW) / (MSR + (k - 1) * MSW),
        `ICC(A,1)` = (MSR - MSE) / (MSR + (k - 1) * MSE + k * (MSC - MSE) / n_ob),   # zgodność absolutna
        `ICC(C,1)` = (MSR - MSE) / (MSR + (k - 1) * MSE),                           # spójność
        `ICC(A,3)` = (MSR - MSE) / (MSR + (MSC - MSE) / n_ob)), 3)                  # średnia z 3 sędziów

# To samo w pakiecie psych: ICC1 = jednoczynnikowy, ICC2 = dwuczynnikowy losowy (zgodność absolutna),
# ICC3 = dwuczynnikowy mieszany (spójność); ICC1k–ICC3k = rzetelność średniej z k sędziów
wynik_icc <- psych::ICC(z, lmer = FALSE)   # psych:: – DescTools też ma funkcję ICC()
print(wynik_icc$results[, c("type", "ICC", "F", "df1", "df2", "p", "lower bound", "upper bound")], digits = 3)

# Bez sędziego C (A i B nie mają przesunięcia): ICC zgodności i spójności prawie równe
print(psych::ICC(z[, c("A", "B")], lmer = FALSE)$results[c(2, 3), c("type", "ICC", "lower bound", "upper bound")], digits = 3)
# Para A–C (przesunięcie o kilka punktów): różnica średnich i oba typy ICC
round(mean(z$C - z$A), 2)
print(psych::ICC(z[, c("A", "C")], lmer = FALSE)$results[c(2, 3), c("type", "ICC", "lower bound", "upper bound")], digits = 3)
Wynik w R
    A     B     C
62.43 64.28 69.18
      A     B     C
A 1.000 0.839 0.864
B 0.839 1.000 0.843
C 0.864 0.843 1.000
   MSR    MSC    MSE    MSW
659.74 729.95  38.15  49.68
  ICC(1) ICC(A,1) ICC(C,1) ICC(A,3)
   0.804    0.807    0.845    0.926
                         type   ICC    F df1 df2        p lower bound upper bound
Single_raters_absolute   ICC1 0.804 13.3  59 120 5.90e-32       0.719       0.870
Single_random_raters     ICC2 0.807 17.3  59 118 3.39e-37       0.673       0.886
Single_fixed_raters      ICC3 0.845 17.3  59 118 3.39e-37       0.774       0.898
Average_raters_absolute ICC1k 0.925 13.3  59 120 5.90e-32       0.885       0.953
Average_random_raters   ICC2k 0.926 17.3  59 118 3.39e-37       0.861       0.959
Average_fixed_raters    ICC3k 0.942 17.3  59 118 3.39e-37       0.911       0.964
                     type   ICC lower bound upper bound
Single_random_raters ICC2 0.827       0.726       0.893
Single_fixed_raters  ICC3 0.830       0.731       0.895
[1] 6.75
                     type   ICC lower bound upper bound
Single_random_raters ICC2 0.794       0.416       0.909
Single_fixed_raters  ICC3 0.861       0.778       0.915
3. Alfa Krippendorffa przy brakach ocen
R
# Alfa Krippendorffa: wszystkie 80 nagrań, także te bez oceny sędziego C (obiekty z przepisu 1)
library(DescTools)   # KrippAlpha()

# Własna funkcja: macierz koincydencji (Hayes i Krippendorff, 2007); x = sędziowie w wierszach, jednostki w kolumnach
alfa_kripp <- function(x, poziom = c("nominal", "interval")) {
  poziom <- match.arg(poziom)
  wart <- sort(unique(na.omit(as.vector(x))))
  o <- matrix(0, length(wart), length(wart))
  for (u in seq_len(ncol(x))) {
    v <- na.omit(x[, u]); m_u <- length(v)
    if (m_u < 2) next                                   # jednostka z jedną oceną nie wnosi informacji
    for (i in seq_len(m_u)) for (j in seq_len(m_u)) if (i != j) {
      a <- match(v[i], wart); b <- match(v[j], wart)
      o[a, b] <- o[a, b] + 1 / (m_u - 1)
    }
  }
  delta2 <- if (poziom == "nominal") outer(wart, wart, "!=") * 1 else outer(wart, wart, "-")^2
  n_c <- rowSums(o); n_all <- sum(o)
  D_o <- sum(o * delta2) / n_all
  D_e <- sum(outer(n_c, n_c) * delta2) / (n_all * (n_all - 1))
  c(n_wartosci = n_all, alfa = 1 - D_o / D_e)
}
x_strat <- t(sapply(strategia, as.integer))       # 3 × 80, NA u sędziego C dla nagrań 61–80
x_zaang <- t(as.matrix(zaang))
x_lek   <- t(as.matrix(lek))

# Strategia (nominalna): wszystkie nagrania i dla porównania 60 nagrań z kompletem
round(alfa_kripp(x_strat, "nominal"), 3)
round(KrippAlpha(x_strat, method = "nominal")$value, 3)
round(alfa_kripp(x_strat[, 1:60], "nominal"), 3)
# Nasilenie lęku (porządkowa) – tylko DescTools
round(KrippAlpha(x_lek, method = "ordinal")$value, 3)
# Zaangażowanie (ilościowa, metryka interwałowa)
round(alfa_kripp(x_zaang, "interval"), 3)
round(KrippAlpha(x_zaang, method = "interval")$value, 3)

# Bootstrap 95% CI dla alfy (strategia): losowanie nagrań ze zwracaniem, 2000 powtórzeń
set.seed(77)
boot_alfa <- replicate(2000, alfa_kripp(x_strat[, sample(ncol(x_strat), replace = TRUE)], "nominal")[["alfa"]])
round(quantile(boot_alfa, c(.025, .975)), 3)
Wynik w R
n_wartosci       alfa
   220.000      0.551
[1] 0.551
n_wartosci       alfa
   180.000      0.567
[1] 0.771
n_wartosci       alfa
   220.000      0.809
[1] 0.809
 2.5% 97.5%
0.434 0.660
4. Paradoks kappy: rzadka kategoria
R
# Paradoks kappy: rzadka kategoria „wzmianka o przemocy rówieśniczej” (sędziowie A i B, 80 nagrań; obiekty z przepisu 1)
library(psych)
tab_p <- table(A = factor(przemoc$A, 0:1, c("nie", "tak")), B = factor(przemoc$B, 0:1, c("nie", "tak")))
tab_p
a <- tab_p["tak", "tak"]; d <- tab_p["nie", "nie"]; b <- tab_p["tak", "nie"]; c_ <- tab_p["nie", "tak"]; N <- sum(tab_p)
p_o <- (a + d) / N
p_e <- ((a + b) * (a + c_) + (c_ + d) * (b + d)) / N^2
pi_sr <- ((a + b) + (a + c_)) / (2 * N)                 # średnia częstość „tak” u obu sędziów
round(c(zgodnosc = p_o, p_e = p_e, kappa = (p_o - p_e) / (1 - p_e),
        p_pos = 2 * a / (2 * a + b + c_),               # zgodność w ocenach „tak” (Cicchetti i Feinstein, 1990)
        p_neg = 2 * d / (2 * d + b + c_),               # zgodność w ocenach „nie”
        AC1 = (p_o - 2 * pi_sr * (1 - pi_sr)) / (1 - 2 * pi_sr * (1 - pi_sr))), 3)   # AC1 Gweta (2008)
round(cohen.kappa(cbind(przemoc$A, przemoc$B))$confid["unweighted kappa", ], 3)

# Ta sama zgodność 95%, różna częstość kategorii: kappa i AC1 przy symetrycznych rozkładach brzegowych
pi_ <- c(.03, .05, .10, .20, .30, .50)
p_e_k <- pi_^2 + (1 - pi_)^2
round(data.frame(czestosc = pi_, kappa = (.95 - p_e_k) / (1 - p_e_k),
                 AC1 = (.95 - 2 * pi_ * (1 - pi_)) / (1 - 2 * pi_ * (1 - pi_))), 3)
Wynik w R
     B
A     nie tak
  nie  73   3
  tak   3   1
zgodnosc      p_e    kappa    p_pos    p_neg      AC1
   0.925    0.905    0.211    0.250    0.961    0.917
   lower estimate    upper
  -0.199    0.211    0.620
  czestosc kappa   AC1
1     0.03 0.141 0.947
2     0.05 0.474 0.945
3     0.10 0.722 0.939
4     0.20 0.844 0.926
5     0.30 0.881 0.914
6     0.50 0.900 0.900
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W artykule podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Sam procent zgodności bez korekty na przypadek – albo sama kappa bez procentu zgodności i tabeli. Podaj oba.
- Korelacja Pearsona jako miara zgodności. Nie widzi systematycznych przesunięć (rysunek 2); zastąp ją ICC zgodności absolutnej.
- „ICC = .85” bez formy. Bez modelu, typu i definicji czytelnik nie wie, czy to rzetelność pojedynczego sędziego, czy średniej z trzech. W przykładzie ta różnica to .81 wobec .93 (Koo i Li, 2016).
- Raportowanie ICC dla średniej z sędziów, gdy w badaniu właściwym każdy obiekt ocenia jedna osoba. Wtedy właściwa jest forma dla pojedynczego sędziego.
- Kappa ważona bez informacji o wagach albo wybór wag po obejrzeniu wyników.
- Interpretacja według słownych progów bez przedziału ufności. Przy 80 obiektach kappa .57 ma przedział od .43 do .70, a przy rzadkiej kategorii przedział może obejmować wartości ujemne.
- Zastępowanie niskiej kappy współczynnikiem AC1 bez pokazania ppos i pneg.
- Zgodność liczona po uzgodnieniach albo na materiale z treningu, a nie na niezależnych ocenach z badania właściwego.
- Usunięcie obiektów z brakującą oceną, gdy można policzyć alfę Krippendorffa na wszystkich parach ocen.
Najczęstsze pytania
Kappa Cohena czy ICC – którą miarę zgodności sędziów wybrać?
Zależy to od poziomu pomiaru. Kappa Cohena jest dla kategorii nominalnych (z wagami – dla porządkowych), a ICC dla ocen ilościowych, takich jak punkty czy oceny na skali 0–100. Przy ICC wybierz model, typ i definicję zgodności zgodnie z planem badania i podaj je w raporcie (Koo i Li, 2016).
Jak policzyć zgodność trzech lub więcej sędziów?
Dla kategorii nominalnych przy komplecie ocen użyj kappy Fleissa (Fleiss, 1971), dla ocen ilościowych – ICC z wszystkimi sędziami w modelu. Gdy części ocen brakuje albo chcesz jednej miary dla różnych poziomów pomiaru, użyj alfy Krippendorffa (Hayes i Krippendorff, 2007). Warto też pokazać kappy dla par sędziów, bo wskazują, kto odbiega od reszty.
Dlaczego kappa jest niska, mimo że sędziowie zgadzają się w ponad 90% przypadków?
To paradoks kappy: gdy jedna kategoria jest bardzo rzadka, zgodność oczekiwana z przypadku jest wysoka, więc kappa spada nawet przy dużym procencie zgodności (Feinstein i Cicchetti, 1990). Podaj wtedy osobno zgodność w ocenach pozytywnych i negatywnych (ppos, pneg). Często okazuje się, że sędziowie zgadzają się tylko co do braku zjawiska.
Kiedy użyć alfy Krippendorffa zamiast kappy?
Gdy nie każdy sędzia ocenił każdy obiekt, gdy sędziów jest więcej niż dwóch albo gdy chcesz jednej miary dla zmiennych nominalnych, porządkowych i ilościowych. Na kompletnych danych alfa daje wyniki bardzo zbliżone do kappy Fleissa (metryka nominalna) i ICC zgodności absolutnej (metryka interwałowa), ale pozwala wykorzystać wszystkie dostępne pary ocen.
Co powinien zawierać raport z badania zgodności sędziów?
Opis sędziów i ich treningu, liczbę i sposób doboru ocenianych obiektów, informację, czy oceny były niezależne, nazwę miary (z formą ICC albo rodzajem wag kappy), wartość z 95% przedziałem ufności i sposób rozstrzygania rozbieżności. Pełną listę 15 zagadnień zawierają wytyczne GRRAS (Kottner i in., 2011).
Powiązane hasła
Przeczytaj też
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikBadanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →Masz oceny kilku sędziów i nie wiesz, którą miarę zgodności zgłosić?
Pomożemy dobrać miarę i formę ICC do planu badania, policzymy zgodność z przedziałami ufności i wyjaśnimy wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cicchetti, D. V., & Feinstein, A. R. (1990). High agreement but low kappa: II. Resolving the paradoxes. Journal of Clinical Epidemiology, 43(6), 551–558. https://doi.org/10.1016/0895-4356(90)90159-m
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-l
- Fleiss, J. L. (1971). Measuring nominal scale agreement among many raters. Psychological Bulletin, 76(5), 378–382. https://doi.org/10.1037/h0031619
- Gwet, K. L. (2008). Computing inter-rater reliability and its variance in the presence of high agreement. British Journal of Mathematical and Statistical Psychology, 61(1), 29–48. https://doi.org/10.1348/000711006x126600
- Hayes, A. F., & Krippendorff, K. (2007). Answering the call for a standard reliability measure for coding data. Communication Methods and Measures, 1(1), 77–89. https://doi.org/10.1080/19312450709336664
- IBM. (b.d.). IBM SPSS Statistics 30.0.0 documentation. Pobrano 21 października 2026 z https://www.ibm.com/docs/en/spss-statistics/30.0.0 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Shoukri, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96–106. https://doi.org/10.1016/j.jclinepi.2010.03.002
- Liljequist, D., Elfving, B., & Skavberg Roaldsen, K. (2019). Intraclass correlation – A discussion and demonstration of basic features. PLOS ONE, 14(7), Article e0219854. https://doi.org/10.1371/journal.pone.0219854 ● Otwarty dostęp
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
Cytowania BibTeX
@article{cicchetti1990high, author={Cicchetti, Domenic V. and Feinstein, Alvan R.}, title={{High agreement but low kappa: II. Resolving the paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={551--558}, doi={10.1016/0895-4356(90)90159-m}}@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{cohen1968weighted, author={Cohen, Jacob}, title={{Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={4}, pages={213--220}, doi={10.1037/h0026256}}@article{feinstein1990high, author={Feinstein, Alvan R. and Cicchetti, Domenic V.}, title={{High agreement but low kappa: I. The problems of two paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={543--549}, doi={10.1016/0895-4356(90)90158-l}}@article{fleiss1971measuring, author={Fleiss, Joseph L.}, title={{Measuring nominal scale agreement among many raters}}, journal={Psychological Bulletin}, year={1971}, volume={76}, number={5}, pages={378--382}, doi={10.1037/h0031619}}@article{gwet2008computing, author={Gwet, Kilem Li}, title={{Computing inter-rater reliability and its variance in the presence of high agreement}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2008}, volume={61}, number={1}, pages={29--48}, doi={10.1348/000711006x126600}}@article{hayes2007answering, author={Hayes, Andrew F. and Krippendorff, Klaus}, title={{Answering the call for a standard reliability measure for coding data}}, journal={Communication Methods and Measures}, year={2007}, volume={1}, number={1}, pages={77--89}, doi={10.1080/19312450709336664}}@misc{ibmndspssdokumentacja, author={{IBM}}, title={{IBM SPSS Statistics 30.0.0 documentation}}, url={https://www.ibm.com/docs/en/spss-statistics/30.0.0}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{kottner2011guidelines, author={Kottner, Jan and Audigé, Laurent and Brorson, Stig and Donner, Allan and Gajewski, Byron J. and Hróbjartsson, Asbjørn and Roberts, Chris and Shoukri, Mohamed and Streiner, David L.}, title={{Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={1}, pages={96--106}, doi={10.1016/j.jclinepi.2010.03.002}}@article{liljequist2019intraclass, author={Liljequist, David and Elfving, Britt and Skavberg Roaldsen, Kirsti}, title={{Intraclass correlation – A discussion and demonstration of basic features}}, journal={PLOS ONE}, year={2019}, volume={14}, number={7}, eid={e0219854}, doi={10.1371/journal.pone.0219854}}@article{mcgraw1996forming, author={McGraw, Kenneth O. and Wong, S. P.}, title={{Forming inferences about some intraclass correlation coefficients}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={30--46}, doi={10.1037/1082-989x.1.1.30}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}@article{sim2005kappa, author={Sim, Julius and Wright, Chris C.}, title={{The kappa statistic in reliability studies: Use, interpretation, and sample size requirements}}, journal={Physical Therapy}, year={2005}, volume={85}, number={3}, pages={257--268}, doi={10.1093/ptj/85.3.257}}