Co to jest kappa Fleissa?
Kappa Fleissa (ang. Fleiss' kappa, κF) to miara zgodności trzech lub więcej sędziów, którzy przypisują obiekty do kategorii nominalnych, skorygowana o zgodność przypadkową. Opisał ją Fleiss (1971); przenosi ona logikę kappy Cohena na wielu sędziów. Stosuje się ją np. przy kodowaniu odpowiedzi otwartych przez zespół koderów albo przy klasyfikacji zachowań z nagrań. Każdy obiekt musi mieć tyle samo ocen, ale nie muszą ich wystawiać ci sami sędziowie.
Jak liczyć
P̄ to średni po obiektach odsetek zgodnych par ocen, a P̄e – zgodność oczekiwana, czyli suma kwadratów ogólnych częstości kategorii. W odróżnieniu od kappy Cohena zgodność przypadkowa jest liczona ze wspólnych częstości wszystkich sędziów, a nie z rozkładów każdego z nich osobno. Uogólnione statystyki typu kappa dla wielu obserwatorów rozwijali też Landis i Koch (1977).
Przykład
Czterech psychologów zakwalifikowało 60 wypowiedzi z dzienników pacjentów jako emocję, myśl albo zachowanie (dane symulowane). Wszyscy czterej zgodzili się przy 30 wypowiedziach. Średni odsetek zgodnych par wyniósł .736, zgodność oczekiwana .362, a kappa Fleissa .586, 95% CI [.48, .69] (bootstrap). Kappy Cohena dla sześciu par sędziów mieściły się w przedziale .53–.64.
Na rysunku
Panel A to dane z przykładu. Panel B to symulacja: czterech sędziów o tej samej trafności co w przykładzie (85% ocen zgodnych z prawdą, reszta losowa) koduje 60 obiektów w dwóch kategoriach, a kategoria „obecne” jest coraz rzadsza. Dla każdej częstości powtórzono 1000 badań.
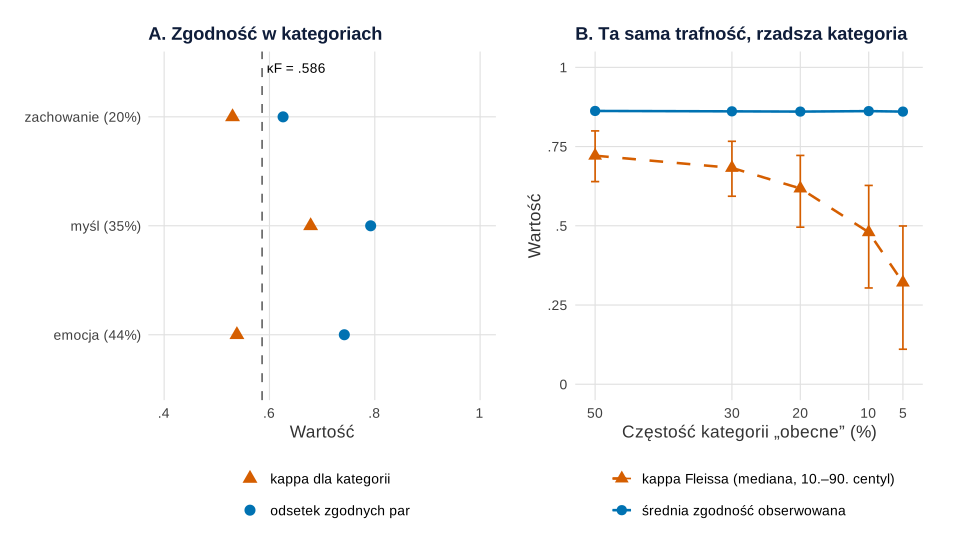
set.seed(203) i set.seed(2031)).Co widać. W przykładzie sędziowie najlepiej zgadzali się co do „myśli” (79.2% zgodnych par, kappa dla kategorii .678), a najsłabiej co do najrzadszego „zachowania” (62.6% i .530). W panelu B średnia zgodność obserwowana prawie się nie zmienia (od 86.0% do 86.2%, błąd Monte Carlo 0.1 pp), a mediana kappy Fleissa spada z .721 przy kategoriach po 50% do .321, gdy „obecne” stanowi 5% obiektów. Przy częstości 5% aż 71.7% badań (błąd MC 1.4 pp) daje κF poniżej .40, choć sędziowie są tak samo trafni jak przy 50%.
Na co uważać. Spadek w panelu B nie jest błędem obliczeń. Przy rzadkiej kategorii zgodność oczekiwana przez przypadek jest wysoka, więc niewiele zostaje „ponad przypadek”. Rośnie też rozrzut kappy między badaniami (dłuższe wąsy). Symulacja zakłada losowe pomyłki, a w prawdziwych danych bywają one systematyczne. Dlatego obok κF podawaj częstości kategorii i zgodność w kategoriach. Przy bardzo rzadkiej kategorii można dodatkowo podać AC1 Gweta, który słabiej reaguje na częstość. Panel A to wykres punktowy Clevelanda.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Panel A korzysta z tego samego ziarna 203 co przykład, a panel B z ziarna 2031. Oba ziarna ustalono raz i nie zmieniano. Trafność sędziów (85%), częstości kategorii i liczbę badań ustawiono ręcznie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Kappa Fleissa: zgodność w kategoriach (A) i paradoks rzadkiej kategorii (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
okabe <- c(kappa = "#D55E00", zgodnosc = "#0072B2")             # paleta Okabe–Ito

# A. Dane z przykładu hasła: 60 wypowiedzi, 4 sędziów, 3 kategorie (to samo ziarno co wyżej)
set.seed(203)
N <- 60; m <- 4; kat <- c("emocja", "mysl", "zachowanie")
prawda <- sample(kat, N, TRUE, c(.45, .35, .20))
oceny <- sapply(1:m, function(j) ifelse(runif(N) < .85, prawda, sample(kat, N, TRUE)))
n_ij <- t(apply(oceny, 1, function(x) table(factor(x, levels = kat))))
p_j <- colSums(n_ij) / (N * m)                              # częstości kategorii
zgodnosc_j <- colSums(n_ij * (n_ij - 1)) / colSums(n_ij * (m - 1))   # zgodne pary wśród par z kategorią j
kappa_j <- 1 - colSums(n_ij * (m - n_ij)) / (N * m * (m - 1) * p_j * (1 - p_j))   # kappa dla kategorii (Fleiss, 1971)
round(rbind(czestosc = p_j, zgodnosc = zgodnosc_j, kappa = kappa_j), 3)

dA <- data.frame(kategoria = rep(sprintf("%s (%.0f%%)", c("emocja", "myśl", "zachowanie"), 100 * p_j), 2),
                 miara = rep(c("odsetek zgodnych par", "kappa dla kategorii"), each = 3),
                 wartosc = c(zgodnosc_j, kappa_j))
pA <- ggplot(dA, aes(wartosc, kategoria, colour = miara, shape = miara)) +
  geom_vline(xintercept = 0.586, linetype = "dashed", colour = "grey40") +
  geom_point(size = 3.5) +
  annotate("text", x = 0.595, y = 3.45, label = "κF = .586", hjust = 0, size = 3.6) +
  scale_colour_manual(values = unname(okabe), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(limits = c(0.4, 1), labels = function(x) sub("^0\\.", ".", x)) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "A. Zgodność w kategoriach", x = "Wartość", y = NULL) +
  motyw

# B. Ci sami „sędziowie” (85% ocen zgodnych z prawdą, reszta losowa), dwie kategorie,
#    coraz rzadsza kategoria „obecne”; po 1000 symulowanych badań z N = 60 i m = 4
fleiss2 <- function(x, m) {                                 # x: liczba ocen „obecne” dla każdego obiektu
  n_ij <- cbind(x, m - x)
  P <- mean((rowSums(n_ij^2) - m) / (m * (m - 1)))
  p <- colSums(n_ij) / sum(n_ij); Pe <- sum(p^2)
  c(P_obs = P, kappa = (P - Pe) / (1 - Pe))
}
czestosci <- c(0.50, 0.30, 0.20, 0.10, 0.05)
R <- 1000
set.seed(2031)
sym <- do.call(rbind, lapply(czestosci, function(pr) {
  t(replicate(R, {
    prawda <- rbinom(N, 1, pr)
    oc <- sapply(1:m, function(j) ifelse(runif(N) < .85, prawda, rbinom(N, 1, 0.5)))
    c(czestosc = pr, fleiss2(rowSums(oc), m))
  }))
}))
sym <- as.data.frame(sym)
wynB <- do.call(rbind, lapply(split(sym, sym$czestosc), function(d) data.frame(
  czestosc = d$czestosc[1], P_obs = mean(d$P_obs), blad_MC_P = sd(d$P_obs) / sqrt(R),
  kappa_med = median(d$kappa), kappa_q10 = quantile(d$kappa, .10), kappa_q90 = quantile(d$kappa, .90),
  kappa_ponizej_40 = mean(d$kappa < .40))))
wynB$blad_MC_40 <- sqrt(wynB$kappa_ponizej_40 * (1 - wynB$kappa_ponizej_40) / R)
rownames(wynB) <- NULL
round(wynB, 3)

dB <- rbind(data.frame(czestosc = wynB$czestosc, miara = "średnia zgodność obserwowana",
                       y = wynB$P_obs, lo = NA, hi = NA),
            data.frame(czestosc = wynB$czestosc, miara = "kappa Fleissa (mediana, 10.–90. centyl)",
                       y = wynB$kappa_med, lo = wynB$kappa_q10, hi = wynB$kappa_q90))
pB <- ggplot(dB, aes(100 * czestosc, y, colour = miara, shape = miara, linetype = miara)) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 1.2, linetype = "solid", na.rm = TRUE) +
  geom_line(linewidth = 0.9) +
  geom_point(size = 3.2) +
  scale_colour_manual(values = unname(okabe), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_x_reverse(breaks = 100 * czestosci) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) sub("^0\\.", ".", x)) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "B. Ta sama trafność, rzadsza kategoria", x = "Częstość kategorii „obecne” (%)", y = "Wartość") +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("kappa-fleissa-rzadka-kategoria.svg", p1, width = 10, height = 5.8)
Wynik w R
         emocja  mysl zachowanie
czestosc  0.442 0.354      0.204
zgodnosc  0.742 0.792      0.626
kappa     0.538 0.678      0.530
  czestosc P_obs blad_MC_P kappa_med kappa_q10 kappa_q90 kappa_ponizej_40
1     0.05 0.860     0.001     0.321     0.111     0.499            0.717
2     0.10 0.862     0.001     0.480     0.304     0.627            0.262
3     0.20 0.860     0.001     0.618     0.496     0.722            0.016
4     0.30 0.861     0.001     0.683     0.593     0.767            0.000
5     0.50 0.862     0.001     0.721     0.639     0.799            0.000
  blad_MC_40
1      0.014
2      0.014
3      0.004
4      0.000
5      0.000
Jak opisać w pracy
Na co uważać
- Kappa Fleissa to nie średnia kapp Cohena. Średnią kapp dla par nazywa się kappą Lighta. Tutaj oba wyniki są zbliżone (.586), ale przy różnych rozkładach ocen sędziów mogą się rozjechać.
- Rzadkie kategorie obniżają kappę. Na wielkość kappy wpływa rozpowszechnienie kategorii (Sim i Wright, 2005), więc podawaj też częstości kategorii.
- Dobierz miarę do danych. Przy kategoriach porządkowych rozważ W Kendalla, a przy brakach ocen – alfę Krippendorffa.
Porównanie wszystkich miar na jednym zbiorze danych znajdziesz we wpisie Zgodność sędziów: kappa, ICC, alfa.
Kappa Fleissa w R
Kod liczy kappę Fleissa ręcznie, bez dodatkowych pakietów.
Kappa Fleissa z tabeli ocen
R
set.seed(203)                                   # 60 wypowiedzi, 4 sędziów, 3 kategorie
N <- 60; m <- 4; kat <- c("emocja", "mysl", "zachowanie")
prawda <- sample(kat, N, TRUE, c(.45, .35, .20))
oceny <- sapply(1:m, function(j) ifelse(runif(N) < .85, prawda, sample(kat, N, TRUE)))
n_ij <- t(apply(oceny, 1, function(x) table(factor(x, levels = kat))))  # liczba ocen w kategorii
P_i <- (rowSums(n_ij^2) - m) / (m * (m - 1))    # odsetek zgodnych par dla wypowiedzi
p_j <- colSums(n_ij) / (N * m)                  # ogólne częstości kategorii
P_obs <- mean(P_i); P_exp <- sum(p_j^2)
round(c(P_obs = P_obs, P_exp = P_exp, kappa_F = (P_obs - P_exp) / (1 - P_exp)), 3)
Wynik w R
  P_obs   P_exp kappa_F
  0.736   0.362   0.586
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu base). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy w kappie Fleissa każdy obiekt muszą ocenić ci sami sędziowie?
Nie. Wystarczy, że każdy obiekt ma tyle samo ocen, np. po trzy z większego zespołu. Gdy liczba ocen się różni, lepszym wyborem jest alfa Krippendorffa.
Czym kappa Fleissa różni się od kappy Lighta?
Kappa Lighta to średnia kapp Cohena dla wszystkich par sędziów. Kappa Fleissa liczy zgodność przypadkową ze wspólnych częstości kategorii, więc przy różnych rozkładach ocen sędziów wyniki mogą się różnić.
Jak policzyć kappę Fleissa w R bez pakietu irr?
Policz dla każdego obiektu liczbę ocen w każdej kategorii, z niej odsetek zgodnych par, a zgodność oczekiwaną z ogólnych częstości kategorii. Kod mieści się w kilku liniach base R.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikOcena ekspercka kwestionariusza
Panel ekspertów jako pretest: lista QAS-99, I-CVI z kappą zmodyfikowaną, zgodność ekspertów, reguła decyzji i liczba ekspertów w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fleiss, J. L. (1971). Measuring nominal scale agreement among many raters. Psychological Bulletin, 76(5), 378–382. https://doi.org/10.1037/h0031619
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174. https://doi.org/10.2307/2529310 ● Otwarty dostęp: pełny tekst
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
Cytowania BibTeX
@article{fleiss1971measuring, author={Fleiss, Joseph L.}, title={{Measuring nominal scale agreement among many raters}}, journal={Psychological Bulletin}, year={1971}, volume={76}, number={5}, pages={378--382}, doi={10.1037/h0031619}}@article{landis1977measurement, author={Landis, J. Richard and Koch, Gary G.}, title={{The measurement of observer agreement for categorical data}}, journal={Biometrics}, year={1977}, volume={33}, number={1}, pages={159--174}, doi={10.2307/2529310}}@article{sim2005kappa, author={Sim, Julius and Wright, Chris C.}, title={{The kappa statistic in reliability studies: Use, interpretation, and sample size requirements}}, journal={Physical Therapy}, year={2005}, volume={85}, number={3}, pages={257--268}, doi={10.1093/ptj/85.3.257}}