Co to jest kappa Cohena?
Kappa Cohena (κ, ang. Cohen’s kappa) to miara zgodności dwóch sędziów, którzy przypisują te same obiekty do kategorii skali nominalnej, skorygowana o zgodność wynikającą z przypadku. Współczynnik wprowadził Cohen (1960) jako alternatywę dla prostego procentu zgodności. McHugh (2012) podkreśla, że kappa koryguje procent zgodności o zgodność przypadkową, przyjmuje wartości od −1 do +1 i należy do najczęściej stosowanych miar rzetelności międzysędziowskiej.
W psychologii kappę liczy się wszędzie tam, gdzie ludzie kodują materiał jakościowy: przy kategoryzowaniu odpowiedzi na pytania otwarte, kodowaniu zachowań w badaniach obserwacyjnych czy porównywaniu diagnoz dwóch klinicystów. Wysoka zgodność jest warunkiem obiektywności pomiaru: wynik nie powinien zależeć od tego, kto kodował. Hallgren (2012) w przystępnym przewodniku omawia, jak zaplanować badanie zgodności, dobrać statystykę oraz policzyć, zinterpretować i opisać wynik.
Wzór na kappę Cohena
- po – zgodność obserwowana: odsetek obiektów, które obaj sędziowie zaliczyli do tej samej kategorii (suma przekątnej tabeli krzyżowej podzielona przez N),
- pe – zgodność oczekiwana przez przypadek: suma iloczynów odsetków, z jakimi każdy sędzia używał danej kategorii,
- licznik mówi, o ile zgodność przekracza przypadek, a mianownik – ile maksymalnie mogła go przekroczyć.
κ = 1 oznacza pełną zgodność, κ = 0 – zgodność na poziomie przypadku, a wartości ujemne – zgodność mniejszą niż przypadkowa. Po co korekta? Hallgren (2012) pokazuje, że gdyby dwaj sędziowie zupełnie losowo oznaczali 10% osób jako „z depresją”, a 90% jako „bez depresji”, oczekiwany odsetek zgodnych ocen wyniósłby 82%, choć cała ta zgodność byłaby przypadkowa. Oczekiwane liczebności liczy się tak samo jak w teście chi-kwadrat: suma wiersza × suma kolumny / N.
Przykład: kodowanie odpowiedzi otwartych
Dwoje niezależnych sędziów zakodowało 100 odpowiedzi studentów na pytanie „Jak radzisz sobie ze stresem przed egzaminem?” w trzech kategoriach strategii: skoncentrowanej na problemie, skoncentrowanej na emocjach i unikania (dane przykładowe). Rysunek 1 przedstawia tabelę zgodności.
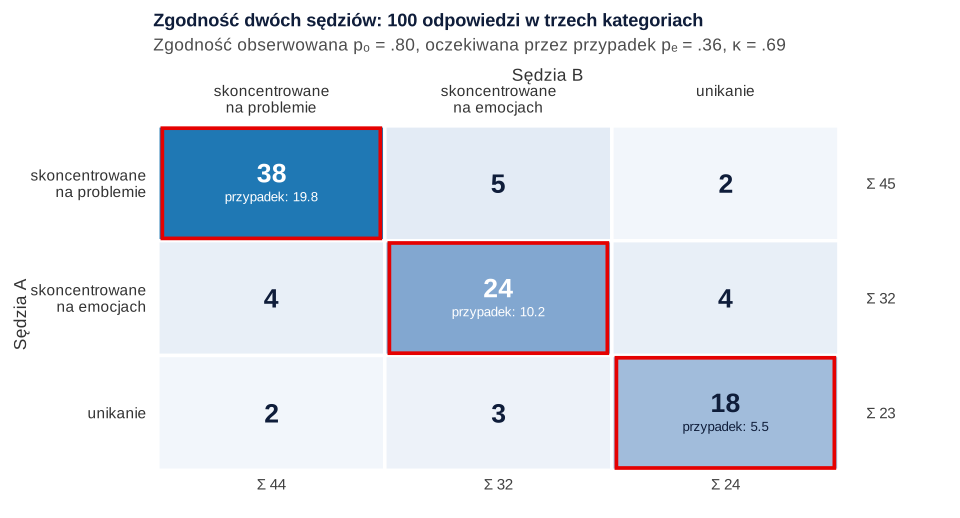
Krok 1. Zgodność obserwowana. Na przekątnej leży 38 + 24 + 18 = 80 odpowiedzi, więc po = 80 / 100 = .80.
Krok 2. Zgodność przypadkowa. Sędzia A użył kategorii w proporcjach .45, .32 i .23, a sędzia B – .44, .32 i .24:
Krok 3. Kappa.
Funkcja cohen.kappa() z pakietu psych daje ten sam wynik z 95% przedziałem ufności: κ = .69, 95% CI [.57, .81]. Choć sędziowie zgodzili się w 80% odpowiedzi, po odjęciu przypadku zostaje zgodność „umiarkowana” według kryteriów McHugh (2012), a dolna granica przedziału spada poniżej .60. To sygnał, by doprecyzować definicje kategorii – najczęściej mylono strategie skoncentrowane na emocjach z pozostałymi.
Jak interpretować kappę Cohena?
McHugh (2012) uważa popularne progi, według których już κ = .41 bywa uznawana za zgodność umiarkowaną, za zbyt łagodne w badaniach dotyczących zdrowia i proponuje surowszą skalę. W jej ujęciu każda kappa poniżej .60 świadczy o niewystarczającej zgodności sędziów.
| Wartość κ | Poziom zgodności |
|---|---|
| 0–.20 | brak |
| .21–.39 | minimalna |
| .40–.59 | słaba |
| .60–.79 | umiarkowana |
| .80–.90 | silna |
| powyżej .90 | prawie doskonała |
Etykiety to konwencja, a nie test. Oceniaj także przedział ufności i to, do czego służą kody: wstępna eksploracja odpowiedzi znosi niższą zgodność niż kodowanie, od którego zależy diagnoza.
Kappa ważona dla kategorii porządkowych
Gdy kategorie są uporządkowane – np. nasilenie objawów: brak, łagodne, umiarkowane, ciężkie na skali porządkowej – pomyłka o jeden stopień jest mniejszym problemem niż pomyłka o trzy. Kappa nieważona traktuje je jednakowo. Kappa ważona przyznaje częściową zgodność za bliskie oceny; jej wersję ważoną i nieważoną definiują m.in. Sim i Wright (2005). Najczęstsze wagi zgodności to liniowe, w = 1 − |i − j| / (k − 1), i kwadratowe, w = 1 − (i − j)² / (k − 1)², gdzie i i j to numery kategorii, a k – ich liczba.
W przykładzie dwóch klinicystów oceniło nasilenie objawów u 80 osób. Zgodzili się w 77.5% przypadków, a wszystkie rozbieżności dotyczyły sąsiednich kategorii. Kappa nieważona wyniosła .695, ważona liniowo – .808, a ważona kwadratowo – .899. Wybór wag zmienia wynik, więc zawsze napisz, jakich użyto. Dla kategorii nominalnych, takich jak strategie radzenia sobie, kappa ważona nie ma sensu.
Paradoks kappy: wysoka zgodność, niska kappa
Sim i Wright (2005) wymieniają czynniki, które wpływają na wartość kappy niezależnie od jakości kodowania: rozpowszechnienie kategorii, stronniczość sędziów i zależność ocen. Hallgren (2012) wyjaśnia, że gdy jedna kategoria występuje znacznie częściej niż inne (problem rozpowszechnienia), kappa bywa niereprezentatywnie niska, a gdy sędziowie różnią się rozkładami ocen (problem stronniczości) – niereprezentatywnie wysoka. Rysunek 2 pokazuje pierwszy efekt.
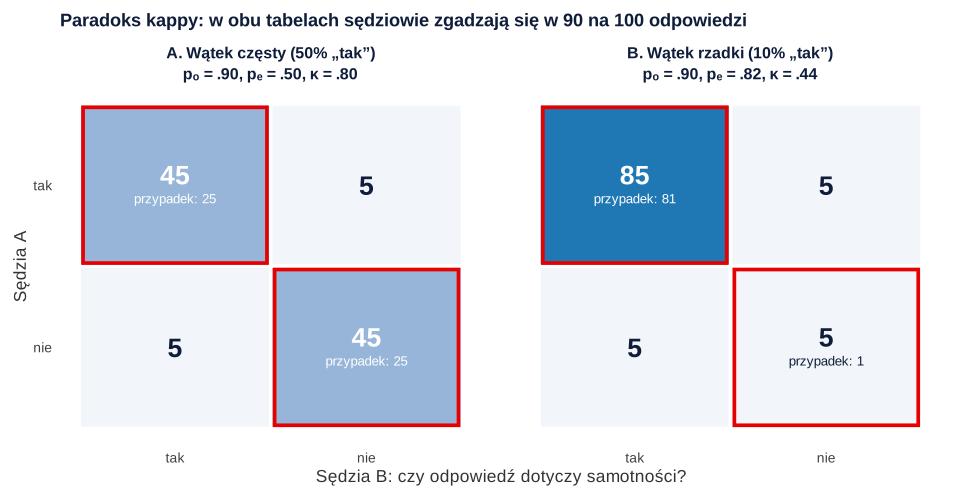
W obu tabelach procent zgodności jest identyczny (90%). Gdy wątek samotności pojawia się w połowie odpowiedzi, κ = .80, 95% CI [.68, .92]. Gdy pojawia się tylko w 10% odpowiedzi, sędziowie zgadzają się głównie co do tego, że go nie ma – a taką zgodność łatwo uzyskać przypadkiem. Kappa spada wtedy do .44, 95% CI [.16, .73]. Dlatego obok kappy podawaj procent zgodności i rozkład kategorii albo całą tabelę. Hallgren (2012) opisuje też warianty kappy korygujące oba efekty, np. wariant Byrta i współpracowników dla rozpowszechnienia, i zaznacza, że żaden nie koryguje obu naraz.
Jak opisać kappę Cohena w pracy (APA)
W opisie procedury kodowania podaj liczbę kodowanych jednostek i sędziów, sposób szkolenia, to, czy kodowali niezależnie, procent zgodności, kappę z przedziałem ufności i sposób rozstrzygania rozbieżności. Gdy kodowanie jest kosztowne, drugi sędzia może zakodować tylko część materiału – Hallgren (2012) dopuszcza uogólnienie zgodności z takiego podzbioru na całą próbę.
Ostatnie zdanie dopasuj do swojej procedury. Więcej gotowych zdań znajdziesz we wpisie jak opisać wyniki w stylu APA, a o planowaniu pytań otwartych w ankiecie – w poradniku jak zrobić ankietę do pracy dyplomowej.
Przykład w R
Kod liczy kappę ręcznie i funkcją cohen.kappa() z pakietu psych, porównuje kappę nieważoną i ważoną dla kategorii porządkowych oraz odtwarza paradoks kappy. Liczby w tekście i na rysunkach pochodzą z tego kodu.
Kappa Cohena, kappa ważona i paradoks
R
library(psych)
# 1. Dwóch sędziów kodowało 100 odpowiedzi otwartych w 3 kategoriach (dane przykładowe)
kat <- c("problem", "emocje", "unikanie")
tab <- matrix(c(38,  5,  2,
                 4, 24,  4,
                 2,  3, 18), nrow = 3, byrow = TRUE, dimnames = list(sedzia_A = kat, sedzia_B = kat))
N   <- sum(tab)
p_o <- sum(diag(tab)) / N                          # zgodność obserwowana
p_e <- sum(rowSums(tab) * colSums(tab)) / N^2      # zgodność oczekiwana przez przypadek
round(c(p_o = p_o, p_e = p_e, kappa = (p_o - p_e) / (1 - p_e)), 4)
cohen.kappa(tab)                                   # kappa z 95% CI (dla kategorii nominalnych czytaj wiersz unweighted)

# 2. Kategorie porządkowe: nasilenie objawów (brak, łagodne, umiarkowane, ciężkie), 80 osób
tab_o <- matrix(c(20,  4,  0,  0,
                   3, 17,  4,  0,
                   0,  3, 14,  2,
                   0,  0,  2, 11), nrow = 4, byrow = TRUE)
w_lin <- 1 - abs(outer(1:4, 1:4, "-")) / 3         # wagi liniowe (1 = pełna zgodność)
round(c(p_o = sum(diag(tab_o)) / sum(tab_o), niewazona = cohen.kappa(tab_o)$kappa,
        liniowa = cohen.kappa(tab_o, w = w_lin)$weighted.kappa,
        kwadratowa = cohen.kappa(tab_o)$weighted.kappa), 3)

# 3. Paradoks kappy: ta sama zgodność 90%, inny rozkład kategorii
czesta <- matrix(c(45, 5, 5, 45), 2)               # kategoria „tak” w 50% odpowiedzi
rzadka <- matrix(c(85, 5, 5, 5), 2)                # kategoria „tak” w 10% odpowiedzi
round(sapply(list(czesta = czesta, rzadka = rzadka), function(t) {
  n <- sum(t); po <- sum(diag(t)) / n; pe <- sum(rowSums(t) * colSums(t)) / n^2
  c(p_o = po, p_e = pe, kappa = (po - pe) / (1 - pe))
}), 3)
Wynik w R
   p_o    p_e  kappa
0.8000 0.3556 0.6896
Call: cohen.kappa1(x = x, w = w, n.obs = n.obs, alpha = alpha, levels = levels,
    w.exp = w.exp)

Cohen Kappa and Weighted Kappa correlation coefficients and confidence boundaries
                 lower estimate upper
unweighted kappa  0.57     0.69  0.81
weighted kappa    0.62     0.75  0.88

 Number of subjects = 100
       p_o  niewazona    liniowa kwadratowa
     0.775      0.695      0.808      0.899
      czesta rzadka
p_o      0.9  0.900
p_e      0.5  0.820
kappa    0.8  0.444
SPSS i JASP. W SPSS wybierz Analiza → Statystyki opisowe → Tabele krzyżowe, umieść kody sędziów w wierszach i kolumnach, a w Statystykach zaznacz Kappa. W JASP użyj analizy Rater Agreement w module Reliability (kappa Cohena i Fleissa).
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Sam procent zgodności – nie uwzględnia przypadku, więc zawyża zgodność (Hallgren, 2012). Podawaj go razem z kappą.
- Kappa nieważona dla kategorii porządkowych – karze bliskie i dalekie rozbieżności tak samo. Użyj kappy ważonej i napisz, jakie wagi wybrano.
- Kappa Cohena dla więcej niż dwóch sędziów – ta statystyka dotyczy dokładnie dwóch sędziów. Hallgren (2012) opisuje kappę Fleissa, gdy obiekty oceniają różni sędziowie, i średnią z kapp dla par, gdy wszyscy oceniają wszystko. Dla ocen ilościowych użyj ICC.
- Kappa bez tabeli – przy rzadkiej kategorii niska kappa nie musi oznaczać złego kodowania (Sim i Wright, 2005). Pokaż rozkład kategorii.
- Związek zamiast zgodności – V Craméra czy korelacja mogą być wysokie, nawet gdy sędziowie systematycznie wybierają różne kategorie; zgodność mierzy tylko przekątna tabeli.
- Zależne kodowanie i mała próba – sędziowie powinni kodować niezależnie, a przy kilkudziesięciu jednostkach przedział ufności kappy jest szeroki; Sim i Wright (2005) omawiają wymaganą liczebność próby w badaniach zgodności.
Najczęstsze pytania
Co to jest kappa Cohena?
Kappa Cohena (κ) to miara zgodności dwóch sędziów, którzy przypisują te same obiekty – np. odpowiedzi na pytanie otwarte – do kategorii. W przeciwieństwie do procentu zgodności odejmuje zgodność, jaką dałoby losowe kodowanie. Przyjmuje wartości od −1 do 1; 0 oznacza zgodność na poziomie przypadku.
Jak obliczyć kappę Cohena?
Policz zgodność obserwowaną po (odsetek obiektów na przekątnej tabeli zgodności) i przypadkową pe (suma iloczynów odsetków, z jakimi sędziowie używali każdej kategorii), a potem κ = (po − pe) / (1 − pe). Na przykład dla po = .80 i pe = .3556 kappa wynosi .69. W R: psych::cohen.kappa().
Jaka wartość kappy Cohena jest dobra?
Według McHugh (2012) kappa .60–.79 oznacza zgodność umiarkowaną, .80–.90 silną, a powyżej .90 prawie doskonałą; wartości poniżej .60 uznaje ona za niewystarczające. Oceniaj też 95% przedział ufności i cel kodowania – od kodów, które decydują o diagnozie, wymaga się więcej niż od wstępnej eksploracji odpowiedzi.
Czym różni się kappa Cohena od procentu zgodności?
Procent zgodności to odsetek obiektów zakodowanych tak samo przez obu sędziów. Kappa odejmuje od niego zgodność przypadkową, która jest wysoka, gdy jedna kategoria dominuje. Dlatego przy tej samej zgodności 90% kappa może wynosić .80 albo .44 – zależnie od rozkładu kategorii.
Kiedy używać kappy ważonej?
Gdy kategorie są uporządkowane, np. nasilenie objawów od braku do ciężkich. Kappa ważona przyznaje częściową zgodność za oceny w sąsiednich kategoriach. Napisz, czy użyto wag liniowych, czy kwadratowych – w przykładzie na tej stronie dają one .808 i .899 przy kappie nieważonej .695.
Co zrobić, gdy sędziów jest więcej niż dwóch?
Kappa Cohena dotyczy dokładnie dwóch sędziów. Przy większej liczbie użyj kappy Fleissa (gdy różne obiekty oceniają różni sędziowie) albo średniej z kapp dla wszystkich par (gdy wszyscy oceniają wszystko). Gdy oceny są ilościowe, policz współczynnik korelacji wewnątrzklasowej (ICC).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031 ● Otwarty dostęp
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
Cytowania BibTeX
@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{mchugh2012interrater, author={McHugh, Mary L.}, title={{Interrater reliability: The kappa statistic}}, journal={Biochemia Medica}, year={2012}, volume={22}, number={3}, pages={276--282}, doi={10.11613/bm.2012.031}}@article{sim2005kappa, author={Sim, Julius and Wright, Chris C.}, title={{The kappa statistic in reliability studies: Use, interpretation, and sample size requirements}}, journal={Physical Therapy}, year={2005}, volume={85}, number={3}, pages={257--268}, doi={10.1093/ptj/85.3.257}}