Co to jest pi Scotta?
Pi Scotta (π, ang. Scott’s pi) to współczynnik zgodności dwóch koderów dla danych nominalnych, skorygowany o zgodność przypadkową. Scott (1955) zaproponował go do oceny rzetelności kodowania w analizie treści, pięć lat przed kappą Cohena (Cohen, 1960). Oba współczynniki mają tę samą postać, a różnią się sposobem liczenia zgodności przypadkowej.
Wzór
π = (Po − Pe) / (1 − Pe), gdzie Po to odsetek zgodnych decyzji, a Pe = Σ pk². Odsetek pk to udział kategorii k we wszystkich decyzjach obu koderów łącznie. Pi zakłada więc, że obaj koderzy mają wspólny rozkład kategorii. Kappa mnoży osobne rozkłady brzegowe każdego kodera. Gdy brzegi są takie same, pi i kappa są równe; gdy się różnią, pi jest niższe od kappy, bo kwadrat średniej dwóch odsetków nie jest mniejszy od ich iloczynu.
Przykład
Dwaj koderzy oceniali 100 wypowiedzi jako pozytywne, neutralne lub negatywne. Przy podobnych brzegach i zgodności 80% pi i kappa wynoszą po 0.695. Gdy pierwszy koder znacznie częściej wybiera „pozytywne” (55 wobec 30 decyzji), przy zgodności 75% kappa wynosi 0.618, a pi – 0.602. Kappa „nagradza” tu część różnicy w brzegach, pi traktuje ją jako niezgodność.
Na rysunku
Jak duża bywa różnica między pi i kappą? Rysunek pokazuje najprostszy przypadek: dwie kategorie, zgodność obserwowana stała (80%), koder 2 daje „tak” w 50% (panel A) albo w 80% przypadków (panel B), a odsetek „tak” u kodera 1 zmienia się w całym dopuszczalnym zakresie – przy zgodności 80% brzegi mogą się różnić najwyżej o 20 punktów procentowych.
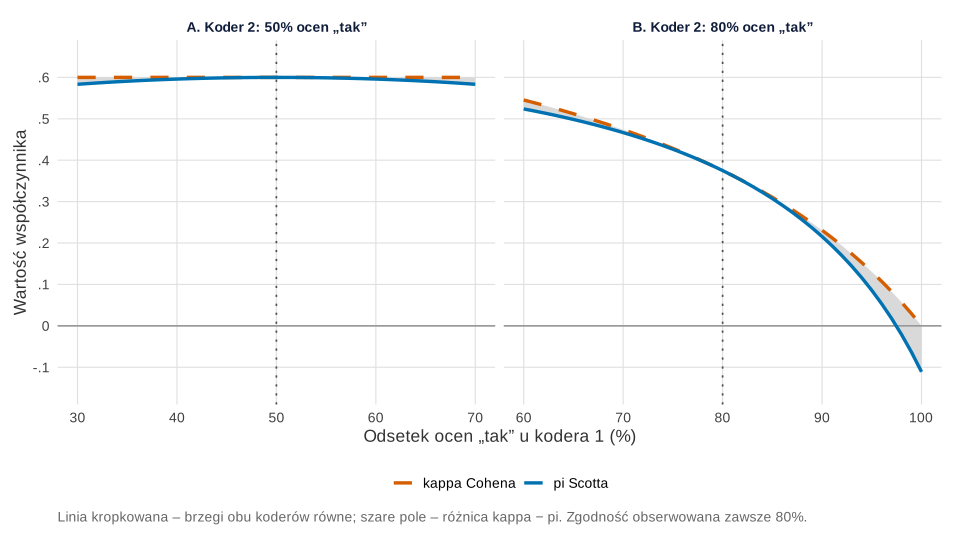
Co widać. Na pionowej linii kropkowanej brzegi są równe i oba współczynniki się pokrywają (.600 w panelu A, .375 w panelu B). Im bardziej brzegi się rozchodzą, tym niższe jest pi względem kappy, ale w panelu A różnica nawet przy 20 pp wynosi tylko .017. Większa jest tam, gdzie jeden koder prawie zawsze wybiera tę samą kategorię: gdy koder 1 daje „tak” w 100% przypadków, kappa wynosi 0, a pi −.111. W panelu B oba współczynniki spadają razem – o ich wartości decyduje przede wszystkim częstość kategorii, a dopiero w drugiej kolejności różnica brzegów.
Na co uważać. Wykres dotyczy dwóch kategorii i jednej wartości zgodności; przy trzech kategoriach z przykładu różnica wyniosła .016. Mała różnica między pi i kappą nie znaczy, że brzegi są podobne – trzeba je pokazać w tabeli decyzji. Sama różnica brzegów to systematyczna rozbieżność koderów (jeden częściej wybiera daną kategorię), którą warto opisać osobno, zamiast wybierać współczynnik, który ją „wybacza”. Spadek obu miar w panelu B to paradoks rzadkiej kategorii, szerzej pokazany w haśle AC1 Gweta.
Podpis do pracy:
Kod poniżej liczy oba współczynniki ze wzorów podanych wyżej i odtwarza rysunek. Nic nie jest losowane; zgodność 80% i brzegi kodera 2 (50% i 80%) ustawiono ręcznie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Pi Scotta a kappa Cohena, gdy brzegi koderów się rozchodzą (2 kategorie, zgodność stała 80%)
library(ggplot2)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

po <- 0.80                                         # zgodność obserwowana, taka sama we wszystkich tabelach
pi_kappa_2 <- function(p1, p2, po) {               # p1, p2: odsetek „tak” u kodera 1 i 2
  pe_k <- p1 * p2 + (1 - p1) * (1 - p2)            # Cohen: iloczyny osobnych brzegów
  ps <- (p1 + p2) / 2
  pe_pi <- ps^2 + (1 - ps)^2                       # Scott: kwadraty wspólnego brzegu
  c(p1 = p1, p2 = p2, kappa = (po - pe_k) / (1 - pe_k), pi = (po - pe_pi) / (1 - pe_pi))
}
# Przy zgodności 80% brzegi mogą się różnić najwyżej o 20 pp
siatka <- rbind(data.frame(p2 = 0.5, p1 = seq(0.30, 0.70, by = 0.01)),
                data.frame(p2 = 0.8, p1 = seq(0.60, 1.00, by = 0.01)))
tab <- as.data.frame(t(mapply(pi_kappa_2, siatka$p1, siatka$p2, MoreArgs = list(po = po))))
tab$roznica <- tab$kappa - tab$pi
round(tab[round(abs(tab$p1 - tab$p2), 2) %in% c(0, 0.1, 0.2), ], 3)   # brzegi równe, różne o 10 i 20 pp

tab$panel <- ifelse(tab$p2 == 0.5, "A. Koder 2: 50% ocen „tak”", "B. Koder 2: 80% ocen „tak”")
d <- rbind(data.frame(tab[, c("p1", "p2", "panel")], miara = "kappa Cohena", y = tab$kappa),
           data.frame(tab[, c("p1", "p2", "panel")], miara = "pi Scotta", y = tab$pi))
p1 <- ggplot(d, aes(100 * p1, y)) +
  geom_ribbon(data = tab, aes(x = 100 * p1, ymin = pi, ymax = kappa), inherit.aes = FALSE, fill = "grey85") +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_vline(aes(xintercept = 100 * p2), linetype = "dotted", colour = "grey30") +
  geom_line(aes(colour = miara, linetype = miara), linewidth = 1.2) +
  facet_wrap(~ panel, scales = "free_x") +
  scale_colour_manual(values = c("#D55E00", "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_y_continuous(limits = c(-0.15, 0.65), breaks = seq(-0.1, 0.6, 0.1), labels = function(x) sub("^(-?)0\\.", "\\1.", x)) +
  labs(x = "Odsetek ocen „tak” u kodera 1 (%)", y = "Wartość współczynnika",
       caption = "Linia kropkowana – brzegi obu koderów równe; szare pole – różnica kappa − pi. Zgodność obserwowana zawsze 80%.") +
  motyw
p1   # zapis: ggsave("pi-scotta-kappa-brzegi.svg", p1, width = 10, height = 5.6)
Wynik w R
    p1  p2 kappa     pi roznica
1  0.3 0.5 0.600  0.583   0.017
11 0.4 0.5 0.600  0.596   0.004
21 0.5 0.5 0.600  0.600   0.000
31 0.6 0.5 0.600  0.596   0.004
41 0.7 0.5 0.600  0.583   0.017
42 0.6 0.8 0.545  0.524   0.022
52 0.7 0.8 0.474  0.467   0.007
62 0.8 0.8 0.375  0.375   0.000
72 0.9 0.8 0.231  0.216   0.015
82 1.0 0.8 0.000 -0.111   0.111
Jak opisać w pracy
Na co uważać
Pi i kappa dają paradoksalnie niskie wartości przy wysokiej zgodności, gdy jedna kategoria dominuje; Gwet (2008) analizuje źródła tych paradoksów i proponuje AC1. Uogólnieniem pi na więcej koderów jest kappa Fleissa – dla dwóch koderów daje dokładnie tę samą wartość. Z kolei alfa Krippendorffa opiera zgodność przypadkową, podobnie jak pi, na połączonym rozkładzie decyzji, ale dopuszcza braki danych i inne poziomy pomiaru. Obok pi podaj odsetek zgodności i tabelę decyzji. Wybór miary omawiamy we wpisie o zgodności sędziów, a kodowanie odpowiedzi – we wpisie analiza treści pytań otwartych.
Pi Scotta w R
Kod liczy pi Scotta i kappę Cohena ręcznie dla dwóch tabel 3 × 3 i sprawdza, że kappa Fleissa z pakietu DescTools daje dla dwóch koderów tę samą wartość co pi.
Pi a kappa przy podobnych i różnych brzegach
R
# Pi Scotta a kappa Cohena dla 2 koderów i 3 kategorii (R bazowy + DescTools)
pi_kappa <- function(tab) {
  N <- sum(tab)
  po <- sum(diag(tab)) / N                        # zgodność obserwowana
  r1 <- rowSums(tab) / N; r2 <- colSums(tab) / N  # brzegi koderów
  pe_kappa <- sum(r1 * r2)                        # Cohen: iloczyny osobnych brzegów
  pe_pi <- sum(((r1 + r2) / 2)^2)                 # Scott: kwadraty połączonych brzegów
  round(c(zgodnosc = po, pe_kappa = pe_kappa, kappa = (po - pe_kappa) / (1 - pe_kappa),
          pe_pi = pe_pi, pi = (po - pe_pi) / (1 - pe_pi)), 3)
}
kat <- c("pozytywny", "neutralny", "negatywny")
# 100 wypowiedzi; wiersze = koder 1, kolumny = koder 2
podobne <- matrix(c(30, 5, 0,
                     5, 30, 5,
                     0, 5, 20), 3, byrow = TRUE, dimnames = list(kat, kat))
rozne <- matrix(c(30, 20, 5,
                   0, 30, 0,
                   0, 0, 15), 3, byrow = TRUE, dimnames = list(kat, kat))
rbind(podobne_brzegi = pi_kappa(podobne), rozne_brzegi = pi_kappa(rozne))

# Kappa Fleissa dla 2 koderów jest równa pi Scotta
library(DescTools)
oceny <- data.frame(k1 = rep(rep(kat, 3), times = c(rozne)),
                    k2 = rep(rep(kat, each = 3), times = c(rozne)))
round(KappaM(oceny, method = "Fleiss"), 3)
Wynik w R
               zgodnosc pe_kappa kappa pe_pi    pi
podobne_brzegi     0.80    0.345 0.695 0.345 0.695
rozne_brzegi       0.75    0.345 0.618 0.371 0.602
[1] 0.602
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools 0.99.60. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym pi Scotta różni się od kappy Cohena?
Tylko zgodnością przypadkową. Pi liczy ją z połączonego rozkładu decyzji obu koderów, kappa – z iloczynu osobnych rozkładów brzegowych. Przy identycznych brzegach oba współczynniki są równe, przy różnych pi jest niższe.
Kiedy wybrać pi Scotta zamiast kappy?
Gdy koderzy są wymienni i różnicę w częstości używania kategorii chcesz traktować jako brak zgodności, co jest typowe w analizie treści. Przy więcej niż dwóch koderach użyj kappy Fleissa lub alfy Krippendorffa.
Jak policzyć pi Scotta w R?
Policz odsetek zgodnych decyzji, udział każdej kategorii we wszystkich decyzjach obu koderów i sumę kwadratów tych udziałów, a następnie podstaw do (Po − Pe) / (1 − Pe). Dla dwóch koderów ten sam wynik daje kappa Fleissa, np. DescTools::KappaM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikAnaliza treści pytań otwartych
Klucz kategoryzacji, pilotaż, kappa dla każdej kategorii, odsetki z przedziałem Wilsona i porównanie grup – z plikiem Excel, kodem R i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Gwet, K. L. (2008). Computing inter-rater reliability and its variance in the presence of high agreement. British Journal of Mathematical and Statistical Psychology, 61(1), 29–48. https://doi.org/10.1348/000711006x126600
- Scott, W. A. (1955). Reliability of content analysis: The case of nominal scale coding. Public Opinion Quarterly, 19(3), 321–325. https://doi.org/10.1086/266577
Cytowania BibTeX
@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{gwet2008computing, author={Gwet, Kilem Li}, title={{Computing inter-rater reliability and its variance in the presence of high agreement}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2008}, volume={61}, number={1}, pages={29--48}, doi={10.1348/000711006x126600}}@article{scott1955reliability, author={Scott, William A.}, title={{Reliability of content analysis: The case of nominal scale coding}}, journal={Public Opinion Quarterly}, year={1955}, volume={19}, number={3}, pages={321--325}, doi={10.1086/266577}}