Kiedy odpowiedzi otwarte wymagają analizy treści
Ankieta do pracy dyplomowej prawie zawsze kończy się polem tekstowym: „Co jeszcze chcesz dodać?”, „Dlaczego?”, „Co należałoby zmienić?”. Po zebraniu danych okazuje się, że jest tam 150 albo 400 wypowiedzi o różnej długości i jakości. Część to jedno słowo, część to akapit, część nie odpowiada na pytanie. Najprostsza reakcja, czyli wklejenie kilku „ciekawych” cytatów do rozdziału wyników, rzadko przekonuje promotora i recenzenta. Nie wiadomo bowiem, jak często dana myśl się powtarzała ani dlaczego wybrano akurat te cytaty.
Analiza treści (ang. content analysis) zamienia swobodne wypowiedzi w kategorie, które da się policzyć, porównać i opisać w sposób powtarzalny. Wytyczne GESIS opisują ją jako podstawową metodę opracowania pytań otwartych w ankietach, obok komputerowej analizy słownikowej i analizy współwystępowania (Züll, 2016). Singer i Couper (2017) zwracają uwagę, że odpowiedzi otwarte w badaniach ilościowych pokazują nie tylko treść opinii, ale też to, jak respondenci rozumieją pytanie. Bywają więc cenne także wtedy, gdy nie są głównym celem badania.
Samą czynność przypisywania wypowiedzi do kategorii omawiamy w haśle kodowanie odpowiedzi otwartych. Ten poradnik prowadzi przez całą analizę na jednym przykładzie. Zaczynamy od przygotowania danych i klucza kategoryzacji, potem pokazujemy pilotaż i zgodność dwóch koderek w każdej kategorii, a na końcu liczenie odsetków z przedziałami ufności, porównanie grup, opis w pracy i kod R.
Trzy podejścia do analizy treści
Hsieh i Shannon (2005) wyróżniają trzy odmiany jakościowej analizy treści. Różnią się tym, skąd pochodzą kategorie:
| Podejście | Skąd kategorie | Kiedy w ankiecie |
|---|---|---|
| Konwencjonalne (indukcyjne) | Z samych odpowiedzi, po ich przeczytaniu | Pytanie eksploracyjne, mało wcześniejszych badań, np. „Co Cię zniechęca…?” |
| Ukierunkowane (dedukcyjne) | Z teorii lub wcześniejszych badań; nowe kategorie dopisuje się w razie potrzeby | Gdy chcesz sprawdzić, czy znana typologia (np. barier, motywów) pasuje do Twojej grupy |
| Sumacyjne | Z listy słów lub treści, które się liczy, a potem interpretuje w kontekście | Gdy interesuje Cię częstość konkretnych określeń, np. nazw usług czy objawów |
Elo i Kyngäs (2008) opisują wariant indukcyjny i dedukcyjny jako ten sam proces w trzech fazach: przygotowanie, organizowanie i raportowanie. Według nich podejście indukcyjne pasuje do zjawisk słabo opisanych w literaturze, a dedukcyjne do sprawdzania wcześniejszej teorii w nowej sytuacji. W pracy dyplomowej często łączy się oba podejścia. Klucz startowy budujesz z literatury, a kategorie, których w niej nie było, dopisujesz po lekturze odpowiedzi. Napisz w rozdziale metodologicznym wprost, które podejście wybrałeś(-aś).
Ten poradnik dotyczy analizy treści, której wynikiem są liczby: liczebności kategorii, odsetki i porównania grup. Gdy pracujesz z długimi wywiadami i celem jest interpretacja znaczeń, a nie liczenie, potrzebujesz metod jakościowych w ścisłym sensie. Wtedy połączenie obu części opisujemy we wpisie badania mieszane (mixed methods) – schematy i opis.
Badanie przykładowe: bariery w korzystaniu z pomocy psychologicznej
Studentka psychologii przeprowadziła ankietę internetową wśród 320 osób studiujących (208 kobiet i 112 mężczyzn; dane symulowane). Oprócz skal i pytań zamkniętych ankieta zawierała jedno nieobowiązkowe pytanie otwarte:
„Co najbardziej zniechęca Cię do skorzystania z pomocy psychologicznej na uczelni?”
Odpowiedziały na nie 184 osoby (57.5%). Odpowiedzi kodowały niezależnie dwie osoby, autorka pracy i koleżanka z seminarium, według wspólnego klucza z dziewięcioma kategoriami. Jedna odpowiedź mogła dostać do trzech kodów, bo wiele osób wymieniało kilka powodów naraz, np. wstyd i terminy. Dane z kodami obu koderek i klucz kategoryzacji możesz pobrać jako plik Excel. Arkusz klucz zawiera definicje i reguły graniczne, a arkusz odpowiedzi zawiera teksty, kody koderki A i B oraz kod ostateczny.
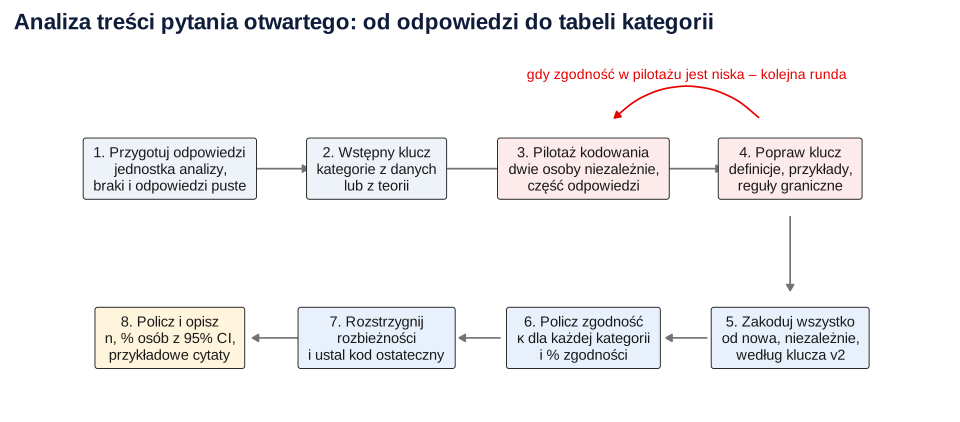
Krok 1. Przygotuj odpowiedzi i ustal jednostkę analizy
Eksport z Google Forms czy LimeSurvey daje kolumnę tekstu, której nie wolno jeszcze analizować. Najpierw zdecyduj o trzech sprawach.
- Co jest jednostką analizy. W ankiecie zwykle jest nią cała odpowiedź jednej osoby. Dzięki temu możesz potem napisać „33.2% osób wspomniało o wstydzie”. Przy długich wypowiedziach można dzielić tekst na fragmenty (zdania, wątki), ale wtedy liczysz wzmianki, a nie osoby. Campbell i in. (2013) pokazują, że przy kodowaniu wywiadów ujednolicenie jednostek tekstu jest pierwszym warunkiem sensownej zgodności koderów. Jeśli każda osoba podzieli tekst inaczej, nie da się porównać ich kodów.
- Co z odpowiedziami pustymi i nie na temat. Puste pole to brak odpowiedzi, a nie kategoria. Odpowiedzi „nie wiem”, „-”, „brak” czy „nic” rozdziel. „Nic mnie nie zniechęca” jest merytoryczną odpowiedzią i dostaje osobny kod. „Nie wiem” albo kreska to brak treści, który możesz wyłączyć z mianownika, ale musisz podać jego liczbę.
- Czy jedna odpowiedź może mieć kilka kodów. Jeśli tak, zapisuj kody jako osobne kolumny 0/1, tak jak odpowiedzi w pytaniu wielokrotnego wyboru, a nie jako jedną kolumnę z tekstem „WSTYD, TERMINY”.
Na tym etapie usuń też z tekstów dane, które pozwalają rozpoznać osobę: nazwiska prowadzących, nazwy małych grup, opisy zdarzeń. Odpowiedzi otwarte częściej niż pytania zamknięte zawierają informacje identyfikujące, dlatego w pliku dla drugiej koderki i w aneksie stosuj zasady z hasła anonimizacja i pseudonimizacja danych. Jak wyeksportować dane z formularza i nadać kolumnom nazwy, pokazujemy we wpisie dane z Google Forms i LimeSurvey do SPSS i R.
Zanim zaczniesz kodować, sprawdź, kto w ogóle odpowiedział. W przykładzie pole wypełniło 62.0% kobiet i 49.1% mężczyzn, χ²(1, N = 320) = 4.97, p = .026, φ = .12. To typowe: na pytania otwarte chętniej odpowiadają osoby bardziej zaangażowane w temat. Wszystkie odsetki z dalszej analizy opisują więc osoby, które coś napisały, a nie całą próbę. Mechanizm ten przypomina błąd braku odpowiedzi w całej ankiecie.
Krok 2. Zbuduj klucz kategoryzacji
Klucz kategoryzacji (ang. codebook) to instrukcja, dzięki której dwie osoby, które nigdy nie rozmawiały o danych, przypiszą tej samej odpowiedzi te same kody. Przeczytaj 40–60 odpowiedzi, wypisz powtarzające się wątki i zgrupuj je. Potem każdą kategorię opisz w pięciu polach.
- Kod: krótka nazwa bez polskich znaków, wygodna w R i SPSS (np.
POUFNOSC). - Nazwa: to, co pojawi się w tabeli wyników.
- Definicja: jedno lub dwa zdania o tym, co należy do kategorii.
- Przykład: typowa odpowiedź z danych.
- Reguła graniczna: jak kodować odpowiedzi pasujące do dwóch kategorii.
Kategorie powinny być rozłączne, bo żadna wypowiedź nie może pasować do dwóch definicji jednocześnie. Muszą też być wyczerpujące, czyli każda odpowiedź musi gdzieś trafić, choćby do „inne”. Ważny jest też poziom szczegółowości. Dziewięć kategorii przy 184 odpowiedziach to rozsądna liczba. Trzydzieści kategorii z kilkoma osobami w każdej daje tabelę, której nie da się zinterpretować, a kappa w rzadkich kategoriach jest bardzo niestabilna. Gotowy klucz zapisz w książce kodowej razem z kodami zmiennych zamkniętych.
| Kod | Definicja | Reguła graniczna |
|---|---|---|
WSTYD | Wstyd, lęk przed oceną innych osób lub przed byciem uznanym za „słabego” | „Boję się, że ktoś się dowie” bez wskazania uczelni lub dokumentów → WSTYD |
POUFNOSC | Obawa, że informacja o wizycie lub treść rozmowy trafi do uczelni, prowadzących albo do akt | Gdy osoba wskazuje, kto mógłby się dowiedzieć (dziekanat, prowadzący, system) → POUFNOSC |
TERMINY | Bariery po stronie poradni: kolejki, godziny przyjęć, liczba specjalistów | „Terminy w godzinach zajęć” → TERMINY, bo problem leży w ofercie poradni |
CZAS | Bariery po stronie osoby: brak czasu z powodu zajęć, pracy, dojazdów | „Nie mam czasu” bez wzmianki o godzinach poradni → CZAS |
ZAUFANIE | Wątpliwości co do skuteczności pomocy, złe doświadczenia, brak zaufania do kompetencji | „To nic nie da” → ZAUFANIE, a nie SAMODZIELNOSC |
Pozostałe kategorie w przykładzie to INFO (brak informacji, gdzie i jak się zapisać), SAMODZIELNOSC („poradzę sobie sam(a)”, „inni mają gorzej”), BRAK („nic mnie nie zniechęca”, kod wyłączny, którego nie łączy się z innymi) oraz INNE. Pełny klucz jest w pliku do pobrania. Zwróć uwagę na pary kategorii, które łatwo pomylić: wstyd i poufność, terminy i brak czasu, „poradzę sobie” i wątpliwości co do skuteczności. Właśnie dla nich reguły graniczne są najważniejsze. Jak pokaże pilotaż, w pierwszej wersji klucza ich brakowało.
Krok 3. Pilotaż kodowania i poprawa klucza
Pierwsza wersja klucza prawie nigdy nie jest dobra. Zanim zakodujesz wszystko, poproś drugą osobę o niezależne zakodowanie niewielkiej części odpowiedzi. Druga osoba nie może przy tym widzieć Twoich kodów. W przykładzie obie koderki zakodowały 40 pierwszych odpowiedzi według klucza w wersji 1, który miał tylko nazwy i krótkie definicje.
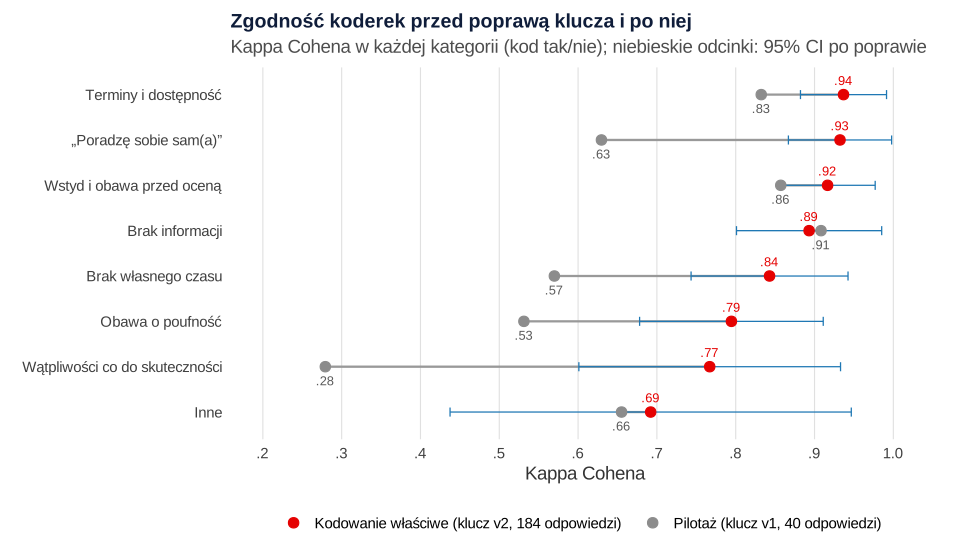
Ten sam zestaw kodów dla całej odpowiedzi miały w 57.5% przypadków. Średnia kappa z kategorii (bez rzadkiej kategorii „inne”) wyniosła .70, ale za tą średnią kryły się duże różnice. Kategorie z wyraźnymi słowami kluczowymi, takie jak brak informacji (κ = .91), wstyd (κ = .86) i terminy (κ = .83), kodowały podobnie. Najsłabiej wypadły wątpliwości co do skuteczności (κ = .28), obawa o poufność (κ = .53), brak czasu (κ = .57) i „poradzę sobie sam(a)” (κ = .63). Te cztery kategorie są dokładnie tymi, które mają „sąsiada”, z którym łatwo je pomylić. Przy wątpliwościach co do skuteczności koderki zgodziły się w 90.0% decyzji tak/nie, a kappa była mimo to bardzo niska. Do tego paradoksu wrócimy w kroku 4.
Po pilotażu koderki omówiły wszystkie rozbieżności i dopisały do klucza reguły graniczne z tabeli wyżej. Tak wygląda praktyczny sens oceny zgodności. O’Connor i Joffe (2020) przyznają, że liczenie zgodności koderów budzi w badaniach jakościowych spory. Wskazują jednak, że zwiększa ono systematyczność i przejrzystość kodowania i pomaga zespołowi dopracować kategorie. Campbell i in. (2013) opisują tę samą logikę jako poprawianie klucza w kolejnych rundach, aż błędy kodowania spadną do akceptowalnego poziomu.
Odpowiedzi z pilotażu po zmianie klucza zakoduj od nowa. Kodów nadanych według wersji 1 nie łącz z kodami według wersji 2. Jeśli po poprawkach zgodność w pilotażu nadal jest niska, zrób drugą rundę na nowych 30–40 odpowiedziach, a nie na tych samych.
Krok 4. Kodowanie właściwe i zgodność w każdej kategorii
Według klucza w wersji 2 obie koderki zakodowały niezależnie wszystkie 184 odpowiedzi. Gdy kodów jest kilka na odpowiedź, zgodność licz osobno dla każdej kategorii. Każda kategoria to wtedy decyzja tak/nie podjęta przez obie osoby, a kappa Cohena koryguje odsetek zgodnych decyzji o zgodność, której można by oczekiwać przy przypadkowym kodowaniu (McHugh, 2012). Pojedyncza kappa „dla całego pytania” nie ma tu sensu, bo kategorie nie wykluczają się wzajemnie.
Tabela 1
Zgodność dwóch koderek w kategoriach pytania o bariery w korzystaniu z pomocy psychologicznej
| Kategoria | Częstość (%) | Zgodność (%) | κ | 95% CI |
|---|---|---|---|---|
| Wstyd i obawa przed oceną | 35.1 | 96.2 | .92 | [.86, .98] |
| Terminy i dostępność | 31.3 | 97.3 | .94 | [.88, .99] |
| „Poradzę sobie sam(a)” | 20.1 | 97.8 | .93 | [.87, 1.00] |
| Brak własnego czasu | 19.3 | 95.1 | .84 | [.74, .94] |
| Obawa o poufność | 17.7 | 94.0 | .79 | [.68, .91] |
| Brak informacji | 15.0 | 97.3 | .89 | [.80, .99] |
| Wątpliwości co do skuteczności | 9.0 | 96.2 | .77 | [.60, .93] |
| Nic nie zniechęca | 7.1 | 100.0 | 1.00 | – |
| Inne | 4.6 | 97.3 | .69 | [.44, .95] |
Uwaga. n = 184 odpowiedzi zakodowanych niezależnie przez dwie osoby według klucza w wersji 2. Częstość to średni odsetek odpowiedzi, którym kategorię przypisały obie koderki. Zgodność to odsetek zgodnych decyzji tak/nie. κ to kappa Cohena dla kodu tak/nie w danej kategorii. Dane symulowane.
Po poprawie klucza średnia kappa wzrosła do .89, a odsetek odpowiedzi z identycznym zestawem kodów do 76.6%. Największą poprawę widać właśnie w czterech kategoriach, które w pilotażu sprawiały trudność (Rysunek 2). Najmniej precyzyjnie oszacowane są kategorie rzadkie: przy wątpliwościach co do skuteczności przedział sięga od .60 do .93, a przy „inne” od .44 do .95.
Dlaczego sam odsetek zgodności nie wystarczy
Spójrz na kategorię „inne”. Koderki zgodziły się w 97.3% decyzji, a kappa wynosi tylko .69. To nie jest błąd obliczeń. Kategorię przypisano zaledwie około 4.6% odpowiedzi, więc dwie osoby, które prawie zawsze wpisują „nie”, zgadzają się w większości przypadków bez żadnego wysiłku. Kappa odejmuje tę „darmową” zgodność. Feinstein i Cicchetti (1990) opisali to zjawisko jako paradoks: przy silnie niezrównoważonych rozkładach brzegowych wysoka zgodność może dawać niską kappę. Sim i Wright (2005) wymieniają rozpowszechnienie kategorii i różnice w skłonnościach oceniających wśród czynników wpływających na wielkość kappy.
Lombard i in. (2002) przejrzeli 200 badań wykorzystujących analizę treści. Stwierdzili, że autorzy często w ogóle nie raportują zgodności koderów albo opierają się na samym odsetku zgodności, który uznali za zbyt liberalny wskaźnik. Krippendorff (2004) w polemice z tym przeglądem analizuje, jak naprawdę zachowują się popularne współczynniki, i formułuje własne zalecenia. Wniosek praktyczny dla pracy dyplomowej: podawaj obie liczby, odsetek zgodności i kappę z przedziałem ufności, osobno dla każdej kategorii. Przy rzadkich kategoriach skomentuj szeroki przedział, zamiast ukrywać go w średniej.
Gdy koderów jest więcej niż dwóch, zamiast kappy Cohena użyj kappy Fleissa albo alfy Krippendorffa, która radzi sobie także z brakami w kodowaniu. Hallgren (2012) omawia, jak zaplanować ocenę zgodności i jak ją raportować. Porównanie miar na wspólnych danych znajdziesz we wpisie zgodność sędziów: kappa, ICC i alfa Krippendorffa. Tutaj nie powtarzamy tych wzorów.
Czy druga osoba musi kodować wszystko?
Nie zawsze. Przy kilkuset odpowiedziach możesz policzyć zgodność na losowej części odpowiedzi, np. co czwartej, a resztę może zakodować jedna osoba według sprawdzonego klucza. Campbell i in. (2013) opisują właśnie taki scenariusz: po dopracowaniu klucza całość koduje jeden kompetentny koder. Losową część wybierz w R (sample()) i podaj w pracy jej wielkość. Niech nie będą to „pierwsze 50 odpowiedzi”, bo kolejność w eksporcie często zależy od czasu wypełnienia. W pracy licencjackiej promotor może zgodzić się na kodowanie przez jedną osobę. Wtedy opisz klucz bardzo dokładnie, dołącz go do aneksu i nazwij brak drugiego kodera ograniczeniem badania.
Krok 5. Rozstrzygnij rozbieżności i ustal kod ostateczny
W kodowaniu właściwym 43 odpowiedzi (23.4%) różniły się co najmniej jednym kodem, a łącznie było 53 rozbieżnych decyzji tak/nie. Każdą z nich koderki omówiły, wracając do definicji i reguł granicznych. Kilka typowych przykładów:
| Odpowiedź | Koderka A | Koderka B | Kod ostateczny |
|---|---|---|---|
| „Nie wiem, czy to nie trafi do dziekanatu” | POUFNOSC | WSTYD, POUFNOSC | POUFNOSC, bo wskazano, kto mógłby się dowiedzieć |
| „Obawiam się, że zostanie jakiś ślad w systemie uczelni, długo się czeka na wizytę” | POUFNOSC, TERMINY | WSTYD, TERMINY | POUFNOSC, TERMINY |
| „Moje problemy nie są aż tak poważne” | SAMODZIELNOSC | CZAS, SAMODZIELNOSC | SAMODZIELNOSC, bo w tekście nie ma mowy o czasie |
| „Nie wiem, czy ktoś na uczelni ma odpowiednie kompetencje” | ZAUFANIE, INNE | ZAUFANIE | ZAUFANIE, bo „inne” stosuje się tylko wtedy, gdy nic nie pasuje |
Rozbieżności można rozstrzygać na trzy sposoby: dyskusją do konsensusu, decyzją trzeciej osoby (np. promotora) albo przyjęciem kodów głównego kodera. Każdy jest dopuszczalny, ale wybrany sposób opisz w pracy. Zgodność raportuj zawsze dla kodów sprzed dyskusji, bo po dyskusji wynosi z definicji 100%. Gdy omawiane przypadki ujawnią nową regułę, dopisz ją do klucza i sprawdź, czy wcześniej zakodowane podobne odpowiedzi jej nie naruszają.
Krok 6. Policz kategorie: trzy możliwe mianowniki
Po rozstrzygnięciu rozbieżności 111 osób miało jeden kod, 46 dwa, a 27 trzy. Razem było więc 284 wzmianek od 184 osób, średnio 1.54 kodu na odpowiedź. Właśnie dlatego odsetki z pytania otwartego z wieloma kodami nie sumują się do 100%. Najczęstszym błędem w tej części pracy jest niejasny mianownik. Ta sama liczba 61 może oznaczać trzy różne odsetki:
Tabela 2
Bariery w korzystaniu z pomocy psychologicznej na uczelni w odpowiedziach na pytanie otwarte
| Kategoria | n | % odpowiadających [95% CI] | % całej próby | % wzmianek |
|---|---|---|---|---|
| Wstyd i obawa przed oceną | 61 | 33.2 [26.8, 40.2] | 19.1 | 21.5 |
| Terminy i dostępność | 58 | 31.5 [25.2, 38.6] | 18.1 | 20.4 |
| „Poradzę sobie sam(a)” | 36 | 19.6 [14.5, 25.9] | 11.2 | 12.7 |
| Brak własnego czasu | 35 | 19.0 [14.0, 25.3] | 10.9 | 12.3 |
| Obawa o poufność | 33 | 17.9 [13.1, 24.1] | 10.3 | 11.6 |
| Brak informacji | 26 | 14.1 [9.8, 19.9] | 8.1 | 9.2 |
| Wątpliwości co do skuteczności | 16 | 8.7 [5.4, 13.7] | 5.0 | 5.6 |
| Nic nie zniechęca | 13 | 7.1 [4.2, 11.7] | 4.1 | 4.6 |
| Inne | 6 | 3.3 [1.5, 6.9] | 1.9 | 2.1 |
Uwaga. Odsetek odpowiadających liczono z 184 osób, które odpowiedziały na pytanie, z 95% przedziałem ufności Wilsona. Odsetek całej próby liczono z N = 320 osób, a odsetek wzmianek z 284 przypisanych kodów. Jedna odpowiedź mogła otrzymać do trzech kodów, dlatego odsetki odpowiadających nie sumują się do 100. Kody ostateczne ustalono po rozstrzygnięciu rozbieżności. Dane symulowane.
- Odsetek odpowiadających (61 z 184 = 33.2%) odpowiada na pytanie „jaka część osób, które coś napisały, wspomniała o wstydzie?”. To zwykle najlepszy wybór do tekstu pracy.
- Odsetek całej próby (61 z 320 = 19.1%) jest dolnym ograniczeniem. Osoby, które nic nie napisały, mogły odczuwać tę samą barierę. Nie pisz więc, że „wstyd zniechęca 19.1% studentów”.
- Odsetek wzmianek (61 z 284 = 21.5%) opisuje strukturę wszystkich wypowiedzi. Przydaje się rzadko, a często myli czytelnika, bo zależy od tego, ile kodów dostawały inne osoby.
Odsetek podaj z przedziałem ufności dla proporcji. Brown i in. (2001) pokazali, że standardowy przedział Walda ma przy proporcjach chaotyczne pokrycie, i zalecają m.in. przedział Wilsona. Przedziały w Tabeli 2 i na Rysunku 3 mają szerokość od około 5 do 13 punktów procentowych. Wstyd (33.2%) i terminy (31.5%) mają przedziały, które w dużej mierze się pokrywają. Na podstawie tych danych nie napiszesz więc, że wstyd jest „ważniejszy” niż terminy. Możesz natomiast napisać, że obie bariery wymieniano wyraźnie częściej niż brak informacji czy wątpliwości co do skuteczności.
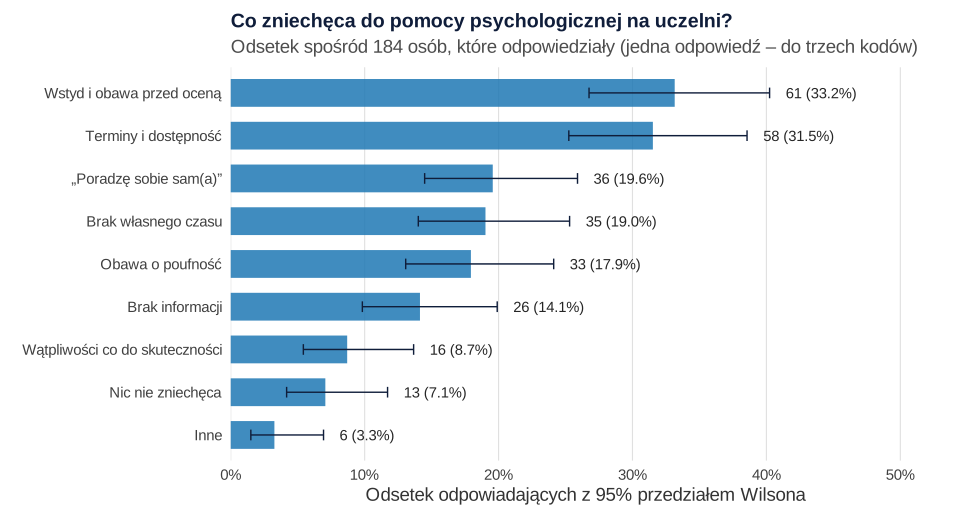
W tabeli i na wykresie uporządkuj kategorie według częstości, a „inne” i „nic nie zniechęca” umieść na końcu. Wybierz słupki poziome, bo nazwy kategorii są długie. Przy kategoriach zakodowanych jako 0/1 nie licz średnich ani testów na „sumie kodów”. Wyjątek to sytuacja, gdy liczba wymienionych barier jest dla Ciebie osobną, zaplanowaną zmienną. Ogólne zasady wykresów słupkowych opisujemy w haśle wykres słupkowy.
Liczby nie wystarczą. Do każdej głównej kategorii dodaj jeden lub dwa krótkie, zanonimizowane cytaty, np. „Obawiam się, że zostanie jakiś ślad w systemie uczelni”. Cytat pokazuje, co kryje się pod etykietą, a liczba pokazuje, jak typowa jest ta wypowiedź. Wybieraj cytaty typowe, a nie najbardziej dramatyczne.
Krok 7. Porównanie grup: ostrożnie i z poprawką
Zakodowane kategorie są zwykłymi zmiennymi nominalnymi, więc możesz je zestawić z innymi zmiennymi w tabeli krzyżowej i teście chi-kwadrat. W przykładzie autorka sprawdziła, czy kobiety i mężczyźni wymieniali te same bariery. Takie porównanie ma jednak trzy słabe punkty, o których trzeba napisać:
- porównujesz tylko osoby, które odpowiedziały, a mężczyźni odpowiadali rzadziej (49.1% wobec 62.0%);
- brak wzmianki o barierze nie znaczy, że jej nie ma, bo osoba mogła po prostu napisać o czymś innym;
- przy dziewięciu kategoriach robisz dziewięć testów, więc rośnie ryzyko fałszywego alarmu.
Wstyd i obawę przed oceną wymieniło 25.6% kobiet (n = 129) i 50.9% mężczyzn (n = 55), χ²(1, N = 184) = 11.16, p < .001, φ = .25. Różnica pozostaje istotna po poprawce Holma na dziewięć porównań (pHolm = .008). Obawę o poufność częściej wymieniali mężczyźni (25.5% wobec 14.7%), ale ta różnica nie była istotna już przed poprawką (p = .083; pHolm = .660). W pozostałych kategoriach różnice między płciami nie przekraczały siedmiu punktów procentowych. W kategorii „inne” najmniejsza liczebność oczekiwana wynosiła 1.79, więc zamiast chi-kwadrat zastosowano test dokładny Fishera (p = .671).
Porównania kategorii z pytania otwartego traktuj w pracy jako eksploracyjne, chyba że hipoteza dotyczyła konkretnej kategorii i była sformułowana przed zebraniem danych. Jeśli pytanie o wstyd jest dla Ciebie kluczowe, w kolejnym badaniu zadaj je jako pytanie zamknięte, np. jako twierdzenie na skali Likerta. Pytanie otwarte dobrze nadaje się do znalezienia takich kategorii, a słabiej do precyzyjnego pomiaru ich częstości.
Jak opisać analizę treści w pracy (APA)
Opis składa się z dwóch części. W rozdziale metodologicznym opisujesz procedurę, a w wynikach liczby. Zmień liczby i nazwy kategorii na własne. Nie zostawiaj zdań o etapach, których nie wykonałeś(-aś).
Metoda: opracowanie odpowiedzi na pytanie otwarte
Wyniki
Tabelę 2 umieść w rozdziale wyników, a Tabelę 1 w wynikach albo w aneksie. Cytaty ilustrujące kategorie dodaj w tekście albo w osobnej kolumnie tabeli. Ogólne zasady zapisu liczb opisujemy we wpisie jak opisać wyniki w stylu APA, a miejsce analizy pytań otwartych w całej ankiecie we wpisie analiza ankiety do pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził Twój klucz, kodowanie i tabele, zanim oddasz rozdział, zajrzyj do oferty analiz dla studentów. Pomagamy policzyć i wyjaśnić wyniki, ale samą interpretację odpowiedzi musisz umieć obronić sam(a).
Analiza treści pytania otwartego w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R, bo przepisy 2 i 3 korzystają z obiektów z przepisu 1. Kody zapisano jako macierze 0/1 (wiersz to odpowiedź, kolumna to kategoria). Kappę z przedziałem ufności liczy funkcja psych::cohen.kappa(), a przedział Wilsona funkcja DescTools::BinomCI(). Pakietu irr nie użyto. Na własnych danych wczytaj arkusz z kodami (np. readxl::read_excel()) i zamień kolumny koderów na takie same macierze.
1. Dane, pilotaż i zgodność koderek w każdej kategorii
R
# Pytanie otwarte: „Co najbardziej zniechęca Cię do skorzystania z pomocy psychologicznej na uczelni?”
# Ankieta wśród 320 osób studiujących (dane symulowane, set.seed(9601)).
# Klucz kategoryzacji: 9 kategorii; jedna odpowiedź może dostać do 3 kodów (kodowanie wielokrotne).
set.seed(9601)
N <- 320
ankieta <- data.frame(id = sprintf("R%03d", 1:N),
                      plec = sample(c("kobieta", "mężczyzna"), N, replace = TRUE, prob = c(.66, .34)))
p_odp <- ifelse(ankieta$plec == "kobieta", .64, .50)
ankieta$odpowiedzial <- rbinom(N, 1, p_odp) == 1

kody <- c("WSTYD", "POUFNOSC", "TERMINY", "CZAS", "INFO", "SAMODZIELNOSC", "ZAUFANIE", "BRAK", "INNE")
nazwy <- c(WSTYD = "Wstyd i obawa przed oceną", POUFNOSC = "Obawa o poufność",
           TERMINY = "Terminy i dostępność", CZAS = "Brak własnego czasu",
           INFO = "Brak informacji", SAMODZIELNOSC = "„Poradzę sobie sam(a)”",
           ZAUFANIE = "Wątpliwości co do skuteczności", BRAK = "Nic nie zniechęca", INNE = "Inne")

# „Prawdziwe” kody (w praktyce nieznane – to, co ustalają koderzy po rozstrzygnięciu rozbieżności)
odp <- ankieta[ankieta$odpowiedzial, ]
n <- nrow(odp)
pr <- function(k, m) switch(k, WSTYD = ifelse(m, .42, .25), POUFNOSC = .13, TERMINY = .28, CZAS = .19,
                             INFO = .21, SAMODZIELNOSC = ifelse(m, .30, .14), ZAUFANIE = .08, INNE = .04)
prawda <- matrix(0L, n, length(kody), dimnames = list(odp$id, kody))
for (i in 1:n) {
  m <- odp$plec[i] == "mężczyzna"
  if (runif(1) < .07) { prawda[i, "BRAK"] <- 1L; next }
  bariery <- setdiff(kody, "BRAK")
  for (k in bariery) prawda[i, k] <- rbinom(1, 1, pr(k, m))
  if (sum(prawda[i, ]) == 0) prawda[i, sample(bariery, 1, prob = sapply(bariery, pr, m = m))] <- 1L
  while (sum(prawda[i, ]) > 3) prawda[i, sample(which(prawda[i, ] == 1), 1)] <- 0L
}

# Koder: pomija kod (miss), dopisuje kod (add) i myli pary podobnych kategorii (myl)
koduj <- function(P, miss, add, myl) {
  K <- P
  for (i in seq_len(nrow(P))) {
    for (k in colnames(P)) {
      if (P[i, k] == 1 && runif(1) < miss) K[i, k] <- 0L
      if (P[i, k] == 0 && k != "BRAK" && runif(1) < add) K[i, k] <- 1L
    }
    for (para in myl) if (P[i, para$z] == 1 && runif(1) < para$p) { K[i, para$z] <- 0L; K[i, para$na] <- 1L }
    if (sum(K[i, ]) == 0) K[i, ] <- P[i, ]
  }
  K
}
# Runda pilotażowa: klucz w wersji 1 (bez reguł granicznych), 40 pierwszych odpowiedzi
pil <- prawda[1:40, ]
myl_v1 <- list(list(z = "POUFNOSC", na = "WSTYD", p = .45), list(z = "CZAS", na = "TERMINY", p = .40),
               list(z = "ZAUFANIE", na = "SAMODZIELNOSC", p = .40))
pA1 <- koduj(pil, .04, .01, list()); pB1 <- koduj(pil, .08, .03, myl_v1)
# Klucz w wersji 2 (dopisane definicje i przypadki graniczne): wszystkie odpowiedzi od nowa
myl_v2 <- list(list(z = "POUFNOSC", na = "WSTYD", p = .12), list(z = "CZAS", na = "TERMINY", p = .10),
               list(z = "ZAUFANIE", na = "SAMODZIELNOSC", p = .12))
A <- koduj(prawda, .04, .01, list()); B <- koduj(prawda, .07, .02, myl_v2)

# Liczba odpowiedzi i odsetek
round(c(N = N, odpowiedzialo = n, proc = 100 * n / N), 1)
tab_odp <- table(ankieta$plec, ankieta$odpowiedzial)
tab_odp
round(100 * prop.table(tab_odp, 1)[, "TRUE"], 1)
chisq.test(tab_odp, correct = FALSE)
c(phi = round(sqrt(unname(chisq.test(tab_odp, correct = FALSE)$statistic) / N), 4))

# Zgodność w każdej kategorii: odsetek zgodnych decyzji tak/nie, częstość kategorii i kappa Cohena z 95% CI
zgodnosc <- function(A, B) {
  t(sapply(colnames(A), function(k) {
    tab <- table(factor(A[, k], 0:1), factor(B[, k], 0:1))
    kk <- suppressWarnings(psych::cohen.kappa(tab))
    c(czestosc = 100 * mean((A[, k] + B[, k]) / 2), zgodnosc = 100 * mean(A[, k] == B[, k]),
      kappa = kk$kappa, dolna = kk$confid[1, 1], gorna = kk$confid[1, 3])
  }))
}
zg_pilot <- zgodnosc(pA1, pB1)
zg_final <- zgodnosc(A, B)
round(zg_pilot[, c("zgodnosc", "kappa")], 2)
round(zg_final, 2)
# Zgodność całych odpowiedzi (ten sam zestaw kodów) i liczba rozbieżności do omówienia
round(c(pilot = 100 * mean(rowSums(pA1 != pB1) == 0), final = 100 * mean(rowSums(A != B) == 0)), 1)
c(rozbiezne_odpowiedzi = sum(rowSums(A != B) > 0), proc = round(100 * mean(rowSums(A != B) > 0), 1),
  rozbiezne_decyzje = sum(A != B))
# Średnia kappa z kategorii (bez rzadkiej kategorii INNE)
round(c(pilot = mean(zg_pilot[kody != "INNE", "kappa"]), final = mean(zg_final[kody != "INNE", "kappa"])), 2)
Wynik w R
            N odpowiedzialo          proc
        320.0         184.0          57.5

            FALSE TRUE
  kobieta      79  129
  mężczyzna    57   55
  kobieta mężczyzna
     62.0      49.1

	Pearson's Chi-squared test

data:  tab_odp
X-squared = 4.9667, df = 1, p-value = 0.02584

   phi
0.1246
              zgodnosc kappa
WSTYD             95.0  0.86
POUFNOSC          92.5  0.53
TERMINY           92.5  0.83
CZAS              85.0  0.57
INFO              97.5  0.91
SAMODZIELNOSC     87.5  0.63
ZAUFANIE          90.0  0.28
BRAK             100.0  1.00
INNE              97.5  0.66
              czestosc zgodnosc kappa dolna gorna
WSTYD            35.05    96.20  0.92  0.86  0.98
POUFNOSC         17.66    94.02  0.79  0.68  0.91
TERMINY          31.25    97.28  0.94  0.88  0.99
CZAS             19.29    95.11  0.84  0.74  0.94
INFO             14.95    97.28  0.89  0.80  0.99
SAMODZIELNOSC    20.11    97.83  0.93  0.87  1.00
ZAUFANIE          8.97    96.20  0.77  0.60  0.93
BRAK              7.07   100.00  1.00  1.00  1.00
INNE              4.62    97.28  0.69  0.44  0.95
pilot final
 57.5  76.6
rozbiezne_odpowiedzi                 proc    rozbiezne_decyzje
                43.0                 23.4                 53.0
pilot final
 0.70  0.89
2. Liczebności kategorii, przedziały Wilsona i porównanie grup
R
# Liczenie kategorii po rozstrzygnięciu rozbieżności (kody ostateczne = obiekt prawda z przepisu 1).
# Odsetek osób, które wspomniały kategorię, z 95% przedziałem Wilsona; trzy różne mianowniki.
K <- prawda
liczba_kodow <- rowSums(K)
table(liczba_kodow)
c(odpowiedzi = nrow(K), wzmianki = sum(K), srednio = round(mean(liczba_kodow), 2))

wil <- DescTools::BinomCI(colSums(K), nrow(K), method = "wilson")
kat <- data.frame(n = colSums(K),
                  proc_odp = 100 * colSums(K) / nrow(K),
                  ci_dolna = 100 * wil[, "lwr.ci"], ci_gorna = 100 * wil[, "upr.ci"],
                  proc_wszystkich = 100 * colSums(K) / N,
                  proc_wzmianek = 100 * colSums(K) / sum(K))
kat <- kat[order(-kat$n), ]
round(kat, 1)

# Kategorie a płeć (analiza eksploracyjna): test chi-kwadrat dla każdej kategorii, poprawka Holma
plec <- odp$plec
porown <- t(sapply(kody, function(k) {
  tab <- table(plec, K[, k])
  ch <- suppressWarnings(chisq.test(tab, correct = FALSE))
  c(K = 100 * mean(K[plec == "kobieta", k]), M = 100 * mean(K[plec == "mężczyzna", k]),
    chi2 = unname(ch$statistic), p = ch$p.value, min_oczek = min(ch$expected),
    phi = sqrt(unname(ch$statistic) / length(plec)))
}))
porown <- cbind(porown, p_holm = p.adjust(porown[, "p"], "holm"))
round(porown, 4)
table(plec)
# Dla kategorii z małą liczebnością oczekiwaną: test dokładny Fishera
fisher.test(table(plec, K[, "INNE"]))$p.value
Wynik w R
liczba_kodow
  1   2   3
111  46  27
odpowiedzi   wzmianki    srednio
    184.00     284.00       1.54
               n proc_odp ci_dolna ci_gorna proc_wszystkich proc_wzmianek
WSTYD         61     33.2     26.8     40.2            19.1          21.5
TERMINY       58     31.5     25.2     38.6            18.1          20.4
SAMODZIELNOSC 36     19.6     14.5     25.9            11.2          12.7
CZAS          35     19.0     14.0     25.3            10.9          12.3
POUFNOSC      33     17.9     13.1     24.1            10.3          11.6
INFO          26     14.1      9.8     19.9             8.1           9.2
ZAUFANIE      16      8.7      5.4     13.7             5.0           5.6
BRAK          13      7.1      4.2     11.7             4.1           4.6
INNE           6      3.3      1.5      6.9             1.9           2.1
                    K       M    chi2      p min_oczek    phi p_holm
WSTYD         25.5814 50.9091 11.1616 0.0008   18.2337 0.2463 0.0075
POUFNOSC      14.7287 25.4545  3.0140 0.0825    9.8641 0.1280 0.6604
TERMINY       29.4574 36.3636  0.8520 0.3560   17.3370 0.0680 1.0000
CZAS          17.8295 21.8182  0.3983 0.5280   10.4620 0.0465 1.0000
INFO          13.1783 16.3636  0.3224 0.5701    7.7717 0.0419 1.0000
SAMODZIELNOSC 17.8295 23.6364  0.8262 0.3634   10.7609 0.0670 1.0000
ZAUFANIE       9.3023  7.2727  0.2001 0.6547    4.7826 0.0330 1.0000
BRAK           8.5271  3.6364  1.4047 0.2359    3.8859 0.0874 1.0000
INNE           3.8760  1.8182  0.5176 0.4719    1.7935 0.0530 1.0000
plec
  kobieta mężczyzna
      129        55
[1] 0.6706352
3. Arkusz z kluczem i kodami do pobrania
R
# Arkusz do pobrania: klucz kategoryzacji + odpowiedzi z kodami dwóch koderów (obiekty z przepisu 1).
# Teksty odpowiedzi składane z krótkich wypowiedzi typowych dla każdej kategorii (dane symulowane).
set.seed(9603)
frazy <- list(
  WSTYD = c("wstydzę się", "boję się, że ktoś mnie zobaczy pod gabinetem", "nie chcę, żeby ktoś uznał, że coś jest ze mną nie tak",
            "trochę wstyd przyznać się, że sobie nie radzę", "obawa, co pomyślą znajomi z roku"),
  POUFNOSC = c("nie wiem, czy to nie trafi do dziekanatu", "boję się, że prowadzący się dowiedzą",
               "nie mam pewności, czy rozmowa zostaje między nami", "obawiam się, że zostanie jakiś ślad w systemie uczelni"),
  TERMINY = c("długo się czeka na wizytę", "terminy są tylko w godzinach zajęć", "zapisy na kilka tygodni do przodu",
              "jedna psycholożka na cały wydział", "trudno się dodzwonić i umówić"),
  CZAS = c("nie mam na to czasu", "pracuję i studiuję jednocześnie", "po zajęciach od razu jadę do pracy",
           "w sesji nie ma kiedy"),
  INFO = c("nie wiem, gdzie to jest", "nie wiedział{em}, że uczelnia ma taką pomoc", "nie wiem, jak się zapisać",
           "brak informacji na stronie wydziału"),
  SAMODZIELNOSC = c("poradzę sobie sam{a}", "moje problemy nie są aż tak poważne", "inni mają gorzej",
                    "wolę porozmawiać ze znajomymi", "radzę sobie sam{a}"),
  ZAUFANIE = c("nie wierzę, że jedna rozmowa coś zmieni", "słyszał{em}, że to nic nie daje",
               "miał{em} złe doświadczenie z psychologiem", "nie wiem, czy ktoś na uczelni ma odpowiednie kompetencje"),
  BRAK = c("nic, w razie potrzeby {poszedl}", "właściwie nic mnie nie zniechęca", "nic, korzystał{em} i polecam"),
  INNE = c("dojazd do drugiego budynku", "chciał{abym} rozmowy po angielsku", "wolał{abym} kontakt online"))
# Formy zależne od płci: {a}, {em}, {abym}, {poszedl}
rodzaj <- function(t, m) {
  z <- if (m) c("{a}" = "", "{em}" = "em", "{abym}" = "bym", "{poszedl}" = "poszedłbym")
       else c("{a}" = "a", "{em}" = "am", "{abym}" = "abym", "{poszedl}" = "poszłabym")
  for (k in names(z)) t <- gsub(k, z[[k]], t, fixed = TRUE)
  t
}
tekst <- sapply(seq_len(nrow(prawda)), function(i) {
  w <- prawda[i, ]
  cz <- vapply(names(w)[w == 1], function(k) sample(frazy[[k]], 1), "")
  t <- rodzaj(paste(cz, collapse = ifelse(runif(1) < .5, ", ", "; ")), odp$plec[i] == "mężczyzna")
  paste0(toupper(substr(t, 1, 1)), substr(t, 2, nchar(t)))
})
kod_tekst <- function(M) apply(M, 1, function(w) paste(names(w)[w == 1], collapse = "; "))
odpowiedzi <- data.frame(id = odp$id, plec = odp$plec, odpowiedz = unname(tekst),
                         koder_A = kod_tekst(A), koder_B = kod_tekst(B),
                         zgodne = ifelse(rowSums(A != B) == 0, "tak", "nie"), kod_ostateczny = kod_tekst(prawda))
klucz <- data.frame(
  kod = kody, nazwa = unname(nazwy[kody]),
  definicja = c("Wstyd, lęk przed oceną innych osób lub przed byciem uznanym za „słabego”.",
                "Obawa, że informacja o wizycie lub treść rozmowy trafi do uczelni, prowadzących albo do akt.",
                "Bariery po stronie poradni: kolejki, godziny przyjęć, liczba specjalistów, trudne zapisy.",
                "Bariery po stronie osoby: brak czasu z powodu zajęć, pracy, dojazdów.",
                "Brak wiedzy, że pomoc istnieje, gdzie jest i jak się zapisać.",
                "Przekonanie, że problem jest za mały albo że osoba poradzi sobie bez pomocy.",
                "Wątpliwości, czy pomoc jest skuteczna; złe doświadczenia; brak zaufania do kompetencji.",
                "Osoba pisze, że nic jej nie zniechęca (kod wyłączny).",
                "Treść, która nie pasuje do żadnej kategorii (zapisz ją w notatce)."),
  przyklad = vapply(kody, function(k) frazy[[k]][1], ""),
  reguly_graniczne = c("„Boję się, że ktoś się dowie” bez wskazania uczelni lub dokumentów → WSTYD.",
                       "Gdy osoba wskazuje, KTO mógłby się dowiedzieć (dziekanat, prowadzący, system) → POUFNOSC.",
                       "„Terminy w godzinach zajęć” → TERMINY (problem leży w ofercie poradni).",
                       "„Nie mam czasu” bez wzmianki o godzinach poradni → CZAS.",
                       "„Nie wiem, czy to darmowe” → INFO.",
                       "„Inni mają gorzej” → SAMODZIELNOSC, a nie WSTYD.",
                       "„To nic nie da” → ZAUFANIE, a nie SAMODZIELNOSC.",
                       "Nie łącz z innymi kodami.",
                       "Używaj tylko wtedy, gdy żadna definicja nie pasuje."))
wb <- openxlsx::createWorkbook(creator = "Metodolog.pl", title = "Analiza treści pytania otwartego – przykład")
openxlsx::addWorksheet(wb, "klucz"); openxlsx::writeData(wb, "klucz", klucz)
openxlsx::addWorksheet(wb, "odpowiedzi"); openxlsx::writeData(wb, "odpowiedzi", odpowiedzi)
openxlsx::setColWidths(wb, "klucz", 1:5, c(16, 30, 70, 45, 75))
openxlsx::setColWidths(wb, "odpowiedzi", 1:7, c(7, 11, 80, 32, 32, 8, 32))
plik <- "../analiza-tresci-pytan-otwartych-przyklad.xlsx"
openxlsx::saveWorkbook(wb, plik, overwrite = TRUE)

# Kontrola: plik otwarty ponownie, metadane autora
sprawdz <- readxl::read_excel(plik, sheet = "odpowiedzi")
dim(sprawdz); readxl::excel_sheets(plik)
tmp <- tempfile(); utils::unzip(plik, "docProps/core.xml", exdir = tmp)
regmatches(readLines(file.path(tmp, "docProps/core.xml"), warn = FALSE),
           gregexpr("<dc:creator>[^<]*</dc:creator>|<cp:lastModifiedBy>[^<]*</cp:lastModifiedBy>",
                    readLines(file.path(tmp, "docProps/core.xml"), warn = FALSE)))
round(file.info(plik)$size / 1024)
# Przykładowe wiersze do tabeli we wpisie: odpowiedzi z rozbieżnymi kodami
head(odpowiedzi[odpowiedzi$zgodne == "nie", c("id", "odpowiedz", "koder_A", "koder_B", "kod_ostateczny")], 6)
head(odpowiedzi[odpowiedzi$zgodne == "tak" & lengths(strsplit(odpowiedzi$kod_ostateczny, ";")) > 1,
                c("id", "odpowiedz", "kod_ostateczny")], 4)
Wynik w R
[1] 184   7
[1] "klucz"      "odpowiedzi"
[[1]]
[1] "<dc:creator>Metodolog.pl</dc:creator>"
[2] "<cp:lastModifiedBy>Metodolog.pl</cp:lastModifiedBy>"

[1] 17
       id                                                                         odpowiedz           koder_A
R002 R002                                          Nie wiem, czy to nie trafi do dziekanatu          POUFNOSC
R015 R015                                                 Zapisy na kilka tygodni do przodu           TERMINY
R016 R016                          Nie wiem, czy ktoś na uczelni ma odpowiednie kompetencje    ZAUFANIE; INNE
R023 R023 Obawiam się, że zostanie jakiś ślad w systemie uczelni, długo się czeka na wizytę POUFNOSC; TERMINY
R026 R026                                               Moje problemy nie są aż tak poważne     SAMODZIELNOSC
R034 R034                                                 Jedna psycholożka na cały wydział           TERMINY
                 koder_B    kod_ostateczny
R002     WSTYD; POUFNOSC          POUFNOSC
R015   POUFNOSC; TERMINY           TERMINY
R016            ZAUFANIE          ZAUFANIE
R023      WSTYD; TERMINY POUFNOSC; TERMINY
R026 CZAS; SAMODZIELNOSC     SAMODZIELNOSC
R034   TERMINY; ZAUFANIE           TERMINY
       id
R007 R007
R020 R020
R022 R022
R029 R029
                                                                                                                                     odpowiedz
R007                                             Nie mam pewności, czy rozmowa zostaje między nami, radzę sobie sama, wolałabym kontakt online
R020                                                                                Długo się czeka na wizytę; pracuję i studiuję jednocześnie
R022 Trochę wstyd przyznać się, że sobie nie radzę, obawiam się, że zostanie jakiś ślad w systemie uczelni, terminy są tylko w godzinach zajęć
R029                                                                               Obawa, co pomyślą znajomi z roku; długo się czeka na wizytę
                    kod_ostateczny
R007 POUFNOSC; SAMODZIELNOSC; INNE
R020                 TERMINY; CZAS
R022      WSTYD; POUFNOSC; TERMINY
R029                WSTYD; TERMINY
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files (R package version 1.4.5) [Computer software]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizie pytań otwartych
- Klucz zmieniany w trakcie kodowania. Jeśli w połowie pracy dopisujesz kategorię albo zmieniasz definicję, pierwsza połowa odpowiedzi jest zakodowana według innych zasad. Poprawki rób po pilotażu, a jeśli są konieczne później, zakoduj wszystko od nowa.
- Kappa liczona po dyskusji. Zgodność opisuje kody nadane niezależnie. Kody po konsensusie zawsze się zgadzają, więc zgodność policzona na nich niczego nie mówi o kluczu.
- Jedna kappa przy kodowaniu wielokrotnym. Gdy odpowiedź może mieć kilka kodów, licz zgodność osobno dla każdej kategorii. Średnią podawaj tylko obok wartości dla kategorii.
- Sam procent zgodności. Przy rzadkich kategoriach daje on obraz zbyt optymistyczny (97.3% przy κ = .69 w kategorii „inne”). Podaj obie liczby.
- Niejasny mianownik. Zdanie „33.2% osób wskazało wstyd” bez dopisku „spośród 184 osób, które odpowiedziały” jest mylące. Zawsze podaj, z czego liczysz odsetek.
- Uogólnianie na całą próbę. Pytanie otwarte jest nieobowiązkowe i odpowiadają na nie określone osoby. Wyniki opisują odpowiadających, a brak wzmianki nie jest odpowiedzią „nie”.
- Zbyt wiele drobnych kategorii. Kategorie z trzema czy czterema osobami łącz w szersze, o ile klucz na to pozwala, albo przenieś do „inne”. Ich kappa i odsetki są zbyt niestabilne, by je interpretować.
- Cytaty wybrane pod tezę. Ilustruj kategorie typowymi wypowiedziami i nie usuwaj z tabeli kategorii, które nie pasują do hipotez, np. „nic nie zniechęca”.
- Testy bez poprawki. Porównanie wielu kategorii między grupami to seria testów. Zastosuj poprawkę na wielokrotne porównania albo wyraźnie nazwij analizę eksploracyjną.
Jeśli dopiero projektujesz ankietę, zastanów się, czy każde pytanie otwarte jest Ci naprawdę potrzebne i ile odpowiedzi zdążysz zakodować. Wskazówki znajdziesz we wpisach jak zrobić ankietę do pracy dyplomowej i najczęstsze błędy w ankietach. Jedno dobrze opracowane pytanie otwarte daje więcej niż pięć pytań, których odpowiedzi trafią do aneksu bez analizy.
Najczęstsze pytania
Jak liczyć procenty w pytaniu otwartym, gdy jedna odpowiedź ma kilka kodów?
Licz odsetek osób, które wspomniały daną kategorię, zwykle spośród osób, które odpowiedziały na pytanie, np. 61 z 184 = 33.2%. Takie odsetki nie sumują się do 100%, bo jedna osoba może mieć kilka kodów. Napisz to w nocie tabeli i podaj, z jakiej liczby liczysz odsetek.
Czy w pracy licencjackiej trzeba mieć dwóch koderów odpowiedzi otwartych?
Nie zawsze jest to wymagane, ale drugi koder bardzo wzmacnia wiarygodność analizy. Najprostsze rozwiązanie to niezależne zakodowanie przez drugą osobę losowej części odpowiedzi i podanie zgodności z kappą. Jeśli kodujesz sam(a), dołącz pełny klucz do aneksu i nazwij to ograniczeniem badania.
Jak zbudować klucz kategorii do pytania otwartego?
Przeczytaj kilkadziesiąt odpowiedzi, wypisz powtarzające się wątki i zgrupuj je w kilka do kilkunastu kategorii. Każdej nadaj kod, nazwę, definicję, przykład i regułę dla przypadków granicznych, a na końcu dodaj kategorię „inne”. Klucz sprawdź w pilotażu z drugą osobą, zanim zakodujesz wszystkie odpowiedzi.
Jak traktować puste odpowiedzi i „nie wiem” w pytaniu otwartym?
Puste pole to brak odpowiedzi, a nie kategoria, więc nie wliczaj go do mianownika odsetków. Podaj jednak, ile osób odpowiedziało. Odpowiedź „nic mnie nie zniechęca” jest merytoryczna i dostaje własny kod. Samo „nie wiem” albo kreskę możesz wyłączyć z analizy, podając ich liczbę.
Dlaczego kappa jest niska, choć koderzy zgadzają się w ponad 90% przypadków?
Przy rzadkich kategoriach koderzy zgadzają się głównie dlatego, że prawie zawsze wpisują „nie”, a kappa odejmuje tę zgodność przypadkową. Przykładowo 97.3% zgodności może iść w parze z κ = .69. Podaj obie liczby z przedziałem ufności i skomentuj niską precyzję w rzadkich kategoriach.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikBadania mieszane (mixed methods)
Trzy podstawowe schematy, cele łączenia metod, integracja na trzech poziomach, joint display i wzory opisu dla doktoratu, wniosku i artykułu.
Czytaj →Masz kilkaset odpowiedzi otwartych i nie wiesz, jak je policzyć?
Sprawdzimy klucz kategorii, policzymy zgodność koderów i odsetki z przedziałami ufności oraz wyjaśnimy wyniki tak, abyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Campbell, J. L., Quincy, C., Osserman, J., & Pedersen, O. K. (2013). Coding in-depth semistructured interviews: Problems of unitization and intercoder reliability and agreement. Sociological Methods & Research, 42(3), 294–320. https://doi.org/10.1177/0049124113500475
- Elo, S., & Kyngäs, H. (2008). The qualitative content analysis process. Journal of Advanced Nursing, 62(1), 107–115. https://doi.org/10.1111/j.1365-2648.2007.04569.x ● Otwarty dostęp
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-L
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- Hsieh, H.-F., & Shannon, S. E. (2005). Three approaches to qualitative content analysis. Qualitative Health Research, 15(9), 1277–1288. https://doi.org/10.1177/1049732305276687
- Krippendorff, K. (2004). Reliability in content analysis: Some common misconceptions and recommendations. Human Communication Research, 30(3), 411–433. https://doi.org/10.1111/j.1468-2958.2004.tb00738.x
- Lombard, M., Snyder-Duch, J., & Bracken, C. C. (2002). Content analysis in mass communication: Assessment and reporting of intercoder reliability. Human Communication Research, 28(4), 587–604. https://doi.org/10.1111/j.1468-2958.2002.tb00826.x
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031 ● Otwarty dostęp
- O’Connor, C., & Joffe, H. (2020). Intercoder reliability in qualitative research: Debates and practical guidelines. International Journal of Qualitative Methods, 19, Article 1609406919899220. https://doi.org/10.1177/1609406919899220 ● Otwarty dostęp
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
- Singer, E., & Couper, M. P. (2017). Some methodological uses of responses to open questions and other verbatim comments in quantitative surveys. Methods, Data, Analyses, 11(2), 115–134. https://doi.org/10.12758/mda.2017.01 ● Otwarty dostęp: pełny tekst
- Züll, C. (2016). Open-ended questions. GESIS – Leibniz Institute for the Social Sciences. https://doi.org/10.15465/gesis-sg_en_002 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{campbell2013coding, author={Campbell, John L. and Quincy, Charles and Osserman, Jordan and Pedersen, Ove K.}, title={{Coding in-depth semistructured interviews: Problems of unitization and intercoder reliability and agreement}}, journal={Sociological Methods \& Research}, year={2013}, volume={42}, number={3}, pages={294--320}, doi={10.1177/0049124113500475}}@article{elo2008qualitative, author={Elo, Satu and Kyngäs, Helvi}, title={{The qualitative content analysis process}}, journal={Journal of Advanced Nursing}, year={2008}, volume={62}, number={1}, pages={107--115}, doi={10.1111/j.1365-2648.2007.04569.x}}@article{feinstein1990high, author={Feinstein, Alvan R. and Cicchetti, Domenic V.}, title={{High agreement but low kappa: I. The problems of two paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={543--549}, doi={10.1016/0895-4356(90)90158-l}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{hsieh2005three, author={Hsieh, Hsiu-Fang and Shannon, Sarah E.}, title={{Three approaches to qualitative content analysis}}, journal={Qualitative Health Research}, year={2005}, volume={15}, number={9}, pages={1277--1288}, doi={10.1177/1049732305276687}}@article{krippendorff2004reliability, author={Krippendorff, Klaus}, title={{Reliability in content analysis: Some common misconceptions and recommendations}}, journal={Human Communication Research}, year={2004}, volume={30}, number={3}, pages={411--433}, doi={10.1111/j.1468-2958.2004.tb00738.x}}@article{lombard2002content, author={Lombard, Matthew and Snyder-Duch, Jennifer and Bracken, Cheryl Campanella}, title={{Content analysis in mass communication: Assessment and reporting of intercoder reliability}}, journal={Human Communication Research}, year={2002}, volume={28}, number={4}, pages={587--604}, doi={10.1111/j.1468-2958.2002.tb00826.x}}@article{mchugh2012interrater, author={McHugh, Mary L.}, title={{Interrater reliability: The kappa statistic}}, journal={Biochemia Medica}, year={2012}, volume={22}, number={3}, pages={276--282}, doi={10.11613/bm.2012.031}}@article{oconnor2020intercoder, author={O'Connor, Clíodhna and Joffe, Hélène}, title={{Intercoder reliability in qualitative research: Debates and practical guidelines}}, journal={International Journal of Qualitative Methods}, year={2020}, volume={19}, eid={1609406919899220}, doi={10.1177/1609406919899220}}@article{sim2005kappa, author={Sim, Julius and Wright, Chris C.}, title={{The kappa statistic in reliability studies: Use, interpretation, and sample size requirements}}, journal={Physical Therapy}, year={2005}, volume={85}, number={3}, pages={257--268}, doi={10.1093/ptj/85.3.257}}@article{singer2017some, author={Singer, Eleanor and Couper, Mick P.}, title={{Some methodological uses of responses to open questions and other verbatim comments in quantitative surveys}}, journal={Methods, Data, Analyses}, year={2017}, volume={11}, number={2}, pages={115--134}, doi={10.12758/mda.2017.01}}@techreport{zull2016open, author={Züll, Cornelia}, title={{Open-ended questions}}, year={2016}, institution={GESIS – Leibniz Institute for the Social Sciences}, doi={10.15465/gesis-sg_en_002}}