Kiedy test chi-kwadrat, a kiedy coś innego?
Test chi-kwadrat (χ²) Pearsona sprawdza, czy liczebności w kategoriach odbiegają od liczebności, których należałoby się spodziewać przy prawdziwej hipotezie zerowej. Pracuje na zmiennych jakościowych: na skali nominalnej (kierunek studiów, preferowana forma pomocy) albo na kilku kategoriach skali porządkowej. W pracach dyplomowych spotkasz dwie odmiany, które mają niemal identyczny wzór, ale odpowiadają na różne pytania (Franke i in., 2012):
- test zgodności (ang. goodness of fit) – jedna zmienna; czy rozkład odpowiedzi zgadza się z rozkładem zakładanym, np. równym albo znanym z populacji. Szczegóły: test chi-kwadrat zgodności;
- test niezależności – dwie zmienne w tabeli krzyżowej; czy rozkład jednej zależy od kategorii drugiej. Gdy porównujesz z góry ustalone grupy (np. kierunki studiów), ten sam rachunek nazywa się testem jednorodności. Definicję i wzory zebraliśmy w haśle chi-kwadrat – test niezależności.
Zanim zaczniesz, sprawdź trzy warunki. Po pierwsze, w komórkach są liczebności osób, a nie średnie, odsetki ani sumy punktów. Po drugie, każda osoba trafia do dokładnie jednej komórki – dlatego pytania wielokrotnego wyboru wymagają osobnych metod (zob. analiza pytań wielokrotnego wyboru). Po trzecie, obserwacje są niezależne: gdy te same osoby odpowiadają dwa razy (przed i po), użyj testu McNemara, a przy trzech lub więcej pomiarach zmiennej 0/1 – testu Q Cochrana. Gdy porównujesz grupy na zmiennej ilościowej albo porządkowej z wieloma poziomami, test χ² nie jest właściwy – sięgnij po testy rangowe z poradnika testy nieparametryczne krok po kroku. Jeżeli wahasz się między testami, zajrzyj do poradnika jak dobrać test statystyczny do hipotezy.
Badanie przykładowe
Przez cały wpis analizujemy jedno badanie ankietowe (dane symulowane). Wzięło w nim udział 300 osób studiujących: 120 z psychologii, 90 z pedagogiki i 90 z informatyki. Pytania brzmiały:
- „Gdybyś przeżywał(a) kryzys psychiczny, z jakiej formy pomocy psychologicznej skorzystał(a)byś najchętniej?” – stacjonarna, online, żadna;
- „Czy w ciągu ostatniego roku korzystałeś(-aś) z pomocy psychologa?” – tak, nie;
- tryb studiów – stacjonarne, niestacjonarne.
Hipotezy są trzy: (1) formy pomocy nie są wybierane równie często, (2) preferowana forma pomocy zależy od kierunku studiów, (3) osoby studiujące stacjonarnie częściej korzystały z pomocy psychologa. Dane możesz pobrać jako plik CSV (300 wierszy, 5 kolumn) i przeliczyć wszystko kodem z sekcji „Test chi-kwadrat w R”.
Krok 1. Test zgodności: czy wszystkie odpowiedzi są równie popularne?
Zacznij od jednej zmiennej. Pomoc stacjonarną wybrało 128 osób (42.7%), pomoc online 113 (37.7%), a 59 osób (19.7%) nie skorzystałoby z żadnej. Jeżeli wszystkie trzy odpowiedzi byłyby w populacji równie popularne, każdą powinno wskazać po 300/3 = 100 osób. To są liczebności oczekiwane (E), a liczby z ankiety to liczebności obserwowane (O). Statystyka testu sumuje kwadraty różnic podzielone przez liczebności oczekiwane:
W teście zgodności liczba stopni swobody to liczba kategorii minus 1, tu df = 2. Wynik χ²(2, N = 300) = 26.34, p < .001 oznacza, że trzy odpowiedzi nie są wybierane równie często. Wielkość odchylenia od rozkładu równomiernego opisuje w Cohena = √(χ²/N) = 0.30.
Rozkład oczekiwany nie musi być równy. Możesz porównać strukturę próby z danymi uczelni (np. 40% studentów stacjonarnych), ale proporcje musisz znać przed analizą i podać ich źródło. Pamiętaj też, że nieistotny test zgodności nie dowodzi, że próba jest reprezentatywna – świadczy tylko o tym, że nie wykryto różnicy w jednej zmiennej.
Krok 2. Tabela krzyżowa: odsetki w wierszach czy w kolumnach?
Hipoteza 2 dotyczy dwóch zmiennych, więc potrzebujesz tabeli krzyżowej 3 × 3. Same liczebności niewiele mówią, bo kierunki mają różną liczbę osób. Liczy się to, w którą stronę policzysz odsetki:
- odsetki w wierszach (każdy wiersz = 100%) odpowiadają na pytanie, jak rozkładają się odpowiedzi w każdym kierunku. To naturalny wybór, gdy wiersze są grupami porównywanymi w hipotezie;
- odsetki w kolumnach (każda kolumna = 100%) mówią, kim są osoby, które wybrały daną odpowiedź – np. jaki odsetek przeciwników pomocy studiuje informatykę.
| Kierunek | Stacjonarna n (% w wierszu) | Online n (% w wierszu) | Żadna n (% w wierszu) | Razem |
|---|---|---|---|---|
| Psychologia | 65 (54.2%) | 41 (34.2%) | 14 (11.7%) | 120 |
| Pedagogika | 42 (46.7%) | 29 (32.2%) | 19 (21.1%) | 90 |
| Informatyka | 21 (23.3%) | 43 (47.8%) | 26 (28.9%) | 90 |
| Razem | 128 (42.7%) | 113 (37.7%) | 59 (19.7%) | 300 |
| % w kolumnie: psychologia / pedagogika / informatyka | 50.8 / 32.8 / 16.4 | 36.3 / 25.7 / 38.1 | 23.7 / 32.2 / 44.1 | 40.0 / 30.0 / 30.0 |
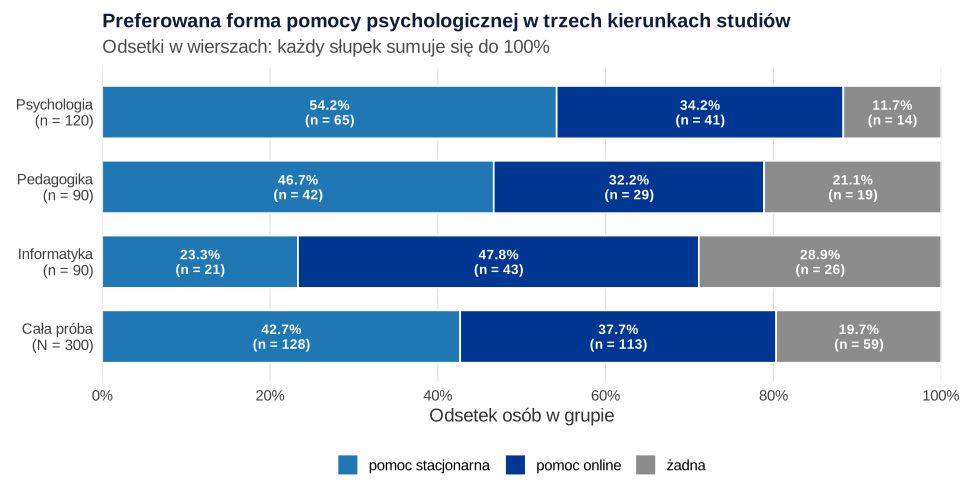
Odsetki w wierszach pokazują wyraźny wzór: pomoc stacjonarną wybiera ponad połowa osób z psychologii (54.2%) i niespełna jedna czwarta z informatyki (23.3%), a z żadnej formy nie skorzystałoby 11.7% studentów psychologii i 28.9% studentów informatyki. Odsetki w kolumnach mówią coś innego: wśród 59 osób, które odrzucają pomoc, 44.1% studiuje informatykę, choć informatycy to tylko 30.0% próby. Oba odczyty są poprawne, ale w tekście trzymaj się jednego kierunku – tego, który odpowiada hipotezie.
Odsetki w wierszach najlepiej pokazuje wykres słupkowy skumulowany do 100% (rysunek 1). Każdy słupek to jeden kierunek, a długość segmentu – odsetek odpowiedzi. Dodaj słupek „cała próba”: od razu widać, które kierunki odbiegają od średniego wzoru.
Krok 3. Liczebności oczekiwane i warunki testu
Liczebność oczekiwana komórki to liczba osób, jakiej należałoby się w niej spodziewać, gdyby zmienne były niezależne:
Dla komórki „psychologia – stacjonarna”: 120 × 128 / 300 = 51.2. Obserwujemy 65 osób, czyli o 13.8 więcej. Dla „informatyka – stacjonarna”: 90 × 128 / 300 = 38.4, a obserwujemy tylko 21. Pozostałe liczebności oczekiwane wynoszą od 17.7 do 45.2.
Liczebności oczekiwane decydują, czy możesz zaufać wartości p z testu χ². Statystyka ma rozkład χ² tylko w przybliżeniu, a przybliżenie słabnie przy małych liczebnościach. Kim (2017) przypomina popularną regułę: najwyżej 20% komórek może mieć liczebność oczekiwaną poniżej 5 i żadna nie może mieć poniżej 1. W naszej tabeli najmniejsza wartość to 17.7, więc warunek jest spełniony z zapasem.
Reguła jest zachowawcza. Camilli i Hopkins (1978) sprawdzili empirycznie wiele tabel 2 × 2 i stwierdzili, że test Pearsona jest bardzo odporny także przy małych liczebnościach oczekiwanych. Campbell (2007) po porównaniu siedmiu testów zaleca dla tabel 2 × 2 chi-kwadrat w wersji „N − 1” (zwykłe χ² pomnożone przez (N − 1)/N), gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a w przeciwnym razie test Fishera–Irwina. Co zrobić, gdy liczebności są naprawdę małe, pokazujemy w kroku 7.
Krok 4. Wynik testu niezależności
Wzór jest taki sam jak w teście zgodności, tylko sumujesz po wszystkich komórkach tabeli. Zmienia się liczba stopni swobody: df = (liczba wierszy − 1) × (liczba kolumn − 1) = 2 × 2 = 4. W przykładzie:
Odrzucasz hipotezę zerową o niezależności: preferowana forma pomocy wiąże się z kierunkiem studiów. Test ilorazu wiarygodności (G², w SPSS Likelihood Ratio) daje podobny wynik, G² = 24.67, p < .001. W pracy wystarczy chi-kwadrat Pearsona.
Tu wiele prac się kończy, a szkoda. Istotny wynik mówi tylko, że gdzieś w tabeli rozkład odbiega od niezależności. Nie mówi, w których komórkach, w którą stronę ani jak silny jest związek. Test nie jest też skierowany przeciw żadnej konkretnej hipotezie alternatywnej, przez co bywa mało czuły (Cochran, 1954). Dlatego potrzebujesz kroków 5 i 6.
Krok 5. Reszty standaryzowane skorygowane: która komórka „robi” wynik?
Sharpe (2015) porównał cztery sposoby szukania źródła istotnego wyniku χ²: analizę reszt, porównywanie komórek, „przeszukiwanie” tabeli i jej podział. Najprostsza i najczęściej używana jest analiza reszt, którą dla tabel krzyżowych opracował Haberman (1973). Skorygowana reszta standaryzowana (ang. adjusted standardized residual) to różnica O − E podzielona przez oszacowanie jej błędu standardowego (IBM Corp., b.d.-a):
Gdy zmienne są niezależne, reszty mają w przybliżeniu standardowy rozkład normalny. Reszta większa niż 1.96 co do wartości bezwzględnej oznacza komórkę z wyraźnie większą (znak +) albo mniejszą (znak −) liczbą osób niż przy niezależności. W tabeli 3 × 3 oglądasz jednak dziewięć reszt naraz, a to rodzina testów. Ostrożniejszy próg z korektą Bonferroniego to wartość z dla α = .05/9, czyli |r| > 2.77. Więcej o wyborze korekty piszemy w poradniku poprawki na wielokrotne porównania.
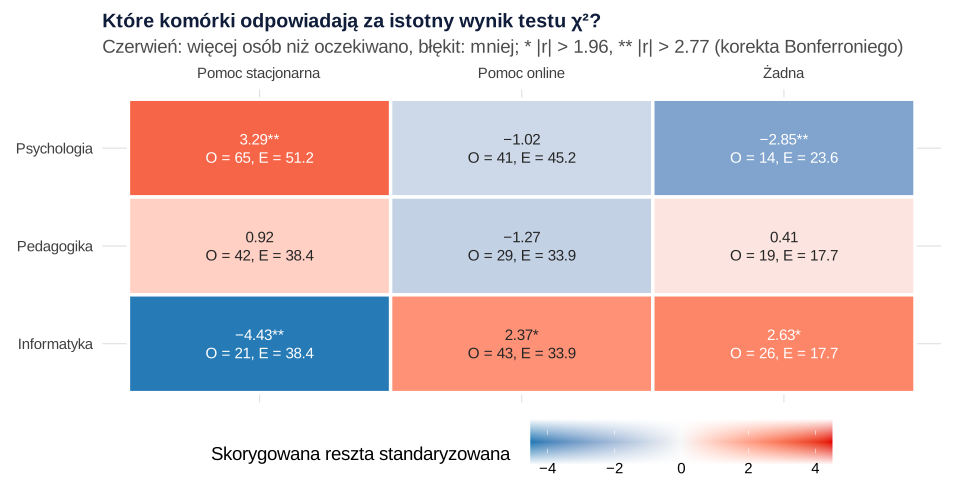
Rysunek 2 czyta się jak mapę. Wynik „robią” przede wszystkim dwa wiersze:
- psychologia: więcej osób niż oczekiwano wybiera pomoc stacjonarną (r = 3.29), a mniej odrzuca pomoc (r = −2.85). Obie reszty przekraczają próg 2.77;
- informatyka: znacznie mniej osób wybiera pomoc stacjonarną (r = −4.43, także po korekcie). Więcej osób wybiera pomoc online (r = 2.37) i nie wybiera żadnej (r = 2.63), ale te dwie reszty przekraczają tylko próg 1.96;
- pedagogika nie odbiega od wzoru całej próby (reszty od −1.27 do 0.92).
W pracy podaj, jakiego progu użyłeś(-aś). Nie myl skorygowanych reszt z resztami standaryzowanymi Pearsona, (O − E)/√E, które mają mniejszą wariancję i przy progu 1.96 rzadziej wskazują komórki.
Krok 6. Wielkość efektu: V Craméra i φ
Wartość χ² rośnie razem z N, więc nie mówi, jak silny jest związek. McHugh (2013) zaleca uzupełnienie istotnego testu miarą siły związku, najczęściej V Craméra. Tę opartą na χ² miarę zaproponował Cramér (1946):
W przykładzie V = √[23.38 / (300 × 2)] = .20, 95% CI [.10, .27]. Jak to ocenić? Progi zależą od wielkości tabeli. Kim (2017) podaje je osobno dla kolejnych stopni swobody; dla df = 1 to .10, .30 i .50 (efekt mały, średni, duży). Przy tabelach większych niż 2 × 2 te same wartości V oznaczają silniejszy związek, więc nie przykładaj automatycznie progów dla tabel 2 × 2. McHugh (2013) zwraca też uwagę, że V daje stosunkowo niskie wartości nawet przy bardzo istotnych wynikach. Wartość .20 przy wyraźnym wzorze reszt to w badaniach ankietowych związek umiarkowany, a nie „słaby, więc nieważny”.
W małych próbach V jest obciążone w górę. Bergsma (2013) zaproponował prostą korektę, która w symulacjach sprawdzała się lepiej od klasycznego V dla tabel większych niż 2 × 2. W przykładzie skorygowane V = .18, 95% CI [.06, .25]. Uwaga: pakiet effectsize (wersja 1.0.2) liczy domyślnie wersję skorygowaną, a SPSS – klasyczną. Napisz w pracy, którą podajesz.
Dla tabeli 2 × 2 V jest równe wartości bezwzględnej współczynnika φ. Szerzej o interpretacji efektów piszemy w poradniku wielkość efektu: interpretacja.
Tabela 2 × 2: φ, iloraz szans i poprawka Yatesa
Hipoteza 3 dotyczy dwóch zmiennych dwukategorialnych: trybu studiów i korzystania z pomocy psychologa w ostatnim roku. Z pomocy korzystało 54 z 212 osób studiujących stacjonarnie (25.5%) i 7 z 88 studiujących niestacjonarnie (8.0%). Najmniejsza liczebność oczekiwana wynosi 17.9.
| Test | Statystyka | p | Kiedy podać |
|---|---|---|---|
| χ² Pearsona (bez poprawki) | χ²(1) = 11.78 | < .001 | domyślnie |
| χ² „N − 1” | χ²(1) = 11.74 | < .001 | małe próby, najmniejsza E ≥ 1 (Campbell, 2007) |
| χ² z poprawką Yatesa | χ²(1) = 10.72 | .001 | tylko gdy wymaga tego promotor lub czasopismo |
| Test dokładny Fishera | – | < .001 | najmniejsza E < 1 albo bardzo mała próba |
Wszystkie wersje prowadzą do tego samego wniosku. Poprawka Yatesa zmniejsza χ² i podnosi p. Camilli i Hopkins (1978) pokazali jednak, że obniża ona trafność wartości p, gdy sumy brzegowe nie są ustalone z góry – a w ankietach prawie nigdy nie są. Funkcja chisq.test() w R stosuje poprawkę domyślnie dla tabel 2 × 2, więc dopisz correct = FALSE, jeśli chcesz zwykłego testu Pearsona. SPSS dla tabel 2 × 2 podaje wiersz Continuity Correction obok Pearson Chi-Square (IBM Corp., b.d.-b).
Siłę związku w tabeli 2 × 2 opisuje φ = .20, 95% CI [.08, .31] – tyle samo co V. Bardziej intuicyjny jest często iloraz szans: szansa skorzystania z pomocy wśród osób studiujących stacjonarnie to 54/158, a wśród niestacjonarnych 7/81, więc OR = 3.95, 95% CI [1.72, 9.08]. Szansa była więc prawie czterokrotnie większa. To nadal badanie przekrojowe: wynik nie dowodzi, że tryb studiów powoduje korzystanie z pomocy (np. osoby stacjonarne mogą mieć łatwiejszy dostęp do poradni uczelnianej). Różnicę 25.5% − 8.0% możesz też opisać jako różnicę proporcji z przedziałem ufności (zob. test dla dwóch proporcji).
Krok 7. Małe liczebności: kiedy test dokładny Fishera?
Przed właściwym badaniem przeprowadzono pilotaż na 30 osobach (19 stacjonarnych, 11 niestacjonarnych). Z pomocy psychologa korzystało 8 z 19 osób stacjonarnych (42.1%) i 1 z 11 niestacjonarnych (9.1%). Liczebności oczekiwane wynoszą 5.7, 13.3, 3.3 i 7.7, więc jedna komórka z czterech (25%) ma E < 5. Reguła 20% nie jest spełniona i R wyświetla ostrzeżenie Chi-squared approximation may be incorrect.
- χ² Pearsona: χ²(1, N = 30) = 3.62, p = .057;
- χ² „N − 1”: 3.495, p = .062;
- test dokładny Fishera: p = .100, OR = 6.86, 95% CI [0.70, 353.60].
Test Fishera nie korzysta z przybliżenia: liczy dokładne prawdopodobieństwo wszystkich tabel o tych samych sumach brzegowych. Kim (2017) przedstawia go jako test przeznaczony zwłaszcza dla małych prób. Zgodnie z regułą 20% w pilotażu podasz więc test Fishera. Wniosek jest jednak taki sam przy każdym teście: 30 osób nie wystarcza, żeby rozstrzygnąć tę hipotezę, co pokazuje też ogromny przedział ufności dla OR. Pilotaż służy do sprawdzenia narzędzia, a nie do testowania hipotez.
Czy test Fishera jest zawsze „bezpieczniejszy”? Rysunek 3 pokazuje, jak często cztery testy dają fałszywy alarm (błąd I rodzaju), gdy hipoteza zerowa jest prawdziwa. Policzyliśmy to dokładnie, sumując prawdopodobieństwa wszystkich możliwych tabel dla prób od 20 do 100 osób.
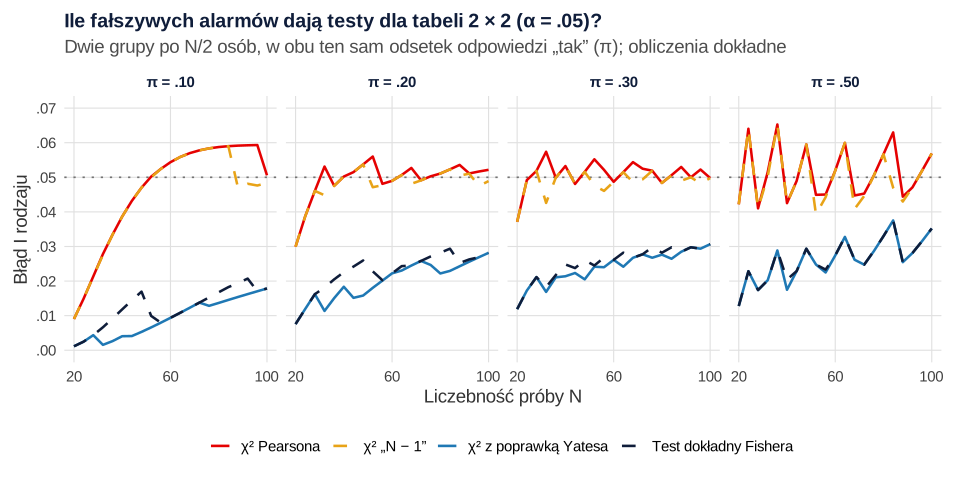
Wynik jest wyraźny. Chi-kwadrat Pearsona i wersja „N − 1” trzymają się blisko .05 (średnio .049 i .048), choć przy niektórych N przekraczają ten poziom, maksymalnie do .065. Poprawka Yatesa i test Fishera są wyraźnie zachowawcze (średnio .020 i .022). Rzadziej dają fałszywy alarm, ale też rzadziej wykrywają prawdziwy związek, czyli mają mniejszą moc. Przy bardzo małych próbach z rzadką odpowiedzią (N = 20, π = .10) zachowawcze są wszystkie testy. Praktyczna reguła: przy dużych liczebnościach oczekiwanych podaj χ² Pearsona, a test Fishera zostaw na sytuacje, w których przybliżenie naprawdę zawodzi.
Tabele większe niż 2 × 2
Przy tabelach 3 × 3, 4 × 3 i większych pamiętaj o kilku rzeczach:
- Wielkość efektu to V, nie φ. Kim (2017) zaleca φ i iloraz szans tylko dla tabel 2 × 2, a dla większych – V Craméra. φ liczone dla większej tabeli może nawet przekroczyć 1.
- Szukaj źródła wyniku w resztach, a nie w serii testów 2 × 2 na wszystkich parach kategorii. Jeśli jednak porównujesz pary (np. psychologia vs informatyka), skoryguj wartości p na liczbę porównań.
- Łączenie kategorii pomaga, gdy liczebności oczekiwane są za małe, np. „rok IV” i „rok V” w „lata IV–V”. Reguły łączenia ustal przed obejrzeniem wyników i opisz je w części metodologicznej. Łączenie „aż wyjdzie” to forma p-hackingu.
- Kategorie uporządkowane. Gdy obie zmienne są porządkowe (np. rok studiów i częstość korzystania z pomocy), zwykły test χ² ignoruje kolejność kategorii. Cochran (1954) pokazał, że dopasowanie testu do spodziewanego wzorca odchyleń daje test mocniejszy. W praktyce sprawdź trend testem liniowym (w SPSS Linear-by-Linear Association) albo korelacją Spearmana.
- Trzecia zmienna. Związek w tabeli łącznej może zniknąć albo odwrócić kierunek po podziale na podgrupy (paradoks Simpsona). Gdy chcesz kontrolować inne zmienne, wybierz regresję logistyczną.
Krok 8. Zapis wyników w stylu APA
W tekście podaj: nazwę testu, χ² ze stopniami swobody i N w nawiasie, dokładne p (albo p < .001), wielkość efektu z przedziałem ufności i odsetki, które pokazują kierunek związku. Odsetki zawsze uzupełnij liczebnościami albo podaj w tabeli liczebności grup. Gotowe opisy dla przykładu:
Przy kilku tabelach krzyżowych lepiej zebrać liczebności w tabeli APA, a w tekście podać tylko wynik testu. Tak może wyglądać tabela dla hipotezy 2:
Tabela 1
Preferowana forma pomocy psychologicznej w zależności od kierunku studiów
| Kierunek | Stacjonarna | Online | Żadna | |||
|---|---|---|---|---|---|---|
| n | % | n | % | n | % | |
| Psychologia (n = 120) | 65 | 54.2+ | 41 | 34.2 | 14 | 11.7− |
| Pedagogika (n = 90) | 42 | 46.7 | 29 | 32.2 | 19 | 21.1 |
| Informatyka (n = 90) | 21 | 23.3− | 43 | 47.8 | 26 | 28.9 |
| Razem (N = 300) | 128 | 42.7 | 113 | 37.7 | 59 | 19.7 |
Uwaga. Odsetki obliczono w wierszach. χ²(4, N = 300) = 23.38, p < .001, V = .20, 95% CI [.10, .27]. Indeksy oznaczają skorygowane reszty standaryzowane większe (+) lub mniejsze (−) od ±2.77 (α = .05 z korektą Bonferroniego dla 9 komórek). Dane symulowane.
Zdania do innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA, a wzory tabel – w zestawieniu tabele APA: wzory i przykłady.
Test chi-kwadrat w SPSS
W SPSS test niezależności wykonasz w oknie Analyze → Descriptive Statistics → Crosstabs... Zmienną z grupami (kierunek) wstaw do Row(s), a zmienną z odpowiedziami do Column(s). Dalej:
- W oknie Statistics zaznacz Chi-square oraz, w grupie Nominal, opcję Phi and Cramer's V (IBM Corp., b.d.-b).
- W oknie Cells zaznacz liczebności Observed i Expected, odsetki Row (albo Column, zależnie od hipotezy) i reszty Adjusted standardized (IBM Corp., b.d.-a).
- Dla tabeli 2 × 2 opcja Chi-square daje chi-kwadrat Pearsona, iloraz wiarygodności, chi-kwadrat z poprawką Yatesa (Continuity Correction) i – gdy któraś komórka ma liczebność oczekiwaną poniżej 5 – test dokładny Fishera (IBM Corp., b.d.-b). Czytaj wiersz Pearson Chi-Square, chyba że liczebności oczekiwane są za małe.
Test zgodności dla jednej zmiennej wykonasz w oknie Chi-Square Test z grupy Analyze → Nonparametric Tests → Legacy Dialogs (IBM Corp., b.d.-c). Jak przepisać pozostałe tabele wydruku, pokazujemy w poradniku jak czytać wyniki z SPSS.
Test chi-kwadrat w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepisy 2 i 3 korzystają z obiektu dane z przepisu 1. Zamiast losować dane, możesz wczytać plik CSV: dane <- read.csv("chi-kwadrat-dane-przyklad.csv", stringsAsFactors = TRUE) – wtedy ustaw kolejność kategorii funkcją factor(…, levels = …) tak jak w przepisie 1.
1. Dane i test zgodności
R
# Badanie przykładowe (dane symulowane): 300 osób studiujących psychologię, pedagogikę i informatykę
# odpowiada, z jakiej formy pomocy psychologicznej skorzystałaby w kryzysie, i czy w ostatnim roku
# korzystała z pomocy psychologa. Zmienne: kierunek, forma (stacjonarna / online / żadna),
# tryb studiów (stacjonarne / niestacjonarne) i pomoc_rok (tak / nie).
set.seed(146)
kierunek <- factor(rep(c("psychologia", "pedagogika", "informatyka"), c(120, 90, 90)),
                   levels = c("psychologia", "pedagogika", "informatyka"))
p_forma <- list(psychologia = c(.50, .36, .14), pedagogika = c(.44, .36, .20), informatyka = c(.24, .46, .30))
forma <- factor(sapply(kierunek, function(k) sample(c("stacjonarna", "online", "żadna"), 1, prob = p_forma[[k]])),
                levels = c("stacjonarna", "online", "żadna"))
tryb <- factor(sample(c("stacjonarne", "niestacjonarne"), 300, replace = TRUE, prob = c(.7, .3)),
               levels = c("stacjonarne", "niestacjonarne"))
pomoc_rok <- factor(ifelse(runif(300) < ifelse(tryb == "stacjonarne", .26, .13), "tak", "nie"), levels = c("tak", "nie"))
dane <- data.frame(id = 1:300, kierunek, tryb, forma, pomoc_rok)
str(dane)

# Krok 1. Test zgodności: czy trzy odpowiedzi są wybierane równie często?
table(dane$forma)
round(100 * prop.table(table(dane$forma)), 1)
zgodnosc <- chisq.test(table(dane$forma), p = c(1, 1, 1) / 3)
zgodnosc
zgodnosc$expected
w_cohena <- sqrt(unname(zgodnosc$statistic) / nrow(dane))      # w = √(χ² / N)
round(w_cohena, 2)
Wynik w R
'data.frame':	300 obs. of  5 variables:
 $ id       : int  1 2 3 4 5 6 7 8 9 10 ...
 $ kierunek : Factor w/ 3 levels "psychologia",..: 1 1 1 1 1 1 1 1 1 1 ...
 $ tryb     : Factor w/ 2 levels "stacjonarne",..: 1 1 1 2 1 1 2 1 1 1 ...
 $ forma    : Factor w/ 3 levels "stacjonarna",..: 1 2 1 2 1 2 1 1 2 2 ...
 $ pomoc_rok: Factor w/ 2 levels "tak","nie": 2 1 2 2 2 2 2 1 1 1 ...

stacjonarna      online       żadna
        128         113          59

stacjonarna      online       żadna
       42.7        37.7        19.7

	Chi-squared test for given probabilities

data:  table(dane$forma)
X-squared = 26.34, df = 2, p-value = 1.907e-06

stacjonarna      online       żadna
        100         100         100
[1] 0.3
2. Tabela krzyżowa 3 × 3, reszty i V Craméra
R
# Krok 2–5. Test niezależności 3 × 3: kierunek studiów a preferowana forma pomocy (obiekt dane z b46-1-dane.R)
tab <- table(dane$kierunek, dane$forma, dnn = c("kierunek", "forma"))
addmargins(tab)
round(100 * prop.table(tab, 1), 1)          # odsetki w wierszach: struktura odpowiedzi w każdym kierunku
round(100 * prop.table(tab, 2), 1)          # odsetki w kolumnach: skład kierunków wśród wybierających daną formę

test <- chisq.test(tab)
round(test$expected, 1)                     # liczebności oczekiwane: suma wiersza × suma kolumny / N
c(min_oczekiwana = round(min(test$expected), 1), odsetek_ponizej_5 = mean(test$expected < 5))
test

# Skorygowane reszty standaryzowane (adjusted standardized residuals): |r| > 1.96, a po korekcie Bonferroniego
# dla 9 komórek |r| > 2.77
round(test$stdres, 2)
round(qnorm(1 - .05 / (2 * length(tab))), 2)
round(2 * pnorm(-abs(test$stdres)), 4)      # p dla każdej komórki (bez korekty)

# Wielkość efektu: V Craméra z 95% CI i wersja z korektą obciążenia (Bergsma, 2013)
library(effectsize)
cramers_v(tab, adjust = FALSE, alternative = "two.sided")  # klasyczne V (jak w SPSS)
cramers_v(tab, adjust = TRUE, alternative = "two.sided")   # V z korektą obciążenia
round(sqrt(unname(test$statistic) / (sum(tab) * (min(dim(tab)) - 1))), 3)   # V ze wzoru

# Test ilorazu wiarygodności (G²) dla porównania z SPSS (Likelihood Ratio)
G2 <- 2 * sum(tab * log(tab / test$expected))
cat("G2 =", round(G2, 2), " df = 4  p =", format.pval(pchisq(G2, 4, lower.tail = FALSE), digits = 3), "\n")
Wynik w R
             forma
kierunek      stacjonarna online żadna Sum
  psychologia          65     41    14 120
  pedagogika           42     29    19  90
  informatyka          21     43    26  90
  Sum                 128    113    59 300
             forma
kierunek      stacjonarna online żadna
  psychologia        54.2   34.2  11.7
  pedagogika         46.7   32.2  21.1
  informatyka        23.3   47.8  28.9
             forma
kierunek      stacjonarna online żadna
  psychologia        50.8   36.3  23.7
  pedagogika         32.8   25.7  32.2
  informatyka        16.4   38.1  44.1
             forma
kierunek      stacjonarna online żadna
  psychologia        51.2   45.2  23.6
  pedagogika         38.4   33.9  17.7
  informatyka        38.4   33.9  17.7
   min_oczekiwana odsetek_ponizej_5
             17.7               0.0

	Pearson's Chi-squared test

data:  tab
X-squared = 23.375, df = 4, p-value = 0.0001065

             forma
kierunek      stacjonarna online żadna
  psychologia        3.29  -1.02 -2.85
  pedagogika         0.92  -1.27  0.41
  informatyka       -4.43   2.37  2.63
[1] 2.77
             forma
kierunek      stacjonarna online  żadna
  psychologia      0.0010 0.3070 0.0044
  pedagogika       0.3591 0.2026 0.6803
  informatyka      0.0000 0.0180 0.0085
Cramer's V |       95% CI
-------------------------
0.20       | [0.10, 0.27]
Cramer's V (adj.) |       95% CI
--------------------------------
0.18              | [0.06, 0.25]
[1] 0.197
G2 = 24.67  df = 4  p = 5.87e-05
3. Tabela 2 × 2: cztery wersje testu, φ i iloraz szans
R
# Tabela 2 × 2: tryb studiów a korzystanie z pomocy psychologa w ostatnim roku (obiekt dane z b46-1-dane.R)
t22 <- table(dane$tryb, dane$pomoc_rok, dnn = c("tryb", "pomoc_rok"))
addmargins(t22)
round(100 * prop.table(t22, 1), 1)
t22_test <- chisq.test(t22, correct = FALSE)          # Pearson bez poprawki
round(t22_test$expected, 1)
t22_test
chisq.test(t22)                                        # z poprawką Yatesa (domyślnie w R dla 2 × 2)
N <- sum(t22)
chi_n1 <- unname(t22_test$statistic) * (N - 1) / N    # chi-kwadrat „N − 1” (Campbell, 2007)
c(chi_N1 = round(chi_n1, 2), p = round(pchisq(chi_n1, 1, lower.tail = FALSE), 4))
fisher.test(t22)                                       # dokładny test Fishera (OR warunkowy)

# Wielkość efektu: phi ze znakiem (kolejność kategorii jak w tabeli) i iloraz szans z próby z 95% CI (Wald)
library(effectsize)
phi(t22, adjust = FALSE, alternative = "two.sided")
a <- t22[1, 1]; b <- t22[1, 2]; c_ <- t22[2, 1]; d <- t22[2, 2]
round((a * d - b * c_) / sqrt(prod(rowSums(t22)) * prod(colSums(t22))), 3)   # phi ze wzoru
OR <- (a * d) / (b * c_)
se_log <- sqrt(1 / a + 1 / b + 1 / c_ + 1 / d)
round(c(OR = OR, dolna = exp(log(OR) - 1.96 * se_log), gorna = exp(log(OR) + 1.96 * se_log)), 2)
Wynik w R
                pomoc_rok
tryb             tak nie Sum
  stacjonarne     54 158 212
  niestacjonarne   7  81  88
  Sum             61 239 300
                pomoc_rok
tryb              tak  nie
  stacjonarne    25.5 74.5
  niestacjonarne  8.0 92.0
                pomoc_rok
tryb              tak   nie
  stacjonarne    43.1 168.9
  niestacjonarne 17.9  70.1

	Pearson's Chi-squared test

data:  t22
X-squared = 11.78, df = 1, p-value = 0.0005988


	Pearson's Chi-squared test with Yates' continuity correction

data:  t22
X-squared = 10.723, df = 1, p-value = 0.001058

 chi_N1       p
11.7400  0.0006

	Fisher's Exact Test for Count Data

data:  t22
p-value = 0.0004487
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
  1.68410 10.73141
sample estimates:
odds ratio
   3.93987

Phi  |       95% CI
-------------------
0.20 | [0.08, 0.31]
[1] 0.198
   OR dolna gorna
 3.95  1.72  9.08
4. Pilotaż: test dokładny Fishera
R
# Pilotaż (dane symulowane): 30 osób, to samo pytanie co w tabeli 2 × 2 – małe liczebności oczekiwane
set.seed(1)
pilotaz <- data.frame(tryb = factor(rep(c("stacjonarne", "niestacjonarne"), c(19, 11)),
                                    levels = c("stacjonarne", "niestacjonarne")))
pilotaz$pomoc_rok <- factor(ifelse(runif(30) < ifelse(pilotaz$tryb == "stacjonarne", .40, .08), "tak", "nie"),
                            levels = c("tak", "nie"))
tp <- table(pilotaz$tryb, pilotaz$pomoc_rok, dnn = c("tryb", "pomoc_rok"))
addmargins(tp)
round(100 * prop.table(tp, 1), 1)
oczek <- suppressWarnings(chisq.test(tp, correct = FALSE))$expected
round(oczek, 2)
c(komorki_ponizej_5 = sum(oczek < 5), odsetek = mean(oczek < 5))
chisq.test(tp, correct = FALSE)                         # R ostrzega: przybliżenie może być niedokładne
fisher.test(tp)
chi_p <- unname(suppressWarnings(chisq.test(tp, correct = FALSE))$statistic)
round(c(chi_N1 = chi_p * 29 / 30, p = pchisq(chi_p * 29 / 30, 1, lower.tail = FALSE)), 3)   # „N − 1”: (N − 1) / N × χ²
Wynik w R
                pomoc_rok
tryb             tak nie Sum
  stacjonarne      8  11  19
  niestacjonarne   1  10  11
  Sum              9  21  30
                pomoc_rok
tryb              tak  nie
  stacjonarne    42.1 57.9
  niestacjonarne  9.1 90.9
                pomoc_rok
tryb             tak  nie
  stacjonarne    5.7 13.3
  niestacjonarne 3.3  7.7
komorki_ponizej_5           odsetek
             1.00              0.25

	Pearson's Chi-squared test

data:  tp
X-squared = 3.6159, df = 1, p-value = 0.05723


	Fisher's Exact Test for Count Data

data:  tp
p-value = 0.1
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
   0.6998328 353.6003058
sample estimates:
odds ratio
  6.858745

chi_N1      p
 3.495  0.062
Warning message:
In chisq.test(tp, correct = FALSE) :
  Chi-squared approximation may be incorrect
5. Błąd I rodzaju czterech testów dla tabeli 2 × 2
R
# Jak często cztery testy dla tabeli 2 × 2 dają fałszywy alarm (α = .05), gdy H0 jest prawdziwa?
# Dwie grupy po N/2 osób, w obu ten sam odsetek odpowiedzi „tak” (π). Liczymy dokładnie, a nie symulacją:
# sumujemy prawdopodobieństwa dwumianowe wszystkich możliwych tabel, w których test odrzuca H0.
blad_I <- function(N, pi, alfa = .05) {
  n <- N / 2
  wynik <- c(Pearson = 0, Yates = 0, N_minus_1 = 0, Fisher = 0)
  for (x1 in 0:n) for (x2 in 0:n) {
    pr <- dbinom(x1, n, pi) * dbinom(x2, n, pi)
    m <- matrix(c(x1, n - x1, x2, n - x2), 2, byrow = TRUE)
    if (sum(m[, 1]) == 0 || sum(m[, 2]) == 0) next          # tabela bez jednej z odpowiedzi: brak testu
    E <- outer(rowSums(m), colSums(m)) / N
    chi <- sum((m - E)^2 / E)
    yates <- sum(pmax(abs(m - E) - .5, 0)^2 / E)
    p <- c(pchisq(chi, 1, lower.tail = FALSE), pchisq(yates, 1, lower.tail = FALSE),
           pchisq(chi * (N - 1) / N, 1, lower.tail = FALSE), fisher.test(m)$p.value)
    wynik <- wynik + pr * (p < alfa)
  }
  c(N = N, pi = pi, oczekiwana_tak = N / 2 * pi, wynik)
}
siatka <- expand.grid(N = seq(20, 100, by = 4), pi = c(.10, .20, .30, .50))
bledy <- as.data.frame(t(mapply(blad_I, siatka$N, siatka$pi)))
bledy[bledy$N %in% c(20, 40, 60, 100), ] |> transform(Pearson = round(Pearson, 3), Yates = round(Yates, 3),
                                                      N_minus_1 = round(N_minus_1, 3), Fisher = round(Fisher, 3))
# Średni błąd I rodzaju w całej siatce
round(colMeans(bledy[, c("Pearson", "Yates", "N_minus_1", "Fisher")]), 3)
# Największe przekroczenie α = .05
round(sapply(bledy[, c("Pearson", "Yates", "N_minus_1", "Fisher")], max), 3)
Wynik w R
     N  pi oczekiwana_tak Pearson Yates N_minus_1 Fisher
1   20 0.1              1   0.009 0.001     0.009  0.001
6   40 0.1              2   0.039 0.004     0.039  0.012
11  60 0.1              3   0.054 0.009     0.054  0.009
21 100 0.1              5   0.051 0.018     0.048  0.018
22  20 0.2              2   0.030 0.008     0.030  0.008
27  40 0.2              4   0.050 0.018     0.050  0.023
32  60 0.2              6   0.049 0.022     0.049  0.022
42 100 0.2             10   0.052 0.028     0.049  0.028
43  20 0.3              3   0.037 0.012     0.037  0.012
48  40 0.3              6   0.053 0.021     0.053  0.025
53  60 0.3              9   0.049 0.026     0.049  0.026
63 100 0.3             15   0.050 0.031     0.050  0.031
64  20 0.5              5   0.042 0.013     0.042  0.013
69  40 0.5             10   0.043 0.017     0.043  0.020
74  60 0.5             15   0.052 0.027     0.052  0.027
84 100 0.5             25   0.057 0.035     0.057  0.035
  Pearson     Yates N_minus_1    Fisher
    0.049     0.020     0.048     0.022
  Pearson     Yates N_minus_1    Fisher
    0.065     0.038     0.065     0.038
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats, w tym chisq.test() i fisher.test()); V Craméra i φ z przedziałami ufności policzono w pakiecie effectsize, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Test χ² na odsetkach albo średnich. Wzór działa tylko na liczebnościach. Wpisanie 54.2 zamiast 65 zmienia wynik, bo zmienia się N.
- Ta sama osoba w kilku komórkach. Pytania wielokrotnego wyboru i pomiary powtarzane łamią założenie niezależności.
- Sam wynik testu bez kierunku. „Wykazano istotny związek, χ²(4) = 23.38” nic nie mówi o tym, kto wybiera którą formę. Dodaj odsetki, reszty i V.
- Odsetki w niewłaściwym kierunku. Gdy porównujesz kierunki studiów, licz odsetki w obrębie kierunków. Odsetek „żadna pomoc” wśród informatyków (28.9%) to coś innego niż odsetek informatyków wśród osób odrzucających pomoc (44.1%).
- Automatyczna poprawka Yatesa. R stosuje ją domyślnie dla tabel 2 × 2. Jeśli raportujesz χ² Pearsona, wyłącz poprawkę i napisz, którą wersję podajesz.
- Test Fishera „dla bezpieczeństwa” przy dużej próbie. Test jest zachowawczy (rysunek 3), więc traci moc. Sięgnij po niego, gdy liczebności oczekiwane są naprawdę małe.
- Interpretacja V progami dla tabel 2 × 2 przy większej tabeli i brak informacji, czy V jest skorygowane.
- Wnioski przyczynowe z badania przekrojowego. Tabela krzyżowa pokazuje współwystępowanie, nie przyczynę (zob. korelacja a przyczynowość).
Jeśli nie wiesz, czy Twoje dane spełniają warunki testu albo jak opisać wynik dla większej tabeli, możemy sprawdzić analizę i wyjaśnić ją krok po kroku w ramach analiz statystycznych dla studentów. Rozumieć i bronić wyników musisz jednak samodzielnie.
Najczęstsze pytania
Jak wykonać test chi-kwadrat krok po kroku w pracy dyplomowej?
Ułóż tabelę krzyżową z liczebnościami osób, policz odsetki w wierszach (gdy wiersze to porównywane grupy) i sprawdź liczebności oczekiwane – najwyżej 20% komórek może mieć E < 5. Potem odczytaj χ², df i p, wskaż komórki o dużych skorygowanych resztach standaryzowanych i podaj V Craméra z 95% CI. Na końcu opisz kierunek związku odsetkami, np. „pomoc stacjonarną wybrało 54.2% osób z psychologii i 23.3% z informatyki”.
Odsetki w wierszach czy w kolumnach – jak liczyć procenty w tabeli krzyżowej?
Licz odsetki w obrębie grup, które porównujesz w hipotezie. Jeśli wiersze to kierunki studiów, każdy wiersz powinien sumować się do 100%: wtedy widać, jak rozkładają się odpowiedzi w każdym kierunku. Odsetki w kolumnach odpowiadają na inne pytanie – kim są osoby, które wybrały daną odpowiedź – i łatwo je źle zinterpretować.
Co zrobić po istotnym wyniku testu chi-kwadrat dla tabeli 3 × 3?
Sprawdź skorygowane reszty standaryzowane (w SPSS Adjusted standardized, w R chisq.test()$stdres). Komórki z resztą powyżej 1.96 co do wartości bezwzględnej mają więcej (+) lub mniej (−) osób niż przy niezależności; przy dziewięciu komórkach ostrożniejszy jest próg 2.77 z korektą Bonferroniego. Uzupełnij to V Craméra i odsetkami.
Czy dla tabeli 2 × 2 wybrać chi-kwadrat z poprawką Yatesa czy test Fishera?
Przy liczebnościach oczekiwanych co najmniej 5 podaj zwykły chi-kwadrat Pearsona – poprawka Yatesa i test Fishera są wtedy wyraźnie zachowawcze: w naszym rachunku dawały średnio około 2% fałszywych alarmów zamiast 5%. Test Fishera wybierz przy bardzo małych liczebnościach oczekiwanych, np. w pilotażu na 30 osobach. Pamiętaj, że chisq.test() w R domyślnie stosuje poprawkę Yatesa.
Jak przedstawić wynik testu chi-kwadrat na wykresie?
Najczytelniejszy jest skumulowany wykres słupkowy do 100%: jeden słupek na grupę, segmenty to odsetki odpowiedzi, a etykiety pokazują procent i liczebność. Dodaj słupek dla całej próby jako punkt odniesienia. Nie używaj wykresów kołowych ani 3D, a źródło wyniku pokaż osobno, np. mapą skorygowanych reszt.
Czy test chi-kwadrat można policzyć na procentach?
Nie. Wzór działa tylko na liczebnościach osób, bo wielkość statystyki zależy od N. Wpisanie 54.2 zamiast 65 zmienia sumę obserwacji i daje błędny wynik. Odsetki podawaj w opisie i tabeli, ale test licz zawsze na liczebnościach.
Powiązane hasła
Przeczytaj też
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Masz tabelę krzyżową i nie wiesz, jak ją opisać?
Sprawdzimy warunki testu, policzymy reszty i wielkość efektu, a potem wyjaśnimy wynik tak, żebyś umiał(a) go opisać w pracy i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bergsma, W. (2013). A bias-correction for Cramér’s V and Tschuprow’s T. Journal of the Korean Statistical Society, 42(3), 323–328. https://doi.org/10.1016/j.jkss.2012.10.002
- Camilli, G., & Hopkins, K. D. (1978). Applicability of chi-square to 2 × 2 contingency tables with small expected cell frequencies. Psychological Bulletin, 85(1), 163–167. https://doi.org/10.1037/0033-2909.85.1.163
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press. https://doi.org/10.1515/9781400883868
- Franke, T. M., Ho, T., & Christie, C. A. (2012). The chi-square test: Often used and more often misinterpreted. American Journal of Evaluation, 33(3), 448–458. https://doi.org/10.1177/1098214011426594
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- IBM Corp. (b.d.-a). Crosstabs cell display. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-cell-display ● Otwarty dostęp
- IBM Corp. (b.d.-b). Crosstabs statistics. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-statistics ● Otwarty dostęp
- IBM Corp. (b.d.-c). Legacy dialogs (nonparametric tests). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-legacy-dialogs-nonparametric ● Otwarty dostęp
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018 ● Otwarty dostęp
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bergsma2013bias, author={Bergsma, Wicher}, title={{A bias-correction for Cramér’s V and Tschuprow’s T}}, journal={Journal of the Korean Statistical Society}, year={2013}, volume={42}, number={3}, pages={323--328}, doi={10.1016/j.jkss.2012.10.002}}@article{camilli1978applicability, author={Camilli, Gregory and Hopkins, Kenneth D.}, title={{Applicability of chi-square to 2 × 2 contingency tables with small expected cell frequencies}}, journal={Psychological Bulletin}, year={1978}, volume={85}, number={1}, pages={163--167}, doi={10.1037/0033-2909.85.1.163}}@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{cochran1954some, author={Cochran, William G.}, title={{Some methods for strengthening the common χ² tests}}, journal={Biometrics}, year={1954}, volume={10}, number={4}, pages={417--451}, doi={10.2307/3001616}}@book{cramer1946mathematical, author={Cramér, Harald}, title={{Mathematical methods of statistics}}, year={1946}, publisher={Princeton University Press}, doi={10.1515/9781400883868}}@article{franke2012chi, author={Franke, Todd Michael and Ho, Timothy and Christie, Christina A.}, title={{The chi-square test: Often used and more often misinterpreted}}, journal={American Journal of Evaluation}, year={2012}, volume={33}, number={3}, pages={448--458}, doi={10.1177/1098214011426594}}@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@misc{ibmndcrosstabscells, author={{IBM Corp.}}, title={{Crosstabs cell display}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-cell-display}}@misc{ibmndcrosstabs, author={{IBM Corp.}}, title={{Crosstabs statistics}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-statistics}}@misc{ibmndnonparlegacy, author={{IBM Corp.}}, title={{Legacy dialogs (nonparametric tests)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-legacy-dialogs-nonparametric}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{mchugh2013chi, author={McHugh, Mary L.}, title={{The chi-square test of independence}}, journal={Biochemia Medica}, year={2013}, volume={23}, number={2}, pages={143--149}, doi={10.11613/bm.2013.018}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}