Test chi-kwadrat – zadania z rozwiązaniami: jak korzystać ze zbioru
Ten wpis to test chi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami w formie, w jakiej pojawiają się na kolokwium i egzaminie ze statystyki. Znajdziesz tu dziesięć ćwiczeń: dwa testy zgodności, tabele 2 × 3 i 3 × 3, procenty w wierszach i kolumnach, reszty skorygowane, φ i V Craméra, poprawkę Yatesa, małe liczności, test trendu Cochrana–Armitage’a i paradoks Simpsona.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku, interpretację w stylu APA i typowy błąd. Wszystko policzysz kalkulatorem, a każdą liczbę sprawdziliśmy w R (kod na końcu wpisu). Wartości krytyczne odczytasz z tablic rozkładów t, χ² i F.
Cały test na jednym przykładzie omawia poradnik test chi-kwadrat krok po kroku; tu są inne dane do przećwiczenia.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | cztery wersje opakowania napoju | test zgodności z rozkładem jednostajnym |
| 2 | miejsce zamieszkania w ankiecie online | test zgodności z rozkładem zadanym, reszty |
| 3 | korepetycje a typ szkoły | tabela 2 × 3: E, df, χ², V |
| 4 | płeć a aplikacja do medytacji | procenty w wierszach czy w kolumnach |
| 5 | wiek a źródło wiadomości | tabela 3 × 3, reszty skorygowane |
| 6 | dyżur nocny a błędy w dokumentacji | φ ze wzoru, znak φ, χ² a liczebność |
| 7 | SMS a zgłoszenie na szczepienie | poprawka Yatesa, wersja N − 1, Fisher |
| 8 | kanał rekrutacji a ukończenie pilotażu | małe liczności: Fisher–Freeman–Halton, łączenie kategorii |
| 9 | nadgodziny a wypalenie | test trendu Cochrana–Armitage’a |
| 10 | powikłania w dwóch szpitalach | paradoks Simpsona, test CMH |
Dane do wszystkich zadań możesz pobrać w jednym pliku: chi-kwadrat-zadania-dane.csv (jeden wiersz to jedna osoba; kolumny zmienna_1, zmienna_2 i warstwa).
We wszystkich zadaniach O to liczność obserwowana, a E – liczność oczekiwana przy prawdziwej hipotezie zerowej. W tabeli krzyżowej liczysz ją ze wzoru E = suma wiersza × suma kolumny / N.
Zadanie 1. Test zgodności z rozkładem jednostajnym
Treść zadania
W teście konsumenckim 160 osób wybrało jedną z czterech wersji opakowania napoju, pokazanych w losowej kolejności. Wersję A wybrały 52 osoby, B – 38, C – 41, D – 29. Czy któraś wersja jest wybierana częściej, niż wynikałoby z przypadku (α = .05)?
Rozwiązanie krok po kroku
Krok 1. Hipotezy. H0: każdą wersję wybiera 1/4 osób. H1: odsetki nie są równe.
Krok 2. Liczności oczekiwane. E = 160 / 4 = 40 dla każdej wersji.
Krok 3. Decyzja. Stopnie swobody w teście zgodności to liczba kategorii minus 1: df = 4 − 1 = 3. Wartość krytyczna χ²kryt(3) = 7.81. Ponieważ 6.75 < 7.81, nie odrzucasz H0; dokładnie p = .080.
Interpretacja
Nieistotny wynik nie dowodzi, że wersje są równie popularne – przy 160 osobach test mógł nie wykryć realnej przewagi. Więcej: test chi-kwadrat zgodności.
Typowy błąd
Liczenie testu na procentach zamiast na licznościach. Te same odsetki potraktowane jak liczby osób (32.5, 23.75, 25.625, 18.125) dają χ² = 4.22 i p = .239 – wynik zależałby od umownej podstawy 100. Test χ² liczysz zawsze na licznościach.
Zadanie 2. Test zgodności z rozkładem zadanym: struktura próby
Treść zadania
Ankietę internetową o korzystaniu z transportu publicznego wypełniło 400 dorosłych osób: 112 mieszkańców wsi, 128 mieszkańców miast do 100 tys. i 160 mieszkańców miast powyżej 100 tys. Przyjmij, że w populacji te grupy stanowią 40%, 30% i 30% (liczby wymyślone na potrzeby zadania, a nie dane urzędowe). Czy struktura próby odpowiada strukturze odniesienia?
Rozwiązanie krok po kroku
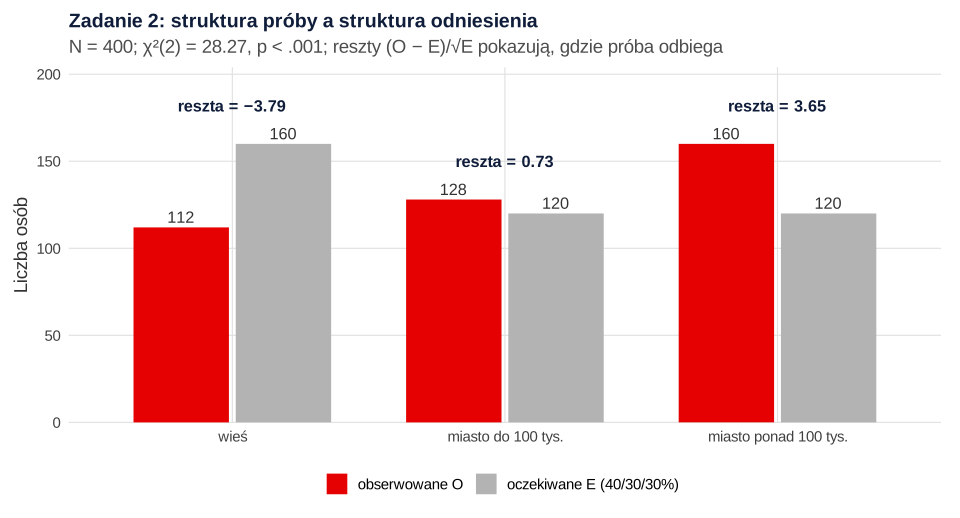
Krok 1. Liczności oczekiwane to N × odsetek z populacji: 400 × 0.40 = 160, 400 × 0.30 = 120 i 120.
Krok 2. Decyzja. χ²kryt(2) = 5.99; 28.27 jest dużo większe, p < .001.
Krok 3. Gdzie próba odbiega? Policz reszty standaryzowane (O − E) / √E: wieś −3.79, małe miasta 0.73, duże miasta 3.65. Wielkość efektu w Cohena = √(χ² / N) = √(28.27 / 400) = 0.27.
Interpretacja
Cochran (1952) w klasycznym przeglądzie testu zgodności omawia m.in. minimalne liczności oczekiwane w kategoriach – tu wszystkie E wynoszą co najmniej 120, więc przybliżenie rozkładem χ² nie budzi wątpliwości.
Typowy błąd
Odwrotny wniosek przy nieistotnym wyniku: „p > .05, więc próba jest reprezentatywna”. Test zgodności sprawdza tylko jedną zmienną i nie mówi nic o sposobie doboru osób. O tym, czego taki test nie rozstrzyga, piszemy w haśle reprezentatywność próby.
Zadanie 3. Tabela 2 × 3: liczności oczekiwane, stopnie swobody i V Craméra
Treść zadania
W badaniu 300 uczniów ostatnich klas zapytano, czy w tym roku szkolnym chodzą na płatne korepetycje z matematyki. W liceum odpowiedziało „tak” 54 ze 120 uczniów, w technikum 33 ze 110, a w szkole branżowej 13 z 70. Czy korzystanie z korepetycji zależy od typu szkoły? Oblicz liczności oczekiwane, χ², df i V Craméra.
Rozwiązanie krok po kroku
| Korepetycje | Liceum: O (E) | Technikum: O (E) | Branżowa: O (E) | Razem |
|---|---|---|---|---|
| tak | 54 (40.00) | 33 (36.67) | 13 (23.33) | 100 |
| nie | 66 (80.00) | 77 (73.33) | 57 (46.67) | 200 |
| Razem | 120 | 110 | 70 | 300 |
Krok 1. Liczności oczekiwane (w nawiasach w tabeli wyżej), np. liceum i „tak”: E = 100 × 120 / 300 = 40. Wszystkie E są większe od 5.
Krok 2. Decyzja. χ²kryt(2) = 5.99; 14.76 > 5.99, p = .001.
Krok 3. Odsetki. Porównujesz typy szkół, więc procenty liczysz w kolumnach: korepetycje ma 45.0% licealistów, 30.0% uczniów techników i 18.6% uczniów szkół branżowych.
Interpretacja
V Craméra (Cramér, 1946) sprowadza χ² do skali 0–1 niezależnej od N. Więcej: V Craméra i chi-kwadrat (test niezależności).
Typowy błąd
Liczenie df jak w teście zgodności: liczba komórek − 1 = 5. Wtedy wartość krytyczna wynosi 11.07, a p = .011 – decyzja się nie zmienia, ale p jest błędne. W tabeli krzyżowej df = (w − 1)(k − 1).
Zadanie 4. Procenty w wierszach czy w kolumnach?
Treść zadania
W ankiecie wzięło udział 150 studentek i 50 studentów. Z aplikacji do medytacji korzysta 45 kobiet i 10 mężczyzn. W sprawozdaniu koła naukowego napisano: „Aż 81.8% użytkowników aplikacji to kobiety, więc kobiety znacznie częściej medytują z aplikacją”. Oceń ten wniosek: policz właściwe odsetki i test χ².
Rozwiązanie krok po kroku
Krok 1. Ustal kierunek pytania. Pytanie brzmi: czy płeć różnicuje korzystanie z aplikacji? Płeć jest zmienną wyjaśniającą, więc procenty liczysz w obrębie każdej płci (tu w wierszach – sumują się do 100% w wierszu).
| Płeć | Korzysta | Nie korzysta | % korzystających w wierszu | % wśród korzystających (kolumna) |
|---|---|---|---|---|
| kobiety | 45 | 105 | 30.0% | 81.8% |
| mężczyźni | 10 | 40 | 20.0% | 18.2% |
Krok 2. Porównaj. Z aplikacji korzysta 30.0% kobiet i 20.0% mężczyzn – różnica wynosi 10.0 punktu procentowego. Liczba 81.8% wynika głównie z tego, że kobiet jest w próbie trzy razy więcej (150 wobec 50); także wśród osób niekorzystających kobiety stanowią 72.4%.
Krok 3. Test. χ²(1) = 1.88 (bez poprawki na ciągłość), p = .170, φ = .10.
Interpretacja
Wniosek ze sprawozdania jest więc przesadzony: odsetek liczony w złą stronę i brak testu. Zob. też hasło tabela krzyżowa.
Typowy błąd
Podawanie procentów kolumnowych („81.8% użytkowników to kobiety”) jako odpowiedzi na pytanie „czy kobiety częściej korzystają”. Zasada: procentuj w obrębie kategorii zmiennej wyjaśniającej i porównuj odsetki w poprzek.
Zadanie 5. Tabela 3 × 3 i reszty skorygowane: która komórka „robi” wynik?
Treść zadania
W sondażu po 120 osób z trzech grup wiekowych wskazało główne źródło wiadomości. Osoby w wieku 18–34 lata: internet 78, telewizja 30, radio lub prasa 12. Osoby w wieku 35–54 lata: 52, 46 i 22. Osoby w wieku 55+: 26, 64 i 30. Oblicz χ² i V Craméra, a potem reszty standaryzowane skorygowane i wskaż komórki odpowiedzialne za wynik.
Rozwiązanie krok po kroku
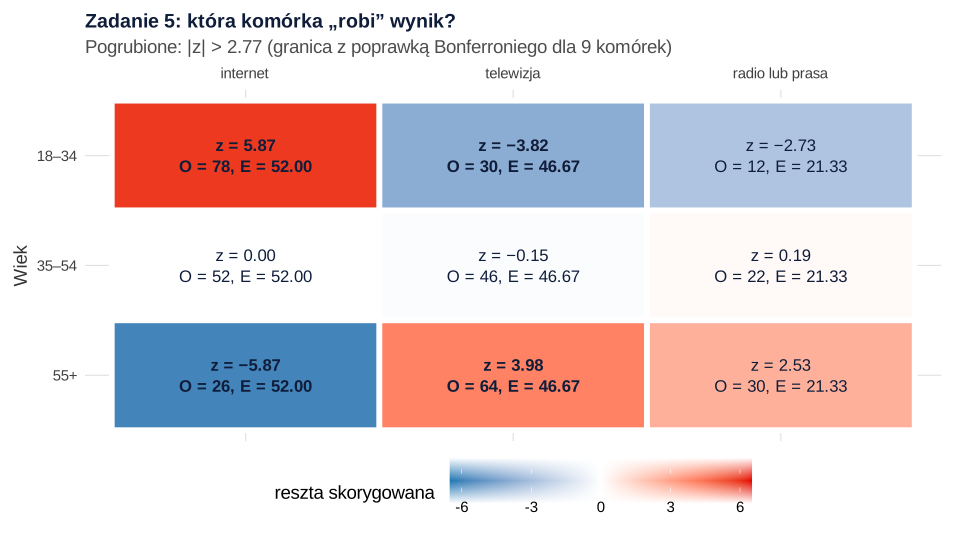
Krok 1. Liczności oczekiwane są takie same w każdym wierszu (grupy są równe): internet 156 × 120 / 360 = 52.00, telewizja 46.67, radio lub prasa 21.33.
Krok 2. Test. χ²(4) = 46.03, p < .001; df = (3 − 1)(3 − 1) = 4. V = √(46.03 / (360 × 2)) = .25.
Krok 3. Reszta skorygowana (Haberman, 1973) porównuje O z E z uwzględnieniem udziału wiersza (uw) i kolumny (uk) w całej próbie:
Krok 4. Granica. Sprawdzasz 9 komórek naraz, więc zamiast 1.96 użyj granicy z korektą Bonferroniego: |z| > 2.77.
Interpretacja
Reszty skorygowane poda Ci też SPSS (jak je włączyć i odczytać, pokazujemy w poradniku chi-kwadrat w SPSS krok po kroku), a w R znajdziesz je w chisq.test()$stdres.
Typowy błąd
Ocenianie każdej z 9 reszt względem 1.96. Wtedy „istotne” wyszłyby też komórki radia i prasy (−2.73 i 2.53), choć przy 9 porównaniach łatwo o przypadkowe przekroczenie granicy.
Zadanie 6. Współczynnik φ ze wzoru i dlaczego χ² nie mierzy siły związku
Treść zadania
W audycie dokumentacji oceniono 80 pielęgniarek: 40 miało w ostatnim tygodniu dyżur nocny, 40 nie. Błąd w dokumentacji znaleziono u 14 osób po dyżurze i u 6 bez dyżuru. (a) Oblicz φ wprost z komórek tabeli i χ². (b) Co się stanie z φ po zamianie kolejności kolumn? (c) Co się stanie z χ² i φ, gdyby próba była dziesięć razy większa przy tych samych proporcjach?
Rozwiązanie krok po kroku
Krok 1. Tabela. a = 14, b = 26 (dyżur: błąd tak, nie), c = 6, d = 34 (bez dyżuru). Błąd ma 35.0% osób po dyżurze i 15.0% bez dyżuru.
Krok 2. χ² z φ. W tabeli 2 × 2 χ² = N × φ² = 80 × .231² = 4.27, p = .039.
Krok 3. Znak. Po zamianie kolumn („nie” przed „tak”) φ = −.231. Znak zależy tylko od kolejności kategorii, a o sile związku mówi wartość bezwzględna.
Krok 4. Dziesięć razy więcej osób. Przy N = 800 i tych samych proporcjach χ² = 42.67, p < .001, a φ nadal wynosi .231.
Interpretacja
W tabeli 2 × 2 |φ| jest równe V Craméra. Więcej o tej mierze: współczynnik phi. Badanie jest przekrojowe, więc nie wiesz, czy to dyżur powoduje błędy.
Typowy błąd
Traktowanie χ² jako miary siły: „przy 800 osobach χ² = 42.67, więc związek jest dziesięć razy silniejszy”. χ² rośnie razem z N, a φ i V – nie; dlatego obok χ² zawsze podaj miarę efektu.
Zadanie 7. Poprawka Yatesa: kiedy zmienia decyzję
Treść zadania
Przychodnia losowo podzieliła 100 pacjentów w wieku 65+ na dwie grupy po 50 osób. Jedna dostała SMS z przypomnieniem o szczepieniu, druga nie. Na szczepienie zgłosiło się 38 osób z grupy SMS i 28 z grupy bez SMS. Oblicz χ² bez poprawki i z poprawką Yatesa. Czy przy α = .05 decyzja zależy od wersji testu?
Rozwiązanie krok po kroku
Krok 1. Warunki. Liczności oczekiwane to 33 i 17 w każdym wierszu – wszystkie większe od 5.
Krok 2. Wzór skrócony dla tabeli 2 × 2. |ad − bc| = |38 × 22 − 12 × 28| = 500, a iloczyn sum brzegowych 50 × 50 × 66 × 34 = 5 610 000.
Krok 3. Inne wersje. Test dokładny Fishera daje p = .057, a wersja „N − 1” (χ² × (N − 1) / N) – χ² = 4.41, p = .036. Campbell (2007) na podstawie porównania siedmiu testów zaleca właśnie wersję N − 1, gdy najmniejsza liczność oczekiwana wynosi co najmniej 1.
Interpretacja
Haviland (1990) pokazuje, że statystyka z poprawką Yatesa jest nadmiernie zachowawcza, a zwykły χ² Pearsona dobrze kontroluje błąd I rodzaju. Uwaga: funkcja chisq.test() w R dla tabeli 2 × 2 domyślnie stosuje poprawkę. Szerzej: poprawka Yatesa i chi-kwadrat czy test Fishera.
Typowy błąd
Wybieranie wersji testu po zobaczeniu wyników („z poprawką wyszło .057, więc podam wersję bez poprawki”). Wersję ustal przed analizą i napisz w pracy, którą liczysz.
Zadanie 8. Małe liczności: test Fishera–Freemana–Haltona albo łączenie kategorii
Treść zadania
W badaniu pilotażowym 40 osób zrekrutowano czterema kanałami. Z 18 osób z Facebooka badanie ukończyło 14, z 10 osób z ogłoszenia na uczelni – 6, z 7 osób poleconych przez znajomych – 2, a z 5 osób z innych źródeł – 0. Sprawdź, czy można użyć testu χ², i zaproponuj rozwiązanie.
Rozwiązanie krok po kroku
Krok 1. Liczności oczekiwane. Ukończyło 22 z 40 osób, więc np. dla „inne”: E = 5 × 22 / 40 = 2.75 (ukończyło) i 2.25 (nie ukończyło). Pięć z ośmiu komórek (62.5%) ma E < 5. Przyjmowana zwykle reguła mówi, że takich komórek może być najwyżej 20% i żadna nie może mieć E < 1 – tu jest wyraźnie przekroczona.
Krok 2. Rozwiązanie A: test dokładny dla tabeli 4 × 2. Test Fishera–Freemana–Haltona (w R fisher.test() dla tabeli większej niż 2 × 2) daje p = .006. Dla porównania wątpliwe przybliżenie χ²(3) = 11.96, p = .008.
Krok 3. Rozwiązanie B: połączenie kategorii podobnych merytorycznie. „Znajomi” i „inne” to rekrutacja nieformalna, więc łączysz je w jedną kategorię (12 osób, ukończyły 2). W tabeli 3 × 2 tylko jedna komórka z sześciu (16.7%) ma E < 5, a najmniejsza E = 4.50. Wynik: χ²(2) = 11.00, p = .004, V = .52; test Fishera dla tej tabeli: p = .005.
Interpretacja
Ręczne liczenie testu Fishera dla tabeli 2 × 2 pokazujemy w zadaniu 6 zbioru statystyka medyczna – zadania z rozwiązaniami (zob. też test dokładny Fishera).
Typowy błąd
Usunięcie małej kategorii („inne” – 5 osób) bez słowa w pracy albo łączenie kategorii tak długo, aż wynik stanie się istotny. Łącz tylko kategorie bliskie merytorycznie i opisz to przed podaniem wyniku.
Zadanie 9. Test trendu Cochrana–Armitage’a dla zmiennej porządkowej
Treść zadania
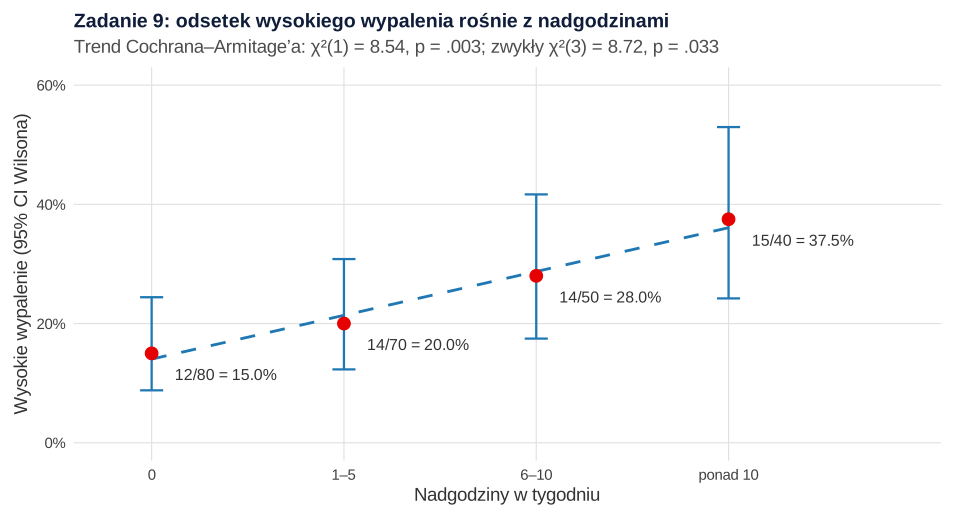
W firmie zbadano 240 pracowników. Wysokie wypalenie zawodowe miało 12 z 80 osób bez nadgodzin, 14 z 70 osób z 1–5 nadgodzinami tygodniowo, 14 z 50 osób z 6–10 nadgodzinami i 15 z 40 osób z ponad 10 nadgodzinami. Czy odsetek wypalenia rośnie wraz z liczbą nadgodzin?
Rozwiązanie krok po kroku
Krok 1. Odsetki: 15.0%, 20.0%, 28.0% i 37.5%. Średni odsetek wypalenia: p̄ = 55 / 240 = 0.229.
Krok 2. Punktacja kategorii. Kategorie mają naturalny porządek, więc nadajesz im wyniki x = 1, 2, 3, 4 (ni – liczba osób, ri – liczba osób z wypaleniem).
Krok 3. Porównaj ze zwykłym testem. Zwykły χ² dla tabeli 4 × 2 wynosi 8.72 przy df = 3, p = .033. Różnica 8.72 − 8.54 = 0.18 (df = 2, p = .914) to odchylenie od trendu liniowego – związek jest prawie w całości liniowy. Punktacja środkami przedziałów (0, 3, 8, 13) daje χ² = 8.71, p = .003.
Interpretacja
Armitage (1955) zwraca uwagę, że przy grupach uporządkowanych pytanie dotyczy zwykle trendu, a nie samej różnicy proporcji – i że test ukierunkowany na trend może wykazać silniejszy efekt niż zwykły χ². Więcej: test trendu Cochrana–Armitage’a.
Typowy błąd
Zwykły test χ² dla zmiennej porządkowej. Traktuje kategorie nadgodzin jak nazwy bez kolejności, dzieli efekt na trzy stopnie swobody i daje słabszy wynik (p = .033 zamiast .003).
Zadanie 10. Tabela warstwowa i paradoks Simpsona
Treść zadania
W dwóch szpitalach wykonano po 800 zabiegów. Szpital A (ośrodek referencyjny): zabiegi planowe – powikłania u 10 z 200 pacjentów, zabiegi pilne – u 120 z 600. Szpital B: zabiegi planowe – u 42 z 600, zabiegi pilne – u 50 z 200. Który szpital ma mniej powikłań? Porównaj wynik bez podziału na tryb zabiegu i z podziałem.
Rozwiązanie krok po kroku
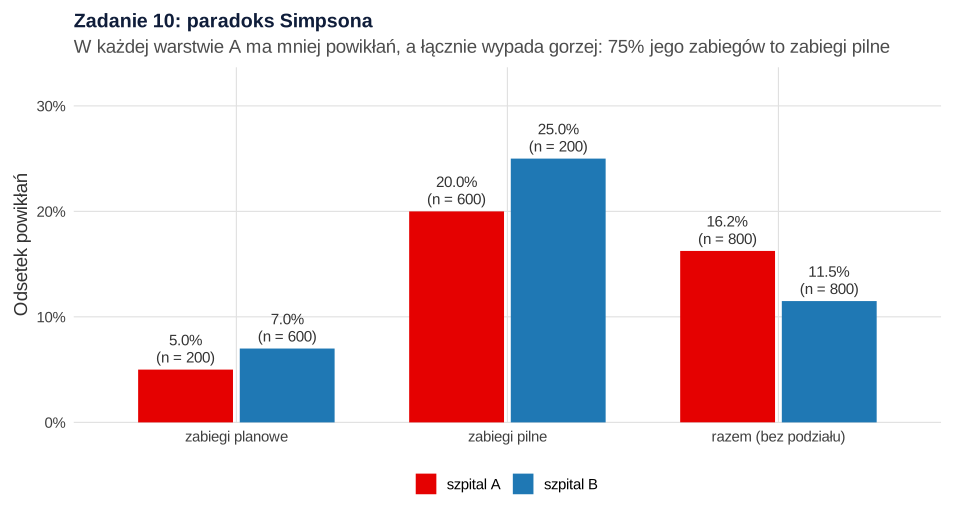
Krok 1. Tabela zsumowana. A: 130 / 800 = 16.2%, B: 92 / 800 = 11.5%; χ²(1) = 7.55, p = .006, OR (A wobec B) = 1.49. Wygląda na to, że szpital A wypada gorzej.
Krok 2. Warstwy. Zabiegi planowe: A 5.0%, B 7.0% (OR = 0.70). Zabiegi pilne: A 20.0%, B 25.0% (OR = 0.75). W obu warstwach szpital A ma mniej powikłań.
Krok 3. Skąd odwrócenie? Zabiegi pilne to 75.0% zabiegów w szpitalu A i tylko 25.0% w szpitalu B, a przy zabiegach pilnych powikłania są dużo częstsze. Tryb zabiegu wiąże się i ze szpitalem, i z wynikiem – działa jak zmienna zakłócająca.
Interpretacja
Kievit i in. (2013) pokazują, że takie odwrócenia zdarzają się częściej, niż się sądzi. O tym, czy wynik warstwowy jest właściwy, decyduje wiedza o kierunku zależności: tryb zabiegu jest tu cechą pacjenta sprzed zabiegu, a nie skutkiem wyboru szpitala, więc warstwy trzeba uwzględnić. Więcej: paradoks Simpsona i test Cochrana–Mantela–Haenszela.
Typowy błąd
Ranking szpitali, oddziałów albo szkół z tabeli zsumowanej, bez sprawdzenia, czy grupy nie różnią się składem (np. ciężkością przypadków).
Ściąga: który test w zadaniu z tabelą
Ustal liczbę zmiennych, ich porządek i to, czy grupy tworzą różne osoby. Szerszy schemat: jaki test statystyczny do jakiej hipotezy.
| Sytuacja w treści zadania | Test lub miara |
|---|---|
| Jedna zmienna, porównanie z równym lub podanym rozkładem | test χ² zgodności, df = k − 1; reszty (O − E)/√E |
| Dwie zmienne nominalne, wszystkie E ≥ 5 | test χ² niezależności, df = (w − 1)(k − 1); φ lub V Craméra |
| Istotny wynik w tabeli większej niż 2 × 2 | reszty skorygowane z korektą Bonferroniego |
| Tabela 2 × 2 z małymi E | test dokładny Fishera (albo wersja N − 1, gdy min E ≥ 1) |
| Tabela większa niż 2 × 2 z małymi E | test Fishera–Freemana–Haltona lub łączenie podobnych kategorii |
| Jedna zmienna porządkowa i wynik tak/nie | test trendu Cochrana–Armitage’a |
| Ta sama tabela 2 × 2 w kilku warstwach | OR Mantela–Haenszela i test CMH |
Wyniki dla własnej tabeli 2 × 2 albo r × c sprawdzisz w kalkulatorze tabeli krzyżowej.
Inne zbiory zadań
Wszystkie zbiory zebraliśmy na stronie zadania ze statystyki z rozwiązaniami. Tematycznie najbliższe temu wpisowi są:
- zadania ze statystyki na psychologii,
- statystyka medyczna – zadania z rozwiązaniami,
- regresja logistyczna – zadania z rozwiązaniami.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone najpierw wzorem, tak jak na kartce, a potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który korzysta z danych z tych przepisów.
Zadania 1–5: testy zgodności, tabele 2 × 3 i 3 × 3, procenty i reszty skorygowane
R
# B388 – zadania 1–5: test zgodności (rozkład jednostajny i zadany), tabela 2 × 3,
# procenty w wierszach i kolumnach, tabela 3 × 3 z resztami skorygowanymi
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # bez zera przed kropką
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))                          # zapis p w APA
proc <- function(x) paste0(formatC(100 * x, format = "f", digits = 1), "%")

# Zadanie 1. Test zgodności z rozkładem jednostajnym: 4 wersje opakowania, 160 osób
O1 <- c(A = 52, B = 38, C = 41, D = 29)
E1 <- rep(sum(O1) / length(O1), length(O1))
skl1 <- (O1 - E1)^2 / E1
chi1 <- sum(skl1); df1 <- length(O1) - 1
cat("Zadanie 1\n")
cat("Odsetki wyborów:", paste(names(O1), proc(O1 / sum(O1))), "\n")
cat("E =", E1, "; składniki (O - E)^2 / E:", z3(skl1), "\n")
cat("chi^2 =", z2(chi1), "; df =", df1, "; p =", bz(pchisq(chi1, df1, lower.tail = FALSE)),
    "; chi^2 krytyczne =", z2(qchisq(0.95, df1)), "\n")
t1 <- chisq.test(O1)
cat("Kontrola chisq.test(): chi^2 =", z2(t1$statistic), "; p =", bz(t1$p.value), "\n")
t1_proc <- suppressWarnings(chisq.test(100 * O1 / sum(O1)))
cat("Błąd – test na procentach zamiast liczności: chi^2 =", z2(t1_proc$statistic), "; p =", bz(t1_proc$p.value), "\n\n")

# Zadanie 2. Test zgodności z rozkładem zadanym: miejsce zamieszkania w ankiecie (N = 400)
# Struktura odniesienia 40% / 30% / 30% – dane wymyślone na potrzeby zadania
O2 <- c(wies = 112, miasto_do_100_tys = 128, miasto_ponad_100_tys = 160)
p2 <- c(0.40, 0.30, 0.30)
E2 <- sum(O2) * p2
skl2 <- (O2 - E2)^2 / E2
chi2 <- sum(skl2); df2 <- length(O2) - 1
cat("Zadanie 2\n")
cat("Odsetki w próbie:", proc(O2 / sum(O2)), "\n")
cat("E =", E2, "; składniki:", z3(skl2), "\n")
cat("chi^2 =", z2(chi2), "; df =", df2, "; p", pz(pchisq(chi2, df2, lower.tail = FALSE)), "\n")
t2 <- chisq.test(O2, p = p2)
cat("Kontrola chisq.test(p = ...): chi^2 =", z2(t2$statistic), "; p", pz(t2$p.value), "\n")
cat("Reszty standaryzowane (O - E) / sqrt(E):", z2(t2$residuals), "\n")
cat("w Cohena = sqrt(chi^2 / N) =", z2(sqrt(chi2 / sum(O2))), "\n\n")

# Zadanie 3. Tabela 2 × 3: korepetycje z matematyki a typ szkoły (N = 300)
tab3 <- matrix(c(54, 66, 33, 77, 13, 57), nrow = 2,
               dimnames = list(korepetycje = c("tak", "nie"), szkola = c("liceum", "technikum", "branzowa")))
N3 <- sum(tab3)
E3 <- outer(rowSums(tab3), colSums(tab3)) / N3
skl3 <- (tab3 - E3)^2 / E3
chi3 <- sum(skl3); df3 <- (nrow(tab3) - 1) * (ncol(tab3) - 1)
V3 <- sqrt(chi3 / (N3 * (min(dim(tab3)) - 1)))
cat("Zadanie 3\n"); print(addmargins(tab3))
cat("Liczności oczekiwane:\n"); print(round(E3, 2))
cat("Składniki (O - E)^2 / E:\n"); print(round(skl3, 3))
cat("chi^2 =", z2(chi3), "; df =", df3, "; p =", bz(pchisq(chi3, df3, lower.tail = FALSE)),
    "; chi^2 krytyczne =", z2(qchisq(0.95, df3)), "\n")
cat("Odsetek uczniów z korepetycjami:", paste(colnames(tab3), proc(tab3["tak", ] / colSums(tab3))), "\n")
cat("V Craméra =", bz(V3, 2), "\n")
cat("Błąd: df = liczba komórek - 1 = 5 -> chi^2 krytyczne =", z2(qchisq(0.95, 5)), "; p =",
    bz(pchisq(chi3, 5, lower.tail = FALSE)), "\n")
t3 <- chisq.test(tab3)
cat("Kontrola chisq.test(): chi^2 =", z2(t3$statistic), "; df =", t3$parameter, "; p =", bz(t3$p.value), "\n\n")

# Zadanie 4. Procenty w wierszach czy w kolumnach? Płeć a korzystanie z aplikacji do medytacji (N = 200)
tab4 <- matrix(c(45, 10, 105, 40), nrow = 2,
               dimnames = list(plec = c("kobiety", "mezczyzni"), aplikacja = c("korzysta", "nie korzysta")))
cat("Zadanie 4\n"); print(addmargins(tab4))
cat("Procenty w wierszach (w obrębie płci):\n"); print(round(100 * prop.table(tab4, 1), 1))
cat("Procenty w kolumnach (w obrębie korzystania):\n"); print(round(100 * prop.table(tab4, 2), 1))
t4 <- chisq.test(tab4, correct = FALSE)
cat("chi^2 (bez poprawki) =", z2(t4$statistic), "; p =", bz(t4$p.value), "; phi =",
    bz(sqrt(t4$statistic / sum(tab4)), 2), "\n")
cat("Różnica odsetków korzystających (kobiety - mężczyźni) =",
    formatC(100 * (tab4[1, 1] / sum(tab4[1, ]) - tab4[2, 1] / sum(tab4[2, ])), format = "f", digits = 1), "pp\n\n")

# Zadanie 5. Tabela 3 × 3: wiek a główne źródło wiadomości (N = 360), reszty skorygowane
tab5 <- matrix(c(78, 52, 26, 30, 46, 64, 12, 22, 30), nrow = 3,
               dimnames = list(wiek = c("18-34", "35-54", "55+"), zrodlo = c("internet", "telewizja", "radio_prasa")))
N5 <- sum(tab5)
t5 <- chisq.test(tab5)
E5 <- t5$expected
w <- rowSums(tab5) / N5; k <- colSums(tab5) / N5
res_skor <- (tab5 - E5) / sqrt(E5 * outer(1 - w, 1 - k))   # wzór Habermana
cat("Zadanie 5\n"); print(addmargins(tab5))
cat("Liczności oczekiwane:\n"); print(round(E5, 2))
cat("chi^2 =", z2(t5$statistic), "; df =", t5$parameter, "; p", pz(t5$p.value), "\n")
cat("V Craméra =", bz(sqrt(t5$statistic / (N5 * (min(dim(tab5)) - 1))), 2), "\n")
cat("Reszty skorygowane – wzorem:\n"); print(round(res_skor, 2))
cat("Kontrola chisq.test()$stdres:\n"); print(round(t5$stdres, 2))
cat("Przykład komórki 18-34 / internet: O =", tab5[1, 1], "; E =", z2(E5[1, 1]),
    "; mianownik = sqrt(E (1 - w)(1 - k)) =", z3(sqrt(E5[1, 1] * (1 - w[1]) * (1 - k[1]))), "\n")
cat("Wartość krytyczna z Bonferronim dla 9 komórek: |z| >", z2(qnorm(1 - 0.05 / (2 * 9))), "\n")
Wynik w R
Zadanie 1
Odsetki wyborów: A 32.5% B 23.8% C 25.6% D 18.1%
E = 40 40 40 40 ; składniki (O - E)^2 / E: 3.600 0.100 0.025 3.025
chi^2 = 6.75 ; df = 3 ; p = .080 ; chi^2 krytyczne = 7.81
Kontrola chisq.test(): chi^2 = 6.75 ; p = .080
Błąd – test na procentach zamiast liczności: chi^2 = 4.22 ; p = .239

Zadanie 2
Odsetki w próbie: 28.0% 32.0% 40.0%
E = 160 120 120 ; składniki: 14.400 0.533 13.333
chi^2 = 28.27 ; df = 2 ; p < .001
Kontrola chisq.test(p = ...): chi^2 = 28.27 ; p < .001
Reszty standaryzowane (O - E) / sqrt(E): -3.79 0.73 3.65
w Cohena = sqrt(chi^2 / N) = 0.27

Zadanie 3
           szkola
korepetycje liceum technikum branzowa Sum
        tak     54        33       13 100
        nie     66        77       57 200
        Sum    120       110       70 300
Liczności oczekiwane:
    liceum technikum branzowa
tak     40     36.67    23.33
nie     80     73.33    46.67
Składniki (O - E)^2 / E:
           szkola
korepetycje liceum technikum branzowa
        tak   4.90     0.367    4.576
        nie   2.45     0.183    2.288
chi^2 = 14.76 ; df = 2 ; p = .001 ; chi^2 krytyczne = 5.99
Odsetek uczniów z korepetycjami: liceum 45.0% technikum 30.0% branzowa 18.6%
V Craméra = .22
Błąd: df = liczba komórek - 1 = 5 -> chi^2 krytyczne = 11.07 ; p = .011
Kontrola chisq.test(): chi^2 = 14.76 ; df = 2 ; p = .001

Zadanie 4
           aplikacja
plec        korzysta nie korzysta Sum
  kobiety         45          105 150
  mezczyzni       10           40  50
  Sum             55          145 200
Procenty w wierszach (w obrębie płci):
           aplikacja
plec        korzysta nie korzysta
  kobiety         30           70
  mezczyzni       20           80
Procenty w kolumnach (w obrębie korzystania):
           aplikacja
plec        korzysta nie korzysta
  kobiety       81.8         72.4
  mezczyzni     18.2         27.6
chi^2 (bez poprawki) = 1.88 ; p = .170 ; phi = .10
Różnica odsetków korzystających (kobiety - mężczyźni) = 10.0 pp

Zadanie 5
       zrodlo
wiek    internet telewizja radio_prasa Sum
  18-34       78        30          12 120
  35-54       52        46          22 120
  55+         26        64          30 120
  Sum        156       140          64 360
Liczności oczekiwane:
       zrodlo
wiek    internet telewizja radio_prasa
  18-34       52     46.67       21.33
  35-54       52     46.67       21.33
  55+         52     46.67       21.33
chi^2 = 46.03 ; df = 4 ; p < .001
V Craméra = .25
Reszty skorygowane – wzorem:
       zrodlo
wiek    internet telewizja radio_prasa
  18-34     5.87     -3.82       -2.73
  35-54     0.00     -0.15        0.19
  55+      -5.87      3.98        2.53
Kontrola chisq.test()$stdres:
       zrodlo
wiek    internet telewizja radio_prasa
  18-34     5.87     -3.82       -2.73
  35-54     0.00     -0.15        0.19
  55+      -5.87      3.98        2.53
Przykład komórki 18-34 / internet: O = 78 ; E = 52.00 ; mianownik = sqrt(E (1 - w)(1 - k)) = 4.432
Wartość krytyczna z Bonferronim dla 9 komórek: |z| > 2.77
Zadania 6–10: φ, Yates, małe liczności, trend i paradoks Simpsona
R
# B388 – zadania 6–10: phi i V Craméra, poprawka Yatesa, małe liczności (Fisher–Freeman–Halton
# i łączenie kategorii), test trendu Cochrana–Armitage'a, paradoks Simpsona i test CMH
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))
proc <- function(x) paste0(formatC(100 * x, format = "f", digits = 1), "%")

# Zadanie 6. phi ze wzoru, znak phi i niezależność od N: dyżur nocny a błąd w dokumentacji (80 pielęgniarek)
tab6 <- matrix(c(14, 6, 26, 34), nrow = 2,
               dimnames = list(dyzur_nocny = c("tak", "nie"), blad = c("tak", "nie")))
a <- tab6[1, 1]; b <- tab6[1, 2]; c <- tab6[2, 1]; d <- tab6[2, 2]
phi6 <- (a * d - b * c) / sqrt((a + b) * (c + d) * (a + c) * (b + d))
t6 <- chisq.test(tab6, correct = FALSE)
cat("Zadanie 6\n"); print(addmargins(tab6))
cat("Odsetek błędów: po dyżurze nocnym =", proc(a / (a + b)), "; bez dyżuru =", proc(c / (c + d)), "\n")
cat("ad - bc =", a * d - b * c, "; mianownik =", z2(sqrt((a + b) * (c + d) * (a + c) * (b + d))), "; phi =", bz(phi6), "\n")
cat("chi^2 = N * phi^2 =", z2(sum(tab6) * phi6^2), "; chisq.test(): chi^2 =", z2(t6$statistic), "; p =", bz(t6$p.value), "\n")
tab6_odwr <- tab6[, c("nie", "tak")]
cat("Po zamianie kolejności kolumn: phi =", bz((tab6_odwr[1, 1] * tab6_odwr[2, 2] - tab6_odwr[1, 2] * tab6_odwr[2, 1]) /
    sqrt(prod(rowSums(tab6_odwr), colSums(tab6_odwr)))), "\n")
t6x10 <- chisq.test(10 * tab6, correct = FALSE)
cat("Te same proporcje, N = 800: chi^2 =", z2(t6x10$statistic), "; p", pz(t6x10$p.value), "; phi =",
    bz(sqrt(t6x10$statistic / sum(10 * tab6))), "\n\n")

# Zadanie 7. Poprawka Yatesa: SMS z przypomnieniem a zgłoszenie się na szczepienie (po 50 osób)
tab7 <- matrix(c(38, 28, 12, 22), nrow = 2,
               dimnames = list(grupa = c("SMS", "bez_SMS"), zglosil_sie = c("tak", "nie")))
a <- tab7[1, 1]; b <- tab7[1, 2]; c <- tab7[2, 1]; d <- tab7[2, 2]; N7 <- sum(tab7)
mian7 <- prod(rowSums(tab7), colSums(tab7))
chi7 <- N7 * (a * d - b * c)^2 / mian7
chi7_y <- N7 * (abs(a * d - b * c) - N7 / 2)^2 / mian7
cat("Zadanie 7\n"); print(addmargins(tab7))
cat("Odsetek zgłoszeń: SMS =", proc(a / (a + b)), "; bez SMS =", proc(c / (c + d)), "\n")
cat("Liczności oczekiwane:\n"); print(chisq.test(tab7)$expected)
cat("|ad - bc| =", abs(a * d - b * c), "; iloczyn sum brzegowych =", mian7, "\n")
cat("Pearson bez poprawki: chi^2 =", z2(chi7), "; p =", bz(pchisq(chi7, 1, lower.tail = FALSE)), "\n")
cat("Z poprawką Yatesa: chi^2 =", z2(chi7_y), "; p =", bz(pchisq(chi7_y, 1, lower.tail = FALSE)), "\n")
cat("Wersja N - 1: chi^2 =", z2(chi7 * (N7 - 1) / N7), "; p =", bz(pchisq(chi7 * (N7 - 1) / N7, 1, lower.tail = FALSE)), "\n")
cat("Kontrola chisq.test(): bez poprawki =", z2(chisq.test(tab7, correct = FALSE)$statistic),
    "; domyślnie (Yates) =", z2(chisq.test(tab7)$statistic), "; p =", bz(chisq.test(tab7)$p.value), "\n")
cat("Test dokładny Fishera: p =", bz(fisher.test(tab7)$p.value), "\n\n")

# Zadanie 8. Małe liczności: kanał rekrutacji a ukończenie badania pilotażowego (N = 40)
tab8 <- matrix(c(14, 6, 2, 0, 4, 4, 5, 5), nrow = 4,
               dimnames = list(kanal = c("Facebook", "uczelnia", "znajomi", "inne"), ukonczyl = c("tak", "nie")))
E8 <- outer(rowSums(tab8), colSums(tab8)) / sum(tab8)
cat("Zadanie 8\n"); print(addmargins(tab8))
cat("Liczności oczekiwane:\n"); print(round(E8, 2))
cat("Komórek z E < 5:", sum(E8 < 5), "z", length(E8), "(", proc(mean(E8 < 5)), "); najmniejsza E =", z2(min(E8)), "\n")
cat("Odsetek ukończenia:", paste(rownames(tab8), proc(tab8[, "tak"] / rowSums(tab8))), "\n")
t8 <- suppressWarnings(chisq.test(tab8))
cat("chi^2 (przybliżenie wątpliwe) =", z2(t8$statistic), "; df =", t8$parameter, "; p =", bz(t8$p.value), "\n")
cat("Test Fishera–Freemana–Haltona (fisher.test dla 4 × 2): p =", bz(fisher.test(tab8)$p.value), "\n")
tab8s <- rbind(tab8[c("Facebook", "uczelnia"), ], znajomi_lub_inne = colSums(tab8[c("znajomi", "inne"), ]))
E8s <- outer(rowSums(tab8s), colSums(tab8s)) / sum(tab8s)
cat("Po połączeniu 'znajomi' i 'inne':\n"); print(addmargins(tab8s))
cat("Odsetek ukończenia:", paste(rownames(tab8s), proc(tab8s[, "tak"] / rowSums(tab8s))), "\n")
cat("Liczności oczekiwane:\n"); print(round(E8s, 2))
cat("Komórek z E < 5:", sum(E8s < 5), "z", length(E8s), "(", proc(mean(E8s < 5)), "); najmniejsza E =", z2(min(E8s)), "\n")
t8s <- suppressWarnings(chisq.test(tab8s))   # jedna komórka ma E = 4.5
cat("chi^2 =", z2(t8s$statistic), "; df =", t8s$parameter, "; p =", bz(t8s$p.value), "; V =",
    bz(sqrt(t8s$statistic / sum(tab8s)), 2), "; Fisher dla 3 × 2: p =", bz(fisher.test(tab8s)$p.value), "\n\n")

# Zadanie 9. Test trendu Cochrana–Armitage'a: nadgodziny tygodniowo a wysokie wypalenie (N = 240)
n9 <- c("0" = 80, "1-5" = 70, "6-10" = 50, "ponad 10" = 40)
r9 <- c(12, 14, 14, 15)          # osoby z wysokim wypaleniem
x9 <- 1:4                        # punktacja kategorii
N9 <- sum(n9); R9 <- sum(r9); pbar <- R9 / N9
T9 <- sum(x9 * (r9 - n9 * pbar))
S9 <- pbar * (1 - pbar) * (sum(n9 * x9^2) - sum(n9 * x9)^2 / N9)
chi9_trend <- T9^2 / S9
tab9 <- cbind(wypalenie = r9, brak = n9 - r9)
chi9_cale <- chisq.test(tab9)$statistic
cat("Zadanie 9\n"); print(cbind(n = n9, wypalenie = r9, odsetek = proc(r9 / n9)), quote = FALSE)
cat("Średni odsetek pbar =", z3(pbar), "; licznik T = suma x (r - n p) =", z3(T9), "; wariancja =", z3(S9), "\n")
cat("chi^2 trendu =", z2(chi9_trend), "; df = 1 ; p =", bz(pchisq(chi9_trend, 1, lower.tail = FALSE)), "\n")
pt9 <- prop.trend.test(r9, n9, score = x9)
cat("Kontrola prop.trend.test(): chi^2 =", z2(pt9$statistic), "; p =", bz(pt9$p.value), "\n")
cat("Zwykły chi^2 dla tabeli 4 × 2 =", z2(chi9_cale), "; df = 3 ; p =", bz(pchisq(chi9_cale, 3, lower.tail = FALSE)), "\n")
cat("Odchylenie od trendu liniowego: chi^2 =", z2(chi9_cale - chi9_trend), "; df = 2 ; p =",
    bz(pchisq(chi9_cale - chi9_trend, 2, lower.tail = FALSE)), "\n")
pt9b <- prop.trend.test(r9, n9, score = c(0, 3, 8, 13))
cat("Inna punktacja (środki przedziałów 0, 3, 8, 13): chi^2 =", z2(pt9b$statistic), "; p =", bz(pt9b$p.value), "\n\n")

# Zadanie 10. Paradoks Simpsona: powikłania po zabiegu w dwóch szpitalach, warstwy: tryb zabiegu
tab10 <- array(c(10, 42, 190, 558,     # zabiegi planowe: szpital A, B × powikłanie tak, nie
                 120, 50, 480, 150),   # zabiegi pilne
               dim = c(2, 2, 2),
               dimnames = list(szpital = c("A", "B"), powiklanie = c("tak", "nie"), tryb = c("planowy", "pilny")))
cat("Zadanie 10\n")
for (s in dimnames(tab10)$tryb) {
  ts <- tab10[, , s]
  cat(s, ": A =", ts["A", "tak"], "/", sum(ts["A", ]), "=", proc(ts["A", "tak"] / sum(ts["A", ])),
      "; B =", ts["B", "tak"], "/", sum(ts["B", ]), "=", proc(ts["B", "tak"] / sum(ts["B", ])),
      "; OR (A vs B) =", z2(ts[1, 1] * ts[2, 2] / (ts[1, 2] * ts[2, 1])), "\n")
}
razem <- apply(tab10, c(1, 2), sum)
cat("Razem: A =", razem["A", "tak"], "/", sum(razem["A", ]), "=", proc(razem["A", "tak"] / sum(razem["A", ])),
    "; B =", razem["B", "tak"], "/", sum(razem["B", ]), "=", proc(razem["B", "tak"] / sum(razem["B", ])),
    "; OR (A vs B) =", z2(razem[1, 1] * razem[2, 2] / (razem[1, 2] * razem[2, 1])), "\n")
t10 <- chisq.test(razem, correct = FALSE)
cat("Tabela zsumowana: chi^2(1) =", z2(t10$statistic), "; p =", bz(t10$p.value), "\n")
cat("Odsetek zabiegów pilnych: A =", proc(sum(tab10["A", , "pilny"]) / sum(tab10["A", , ])),
    "; B =", proc(sum(tab10["B", , "pilny"]) / sum(tab10["B", , ])), "\n")
or_mh_l <- sum(sapply(1:2, function(k) tab10[1, 1, k] * tab10[2, 2, k] / sum(tab10[, , k])))
or_mh_m <- sum(sapply(1:2, function(k) tab10[1, 2, k] * tab10[2, 1, k] / sum(tab10[, , k])))
cat("OR Mantela–Haenszela wzorem =", z2(or_mh_l / or_mh_m), "\n")
mh <- mantelhaen.test(tab10, correct = FALSE)
cat("Kontrola mantelhaen.test(): chi^2 CMH =", z2(mh$statistic), "; p =", bz(mh$p.value), "; OR_MH =", z2(mh$estimate),
    "; 95% CI [", z2(mh$conf.int[1]), ",", z2(mh$conf.int[2]), "]\n")
Wynik w R
Zadanie 6
           blad
dyzur_nocny tak nie Sum
        tak  14  26  40
        nie   6  34  40
        Sum  20  60  80
Odsetek błędów: po dyżurze nocnym = 35.0% ; bez dyżuru = 15.0%
ad - bc = 320 ; mianownik = 1385.64 ; phi = .231
chi^2 = N * phi^2 = 4.27 ; chisq.test(): chi^2 = 4.27 ; p = .039
Po zamianie kolejności kolumn: phi = -.231
Te same proporcje, N = 800: chi^2 = 42.67 ; p < .001 ; phi = .231

Zadanie 7
         zglosil_sie
grupa     tak nie Sum
  SMS      38  12  50
  bez_SMS  28  22  50
  Sum      66  34 100
Odsetek zgłoszeń: SMS = 76.0% ; bez SMS = 56.0%
Liczności oczekiwane:
         zglosil_sie
grupa     tak nie
  SMS      33  17
  bez_SMS  33  17
|ad - bc| = 500 ; iloczyn sum brzegowych = 5610000
Pearson bez poprawki: chi^2 = 4.46 ; p = .035
Z poprawką Yatesa: chi^2 = 3.61 ; p = .057
Wersja N - 1: chi^2 = 4.41 ; p = .036
Kontrola chisq.test(): bez poprawki = 4.46 ; domyślnie (Yates) = 3.61 ; p = .057
Test dokładny Fishera: p = .057

Zadanie 8
          ukonczyl
kanal      tak nie Sum
  Facebook  14   4  18
  uczelnia   6   4  10
  znajomi    2   5   7
  inne       0   5   5
  Sum       22  18  40
Liczności oczekiwane:
          tak  nie
Facebook 9.90 8.10
uczelnia 5.50 4.50
znajomi  3.85 3.15
inne     2.75 2.25
Komórek z E < 5: 5 z 8 ( 62.5% ); najmniejsza E = 2.25
Odsetek ukończenia: Facebook 77.8% uczelnia 60.0% znajomi 28.6% inne 0.0%
chi^2 (przybliżenie wątpliwe) = 11.96 ; df = 3 ; p = .008
Test Fishera–Freemana–Haltona (fisher.test dla 4 × 2): p = .006
Po połączeniu 'znajomi' i 'inne':
                 tak nie Sum
Facebook          14   4  18
uczelnia           6   4  10
znajomi_lub_inne   2  10  12
Sum               22  18  40
Odsetek ukończenia: Facebook 77.8% uczelnia 60.0% znajomi_lub_inne 16.7%
Liczności oczekiwane:
                 tak nie
Facebook         9.9 8.1
uczelnia         5.5 4.5
znajomi_lub_inne 6.6 5.4
Komórek z E < 5: 1 z 6 ( 16.7% ); najmniejsza E = 4.50
chi^2 = 11.00 ; df = 2 ; p = .004 ; V = .52 ; Fisher dla 3 × 2: p = .005

Zadanie 9
         n  wypalenie odsetek
0        80 12        15.0%
1-5      70 14        20.0%
6-10     50 14        28.0%
ponad 10 40 15        37.5%
Średni odsetek pbar = 0.229 ; licznik T = suma x (r - n p) = 20.542 ; wariancja = 49.388
chi^2 trendu = 8.54 ; df = 1 ; p = .003
Kontrola prop.trend.test(): chi^2 = 8.54 ; p = .003
Zwykły chi^2 dla tabeli 4 × 2 = 8.72 ; df = 3 ; p = .033
Odchylenie od trendu liniowego: chi^2 = 0.18 ; df = 2 ; p = .914
Inna punktacja (środki przedziałów 0, 3, 8, 13): chi^2 = 8.71 ; p = .003

Zadanie 10
planowy : A = 10 / 200 = 5.0% ; B = 42 / 600 = 7.0% ; OR (A vs B) = 0.70
pilny : A = 120 / 600 = 20.0% ; B = 50 / 200 = 25.0% ; OR (A vs B) = 0.75
Razem: A = 130 / 800 = 16.2% ; B = 92 / 800 = 11.5% ; OR (A vs B) = 1.49
Tabela zsumowana: chi^2(1) = 7.55 ; p = .006
Odsetek zabiegów pilnych: A = 75.0% ; B = 25.0%
OR Mantela–Haenszela wzorem = 0.74
Kontrola mantelhaen.test(): chi^2 CMH = 3.22 ; p = .073 ; OR_MH = 0.74 ; 95% CI [ 0.53 , 1.03 ]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie zadania z testu chi-kwadrat pojawiają się na kolokwium ze statystyki?
Najczęściej test zgodności (czy odpowiedzi rozkładają się równo albo zgodnie z podaną strukturą), test niezależności dla tabeli 2 × 2 lub większej z licznościami oczekiwanymi i stopniami swobody, miara siły związku (φ, V Craméra) i interpretacja w stylu APA. Na wyższych latach dochodzą reszty skorygowane, poprawka Yatesa, test Fishera, test trendu i tabele warstwowe. Zakres zależy od uczelni, więc porównaj go z sylabusem.
Po czym poznać w treści zadania, że chodzi o test chi-kwadrat zgodności?
W zadaniu jest tylko jedna zmienna kategorialna i rozkład, z którym masz ją porównać: równy (np. cztery wersje produktu po 25%) albo podany w treści (np. struktura populacji 40/30/30%). Gdy w zadaniu są dwie zmienne i pytanie „czy jedna zależy od drugiej”, to test niezależności w tabeli krzyżowej.
Jak policzyć resztę skorygowaną dla jednej komórki tabeli kalkulatorem?
Policz E, udział wiersza uw (suma wiersza / N) i udział kolumny uk (suma kolumny / N), a potem z = (O − E) / √(E(1 − uw)(1 − uk)). W zadaniu 5 dla osób w wieku 18–34 lata i internetu: (78 − 52) / 4.432 = 5.87. Przy wielu komórkach porównuj |z| z granicą po korekcie Bonferroniego, np. 2.77 dla 9 komórek.
Dlaczego mój wynik chi-kwadrat z kalkulatora różni się od wyniku z R w ostatniej cyfrze?
Zwykle dlatego, że zaokrąglasz liczności oczekiwane albo składniki (O − E)² / E przed zsumowaniem. Licz z co najmniej trzema miejscami po przecinku i zaokrąglaj dopiero wynik. Jeśli różnica jest większa, sprawdź, czy R nie zastosował poprawki Yatesa – w tabeli 2 × 2 robi to domyślnie.
Czy w zadaniu z tabelą krzyżową trzeba zawsze podać wielkość efektu?
Tak, jeśli zadanie każe opisać wynik w stylu APA. Wartość χ² rośnie razem z liczebnością próby (w zadaniu 6 przy dziesięć razy większej próbie χ² wzrosło z 4.27 do 42.67, a φ zostało równe .23), więc sama nie mówi o sile związku. Dla tabeli 2 × 2 podaj φ, dla większych tabel V Craméra.
Powiązane hasła
Przeczytaj też
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikZadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →Masz w pracy tabele krzyżowe i nie wiesz, który wariant testu wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P. (1955). Tests for linear trends in proportions and frequencies. Biometrics, 11(3), 375–386. https://doi.org/10.2307/3001775
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380 ● Otwarty dostęp
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press. https://doi.org/10.1515/9781400883868
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Haviland, M. G. (1990). Yates's correction for continuity and the analysis of 2 × 2 contingency tables. Statistics in Medicine, 9(4), 363–367. https://doi.org/10.1002/sim.4780090403
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
Cytowania BibTeX
@article{armitage1955tests, author={Armitage, P.}, title={{Tests for linear trends in proportions and frequencies}}, journal={Biometrics}, year={1955}, volume={11}, number={3}, pages={375--386}, doi={10.2307/3001775}}@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{cochran1952chi, author={Cochran, William G.}, title={{The χ² test of goodness of fit}}, journal={The Annals of Mathematical Statistics}, year={1952}, volume={23}, number={3}, pages={315--345}, doi={10.1214/aoms/1177729380}}@book{cramer1946mathematical, author={Cramér, Harald}, title={{Mathematical methods of statistics}}, year={1946}, publisher={Princeton University Press}, doi={10.1515/9781400883868}}@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@article{haviland1990yates, author={Haviland, Mark G.}, title={{Yates's correction for continuity and the analysis of 2 × 2 contingency tables}}, journal={Statistics in Medicine}, year={1990}, volume={9}, number={4}, pages={363--367}, doi={10.1002/sim.4780090403}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}