Co to jest test chi-kwadrat zgodności?
Test chi-kwadrat zgodności (ang. chi-square goodness-of-fit test) sprawdza, czy rozkład jednej zmiennej jakościowej w próbie jest zgodny z rozkładem oczekiwanym, określonym z góry: równymi proporcjami, znaną strukturą populacji albo przewidywaniem teorii. Porównuje liczebności obserwowane w kategoriach z liczebnościami, jakich należałoby się spodziewać, gdyby ten rozkład był prawdziwy.
To najstarszy test z rodziny χ². Kryterium zaproponował Karl Pearson (1900), a Plackett (1983) rekonstruuje kontekst powstania tej pracy i pokazuje, że interpretacja pierwotnej procedury nie jest dla współczesnego czytelnika oczywista. Cochran (1952) w przystępnym przeglądzie dla użytkowników statystyki omówił historię testu, badania nad minimalną liczebnością oczekiwaną w kategorii i tworzeniem kategorii, a także testy alternatywne.
W psychologii test zgodności przydaje się zwłaszcza wtedy, gdy chcesz sprawdzić, czy struktura próby (np. płeć, wiek, kierunek studiów z metryczki) odpowiada strukturze populacji, albo czy odpowiedzi z kafeterii są wybierane równie często. Testy niezależności, jednorodności i zgodności mają niemal identyczny wzór, ale odpowiadają na różne pytania (Franke i in., 2012): test zgodności dotyczy jednej zmiennej i rozkładu teoretycznego, a test chi-kwadrat niezależności – związku dwóch zmiennych.
Wzór i stopnie swobody
- Oi – liczebność obserwowana w kategorii i,
- πi – oczekiwany odsetek w kategorii i (zapisany jako proporcja, np. 0.25),
- Ei – liczebność oczekiwana, N – liczebność próby, k – liczba kategorii.
Hipoteza zerowa mówi, że rozkład w populacji, z której pochodzi próba, jest zgodny z oczekiwanym; alternatywna – że nie jest. Duże różnice między O i E dają duże χ², które porównuje się z rozkładem χ² o k − 1 stopniach swobody. Jeśli parametry rozkładu oczekiwanego oszacowano z tych samych danych (np. średnią i odchylenie standardowe przy sprawdzaniu zgodności z rozkładem normalnym), liczba stopni swobody maleje o liczbę oszacowanych parametrów: df = k − 1 − m. Do sprawdzania normalności zmiennej ilościowej lepiej jednak użyć testu Shapiro-Wilka.
Założenia testu zgodności
- Liczebności niezależnych obserwacji. Każda osoba trafia do dokładnie jednej kategorii; kategorie są rozłączne i obejmują wszystkie możliwe odpowiedzi.
- Rozkład oczekiwany ustalony z góry – z teorii, rejestrów lub statystyk publicznych, a nie dopasowany do tych samych danych po ich obejrzeniu.
- Wystarczające liczebności oczekiwane. Najczęściej przyjmuje się, że najwyżej 20% kategorii może mieć liczebność oczekiwaną mniejszą niż 5 i żadna nie może mieć mniejszej niż 1 (Kim, 2017). Gdy warunek nie jest spełniony, połącz sąsiednie kategorie (jeśli ma to sens merytoryczny) albo policz wartość p metodą Monte Carlo:
chisq.test(x, p = proporcje, simulate.p.value = TRUE).
Przykład 1: czy struktura wieku w ankiecie odpowiada populacji?
Ankietę internetową o dobrostanie wypełniło 400 dorosłych osób (dane symulowane). Badaczka porównuje strukturę wieku w próbie ze strukturą populacji; na potrzeby przykładu przyjmujemy, że w populacji 20% osób ma 18–29 lat, 30% – 30–44 lata, 25% – 45–59 lat i 25% – 60 lat lub więcej. Liczebności oczekiwane to 400 × 0.20 = 80, 400 × 0.30 = 120 i dwa razy 400 × 0.25 = 100.
| Wiek | O (% w próbie) | % w populacji | E | (O − E)² / E | Reszta z |
|---|---|---|---|---|---|
| 18–29 | 114 (28.5%) | 20% | 80 | 14.45 | 4.25 |
| 30–44 | 128 (32.0%) | 30% | 120 | 0.53 | 0.87 |
| 45–59 | 93 (23.3%) | 25% | 100 | 0.49 | −0.81 |
| 60+ | 65 (16.3%) | 25% | 100 | 12.25 | −4.04 |
| Razem | 400 (100%) | 100% | 400 | χ² = 27.72 |
Suma ostatnich składników daje χ²(3, N = 400) = 27.72, p < .001: struktura wieku w próbie istotnie odbiega od populacyjnej. Dwie skrajne grupy wieku odpowiadają łącznie za 96.3% wartości χ². Które kategorie odbiegają istotnie, pokazują skorygowane reszty standaryzowane:
Taka reszta odpowiada testowi, czy odsetek w jednej kategorii różni się od oczekiwanego. Przy czterech kategoriach próg z korektą Bonferroniego wynosi |z| > 2.50. Przekraczają go grupa 18–29 lat (z = 4.25 – nadreprezentacja) i grupa 60+ (z = −4.04 – niedoreprezentacja); osoby w wieku 30–59 lat są w próbie mniej więcej w takich proporcjach jak w populacji.
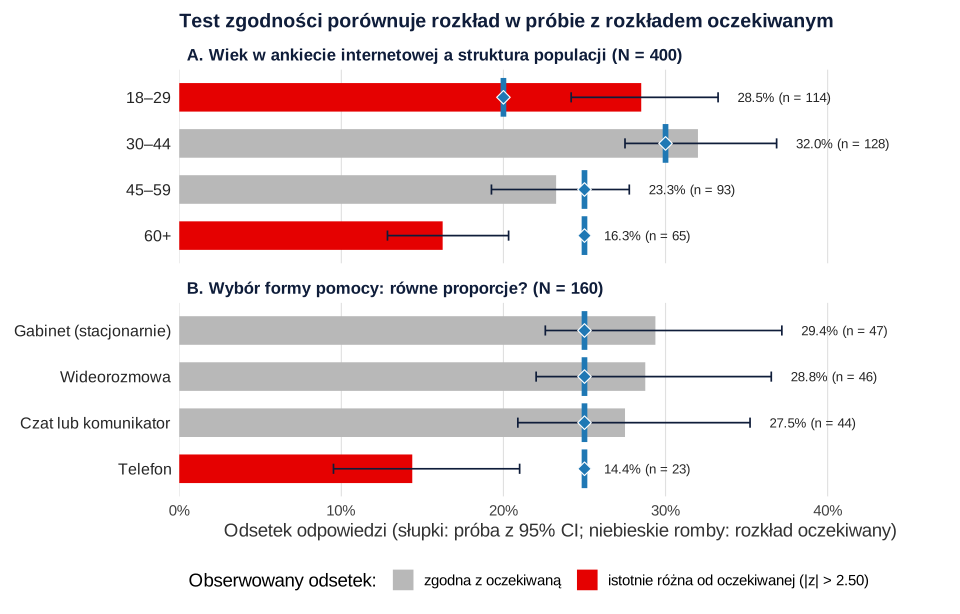
Próba nadreprezentuje młodych dorosłych i niedoreprezentuje seniorów. Taki wzór może wynikać ze sposobu rekrutacji: ankieta rozsyłana w mediach społecznościowych to zwykle dobór wygodny (zob. też gdzie znaleźć respondentów do ankiety). W takiej sytuacji uogólniaj wyniki ostrożnie, opisz ograniczenie w pracy, a przy planowaniu kolejnego badania rozważ próbę kwotową.
Przykład 2: czy odpowiedzi są wybierane równie często?
Gdy nie podasz proporcji, test zakłada równe proporcje wszystkich kategorii. W ankiecie 160 studentów wskazało preferowaną formę pomocy psychologicznej (dane symulowane): gabinet – 47 osób, wideorozmowa – 46, czat lub komunikator – 44, telefon – 23. Przy równych proporcjach w każdej kategorii oczekujemy 160 / 4 = 40 osób.
Wynik: χ²(3, N = 160) = 9.75, p = .021 – formy pomocy nie są wybierane równie często. Skorygowane reszty pokazują, że odpowiada za to głównie telefon (z = −3.10, jedyna reszta powyżej progu 2.50); reszty dla trzech pozostałych form wynoszą od 0.73 do 1.28. W analizie eksploracyjnej możesz to potwierdzić testem bez kategorii „telefon”: trzy pozostałe formy wybierano podobnie często, χ²(2, N = 137) = 0.10, p = .950.
Wielkość efektu: w Cohena
Wartość χ² rośnie razem z liczebnością próby, dlatego obok wyniku testu podaj wielkość efektu – w Cohena:
gdzie pi to odsetek obserwowany w kategorii i, a πi – oczekiwany. W przykładzie 1: w = √(27.72 / 400) = 0.26, w przykładzie 2: w = √(9.75 / 160) = 0.25. Cohen (1992) podaje dla w konwencjonalne wartości efektu małego, średniego i dużego: 0.10, 0.30 i 0.50 – oba efekty leżą więc między małym a średnim. W teście zgodności w może przekroczyć 1, dlatego zapisuje się je z zerem przed kropką.
Wielkość efektu pomaga też uniknąć pułapki „nieistotny wynik = zgodność”. Gdyby ankietę wypełniło tylko 40 osób o podobnej strukturze wieku (11, 13, 9 i 7 osób), test dałby χ²(3, N = 40) = 2.21, p = .530, choć odchylenie od populacji byłoby prawie takie samo (w = 0.23). Przy małej próbie test ma niską moc, a przy bardzo dużej – wykrywa nawet nieistotne praktycznie odchylenia.
Jak opisać wynik w pracy (APA)
Podaj liczbę stopni swobody, liczebność próby, wartość χ², p i w w formacie χ²(df, N = …) = …, p = …, a następnie opisz, które kategorie odbiegają od oczekiwań. Opis przykładu 1:
Opis przykładu 2 (równe proporcje):
Strukturę próby warto też pokazać w tabeli charakterystyki próby – zob. jak opisać charakterystykę próby badawczej.
Test chi-kwadrat zgodności w R
Kod liczy test zgodności ze znaną strukturą populacji (przykład 1) i test równych proporcji (przykład 2), liczebności oczekiwane, skorygowane reszty i w Cohena. W SPSS: Analiza → Testy nieparametryczne → Testy tradycyjne → Chi-kwadrat; w polu Wartości oczekiwane wybierz „Wszystkie kategorie równe” albo wpisz kolejno oczekiwane proporcje kategorii.
Zgodność z rozkładem populacji i z równymi proporcjami
R
proba <- c("18-29" = 114, "30-44" = 128, "45-59" = 93, "60+" = 65)   # ankieta online, N = 400
populacja <- c(.20, .30, .25, .25)                                  # struktura populacji
test <- chisq.test(proba, p = populacja)
test
test$expected                            # liczebności oczekiwane
round(test$stdres, 2)                    # skorygowane reszty standaryzowane
unname(sqrt(test$statistic / sum(proba)))   # w Cohena
wybory <- c(gabinet = 47, wideo = 46, czat = 44, telefon = 23)
chisq.test(wybory)                       # domyślnie: równe proporcje (po 25%)
round(chisq.test(wybory)$stdres, 2)
Wynik w R
	Chi-squared test for given probabilities

data:  proba
X-squared = 27.723, df = 3, p-value = 4.152e-06

18-29 30-44 45-59   60+
   80   120   100   100
18-29 30-44 45-59   60+
 4.25  0.87 -0.81 -4.04
[1] 0.2632648

	Chi-squared test for given probabilities

data:  wybory
X-squared = 9.75, df = 3, p-value = 0.02082

gabinet   wideo    czat telefon
   1.28    1.10    0.73   -3.10
Wartość p-value = 4.152e-06 to 0.000004, w zapisie APA: p < .001. Proporcje w argumencie p muszą sumować się do 1 – jeśli podajesz liczebności populacyjne, dodaj rescale.p = TRUE.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Wynik nieistotny, więc próba jest reprezentatywna”. Test pokazuje tylko, czy odchylenie w jednej zmiennej da się wykryć przy danej liczebności. Reprezentatywność próby zależy przede wszystkim od sposobu doboru osób (zob. próba losowa), a nie od zgodności kilku rozkładów brzegowych.
- Procenty zamiast liczebności. Wpisanie „28.5” zamiast 114 osób zmienia N i całkowicie zmienia wynik testu.
- Rozkład oczekiwany ustalony po obejrzeniu danych albo oszacowany z tej samej próby bez obniżenia liczby stopni swobody.
- Test zgodności do porównania dwóch grup – np. rozkładu odpowiedzi kobiet i mężczyzn. To pytanie o związek dwóch zmiennych, czyli test niezależności.
- Sam wynik ogólny bez wskazania, które kategorie odbiegają od oczekiwań, i bez wielkości efektu w.
Najczęstsze pytania
Co to jest test chi-kwadrat zgodności?
To test, który sprawdza, czy rozkład jednej zmiennej jakościowej w próbie zgadza się z rozkładem oczekiwanym – np. czy struktura wieku w ankiecie odpowiada strukturze populacji albo czy cztery odpowiedzi są wybierane równie często. Porównuje liczebności obserwowane z oczekiwanymi i daje statystykę χ² z k − 1 stopniami swobody.
Czym różni się test chi-kwadrat zgodności od testu niezależności?
Test zgodności dotyczy jednej zmiennej i porównuje jej rozkład z rozkładem teoretycznym ustalonym z góry. Test niezależności dotyczy dwóch zmiennych w tabeli krzyżowej i sprawdza, czy są ze sobą powiązane. Wzory są podobne, ale liczebności oczekiwane i stopnie swobody liczy się inaczej.
Jak obliczyć liczebności oczekiwane w teście zgodności?
Pomnóż liczebność próby przez oczekiwany odsetek każdej kategorii: E = N × π. Przy N = 400 i oczekiwanym odsetku 20% liczebność oczekiwana wynosi 80. Przy równych proporcjach każda kategoria ma E = N / k, np. 160 / 4 = 40.
Czy test chi-kwadrat zgodności potwierdza reprezentatywność próby?
Nie. Nieistotny wynik oznacza tylko, że w danej zmiennej nie wykryto odchylenia od struktury populacji – przy małej próbie test ma niską moc, a zgodność kilku rozkładów nie gwarantuje zgodności w innych cechach. O reprezentatywności decyduje przede wszystkim sposób doboru próby; test zgodności pomaga ją opisać i skontrolować.
Jak obliczyć wielkość efektu w teście chi-kwadrat zgodności?
Najczęściej podaje się w Cohena: w = √(χ² / N). Na przykład przy χ² = 27.72 i N = 400: w = 0.26. Konwencjonalne progi efektu małego, średniego i dużego to 0.10, 0.30 i 0.50.
Jak zapisać wynik testu chi-kwadrat zgodności w APA?
Użyj formatu χ²(df, N = …) = …, p = …, np. χ²(3, N = 400) = 27.72, p < .001, w = 0.26. Następnie opisz, które kategorie występowały częściej lub rzadziej, niż oczekiwano, podając odsetki obserwowane i oczekiwane.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Gdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikJak opisać charakterystykę próby badawczej?
Co uwzględnić w tekście i tabeli, jak dobrać miary opisowe oraz jak nie ukryć problemów z selekcją i brakami danych.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380 ● Otwarty dostęp
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Franke, T. M., Ho, T., & Christie, C. A. (2012). The chi-square test: Often used and more often misinterpreted. American Journal of Evaluation, 33(3), 448–458. https://doi.org/10.1177/1098214011426594
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Plackett, R. L. (1983). Karl Pearson and the chi-squared test. International Statistical Review, 51(1), 59–72. https://doi.org/10.2307/1402731
Cytowania BibTeX
@article{cochran1952chi, author={Cochran, William G.}, title={{The χ² test of goodness of fit}}, journal={The Annals of Mathematical Statistics}, year={1952}, volume={23}, number={3}, pages={315--345}, doi={10.1214/aoms/1177729380}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{franke2012chi, author={Franke, Todd Michael and Ho, Timothy and Christie, Christina A.}, title={{The chi-square test: Often used and more often misinterpreted}}, journal={American Journal of Evaluation}, year={2012}, volume={33}, number={3}, pages={448--458}, doi={10.1177/1098214011426594}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{pearson1900criterion, author={Pearson, Karl}, title={{On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling}}, journal={The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science}, year={1900}, volume={50}, number={302}, pages={157--175}, doi={10.1080/14786440009463897}}@article{plackett1983karl, author={Plackett, R. L.}, title={{Karl Pearson and the chi-squared test}}, journal={International Statistical Review}, year={1983}, volume={51}, number={1}, pages={59--72}, doi={10.2307/1402731}}