Kim był Gregor Mendel?
Gregor Mendel (1822–1884) był mnichem augustiańskim z Brna, który na podstawie krzyżowań grochu sformułował prawa dziedziczenia – dziś nazywane prawami Mendla (Pires i Branco, 2010). W październiku 1843 r. opat Cyrill Napp przyjął go jako nowicjusza do klasztoru św. Tomasza w Brnie, a potem umożliwił mu studia w Wiedniu, które Mendel ukończył w lipcu 1853 r. Uczył w szkole realnej, a w 1855 r. opat zbudował dla jego doświadczeń ogrzewaną szklarnię (van Dijk i in., 2018).
Krzyżowania prowadził w latach 1856–1863. W lutym i marcu 1865 r. przedstawił wyniki w Towarzystwie Przyrodniczym w Brnie, a w 1866 r. opublikował pracę „Versuche über Pflanzen-Hybriden” („Doświadczenia z mieszańcami roślin”). W marcu 1868 r. został opatem klasztoru; zmarł w styczniu 1884 r. Jego pracę doceniono dopiero w 1900 r. (van Dijk i in., 2018).
Najważniejsze pomysły
- Liczyć zamiast opisywać. Mendel badał siedem cech grochu o dwóch wyraźnych formach, np. nasiona okrągłe lub kanciaste. Przez co najmniej siedem lat kontrolował zapylenie około 29 tys. roślin i liczył, ile potomków ma każdą formę (Pires i Branco, 2010).
- Stosunek 3 : 1. W pierwszym pokoleniu mieszańców występowała tylko jedna forma (dominująca), a w następnym obie – mniej więcej w stosunku 3 : 1. Z wszystkich doświadczeń Mendel otrzymał średnio 2.98 : 1 (Abbott i Fairbanks, 2016).
- Niezależne łączenie cech. Gdy krzyżował rośliny różniące się dwiema cechami, otrzymywał cztery formy w proporcjach zgodnych z niezależnym dziedziczeniem każdej z nich: 315 nasion okrągłych żółtych, 101 kanciastych żółtych, 108 okrągłych zielonych i 32 kanciaste zielone (Abbott i Fairbanks, 2016) – blisko proporcji 9 : 3 : 3 : 1.
- Przypadek. Mendel nie znał testów statystycznych – jeszcze ich nie było – ale rozumiał rolę przypadku i zmienności (Pires i Branco, 2010). Losowy rozdział genów dał później nazwę randomizacji mendlowskiej.
Ciekawostka
Mnich, który mierzył pogodę. Mendel zbierał latami nie tylko dane o grochu. Najpierw pomagał w pomiarach meteorologicznych w szpitalu św. Anny w Brnie, a od lipca 1878 do lipca 1883 r. sam prowadził pomiary na terenie opactwa jako obserwator austriackiej służby meteorologicznej. Fachowo opisał trąbę powietrzną, która w październiku 1870 r. przeszła nad Brnem (Rožnovský, 2023).
Po 1870 r. hodował też pszczoły w doświadczalnej pasiece w ogrodzie klasztornym (van Dijk i in., 2018).
Przykład na historycznych danych
Liczebności przepisaliśmy z przekładu pracy Mendla (Abbott i Fairbanks, 2016) i z tabel Piresa i Branco (2010). Dla siedmiu doświadczeń z jedną cechą test chi-kwadrat zgodności z proporcją 3 : 1 daje bardzo małe χ²: od 0.015 (barwa liścieni, 6022 : 2001) do 0.607 (długość łodygi, 787 : 277), a wszystkie p leżą między .436 a .903.
Fisher (1936) zsumował jednak statystyki ze wszystkich doświadczeń – suma niezależnych statystyk χ² ma rozkład chi-kwadrat z sumą stopni swobody. Odtworzyliśmy jego tabelę V: siedem doświadczeń 3 : 1 daje χ²(7) = 2.14, osiem testów potomstwa w proporcji 2 : 1 – χ²(8) = 5.17, doświadczenie z dwiema cechami – χ²(8) = 2.81, z gametami – χ²(15) = 3.67, a z trzema cechami – χ²(26) = 15.32. Razem χ²(64) = 29.12, czyli mniej niż połowa wartości oczekiwanej (64). Prawdopodobieństwo, że czysty przypadek da dopasowanie tak dobre lub lepsze, wynosi 0.00005 – mniej więcej 1 na 20 000. Fisher podał 0.99987 jako prawdopodobieństwo gorszego dopasowania – liczył rozkład χ² inaczej (Pires i Branco, 2010).
W symulacji 10 000 powtórzeń wszystkich doświadczeń przy prawdziwych proporcjach Mendla średnia suma wyniosła 63.96 i ani razu nie spadła do 29.12. Gdy doświadczenia o p < .201 „powtarzano” i zostawiano lepszy wynik (uproszczony model selekcji; Pires i Branco, 2010), średnia spadła do 49.07, a tak dobre dopasowanie jak u Mendla pojawiło się w 0.21% symulacji.
Na rysunku
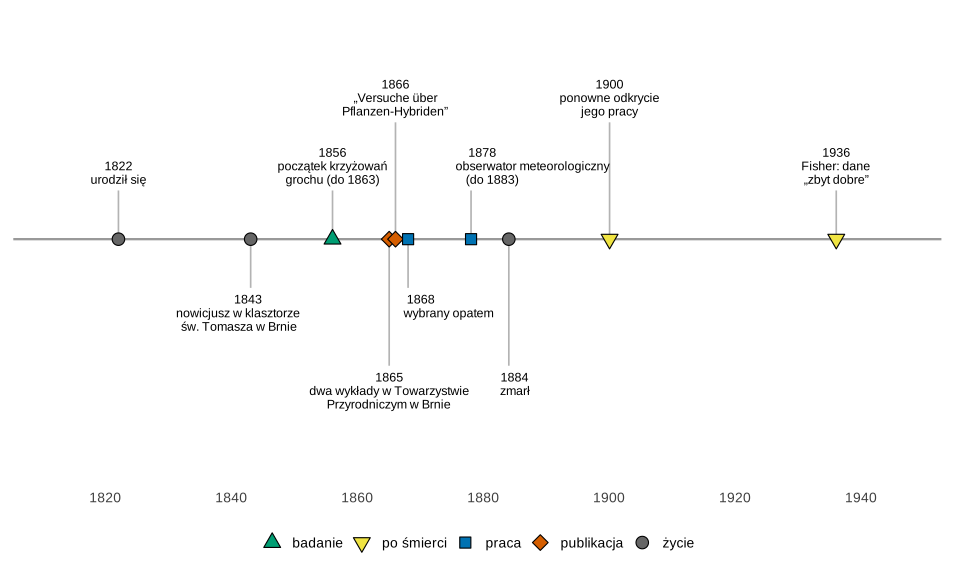
Co widać. Od publikacji do ponownego odkrycia minęły 34 lata, a spór o dane zaczął się jeszcze później.
Na co uważać. Cytowane opracowania nie podają dnia ani miejsca urodzenia Mendla, więc ich nie wpisujemy. Rok 1878 to początek samodzielnych pomiarów pogody.
Podpis do pracy:
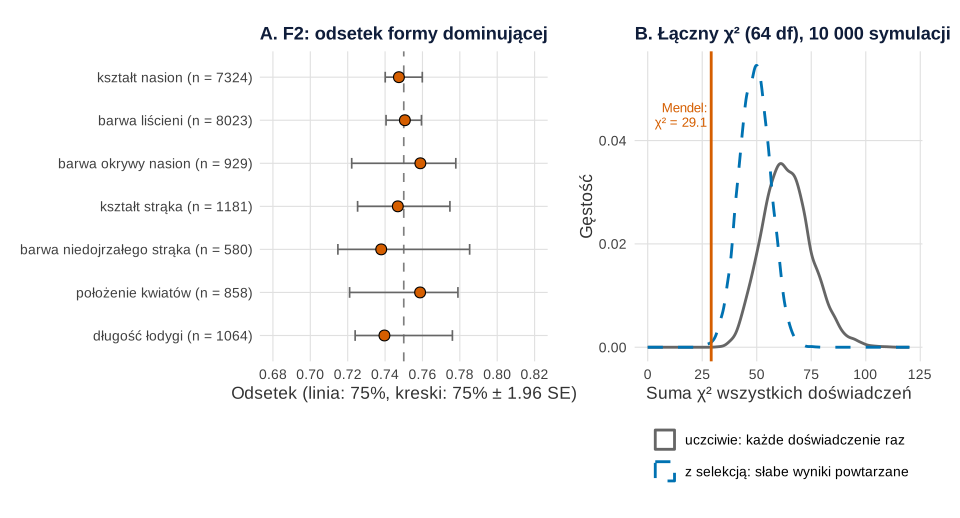
Co widać. Na panelu A wyniki Mendla leżą bliżej 75%, niż zwykle pozwala przypadek: przy losowych wynikach mniej więcej co trzecie doświadczenie odbiega od 75% o więcej niż jeden błąd standardowy (około połowy kreski), a u Mendla żadne z siedmiu. Przy prawdziwej proporcji 3 : 1 zdarza się to z prawdopodobieństwem 0.069. Na panelu B wynik Mendla leży na lewym skraju rozkładu uczciwych powtórzeń, a nawet rozkładu z selekcją.
Na co uważać. Zbyt dobre dopasowanie nie dowodzi oszustwa – mówi tylko, że dane nie zachowują się jak niezależne losowania. Nasza symulacja selekcji jest uproszczona: Pires i Branco (2010) stosowali ją do 84 doświadczeń dwumianowych, a my do całych doświadczeń, więc nie odtwarzamy ich wniosku, że selekcja tłumaczy całe dopasowanie. Próg .201 to ich oszacowanie.
Podpis do pracy:
Gdzie spotkasz Mendla w swojej pracy
Doświadczenia Mendla to podręcznikowy przykład testu chi-kwadrat zgodności. W praktyce:
- strukturę próby albo odpowiedzi porównujesz z przewidywaniem tak samo jak Mendla z proporcją 3 : 1 – zob. wpis Test chi-kwadrat krok po kroku;
- bardzo duża wartość p nie „potwierdza” teorii; seria wartości bliskich 1 może sygnalizować problem z danymi, tak jak seria wartości tuż poniżej .05 – p-hacking;
- zgodność dużej liczby wartości p z rozkładem jednostajnym sprawdza się testem Kołmogorowa–Smirnowa i dystrybuantą empiryczną – tak Pires i Branco (2010) analizowali 84 wartości p Mendla;
- liczba roślin formy dominującej ma rozkład dwumianowy – z niego bierze się zakres na rysunku 2.
Test opisał Karl Pearson w 1900 r.; pierwszą statystyczną analizę danych Mendla ogłoszono w 1902 r. w „Biometrice” (Pires i Branco, 2010).
Spory, mity i trudne strony
- Czy Mendel fałszował dane? Ronald Fisher (1936) uznał, że dane większości doświadczeń poprawiono, by zgadzały się z oczekiwaniami, i wskazał jako możliwego sprawcę asystenta. Już w 1911 r. jako student sugerował, że Mendel mógł nieświadomie zaliczać wątpliwe rośliny na korzyść hipotezy (Pires i Branco, 2010).
- Spór trwa. Z lat 1964–2007 pochodzi co najmniej 50 prac na ten temat (Pires i Branco, 2010). Autorzy książki „Ending the Mendel–Fisher Controversy” odrzucają zarzuty Fishera z wyjątkiem „zbyt dobrego” dopasowania (Franklin i in., 2008). Pires i Branco proponują wyjaśnienie bez oszustwa: doświadczenia z wynikiem odbiegającym od teorii były powtarzane, a raportowano lepszy wynik – co dziś nazwalibyśmy selektywnym raportowaniem.
- Teoria była poprawna. Spór dotyczy sposobu zebrania i przedstawienia danych, nie samych praw dziedziczenia – Pires i Branco (2010) podkreślają, że wyniki Mendla są w istocie poprawne.
Dane Mendla w R
Kod wpisuje liczebności z pracy Mendla (1866) według przekładu Abbotta i Fairbanksa (2016) oraz tabel 1–4 Piresa i Branco (2010), liczy test chi-kwadrat zgodności dla siedmiu doświadczeń z jedną cechą, odtwarza tabelę V Fishera (1936) bez „ilustracji zmienności roślin” i symuluje 10 000 powtórzeń wszystkich doświadczeń bez selekcji i z selekcją wyników, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1866); próg selekcji 0.201 to oszacowanie Piresa i Branco (2010).
1. Test chi-kwadrat i „zbyt dobre” dopasowanie: rysunek 2
Kod R rysunku 2
# Gregor Mendel: test chi-kwadrat zgodności dla jego liczebności i „zbyt dobre” dopasowanie (Fisher, 1936)
# Liczebności: Mendel (1866) w przekładzie Abbotta i Fairbanksa (2016) oraz tabele 1–4 u Piresa i Branco (2010)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(mendel = "#D55E00", uczciwe = "grey40", selekcja = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# 1. Siedem doświadczeń z jedną cechą, pokolenie F2: forma dominująca i recesywna, oczekiwany stosunek 3 : 1
f2 <- data.frame(
  cecha = c("kształt nasion", "barwa liścieni", "barwa okrywy nasion", "kształt strąka",
            "barwa niedojrzałego strąka", "położenie kwiatów", "długość łodygi"),
  dominujaca = c(5474, 6022, 705, 882, 428, 651, 787),
  recesywna  = c(1850, 2001, 224, 299, 152, 207, 277))
f2$n <- f2$dominujaca + f2$recesywna
f2$stosunek <- round(f2$dominujaca / f2$recesywna, 2)
f2$chi2 <- sapply(seq_len(nrow(f2)), function(i)
  unname(chisq.test(c(f2$dominujaca[i], f2$recesywna[i]), p = c(3, 1) / 4)$statistic))
f2$p <- round(pchisq(f2$chi2, df = 1, lower.tail = FALSE), 3)
f2$chi2 <- round(f2$chi2, 3)
f2
c(srednia_proporcja = round(sum(f2$dominujaca) / sum(f2$recesywna), 2))   # Mendel: 2.98 : 1
# Ile doświadczeń odbiega od 3 : 1 o więcej niż 1 SE (chi2 > 1) i jak często żadne z 7, gdy 3 : 1 jest prawdziwe
c(powyzej_1_SE = sum(f2$chi2 > 1), P_zadne_z_7 = round(pchisq(1, df = 1)^7, 3))

# 2. Wszystkie doświadczenia z tabeli V Fishera (bez „ilustracji zmienności roślin”): liczebności i oczekiwane proporcje
r121 <- c(1, 2, 1) / 4
dosw <- c(
  lapply(seq_len(nrow(f2)), function(i) list(grupa = "3 : 1", o = c(f2$dominujaca[i], f2$recesywna[i]), p = c(3, 1) / 4)),
  lapply(list(c(372, 193), c(353, 166), c(64, 36), c(71, 29), c(60, 40), c(67, 33), c(72, 28), c(65, 35)),
         function(o) list(grupa = "2 : 1", o = o, p = c(2, 1) / 3)),       # potomstwo roślin F2: Aa : AA
  list(list(grupa = "dwie cechy", p = as.vector(outer(r121, r121)),         # 9 genotypów (AA, Aa, aa w wierszach BB, Bb, bb), 1:2:1:2:4:2:1:2:1
            o = c(38, 60, 28, 65, 138, 68, 35, 67, 30))),
  lapply(list(c(20, 23, 25, 22), c(31, 26, 27, 26), c(25, 19, 22, 21), c(24, 25, 22, 27), c(47, 40, 38, 41)),
         function(o) list(grupa = "gamety 1 : 1 : 1 : 1", o = o, p = rep(1 / 4, 4))),
  list(list(grupa = "trzy cechy", p = as.vector(outer(outer(r121, r121), r121)),   # 27 genotypów: bloki CC, Cc, cc
            o = c(8, 14, 8, 15, 49, 19, 9, 20, 10,  22, 38, 25, 45, 78, 36, 17, 40, 20,  14, 18, 10, 18, 48, 24, 11, 16, 7))))
chi2_dosw <- function(o, p) sum((o - sum(o) * p)^2 / (sum(o) * p))
wyn <- data.frame(grupa = sapply(dosw, `[[`, "grupa"),
                  chi2 = sapply(dosw, function(d) chi2_dosw(d$o, d$p)),
                  df = sapply(dosw, function(d) length(d$p) - 1))
tab_v <- aggregate(cbind(chi2, df) ~ grupa, data = wyn, FUN = sum)
tab_v$P_wiekszego <- round(pchisq(tab_v$chi2, tab_v$df, lower.tail = FALSE), 4)
tab_v$chi2 <- round(tab_v$chi2, 4)
tab_v
razem <- c(chi2 = sum(wyn$chi2), df = sum(wyn$df))
round(c(razem, P_wiekszego = pchisq(razem[["chi2"]], razem[["df"]], lower.tail = FALSE),
        P_lepszego = pchisq(razem[["chi2"]], razem[["df"]])), 5)

# 3. Symulacja: 10 000 powtórzeń wszystkich doświadczeń, gdy prawdziwe są proporcje Mendla
#    „uczciwie” – każde doświadczenie raz; „z selekcją” – gdy p < .201, doświadczenie powtórzono
#    i podano lepszy wynik (uproszczony model A Piresa i Branco, 2010; alfa to ich oszacowanie)
set.seed(1866)
R <- 10000; alfa <- 0.201
symuluj <- function(d, selekcja) {
  n <- sum(d$o); e <- n * d$p; df <- length(d$p) - 1
  x2 <- colSums((rmultinom(R, n, d$p) - e)^2 / e)
  if (selekcja) {
    druga <- colSums((rmultinom(R, n, d$p) - e)^2 / e)
    powt <- pchisq(x2, df, lower.tail = FALSE) < alfa
    x2[powt] <- pmin(x2[powt], druga[powt])
  }
  x2
}
suma_uczciwe  <- Reduce(`+`, lapply(dosw, symuluj, selekcja = FALSE))
suma_selekcja <- Reduce(`+`, lapply(dosw, symuluj, selekcja = TRUE))
round(c(srednia_uczciwe = mean(suma_uczciwe), srednia_selekcja = mean(suma_selekcja),
        odsetek_uczciwe_lepszych = mean(suma_uczciwe <= razem[["chi2"]]),
        odsetek_selekcja_lepszych = mean(suma_selekcja <= razem[["chi2"]])), 4)

# Rysunek 2A: odsetek formy dominującej w 7 doświadczeniach F2 i zakres 95% oczekiwany przy 3 : 1
f2$odsetek <- f2$dominujaca / f2$n
f2$dolna <- 0.75 - 1.96 * sqrt(0.75 * 0.25 / f2$n)
f2$gorna <- 0.75 + 1.96 * sqrt(0.75 * 0.25 / f2$n)
f2$etykieta <- factor(paste0(f2$cecha, " (n = ", f2$n, ")"), levels = rev(paste0(f2$cecha, " (n = ", f2$n, ")")))
pA <- ggplot(f2, aes(odsetek, etykieta)) +
  geom_vline(xintercept = 0.75, colour = "grey50", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, colour = kol[["uczciwe"]], orientation = "y") +
  geom_point(shape = 21, size = 3.4, fill = kol[["mendel"]], colour = "black") +
  scale_x_continuous(limits = c(0.68, 0.82), breaks = seq(0.68, 0.82, 0.02)) +
  labs(title = "A. F2: odsetek formy dominującej",
       x = "Odsetek (linia: 75%, kreski: 75% ± 1.96 SE)", y = NULL) +
  motyw
# Rysunek 2B: rozkład łącznego chi-kwadrat (64 df) w symulacji i wynik Mendla
sym <- data.frame(chi2 = c(suma_uczciwe, suma_selekcja),
                  model = rep(c("uczciwie: każde doświadczenie raz", "z selekcją: słabe wyniki powtarzane"), each = R))
pB <- ggplot(sym, aes(chi2, colour = model, linetype = model)) +
  geom_density(linewidth = 1) +
  geom_vline(xintercept = razem[["chi2"]], colour = kol[["mendel"]], linewidth = 1) +
  annotate("text", x = razem[["chi2"]] - 2, y = 0.045, label = sprintf("Mendel:\nχ² = %.1f", razem[["chi2"]]),
           hjust = 1, size = 3.5, colour = kol[["mendel"]], lineheight = 0.9) +
  scale_colour_manual(values = c(kol[["uczciwe"]], kol[["selekcja"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(limits = c(0, 120)) +
  labs(title = "B. Łączny χ² (64 df), 10 000 symulacji",
       x = "Suma χ² wszystkich doświadczeń", y = "Gęstość") +
  motyw + guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))
p2 <- pA + pB + plot_layout(widths = c(1, 1))
p2
Wynik w R
                       cecha dominujaca recesywna    n stosunek  chi2     p
1             kształt nasion       5474      1850 7324     2.96 0.263 0.608
2             barwa liścieni       6022      2001 8023     3.01 0.015 0.903
3        barwa okrywy nasion        705       224  929     3.15 0.391 0.532
4             kształt strąka        882       299 1181     2.95 0.064 0.801
5 barwa niedojrzałego strąka        428       152  580     2.82 0.451 0.502
6          położenie kwiatów        651       207  858     3.14 0.350 0.554
7             długość łodygi        787       277 1064     2.84 0.607 0.436
srednia_proporcja
             2.98
powyzej_1_SE  P_zadne_z_7
       0.000        0.069
                 grupa    chi2 df P_wiekszego
1                2 : 1  5.1733  8      0.7389
2                3 : 1  2.1389  7      0.9518
3           dwie cechy  2.8110  8      0.9457
4 gamety 1 : 1 : 1 : 1  3.6730 15      0.9986
5           trzy cechy 15.3224 26      0.9511
       chi2          df P_wiekszego  P_lepszego
   29.11850    64.00000     0.99995     0.00005
          srednia_uczciwe          srednia_selekcja  odsetek_uczciwe_lepszych
                  63.9619                   49.0672                    0.0000
odsetek_selekcja_lepszych
                   0.0021
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Gregor Mendel, 1822–1884, i losy jego pracy – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1822, 1843, 1856, 1865, 1866, 1868, 1878, 1884, 1900, 1936),
  opis = c("urodził się", "nowicjusz w klasztorze\nśw. Tomasza w Brnie", "początek krzyżowań\ngrochu (do 1863)",
           "dwa wykłady w Towarzystwie\nPrzyrodniczym w Brnie", "„Versuche über\nPflanzen-Hybriden”", "wybrany opatem",
           "obserwator meteorologiczny\n(do 1883)", "zmarł", "ponowne odkrycie\njego pracy", "Fisher: dane\n„zbyt dobre”"),
  rodzaj = c("życie", "życie", "badanie", "publikacja", "publikacja", "praca", "praca", "życie", "po śmierci", "po śmierci"))
# Gęste lata 1856–1884: etykiety nad (1) i pod (−1) osią, na dwóch wysokościach, częściowo przesunięte w bok
zdarzenia$strona     <- c(1, -1, 1, -1, 1, -1, 1, -1, 1, 1)
zdarzenia$poziom     <- c(0.5, 0.5, 0.5, 1.3, 1.2, 0.5, 0.5, 1.3, 1.2, 0.5)
zdarzenia$wyrownanie <- c(0.5, 0.6, 0.5, 0.5, 0.5, 0.05, 0.1, 0.3, 0.5, 0.5)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "badanie" = 24, "po śmierci" = 25)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "badanie" = "#009E73",
            "po śmierci" = "#F0E442")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = (poziom + 0.07) * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.3, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1812, 1946), breaks = seq(1820, 1940, by = 20)) +
  scale_y_continuous(limits = c(-2.3, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test chi-kwadrat – funkcja chisq.test(), rozkład χ² – pchisq(), losowanie – rmultinom() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Gregor Mendel?
Mnichem augustiańskim z klasztoru św. Tomasza w Brnie (1822–1884), nauczycielem, a od 1868 r. opatem. W latach 1856–1863 krzyżował groch, w 1866 r. opublikował prawa dziedziczenia, a jego pracę doceniono dopiero w 1900 r. (van Dijk i in., 2018).
Czy Mendel sfałszował swoje wyniki?
Nie wiadomo. Fisher (1936) uznał dane za poprawione i wskazał jako możliwego sprawcę asystenta. Autorzy późniejszych prac odrzucają większość jego zarzutów, ale nie zbyt dobre dopasowanie; Pires i Branco (2010) tłumaczą je powtarzaniem doświadczeń o słabszym wyniku i raportowaniem lepszego.
Dlaczego dane Mendla nazywa się zbyt dobrymi?
Bo suma statystyk chi-kwadrat ze wszystkich jego doświadczeń jest dużo mniejsza od oczekiwanej. W R dla 64 stopni swobody wychodzi χ² = 29.12, a dopasowanie tak dobre lub lepsze zdarza się przypadkiem z prawdopodobieństwem około 0.00005.
Jak sprawdzić stosunek 3 : 1 testem chi-kwadrat?
Porównaj liczebności obserwowane z oczekiwanymi 75% i 25% testem chi-kwadrat zgodności z jednym stopniem swobody. Dla 5474 nasion okrągłych i 1850 kanciastych Mendla wychodzi χ²(1) = 0.263, p = .608, czyli wynik zgodny z proporcją 3 : 1.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Abbott, S., & Fairbanks, D. J. (2016). Experiments on plant hybrids by Gregor Mendel. Genetics, 204(2), 407–422. https://doi.org/10.1534/genetics.116.195198 ● Otwarty dostęp
- Fisher, R. A. (1936). Has Mendel’s work been rediscovered? Annals of Science, 1(2), 115–137. https://doi.org/10.1080/00033793600200111
- Franklin, A., Edwards, A. W. F., Fairbanks, D. J., Hartl, D. L., & Seidenfeld, T. (2008). Ending the Mendel–Fisher controversy. University of Pittsburgh Press.
- Pires, A. M., & Branco, J. A. (2010). A statistical model to explain the Mendel–Fisher controversy. Statistical Science, 25(4), 545–565. https://doi.org/10.1214/10-sts342 ● Otwarty dostęp
- Rožnovský, J. (2023). Meteorological activities of J. G. Mendel as part of a tour of the Augustinian Abbey. In Public recreation and landscape protection – with environment hand in hand? Proceedings of the 14th Conference (pp. 158–162). Mendel University in Brno. https://doi.org/10.11118/978-80-7509-904-4-0158 ● Otwarty dostęp
- van Dijk, P. J., Weissing, F. J., & Ellis, T. H. N. (2018). How Mendel’s interest in inheritance grew out of plant improvement. Genetics, 210(2), 347–355. https://doi.org/10.1534/genetics.118.300916 ● Otwarty dostęp
Cytowania BibTeX
@article{abbott2016experiments, author={Abbott, Scott and Fairbanks, Daniel J.}, title={{Experiments on plant hybrids by Gregor Mendel}}, journal={Genetics}, year={2016}, volume={204}, number={2}, pages={407--422}, doi={10.1534/genetics.116.195198}}@article{fisher1936has, author={Fisher, Ronald A.}, title={{Has Mendel’s work been rediscovered?}}, journal={Annals of Science}, year={1936}, volume={1}, number={2}, pages={115--137}, doi={10.1080/00033793600200111}}@book{franklin2008ending, author={Franklin, Allan and Edwards, A. W. F. and Fairbanks, Daniel J. and Hartl, Daniel L. and Seidenfeld, Teddy}, title={{Ending the Mendel–Fisher controversy}}, year={2008}, publisher={University of Pittsburgh Press}, url={https://upittpress.org/books/9780822959861/}}@article{pires2010statistical, author={Pires, Ana M. and Branco, João A.}, title={{A statistical model to explain the Mendel–Fisher controversy}}, journal={Statistical Science}, year={2010}, volume={25}, number={4}, pages={545--565}, doi={10.1214/10-sts342}}@inproceedings{roznovsky2023meteorological, author={Rožnovský, Jaroslav}, title={{Meteorological activities of J. G. Mendel as part of a tour of the Augustinian Abbey}}, booktitle={Public recreation and landscape protection – with environment hand in hand? Proceedings of the 14th Conference}, year={2023}, pages={158--162}, publisher={Mendel University in Brno}, doi={10.11118/978-80-7509-904-4-0158}}@article{vandijk2018how, author={van Dijk, Peter J. and Weissing, Franz J. and Ellis, T. H. Noel}, title={{How Mendel’s interest in inheritance grew out of plant improvement}}, journal={Genetics}, year={2018}, volume={210}, number={2}, pages={347--355}, doi={10.1534/genetics.118.300916}}