Co to jest randomizacja mendlowska?
Randomizacja mendlowska (ang. Mendelian randomization, MR) wykorzystuje warianty genetyczne związane z ekspozycją jako zmienne instrumentalne, by ocenić, czy ekspozycja, np. stężenie cholesterolu, wpływa przyczynowo na wynik. Nazwa nawiązuje do losowego rozdziału genów od rodziców do potomstwa przy powstawaniu gamet i poczęciu (Davey Smith i Ebrahim, 2003). Związek wariantu z chorobą zwykle nie podlega odwrotnej przyczynowości ani zakłóceniu, które zniekształcają klasyczne badania obserwacyjne, dlatego metodę porównuje się do badania z randomizacją (Lawlor i in., 2008).
Założenia instrumentu
- Wariant jest wyraźnie związany z ekspozycją (silny instrument).
- Wariant nie jest związany z zakłócaczami związku ekspozycji z wynikiem.
- Wariant wpływa na wynik wyłącznie przez ekspozycję.
Davey Smith i Ebrahim (2003) wymieniają ograniczenia: zakłócenie przez sprzężony wariant, kilka efektów fenotypowych jednego polimorfizmu (plejotropię), brak odpowiednich wariantów dla wielu ekspozycji oraz kanalizację, czyli buforowanie skutków zmienności genetycznej w rozwoju. Dwa ostatnie założenia sprawdza się tylko częściowo, więc wynik MR nie zastępuje rozważań z hasła korelacja a przyczynowość.
Estymatory Walda i IVW
Najprostszy jest estymator Walda: iloraz związku wariantu z wynikiem i związku wariantu z ekspozycją. Przy wielu wariantach ilorazy łączy się średnią ważoną odwrotnością wariancji (IVW), podobnie jak w metaanalizie. Burgess i in. (2013) pokazali, że IVW na danych zagregowanych z badań asocjacyjnych całego genomu daje oszacowania i precyzję podobne do 2SLS na danych indywidualnych, ale zawyża precyzję, gdy warianty są ze sobą sprzężone.
W przykładzie z R prawdziwy efekt ekspozycji wynosi 0.20. Zwykła regresja daje 0.685, bo niezmierzone zakłócenie działa na ekspozycję i wynik. Estymator Walda dla jednego wariantu daje 0.206, a IVW z pięciu wariantów 0.235 (95% CI: 0.090–0.380). Przedział jest szeroki, bo warianty wyjaśniają małą część zmienności ekspozycji.
Na rysunku
Podstawowy rysunek analizy MR to wykres rozrzutu: każdy punkt to jeden wariant, na osi poziomej jego efekt na ekspozycję, na pionowej – na wynik. Estymator IVW to nachylenie prostej przechodzącej przez zero. MR-Egger dopuszcza wyraz wolny różny od zera, który mierzy przeciętną plejotropię kierunkową (Bowden i in., 2015). Dane są symulowane: dwie próby po 20 000 osób, 25 wariantów, prawdziwy efekt 0.20. Efekty wariantów (0.05–0.20 na ekspozycję, 0–0.03 bezpośrednio na wynik w panelu B) ustawiono ręcznie; ziarna nie zmieniano.
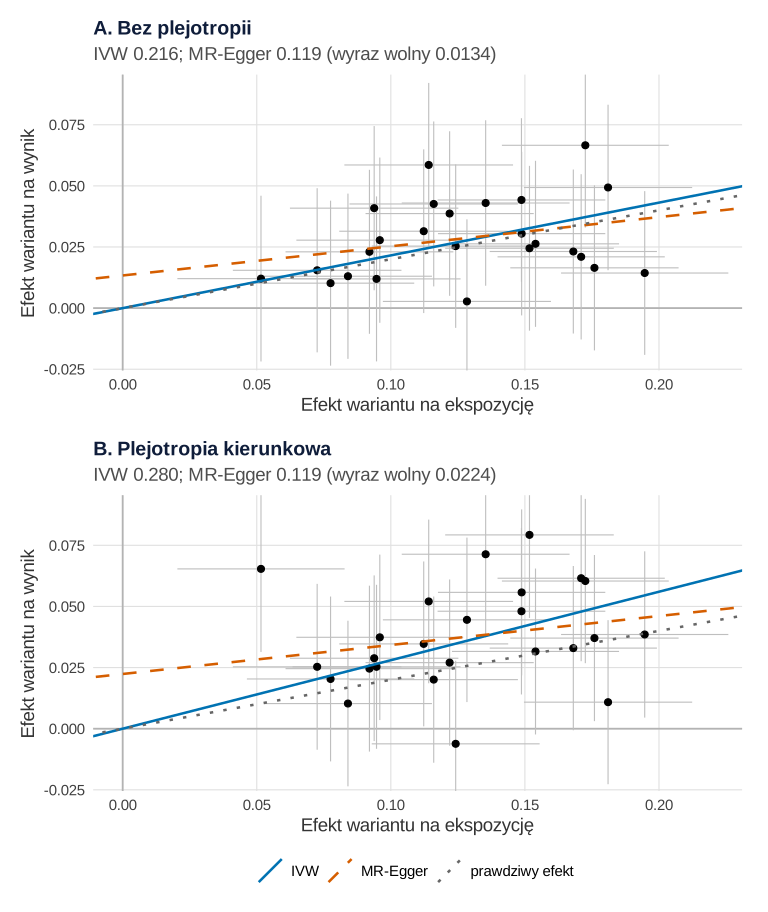
set.seed(57802)).Co widać. Bez plejotropii IVW daje 0.216 (95% CI [0.165, 0.267]) i obejmuje prawdziwe 0.20. Gdy warianty wpływają na wynik także z pominięciem ekspozycji, wszystkie punkty przesuwają się w górę, a prosta IVW staje się bardziej stroma: 0.280, 95% CI [0.218, 0.342], czyli przedział już nie obejmuje prawdy. MR-Egger w obu panelach daje 0.119 z bardzo szerokim przedziałem (w panelu B od −0.094 do 0.331). Wyraz wolny jest większy przy plejotropii (0.0224 wobec 0.0134), ale nie jest istotny (p = .12).
Na co uważać. Brak istotnego wyrazu wolnego nie dowodzi braku plejotropii – przy 25 wariantach test ma małą moc, a MR-Egger płaci za odporność dużą niepewnością. Działa tylko wtedy, gdy plejotropia nie zależy od siły wariantu (założenie InSIDE). Wykres nie pokazuje też sprzężenia wariantów ani tego, czy obie próby pochodzą z tej samej populacji. Kierunek osi zależy od kodowania alleli: przed analizą Eggera warianty orientuje się tak, by efekt na ekspozycję był dodatni. Podobny wykres i logikę ważenia zna się z metaanalizy na obrazkach i testu Eggera.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby (set.seed(57802), kilka sekund). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tych samych obiektów A$p i B$p z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Wykres rozrzutu MR: efekt wariantów na wynik vs na ekspozycję, proste IVW i MR-Egger
library(ggplot2)
library(patchwork)
library(MendelianRandomization)

# Paleta Okabe–Ito; metody odróżnia też typ linii
kol <- c("IVW" = "#0072B2", "MR-Egger" = "#D55E00", "prawdziwy efekt" = "grey40")
lin <- c("IVW" = "solid", "MR-Egger" = "dashed", "prawdziwy efekt" = "dotted")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Dwie próby (jak w MR na danych zagregowanych): w jednej liczymy efekty wariantów na ekspozycję,
# w drugiej – na wynik. Prawdziwy efekt X na Y = 0.20; 25 wariantów, częstość allelu 0.3.
set.seed(57802)
n <- 20000; k <- 25; beta <- 0.20
gamma <- runif(k, 0.05, 0.20)              # efekty wariantów na ekspozycję
alfa  <- runif(k, 0, 0.03)                 # bezpośrednie efekty wariantów na wynik (plejotropia)
proba <- function(plejotropia) {
  G <- matrix(rbinom(n * k, 2, 0.3), n, k); U <- rnorm(n)
  X <- drop(G %*% gamma) + U + rnorm(n)
  Y <- beta * X + plejotropia * drop(G %*% alfa) + U + rnorm(n)
  list(G = G, X = X, Y = Y)
}
wsp <- function(y, G) t(apply(G, 2, function(g) summary(lm(y ~ g))$coef[2, 1:2]))
ekspoz <- proba(0)                          # próba do efektów na ekspozycję
bx <- wsp(ekspoz$X, ekspoz$G)

analiza <- function(plejotropia, tytul) {
  wyn <- proba(plejotropia)                 # osobna próba do efektów na wynik
  by <- wsp(wyn$Y, wyn$G)
  wej <- mr_input(bx = bx[, 1], bxse = bx[, 2], by = by[, 1], byse = by[, 2])
  ivw <- mr_ivw(wej); egg <- mr_egger(wej)
  tab <- c(IVW = ivw@Estimate, IVW_dolna = ivw@CILower, IVW_gorna = ivw@CIUpper,
           Egger = egg@Estimate, Egger_dolna = egg@CILower.Est, Egger_gorna = egg@CIUpper.Est,
           Egger_wyraz_wolny = egg@Intercept, wyraz_wolny_p = egg@Pvalue.Int)
  d <- data.frame(bx = bx[, 1], sx = bx[, 2], by = by[, 1], sy = by[, 2])
  linie <- data.frame(metoda = factor(names(kol), levels = names(kol)),
                      a = c(0, egg@Intercept, 0), b = c(ivw@Estimate, egg@Estimate, beta))
  p <- ggplot(d, aes(bx, by)) +
    geom_hline(yintercept = 0, colour = "grey70") + geom_vline(xintercept = 0, colour = "grey70") +
    geom_errorbar(aes(ymin = by - 1.96 * sy, ymax = by + 1.96 * sy), width = 0, colour = "grey75", linewidth = 0.4) +
    geom_errorbar(aes(xmin = bx - 1.96 * sx, xmax = bx + 1.96 * sx), width = 0, colour = "grey75", linewidth = 0.4, orientation = "y") +
    geom_point(size = 2) +
    geom_abline(data = linie, aes(intercept = a, slope = b, colour = metoda, linetype = metoda),
                linewidth = 0.9) +
    scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
    coord_cartesian(xlim = c(0, 0.22), ylim = c(-0.02, 0.09)) +
    labs(title = tytul, subtitle = sprintf("IVW %.3f; MR-Egger %.3f (wyraz wolny %.4f)",
                                           ivw@Estimate, egg@Estimate, egg@Intercept),
         x = "Efekt wariantu na ekspozycję", y = "Efekt wariantu na wynik") + motyw
  list(tab = round(tab, 4), p = p)
}
A <- analiza(0, "A. Bez plejotropii")
B <- analiza(1, "B. Plejotropia kierunkowa")
rbind(bez_plejotropii = A$tab, z_plejotropia = B$tab)
range(bx[, 1] / bx[, 2])^2                   # zakres statystyki F pojedynczych wariantów

p1 <- A$p + B$p + plot_layout(ncol = 1, guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("randomizacja-mendlowska-ivw-egger.svg", p1, width = 8, height = 9.5)
Wynik w R
                   IVW IVW_dolna IVW_gorna  Egger Egger_dolna Egger_gorna
bez_plejotropii 0.2158    0.1651    0.2665 0.1194     -0.0588      0.2976
z_plejotropia   0.2801    0.2179    0.3423 0.1185     -0.0935      0.3305
                Egger_wyraz_wolny wyraz_wolny_p
bez_plejotropii            0.0134        0.2686
z_plejotropia              0.0224        0.1192
[1]  10.51137 149.68833
Jak opisać w pracy
Estymator Walda i IVW w R
Kod symuluje dane z niezmierzonym zakłóceniem, porównuje zwykłą regresję z estymatorem Walda i IVW liczonym ręcznie. Analogiczne wywołanie funkcji mr_ivw() z pakietu MendelianRandomization pokazano w komentarzu.
Wald, IVW i obciążona regresja
R
# Randomizacja mendlowska na danych symulowanych: prawdziwy efekt X na Y = 0.20
set.seed(57801)
n <- 10000; k <- 5
G <- sapply(1:k, function(j) rbinom(n, 2, 0.3))   # 5 wariantów genetycznych (0/1/2 allele)
U <- rnorm(n)                                      # niezmierzone zakłócenie
X <- drop(G %*% rep(0.15, k)) + U + rnorm(n)       # ekspozycja
Y <- 0.20 * X + U + rnorm(n)                       # wynik
# Zwykła regresja Y na X jest obciążona przez U
b_ols <- coef(lm(Y ~ X))[2]
# Estymator Walda (iloraz) dla pierwszego wariantu
bx <- sapply(1:k, function(j) coef(lm(X ~ G[, j]))[2])
by <- sapply(1:k, function(j) coef(lm(Y ~ G[, j]))[2])
se_y <- sapply(1:k, function(j) summary(lm(Y ~ G[, j]))$coef[2, 2])
se_x <- sapply(1:k, function(j) summary(lm(X ~ G[, j]))$coef[2, 2])
wald1 <- by[1] / bx[1]
# IVW: ważone połączenie ilorazów wszystkich wariantów
ivw <- sum(bx * by / se_y^2) / sum(bx^2 / se_y^2)
se_ivw <- 1 / sqrt(sum(bx^2 / se_y^2))
round(c(OLS = unname(b_ols), Wald_wariant1 = unname(wald1), IVW = ivw,
        IVW_dolna = ivw - 1.96 * se_ivw, IVW_gorna = ivw + 1.96 * se_ivw), 3)
# ten sam estymator IVW w pakiecie MendelianRandomization:
# library(MendelianRandomization)
# mr_ivw(mr_input(bx = bx, bxse = se_x, by = by, byse = se_y))
Wynik w R
          OLS Wald_wariant1           IVW     IVW_dolna     IVW_gorna
        0.685         0.206         0.235         0.090         0.380
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). Rysunek 1 i jego oszacowania IVW i MR-Egger policzono w pakiecie MendelianRandomization, narysowano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MendelianRandomization (wersja 0.10.0): Burgess, S., & Yavorska, O. (2024). MendelianRandomization: Mendelian randomization package [R package]. https://doi.org/10.32614/CRAN.package.MendelianRandomization
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym jest plejotropia w randomizacji mendlowskiej?
To sytuacja, w której wariant genetyczny wpływa na kilka cech naraz, a przez którąś z nich na wynik z pominięciem badanej ekspozycji. Narusza to założenie, że wariant działa na wynik wyłącznie przez ekspozycję, i obciąża oszacowanie (Davey Smith i Ebrahim, 2003).
Czy randomizację mendlowską można prowadzić na danych zagregowanych?
Tak. Wystarczą opublikowane współczynniki związku wariantów z ekspozycją i z wynikiem. Burgess i in. (2013) pokazali, że estymator IVW z takich danych daje wyniki podobne do analizy danych indywidualnych, o ile warianty nie są ze sobą sprzężone.
Czym randomizacja mendlowska różni się od badania randomizowanego?
W badaniu randomizowanym badacz losuje interwencję, a w MR losowość pochodzi z dziedziczenia alleli. Wariant działa przez całe życie i zwykle słabo, więc MR szacuje długotrwały wpływ ekspozycji i wymaga dużych prób.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja nieciągła (RDD) i zmienne instrumentalne
Próg w regule przydziału i zmienna instrumentalna: założenia, lokalna regresja liniowa, testy, 2SLS w R z poprawnym SE i wzór opisu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bowden, J., Davey Smith, G., & Burgess, S. (2015). Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. International Journal of Epidemiology, 44(2), 512–525. https://doi.org/10.1093/ije/dyv080 ● Otwarty dostęp
- Burgess, S., Butterworth, A., & Thompson, S. G. (2013). Mendelian randomization analysis with multiple genetic variants using summarized data. Genetic Epidemiology, 37(7), 658–665. https://doi.org/10.1002/gepi.21758 ● Otwarty dostęp
- Davey Smith, G., & Ebrahim, S. (2003). ‘Mendelian randomization’: Can genetic epidemiology contribute to understanding environmental determinants of disease? International Journal of Epidemiology, 32(1), 1–22. https://doi.org/10.1093/ije/dyg070
- Lawlor, D. A., Harbord, R. M., Sterne, J. A. C., Timpson, N., & Davey Smith, G. (2008). Mendelian randomization: Using genes as instruments for making causal inferences in epidemiology. Statistics in Medicine, 27(8), 1133–1163. https://doi.org/10.1002/sim.3034
Cytowania BibTeX
@article{bowden2015mendelian, author={Bowden, Jack and Davey Smith, George and Burgess, Stephen}, title={{Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression}}, journal={International Journal of Epidemiology}, year={2015}, volume={44}, number={2}, pages={512--525}, doi={10.1093/ije/dyv080}}@article{burgess2013mendelian, author={Burgess, Stephen and Butterworth, Adam and Thompson, Simon G.}, title={{Mendelian randomization analysis with multiple genetic variants using summarized data}}, journal={Genetic Epidemiology}, year={2013}, volume={37}, number={7}, pages={658--665}, doi={10.1002/gepi.21758}}@article{daveysmith2003mendelian, author={Davey Smith, George and Ebrahim, Shah}, title={{‘Mendelian randomization’: Can genetic epidemiology contribute to understanding environmental determinants of disease?}}, journal={International Journal of Epidemiology}, year={2003}, volume={32}, number={1}, pages={1--22}, doi={10.1093/ije/dyg070}}@article{lawlor2008mendelian, author={Lawlor, Debbie A. and Harbord, Roger M. and Sterne, Jonathan A. C. and Timpson, Nic and Davey Smith, George}, title={{Mendelian randomization: Using genes as instruments for making causal inferences in epidemiology}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={8}, pages={1133--1163}, doi={10.1002/sim.3034}}