Kiedy sięgnąć po RDD lub zmienne instrumentalne
W badaniu obserwacyjnym osoby, które skorzystały z interwencji, zwykle różnią się od pozostałych. Część tych różnic da się zmierzyć, ale część nie, np. motywacja, zasoby rodziny czy gotowość do szukania pomocy. Ta niezmierzona zmienna zakłócająca podważa trafność wewnętrzną zwykłej regresji, bo kontrolować można tylko to, co zmierzono. Regresja nieciągła (ang. regression discontinuity design, RDD) i zmienne instrumentalne (ang. instrumental variables, IV) nie wymagają zmierzenia wszystkich zakłóceń. Zamiast tego wykorzystują źródło zmienności w udziale, które działa „jak losowanie”.
Obie metody należą do rodziny schematów quasi-eksperymentalnych. Różnią się od metod opisanych w innych wpisach tym, czego potrzebują od danych.
| Metoda | Czego potrzebujesz | Kluczowe założenie | Co szacujesz |
|---|---|---|---|
| Propensity score | pomiar wszystkich zmiennych zakłócających | brak niezmierzonych zakłóceń | ATE lub ATT w całej próbie |
| Różnica w różnicach | pomiary przed i po w dwóch grupach | równoległe trendy | efekt w grupie objętej interwencją |
| Regresja nieciągła | znaną regułę przydziału z progiem na zmiennej ciągłej | ciągłość wyników w progu, brak manipulacji | efekt lokalny, u osób tuż przy progu |
| Zmienne instrumentalne | zmienną, która zmienia udział, ale na wynik działa tylko przez udział | trafność instrumentu (zob. tabela niżej) | efekt u osób, które instrument skłonił do udziału (LATE) |
Najlepiej zacząć od rysunku: graf przyczynowy (DAG) pokaże, czy instrument albo próg rzeczywiście omijają niezmierzone zakłócenia.
Logika regresji nieciągłej
Regresja nieciągła wykorzystuje regułę przydziału. Interwencję dostają osoby, których wynik na zmiennej przydziału (ang. running variable) leży po jednej stronie progu (Imbens i Lemieux, 2008). Schemat zaproponowali Thistlethwaite i Campbell (1960) jako alternatywę dla porównań po fakcie, gdy losowanie jest niemożliwe. Osoby z wynikiem 19 i 20 punktów w teście przesiewowym są do siebie podobne, a różni je tylko to, czy przekroczyły próg. Jeśli wyniki zmieniają się płynnie wraz ze zmienną przydziału, to skok w samym progu można przypisać interwencji. Lee i Lemieux (2010) wyjaśniają, dlaczego taki schemat uznaje się za quasi-eksperyment i kiedy przestaje być trafny.
Wyróżnia się dwie wersje:
- ostra RDD (ang. sharp): przekroczenie progu oznacza udział u wszystkich, a jego brak – u nikogo;
- rozmyta RDD (ang. fuzzy): próg zmienia tylko prawdopodobieństwo udziału, bo część zaproszonych nie przychodzi, a część osób spod progu trafia do programu inną drogą.
W rozmytej RDD skok w wyniku jest efektem zaproszenia, a nie udziału. Żeby oszacować efekt samego udziału, próg trzeba potraktować jak zmienną instrumentalną. Dlatego obie metody omawiamy razem.
Przykład: warsztat dla studentów z wysokim stresem
Uczelnia przeprowadziła przesiew stresu skalą PSS-10 (0–40 pkt) wśród 4000 studentów (dane symulowane). Osoby z wynikiem co najmniej 20 pkt dostały zaproszenie na warsztat radzenia sobie ze stresem. Wynikiem jest PSS-10 po trzech miesiącach. Zaproszenie dostało 40.4% osób. Z zaproszonych w warsztacie wzięło udział 57.2%, a wśród niezaproszonych 9.4%, które zgłosiły się same. To klasyczna rozmyta RDD. W symulacji udział obniża stres o 3 pkt, ale osoby bardziej zmotywowane częściej przychodzą i same szybciej się poprawiają. Motywacji nie zmierzono.
Uwaga na regresję do średniej. Osoby z wysokim wynikiem przesiewu i tak obniżą wynik w kolejnym pomiarze. Porównanie przed–po w grupie zaproszonych pomyliłoby to z efektem warsztatu. RDD nie ma tego problemu, bo porównuje osoby po obu stronach progu w tym samym pomiarze.
Lokalna regresja liniowa i szerokość okna
Efekt w progu szacuje się regresją liniową tylko na osobach blisko progu, w oknie o szerokości h. Zmienną przydziału centruje się w progu (xc = wynik − 20), a nachylenie może się różnić po obu stronach dzięki interakcji:
Współczynnik τ to skok w progu. Przy oknie h = 5 (wyniki 16–24 pkt, n = 2058) stres po trzech miesiącach był u zaproszonych niższy o 1.22 pkt, 95% CI [−2.02, −0.42], p = .003. To efekt zaproszenia, czyli odpowiednik analizy ITT w badaniu z randomizacją.
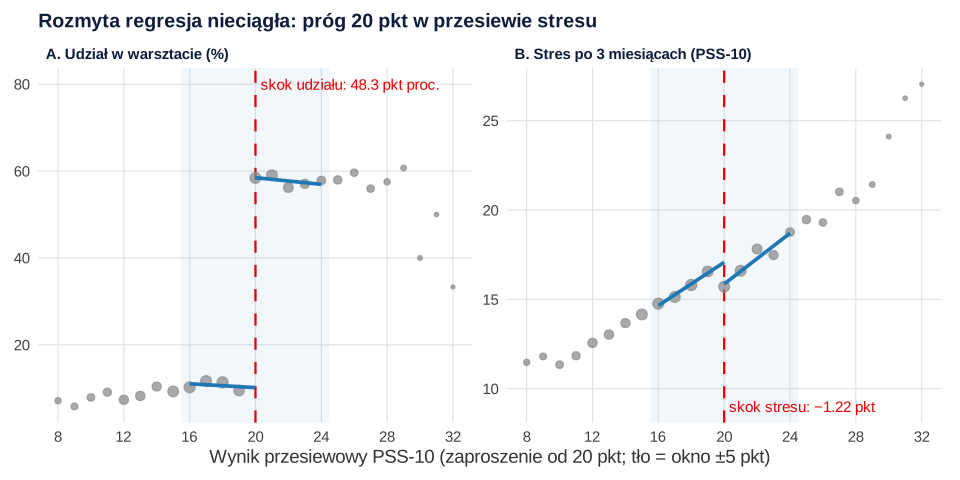
Szerokość okna to kompromis. Węższe okno zmniejsza obciążenie, bo osoby są bardziej podobne, ale zwiększa błąd losowy. Przy h = 3 skok wyniósł −1.66, 95% CI [−3.01, −0.31], a przy h = 10 −1.01, 95% CI [−1.55, −0.47]. Pakiety do RDD (np. rdrobust) dobierają okno automatycznie. Niezależnie od tego pokaż wyniki dla kilku okien jako analizę wrażliwości.
Nie zastępuj lokalnej regresji wielomianem wysokiego stopnia na całych danych. Gelman i Imbens (2019) pokazują, że takie modele dają zaszumione oszacowania, wrażliwe na stopień wielomianu, i przedziały o złym pokryciu. Zalecają estymatory lokalne liniowe lub kwadratowe. W przykładzie wielomian 4. stopnia dał skok −1.30 przy błędzie standardowym 0.573 wobec 0.408 w oknie h = 5. Gdy zależność od zmiennej przydziału jest wyraźnie krzywoliniowa, lepiej sprawdzają się gładkie funkcje z wpisu o splajnach i modelach GAM.
Jak sprawdzić założenia RDD
Ciągłości wyników kontrfaktycznych w progu nie da się sprawdzić wprost. Da się jednak sprawdzić jej konsekwencje.
- Brak manipulacji zmienną przydziału. Gdyby studenci zawyżali wynik, żeby dostać zaproszenie, tuż nad progiem byłoby nienaturalnie dużo osób. McCrary (2008) zaproponował test ciągłości gęstości zmiennej przydziału w progu. Uproszczona wersja to porównanie liczebności tuż pod progiem i tuż nad nim: 515 osób z wynikiem 18–19 pkt i 504 z wynikiem 20–21 pkt, test dwumianowy p = .754. Obejrzyj też histogram zmiennej przydziału.
- Brak skoku w zmiennych sprzed interwencji. Średnia ocen z poprzedniego semestru nie skacze w progu: 0.02, 95% CI [−0.05, 0.09], p = .645.
- Brak skoku w progach placebo. Ten sam model w fałszywym progu 16 pkt (tylko osoby spod progu) dał −0.05, p = .904, a w progu 24 pkt (tylko osoby zaproszone) 0.16, p = .745.
- Brak innych zmian w tym samym progu. Jeśli przy 20 pkt uczelnia przyznaje też np. dodatkowe konsultacje, skok jest sumą obu działań. Tego nie sprawdzi żaden test, tylko znajomość procedury.
Zmienne instrumentalne: cztery założenia
Instrument to zmienna, która przewiduje udział w interwencji, ale przy ustalonym udziale nie ma własnego związku z wynikiem (Lousdal, 2018). Idealnym instrumentem jest losowy przydział w badaniu z randomizacją, w którym nie wszyscy stosują się do przydziału. W danych obserwacyjnych bywają nim odległość od placówki, zmienność geograficzna, preferencje lekarza albo, jak tu, próg w regule przydziału. Klasyczny przykład z odległością od uczelni i zarobkami pokazujemy w haśle ekonometria.
| Założenie | W przykładzie | Jak sprawdzić |
|---|---|---|
| Istotność (ang. relevance) | zaproszenie zwiększa udział | statystyka F pierwszego etapu |
| Niezależność (jak losowanie) | tuż przy progu zaproszenie nie zależy od motywacji | testy z poprzedniej sekcji; dla innych instrumentów – tylko argument merytoryczny |
| Wyłączenie (ang. exclusion restriction) | samo zaproszenie, bez udziału, nie zmienia stresu | nie da się sprawdzić danymi; uzasadnij merytorycznie |
| Monotoniczność | nikt nie przychodzi tylko dlatego, że nie dostał zaproszenia | uzasadnij merytorycznie |
Hernán i Robins (2006) przypominają, że zgodne oszacowanie wymaga spełnienia kilku silnych warunków naraz. Założenie wyłączenia bywa tu najsłabszym ogniwem. Samo zaproszenie z informacją o wysokim stresie mogłoby skłonić część osób do szukania pomocy gdzie indziej. Wtedy efekt przypisany warsztatowi byłby zawyżony.
Ważna jest też interpretacja. Angrist, Imbens i Rubin (1996) pokazali, że przy tych założeniach oszacowanie IV jest średnim efektem w podgrupie osób, które instrument skłonił do udziału (ang. compliers). To lokalny efekt LATE. Nie dotyczy on osób, które przyszłyby zawsze albo nigdy. Bez tych założeń jest tylko ilorazem efektów ITT. Ta sama logika stoi za porównaniem ITT i per protocol w badaniach z niepełną adherencją. Analiza per protocol porównuje osoby, które same zdecydowały o udziale, więc jest narażona na te same zakłócenia co zwykła regresja.
Rozmyta RDD jako 2SLS krok po kroku
Dwustopniowa metoda najmniejszych kwadratów (2SLS) ma dwa etapy. Używamy tego samego okna h = 5 i tych samych zmiennych kontrolnych (xc i interakcji) w obu etapach.
- Pierwszy etap: udział regresujesz na zaproszeniu. Zaproszenie zwiększało udział o 0.483 (SE = 0.038), czyli o 48.3 punktu procentowego. Statystyka F = 162.7 wskazuje silny instrument. Staiger i Stock (1997) pokazali, że przy słabym instrumencie 2SLS może być silnie obciążony nawet w dużych próbach. W praktyce za sygnał ostrzegawczy przyjmuje się zwykle F pierwszego etapu poniżej 10.
- Forma zredukowana: skok w stresie, −1.22 pkt, czyli wynik z poprzedniej sekcji.
- Efekt udziału: iloraz formy zredukowanej i pierwszego etapu (estymator Walda), −1.22 / 0.483 = −2.52 pkt. Ten sam wynik daje drugi etap 2SLS: regresja stresu na udziale przewidzianym z pierwszego etapu.
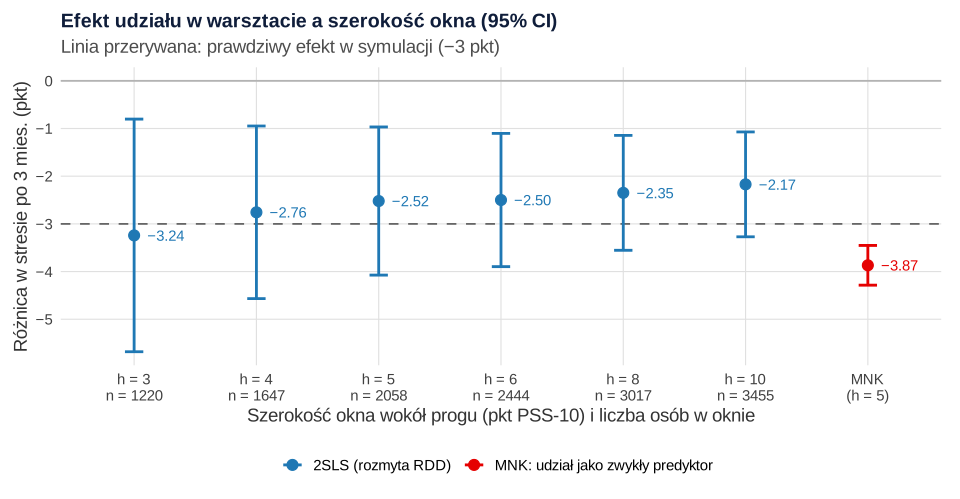
Błędu standardowego nie bierz z drugiego wywołania lm(). Program liczy reszty z udziałem przewidzianym, a poprawne reszty liczy się z udziałem rzeczywistym. Po poprawce błąd standardowy wyniósł 0.792 zamiast 0.843 z drugiego lm(). Efekt udziału: −2.52 pkt, 95% CI [−4.07, −0.97], p = .001. Przedział obejmuje prawdziwy efekt z symulacji, −3 pkt. Gdy reszty mają nierówną wariancję, użyj odpornych błędów standardowych. Gotowe funkcje (np. ivreg) liczą poprawny błąd automatycznie.
Zwykła regresja z udziałem jako predyktorem w tym samym oknie dała −3.87 pkt, 95% CI [−4.29, −3.45]. Wąski przedział nie chroni przed obciążeniem. Zmotywowani studenci częściej przychodzili i sami szybciej się poprawiali, więc regresja przypisała warsztatowi część efektu motywacji. Rysunek 2 pokazuje oba oszacowania i wrażliwość 2SLS na szerokość okna.
Jak opisać RDD i 2SLS w artykule
W części metodologicznej opisz regułę przydziału i jej źródło, wybór okna, model, testy założeń i analizę wrażliwości. Zaznacz też, że efekt jest lokalny. Wyniki opisz tak:
Jeśli recenzent kwestionuje instrument albo wybór okna, możemy wspólnie przygotować analizy wrażliwości i odpowiedź w ramach wsparcia statystycznego dla badaczy. Więcej o planowaniu analiz w pracy naukowej znajdziesz w przewodniku po doktoracie i publikacjach.
RDD i 2SLS w R bez dodatkowych pakietów
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik rdd-iv-dane.csv (możesz go pobrać tutaj) i szacuje skok w progu oraz testy założeń. Drugi liczy 2SLS ręcznie, z poprawnym błędem standardowym. Wystarczają funkcje podstawowego R.
1. Lokalna regresja liniowa i testy założeń
R
# Dane symulowane: przesiew stresu na uczelni. Osoby z wynikiem PSS-10 >= 20 dostają zaproszenie na warsztat
# radzenia sobie ze stresem. Wynik: PSS-10 po 3 miesiącach (0–40, wyższy = większy stres); N = 4000
set.seed(2071)
N <- 4000
prog <- 20
przesiew <- pmin(pmax(round(rnorm(N, 18, 6)), 0), 40)
motywacja <- rnorm(N)                                  # nieobserwowana gotowość do szukania pomocy
srednia_ocen <- round(pmin(pmax(4.1 - 0.02 * (przesiew - 18) + rnorm(N, 0, 0.4), 2), 5), 2)  # zmienna sprzed przesiewu
zaproszenie <- as.integer(przesiew >= prog)
udzial <- rbinom(N, 1, plogis(ifelse(zaproszenie == 1, 0.4, -2.6) + 0.8 * motywacja))
stres_po <- round(pmin(pmax(5 + 0.62 * przesiew + 0.012 * (przesiew - 18)^2 - 3 * udzial - 1.2 * motywacja +
                              rnorm(N, 0, 4), 0), 40))
dane <- data.frame(id = sprintf("s%04d", 1:N), przesiew, zaproszenie, udzial, stres_po, srednia_ocen)
write.csv(dane, "rdd-iv-dane.csv", row.names = FALSE)
dane$xc <- dane$przesiew - prog                        # zmienna przydziału wycentrowana w progu

# Udział w warsztacie po obu stronach progu
round(prop.table(table(zaproszenie = dane$zaproszenie, udzial = dane$udzial), 1), 3)

# 1. Manipulacja zmienną przydziału: liczebności tuż pod progiem (18–19) i tuż nad nim (20–21)
pod <- sum(dane$przesiew %in% 18:19); nad <- sum(dane$przesiew %in% 20:21)
c(pod = pod, nad = nad, p = round(binom.test(nad, pod + nad)$p.value, 3))

# 2. Lokalna regresja liniowa w oknie |xc| < h: osobne nachylenia po obu stronach progu (jądro prostokątne)
skok <- function(wynik, h, d = dane) {
  w <- d[abs(d$xc) < h, ]
  m <- lm(reformulate(c("zaproszenie", "xc", "zaproszenie:xc"), wynik), data = w)
  est <- coef(m)[["zaproszenie"]]; se <- sqrt(vcov(m)["zaproszenie", "zaproszenie"])
  data.frame(wynik, h, n = nrow(w), skok = est, SE = se,
             dolny95 = est - qt(.975, m$df.residual) * se, gorny95 = est + qt(.975, m$df.residual) * se,
             p = 2 * pt(-abs(est / se), m$df.residual))
}
okna <- c(3, 4, 5, 6, 8, 10)
wrazliwosc <- do.call(rbind, lapply(okna, function(h) skok("stres_po", h)))
print(cbind(wrazliwosc[1:3], round(wrazliwosc[4:8], 3)), row.names = FALSE)

# Dla porównania: globalny wielomian 4. stopnia na całych danych
glob <- lm(stres_po ~ zaproszenie * poly(xc, 4, raw = TRUE), data = dane)
round(c(skok = coef(glob)[["zaproszenie"]], SE = sqrt(vcov(glob)["zaproszenie", "zaproszenie"]),
        confint(glob)["zaproszenie", ]), 3)

# 3. Test zmiennej sprzed interwencji (średnia ocen nie powinna „skakać” w progu)
kontrola <- skok("srednia_ocen", 5)
print(cbind(kontrola[1:3], round(kontrola[4:8], 3)), row.names = FALSE)

# 4. Progi placebo: 16 (tylko osoby poniżej 20) i 24 (tylko osoby od 20 w górę)
placebo <- function(c0, d) { d$xc <- d$przesiew - c0; d$zaproszenie <- as.integer(d$przesiew >= c0); skok("stres_po", 5, d) }
pl <- rbind(cbind(prog_placebo = 16, placebo(16, dane[dane$przesiew < prog, ])),
            cbind(prog_placebo = 24, placebo(24, dane[dane$przesiew >= prog, ])))
print(cbind(pl[c(1, 4)], round(pl[5:9], 3)), row.names = FALSE)
Wynik w R
           udzial
zaproszenie     0     1
          0 0.906 0.094
          1 0.428 0.572
    pod     nad       p
515.000 504.000   0.754
    wynik  h    n   skok    SE dolny95 gorny95     p
 stres_po  3 1220 -1.664 0.689  -3.015  -0.313 0.016
 stres_po  4 1647 -1.380 0.494  -2.349  -0.412 0.005
 stres_po  5 2058 -1.218 0.408  -2.018  -0.419 0.003
 stres_po  6 2444 -1.183 0.359  -1.888  -0.478 0.001
 stres_po  8 3017 -1.103 0.306  -1.703  -0.503 0.000
 stres_po 10 3455 -1.010 0.276  -1.551  -0.469 0.000
  skok     SE  2.5 % 97.5 %
-1.299  0.573 -2.422 -0.175
        wynik h    n  skok    SE dolny95 gorny95     p
 srednia_ocen 5 2058 0.017 0.037  -0.055   0.089 0.645
 prog_placebo    n   skok    SE dolny95 gorny95     p
           16 1816 -0.051 0.418  -0.871   0.770 0.904
           24 1451  0.164 0.505  -0.826   1.153 0.745
2. Rozmyta RDD: pierwszy etap, estymator Walda i 2SLS
R
# Rozmyta regresja nieciągła jako zmienna instrumentalna: zaproszenie (próg) jest instrumentem dla udziału w warsztacie
# Kontynuacja przepisu 1 (obiekty dane, prog); okno h = 5 punktów PSS-10
h <- 5
w <- dane[abs(dane$xc) < h, ]

# Pierwszy etap: o ile zaproszenie zwiększa udział w warsztacie
etap1 <- lm(udzial ~ zaproszenie + xc + zaproszenie:xc, data = w)
fs <- summary(etap1)$coefficients["zaproszenie", ]
round(c(skok_udzialu = fs[["Estimate"]], SE = fs[["Std. Error"]], F = fs[["t value"]]^2), 3)

# Forma zredukowana: skok w stresie po zaproszeniu (to samo co skok() z przepisu 1 dla h = 5)
rf <- coef(lm(stres_po ~ zaproszenie + xc + zaproszenie:xc, data = w))[["zaproszenie"]]
round(c(forma_zredukowana = rf, wald = rf / fs[["Estimate"]]), 3)

# 2SLS ręcznie: drugi etap na przewidywanym udziale, potem poprawny błąd standardowy
w$udzial_hat <- fitted(etap1)
etap2 <- lm(stres_po ~ udzial_hat + xc + zaproszenie:xc, data = w)
b <- coef(etap2)
X <- model.matrix(~ udzial + xc + zaproszenie:xc, data = w)      # prawdziwy udział
Xh <- model.matrix(etap2)                                          # przewidywany udział
e <- w$stres_po - X %*% b                                          # reszty liczone z prawdziwym udziałem
s2 <- sum(e^2) / (nrow(w) - ncol(X))
se_2sls <- sqrt(diag(s2 * solve(crossprod(Xh))))[["udzial_hat"]]
se_naiwny <- summary(etap2)$coefficients["udzial_hat", "Std. Error"]
df <- nrow(w) - ncol(X)
round(c(efekt_2sls = b[["udzial_hat"]], SE = se_2sls, SE_z_drugiego_lm = se_naiwny,
        dolny95 = b[["udzial_hat"]] - qt(.975, df) * se_2sls, gorny95 = b[["udzial_hat"]] + qt(.975, df) * se_2sls,
        p = 2 * pt(-abs(b[["udzial_hat"]] / se_2sls), df)), 3)

# Porównanie: zwykła regresja (MNK) z udziałem jako predyktorem w tym samym oknie
mnk <- lm(stres_po ~ udzial + xc + zaproszenie:xc, data = w)
round(c(efekt_mnk = coef(mnk)[["udzial"]], confint(mnk)["udzial", ]), 3)

# Wrażliwość efektu 2SLS na szerokość okna (te same kroki w funkcji)
iv_okno <- function(h) {
  v <- dane[abs(dane$xc) < h, ]
  e1 <- lm(udzial ~ zaproszenie + xc + zaproszenie:xc, data = v)
  v$udzial_hat <- fitted(e1)
  e2 <- lm(stres_po ~ udzial_hat + xc + zaproszenie:xc, data = v)
  X <- model.matrix(~ udzial + xc + zaproszenie:xc, data = v)
  s2 <- sum((v$stres_po - X %*% coef(e2))^2) / (nrow(v) - ncol(X))
  se <- sqrt(diag(s2 * solve(crossprod(model.matrix(e2)))))[["udzial_hat"]]
  est <- coef(e2)[["udzial_hat"]]; q <- qt(.975, nrow(v) - ncol(X))
  c(h = h, n = nrow(v), F_etap1 = summary(e1)$coefficients["zaproszenie", "t value"]^2,
    efekt_2sls = est, SE = se, dolny95 = est - q * se, gorny95 = est + q * se)
}
iv_wrazliwosc <- t(sapply(c(3, 4, 5, 6, 8, 10), iv_okno))
round(iv_wrazliwosc, 3)
Wynik w R
skok_udzialu           SE            F
       0.483        0.038      162.659
forma_zredukowana              wald
           -1.218            -2.521
      efekt_2sls               SE SE_z_drugiego_lm          dolny95
          -2.521            0.792            0.843           -4.074
         gorny95                p
          -0.968            0.001
efekt_mnk     2.5 %    97.5 %
   -3.869    -4.285    -3.452
      h    n F_etap1 efekt_2sls    SE dolny95 gorny95
[1,]  3 1220  61.953     -3.242 1.243  -5.681  -0.803
[2,]  4 1647 116.144     -2.757 0.923  -4.567  -0.947
[3,]  5 2058 162.659     -2.521 0.792  -4.074  -0.968
[4,]  6 2444 205.330     -2.499 0.713  -3.897  -1.102
[5,]  8 3017 282.698     -2.349 0.614  -3.554  -1.145
[6,] 10 3455 353.076     -2.171 0.561  -3.271  -1.072
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), model.matrix(), binom.test()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Uogólnianie efektu z progu na wszystkich. RDD mówi o osobach blisko progu, a IV o osobach, które instrument skłonił do udziału.
- Globalny wielomian wysokiego stopnia zamiast lokalnej regresji i jedna szerokość okna bez analizy wrażliwości.
- Pominięcie testu manipulacji i zmiennych sprzed interwencji. Gdy ludzie wiedzą o progu, mogą się do niego „dopasować”.
- Błąd standardowy z drugiego
lm()zamiast poprawnego błędu 2SLS. - Słaby instrument bez raportu statystyki F pierwszego etapu.
- Instrument uzasadniony tylko korelacją. Założenia wyłączenia nie potwierdzi żaden test – potrzebny jest argument merytoryczny. Pomyłka w tej sprawie to klasyczny problem korelacji i przyczynowości.
Najczęstsze pytania
Czym różni się ostra regresja nieciągła od rozmytej?
W ostrej RDD przekroczenie progu oznacza udział w interwencji u wszystkich, a jego brak – u nikogo. W rozmytej próg zmienia tylko prawdopodobieństwo udziału. Skok w wyniku jest wtedy efektem przydziału, a efekt samego udziału szacuje się metodą zmiennych instrumentalnych, z progiem jako instrumentem.
Jak dobrać szerokość okna w regresji nieciągłej?
Węższe okno zmniejsza obciążenie, ale zwiększa błąd losowy. Okno można dobrać metodą automatyczną dostępną w pakietach do RDD albo uzasadnić merytorycznie. W obu przypadkach pokaż wyniki dla kilku szerokości jako analizę wrażliwości. Unikaj globalnych wielomianów wysokiego stopnia (Gelman i Imbens, 2019).
Jak sprawdzić, czy zmienna instrumentalna jest dobra?
Siłę instrumentu sprawdzisz statystyką F pierwszego etapu; wartości poniżej ok. 10 sygnalizują słaby instrument. Założeń niezależności, wyłączenia i monotoniczności nie da się w pełni sprawdzić danymi (Lousdal, 2018), więc potrzebny jest argument merytoryczny, najlepiej z grafem przyczynowym.
Dlaczego błąd standardowy z drugiego etapu 2SLS jest niepoprawny?
Drugi etap ręcznego 2SLS liczy reszty z przewidzianej wartości zmiennej endogenicznej, a poprawne reszty liczy się z wartości rzeczywistej. Dlatego błąd standardowy trzeba przeliczyć albo użyć funkcji, która robi to automatycznie. W przykładzie poprawny SE wyniósł 0.792, a z drugiego lm() 0.843.
Co oznacza LATE w metodzie zmiennych instrumentalnych?
LATE (ang. local average treatment effect) to średni efekt w podgrupie osób, które wzięły udział w interwencji tylko dlatego, że instrument je do tego skłonił (Angrist i in., 1996). Nie dotyczy osób, które wzięłyby udział zawsze albo nigdy, więc nie musi być równy efektowi w całej populacji.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Masz próg w regule przydziału albo kandydata na instrument?
Pomożemy ocenić założenia, dobrać okno, policzyć 2SLS z poprawnymi błędami i przygotować analizy wrażliwości tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Angrist, J. D., Imbens, G. W., & Rubin, D. B. (1996). Identification of causal effects using instrumental variables. Journal of the American Statistical Association, 91(434), 444–455. https://doi.org/10.1080/01621459.1996.10476902
- Gelman, A., & Imbens, G. (2019). Why high-order polynomials should not be used in regression discontinuity designs. Journal of Business & Economic Statistics, 37(3), 447–456. https://doi.org/10.1080/07350015.2017.1366909
- Hernán, M. A., & Robins, J. M. (2006). Instruments for causal inference: An epidemiologist's dream? Epidemiology, 17(4), 360–372. https://doi.org/10.1097/01.ede.0000222409.00878.37
- Imbens, G. W., & Lemieux, T. (2008). Regression discontinuity designs: A guide to practice. Journal of Econometrics, 142(2), 615–635. https://doi.org/10.1016/j.jeconom.2007.05.001
- Lee, D. S., & Lemieux, T. (2010). Regression discontinuity designs in economics. Journal of Economic Literature, 48(2), 281–355. https://doi.org/10.1257/jel.48.2.281 ● Otwarty dostęp: pełny tekst
- Lousdal, M. L. (2018). An introduction to instrumental variable assumptions, validation and estimation. Emerging Themes in Epidemiology, 15(1), Article 1. https://doi.org/10.1186/s12982-018-0069-7 ● Otwarty dostęp
- McCrary, J. (2008). Manipulation of the running variable in the regression discontinuity design: A density test. Journal of Econometrics, 142(2), 698–714. https://doi.org/10.1016/j.jeconom.2007.05.005 ● Otwarty dostęp: pełny tekst
- Staiger, D., & Stock, J. H. (1997). Instrumental variables regression with weak instruments. Econometrica, 65(3), 557–586. https://doi.org/10.2307/2171753
- Thistlethwaite, D. L., & Campbell, D. T. (1960). Regression-discontinuity analysis: An alternative to the ex post facto experiment. Journal of Educational Psychology, 51(6), 309–317. https://doi.org/10.1037/h0044319
Cytowania BibTeX
@article{angrist1996identification, author={Angrist, Joshua D. and Imbens, Guido W. and Rubin, Donald B.}, title={{Identification of causal effects using instrumental variables}}, journal={Journal of the American Statistical Association}, year={1996}, volume={91}, number={434}, pages={444--455}, doi={10.1080/01621459.1996.10476902}}@article{gelman2019high, author={Gelman, Andrew and Imbens, Guido}, title={{Why high-order polynomials should not be used in regression discontinuity designs}}, journal={Journal of Business \& Economic Statistics}, year={2019}, volume={37}, number={3}, pages={447--456}, doi={10.1080/07350015.2017.1366909}}@article{hernan2006instruments, author={Hernán, Miguel A. and Robins, James M.}, title={{Instruments for causal inference: An epidemiologist's dream?}}, journal={Epidemiology}, year={2006}, volume={17}, number={4}, pages={360--372}, doi={10.1097/01.ede.0000222409.00878.37}}@article{imbens2008regression, author={Imbens, Guido W. and Lemieux, Thomas}, title={{Regression discontinuity designs: A guide to practice}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={615--635}, doi={10.1016/j.jeconom.2007.05.001}}@article{lee2010regression, author={Lee, David S. and Lemieux, Thomas}, title={{Regression discontinuity designs in economics}}, journal={Journal of Economic Literature}, year={2010}, volume={48}, number={2}, pages={281--355}, doi={10.1257/jel.48.2.281}}@article{lousdal2018introduction, author={Lousdal, Mette Lise}, title={{An introduction to instrumental variable assumptions, validation and estimation}}, journal={Emerging Themes in Epidemiology}, year={2018}, volume={15}, number={1}, eid={1}, doi={10.1186/s12982-018-0069-7}}@article{mccrary2008manipulation, author={McCrary, Justin}, title={{Manipulation of the running variable in the regression discontinuity design: A density test}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={698--714}, doi={10.1016/j.jeconom.2007.05.005}}@article{staiger1997instrumental, author={Staiger, Douglas and Stock, James H.}, title={{Instrumental variables regression with weak instruments}}, journal={Econometrica}, year={1997}, volume={65}, number={3}, pages={557--586}, doi={10.2307/2171753}}@article{thistlethwaite1960regression, author={Thistlethwaite, Donald L. and Campbell, Donald T.}, title={{Regression-discontinuity analysis: An alternative to the ex post facto experiment}}, journal={Journal of Educational Psychology}, year={1960}, volume={51}, number={6}, pages={309--317}, doi={10.1037/h0044319}}