mgcv::gam z s(x) i method = "REML") sam dobiera kształt krzywej, a jego złożoność opisują efektywne stopnie swobody (edf). Wynik przedstaw rysunkiem krzywej z 95% CI i kilkoma wartościami przewidywanymi, a dobór k sprawdź gam.check().Kiedy prosta linia nie wystarcza
Regresja liniowa zakłada, że każda kolejna jednostka predyktora zmienia wynik o tyle samo. W badaniach to założenie często zawodzi. Wynik może rosnąć z predyktorem tylko do pewnego progu, zmieniać się inaczej u osób młodych i starszych albo wypłaszczać się przy wysokich dawkach. Wykres reszt modelu liniowego pokazuje wtedy łuk, a współczynnik b uśrednia nachylenia, które w różnych częściach zakresu są zupełnie inne.
Badacze reagują na to zwykle na trzy sposoby: dzielą predyktor na grupy, dodają do modelu kwadrat predyktora albo modelują kształt elastycznie, splajnem lub modelem addytywnym (GAM). Ten wpis porównuje wszystkie trzy podejścia na jednym zbiorze danych i pokazuje, jak dopasować, sprawdzić i opisać model GAM w pakiecie mgcv. Podstawy regresji z wieloma predyktorami znajdziesz w poradniku regresja wieloraka krok po kroku, a model z kwadratem predyktora w haśle regresja krzywoliniowa.
Przykład: czas snu a dobrostan
W badaniu przekrojowym 600 dorosłych (321 kobiet, 279 mężczyzn; dane symulowane, set.seed(2091)) podało zwykły czas snu w godzinach (M = 7.02, SD = 1.30, zakres 4–10.5) i wypełniło indeks dobrostanu WHO-5 przeliczony na skalę 0–100 (M = 57.76, SD = 13.89; sposób liczenia opisujemy we wpisie WHO-5 – jak policzyć wynik). Wiek wynosił od 20 do 75 lat (M = 47.80, SD = 15.84). Pytanie badawcze brzmi: jak dobrostan zmienia się wraz z czasem snu po uwzględnieniu wieku i płci? Dane możesz pobrać jako plik CSV (600 wierszy: sen, wiek, plec, dobrostan).
Ten sam zbiór przeanalizowaliśmy sześcioma modelami. Każdy zawiera wiek i płeć jako predyktory liniowe, a różni się tylko tym, jak traktuje czas snu.
| Czas snu w modelu | Parametry (df) | R²skor | AIC | ΔAIC |
|---|---|---|---|---|
| Liniowo | 5 | .231 | 4708.2 | 38.7 |
| Podział medianą (dwie grupy) | 5 | .168 | 4755.1 | 85.6 |
| Tercyle (trzy grupy) | 6 | .230 | 4710.0 | 40.5 |
| Wielomian 2. stopnia | 6 | .262 | 4684.7 | 15.2 |
| Splajn naturalny, 4 df | 8 | .282 | 4669.5 | 0.0 |
GAM: s(sen), REML | 8.75 (efektywne) | .281 | 4673.1 | 3.6 |
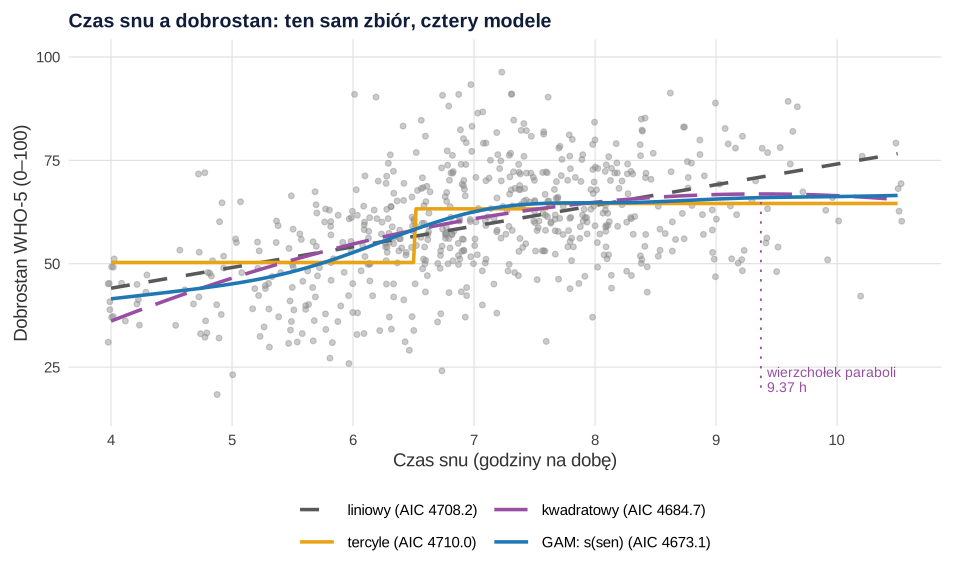
Mniejsze AIC oznacza lepszy kompromis między dopasowaniem a złożonością. Elastyczne modele mają AIC niższe od prostej o 35–39 punktów, a różnica między splajnem a GAM (3.6 punktu) jest przy tym niewielka. Podziały na grupy wypadają najgorzej, a podział medianą jest gorszy nawet od modelu liniowego. Rysunek 1 pokazuje, skąd biorą się te różnice.
Dlaczego nie dzielić predyktora na grupy
Podział na grupy zakłada, że w obrębie grupy wynik się nie zmienia, a na granicy skacze. Osoba śpiąca 6.5 h trafia do innej grupy niż osoba śpiąca 6.6 h, a osoba śpiąca 4 h do tej samej. Royston, Altman i Sauerbrei (2006) pokazują, że dychotomizacja predyktora oznacza dużą utratę mocy i niepełną kontrolę zakłócania, a próg wybrany jako „optymalny” na podstawie danych poważnie obciąża wyniki. Bennette i Vickers (2012) krytykują podobnie podział na tercyle, kwartyle i kwintyle, częsty w epidemiologii.
W przykładzie podział medianą obniżył skorygowane R² z .231 do .168. Tercyle odzyskały dopasowanie prostej (.230), ale tylko dlatego, że trzy schodki przypadkiem przybliżają łuk. Granice tercyli (6.5 i 7.6 h) wyznacza próba, a nie teoria, więc w innym badaniu będą inne. Szczegóły tych kosztów opisujemy w hasłach dzielenie medianą i tercyle i podział kwantylowy. Grupy mają sens, gdy próg wynika z kryterium zewnętrznego, np. z punktu odcięcia narzędzia. Wtedy jednak to inne pytanie badawcze.
Wielomian czy splajn
Kwadrat predyktora poprawił dopasowanie o 23.5 punktu AIC względem prostej, więc wynik „istotna krzywoliniowość” byłby prawdziwy. Parabola ma jednak zawsze jeden wierzchołek i jest symetryczna. W przykładzie wierzchołek wypadł przy 9.37 h snu, co sugeruje optimum i spadek dobrostanu przy dłuższym śnie. W danych nic takiego nie ma: krzywa wypłaszcza się około 7.5 h. Simonsohn (2018) pokazuje, że regresja kwadratowa narzuca arbitralny kształt i może „znajdować” odwrócone U tam, gdzie związek jest tylko wklęsły. Jak testować kształt U, opisujemy w haśle o regresji krzywoliniowej.
Splajn to krzywa złożona z odcinków wielomianów (zwykle trzeciego stopnia), połączonych gładko w punktach zwanych węzłami. Dzięki temu kształt w jednej części zakresu nie wymusza kształtu w innej. Splajn naturalny (splines::ns()) jest dodatkowo liniowy poza skrajnymi węzłami, co stabilizuje krańce zakresu. W przykładzie splajn z 4 stopniami swobody dał najmniejsze AIC (4669.5). Kłopot polega na tym, że liczbę i położenie węzłów wybiera badacz. Perperoglou i in. (2019) porównali procedury splajnów w R i stwierdzili, że różne funkcje dają różne wyniki nawet w prostych danych, a różnice wynikają głównie z wyboru takich hiperparametrów, a nie z rodzaju bazy.
Model GAM: kara za krzywiznę zamiast wyboru węzłów
Uogólniony model addytywny (ang. generalized additive model) zastępuje liniową kombinację predyktorów sumą gładkich funkcji (Hastie i Tibshirani, 1986):
Tu g to funkcja łącząca (dla wyniku ciągłego tożsamościowa), a f1 i f2 to splajny z wieloma węzłami. W mgcv zapisujesz je jako s(sen) i s(wiek). Elastyczność krzywej ogranicza kara za krzywiznę, a jej siłę (parametr wygładzania) szacuje się z danych. Wood (2011) opisuje szacowanie parametrów wygładzania metodą REML, które ma lepszą zbieżność niż wcześniejsze metody iteracyjne. Dlatego w kodzie zawsze podawaj method = "REML" (zob. REML a ML). Całe podejście, oparte na karanych splajnach regresyjnych, przedstawia podręcznik Wooda (2017).
Wynik modelu w przykładzie:
| Składnik | edf | Ref.df | F | p |
|---|---|---|---|---|
s(sen) | 4.77 | 5.85 | 39.99 | < .001 |
s(wiek) | 3.51 | 4.34 | 5.69 | < .001 |
| płeć: mężczyzna (b = −2.95, SE = 0.95) | – | – | t = −3.10 | .002 |
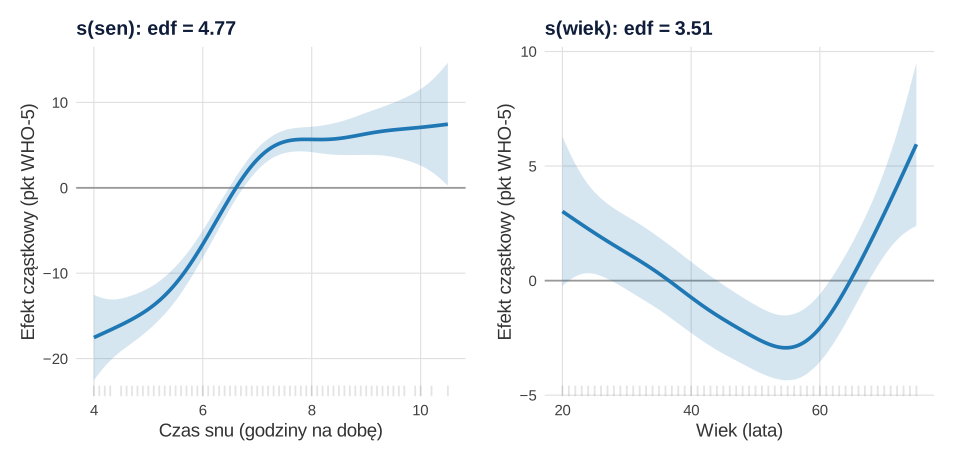
Efektywne stopnie swobody (edf) mówią, jak bardzo wygięta jest krzywa. edf = 1 oznacza prostą, a im wyższa wartość, tym bardziej złożony kształt. Krzywa snu zużyła 4.77 edf, a krzywa wieku 3.51. Argument k w s() (domyślnie 10) wyznacza tylko górną granicę złożoności, a kara dobiera właściwą wartość poniżej niej. Test F sprawdza hipotezę, że cała funkcja jest równa zeru. Wartości p dla składników gładkich są przybliżone (Wood, 2013), więc przy wynikach bliskich progu nie opieraj na nich wniosków. Cały model wyjaśnił 32% dewiancji (R²skor = .31), a jego AIC (4651.9) było o 56.3 punktu niższe niż w modelu z liniowym snem i wiekiem. O stopniach swobody i skorygowanym R² piszemy w słowniku.
Współczynniki składników gładkich nie mają prostej interpretacji, dlatego GAM czyta się z wykresu (Rysunek 2) i z wartości przewidywanych.
Jak czytać krzywą
Najprościej opisać kształt wartościami przewidywanymi dla kilku sensownych długości snu, przy ustalonym wieku (48 lat) i płci (kobieta):
| Sen (h) | 5 | 6 | 7 | 7.5 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|
| Dobrostan | 42.7 | 50.3 | 60.3 | 62.3 | 62.6 | 63.3 | 64.0 |
| 95% CI | [39.6, 45.9] | [47.8, 52.9] | [57.9, 62.6] | [60.0, 64.7] | [60.2, 65.0] | [60.1, 66.4] | [59.1, 68.9] |
Między 5 a 7 h przewidywany dobrostan rośnie o 17.6 punktu, a między 8 a 10 h tylko o 1.4 punktu. Nachylenie krzywej (pochodną) z przedziałem ufności można policzyć z macierzy predykcji modelu. W przykładzie było ono istotnie dodatnie od 5.0 do 7.35 h, np. 10.62 pkt na godzinę przy 6 h (SE = 1.71). Od 7.4 h przedział nachylenia obejmował zero. To nie dowodzi, że dłuższy sen „nic nie zmienia”: przy co najmniej 9 h było tylko 45 osób, więc przedziały są tam szerokie.
Przedziały wokół krzywej GAM mają pokrycie bliskie nominalnemu w całym zakresie funkcji, z wyjątkiem sytuacji, gdy prawdziwa funkcja jest prawie prosta (Marra i Wood, 2012). Pamiętaj też, że to dane przekrojowe. Krzywa opisuje, jak dobrostan różni się między osobami o różnej długości snu, a nie skutek wydłużenia snu.
Diagnostyka i analizy wrażliwości
Po dopasowaniu modelu sprawdź cztery rzeczy (przepis 2 w kodzie):
- Czy
knie było za małe.gam.check()podaje k-index. Wartość wyraźnie poniżej 1 z małym p, przy edf bliskimk', sugeruje, że krzywa potrzebuje większej bazy. W przykładzie k-index dla snu wyniósł 0.97 (p = .25) przy edf 4.77 z 9 możliwych, więc baza wystarczała. Dla pewności dopasuj model zk = 20: edf snu wzrosło tylko do 5.00, a AIC się nie zmieniło (4651.9). - Reszty.
gam.check()rysuje też wykresy reszt, które czytasz jak w zwykłej regresji (zob. diagnostyka regresji w R). - Współkrzywoliniowość (concurvity). To nieliniowy odpowiednik współliniowości: jedna gładka funkcja da się przybliżyć innymi. Wartości bliskie 1 są niepokojące. W przykładzie dla składników gładkich nie przekraczały .06, bo sen i wiek nie były powiązane.
- Czy kształt różni się między grupami. Osobne krzywe dla kobiet i mężczyzn (
s(sen, by = plec)) dały AIC 4660.0 wobec 4651.9 dla wspólnej krzywej, więc wspólny kształt wystarcza. Taki model to nieliniowy odpowiednik interakcji. Interakcję dwóch zmiennych ciągłych modeluje się powierzchniąte(x, z).
Wybór k, rodzaju bazy i metody wygładzania warto opisać jako część analizy wrażliwości. Większa elastyczność ma też koszt: w małych próbach krzywa może podążać za szumem (przeuczenie). Jeśli model ma przewidywać, sprawdź go walidacją krzyżową, tak jak inne modele predykcyjne.
Ta sama składnia działa w szerszych zastosowaniach. Wynik binarny modelujesz z family = binomial (krzywa na skali logitu, jak w regresji logistycznej). Dane zagnieżdżone obsłużysz, dodając losowy wyraz wolny s(id, bs = "re"), podobnie jak w modelu wielopoziomowym. Gdy nieliniowość dotyczy samej zmiennej zależnej, a nie związku, rozważ transformację albo inny rozkład w GLM.
Jak opisać model GAM w artykule
W metodzie podaj pakiet i jego wersję, rodzaj bazy, k, metodę wygładzania i sposób porównania modeli. W wynikach podaj edf, test F i p dla każdego składnika gładkiego, dopasowanie całego modelu i rysunek krzywej z przedziałem ufności. Kilka wartości przewidywanych w tekście ułatwia czytelnikowi zrozumienie kształtu. Ogólne zasady przygotowania rysunków opisujemy we wpisie tabele i rysunki do artykułu naukowego.
Gdy recenzent pyta, dlaczego nie podzielono predyktora na grupy albo nie użyto kwadratu, wystarczy krótkie porównanie AIC z tabeli wyżej i odwołanie do literatury o kategoryzacji. Podobne zarzuty i wzory odpowiedzi zebraliśmy we wpisie zarzuty recenzentów do statystyki. Jeśli chcesz, żeby ktoś sprawdził specyfikację modelu przed wysłaniem artykułu, zajrzyj do oferty dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik sen-dobrostan-dane.csv (możesz go pobrać tutaj), porównuje modele i dopasowuje GAM. Drugi wykonuje diagnostykę. Potrzebujesz pakietu mgcv, który jest instalowany razem z R.
1. Porównanie modeli i model GAM
R
# Dane symulowane: 600 dorosłych; czas snu (godziny na dobę), wiek, płeć i dobrostan WHO-5 (0–100)
suppressPackageStartupMessages(library(mgcv))   # mgcv dołącza też pakiet nlme
library(splines)
set.seed(2091)
n <- 600
sen <- round(pmin(pmax(rnorm(n, 7, 1.3), 4), 10.5), 1)
wiek <- round(runif(n, 20, 75))
plec <- factor(sample(c("kobieta", "mężczyzna"), n, replace = TRUE))
# prawdziwy związek: dobrostan rośnie wraz z czasem snu do ok. 7 h, potem się wypłaszcza; łagodny dołek w średnim wieku
f_sen <- 25 * plogis((sen - 6) / 0.4) - 25
f_wiek <- 0.01 * (wiek - 48)^2
dobrostan <- round(pmin(pmax(62 + f_sen + f_wiek - 3 * (plec == "mężczyzna") + rnorm(n, 0, 12), 0), 100))
dane <- data.frame(sen, wiek, plec, dobrostan)
write.csv(dane, "sen-dobrostan-dane.csv", row.names = FALSE)
round(sapply(dane[, c("sen", "wiek", "dobrostan")], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
table(dane$plec)

# 1. Pięć sposobów modelowania czasu snu (wiek i płeć liniowo)
dane$sen_tercyl <- cut(dane$sen, quantile(dane$sen, 0:3 / 3), include.lowest = TRUE)
dane$sen_mediana <- factor(dane$sen > median(dane$sen), labels = c("niski", "wysoki"))
modele <- list(
  liniowy   = lm(dobrostan ~ sen + wiek + plec, data = dane),
  mediana   = lm(dobrostan ~ sen_mediana + wiek + plec, data = dane),
  tercyle   = lm(dobrostan ~ sen_tercyl + wiek + plec, data = dane),
  kwadratowy = lm(dobrostan ~ poly(sen, 2) + wiek + plec, data = dane),
  splajn_ns4 = lm(dobrostan ~ ns(sen, df = 4) + wiek + plec, data = dane),
  gam       = gam(dobrostan ~ s(sen) + wiek + plec, data = dane, method = "REML"))
porownanie <- data.frame(model = names(modele),
  df_modelu = sapply(modele, function(m) round(if (inherits(m, "gam")) sum(m$edf) + 1 else length(coef(m)) + 1, 2)),
  R2 = sapply(modele, function(m) round(if (inherits(m, "gam")) summary(m)$r.sq else summary(m)$adj.r.squared, 3)),
  AIC = sapply(modele, function(m) round(AIC(m), 1)))
porownanie$dAIC <- round(porownanie$AIC - min(porownanie$AIC), 1)
print(porownanie, row.names = FALSE)
table(dane$sen_tercyl)
# Wierzchołek paraboli z modelu kwadratowego (surowe potęgi): −b1 / (2 × b2)
m_kw <- lm(dobrostan ~ sen + I(sen^2) + wiek + plec, data = dane)
cat("Wierzchołek paraboli:", round(-coef(m_kw)[["sen"]] / (2 * coef(m_kw)[["I(sen^2)"]]), 2), "h\n")

# 2. Model GAM: gładkie funkcje snu i wieku, płeć parametrycznie, REML
m_gam <- gam(dobrostan ~ s(sen) + s(wiek) + plec, data = dane, method = "REML")
summary(m_gam)
round(c(AIC_gam = AIC(m_gam), AIC_liniowy = AIC(modele$liniowy)), 1)

# 3. Przewidywany dobrostan dla wybranych długości snu (wiek 48, kobieta) z 95% CI
nowe <- data.frame(sen = c(5, 6, 7, 7.5, 8, 9, 10), wiek = 48, plec = "kobieta")
pr <- predict(m_gam, nowe, se.fit = TRUE)
print(data.frame(sen = nowe$sen, przewidywany = round(pr$fit, 1),
                 dolny95 = round(pr$fit - 1.96 * pr$se.fit, 1), gorny95 = round(pr$fit + 1.96 * pr$se.fit, 1)), row.names = FALSE)

# 4. Nachylenie krzywej snu (pochodna z różnic skończonych) i zakres, w którym 95% CI wyklucza zero
siatka <- data.frame(sen = seq(4, 10.5, by = 0.05), wiek = 48, plec = "kobieta")
eps <- 1e-4
X0 <- predict(m_gam, siatka, type = "lpmatrix")
X1 <- predict(m_gam, transform(siatka, sen = sen + eps), type = "lpmatrix")
Xd <- (X1 - X0) / eps
nachyl <- drop(Xd %*% coef(m_gam))
se_nachyl <- sqrt(rowSums((Xd %*% vcov(m_gam)) * Xd))
siatka$nachylenie <- nachyl
siatka$istotne <- abs(nachyl / se_nachyl) > 1.96
siatka$przewid <- drop(X0 %*% coef(m_gam))
print(data.frame(sen = c(5, 6, 7, 8, 9), nachylenie = round(nachyl[match(c(5, 6, 7, 8, 9), round(siatka$sen, 2))], 2),
                 se = round(se_nachyl[match(c(5, 6, 7, 8, 9), round(siatka$sen, 2))], 2)), row.names = FALSE)
odcinki <- rle(siatka$istotne)
koniec <- cumsum(odcinki$lengths); poczatek <- koniec - odcinki$lengths + 1
print(data.frame(od = siatka$sen[poczatek], do = siatka$sen[koniec], nachylenie_rozne_od_zera = odcinki$values))
cat("Osoby śpiące co najmniej 9 h:", sum(dane$sen >= 9), "\n")
Wynik w R
      sen  wiek dobrostan
M    7.02 47.80     57.76
SD   1.30 15.84     13.89
min  4.00 20.00     15.00
max 10.50 75.00     93.00

  kobieta mężczyzna
      321       279
      model df_modelu    R2    AIC dAIC
    liniowy      5.00 0.231 4708.2 38.7
    mediana      5.00 0.168 4755.1 85.6
    tercyle      6.00 0.230 4710.0 40.5
 kwadratowy      6.00 0.262 4684.7 15.2
 splajn_ns4      8.00 0.282 4669.5  0.0
        gam      8.75 0.281 4673.1  3.6

   [4,6.5]  (6.5,7.6] (7.6,10.5]
       207        203        190
Wierzchołek paraboli: 9.37 h

Family: gaussian
Link function: identity

Formula:
dobrostan ~ s(sen) + s(wiek) + plec

Parametric coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)    59.1340     0.6461  91.522  < 2e-16 ***
plecmężczyzna  -2.9477     0.9511  -3.099  0.00203 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Approximate significance of smooth terms:
          edf Ref.df      F  p-value
s(sen)  4.774  5.850 39.992  < 2e-16 ***
s(wiek) 3.509  4.343  5.685 0.000118 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

R-sq.(adj) =   0.31   Deviance explained =   32%
-REML = 2322.6  Scale est. = 133.13    n = 600
    AIC_gam AIC_liniowy
     4651.9      4708.2
  sen przewidywany dolny95 gorny95
  5.0         42.7    39.6    45.9
  6.0         50.3    47.8    52.9
  7.0         60.3    57.9    62.6
  7.5         62.3    60.0    64.7
  8.0         62.6    60.2    65.0
  9.0         63.3    60.1    66.4
 10.0         64.0    59.1    68.9
 sen nachylenie   se
   5       4.51 2.19
   6      10.62 1.71
   7       6.71 1.52
   8      -0.11 1.76
   9       1.17 2.09
   od    do nachylenie_rozne_od_zera
1 4.0  4.95                    FALSE
2 5.0  7.35                     TRUE
3 7.4 10.50                    FALSE
Osoby śpiące co najmniej 9 h: 45
2. Diagnostyka: k, concurvity i osobne krzywe w grupach
R
# Diagnostyka modelu GAM z przepisu 1: wymiar bazy k, reszty i współkrzywoliniowość (concurvity)
set.seed(2092)
gam.check(m_gam, rep = 0)
round(concurvity(m_gam, full = TRUE), 3)

# Wrażliwość na górną granicę wymiaru bazy k: efektywne df prawie się nie zmieniają
wrazliwosc_k <- sapply(c(5, 10, 20), function(k) {
  m <- gam(dobrostan ~ s(sen, k = k) + s(wiek, k = k) + plec, data = dane, method = "REML")
  c(k = k, edf_sen = round(sum(m$edf[grep("s\\(sen", names(m$edf))]), 2),
    edf_wiek = round(sum(m$edf[grep("s\\(wiek", names(m$edf))]), 2), AIC = round(AIC(m), 1))
})
print(t(wrazliwosc_k))

# Czy zależność od snu różni się u kobiet i mężczyzn? Osobne krzywe (by =) a wspólna krzywa
m_by <- gam(dobrostan ~ plec + s(sen, by = plec) + s(wiek), data = dane, method = "REML")
round(c(AIC_wspolna = AIC(m_gam), AIC_osobne = AIC(m_by)), 1)
Wynik w R
Method: REML   Optimizer: outer newton
full convergence after 5 iterations.
Gradient range [-0.001572995,2.272593e-05]
(score 2322.62 & scale 133.1299).
Hessian positive definite, eigenvalue range [0.9589396,298.0189].
Model rank =  20 / 20

Basis dimension (k) checking results. Low p-value (k-index<1) may
indicate that k is too low, especially if edf is close to k'.

          k'  edf k-index p-value
s(sen)  9.00 4.77    0.97    0.25
s(wiek) 9.00 3.51    1.02    0.68
          para s(sen) s(wiek)
worst    0.471  0.052   0.056
observed 0.471  0.021   0.013
estimate 0.471  0.022   0.016
      k edf_sen edf_wiek    AIC
[1,]  5    3.66     3.16 4650.9
[2,] 10    4.77     3.51 4651.9
[3,] 20    5.00     3.54 4651.9
AIC_wspolna  AIC_osobne
     4651.9      4660.0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), splines::ns(), mgcv::gam(), gam.check(), concurvity()); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9-4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Podział predyktora na grupy, żeby „uchwycić nieliniowość”. Tracisz informację, a próg z próby nie przenosi się na inne badania.
- Wniosek o optimum z wierzchołka paraboli. Kwadrat wymusza symetryczny łuk. Porównaj go z modelem elastycznym i obejrzyj dane.
- Brak
method = "REML". Funkcjagam()domyślnie dobiera wygładzanie kryterium GCV, a Wood (2011) przywołuje argumenty za REML. Ustaw metodę jawnie i podaj ją w opisie. - Interpretowanie edf jako wielkości efektu. edf opisuje złożoność kształtu, a nie siłę związku. Siłę pokazują wartości przewidywane i rysunek.
- Odczytywanie kształtu na krańcach zakresu. Tam, gdzie jest mało obserwacji, przedziały są szerokie, a krzywa niepewna.
- Wybór specyfikacji po obejrzeniu wielu wersji. Liczbę węzłów,
ki zestaw zmiennych zapisz w planie analizy, a inne wersje pokaż jako analizę wrażliwości. - Język przyczynowy przy danych przekrojowych. „Wiązał się z”, a nie „wpływał na”.
Najczęstsze pytania
Co oznaczają efektywne stopnie swobody (edf) w modelu GAM?
edf opisuje, jak bardzo wygięta jest oszacowana krzywa: edf = 1 to prosta, a wyższe wartości oznaczają bardziej złożony kształt. To miara złożoności, a nie siły związku. Siłę pokazują wartości przewidywane i wykres krzywej z przedziałem ufności.
Czym splajn różni się od regresji wielomianowej?
Wielomian, np. parabola, ma jeden wzór dla całego zakresu predyktora, więc kształt w jednej części wymusza kształt w innej. Splajn składa się z odcinków wielomianów połączonych gładko w węzłach i może np. rosnąć, a potem się wypłaszczyć. Regresja kwadratowa potrafi przez to wskazać optimum, którego w danych nie ma (Simonsohn, 2018).
Jak wybrać k w funkcji s() w pakiecie mgcv?
k to górna granica złożoności krzywej, a właściwy stopień wygładzenia dobiera kara szacowana metodą REML. Zacznij od domyślnego k = 10, sprawdź gam.check() (k-index bliski 1, edf wyraźnie mniejsze niż k') i dopasuj model z większym k. Jeśli edf i AIC prawie się nie zmieniają, k wystarcza.
Jak opisać model GAM w artykule?
W metodzie podaj pakiet z wersją, rodzaj splajnu, k i metodę wygładzania (REML). W wynikach podaj dla każdego składnika gładkiego edf, F i p, dopasowanie modelu (R² skorygowane, odsetek wyjaśnionej dewiancji, AIC), rysunek krzywej z 95% CI i kilka wartości przewidywanych. Dodaj wynik diagnostyki k.
Czy model GAM nadaje się do małej próby?
Tak, ale elastyczność kosztuje. Kara za krzywiznę ogranicza dopasowanie do szumu, jednak przy małej liczbie obserwacji przedziały wokół krzywej są szerokie, zwłaszcza na krańcach zakresu. Zaplanuj prostszy model główny, ogranicz k i pokaż wersję liniową jako analizę wrażliwości.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikModele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →Recenzent pyta o nieliniowość albo kwestionuje podział zmiennej na grupy?
Pomożemy dobrać i sprawdzić model ze splajnami lub GAM, przygotować rysunek krzywej i opis wyników tak, żebyś mógł(a) samodzielnie obronić decyzje analityczne.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Hastie, T., & Tibshirani, R. (1986). Generalized additive models. Statistical Science, 1(3), 297–310. https://doi.org/10.1214/ss/1177013604 ● Otwarty dostęp
- Marra, G., & Wood, S. N. (2012). Coverage properties of confidence intervals for generalized additive model components. Scandinavian Journal of Statistics, 39(1), 53–74. https://doi.org/10.1111/j.1467-9469.2011.00760.x ● Otwarty dostęp: pełny tekst
- Perperoglou, A., Sauerbrei, W., Abrahamowicz, M., & Schmid, M. (2019). A review of spline function procedures in R. BMC Medical Research Methodology, 19(1), Article 46. https://doi.org/10.1186/s12874-019-0666-3 ● Otwarty dostęp
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
- Simonsohn, U. (2018). Two lines: A valid alternative to the invalid testing of U-shaped relationships with quadratic regressions. Advances in Methods and Practices in Psychological Science, 1(4), 538–555. https://doi.org/10.1177/2515245918805755 ● Otwarty dostęp: pełny tekst
- Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x ● Otwarty dostęp
- Wood, S. N. (2013). On p-values for smooth components of an extended generalized additive model. Biometrika, 100(1), 221–228. https://doi.org/10.1093/biomet/ass048 ● Otwarty dostęp: pełny tekst
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
Cytowania BibTeX
@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{hastie1986generalized, author={Hastie, Trevor and Tibshirani, Robert}, title={{Generalized additive models}}, journal={Statistical Science}, year={1986}, volume={1}, number={3}, pages={297--310}, doi={10.1214/ss/1177013604}}@article{marra2012coverage, author={Marra, Giampiero and Wood, Simon N.}, title={{Coverage properties of confidence intervals for generalized additive model components}}, journal={Scandinavian Journal of Statistics}, year={2012}, volume={39}, number={1}, pages={53--74}, doi={10.1111/j.1467-9469.2011.00760.x}}@article{perperoglou2019review, author={Perperoglou, Aris and Sauerbrei, Willi and Abrahamowicz, Michal and Schmid, Matthias}, title={{A review of spline function procedures in R}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={46}, doi={10.1186/s12874-019-0666-3}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}@article{simonsohn2018two, author={Simonsohn, Uri}, title={{Two lines: A valid alternative to the invalid testing of U-shaped relationships with quadratic regressions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={4}, pages={538--555}, doi={10.1177/2515245918805755}}@article{wood2011fast, author={Wood, Simon N.}, title={{Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2011}, volume={73}, number={1}, pages={3--36}, doi={10.1111/j.1467-9868.2010.00749.x}}@article{wood2013p, author={Wood, Simon N.}, title={{On p-values for smooth components of an extended generalized additive model}}, journal={Biometrika}, year={2013}, volume={100}, number={1}, pages={221--228}, doi={10.1093/biomet/ass048}}@book{wood2017generalized, author={Wood, Simon N.}, title={{Generalized additive models: An introduction with R (2nd ed.)}}, year={2017}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315370279}}