Przewidywanie to inny cel niż wyjaśnianie
Większość modeli regresji w psychologii, pedagogice i naukach o zdrowiu służy do wyjaśniania. Pytamy, czy sojusz terapeutyczny wiąże się z przerwaniem terapii przy kontroli innych zmiennych, i interpretujemy współczynniki. Model predykcyjny ma inne zadanie. Ma dla nowej osoby podać trafne prawdopodobieństwo zdarzenia, np. ryzyko, że pacjent zrezygnuje z terapii przed ósmą sesją. Shmueli (2010) wyjaśnia, że to dwa różne cele, a wysoka moc wyjaśniająca modelu nie oznacza wysokiej mocy predykcyjnej. Rozróżnienie ma znaczenie na każdym etapie budowy modelu. Yarkoni i Westfall (2017) dodają, że skupienie psychologii na wyjaśnianiu dało teorie o małej lub nieznanej zdolności przewidywania. Narzędzia uczenia maszynowego mogą to zmienić.
Z tej różnicy wynika jedna praktyczna zasada. Model predykcyjny ocenia się na danych, których nie widział. Współczynnik istotny w próbie, w której go oszacowano, nic nie mówi o tym, jak model zadziała u następnych pacjentów. Ten poradnik dla badaczy i doktorantów pokazuje krok po kroku, na jednym przykładzie w R:
- jak sprawdzić, czy próba wystarczy do zbudowania modelu,
- jak wygląda przeuczenie i dlaczego trafność pozorna je ukrywa,
- jak poprawnie przeprowadzić walidację krzyżową i bootstrap,
- kiedy pomaga kara LASSO albo regresja grzbietowa,
- jak czytać kalibrację, wynik Briera i próg decyzyjny w nowej próbie,
- co napisać w artykule według TRIPOD+AI.
Zakładamy, że znasz regresję logistyczną: ilorazy szans, założenia, pseudo-R² i krzywą ROC opisuje poradnik regresja logistyczna krok po kroku. Pojedyncze pojęcia mają osobne hasła: przeuczenie, walidacja krzyżowa, regresja grzbietowa i LASSO oraz kalibracja modelu. Tu łączymy je w jeden proces.
Przykład: kto przerwie psychoterapię przed ósmą sesją?
W przykładzie (dane symulowane) poradnia chce przewidywać, którzy pacjenci przerwą terapię przed ósmą sesją, aby wcześniej zaproponować im rozmowę o motywacji. W próbie rozwojowej jest 300 osób, z których terapię przerwało 95 (31.7%). Kandydaci na predyktory to:
- 5 zmiennych wskazanych w hipotezach: sojusz terapeutyczny po pierwszej sesji (1–7), motywacja do terapii (1–5), nasilenie objawów (0–40), wiek i wcześniejsze przerwanie terapii (1 = tak);
- 15 dodatkowych skal kwestionariuszowych (wyniki T), które zebrano „przy okazji”. W symulacji nie mają one żadnego związku z wynikiem, ale badacz o tym nie wie.
Mamy też drugą, niezależną próbę 2000 osób z tej samej populacji. Posłuży jako sprawdzian, na który w prawdziwym badaniu rzadko można liczyć. Dzięki niej zobaczysz, które oszacowania trafności z próby rozwojowej były blisko prawdy, a które nie. W prawdziwej walidacji zewnętrznej nowa próba pochodzi zwykle z innego ośrodka albo okresu, więc różni się także składem pacjentów.
Plik do pobrania: modele-predykcyjne-dane.csv. Plik ma 2300 wierszy, w tym kolumnę proba („rozwojowa” albo „walidacyjna”), wynik przerwanie (1 = tak), 5 predyktorów z hipotez i kolumny skala_01–skala_15. Wszystkie liczby w tekście pochodzą z kodu w sekcji Model predykcyjny w R.
Krok 1. Czy próba wystarczy do zbudowania modelu?
Popularna reguła mówi o co najmniej 10 zdarzeniach na zmienną (EPV, events per variable). U nas jest 95 zdarzeń, więc dla 5 predyktorów EPV wynosi 19.0, a dla 20 predyktorów tylko 4.8. Riley i in. (2019) zalecają jednak unikać takich reguł kciuka. Minimalną liczebność wyznaczają trzy kryteria:
- oczekiwane skurczenie współczynników nie mniejsze niż 0.9, czyli niewielkie przeuczenie;
- mała różnica między pozornym a skorygowanym R² Nagelkerkego (najwyżej .05);
- precyzyjne oszacowanie ogólnego ryzyka zdarzenia, np. z marginesem ±.05.
Kryteria 1 i 2 wymagają założenia, jakie R² Coxa–Snella osiągnie model. Najlepiej wziąć je z wcześniejszych badań. Przy założonym R² Coxa–Snella = .10 kryterium 1 daje minimum 1699 osób dla 20 predyktorów i 425 osób dla 5 predyktorów. Kryterium 3 przy częstości przerwań 31.7% wymaga 333 osób. Próba 300 osób nie spełnia więc żadnego kryterium dla 20 predyktorów i jest na granicy kryterium 3 dla modelu z 5 predyktorami. Gdy liczysz predyktory, licz parametry: zmienna kategorialna o czterech kategoriach to trzy parametry, a człon nieliniowy to kolejne.
To nie jest formalność. Liczebność decyduje o tym, ile predyktorów model w ogóle udźwignie. Przy małej próbie lepszy jest model prostszy, zbudowany na wiedzy merytorycznej. Ogólne zasady planowania liczebności opisuje wpis dobór liczebności próby, a przykład opisu kryteriów Riley w artykule klinicznym podajemy we wpisie statystyka w publikacji medycznej.
Krok 2. Trafność pozorna i przeuczenie
Dopasowaliśmy dwa modele regresji logistycznej: z 5 predyktorami z hipotez i ze wszystkimi 20. Ocena „pozorna” (apparent) to miary policzone na tej samej próbie, na której model oszacowano. Do oceny modelu predykcyjnego służą trzy grupy miar. Steyerberg i in. (2010) podkreślają, że dyskryminację i kalibrację należy raportować zawsze.
| Miara | Co mierzy | Wartość idealna |
|---|---|---|
| AUC (statystyka c) | dyskryminację: jak często osoba ze zdarzeniem dostaje wyższe ryzyko niż osoba bez zdarzenia (krzywa ROC) | 1 (.50 = losowo) |
| Nachylenie kalibracji | czy przewidywania są zbyt skrajne (< 1) albo zbyt ostrożne (> 1) | 1 |
| Wyraz wolny kalibracji (CITL) | czy model systematycznie zawyża albo zaniża ryzyko | 0 |
| Wynik Briera | średni kwadrat różnicy między przewidywanym prawdopodobieństwem a wynikiem 0/1; łączy dyskryminację i kalibrację | 0 (im mniej, tym lepiej) |
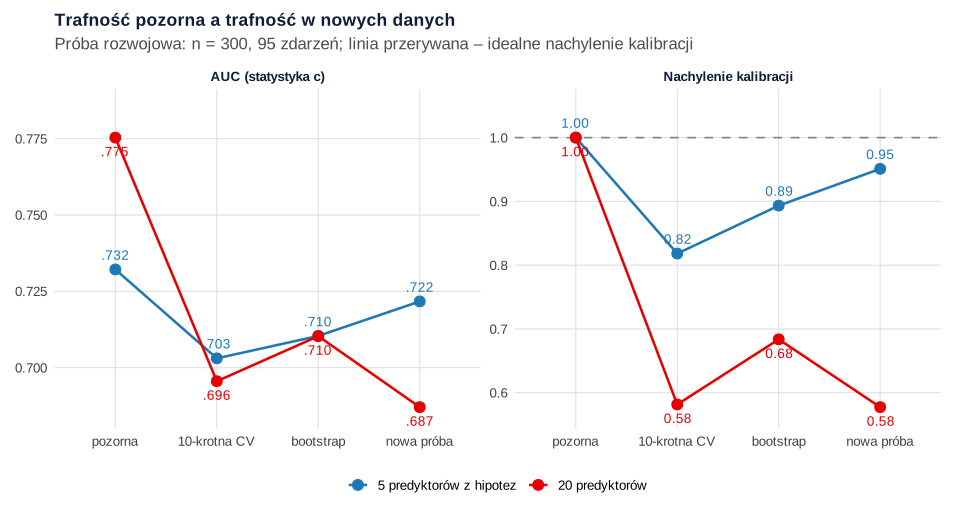
Trafność pozorna modelu z 20 predyktorami wygląda lepiej: AUC = .775 wobec .732, a wynik Briera to .167 wobec .182. Nachylenie kalibracji w próbie rozwojowej wynosi w obu modelach dokładnie 1, bo model jest „skalibrowany” do danych, z których powstał. Jedna z 15 skal, które w symulacji nie mają związku z wynikiem, dostała nawet istotny współczynnik (p = .018). Tak wygląda przeuczenie: model dopasowuje się do przypadkowego szumu próby. Babyak (2004) pokazuje, że przy danej liczbie obserwacji złożoność modelu ma górną granicę. Automatyczny dobór zmiennych, wstępne testowanie kandydatów i dychotomizacja zmiennych ciągłych dają wyniki, które nie replikują się w nowych próbach.
Wiemy już, ile wart był ten optymizm (rysunek 1). W nowej próbie 2000 osób model z 20 predyktorami osiągnął AUC = .687, a model z 5 predyktorami .722. Najbardziej spadło jednak nachylenie kalibracji modelu z 20 predyktorami, do 0.58. Jego przewidywania były zdecydowanie zbyt skrajne. Pytanie brzmi więc: jak oszacować te liczby bez nowej próby?
Krok 3. Walidacja krzyżowa krok po kroku
W k-krotnej walidacji krzyżowej dzielisz próbę losowo na k części (zwykle 10). Każdą część przewidujesz modelem zbudowanym na pozostałych dziewięciu. Po przejściu wszystkich części każda osoba ma jedno przewidywanie „spoza próby” i na nich liczysz AUC, wynik Briera i kalibrację. Podział jest losowy, więc wynik zależy od ziarna. Dlatego powtórz całą procedurę kilka lub kilkadziesiąt razy i podaj średnią z zakresem. Procedura w punktach:
- Ustal z góry formułę modelu albo cały algorytm, łącznie z doborem zmiennych, transformacjami i imputacją braków.
- Wylosuj podział na 10 części (dla rzadkich zdarzeń warstwowo według wyniku).
- Dla każdej części powtórz cały algorytm na 9/10 danych i zapisz przewidywania dla odłożonej części.
- Policz miary na wszystkich przewidywaniach spoza próby.
- Powtórz kroki 2–4 np. 20 razy i uśrednij.
Wynik w naszych danych (20 powtórzeń): model z 5 predyktorami miał AUC = .703 (zakres .694–.710) i nachylenie kalibracji 0.82. Model z 20 predyktorami miał AUC = .696 (zakres .669–.715) i nachylenie 0.58. Walidacja krzyżowa trafnie odwróciła ranking modeli i bardzo dobrze oszacowała nachylenie modelu z 20 predyktorami (0.58 w nowej próbie). Nachylenie modelu prostszego i AUC obu modeli wyszły nieco gorzej niż w nowej próbie. Każdy model w pętli powstaje na 270, a nie 300 osobach, a mała próba rozwojowa sama w sobie daje niepewne oszacowania. Ile części wybrać i czym walidacja krzyżowa różni się od podziału próby na pół, wyjaśnia hasło walidacja krzyżowa.
Krok 4. Bootstrap z korektą optymizmu
Drugą metodą walidacji wewnętrznej jest bootstrap. Losujesz ze zwracaniem próbę tej samej wielkości i budujesz na niej model. Liczysz jego trafność w próbie bootstrapowej i w próbie oryginalnej, a różnica między nimi to optymizm. Po 200 powtórzeniach średni optymizm odejmujesz od trafności pozornej. Steyerberg i in. (2001) porównali metody walidacji wewnętrznej modeli logistycznych. Podział próby dawał oszacowania zbyt pesymistyczne i bardzo zmienne, a bootstrap stabilne i mało obciążone. Autorzy zalecają więc bootstrap.
| Model | AUC pozorne | Optymizm AUC | AUC skorygowane | Nachylenie skorygowane |
|---|---|---|---|---|
| 5 predyktorów | .732 | .022 | .710 | 0.89 |
| 20 predyktorów | .775 | .065 | .710 | 0.68 |
Optymizm modelu z 20 predyktorami jest trzy razy większy. Po korekcie oba modele mają takie samo AUC, a model z 20 predyktorami ma wyraźnie gorszą kalibrację. Skorygowane nachylenie (0.68) można traktować jako współczynnik skurczenia: model przewidywałby lepiej, gdyby wszystkie jego współczynniki zmniejszyć mniej więcej o jedną trzecią. Tak samo działa kara w regresji grzbietowej, tylko wbudowana w estymację.
Wyciek informacji: błąd, który unieważnia walidację
Walidacja krzyżowa jest uczciwa tylko wtedy, gdy odłożona część naprawdę nie wpływa na budowę modelu. Najczęstszy błąd to dobór predyktorów na całej próbie i walidacja krzyżowa już wybranych zmiennych. Pokazujemy to na danych bez żadnego sygnału: 300 osób, 200 zmiennych losowych i wynik wylosowany niezależnie od nich. Gdy 10 zmiennych o najmniejszym p wybraliśmy na całej próbie, walidacja krzyżowa dała AUC = .734. Model wyglądał na całkiem przyzwoity, choć nie mógł niczego przewidywać. Gdy wybór powtarzano wewnątrz każdej pętli, AUC spadło do .564, czyli blisko poziomu losowego.
Varma i Simon (2006) pokazali to samo dla strojenia parametrów klasyfikatora. Oszacowanie błędu z walidacji krzyżowej, w której wybierano parametry, było wyraźnie obciążone. Nawet dla danych bez różnic między klasami klasyfikator często wydawał się trafny, a w niezależnej próbie nie był lepszy od losowania. Prawie nieobciążone oszacowanie dawała zagnieżdżona walidacja krzyżowa: pętla wewnętrzna stroi parametry, a zewnętrzna mierzy błąd. Wniosek dla praktyki: wewnątrz pętli powtarzaj wszystko, co patrzy na wynik. Dotyczy to doboru zmiennych (także metodą krokową), wyboru punktów odcięcia, siły kary, a nawet imputacji braków, jeśli model imputacyjny korzysta z wyniku.
Krok 5. LASSO i regresja grzbietowa: kara za złożoność
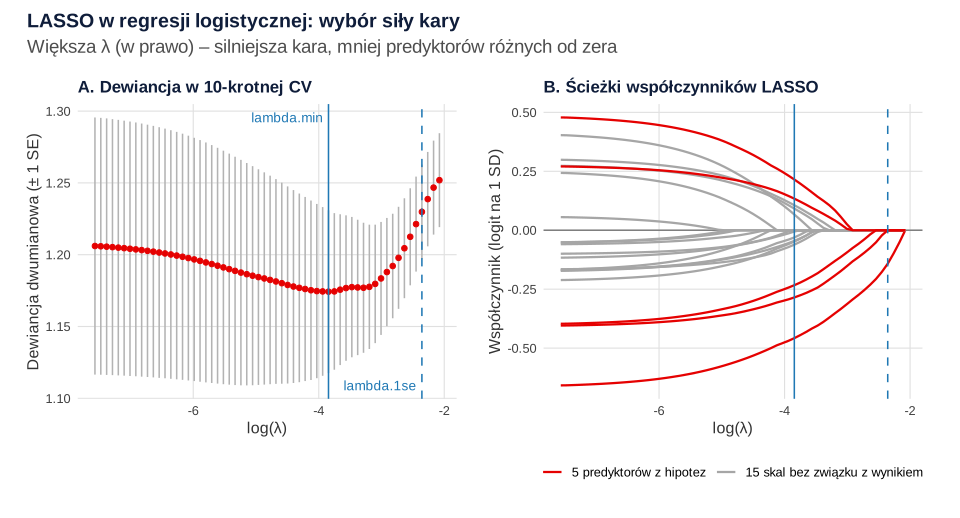
Zamiast ręcznie wybierać predyktory, możesz dodać do funkcji wiarygodności karę za duże współczynniki. Regresja grzbietowa (ridge) karze sumę kwadratów współczynników, więc zmniejsza wszystkie, ale żadnego nie zeruje. Tibshirani (1996) zaproponował LASSO. Kara za sumę wartości bezwzględnych współczynników ustawia część z nich dokładnie na zero, więc LASSO jednocześnie ściąga i wybiera zmienne. Siłę kary λ wybiera się walidacją krzyżową (rysunek 2). W pakiecie glmnet predyktory są domyślnie standaryzowane przed estymacją, a współczynniki wracają w oryginalnych jednostkach.
Wyniki w próbie rozwojowej:
- LASSO z lambda.min (λ = 0.0214) zachowało 13 predyktorów: wszystkie 5 z hipotez i 8 dodatkowych skal z bardzo małymi współczynnikami (co do wartości bezwzględnej najwyżej 0.011 na punkt T). LASSO nie odsiało więc szumu całkowicie, ale go zneutralizowało.
- LASSO z lambda.1se (λ = 0.0948, najsilniejsza kara w granicach 1 SE od minimum) zostawiło tylko motywację. Przy małej próbie ta reguła łatwo daje model zbyt ubogi.
- Regresja grzbietowa (λ = 0.0970) zachowuje wszystkie 20 zmiennych, ale je ściąga. Współczynnik sojuszu wyniósł −0.280, w LASSO −0.323, a w zwykłej regresji z 20 predyktorami −0.462.
Uwaga na ocenę modelu z karą. Funkcja cv.glmnet() raportuje AUC dla najlepszej λ (u nas .710). To samo CV wybrało jednak tę λ, więc wynik jest optymistyczny z konstrukcji, jak w przykładzie z wyciekiem. Uczciwą ocenę daje walidacja zagnieżdżona. Dla LASSO wyniosła AUC = .662 i nachylenie 0.75, a dla regresji grzbietowej .680 i 0.87. W tym przykładzie naiwna liczba przypadkiem trafiła blisko wyniku z nowej próby (.710). Nie da się jednak tego stwierdzić bez nowej próby, a w artykule raportujesz procedurę, nie szczęście.
Heinze i in. (2018) przypominają, że dobór zmiennych, zwłaszcza w modelowaniu wyjaśniającym, może naruszać stabilność modelu, nieobciążoność współczynników i trafność przedziałów ufności. Zalecają raportować stabilność selekcji ocenianą ponownym próbkowaniem. Lista zmiennych wybranych przez LASSO w jednej próbie nie jest więc odkryciem, które czynniki „naprawdę” mają znaczenie. Współczynniki z kary nie mają też zwykłych wartości p, o czym piszemy w haśle regresja grzbietowa i LASSO.
Krok 6. Nowa próba: dyskryminacja, kalibracja i wynik Briera
W niezależnej próbie 2000 osób terapię przerwało 638 (31.9%). Tabela 1 zestawia wszystkie modele.
Tabela 1
Trafność czterech modeli przewidywania przerwania psychoterapii: walidacja wewnętrzna i walidacja w niezależnej próbie
| Model | Predyktory | AUC (CV) | AUC (nowa próba) [95% CI] | Nachylenie (CV) | Nachylenie (nowa próba) | Brier | Skalowany Brier |
|---|---|---|---|---|---|---|---|
| Regresja logistyczna, predyktory z hipotez | 5 | .703 | .722 [.698, .745] | 0.82 | 0.95 | .189 | .132 |
| Regresja logistyczna, wszystkie zmienne | 20 | .696 | .687 [.662, .712] | 0.58 | 0.58 | .203 | .068 |
| LASSO | 13 | .662 | .710 [.686, .734] | 0.75 | 1.21 | .192 | .115 |
| Regresja grzbietowa | 20 | .680 | .694 [.670, .719] | 0.87 | 1.05 | .195 | .101 |
Uwaga. Dane symulowane. Próba rozwojowa: N = 300 (95 zdarzeń); próba walidacyjna: N = 2000 (638 zdarzeń). CV: dla modeli bez kary – 10-krotna walidacja krzyżowa powtórzona 20 razy; dla LASSO i regresji grzbietowej – zagnieżdżona walidacja krzyżowa (10 × 10) powtórzona 5 razy. AUC z 95% CI metodą DeLonga. Skalowany wynik Briera = 1 − Brier / Brier modelu bez predyktorów (.217). LASSO: λ wybrane jako lambda.min; liczba predyktorów to liczba niezerowych współczynników.
Dyskryminacja. Najlepiej rozróżniał osoby przerywające terapię model z 5 predyktorami (AUC = .722, 95% CI [.698, .745]), a model z 20 predyktorami najsłabiej (AUC = .687, 95% CI [.662, .712]). Te same osoby oceniono oboma modelami, więc AUC porównaliśmy testem DeLonga dla skorelowanych krzywych ROC. Różnica wyniosła .035, 95% CI [.020, .049], Z = 4.64, p < .001. Pamiętaj, że AUC około .70 to dyskryminacja umiarkowana. Model pomoże ustalić kolejność pacjentów według ryzyka, ale wielu z nich zaklasyfikuje błędnie.
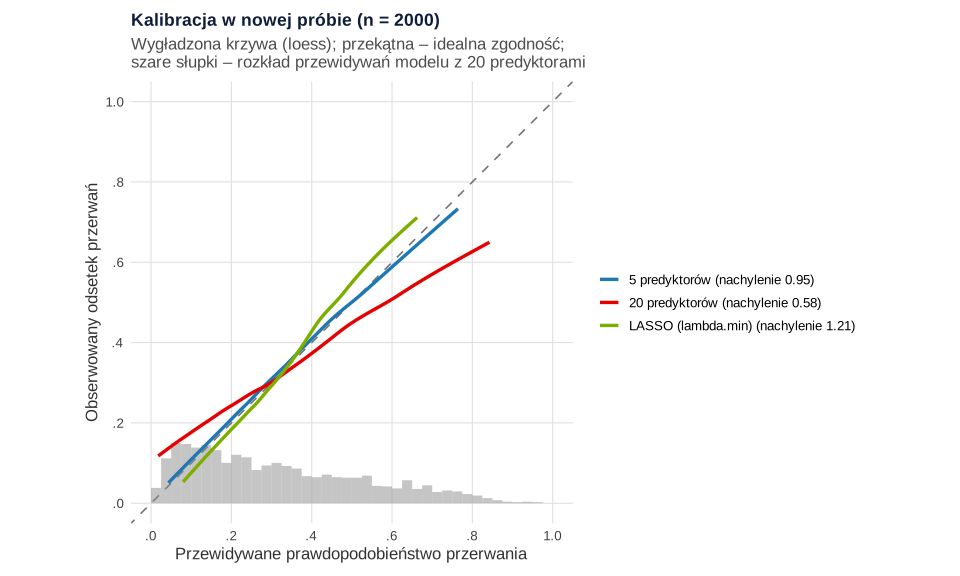
Kalibracja. Steyerberg i Vergouwe (2014) proponują, by w niezależnych danych oceniać model czterema kluczowymi miarami: kalibracją ogólną, czyli wyrazem wolnym (A), nachyleniem kalibracji (B), dyskryminacją mierzoną statystyką c (C) i użytecznością kliniczną z analizy krzywej decyzyjnej (D). Do oceny kalibracji potrzebna jest duża próba walidacyjna. Collins i in. (2016) na podstawie symulacji z ponownym próbkowaniem zalecają co najmniej 100, a najlepiej 200 lub więcej zdarzeń. Nasze 638 zdarzeń spełnia to z zapasem. Rysunek 3 pokazuje wygładzone krzywe kalibracji. Model z 20 predyktorami (nachylenie 0.58) zaniża ryzyko u osób z niskim przewidywaniem i zawyża je u osób z wysokim. W 10% osób o najniższym przewidywaniu podawał średnio 4.3% ryzyka, a terapię przerwało 10.0%. W 10% o najwyższym podawał 74.3%, a przerwało 57.5%. Model z 5 predyktorami leży blisko przekątnej (nachylenie 0.95). LASSO z lambda.min jest z kolei za ostrożne (nachylenie 1.21), czyli kara okazała się nieco za silna. Wyraz wolny kalibracji był bliski zera we wszystkich modelach (0.02–0.03), więc ogólny poziom ryzyka był trafny.
Wynik Briera. Sam wynik Briera trudno interpretować, bo zależy od częstości zdarzenia. Dlatego podaje się go także w wersji skalowanej, względem modelu bez predyktorów, który każdemu przypisuje ten sam odsetek. Skalowany wynik Briera wyniósł .132 dla modelu z 5 predyktorami i .068 dla modelu z 20 predyktorami. Przeuczony model zyskał więc nad „zgadywaniem średniej” o połowę mniej niż model prosty. Test Hosmera–Lemeshowa nie zastąpi tych miar. Steyerberg i in. (2010) zwracają uwagę na jego ograniczoną moc i słabą interpretowalność.
Próg decyzyjny i korzyść netto
Poradnia potrzebuje decyzji: komu zaproponować dodatkową rozmowę? Często wybiera się próg z największym indeksem Youdena. W próbie rozwojowej dla modelu z 20 predyktorami wypadł on przy ryzyku .394, z czułością .632 i swoistością .800. W nowej próbie ten sam próg dał czułość .519 i swoistość .760. Leeflang i in. (2008) opisali to zjawisko: wybór „optymalnego” punktu odcięcia na podstawie danych daje zbyt optymistyczne czułość i swoistość, a obciążenie maleje wraz z liczebnością próby. Próg wybrany w próbie rozwojowej traktuj więc jako propozycję do sprawdzenia, a nie jako wynik.
Lepiej wyjść od konsekwencji decyzji. Vickers i Elkin (2006) zaproponowali analizę krzywej decyzyjnej. Próg prawdopodobieństwa, przy którym zdecydowałbyś się na działanie, wyraża to, jak ważysz szkodę wyniku fałszywie dodatniego wobec fałszywie ujemnego. Z tego wynika korzyść netto modelu. Jeśli poradnia uznaje, że rozmowę warto zaproponować przy ryzyku co najmniej .30, korzyść netto w nowej próbie wyniosła .116 dla modelu z 5 predyktorami, .104 dla LASSO, .100 dla regresji grzbietowej i .096 dla modelu z 20 predyktorami. Strategia „rozmowa z każdym” dała .027. Korzyść netto .116 odpowiada mniej więcej 11.6 trafnie wskazanej osoby na 100 pacjentów, bez dodatkowych fałszywych alarmów. Pełną krzywą liczy się dla całego zakresu sensownych progów. Wartości predykcyjne dla wybranego progu opisuje hasło PPV i NPV.
Jak opisać model predykcyjny w artykule (TRIPOD+AI)
Modele predykcyjne raportuje się według listy TRIPOD+AI. Collins i in. (2024) opisują ją jako 27 głównych punktów, które zastępują TRIPOD 2015 i dotyczą modeli budowanych zarówno regresją, jak i uczeniem maszynowym. Lista wymaga m.in. uzasadnienia liczebności próby, opisu postępowania z brakami danych, opisu metody walidacji wewnętrznej oraz miar dyskryminacji i kalibracji. Kalibrację najlepiej pokazać na wykresie z wygładzoną krzywą. Minimum do sekcji metod i wyników:
- cel (predykcja, nie wyjaśnianie), populację, źródło danych, definicję wyniku i horyzont czasowy;
- kandydatów na predyktory z uzasadnieniem i sposobem kodowania (bez dychotomizacji);
- uzasadnienie liczebności (np. kryteria Riley z założonym R²) oraz liczbę zdarzeń;
- metodę estymacji (np. LASSO z λ z 10-krotnej CV) i walidacji wewnętrznej (bootstrap, CV, zagnieżdżona CV);
- AUC z 95% CI, nachylenie i wyraz wolny kalibracji, wykres kalibracji, wynik Briera;
- pełne równanie modelu albo kod, aby inni mogli go zwalidować zewnętrznie.
Nie pisz o „czynnikach ryzyka” ani o przyczynach. Model predykcyjny pokazuje, które zmienne pomagają przewidywać wynik, a nie które go wywołują. Jak przygotować kod i dane do udostępnienia, opisuje wpis pakiet replikacyjny. Typowe pytania recenzentów o modele zebraliśmy we wpisie zarzuty recenzentów do statystyki. Jeśli budujesz model do artykułu albo rozprawy i chcesz sprawdzić walidację, kalibrację lub opis według TRIPOD+AI, zajrzyj do oferty analiz statystycznych dla badaczy. Przeliczamy i konsultujemy, a interpretacja i odpowiedzialność za wnioski zostają przy autorach.
Model predykcyjny w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik modele-predykcyjne-dane.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji. Przepis 1 definiuje funkcje auc_mw() i miary(), z których korzystają pozostałe. Potrzebne pakiety: glmnet i pROC. Walidacja zagnieżdżona w przepisie 3 trwa kilka sekund.
1. Próba rozwojowa, liczebność i trafność pozorna
R
# 1. Próba rozwojowa, liczebność, model z 5 i z 20 predyktorami, trafność pozorna
options(width = 110)
# Funkcje pomocnicze B94: miary trafności modelu dla wyniku 0/1 i przewidywanych prawdopodobieństw p
auc_mw <- function(y, p) {                                  # AUC = statystyka c (wzór Manna–Whitneya)
  r <- rank(p); n1 <- sum(y == 1); n0 <- sum(y == 0)
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0)
}
miary <- function(y, p) {
  p <- pmin(pmax(p, 1e-6), 1 - 1e-6); lp <- qlogis(p)
  c(AUC = auc_mw(y, p),
    Brier = mean((y - p)^2),
    nachylenie = unname(coef(glm(y ~ lp, family = binomial))[2]),              # nachylenie kalibracji
    wyraz_wolny = unname(coef(glm(y ~ 1 + offset(lp), family = binomial))[1]))  # kalibracja ogólna (CITL)
}
dane <- read.csv("modele-predykcyjne-dane.csv")
roz <- subset(dane, proba == "rozwojowa")
predyktory <- setdiff(names(dane), c("id", "proba", "przerwanie"))
f20 <- reformulate(predyktory, "przerwanie")
f5  <- przerwanie ~ sojusz + motywacja + objawy + wiek + wczesniej

zdarzenia <- sum(roz$przerwanie)
c(n = nrow(roz), zdarzenia = zdarzenia, odsetek = round(100 * mean(roz$przerwanie), 1),
  EPV_20 = round(zdarzenia / 20, 1), EPV_5 = round(zdarzenia / 5, 1))

# Riley i in. (2019): kryterium (i) – skurczenie >= 0.9 przy założonym R2 Coxa–Snella; kryterium (iii) – ryzyko ±0.05
R2cs <- 0.10; S <- 0.9
n_i <- function(p) ceiling(p / ((S - 1) * log(1 - R2cs / S)))
phi <- mean(roz$przerwanie)
c(n_kryt_i_20 = n_i(20), n_kryt_i_5 = n_i(5), n_kryt_iii = ceiling((1.96 / 0.05)^2 * phi * (1 - phi)))

m5  <- glm(f5,  family = binomial, data = roz)
m20 <- glm(f20, family = binomial, data = roz)
ci5 <- exp(confint.default(m5))                                 # przedziały Walda dla OR
round(cbind(b = coef(m5), OR = exp(coef(m5)), OR_dolna = ci5[, 1], OR_gorna = ci5[, 2]), 3)
round(rbind(model_5 = miary(roz$przerwanie, fitted(m5)), model_20 = miary(roz$przerwanie, fitted(m20))), 3)
# Ile z 15 skal bez związku z wynikiem ma p < .05 w modelu z 20 predyktorami?
p_skal <- summary(m20)$coefficients[grep("skala", names(coef(m20))), 4]
c(skale_p_ponizej_05 = sum(p_skal < .05), min_p = round(min(p_skal), 3))
Wynik w R
        n zdarzenia   odsetek    EPV_20     EPV_5
    300.0      95.0      31.7       4.8      19.0
n_kryt_i_20  n_kryt_i_5  n_kryt_iii
       1699         425         333
                 b     OR OR_dolna OR_gorna
(Intercept)  4.011 55.185    8.103  375.851
sojusz      -0.468  0.626    0.453    0.865
motywacja   -0.812  0.444    0.297    0.664
objawy       0.066  1.068    1.020    1.118
wiek        -0.037  0.964    0.935    0.994
wczesniej    0.521  1.684    0.928    3.055
           AUC Brier nachylenie wyraz_wolny
model_5  0.732 0.182          1           0
model_20 0.775 0.167          1           0
skale_p_ponizej_05              min_p
             1.000              0.018
2. Walidacja krzyżowa, bootstrap i wyciek informacji
R
# 2. Walidacja wewnętrzna: powtarzana 10-krotna walidacja krzyżowa i bootstrap z korektą optymizmu
options(width = 110)
# funkcje auc_mw() i miary() – z przepisu 1
dane <- read.csv("modele-predykcyjne-dane.csv")
roz <- subset(dane, proba == "rozwojowa")
predyktory <- setdiff(names(dane), c("id", "proba", "przerwanie"))
formuly <- list(model_5 = przerwanie ~ sojusz + motywacja + objawy + wiek + wczesniej,
                model_20 = reformulate(predyktory, "przerwanie"))

cv_glm <- function(f, d, k = 10, powt = 20) {
  t(sapply(seq_len(powt), function(r) {
    fold <- sample(rep(1:k, length.out = nrow(d)))
    p <- numeric(nrow(d))
    for (j in 1:k) {
      m <- glm(f, family = binomial, data = d[fold != j, ])
      p[fold == j] <- predict(m, d[fold == j, ], type = "response")
    }
    miary(d$przerwanie, p)
  }))
}
boot_opt <- function(f, d, B = 200) {
  pozorne <- miary(d$przerwanie, fitted(glm(f, family = binomial, data = d)))
  opt <- t(sapply(seq_len(B), function(b) {
    db <- d[sample(nrow(d), replace = TRUE), ]
    mb <- glm(f, family = binomial, data = db)
    miary(db$przerwanie, fitted(mb)) - miary(d$przerwanie, predict(mb, d, type = "response"))
  }))
  rbind(pozorne = pozorne, optymizm = colMeans(opt), skorygowane = pozorne - colMeans(opt))
}
set.seed(9402)
cv <- lapply(formuly, cv_glm, d = roz)
cat("Powtarzana 10-krotna CV (20 powtórzeń): średnia i zakres AUC\n")
print(round(t(sapply(cv, function(x) c(colMeans(x), AUC_min = min(x[, "AUC"]), AUC_max = max(x[, "AUC"])))), 3))
set.seed(9403)
bo <- lapply(formuly, boot_opt, d = roz)
for (nm in names(bo)) { cat("Bootstrap (B = 200),", nm, "\n"); print(round(bo[[nm]], 3)) }
zapis <- do.call(rbind, lapply(names(formuly), function(nm) rbind(
  data.frame(model = nm, ocena = "pozorna", t(bo[[nm]]["pozorne", ])),
  data.frame(model = nm, ocena = "10-krotna CV", t(colMeans(cv[[nm]]))),
  data.frame(model = nm, ocena = "bootstrap", t(bo[[nm]]["skorygowane", ])))))

# Wyciek informacji: dobór predyktorów na całej próbie przed walidacją krzyżową (dane bez żadnego sygnału)
set.seed(9404)
n <- 300; X <- matrix(rnorm(n * 200), n); y <- rbinom(n, 1, .3)        # 200 zmiennych szumu
wybierz <- function(X, y, ile = 10) order(apply(X, 2, function(x) t.test(x ~ y)$p.value))[1:ile]
cv_wyciek <- function(wewnatrz, k = 10) {
  fold <- sample(rep(1:k, length.out = n)); p <- numeric(n)
  if (!wewnatrz) sel <- wybierz(X, y)                                   # BŁĄD: wybór na wszystkich danych
  for (j in 1:k) {
    tr <- fold != j
    if (wewnatrz) sel <- wybierz(X[tr, ], y[tr])                        # poprawnie: wybór w każdej pętli
    d_tr <- data.frame(y = y[tr], X[tr, sel]); d_te <- data.frame(X[!tr, sel])
    names(d_te) <- names(d_tr)[-1]
    p[!tr] <- predict(glm(y ~ ., binomial, d_tr), d_te, type = "response")
  }
  auc_mw(y, p)
}
c(AUC_wybor_poza_CV = round(cv_wyciek(FALSE), 3), AUC_wybor_w_CV = round(cv_wyciek(TRUE), 3))
Wynik w R
Powtarzana 10-krotna CV (20 powtórzeń): średnia i zakres AUC
           AUC Brier nachylenie wyraz_wolny AUC_min AUC_max
model_5  0.703 0.191      0.818      -0.002   0.694   0.710
model_20 0.696 0.196      0.582      -0.008   0.669   0.715
Bootstrap (B = 200), model_5
              AUC  Brier nachylenie wyraz_wolny
pozorne     0.732  0.182      1.000       0.000
optymizm    0.022 -0.009      0.107      -0.004
skorygowane 0.710  0.191      0.893       0.004
Bootstrap (B = 200), model_20
              AUC  Brier nachylenie wyraz_wolny
pozorne     0.775  0.167      1.000       0.000
optymizm    0.065 -0.028      0.316       0.009
skorygowane 0.710  0.195      0.684      -0.009
AUC_wybor_poza_CV    AUC_wybor_w_CV
            0.734             0.564
3. LASSO i regresja grzbietowa z zagnieżdżoną walidacją krzyżową
R
# 3. Regresja logistyczna z karą: LASSO i regresja grzbietowa (glmnet); zagnieżdżona walidacja krzyżowa
options(width = 110)
suppressPackageStartupMessages(library(glmnet))
# funkcje auc_mw() i miary() – z przepisu 1
dane <- read.csv("modele-predykcyjne-dane.csv")
roz <- subset(dane, proba == "rozwojowa")
predyktory <- setdiff(names(dane), c("id", "proba", "przerwanie"))
X <- as.matrix(roz[, predyktory]); y <- roz$przerwanie

set.seed(9405)
fold_id <- sample(rep(1:10, length.out = nrow(X)))
cv_lasso <- cv.glmnet(X, y, family = "binomial", alpha = 1, foldid = fold_id)
cv_ridge <- cv.glmnet(X, y, family = "binomial", alpha = 0, foldid = fold_id)
round(c(lasso_lambda_min = cv_lasso$lambda.min, lasso_lambda_1se = cv_lasso$lambda.1se,
        ridge_lambda_min = cv_ridge$lambda.min), 4)
b_l <- coef(cv_lasso, s = "lambda.min")[, 1]; b_l1 <- coef(cv_lasso, s = "lambda.1se")[, 1]
cat("LASSO (lambda.min) – niezerowe współczynniki:\n"); print(round(b_l[b_l != 0], 3))
cat("LASSO (lambda.1se) – niezerowe współczynniki:\n"); print(round(b_l1[b_l1 != 0], 3))
# Porównanie współczynników sojuszu: zwykła regresja z 20 predyktorami, ridge, LASSO
m20 <- glm(reformulate(predyktory, "przerwanie"), binomial, roz)
round(c(glm_20 = coef(m20)[["sojusz"]], ridge = coef(cv_ridge, s = "lambda.min")["sojusz", 1], lasso = b_l[["sojusz"]]), 3)

# „Naiwna” trafność z cv.glmnet (to samo CV wybrało lambdę) a zagnieżdżona walidacja krzyżowa
cv_auc <- cv.glmnet(X, y, family = "binomial", alpha = 1, foldid = fold_id, type.measure = "auc")
cat("AUC z cv.glmnet przy wybranej lambdzie (naiwne):", round(max(cv_auc$cvm), 3), "\n")
zagniezdzona <- function(alpha, powt = 5) {
  t(sapply(seq_len(powt), function(r) {
    zew <- sample(rep(1:10, length.out = nrow(X))); p <- numeric(nrow(X))
    for (j in 1:10) {
      cvj <- cv.glmnet(X[zew != j, ], y[zew != j], family = "binomial", alpha = alpha, nfolds = 10)
      p[zew == j] <- predict(cvj, X[zew == j, ], s = "lambda.min", type = "response")
    }
    miary(y, p)
  }))
}
set.seed(9406)
zl <- zagniezdzona(1); zr <- zagniezdzona(0)
round(rbind(lasso_zagniezdzona = colMeans(zl), ridge_zagniezdzona = colMeans(zr)), 3)
Wynik w R
lasso_lambda_min lasso_lambda_1se ridge_lambda_min
          0.0214           0.0948           0.0970
LASSO (lambda.min) – niezerowe współczynniki:
(Intercept)      sojusz   motywacja      objawy        wiek   wczesniej    skala_02    skala_05    skala_06
      2.673      -0.323      -0.638       0.034      -0.026       0.310       0.006       0.009      -0.001
   skala_07    skala_09    skala_11    skala_13    skala_15
     -0.006       0.011      -0.004      -0.005      -0.003
LASSO (lambda.1se) – niezerowe współczynniki:
(Intercept)   motywacja
     -0.107      -0.198
glm_20  ridge  lasso
-0.462 -0.280 -0.323
AUC z cv.glmnet przy wybranej lambdzie (naiwne): 0.71
                     AUC Brier nachylenie wyraz_wolny
lasso_zagniezdzona 0.662 0.201      0.754      -0.013
ridge_zagniezdzona 0.680 0.197      0.872       0.006
4. Walidacja w nowej próbie, próg Youdena i korzyść netto
R
# 4. Walidacja w niezależnej próbie (n = 2000): dyskryminacja, kalibracja, wynik Briera, próg, korzyść netto
options(width = 110)
suppressPackageStartupMessages({ library(glmnet); library(pROC) })
# funkcje auc_mw() i miary() – z przepisu 1
dane <- read.csv("modele-predykcyjne-dane.csv")
roz <- subset(dane, proba == "rozwojowa"); wal <- subset(dane, proba == "walidacyjna")
predyktory <- setdiff(names(dane), c("id", "proba", "przerwanie"))
f5 <- przerwanie ~ sojusz + motywacja + objawy + wiek + wczesniej
m5 <- glm(f5, binomial, roz); m20 <- glm(reformulate(predyktory, "przerwanie"), binomial, roz)
X <- as.matrix(roz[, predyktory]); Xw <- as.matrix(wal[, predyktory])
set.seed(9405)
fold_id <- sample(rep(1:10, length.out = nrow(X)))
cv_lasso <- cv.glmnet(X, roz$przerwanie, family = "binomial", alpha = 1, foldid = fold_id)
cv_ridge <- cv.glmnet(X, roz$przerwanie, family = "binomial", alpha = 0, foldid = fold_id)
pw <- list(model_5 = predict(m5, wal, type = "response"),
           model_20 = predict(m20, wal, type = "response"),
           lasso = as.numeric(predict(cv_lasso, Xw, s = "lambda.min", type = "response")),
           ridge = as.numeric(predict(cv_ridge, Xw, s = "lambda.min", type = "response")))
yw <- wal$przerwanie
c(n = length(yw), zdarzenia = sum(yw), odsetek = round(100 * mean(yw), 1))
tab <- t(sapply(pw, miary, y = yw))
ci <- t(sapply(pw, function(p) as.numeric(ci.auc(roc(yw, p, quiet = TRUE)))[c(1, 3)]))
colnames(ci) <- c("AUC_dolna", "AUC_gorna")
brier_0 <- mean((yw - mean(roz$przerwanie))^2)                       # model bez predyktorów
print(round(cbind(tab, ci, Brier_skalowany = 1 - tab[, "Brier"] / brier_0), 3))
cat("Brier modelu bez predyktorów:", round(brier_0, 3), "\n")
# Porównanie AUC: model z 5 a z 20 predyktorami (test DeLonga, te same osoby)
print(roc.test(roc(yw, pw$model_5, quiet = TRUE), roc(yw, pw$model_20, quiet = TRUE)))

# Kalibracja w dziesięciu grupach ryzyka (model z 20 predyktorami)
g <- cut(pw$model_20, quantile(pw$model_20, 0:10 / 10), include.lowest = TRUE, labels = FALSE)
print(round(data.frame(przewidywane = tapply(pw$model_20, g, mean), obserwowane = tapply(yw, g, mean))[c(1, 10), ], 3))

# Próg wybrany indeksem Youdena w próbie rozwojowej i jego działanie w próbie walidacyjnej
r_roz <- roc(roz$przerwanie, fitted(m20), quiet = TRUE)
prog <- coords(r_roz, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"))
prog <- prog[1, ]
ss <- function(y, p, t) c(czulosc = mean(p[y == 1] >= t), swoistosc = mean(p[y == 0] < t))
round(rbind(rozwojowa = unlist(prog[2:3]), walidacyjna = ss(yw, pw$model_20, prog$threshold)), 3)
cat("Próg Youdena:", round(prog$threshold, 3), "\n")

# Korzyść netto przy progu ryzyka .30 (krzywa decyzyjna w jednym punkcie)
kn <- function(y, p, t) { n <- length(y); tp <- sum(p >= t & y == 1); fp <- sum(p >= t & y == 0); tp / n - fp / n * t / (1 - t) }
round(c(sapply(pw, kn, y = yw, t = .30), wszyscy = kn(yw, rep(1, length(yw)), .30)), 4)
Wynik w R
        n zdarzenia   odsetek
   2000.0     638.0      31.9
           AUC Brier nachylenie wyraz_wolny AUC_dolna AUC_gorna Brier_skalowany
model_5  0.722 0.189      0.951       0.033     0.698     0.745           0.132
model_20 0.687 0.203      0.577       0.019     0.662     0.712           0.068
lasso    0.710 0.192      1.206       0.019     0.686     0.734           0.115
ridge    0.694 0.195      1.047       0.025     0.670     0.719           0.101
Brier modelu bez predyktorów: 0.217

	DeLong's test for two correlated ROC curves

data:  roc(yw, pw$model_5, quiet = TRUE) and roc(yw, pw$model_20, quiet = TRUE)
Z = 4.637, p-value = 3.535e-06
alternative hypothesis: true difference in AUC is not equal to 0
95 percent confidence interval:
 0.01999336 0.04926906
sample estimates:
AUC of roc1 AUC of roc2
  0.7216936   0.6870624

   przewidywane obserwowane
1         0.043       0.100
10        0.743       0.575
            sensitivity specificity
rozwojowa         0.632        0.80
walidacyjna       0.519        0.76
Próg Youdena: 0.394
 model_5 model_20    lasso    ridge  wszyscy
  0.1159   0.0961   0.1039   0.0997   0.0271
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Dane wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w modelach predykcyjnych
- Raportowanie tylko trafności pozornej. AUC z próby rozwojowej jest zawyżone. W przykładzie o .065 dla modelu z 20 predyktorami.
- Dobór predyktorów, progów albo λ poza pętlą walidacji. To wyciek informacji. Wewnątrz pętli powtarzaj cały algorytm albo użyj walidacji zagnieżdżonej.
- „Wrzucenie wszystkiego, co zebrano”. Więcej predyktorów przy tej samej liczbie zdarzeń to więcej przeuczenia, a nie lepsza predykcja.
- Jednorazowy podział próby na uczącą i testową przy małej liczebności. Daje zmienne i pesymistyczne oszacowania. Lepszy jest bootstrap albo powtarzana CV.
- Pomijanie kalibracji. Wysokie AUC nie gwarantuje trafnych prawdopodobieństw. Podaj nachylenie, wyraz wolny i wykres kalibracji.
- Trafność klasyfikacji (accuracy) jako główna miara. Zależy od progu i częstości zdarzenia. Lepsze są AUC, kalibracja i wynik Briera, a dla decyzji korzyść netto.
- Próg z indeksu Youdena podany jako „optymalny” bez sprawdzenia w nowych danych.
- Interpretowanie zmiennych wybranych przez LASSO jako przyczyn albo jedynych ważnych czynników. Selekcja w małej próbie jest niestabilna.
- Brak pełnego równania lub kodu modelu, przez co nikt nie może go zwalidować zewnętrznie.
Model predykcyjny bywa jednym z artykułów rozprawy. Jak zaplanować analizy całego doktoratu, aby kolejne badania mogły służyć jako walidacja zewnętrzna wcześniejszego modelu, opisuje wpis analiza statystyczna w doktoracie.
Najczęstsze pytania
Czym różni się model predykcyjny od modelu wyjaśniającego?
Model wyjaśniający służy do oceny związku konkretnych zmiennych z wynikiem przy kontroli innych i interpretuje się w nim współczynniki. Model predykcyjny ma trafnie przewidywać wynik u nowych osób, więc ocenia się go miarami trafności poza próbą: AUC, kalibracją i wynikiem Briera. Dobry model wyjaśniający nie musi dobrze przewidywać, a model predykcyjny nie mówi nic o przyczynach.
Co to jest korekta optymizmu metodą bootstrap?
Losujesz ze zwracaniem wiele prób tej samej wielkości, w każdej budujesz model i porównujesz jego trafność w próbie bootstrapowej z trafnością w próbie oryginalnej. Średnia różnica to optymizm, który odejmujesz od trafności pozornej. W przykładzie z 20 predyktorami optymizm AUC wyniósł .065, a skorygowane nachylenie kalibracji 0.68.
Dlaczego dobór zmiennych przed walidacją krzyżową jest błędem?
Bo odłożone części brały już udział w wyborze zmiennych, więc walidacja ocenia model na danych, które go ukształtowały. Na danych bez żadnego sygnału taki błąd dał w przykładzie AUC = .734, a poprawna procedura z wyborem wewnątrz każdej pętli – .564. Każdy krok, który korzysta z wyniku, musi być powtarzany w pętli albo w walidacji zagnieżdżonej.
Co oznacza nachylenie kalibracji mniejsze od 1?
Że przewidywania modelu są zbyt skrajne: osobom z niskim ryzykiem przypisuje za niskie prawdopodobieństwo, a osobom z wysokim za wysokie. To typowy objaw przeuczenia. Nachylenie większe od 1 oznacza przewidywania zbyt ostrożne, co zdarza się np. przy zbyt silnej karze w LASSO.
Jak interpretować wynik Briera?
Wynik Briera to średni kwadrat różnicy między przewidywanym prawdopodobieństwem a wynikiem 0/1, więc im mniejszy, tym lepiej. Jego wartość zależy od częstości zdarzenia, dlatego podaj też wersję skalowaną: 1 − Brier modelu / Brier modelu bez predyktorów. Skalowany wynik .13 oznacza, że model zmniejsza błąd kwadratowy o 13% w porównaniu z przypisaniem każdemu średniego ryzyka.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Budujesz model predykcyjny do artykułu lub doktoratu?
Sprawdzimy liczebność, przeprowadzimy walidację wewnętrzną i ocenę kalibracji w R oraz pomożemy opisać model według TRIPOD+AI, tak abyś rozumiał(a) każdy krok.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., Ghassemi, M., Liu, X., Reitsma, J. B., van Smeden, M., Boulesteix, A.-L., Camaradou, J. C., Celi, L. A., Denaxas, S., Denniston, A. K., Glocker, B., Golub, R. M., Harvey, H., Heinze, G., . . . Logullo, P. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ, 385, Article e078378. https://doi.org/10.1136/bmj-2023-078378 ● Otwarty dostęp
- Collins, G. S., Ogundimu, E. O., & Altman, D. G. (2016). Sample size considerations for the external validation of a multivariable prognostic model: A resampling study. Statistics in Medicine, 35(2), 214–226. https://doi.org/10.1002/sim.6787 ● Otwarty dostęp
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- Riley, R. D., Snell, K. I. E., Ensor, J., Burke, D. L., Harrell, F. E., Jr., Moons, K. G. M., & Collins, G. S. (2019). Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes. Statistics in Medicine, 38(7), 1276–1296. https://doi.org/10.1002/sim.7992 ● Otwarty dostęp
- Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-sts330 ● Otwarty dostęp
- Steyerberg, E. W., & Vergouwe, Y. (2014). Towards better clinical prediction models: Seven steps for development and an ABCD for validation. European Heart Journal, 35(29), 1925–1931. https://doi.org/10.1093/eurheartj/ehu207 ● Otwarty dostęp: pełny tekst
- Steyerberg, E. W., Harrell, F. E., Borsboom, G. J. J. M., Eijkemans, M. J. C., Vergouwe, Y., & Habbema, J. D. F. (2001). Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis. Journal of Clinical Epidemiology, 54(8), 774–781. https://doi.org/10.1016/s0895-4356(01)00341-9
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Varma, S., & Simon, R. (2006). Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 7(1), Article 91. https://doi.org/10.1186/1471-2105-7-91 ● Otwarty dostęp
- Vickers, A. J., & Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565–574. https://doi.org/10.1177/0272989x06295361 ● Otwarty dostęp: pełny tekst
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: Lessons from machine learning. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@article{collins2024tripod, author={Collins, Gary S. and Moons, Karel G. M. and Dhiman, Paula and Riley, Richard D. and Beam, Andrew L. and Van Calster, Ben and Ghassemi, Marzyeh and Liu, Xiaoxuan and Reitsma, Johannes B. and van Smeden, Maarten and Boulesteix, Anne-Laure and Camaradou, Jennifer Catherine and Celi, Leo Anthony and Denaxas, Spiros and Denniston, Alastair K. and Glocker, Ben and Golub, Robert M. and Harvey, Hugh and Heinze, Georg and Hoffman, Michael M. and Kengne, André Pascal and Lam, Emily and Lee, Naomi and Loder, Elizabeth W. and Maier-Hein, Lena and Mateen, Bilal A. and McCradden, Melissa D. and Oakden-Rayner, Lauren and Ordish, Johan and Parnell, Richard and Rose, Sherri and Singh, Karandeep and Wynants, Laure and Logullo, Patricia}, title={{TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods}}, journal={BMJ}, year={2024}, volume={385}, eid={e078378}, doi={10.1136/bmj-2023-078378}}@article{collins2016sample, author={Collins, Gary S. and Ogundimu, Emmanuel O. and Altman, Douglas G.}, title={{Sample size considerations for the external validation of a multivariable prognostic model: A resampling study}}, journal={Statistics in Medicine}, year={2016}, volume={35}, number={2}, pages={214--226}, doi={10.1002/sim.6787}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{riley2019minimum, author={Riley, Richard D. and Snell, Kym I. E. and Ensor, Joie and Burke, Danielle L. and Harrell, Frank E., Jr. and Moons, Karel G. M. and Collins, Gary S.}, title={{Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={7}, pages={1276--1296}, doi={10.1002/sim.7992}}@article{shmueli2010explain, author={Shmueli, Galit}, title={{To explain or to predict?}}, journal={Statistical Science}, year={2010}, volume={25}, number={3}, pages={289--310}, doi={10.1214/10-sts330}}@article{steyerberg2014towards, author={Steyerberg, Ewout W. and Vergouwe, Yvonne}, title={{Towards better clinical prediction models: Seven steps for development and an ABCD for validation}}, journal={European Heart Journal}, year={2014}, volume={35}, number={29}, pages={1925--1931}, doi={10.1093/eurheartj/ehu207}}@article{steyerberg2001internal, author={Steyerberg, Ewout W. and Harrell, Frank E. and Borsboom, Gerard J. J. M. and Eijkemans, Marinus J. C. and Vergouwe, Yvonne and Habbema, J. Dik F.}, title={{Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={8}, pages={774--781}, doi={10.1016/s0895-4356(01)00341-9}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{tibshirani1996regression, author={Tibshirani, Robert}, title={{Regression shrinkage and selection via the lasso}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1996}, volume={58}, number={1}, pages={267--288}, doi={10.1111/j.2517-6161.1996.tb02080.x}}@article{varma2006bias, author={Varma, Sudhir and Simon, Richard}, title={{Bias in error estimation when using cross-validation for model selection}}, journal={BMC Bioinformatics}, year={2006}, volume={7}, number={1}, eid={91}, doi={10.1186/1471-2105-7-91}}@article{vickers2006decision, author={Vickers, Andrew J. and Elkin, Elena B.}, title={{Decision curve analysis: A novel method for evaluating prediction models}}, journal={Medical Decision Making}, year={2006}, volume={26}, number={6}, pages={565--574}, doi={10.1177/0272989x06295361}}@article{yarkoni2017choosing, author={Yarkoni, Tal and Westfall, Jacob}, title={{Choosing prediction over explanation in psychology: Lessons from machine learning}}, journal={Perspectives on Psychological Science}, year={2017}, volume={12}, number={6}, pages={1100--1122}, doi={10.1177/1745691617693393}}