Statystyka w publikacji medycznej: czego oczekują recenzenci
Typowy artykuł z danych szpitalnych wygląda tak: Tabela 1 porównuje pacjentów z powikłaniem i bez niego, a w ostatniej kolumnie stoją wartości p. Potem regresja logistyczna z doborem krokowym wskazuje „niezależne czynniki ryzyka”, a krzywa ROC z „optymalnym” punktem odcięcia kończy pracę. Recenzent metodologiczny może zakwestionować każdy z tych kroków – i często powoła się przy tym na wytyczne raportowania, których autorzy nie sprawdzili.
Ten poradnik przeprowadza przez statystykę w publikacji medycznej w kolejności, w jakiej powstaje artykuł: wybór wytycznych (STROBE, CONSORT 2025, STARD 2015, TRIPOD+AI), sekcja „Statistical analysis”, Tabela 1, braki danych, liczebność, regresja logistyczna z wykresem lasu, krzywa ROC i walidacja modelu, a na końcu gotowe zdania po polsku i angielsku. Zakładamy, że znasz podstawy regresji logistycznej i krzywej ROC – tutaj skupiamy się na tym, jak je przeprowadzić i opisać, żeby wynik przeszedł recenzję. Jak czytać wyniki cudzych badań (NNT, wartości predykcyjne, krzywe Kaplana–Meiera), wyjaśniamy w poradniku statystyka dla lekarza.
Przez cały tekst pracujemy na jednym przykładzie (dane symulowane, liczby nie są normami klinicznymi): retrospektywna kohorta 700 pacjentów po planowej operacji w obrębie jamy brzusznej, a wynikiem jest powikłanie pooperacyjne w ciągu 30 dni. Powikłanie wystąpiło u 149 osób (21.3%). Wszystkie liczby pochodzą z kodu w sekcji Przykład w R.
Wytyczne raportowania: STROBE, CONSORT 2025, STARD 2015 i TRIPOD+AI
Wytyczne raportowania to listy kontrolne informacji, bez których czytelnik nie oceni wiarygodności badania. Wybór zależy od schematu badania, a nie od dziedziny. Wersje w tabeli sprawdziliśmy w bibliotece EQUATOR Network i w Crossref 16 października 2026 r.
| Wytyczne | Schemat badania | Aktualna wersja | Punkty | Najważniejsze dla statystyki |
|---|---|---|---|---|
| STROBE | obserwacyjne: kohortowe, kliniczno-kontrolne, przekrojowe | STROBE (2007) | 22 | definicje zmiennych, kontrola zakłócania, braki danych (12c), oszacowania surowe i skorygowane z 95% CI (16a) |
| CONSORT | badania randomizowane | CONSORT 2025 (aktualizacja CONSORT 2010) | 30 | plan analizy, braki danych (21c), Tabela 1 bez testów (25), efekty względne i bezwzględne z CI (26), podgrupy (28) |
| STARD | badania dokładności diagnostycznej | STARD 2015 | 30 | punkty odcięcia ustalone z góry lub eksploracyjne (12a), liczebność (18), tabela krzyżowa (23), dokładność z 95% CI (24) |
| TRIPOD+AI | modele predykcyjne (regresja i uczenie maszynowe) | TRIPOD+AI (2024), zastępuje TRIPOD 2015 | 27 | uzasadnienie liczebności (10), braki danych (11), walidacja wewnętrzna, dyskryminacja i kalibracja |
STROBE obejmuje 22 punkty, z których 18 jest wspólnych dla badań kohortowych, kliniczno-kontrolnych i przekrojowych, a 4 zależą od schematu (von Elm i in., 2007). Według biblioteki EQUATOR wersja z 2007 r. nadal jest aktualna; szczegółowe uzasadnienie każdego punktu zawiera dokument objaśniający (Vandenbroucke i in., 2007). CONSORT 2025 ma 30 punktów i aktualizuje wersję z 2010 r. – doszły m.in. punkty o udostępnianiu danych i kodu, udziale pacjentów, ocenie szkód, postępowaniu z brakami danych i faktycznym podawaniu interwencji, a listę uzgodniono z wytycznymi SPIRIT 2025 dla protokołów (Hopewell i in., 2025). STARD 2015 to 30 punktów, które powinny znaleźć się w każdym raporcie badania dokładności diagnostycznej (Bossuyt i in., 2015). TRIPOD+AI ma 27 głównych punktów, obejmuje modele budowane zarówno regresją, jak i uczeniem maszynowym, i zastępuje listę TRIPOD 2015, której – według autorów – nie należy już stosować (Collins i in., 2024). Przeglądy systematyczne raportuje się według PRISMA 2020.
Pracując nad artykułem, wypełniaj listę równolegle z pisaniem, a nie po fakcie, i sprawdź w instrukcjach dla autorów, czy czasopismo wymaga dołączenia wypełnionej listy kontrolnej. Badanie, które ma jednocześnie szacować związek czynnika z wynikiem i budować model predykcyjny, raportuj według obu list (STROBE i TRIPOD+AI) i wyraźnie oddziel te dwa cele.
Sekcja „Statistical analysis” – co musi zawierać
Sekcja metod statystycznych ma pozwolić osobie z dostępem do danych odtworzyć Twoje wyniki. Na podstawie STROBE, CONSORT 2025 i TRIPOD+AI zawiera co najmniej:
- Definicje zmiennych – wynik, ekspozycje, predyktory i potencjalne zmienne zakłócające, z kryteriami rozpoznania (Vandenbroucke i in., 2007).
- Statystyki opisowe – średnia i SD albo mediana z rozstępem ćwiartkowym, liczby i odsetki.
- Model i sposób doboru zmiennych – które zmienne i dlaczego (na podstawie wiedzy, nie wartości p), jak modelowano zmienne ciągłe (liniowo, splajny) i jakie miary efektu podajesz.
- Liczebność – jak ją ustalono i jakie przyjęto założenia (CONSORT 2025, punkt 16a; TRIPOD+AI, punkt 10).
- Braki danych – ile ich było i jak je potraktowano (STROBE 12c, CONSORT 21c, TRIPOD+AI 11).
- Analizy dodatkowe – podgrupy i analizy wrażliwości, z rozróżnieniem zaplanowanych i wykonanych post hoc.
- Ocenę modelu predykcyjnego – dyskryminację, kalibrację i metodę walidacji wewnętrznej.
- Oprogramowanie z wersjami pakietów oraz poziom istotności i informację, że testy były dwustronne.
Wzór dla naszego przykładu – najpierw po angielsku, bo w tym języku zwykle powstaje artykuł (zapis liczb jak w wielu czasopismach medycznych; dostosuj go do instrukcji dla autorów), potem po polsku:
Wzór zmieniaj tak, by opisywał to, co naprawdę zrobiłeś – recenzent porówna go z wynikami. Plan tych decyzji najlepiej spisać przed analizą (plan analizy statystycznej i prerejestracja), a jeśli potrzebujesz wsparcia przy metodach, obliczeniach albo odpowiedzi na uwagi recenzentów, zobacz ofertę analiz dla badaczy.
Tabela 1: charakterystyka pacjentów bez wartości p
W badaniu randomizowanym sprawa jest prosta. Wyjaśnienia do CONSORT 2025 (punkt 25) mówią wprost, że testów istotności różnic wyjściowych między grupami nie zaleca się i nie należy ich raportować: przy prawidłowej randomizacji każda różnica jest dziełem przypadku, a takie testy są zbędne i mogą wprowadzać w błąd (Hopewell i in., 2025). O ewentualnej nierównowadze decyduje siła prognostyczna zmiennej i wielkość różnicy, a nie wartość p. Zmienne ciągłe opisuj średnią i SD albo medianą i percentylami; błąd standardowy i przedział ufności nie opisują zmienności, bo są statystykami wnioskowania (Hopewell i in., 2025).
W badaniu obserwacyjnym grupy różnią się naprawdę, ale i tu tabela opisowa nie jest miejscem na testy: dokument objaśniający STROBE zaleca unikanie testów istotności w tabelach opisowych i przypomina, że wartość p nie jest właściwym kryterium wyboru zmiennych zakłócających do modelu (Vandenbroucke i in., 2007). Zamiast p rozważ standaryzowaną różnicę (SMD), która opisuje wielkość różnicy niezależnie od liczebności:
zmienna 0/1: SMD = (p1 − p0) / √{[p1(1 − p1) + p0(1 − p0)] / 2}
Austin (2009) opisał stosowanie SMD do zmiennych dychotomicznych i pokazał, że SMD = 0.1 odpowiada współczynnikowi φ = .05, czyli znikomej korelacji między grupą a zmienną. Dla zmiennych ilościowych SMD czyta się podobnie jak d Cohena. Tabela 1 dla naszej kohorty:
Tabela 1
Charakterystyka pacjentów według wystąpienia powikłania w ciągu 30 dni od operacji
| Cecha | Ogółem (N = 700) | Bez powikłania (n = 551) | Z powikłaniem (n = 149) | SMD | Braki, n (%) |
|---|---|---|---|---|---|
| Wiek, lata, M (SD) | 63.0 (11.1) | 61.6 (10.8) | 68.1 (10.9) | 0.60 | 0 |
| Płeć męska, n (%) | 399 (57.0) | 310 (56.3) | 89 (59.7) | 0.07 | 0 |
| BMI, kg/m², M (SD) | 27.6 (4.4) | 27.5 (4.4) | 27.9 (4.2) | 0.09 | 0 |
| Cukrzyca, n (%) | 133 (19.0) | 91 (16.5) | 42 (28.2) | 0.28 | 0 |
| Klasa ASA III–IV, n (%) | 219 (31.3) | 147 (26.7) | 72 (48.3) | 0.46 | 0 |
| Palenie tytoniu, n (%) | 172 (24.6) | 127 (23.0) | 45 (30.2) | 0.16 | 0 |
| Operacja otwarta, n (%) | 295 (42.1) | 204 (37.0) | 91 (61.1) | 0.50 | 0 |
| Czas operacji, min, Me [Q1, Q3] | 159 [133, 207] | 156 [133, 204] | 171 [135, 215] | 0.08 | 0 |
| Albumina, g/dl, M (SD) | 3.89 (0.48) | 3.90 (0.48) | 3.84 (0.50) | −0.13 | 106 (15.1) |
Uwaga. SMD – standaryzowana różnica (grupa z powikłaniem minus grupa bez powikłania); dla czasu operacji obliczona ze średnich i odchyleń standardowych. ASA – klasyfikacja stanu fizycznego pacjenta według American Society of Anesthesiologists. Albuminę oznaczono u 594 pacjentów. Dane symulowane.
Kolumna SMD od razu pokazuje, gdzie grupy różnią się wyraźnie: wiek (0.60), operacja otwarta (0.50), klasa ASA (0.46) i cukrzyca (0.28). Płeć, BMI i czas operacji różnią się nieznacznie (|SMD| < 0.1). Tabela 1 to opis, a nie test hipotez – dlatego nie ma w niej gwiazdek ani pogrubionych „istotnych” wierszy. Więcej wzorów tabel opisowych znajdziesz w haśle tabela statystyk opisowych w APA.
Braki danych: ile, u kogo i co z nimi zrobiono
Recenzent zapyta o braki danych zawsze, bo wpływają one na wiarygodność wszystkich dalszych analiz. Dokument objaśniający STROBE przypomina, że analiza tylko przypadków kompletnych w wielu sytuacjach jest nieobciążona, ale może być obciążona i zawsze jest nieefektywna, bo zmniejsza próbę (Vandenbroucke i in., 2007). Sterne i in. (2009) proponują listę informacji do raportowania przy każdej analizie dotkniętej brakami danych:
- liczbę braków dla każdej zmiennej (albo liczbę przypadków kompletnych) i ich przyczyny, także na diagramie przepływu pacjentów;
- porównanie osób z danymi kompletnymi i niekompletnymi;
- metodę postępowania z brakami i jej założenia, np. braki losowe (MAR – zob. braki danych MCAR, MAR i MNAR);
- przy imputacji wielokrotnej: oprogramowanie, liczbę imputowanych zbiorów (autorzy wskazują, że co najmniej 20 może być lepsze niż często proponowane 5), zmienne w modelu imputacji i porównanie z analizą przypadków kompletnych.
W naszej kohorcie brakowało tylko albuminy (106 pacjentów, 15.1%). Braki nie były przypadkowe: dotyczyły 18.1% pacjentów w klasie ASA I–II i 8.7% w klasie III–IV, a pacjenci bez oznaczenia byli młodsi (średnio 58.8 a 63.7 roku). To typowy sygnał, że analiza przypadków kompletnych mogłaby dać obciążony wynik, gdyby albumina była zmienną modelu. Jak przeprowadzić imputację wielokrotną krok po kroku, pokazujemy w poradniku braki danych i imputacja wielokrotna w R. Wzór opisu, gdy braki dotyczą zmiennych modelu:
Liczebność w regresji logistycznej: EPV to za mało
Popularna reguła „10 zdarzeń na zmienną” (EPV, ang. events per variable) ma słabe uzasadnienie: van Smeden i in. (2016) pokazali w symulacjach, że problemy małych prób zależą też od całkowitej liczebności i od separacji danych, a nie tylko od EPV. Riley i in. (2019) zaproponowali w zamian trzy kryteria minimalnej liczebności modelu predykcyjnego: (i) oczekiwany współczynnik skurczenia (ang. shrinkage) co najmniej 0.9, czyli niewielkie przeuczenie współczynników, (ii) różnica między pozornym a skorygowanym R² Nagelkerkego najwyżej .05 oraz (iii) oszacowanie ogólnego odsetka zdarzeń z dokładnością ±0.05. Wymagają one założenia, jakie R² Coxa–Snella osiągnie model, np. na podstawie wcześniejszych badań. Kryterium (i):
gdzie p to liczba parametrów modelu, S = 0.9 – docelowe skurczenie, a R²CS – zakładane R² Coxa–Snella. Dla 8 parametrów, R²CS = .10 i odsetka powikłań 0.20 kryterium (i) wymaga 680 pacjentów (dokładnie 679.2), kryterium (ii) – 236, a kryterium (iii) – 246. Rozstrzyga najwyższa wartość: 680 pacjentów, czyli 136 zdarzeń, co daje 17 zdarzeń na parametr. Reguła EPV ≥ 10 „pozwoliłaby” poprzestać na 80 zdarzeniach, czyli 400 pacjentach. Nasza kohorta (700 pacjentów, 149 zdarzeń, EPV = 18.6) spełnia kryteria. Riley i in. (2019) pokazują na przykładach, że wymagane EPV zależy od sytuacji – w ich przykładach od 4.8 do 23 – dlatego reguł kciuka lepiej unikać. Uzasadnienie liczebności opisuj w artykule zawsze (TRIPOD+AI, punkt 10; Collins i in., 2024).
Regresja logistyczna: model ustalony z góry, bez doboru krokowego
Zmienne do modelu wybieraj na podstawie wiedzy klinicznej i wcześniejszych badań, zanim zobaczysz wyniki – nie na podstawie wartości p z analiz jednoczynnikowych ani metodą krokową. Heinze i in. (2018) w przeglądzie metod doboru zmiennych pokazują, że dobór na podstawie danych może naruszać stabilność modelu, nieobciążoność współczynników oraz trafność wartości p i przedziałów ufności, zwłaszcza w modelach wyjaśniających. Sprawdziliśmy to symulacją: 500 razy wylosowaliśmy kohortę z tej samej populacji, w której prawdziwy OR dla palenia wynosi 1.45, i w każdej porównaliśmy model pełny z eliminacją wsteczną (zostawały zmienne z p < .05).
| Liczebność kohorty | Mediana EPV | Średni OR w modelu pełnym | Palenie zostało w modelu krokowym | Średni OR, gdy palenie zostało |
|---|---|---|---|---|
| 700 pacjentów | 17.9 | 1.47 | w 41.2% symulacji | 1.81 |
| 250 pacjentów | 6.4 | 1.48 | w 18.4% symulacji | 2.30 |
Model pełny szacuje efekt prawie bez obciążenia (średni OR 1.47 i 1.48 przy prawdziwym 1.45). Dobór krokowy w większości symulacji usuwa zmienną, która naprawdę wiąże się z wynikiem, a gdy ją zostawia, zawyża jej efekt – tym bardziej, im mniejsza próba (OR 2.30 przy EPV około 6). Wynik „istotny po doborze krokowym” to wynik wybrany dlatego, że przypadkiem wypadł duży. Liczbę zmiennych dopasuj więc do liczebności przed analizą, a nie po niej.
Model z ośmioma predyktorami ustalonymi z góry był istotnie lepszy od modelu zerowego, χ²(8) = 77.42, p < .001. Test ilorazu wiarygodności nie wykazał nieliniowości zmiennych ciągłych (model z naturalnymi splajnami: χ²(6) = 9.40, p = .152), więc wiek, BMI i czas operacji uwzględniono liniowo – na 10 lat, 5 kg/m² i 60 minut, żeby OR miały sensowną jednostkę. Ilorazy szans z 95% CI pokazuje tabela 2 i rysunek 1.
Tabela 2
Czynniki związane z powikłaniem w ciągu 30 dni od operacji: wieloczynnikowa regresja logistyczna
| Predyktor | OR | 95% CI | p | |
|---|---|---|---|---|
| LL | UL | |||
| Wiek (na 10 lat) | 1.58 | 1.30 | 1.92 | < .001 |
| Płeć męska | 0.99 | 0.67 | 1.47 | .967 |
| BMI (na 5 kg/m²) | 1.12 | 0.89 | 1.40 | .326 |
| Cukrzyca | 1.54 | 0.97 | 2.42 | .066 |
| Klasa ASA III–IV | 1.72 | 1.14 | 2.57 | .009 |
| Palenie tytoniu | 1.71 | 1.10 | 2.65 | .015 |
| Operacja otwarta | 2.11 | 1.42 | 3.14 | < .001 |
| Czas operacji (na 60 min) | 1.02 | 0.83 | 1.25 | .848 |
Uwaga. N = 700, 149 powikłań. OR – iloraz szans skorygowany o pozostałe zmienne w modelu; LL i UL – dolna i górna granica 95% przedziału ufności profilowej wiarygodności; p z testu Walda. Kategorie odniesienia: kobiety, brak cukrzycy, klasa ASA I–II, niepalący, operacja laparoskopowa. Model: χ²(8) = 77.42, p < .001; AUC = .72, 95% CI [.68, .77]; po korekcie optymizmu (500 prób bootstrapowych) AUC = .71 i nachylenie kalibracji 0.91. Dane symulowane.
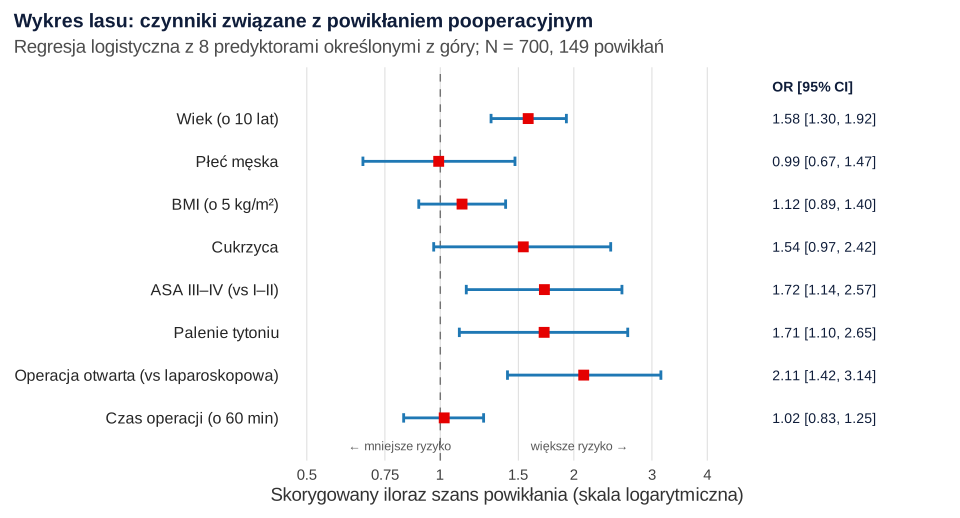
W artykule wystarczy jedno z tych dwóch przedstawień – na przykład wykres w tekście, a tabela w materiałach dodatkowych. Opisując wynik, pamiętaj o trzech sprawach:
- Jednostka. OR = 1.58 dotyczy różnicy 10 lat wieku, a nie roku. Przy powikłaniu występującym u co piątego pacjenta iloraz szans jest wyraźnie większy niż ryzyko względne, więc nie pisz, że ryzyko „rośnie 1.6 raza”.
- Przedział ufności, a nie gwiazdki. Cukrzyca (OR = 1.54, 95% CI [0.97, 2.42], p = .066) nie jest „nieistotna, więc bez znaczenia” – dane są zgodne zarówno z brakiem związku, jak i z ponad dwukrotnie większymi szansami powikłania.
- Nie każdy OR jest „niezależnym czynnikiem ryzyka”. Westreich i Greenland (2013) nazywają to błędem Tabeli 2: ilorazy szans zmiennych zakłócających z jednego modelu łatwo pomylić z efektami całkowitymi, choć są oszacowaniami efektów bezpośrednich i same mogą być zakłócone. Jeśli pytasz o wpływ konkretnej ekspozycji, zbuduj model dla niej, z zestawem zmiennych zakłócających dobranym właśnie do tego pytania.
Pełny opis założeń i diagnostyki modelu znajdziesz w poradniku regresja logistyczna: założenia, interpretacja i raportowanie, a wzór tabeli z ilorazami szans – w haśle tabela regresji logistycznej w APA.
Krzywa ROC, punkt odcięcia i optymizm
Jeśli model ma przewidywać ryzyko u kolejnych pacjentów, oceniasz go inaczej niż model wyjaśniający. Steyerberg i in. (2010) podkreślają, że dla modelu predykcyjnego zawsze należy raportować dyskryminację i kalibrację. Dyskryminacja to zdolność odróżniania pacjentów, u których wystąpi powikłanie, od pozostałych. Mierzy ją pole pod krzywą ROC: w naszym modelu AUC = .72, 95% CI [.68, .77] (metoda DeLonga). Interpretację AUC i indeksu Youdena omawia hasło krzywa ROC.
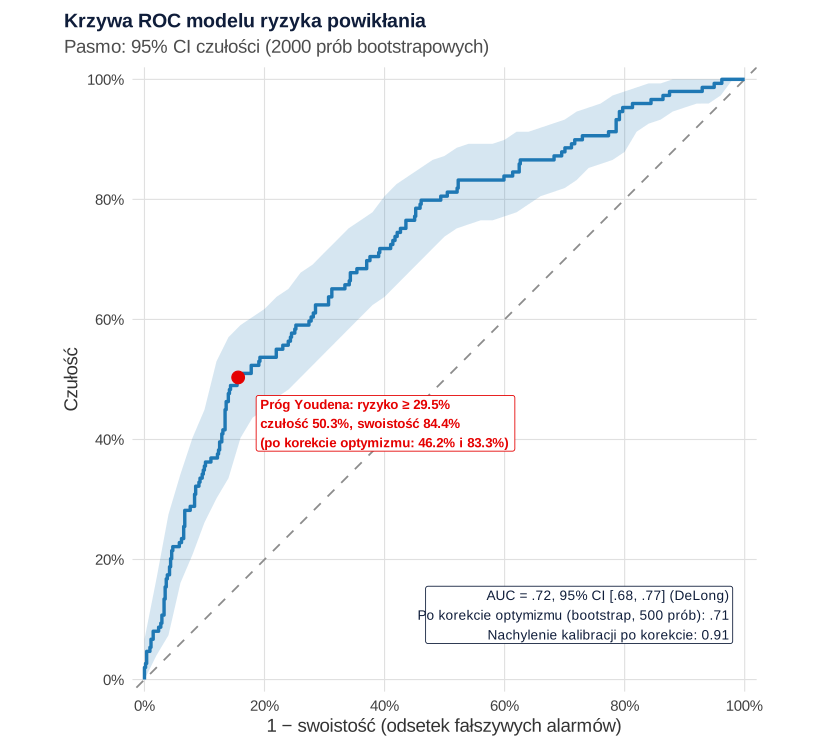
Indeks Youdena wskazał próg przewidywanego ryzyka 29.5%, przy którym czułość wynosi 50.3%, a swoistość 84.4%. To jednak liczby zbyt optymistyczne. Leeflang i in. (2008) pokazali, że punkt odcięcia wybrany na tych samych danych zawyża czułość i swoistość, tym bardziej, im mniejsza próba: przy prawdziwych wartościach 84% badania z 40 osobami szacowały je na około 90%. Dlatego STARD 2015 każe podać, czy punkty odcięcia ustalono z góry, czy wyznaczono eksploracyjnie (punkt 12a; Bossuyt i in., 2015).
Optymizm da się oszacować bootstrapem. Steyerberg i in. (2001) porównali metody walidacji wewnętrznej modelu regresji logistycznej: podział próby na część uczącą i testową dawał zbyt pesymistyczne i bardzo zmienne oszacowania, a bootstrap – stabilne i mało obciążone, dlatego autorzy go zalecają. Procedura wygląda tak:
- wylosuj ze zwracaniem próbę 700 pacjentów i dopasuj w niej cały model (z wyborem progu włącznie);
- oblicz AUC, czułość i swoistość tego modelu w próbie bootstrapowej oraz w danych oryginalnych;
- różnica to optymizm; powtórz 500 razy i uśrednij;
- odejmij średni optymizm od wartości pozornych (z danych, na których zbudowano model).
W przykładzie optymizm AUC wyniósł 0.018, więc po korekcie AUC = .71. Czułość przy progu Youdena spadła z 50.3% do 46.2%, a swoistość z 84.4% do 83.3%. Sam próg okazał się niestabilny: w 95% prób bootstrapowych mieścił się między 16.0% a 33.1% przewidywanego ryzyka (mediana 23.3%). Takiego progu nie przedstawiaj jako „optymalnego punktu odcięcia” do praktyki klinicznej – to wynik eksploracyjny, który wymaga sprawdzenia w nowych danych. Nachylenie kalibracji po korekcie wyniosło 0.91. Według Steyerberga i in. (2010) nachylenie mniejsze od 1 świadczy o przeuczeniu modelu i potrzebie skurczenia współczynników – tu niewielkim. W praktyce oznacza to nieco zbyt skrajne przewidywania: trochę za wysokie ryzyko u pacjentów wysokiego ryzyka i za niskie u pacjentów niskiego ryzyka.
Kalibracja i walidacja zewnętrzna
Kalibracja to zgodność przewidywanego ryzyka z obserwowaną częstością zdarzeń: wśród pacjentów z przewidywanym ryzykiem 20% powikłanie powinno wystąpić u około co piątego. TRIPOD+AI zaleca ocenę kalibracji na wykresie z przewidywanym ryzykiem na osi poziomej, obserwowaną częstością na pionowej i wygładzoną krzywą kalibracji (Collins i in., 2024). Steyerberg i in. (2010) opisują dwie liczby, które ją podsumowują: wyraz wolny kalibracji pokazuje, czy przewidywania są systematycznie za niskie albo za wysokie (ideał: 0), a nachylenie kalibracji powinno wynosić 1. Autorzy zwracają też uwagę na wady popularnego testu Hosmera–Lemeshowa: ograniczoną moc i słabą interpretowalność.
W danych, na których zbudowano model, kalibracja wygląda dobrze z definicji. Prawdziwy sprawdzian to walidacja zewnętrzna. W przykładzie (dane symulowane) model zastosowano bez zmian u 600 pacjentów z innego szpitala, w którym ryzyko wyjściowe było niższe, a związki predyktorów z powikłaniem słabsze. Powikłanie wystąpiło u 67 pacjentów (11.2%), podczas gdy średnie przewidywane ryzyko wynosiło 20.7%.
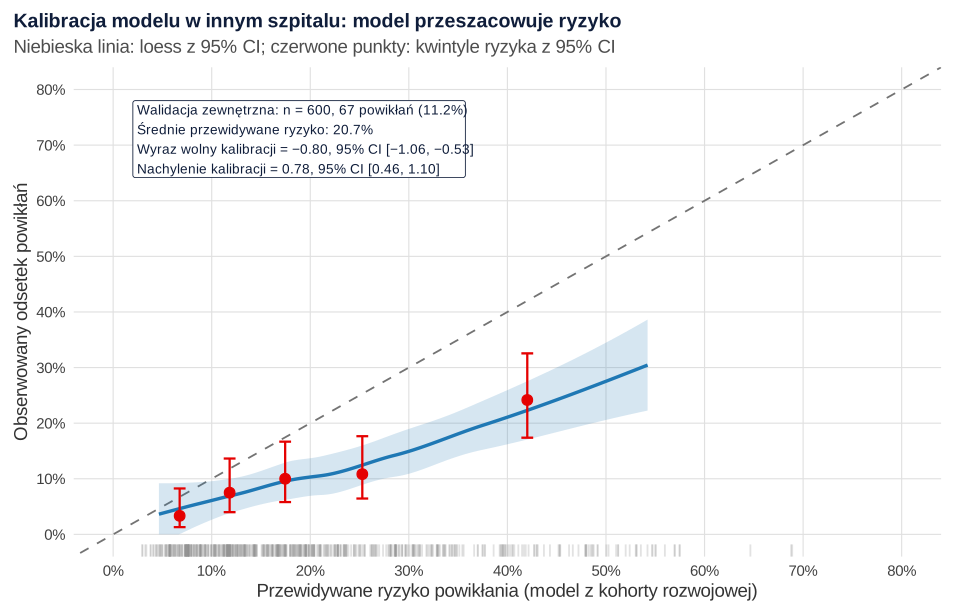
Wszystkie punkty leżą poniżej przekątnej: w najwyższym kwintylu model przewidywał 42.0% powikłań, a wystąpiło 24.2%. Wyraz wolny kalibracji wyniósł −0.80, 95% CI [−1.06, −0.53], czyli model systematycznie przeszacowywał ryzyko, a nachylenie 0.78, 95% CI [0.46, 1.10], sugeruje dodatkowo zbyt skrajne przewidywania, choć przy tej liczbie zdarzeń przedział obejmuje też wartość 1. Jednocześnie AUC = .68, 95% CI [.61, .75], niewiele odbiega od kohorty rozwojowej. Samo AUC nie pokazałoby problemu – model wciąż dobrze porządkuje pacjentów, ale podaje im błędne ryzyko bezwzględne. Przy 67 zdarzeniach krzywa kalibracji jest też mało precyzyjna, co widać po szerokim paśmie.
Wzory zdań do sekcji wyników (PL i EN)
Gotowe opisy dla przykładu. Zachowaj kolejność: liczebność i zdarzenia, model, najważniejsze OR z przedziałami ufności, ocena modelu, ograniczenia. W wersji polskiej stosujemy zapis APA, a w angielskiej – zapis często spotykany w czasopismach medycznych (zero przed kropką dziesiętną, przedziały z półpauzą). Formę dostosuj do instrukcji dla autorów wybranego czasopisma.
Gdy recenzent poprosi o zmiany w analizie, przydadzą się wzory odpowiedzi z poradnika odpowiedź recenzentom w sprawach statystycznych, a dane i kod do artykułu przygotujesz według poradnika pakiet replikacyjny – CONSORT 2025 wprowadził osobny punkt o tym, gdzie i jak można uzyskać dane i kod statystyczny (Hopewell i in., 2025).
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R – kolejne korzystają z obiektów z poprzednich. Walidacja bootstrapowa (przepis 3) trwa kilka sekund, a symulacja doboru krokowego (przepis 5) – około 40 sekund.
1. Dane i Tabela 1 ze standaryzowanymi różnicami
R
# Kohorta retrospektywna (dane symulowane): 700 pacjentów po planowej operacji jamy brzusznej.
# Wynik: powikłanie pooperacyjne w ciągu 30 dni (1 = tak). Funkcja posłuży też w przepisach 4 i 5.
generuj_kohorte <- function(N, b0 = -2.25, sila = 1) {
  wiek      <- round(pmin(90, pmax(25, rnorm(N, 63, 11))))
  mezczyzna <- rbinom(N, 1, 0.55)
  bmi       <- round(pmin(45, pmax(17, rnorm(N, 27.5, 4.5))), 1)
  cukrzyca  <- rbinom(N, 1, plogis(-1.6 + 0.03 * (wiek - 63) + 0.10 * (bmi - 27.5)))
  asa3      <- rbinom(N, 1, plogis(-1.0 + 0.05 * (wiek - 63) + 0.7 * cukrzyca))      # ASA III–IV
  palenie   <- rbinom(N, 1, plogis(-1.3 + 0.4 * mezczyzna - 0.02 * (wiek - 63)))
  otwarta   <- rbinom(N, 1, plogis(-0.5 + 0.03 * (wiek - 63) + 0.4 * asa3))          # 0 = laparoskopia
  czas      <- round(exp(rnorm(N, log(150) + 0.15 * otwarta, 0.30)))                  # minuty
  lp <- b0 + sila * (log(1.35) * (wiek - 63) / 10 + log(1.20) * mezczyzna + log(1.25) * (bmi - 27.5) / 5 +
                     log(1.60) * cukrzyca + log(1.90) * asa3 + log(1.45) * palenie + log(1.80) * otwarta +
                     log(1.25) * (czas - 165) / 60)
  powiklanie <- rbinom(N, 1, plogis(lp))
  albumina <- round(rnorm(N, 3.95 - 0.20 * asa3 - 0.01 * (wiek - 63), 0.45), 2)       # g/dl
  albumina[rbinom(N, 1, plogis(-1.6 - 0.04 * (wiek - 63) - 0.8 * asa3)) == 1] <- NA    # brak oznaczenia
  data.frame(powiklanie, wiek, mezczyzna, bmi, cukrzyca, asa3, palenie, otwarta, czas, albumina)
}
set.seed(37)
kohorta <- generuj_kohorte(700)
table(kohorta$powiklanie)

# Tabela 1: charakterystyka ogółem i według wystąpienia powikłania, SMD zamiast wartości p
smd <- function(x, g) {
  m <- tapply(x, g, mean, na.rm = TRUE)
  if (all(x %in% c(0, 1, NA))) s <- sqrt((m[1] * (1 - m[1]) + m[2] * (1 - m[2])) / 2)   # zmienna 0/1
  else s <- sqrt((tapply(x, g, var, na.rm = TRUE)[1] + tapply(x, g, var, na.rm = TRUE)[2]) / 2)
  unname((m[2] - m[1]) / s)
}
opis <- function(x, typ) {
  x <- x[!is.na(x)]
  switch(typ,
         srednia = sprintf("%.1f (%.1f)", mean(x), sd(x)),
         mediana = sprintf("%.0f [%.0f, %.0f]", median(x), quantile(x, 0.25), quantile(x, 0.75)),
         odsetek = sprintf("%d (%.1f%%)", sum(x), 100 * mean(x)),
         albumina = sprintf("%.2f (%.2f)", mean(x), sd(x)))
}
zmienne <- c(wiek = "srednia", mezczyzna = "odsetek", bmi = "srednia", cukrzyca = "odsetek", asa3 = "odsetek",
             palenie = "odsetek", otwarta = "odsetek", czas = "mediana", albumina = "albumina")
g <- kohorta$powiklanie
tabela1 <- t(sapply(names(zmienne), function(v) {
  x <- kohorta[[v]]
  c(ogolem = opis(x, zmienne[v]), bez_powiklania = opis(x[g == 0], zmienne[v]),
    z_powiklaniem = opis(x[g == 1], zmienne[v]), SMD = sprintf("%.2f", smd(x, g)),
    braki = sprintf("%d (%.1f%%)", sum(is.na(x)), 100 * mean(is.na(x))))
}))
print(noquote(tabela1))
# Kogo dotyczą braki albuminy? Odsetek braków według klasy ASA i wieku
round(c(oznaczono_albumine = sum(!is.na(kohorta$albumina)),
        braki_ASA_I_II = mean(is.na(kohorta$albumina[kohorta$asa3 == 0])),
        braki_ASA_III_IV = mean(is.na(kohorta$albumina[kohorta$asa3 == 1])),
        wiek_z_brakiem = mean(kohorta$wiek[is.na(kohorta$albumina)]),
        wiek_bez_braku = mean(kohorta$wiek[!is.na(kohorta$albumina)])), 3)
Wynik w R
  0   1
551 149
          ogolem         bez_powiklania z_powiklaniem  SMD   braki
wiek      63.0 (11.1)    61.6 (10.8)    68.1 (10.9)    0.60  0 (0.0%)
mezczyzna 399 (57.0%)    310 (56.3%)    89 (59.7%)     0.07  0 (0.0%)
bmi       27.6 (4.4)     27.5 (4.4)     27.9 (4.2)     0.09  0 (0.0%)
cukrzyca  133 (19.0%)    91 (16.5%)     42 (28.2%)     0.28  0 (0.0%)
asa3      219 (31.3%)    147 (26.7%)    72 (48.3%)     0.46  0 (0.0%)
palenie   172 (24.6%)    127 (23.0%)    45 (30.2%)     0.16  0 (0.0%)
otwarta   295 (42.1%)    204 (37.0%)    91 (61.1%)     0.50  0 (0.0%)
czas      159 [133, 207] 156 [133, 204] 171 [135, 215] 0.08  0 (0.0%)
albumina  3.89 (0.48)    3.90 (0.48)    3.84 (0.50)    -0.13 106 (15.1%)
oznaczono_albumine     braki_ASA_I_II   braki_ASA_III_IV     wiek_z_brakiem
           594.000              0.181              0.087             58.783
    wiek_bez_braku
            63.709
2. Liczebność (EPV i kryteria Riley i in.) oraz model regresji logistycznej
R
# Liczebność: zdarzenia na parametr (EPV) i trzy kryteria Riley i in. (2019) liczone ręcznie
E <- sum(kohorta$powiklanie); p <- 8                      # 8 parametrów określonych przed analizą
round(c(zdarzenia = E, parametry = p, EPV = E / p), 1)
phi  <- 0.20                                              # założony odsetek powikłań (z wcześniejszych danych)
R2cs <- 0.10                                              # założone R² Coxa–Snella modelu w nowych danych
maxR2 <- 1 - exp(2 * (phi * log(phi) + (1 - phi) * log(1 - phi)))
n_dla <- function(S) p / ((S - 1) * log(1 - R2cs / S))
S2 <- R2cs / (R2cs + 0.05 * maxR2)                        # kryterium (ii): różnica R² Nagelkerkego ≤ 0.05
round(c(max_R2cs = maxR2,
        kryterium_i = n_dla(0.90),                        # skurczenie (shrinkage) ≥ 0.90
        kryterium_ii = n_dla(S2),
        kryterium_iii = (1.96 / 0.05)^2 * phi * (1 - phi)), 3)   # odsetek zdarzeń z dokładnością ±0.05
E_min <- ceiling(n_dla(0.90) * phi)                       # potrzebna liczba zdarzeń
c(zdarzenia_potrzebne = E_min, na_parametr = E_min / p)
c(regula_EPV10_zdarzenia = 10 * p, regula_EPV10_pacjenci = 10 * p / phi)   # dla porównania: reguła „10 zdarzeń na parametr”

# Model określony przed analizą: 8 predyktorów, bez doboru krokowego
kohorta <- transform(kohorta, wiek10 = wiek / 10, bmi5 = bmi / 5, czas60 = czas / 60)
model <- glm(powiklanie ~ wiek10 + mezczyzna + bmi5 + cukrzyca + asa3 + palenie + otwarta + czas60,
             family = binomial, data = kohorta)
or <- cbind(OR = exp(coef(model)), suppressMessages(exp(confint(model))), p = coef(summary(model))[, 4])
round(or[-1, ], 3)                                        # OR z 95% CI (profilowa wiarygodność)

# Dopasowanie: test ilorazu wiarygodności i R² Coxa–Snella w tych samych danych
LR <- model$null.deviance - model$deviance; N <- nrow(kohorta)
round(c(chi2 = LR, df = p, p = pchisq(LR, p, lower.tail = FALSE), R2_CS = 1 - exp(-LR / N)), 4)

# Liniowość logitu dla zmiennych ciągłych: model ze splajnami (3 df) a model liniowy
library(splines)
model_spl <- update(model, . ~ . - wiek10 - bmi5 - czas60 + ns(wiek, 3) + ns(bmi, 3) + ns(czas, 3))
anova(model, model_spl, test = "LRT")
Wynik w R
zdarzenia parametry       EPV
    149.0       8.0      18.6
     max_R2cs   kryterium_i  kryterium_ii kryterium_iii
        0.632       679.215       235.956       245.862
zdarzenia_potrzebne         na_parametr
                136                  17
regula_EPV10_zdarzenia  regula_EPV10_pacjenci
                    80                    400
             OR 2.5 % 97.5 %     p
wiek10    1.578 1.301  1.924 0.000
mezczyzna 0.992 0.669  1.474 0.967
bmi5      1.119 0.894  1.404 0.326
cukrzyca  1.538 0.966  2.422 0.066
asa3      1.717 1.144  2.568 0.009
palenie   1.714 1.104  2.646 0.015
otwarta   2.106 1.417  3.143 0.000
czas60    1.020 0.827  1.252 0.848
   chi2      df       p   R2_CS
77.4228  8.0000  0.0000  0.1047
Analysis of Deviance Table

Model 1: powiklanie ~ wiek10 + mezczyzna + bmi5 + cukrzyca + asa3 + palenie +
    otwarta + czas60
Model 2: powiklanie ~ mezczyzna + cukrzyca + asa3 + palenie + otwarta +
    ns(wiek, 3) + ns(bmi, 3) + ns(czas, 3)
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1       691     647.38
2       685     637.98  6   9.4047   0.1521
3. AUC, próg Youdena i walidacja bootstrapowa
R
# Dyskryminacja: AUC z 95% CI (DeLong) i próg według indeksu Youdena
suppressPackageStartupMessages(library(pROC))
kohorta$ryzyko <- fitted(model)
roc_m <- roc(kohorta$powiklanie, kohorta$ryzyko, levels = c(0, 1), direction = "<", quiet = TRUE)
round(as.numeric(ci.auc(roc_m)), 3)                      # dolna granica, AUC, górna granica
youden <- coords(roc_m, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"))
round(youden, 3)

# Walidacja wewnętrzna bootstrapem (500 prób): cały model i wybór progu powtarzamy w każdej próbie,
# a optymizm to różnica między wynikiem w próbie bootstrapowej a wynikiem w danych oryginalnych
auc_wilcoxon <- function(y, r) { k <- rank(r); n1 <- sum(y); n0 <- length(y) - n1
  (sum(k[y == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0) }
czul <- function(y, r, prog) mean(r[y == 1] >= prog)
swoi <- function(y, r, prog) mean(r[y == 0] < prog)
set.seed(2025)
boot <- t(replicate(500, {
  db <- kohorta[sample(nrow(kohorta), replace = TRUE), ]
  mb <- update(model, data = db)
  r_b <- fitted(mb)                                       # model oceniany na „swojej” próbie
  r_o <- predict(mb, newdata = kohorta, type = "response") # ten sam model w danych oryginalnych
  prog <- coords(roc(db$powiklanie, r_b, levels = c(0, 1), direction = "<", quiet = TRUE),
                 "best", best.method = "youden", ret = "threshold")$threshold[1]
  y <- kohorta$powiklanie
  c(prog = prog,
    auc = auc_wilcoxon(db$powiklanie, r_b) - auc_wilcoxon(y, r_o),
    nachylenie = unname(coef(glm(y ~ qlogis(r_o), family = binomial))[2]),
    czulosc = czul(db$powiklanie, r_b, prog) - czul(y, r_o, prog),
    swoistosc = swoi(db$powiklanie, r_b, prog) - swoi(y, r_o, prog))
}))
round(colMeans(boot[, c("auc", "czulosc", "swoistosc")]), 3)     # średni optymizm
round(c(AUC_pozorne = auc(roc_m), AUC_skorygowane = auc(roc_m) - mean(boot[, "auc"]),
        nachylenie_kalibracji = mean(boot[, "nachylenie"]),
        czulosc_skorygowana = youden$sensitivity - mean(boot[, "czulosc"]),
        swoistosc_skorygowana = youden$specificity - mean(boot[, "swoistosc"])), 4)
round(quantile(boot[, "prog"], c(0.025, 0.25, 0.5, 0.75, 0.975)), 3)  # jak „wędruje” próg Youdena
Wynik w R
[1] 0.676 0.723 0.770
  threshold sensitivity specificity
1     0.295       0.503       0.844
      auc   czulosc swoistosc
    0.018     0.042     0.011
          AUC_pozorne       AUC_skorygowane nachylenie_kalibracji
               0.7233                0.7054                0.9101
  czulosc_skorygowana swoistosc_skorygowana
               0.4617                0.8327
 2.5%   25%   50%   75% 97.5%
0.160 0.205 0.233 0.269 0.331
4. Walidacja zewnętrzna: dyskryminacja i kalibracja
R
# Walidacja zewnętrzna (dane symulowane): 600 pacjentów z innego szpitala,
# gdzie ryzyko wyjściowe jest niższe, a związki predyktorów z powikłaniem – słabsze
set.seed(4)
zewn <- generuj_kohorte(600, b0 = -2.60, sila = 0.85)
zewn <- transform(zewn, wiek10 = wiek / 10, bmi5 = bmi / 5, czas60 = czas / 60)
zewn$ryzyko <- predict(model, newdata = zewn, type = "response")    # model z kohorty rozwojowej, bez zmian
lp <- qlogis(zewn$ryzyko)
round(c(n = nrow(zewn), zdarzenia = sum(zewn$powiklanie),
        odsetek_obserwowany = mean(zewn$powiklanie), sredni_przewidywany = mean(zewn$ryzyko)), 3)
roc_z <- roc(zewn$powiklanie, zewn$ryzyko, levels = c(0, 1), direction = "<", quiet = TRUE)
round(as.numeric(ci.auc(roc_z)), 3)                        # dyskryminacja w nowym szpitalu
# Kalibracja: wyraz wolny przy nachyleniu ustalonym na 1 (offset) i nachylenie kalibracji
kal_a <- glm(powiklanie ~ offset(lp), family = binomial, data = zewn)
kal_b <- glm(powiklanie ~ lp, family = binomial, data = zewn)
round(rbind(wyraz_wolny = c(coef(kal_a), confint.default(kal_a)),
            nachylenie  = c(coef(kal_b)[2], confint.default(kal_b)[2, ])), 3)
# Odsetek obserwowany a przewidywany w pięciu grupach ryzyka (kwintyle)
zewn$grupa <- cut(zewn$ryzyko, quantile(zewn$ryzyko, 0:5 / 5), include.lowest = TRUE, labels = 1:5)
kwintyle <- aggregate(cbind(przewidywane = ryzyko, obserwowane = powiklanie) ~ grupa, data = zewn, FUN = mean)
kwintyle[, -1] <- round(kwintyle[, -1], 3)
kwintyle
Wynik w R
                  n           zdarzenia odsetek_obserwowany sredni_przewidywany
            600.000              67.000               0.112               0.207
[1] 0.607 0.676 0.746
            (Intercept)
wyraz_wolny      -0.798 -1.062 -0.535
nachylenie        0.779  0.458  1.100
  grupa przewidywane obserwowane
1     1        0.067       0.033
2     2        0.118       0.075
3     3        0.175       0.100
4     4        0.253       0.108
5     5        0.420       0.242
5. Symulacja: co dobór krokowy robi z ilorazem szans
R
# Dlaczego nie dobór krokowy? 500 kohort z tej samej populacji (prawdziwy OR dla palenia = 1.45),
# w każdej model pełny i eliminacja wsteczna (zostają zmienne z p < .05 w teście ilorazu wiarygodności)
wzor <- powiklanie ~ wiek10 + mezczyzna + bmi5 + cukrzyca + asa3 + palenie + otwarta + czas60
symulacja <- function(N, powtorzen = 500) {
  t(replicate(powtorzen, {
    d <- generuj_kohorte(N)
    d <- transform(d, wiek10 = wiek / 10, bmi5 = bmi / 5, czas60 = czas / 60)
    pelny <- glm(wzor, family = binomial, data = d)
    krok  <- step(pelny, direction = "backward", k = qchisq(0.95, 1), trace = 0)
    c(zdarzenia = sum(d$powiklanie), b_pelny = unname(coef(pelny)["palenie"]),
      zostalo = "palenie" %in% names(coef(krok)), b_krok = unname(coef(krok)["palenie"]))
  }))
}
set.seed(5)
wyniki <- lapply(c(N700 = 700, N250 = 250), symulacja)
round(t(sapply(wyniki, function(w) c(
  EPV_mediana          = median(w[, "zdarzenia"]) / 8,
  OR_model_pelny       = exp(mean(w[, "b_pelny"])),                          # średnia na skali logitu
  odsetek_zachowanych  = mean(w[, "zostalo"]),
  OR_gdy_zachowano     = exp(mean(w[w[, "zostalo"] == 1, "b_krok"]))))), 3)
Wynik w R
     EPV_mediana OR_model_pelny odsetek_zachowanych OR_gdy_zachowano
N700      17.875          1.467               0.412            1.810
N250       6.375          1.475               0.184            2.302
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele: pakiety stats i splines z podstawowej instalacji R); krzywą ROC i AUC policzono w pakiecie pROC, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy i lista kontrolna przed wysłaniem
- Wartości p w Tabeli 1 badania randomizowanego. CONSORT 2025 ich nie zaleca; w badaniu obserwacyjnym zamiast testów podaj SMD.
- Dobór zmiennych na podstawie analiz jednoczynnikowych albo metodą krokową. Zawyża efekty zmiennych, które zostały w modelu, i ich istotność – zmienne ustal przed analizą.
- Liczebność uzasadniona regułą EPV ≥ 10. Przy modelu predykcyjnym policz minimalną liczebność według kryteriów Riley i in. i podaj założenia.
- Braki danych przemilczane albo usunięte bez słowa. Podaj, ilu i jakich pacjentów dotyczyły, oraz metodę i jej założenia.
- Każdy istotny OR nazwany „niezależnym czynnikiem ryzyka”. To błąd Tabeli 2; efekty przyczynowe wymagają modelu zbudowanego dla konkretnej ekspozycji.
- Iloraz szans opisany jak ryzyko względne przy częstym wyniku – wtedy OR wyolbrzymia efekt.
- Dzielenie zmiennych ciągłych na kategorie (np. wiek powyżej i poniżej mediany) bez uzasadnienia – traci się informację; zmienne ciągłe modeluj w pierwotnej postaci, a dychotomizację stosuj tylko wtedy, gdy wymaga jej pytanie kliniczne.
- „Optymalny” punkt odcięcia bez walidacji. Zaznacz, że próg wyznaczono eksploracyjnie, i podaj czułość oraz swoistość po korekcie optymizmu albo w niezależnych danych.
- Samo AUC bez kalibracji i bez walidacji – albo test Hosmera–Lemeshowa zamiast wykresu kalibracji.
- Nieaktualne wytyczne – CONSORT 2010 zamiast CONSORT 2025 albo TRIPOD 2015 zamiast TRIPOD+AI.
Przed wysłaniem przejdź jeszcze listę najczęstszych uwag z poradnika najczęstsze zarzuty recenzentów do statystyki. Jeśli artykuł jest częścią rozprawy doktorskiej, plan całej części empirycznej opisujemy w poradniku analiza statystyczna w doktoracie.
Najczęstsze pytania
Którą listę kontrolną wybrać: STROBE, CONSORT, STARD czy TRIPOD?
Zależy od schematu badania: CONSORT 2025 (30 punktów) dla badań randomizowanych, STROBE (22 punkty) dla obserwacyjnych – kohortowych, kliniczno-kontrolnych i przekrojowych, STARD 2015 (30 punktów) dla badań dokładności diagnostycznej, a TRIPOD+AI (27 punktów) dla modeli predykcyjnych. Gdy badanie ma dwa cele, np. czynniki ryzyka i model predykcyjny, korzystaj z obu właściwych list. Aktualne wersje sprawdzisz w bibliotece EQUATOR Network.
Czy w Tabeli 1 należy podawać wartości p?
W badaniu randomizowanym nie: wyjaśnienia do CONSORT 2025 mówią, że testów istotności różnic wyjściowych nie zaleca się i nie należy ich raportować, bo przy prawidłowej randomizacji wszystkie różnice są przypadkowe (Hopewell i in., 2025). W badaniu obserwacyjnym dokument objaśniający STROBE zaleca unikanie testów w tabelach opisowych (Vandenbroucke i in., 2007); wielkość różnic lepiej opisze standaryzowana różnica (SMD).
Co powinna zawierać sekcja Statistical analysis w artykule medycznym?
Definicje zmiennych, statystyki opisowe, opis modeli i sposobu doboru zmiennych (ustalonych z góry, a nie krokowo), uzasadnienie liczebności, postępowanie z brakami danych, analizy wrażliwości i podgrup z informacją, które zaplanowano wcześniej, miary oceny modelu oraz oprogramowanie z wersjami pakietów. Opis ma pozwolić odtworzyć wyniki osobie, która ma dostęp do danych.
Czy można stosować regresję krokową w artykule medycznym?
Lepiej nie. Dobór zmiennych na podstawie danych może naruszać stabilność modelu, nieobciążoność współczynników i trafność wartości p (Heinze i in., 2018). W naszej symulacji palenie (prawdziwy OR = 1.45) zostawało w modelu krokowym tylko w 41.2% kohort po 700 osób, a gdy zostawało, jego średni OR wynosił 1.81. Zmienne wybieraj przed analizą, na podstawie wiedzy klinicznej.
Jak opisać punkt odcięcia z krzywej ROC w publikacji?
Napisz, czy próg ustalono przed badaniem, czy wyznaczono na danych (np. indeksem Youdena) – tego wymaga STARD 2015. Próg wybrany na tych samych danych zawyża czułość i swoistość (Leeflang i in., 2008), więc podaj wartości po korekcie optymizmu bootstrapem albo z niezależnej próby i nazwij próg eksploracyjnym.
Co to jest kalibracja modelu predykcyjnego?
Kalibracja to zgodność przewidywanego ryzyka z obserwowaną częstością zdarzeń: wśród pacjentów z przewidywanym ryzykiem 20% zdarzenie powinno wystąpić u około co piątego. Ocenia się ją na wykresie kalibracji oraz wyrazem wolnym (ideał 0) i nachyleniem kalibracji (ideał 1). Model może mieć przyzwoite AUC, a jednocześnie systematycznie przeszacowywać ryzyko, dlatego raportuj obie cechy (Steyerberg i in., 2010).
Powiązane hasła
Przeczytaj też
Statystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikRegresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Przygotowujesz artykuł medyczny albo odpowiadasz na recenzję?
Sprawdzimy analizę pod kątem wytycznych CONSORT, STROBE, STARD lub TRIPOD+AI, wykonamy obliczenia i wyjaśnimy wyniki tak, by każdą decyzję móc uzasadnić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Using the standardized difference to compare the prevalence of a binary variable between two groups in observational research. Communications in Statistics – Simulation and Computation, 38(6), 1228–1234. https://doi.org/10.1080/03610910902859574
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., Lijmer, J. G., Moher, D., Rennie, D., de Vet, H. C. W., Kressel, H. Y., Rifai, N., Golub, R. M., Altman, D. G., Hooft, L., Korevaar, D. A., & Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, Article h5527. https://doi.org/10.1136/bmj.h5527 ● Otwarty dostęp
- Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., Ghassemi, M., Liu, X., Reitsma, J. B., van Smeden, M., Boulesteix, A.-L., Camaradou, J. C., Celi, L. A., Denaxas, S., Denniston, A. K., Glocker, B., Golub, R. M., Harvey, H., Heinze, G., . . . Logullo, P. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ, 385, Article e078378. https://doi.org/10.1136/bmj-2023-078378 ● Otwarty dostęp
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- Riley, R. D., Snell, K. I. E., Ensor, J., Burke, D. L., Harrell, F. E., Jr., Moons, K. G. M., & Collins, G. S. (2019). Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes. Statistics in Medicine, 38(7), 1276–1296. https://doi.org/10.1002/sim.7992 ● Otwarty dostęp
- Sterne, J. A. C., White, I. R., Carlin, J. B., Spratt, M., Royston, P., Kenward, M. G., Wood, A. M., & Carpenter, J. R. (2009). Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls. BMJ, 338, Article b2393. https://doi.org/10.1136/bmj.b2393 ● Otwarty dostęp
- Steyerberg, E. W., Harrell, F. E., Borsboom, G. J. J. M., Eijkemans, M. J. C., Vergouwe, Y., & Habbema, J. D. F. (2001). Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis. Journal of Clinical Epidemiology, 54(8), 774–781. https://doi.org/10.1016/s0895-4356(01)00341-9
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2009using, author={Austin, Peter C.}, title={{Using the standardized difference to compare the prevalence of a binary variable between two groups in observational research}}, journal={Communications in Statistics – Simulation and Computation}, year={2009}, volume={38}, number={6}, pages={1228--1234}, doi={10.1080/03610910902859574}}@article{bossuyt2015stard, author={Bossuyt, Patrick M. and Reitsma, Johannes B. and Bruns, David E. and Gatsonis, Constantine A. and Glasziou, Paul P. and Irwig, Les and Lijmer, Jeroen G. and Moher, David and Rennie, Drummond and de Vet, Henrica C. W. and Kressel, Herbert Y. and Rifai, Nader and Golub, Robert M. and Altman, Douglas G. and Hooft, Lotty and Korevaar, Daniël A. and Cohen, Jérémie F.}, title={{STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies}}, journal={BMJ}, year={2015}, volume={351}, eid={h5527}, doi={10.1136/bmj.h5527}}@article{collins2024tripod, author={Collins, Gary S. and Moons, Karel G. M. and Dhiman, Paula and Riley, Richard D. and Beam, Andrew L. and Van Calster, Ben and Ghassemi, Marzyeh and Liu, Xiaoxuan and Reitsma, Johannes B. and van Smeden, Maarten and Boulesteix, Anne-Laure and Camaradou, Jennifer Catherine and Celi, Leo Anthony and Denaxas, Spiros and Denniston, Alastair K. and Glocker, Ben and Golub, Robert M. and Harvey, Hugh and Heinze, Georg and Hoffman, Michael M. and Kengne, André Pascal and Lam, Emily and Lee, Naomi and Loder, Elizabeth W. and Maier-Hein, Lena and Mateen, Bilal A. and McCradden, Melissa D. and Oakden-Rayner, Lauren and Ordish, Johan and Parnell, Richard and Rose, Sherri and Singh, Karandeep and Wynants, Laure and Logullo, Patricia}, title={{TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods}}, journal={BMJ}, year={2024}, volume={385}, eid={e078378}, doi={10.1136/bmj-2023-078378}}@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{riley2019minimum, author={Riley, Richard D. and Snell, Kym I. E. and Ensor, Joie and Burke, Danielle L. and Harrell, Frank E., Jr. and Moons, Karel G. M. and Collins, Gary S.}, title={{Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={7}, pages={1276--1296}, doi={10.1002/sim.7992}}@article{sterne2009multiple, author={Sterne, Jonathan A. C. and White, Ian R. and Carlin, John B. and Spratt, Michael and Royston, Patrick and Kenward, Michael G. and Wood, Angela M. and Carpenter, James R.}, title={{Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls}}, journal={BMJ}, year={2009}, volume={338}, eid={b2393}, doi={10.1136/bmj.b2393}}@article{steyerberg2001internal, author={Steyerberg, Ewout W. and Harrell, Frank E. and Borsboom, Gerard J. J. M. and Eijkemans, Marinus J. C. and Vergouwe, Yvonne and Habbema, J. Dik F.}, title={{Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={8}, pages={774--781}, doi={10.1016/s0895-4356(01)00341-9}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{westreich2013table, author={Westreich, Daniel and Greenland, Sander}, title={{The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients}}, journal={American Journal of Epidemiology}, year={2013}, volume={177}, number={4}, pages={292--298}, doi={10.1093/aje/kws412}}