Co to jest krzywa Kaplana–Meiera?
Krzywa Kaplana–Meiera (ang. Kaplan–Meier curve) to schodkowy wykres oszacowanej funkcji przeżycia S(t), czyli odsetka osób bez zdarzenia do czasu t. Kaplan i Meier (1958) zaproponowali ten nieparametryczny estymator iloczynowy dla danych niekompletnych, przy założeniu, że czas do zdarzenia nie zależy od momentu utraty z obserwacji. W psychologii i naukach o zdrowiu opisuje się nią np. czas do nawrotu (zob. analiza przeżycia).
Jak się ją liczy?
di to liczba zdarzeń w chwili ti, a ni – liczba osób w ryzyku tuż przed nią, czyli bez zdarzenia i nadal obserwowanych. Obserwacja ucięta (cenzurowana), np. osoba wycofana z badania, nie obniża krzywej, tylko zmniejsza ni przy kolejnych zdarzeniach. Mediana czasu przeżycia to pierwszy moment, w którym Ŝ(t) spada do .50 lub niżej (zob. mediana).
Przykład
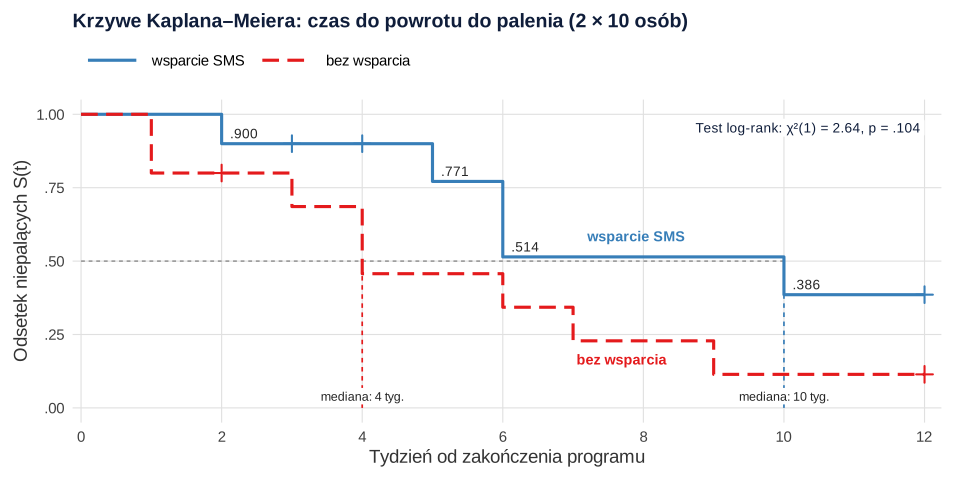
Dziesięć osób ze wsparciem SMS po programie rzucania palenia obserwowano przez 12 tygodni (proste dane przykładowe). Do palenia wróciły w tygodniach 2, 5, 6, 6 i 10; obserwacje ucięto w tygodniach 3, 4 i 12 (trzy osoby).
| Tydzień ti | W ryzyku ni | Zdarzenia di | 1 − di/ni | Ŝ(t) |
|---|---|---|---|---|
| 2 | 10 | 1 | .900 | .900 |
| 5 | 7 | 1 | .857 | .771 |
| 6 | 6 | 2 | .667 | .514 |
| 10 | 4 | 1 | .750 | .386 |
Ucięcia w 3. i 4. tygodniu nie obniżyły krzywej, ale w 5. tygodniu w ryzyku było już 7 osób: Ŝ = .900 × 6/7 = .771. Mediana wyniosła 10 tygodni, bo w 6. tygodniu Ŝ(t) = .514 było jeszcze powyżej .50. W grupie bez wsparcia mediana wyniosła 4 tygodnie (rysunek 1).
Test log-rank
Test log-rank sprawdza hipotezę zerową, że krzywe w populacji są takie same. W każdej chwili zdarzenia porównuje liczbę zdarzeń obserwowanych z oczekiwaną przy wspólnym ryzyku i sumuje różnice w statystykę χ² (Bland i Altman, 2004). W grupie SMS było 5 powrotów do palenia przy 7.74 oczekiwanych, χ²(1) = 2.64, p = .104. Przy 10 osobach w grupie test ma małą moc, a wielkość różnicy opisuje dopiero iloraz hazardów. Przykład kliniczny omawia poradnik statystyka dla lekarza.
Jak zapisać w pracy
Na co uważać
- Usuwanie obserwacji uciętych albo traktowanie ich jak zdarzeń. Czasy do zdarzenia są ucięte i zwykle silnie skośne, więc wymagają analizy przeżycia, a nie testu t (Clark i in., 2003).
- Średnia zamiast mediany. Jeśli krzywa nie spadła do .50, napisz, że mediany nie osiągnięto.
Krzywa Kaplana–Meiera w R
Kod wpisuje dane z przykładu, w pakiecie survival liczy estymator Kaplana–Meiera i mediany oraz wykonuje test log-rank. Liczby w tekście i na rysunku pochodzą z tego kodu; rysunek przygotowano w ggplot2.
Estymator Kaplana–Meiera, mediany i test log-rank
R
library(survival)
czas    <- c(2, 3, 4, 5, 6, 6, 10, 12, 12, 12,   1, 1, 2, 3, 4, 4, 6, 7, 9, 12)   # tygodnie obserwacji
palenie <- c(1, 0, 0, 1, 1, 1, 1, 0, 0, 0,      1, 1, 0, 1, 1, 1, 1, 1, 1, 0)   # 1 = powrót do palenia, 0 = ucięta
grupa <- factor(rep(c("wsparcie SMS", "bez wsparcia"), each = 10), levels = c("wsparcie SMS", "bez wsparcia"))
km <- survfit(Surv(czas, palenie) ~ grupa)
summary(km)                                      # n.risk, n.event i S(t) w tygodniach ze zdarzeniem
km                                               # mediany czasu do powrotu do palenia
lr <- survdiff(Surv(czas, palenie) ~ grupa)      # test log-rank
round(cbind(N = lr$n, O = lr$obs, E = lr$exp), 2)   # zdarzenia obserwowane i oczekiwane przy H0
round(c(chi2 = lr$chisq, p = pchisq(lr$chisq, df = 1, lower.tail = FALSE)), 3)
Wynik w R
Call: survfit(formula = Surv(czas, palenie) ~ grupa)

                grupa=wsparcie SMS
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
    2     10       1    0.900  0.0949        0.732         1.00
    5      7       1    0.771  0.1442        0.535         1.00
    6      6       2    0.514  0.1769        0.262         1.00
   10      4       1    0.386  0.1732        0.160         0.93

                grupa=bez wsparcia
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
    1     10       2    0.800   0.126       0.5868        1.000
    3      7       1    0.686   0.151       0.4447        1.000
    4      6       2    0.457   0.166       0.2242        0.932
    6      4       1    0.343   0.159       0.1380        0.852
    7      3       1    0.229   0.141       0.0681        0.768
    9      2       1    0.114   0.107       0.0181        0.720

Call: survfit(formula = Surv(czas, palenie) ~ grupa)

                    n events median 0.95LCL 0.95UCL
grupa=wsparcie SMS 10      5     10       6      NA
grupa=bez wsparcia 10      8      4       3      NA
                    N O    E
grupa=wsparcie SMS 10 5 7.74
grupa=bez wsparcia 10 8 5.26
 chi2     p
2.637 0.104
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jak odczytać medianę czasu z krzywej Kaplana–Meiera?
Znajdź pierwszy moment, w którym krzywa spada do .50 lub niżej. Jeśli do końca obserwacji nie spadła do .50, mediany nie osiągnięto – napisz to zamiast podawać średni czas.
Co oznaczają krzyżyki lub pionowe kreski na krzywej Kaplana–Meiera?
To obserwacje ucięte: osoby, u których zdarzenie nie wystąpiło do końca obserwacji albo które wycofały się z badania. W tym miejscu krzywa nie spada, ale maleje liczba osób w ryzyku.
Kiedy test log-rank może przeoczyć różnicę między krzywymi przeżycia?
Gdy krzywe się przecinają albo próba jest mała. Test najłatwiej wykrywa różnicę, gdy ryzyko jest stale wyższe w jednej grupie (Bland i Altman, 2004), dlatego zawsze oglądaj wykres.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2004). The logrank test. BMJ, 328(7447), 1073. https://doi.org/10.1136/bmj.328.7447.1073 ● Otwarty dostęp
- Clark, T. G., Bradburn, M. J., Love, S. B., & Altman, D. G. (2003). Survival analysis part I: Basic concepts and first analyses. British Journal of Cancer, 89(2), 232–238. https://doi.org/10.1038/sj.bjc.6601118 ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
Cytowania BibTeX
@article{bland2004logrank, author={Bland, J. Martin and Altman, Douglas G.}, title={{The logrank test}}, journal={BMJ}, year={2004}, volume={328}, number={7447}, pages={1073}, doi={10.1136/bmj.328.7447.1073}}@article{clark2003survival, author={Clark, T. G. and Bradburn, M. J. and Love, S. B. and Altman, D. G.}, title={{Survival analysis part I: Basic concepts and first analyses}}, journal={British Journal of Cancer}, year={2003}, volume={89}, number={2}, pages={232--238}, doi={10.1038/sj.bjc.6601118}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}