Przykład: aplikacja do nauki języków i 2400 abonentów
Fikcyjna aplikacja do nauki języków sprzedaje dwa abonamenty: miesięczny i roczny. Dział marketingu pyta: jak długo abonenci zostają, kiedy odchodzą i co skraca ten czas? Odejście klienta, czyli rezygnację z abonamentu, nazywa się po angielsku churn.
Mamy 2400 abonamentów kupionych od stycznia 2025 do czerwca 2026. Dla każdego znamy plan, kanał pozyskania (sklep z aplikacjami, reklama w mediach społecznościowych albo kod promocyjny: −50% przez trzy miesiące, tylko w planie miesięcznym), liczbę dni z lekcją w pierwszym tygodniu (0–7) i to, czy abonament odnowiono. Dla prostoty każdy abonament zaczyna się 1. dnia miesiąca, a dane pobrano 1 lipca 2026.
Wynikiem jest czas do zdarzenia, a u większości klientów zdarzenia jeszcze nie było. To zadanie dla analizy przeżycia. Procedurę ogólną opisuje wpis Kaplan–Meier i model Coxa krok po kroku, a okna SPSS – Kaplan–Meier i regresja Coxa w SPSS.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Miesięczne ryzyko odejścia ustawiliśmy ręcznie: w planie miesięcznym 11.5% po pierwszym miesiącu, potem coraz mniej (do ok. 3.5%); w rocznym 4% w pierwszym miesiącu (zwrot), zero do 11. miesiąca i 30% przy pierwszym odnowieniu. Reklama społecznościowa mnoży ryzyko przez 1.35, każdy dzień z lekcją w pierwszym tygodniu – przez 0.85, a kod promocyjny – przez 0.8 w miesiącach 1–3, przez 4 w 4. miesiącu (pierwsza pełna cena) i przez 1.2 później. Parametry dobraliśmy tak, by skoki odejść były wyraźne. Ziarno 607 ustalono raz i nie zmieniano go. Dane pobierzesz jako churn-abonenci-aplikacji.csv.
Rysunek 1: oś czasu i cenzurowanie
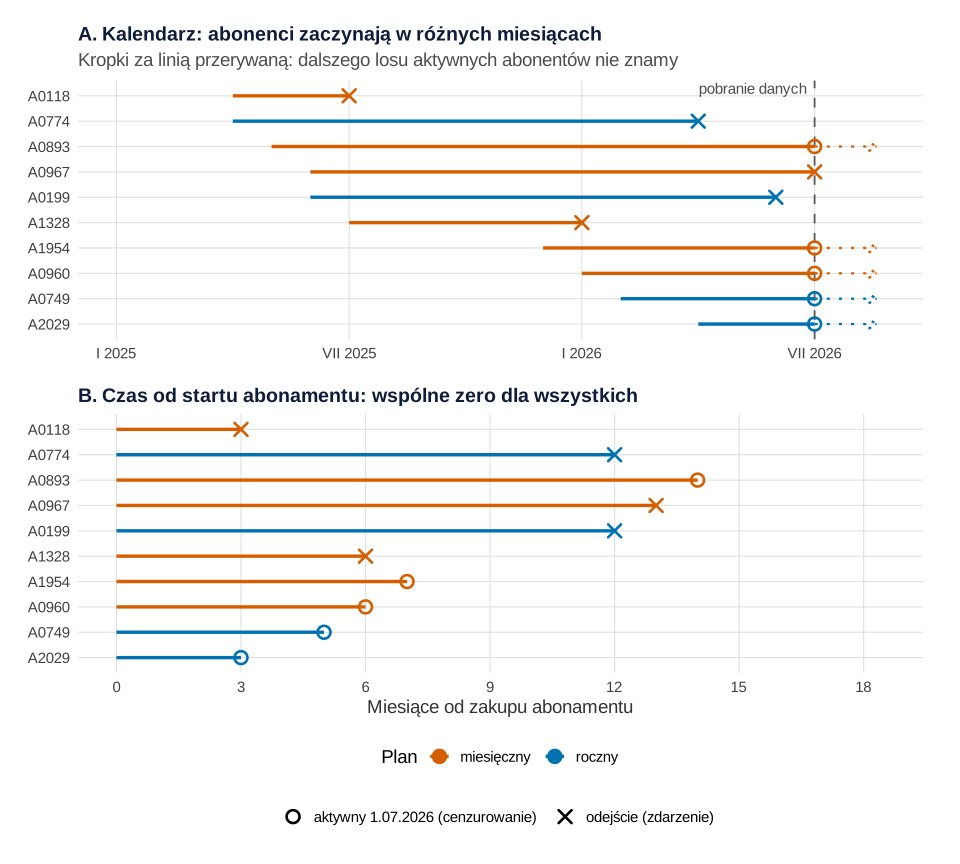
set.seed(607)).Co widać. W panelu A abonenci zaczynają w różnych miesiącach. Pięciu odeszło (krzyżyk), a pięciu 1 lipca 2026 wciąż płaci (kółko). O nich wiemy tylko tyle, że byli z nami co najmniej 3, 5, 6, 7 albo 14 miesięcy. To obserwacje cenzurowane. Panel B przesuwa wszystkich do wspólnego zera: liczy się czas od zakupu, a nie data. W całej bazie odeszło 877 z 2400 abonentów, a 1523 jest cenzurowanych.
Jak może zmylić. Naiwny odsetek odejść wynosi 44.6% w planie miesięcznym i 16.5% w rocznym, ale w mianowniku są też klienci sprzed miesiąca, którzy nie zdążyli odejść. Średni czas wśród tych, którzy odeszli (4.3 i 9.2 miesiąca), jest zaniżony, bo długo płacący klienci są w większości wciąż aktywni. Estymator Kaplana i Meiera (1958) wykorzystuje obie informacje, ale zakłada, że cenzurowanie nie wiąże się z ryzykiem odejścia. Tu cenzurowanie wynika tylko z daty pobrania danych.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: krzywe Kaplana–Meiera według planu
Krzywa Kaplana–Meiera pokazuje, jaki odsetek abonentów wciąż płaci po t miesiącach. Mnoży odsetki pozostających w kolejnych miesiącach; klient cenzurowany nie obniża krzywej, tylko wypada z mianownika.
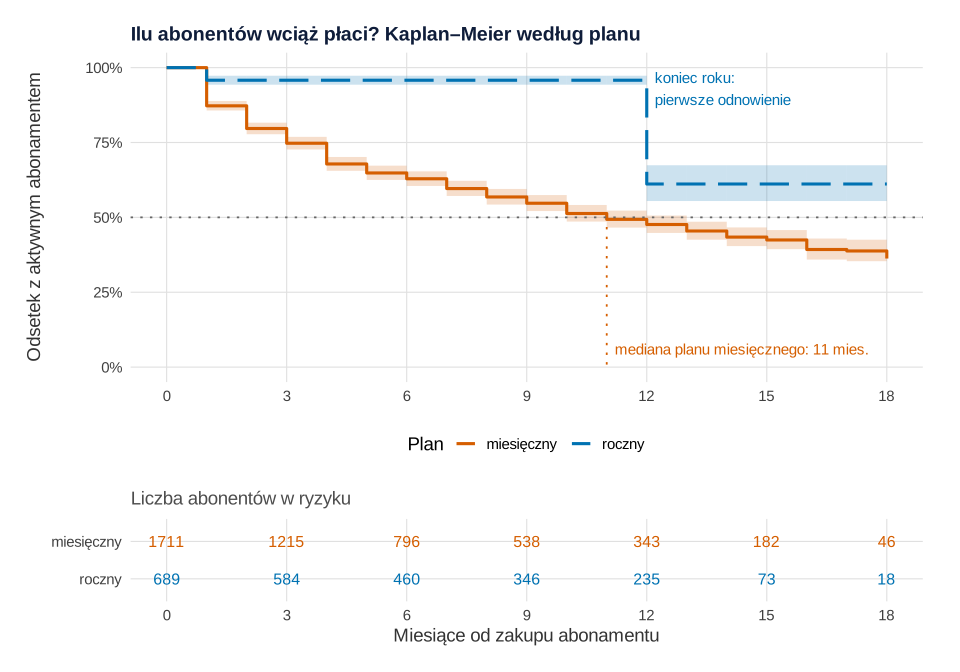
set.seed(607)).Co widać. W planie miesięcznym po trzech miesiącach płaci 74.8% abonentów, po 12 – 47.6%, 95% CI [44.8, 50.6]. Mediana czasu to 11 miesięcy, 95% CI [10, 13]. W planie rocznym krzywa jest płaska do 11. miesiąca (95.8%), a przy pierwszym odnowieniu spada do 61.1%, 95% CI [55.5, 67.4]. Jego mediany nie da się wyznaczyć, bo krzywa nie zeszła do 50%. Do 12. miesiąca odeszło więc 52.4% abonentów miesięcznych i 38.9% rocznych – dużo więcej niż w naiwnym rachunku. Test log-rank: χ²(1) = 177.4, p < .001.
Pole pod krzywą do 18. miesiąca to RMST: przeciętny abonent miesięczny ma aktywny abonament przez 10.7, a roczny przez 15.2 z pierwszych 18 miesięcy. Ta liczba w miesiącach przyda się do wartości klienta (CLV).
Jak może zmylić. Plan roczny „wygrywa” głównie dlatego, że przed końcem roku nie da się z niego odejść. To umowa, a nie lojalność. Prawdziwy test przychodzi w 12. miesiącu. Koniec krzywych opiera się na nielicznych osobach (46 i 18 w 18. miesiącu), stąd szerokie pasma. Test log-rank mówi tylko, że krzywe się różnią, a nie jak i kiedy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: hazard – kiedy abonenci odchodzą?
Krzywa mówi, ilu zostało. Hazard mówi, kiedy odchodzą: jaka część abonentów aktywnych na początku miesiąca k nie odnowiła abonamentu po tym miesiącu. Przedziały to 95% CI Wilsona, jak dla każdej proporcji.
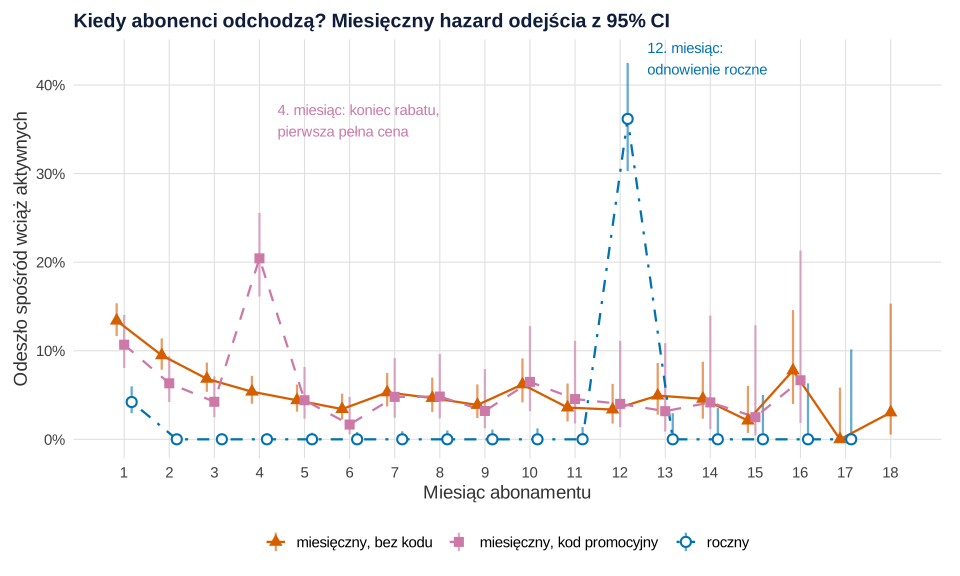
set.seed(607)).Co widać. Bez kodu najwięcej abonentów odchodzi na początku: 13.4% po pierwszym miesiącu, 6.8% po trzecim, około 3–5% w kolejnych miesiącach. Z kodem promocyjnym hazard jest niski, dopóki trwa rabat (4.2% w 3. miesiącu), a w 4. miesiącu, przy pierwszej pełnej cenie, skacze do 20.4%, 95% CI [16.1, 25.5]. W planie rocznym po zwrotach w pierwszym miesiącu (4.2%) nie ma odejść aż do odnowienia, gdy odchodzi 36.2%, 95% CI [30.3, 42.5].
Jak może zmylić. Malejący hazard grupy nie znaczy, że każdy klient z czasem się przywiązuje. Najpierw odchodzą najmniej zainteresowani, więc zostają ci, którzy i tak by zostali. W bazach siedmiu usług abonamentowych Schweidel i in. (2008) pokazali, że prognozy retencji poprawiało uwzględnienie efektów promocji (zawsze), a w pięciu usługach także różnic między abonentami, zależności od czasu trwania i efektów kalendarza. Zmiany w czasie mogą też wynikać z kalendarza, np. ze styczniowych postanowień. Porównanie miesięcy startu opisuje analiza kohortowa retencji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: model Coxa i sprawdzenie proporcjonalności
Model Coxa ocenia kilka zmiennych naraz (Cox, 1972). Każda dostaje iloraz hazardów (HR): ile razy szybciej (HR > 1) albo wolniej (HR < 1) odchodzą klienci z daną cechą przy tych samych pozostałych zmiennych. Model zakłada, że ten iloraz jest stały w czasie (proporcjonalne hazardy).
Model „jak z podręcznika” (A) z planem, kanałem i aktywnością daje: plan roczny HR = 0.32, 95% CI [0.26, 0.39]; reklama społecznościowa HR = 1.35, 95% CI [1.16, 1.57]; kod promocyjny HR = 1.12, 95% CI [0.93, 1.35], p = .217; każdy dodatkowy dzień z lekcją HR = 0.86, 95% CI [0.82, 0.91]. Wniosek „roczny chroni, kod nie ma znaczenia” przeczy jednak rysunkowi 3.
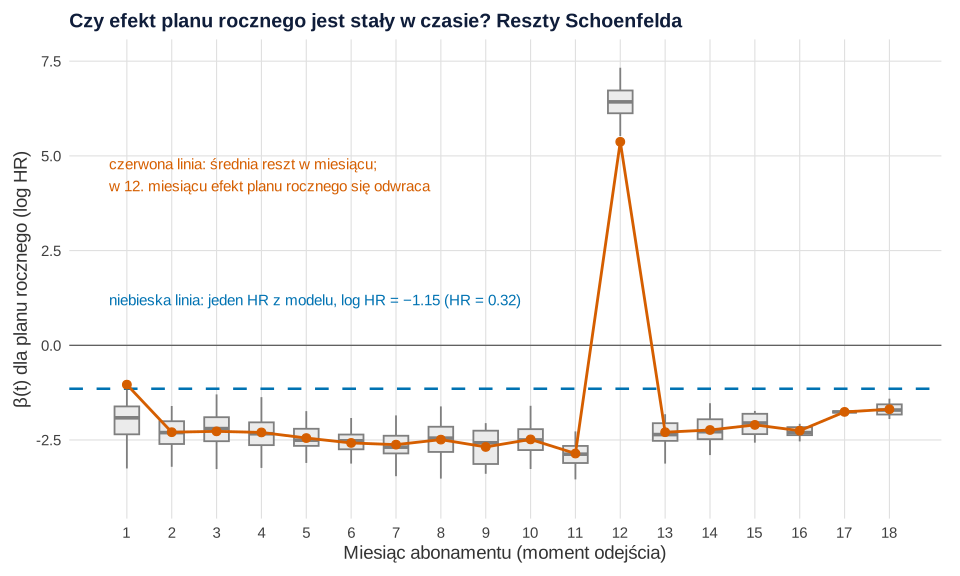
set.seed(607)).Co widać. Reszty Schoenfelda liczy się w chwilach odejść. Skalowane i dodane do współczynnika przybliżają efekt zmienny w czasie, β(t) (Grambsch i Therneau, 1994). Dla planu rocznego średnia β(t) leży między −2.86 a −2.27 w miesiącach 2–11, a w 12. miesiącu skacze do 5.4: wtedy roczni odchodzą szybciej niż miesięczni. Jeden HR = 0.32 to średnia z tych okresów. Hernán (2010) przypomina, że taki HR zależy od długości obserwacji. Test proporcjonalności (cox.zph()) dla planu: χ²(1) = 45.17, p < .001.
Jak może zmylić. Dla kanału test nie wykrył problemu (χ²(2) = 0.37, p = .830), choć rysunek 3 pokazuje skok w 4. miesiącu. Jednomiesięczny skok ginie w teście całego okresu. Nieistotny test nie dowodzi proporcjonalności – zawsze obejrzyj hazard w czasie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: lepszy model – warstwy planu i okresy
W modelu B robimy dwie zmiany. Plan jako warstwa (strata(plan)): każdy plan ma własny hazard bazowy, więc nie zakładamy stałego HR planu. Plany porównujemy krzywymi z rysunku 2 i RMST. Czas podzielony na okresy (miesiące 1–3, 4 i dalsze): kod promocyjny dostaje osobny HR w każdym okresie. To najprostsza zmienna zależna od czasu.
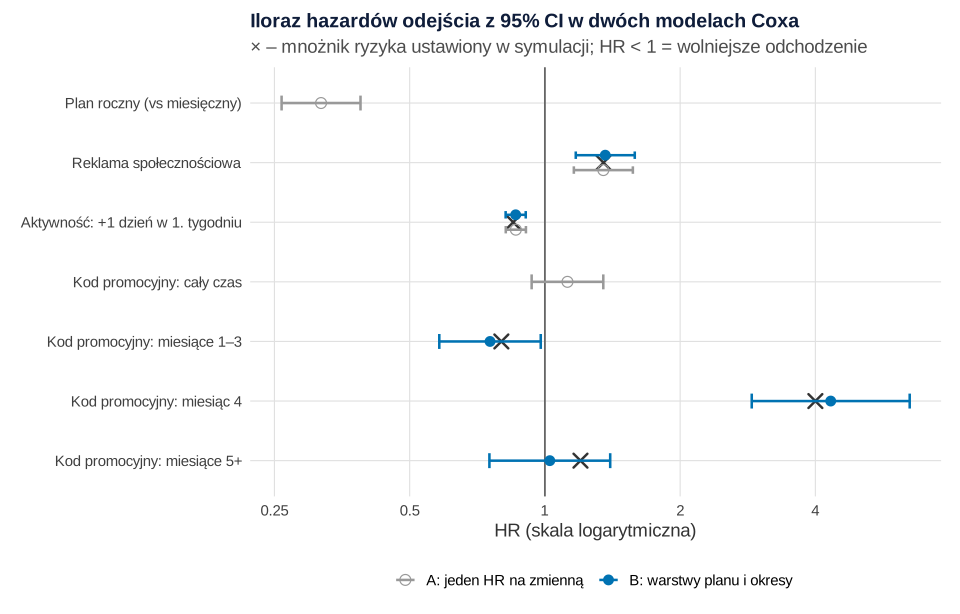
set.seed(607)).Co widać. Jeden HR kodu promocyjnego (1.12) rozpada się na trzy: 0.75, 95% CI [0.58, 0.98], w czasie rabatu; 4.33, 95% CI [2.89, 6.49], w pierwszym miesiącu pełnej ceny; 1.03, 95% CI [0.75, 1.40], później. Reklama społecznościowa (HR = 1.36, 95% CI [1.17, 1.59]) i aktywność (HR = 0.86 na dzień) prawie się nie zmieniły. Oszacowania leżą blisko ustawionych mnożników (krzyżyki), które dotyczą miesięcznego prawdopodobieństwa, więc tylko przybliżają HR. Model oparto na 877 odejściach.
Jak może zmylić. HR = 1.36 to szybsze tempo odejść, a nie o 36 punktów procentowych więcej odejść. To też nie efekt reklamy: kanały przyciągają różnych ludzi. Datta i in. (2015) pokazali, że klienci pozyskani darmowym okresem próbnym mieli o 59% niższą wartość w czasie, ale silniej reagowali na komunikację marketingową. Podobnie aktywność w pierwszym tygodniu jest sygnałem, a nie gotową dźwignią. Bolton (1998) w modelu proporcjonalnych hazardów dla klientów telefonii komórkowej wskazuje na wagę pierwszych doświadczeń: niezadowalający początek zwykle oznacza krótką relację.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Kod promocyjny: najważniejszy moment to koniec rabatu. Przed 4. miesiącem przypomnij o cenie i zaproponuj plan roczny albo łagodniejsze przejście do pełnej ceny. Wybór adresatów opisuje modelowanie uplift.
- Plan roczny: kampania utrzymaniowa przed pierwszym odnowieniem, bo wtedy odchodzi 36.2% aktywnych.
- Pierwszy tydzień: zadbaj o pierwsze lekcje (powitanie, przypomnienia), ale skuteczność sprawdź w teście A/B, a nie w modelu Coxa.
- Kanały: przed zwiększeniem budżetu reklamy porównaj RMST klientów z każdego kanału.
- Pojedynczy klient: analiza przeżycia mówi „kiedy”, a pytanie „kto odejdzie” lepiej obsługuje model przewidywania odejść i kampania retencyjna.
Gdy masz tylko dotychczasowe wskaźniki retencji i chcesz je przenieść w przyszłość, Fader i Hardie (2007) proponują prosty model probabilistyczny odejść zamiast dopasowywania krzywych.
Jak opisać w pracy
Do Wyników dołącz tabelę z liczbami, które czytelnik zrozumie bez wykresu:
| Plan | n | Odejścia | Po 3 mies. (%) | Po 12 mies. (%) | Mediana (mies.) | RMST do 18 mies. |
|---|---|---|---|---|---|---|
| Miesięczny | 1711 | 763 | 74.8 | 47.6 | 11 [10, 13] | 10.7 |
| Roczny | 689 | 114 | 95.8 | 61.1 | nieosiągnięta | 15.2 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a przepis 4 – model A potrzebny w przepisie 5. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1: dane i wybór dziesięciu abonentów do osi czasu zaczynają się od własnego set.seed(607). Pozostałe przepisy nie losują, więc skopiowane z przepisem 1 dadzą te same liczby co na stronie. Ziarno 607 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę abonentów (2400), udziały planów (70% i 30%) i kanałów, prawdopodobieństwa aktywności w pierwszym tygodniu, miesięczne ryzyka odejścia w obu planach i mnożniki kanałów, aktywności i kodu promocyjnego (przepis 1); granice okresów 3 i 4 miesiące (przepis 5) oraz próg 30 osób w ryzyku na rysunku 3. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, naiwne odsetki i oś czasu: Rysunek 1
R
# Rysunek 1. Fikcyjna aplikacja do nauki języków: dane abonentów i oś czasu z cenzurowaniem
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii), kształty i prosty motyw
kol_plan <- c("miesięczny" = "#D55E00", "roczny" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 2400 abonamentów rozpoczętych od stycznia 2025 (miesiąc 1) do czerwca 2026 (miesiąc 18); dla prostoty
# każdy zaczyna się 1. dnia miesiąca, a dane pobrano 1 lipca 2026. Odejście w miesiącu k = abonament
# opłacony przez k miesięcy i nieodnowiony. Udziały planów i kanałów, aktywność oraz ryzyka miesięczne
# ustalono ręcznie, tak by efekt końca rabatu i rocznego odnowienia był wyraźny.
set.seed(607)                                     # ziarno ustalone raz, bez dobierania pod wynik
n <- 2400
plan <- sample(c("miesięczny", "roczny"), n, replace = TRUE, prob = c(0.7, 0.3))
kanal_m <- sample(c("sklep z aplikacjami", "reklama społecznościowa", "kod promocyjny"), n, TRUE, c(0.45, 0.30, 0.25))
kanal_r <- sample(c("sklep z aplikacjami", "reklama społecznościowa"), n, TRUE, c(0.6, 0.4))
kanal <- ifelse(plan == "miesięczny", kanal_m, kanal_r)   # kod promocyjny (−50% przez 3 miesiące) tylko w planie miesięcznym
aktywne_dni <- rbinom(n, 7, 0.50 + 0.08 * (plan == "roczny") - 0.10 * (kanal == "kod promocyjny") -
                        0.05 * (kanal == "reklama społecznościowa"))   # dni z lekcją w 1. tygodniu (0–7)
start <- sample(1:18, n, replace = TRUE)
obserwowane <- 19 - start                         # pełne miesiące do 1 lipca 2026 (od 1 do 18)

# Ryzyko odejścia w kolejnych miesiącach (prawdopodobieństwo nieodnowienia po miesiącu k)
mnoznik <- 1.35^(kanal == "reklama społecznościowa") * 0.85^(aktywne_dni - 3.5)
czas_odejscia <- rep(Inf, n)
for (k in 1:18) {
  h <- ifelse(plan == "miesięczny", 0.035 + 0.08 * exp(-(k - 1) / 1.5),       # miesięczny: maleje w czasie
              if (k == 1) 0.04 else if (k == 12) 0.30 else 0)                  # roczny: zwrot lub koniec roku
  promo <- if (k <= 3) 0.8 else if (k == 4) 4 else 1.2                         # 4. miesiąc = pierwsza pełna cena
  h <- pmin(h * mnoznik * ifelse(kanal == "kod promocyjny", promo, 1), 0.95)
  odchodzi <- is.infinite(czas_odejscia) & runif(n) < h
  czas_odejscia[odchodzi] <- k
}
abonenci <- data.frame(id = sprintf("A%04d", 1:n),
                       start = format(seq(as.Date("2025-01-01"), by = "month", length.out = 18)[start], "%Y-%m"),
                       plan, kanal, aktywne_dni,
                       miesiace = pmin(czas_odejscia, obserwowane),            # obserwowany czas
                       odszedl = as.integer(czas_odejscia <= obserwowane))     # 1 = odejście, 0 = cenzurowanie
write.csv(abonenci, "churn-abonenci-aplikacji.csv", row.names = FALSE)

# Ile odejść, ile obserwacji cenzurowanych (wciąż aktywnych) i jak mylą proste odsetki
addmargins(table(abonenci$plan, ifelse(abonenci$odszedl == 1, "odszedł", "aktywny (cenzurowany)")))
round(100 * tapply(abonenci$odszedl, abonenci$plan, mean), 1)                  # % odejść wśród wszystkich
with(subset(abonenci, odszedl == 1), round(tapply(miesiace, plan, mean), 1))   # średni czas tylko odchodzących

# Oś czasu 10 abonentów: 3 + 3 z planu miesięcznego i 2 + 2 z rocznego (odejście / cenzurowanie)
set.seed(607)
wybor <- unlist(lapply(list(c("miesięczny", 1, 3), c("miesięczny", 0, 3), c("roczny", 1, 2), c("roczny", 0, 2)),
  function(w) sample(which(abonenci$plan == w[1] & abonenci$odszedl == as.integer(w[2]) & abonenci$miesiace >= 3),
                     as.integer(w[3]))))
os <- abonenci[wybor, ]
os$s <- match(os$start, format(seq(as.Date("2025-01-01"), by = "month", length.out = 18), "%Y-%m")) - 1
os <- os[order(os$s), ]
os$wiersz <- factor(os$id, levels = rev(os$id))
os$koniec <- ifelse(os$odszedl == 1, "odejście (zdarzenie)", "aktywny 1.07.2026 (cenzurowanie)")
os[, c("id", "start", "plan", "miesiace", "odszedl")]

wspolne <- list(scale_colour_manual(values = kol_plan, name = "Plan"),
                scale_shape_manual(values = c("odejście (zdarzenie)" = 4, "aktywny 1.07.2026 (cenzurowanie)" = 1),
                                   name = NULL), labs(y = NULL), motyw,
                guides(colour = guide_legend(order = 1), shape = guide_legend(order = 2)))
pA <- ggplot(os, aes(y = wiersz, colour = plan)) +
  geom_vline(xintercept = 18, linetype = "dashed", colour = "grey35") +
  geom_segment(aes(x = s, xend = s + miesiace, yend = wiersz), linewidth = 1.2) +
  annotate("text", x = 17.8, y = 10.3, label = "pobranie danych", hjust = 1, size = 4, colour = "grey30") +
  geom_segment(data = subset(os, odszedl == 0), aes(x = 18, xend = 19.6, yend = wiersz), linetype = "dotted",
               linewidth = 0.8, arrow = arrow(length = unit(2.5, "mm")), show.legend = FALSE) +
  geom_point(aes(x = s + miesiace, shape = koniec), size = 3.6, stroke = 1.4) +
  scale_x_continuous(breaks = c(0, 6, 12, 18), labels = c("I 2025", "VII 2025", "I 2026", "VII 2026"),
                     limits = c(0, 19.8)) +
  labs(title = "A. Kalendarz: abonenci zaczynają w różnych miesiącach",
       subtitle = "Kropki za linią przerywaną: dalszego losu aktywnych abonentów nie znamy", x = NULL) + wspolne
pB <- ggplot(os, aes(y = wiersz, colour = plan)) +
  geom_segment(aes(x = 0, xend = miesiace, yend = wiersz), linewidth = 1.2) +
  geom_point(aes(x = miesiace, shape = koniec), size = 3.6, stroke = 1.4) +
  scale_x_continuous(breaks = seq(0, 18, 3), limits = c(0, 18.5)) +
  labs(title = "B. Czas od startu abonamentu: wspólne zero dla wszystkich", x = "Miesiące od zakupu abonamentu") +
  wspolne
p1 <- (pA / pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.box = "vertical")
p1   # zapis: ggsave("churn-os-czasu-cenzurowanie.svg", p1, width = 10, height = 9)
Wynik w R
             aktywny (cenzurowany) odszedł  Sum
  miesięczny                   948     763 1711
  roczny                       575     114  689
  Sum                         1523     877 2400
miesięczny     roczny
      44.6       16.5
miesięczny     roczny
       4.3        9.2
        id   start       plan miesiace odszedl
118  A0118 2025-04 miesięczny        3       1
774  A0774 2025-04     roczny       12       1
893  A0893 2025-05 miesięczny       14       0
967  A0967 2025-06 miesięczny       13       1
199  A0199 2025-06     roczny       12       1
1328 A1328 2025-07 miesięczny        6       1
1954 A1954 2025-12 miesięczny        7       0
960  A0960 2026-01 miesięczny        6       0
749  A0749 2026-02     roczny        5       0
2029 A2029 2026-04     roczny        3       0
2. Kaplan–Meier, test log-rank i RMST: Rysunek 2
R
# Rysunek 2. Krzywe Kaplana–Meiera według planu z 95% przedziałami, mediana i liczba abonentów w ryzyku
# (korzysta z abonenci, kol_plan i motyw z przepisu 1)
library(survival)
library(ggplot2)
library(patchwork)

abonenci$plan <- factor(abonenci$plan, levels = c("miesięczny", "roczny"))
km <- survfit(Surv(miesiace, odszedl) ~ plan, data = abonenci)
print(km, rmean = 18)          # mediana z 95% CI i RMST – średnia liczba miesięcy z abonamentem do 18. miesiąca
summary(km, times = c(3, 4, 6, 11, 12, 18))[c("strata", "time", "n.risk", "surv", "lower", "upper")] |>
  as.data.frame() |> transform(surv = round(surv, 3), lower = round(lower, 3), upper = round(upper, 3))
logrank <- survdiff(Surv(miesiace, odszedl) ~ plan, data = abonenci)      # test log-rank
logrank
round(logrank$chisq, 1)                                         # χ²(1) dokładniej niż w wydruku

# Naiwny odsetek odejść (wszyscy w mianowniku) a odsetek odejść do 12. miesiąca z Kaplana–Meiera
s12 <- summary(km, times = 12)
round(rbind(naiwnie = 100 * tapply(abonenci$odszedl, abonenci$plan, mean), km_12_mies = 100 * (1 - s12$surv)), 1)

# Krzywa schodkowa: wartości w pełnych miesiącach (zdarzenia zachodzą tylko w pełnych miesiącach)
s <- summary(km, times = 0:18, extend = TRUE)
krzywe <- data.frame(plan = sub("plan=", "", s$strata), t = s$time, S = s$surv, dol = s$lower, gora = s$upper,
                     ryzyko = s$n.risk)
krzywe$plan <- factor(krzywe$plan, levels = names(kol_plan))
mediana <- unname(summary(km)$table[, "median"])               # NA = mediana nieosiągnięta
p2a <- ggplot(krzywe, aes(t, S, colour = plan, fill = plan)) +
  geom_rect(data = subset(krzywe, t < 18), aes(xmin = t, xmax = t + 1, ymin = dol, ymax = gora),
            inherit.aes = FALSE, fill = rep(kol_plan[as.character(subset(krzywe, t < 18)$plan)]), alpha = 0.2) +
  geom_step(aes(linetype = plan), linewidth = 1.1) +
  geom_hline(yintercept = 0.5, linetype = "dotted", colour = "grey40") +
  annotate("segment", x = mediana[1], xend = mediana[1], y = 0.5, yend = 0, linetype = "dotted", colour = kol_plan[1]) +
  annotate("text", x = mediana[1] + 0.2, y = 0.06, hjust = 0, size = 4, colour = kol_plan[1],
           label = sprintf("mediana planu miesięcznego: %g mies.", mediana[1])) +
  annotate("text", x = 12.2, y = 0.93, hjust = 0, size = 4, colour = kol_plan[2], label = "koniec roku:\npierwsze odnowienie") +
  scale_colour_manual(values = kol_plan, name = "Plan") + scale_fill_manual(values = kol_plan, guide = "none") +
  scale_linetype_manual(values = c("miesięczny" = "solid", "roczny" = "longdash"), name = "Plan") +
  scale_x_continuous(breaks = seq(0, 18, 3), limits = c(0, 18)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(title = "Ilu abonentów wciąż płaci? Kaplan–Meier według planu",
       x = NULL, y = "Odsetek z aktywnym abonamentem") + motyw
tabela <- subset(krzywe, t %in% seq(0, 18, 3))
xtabs(ryzyko ~ plan + t, data = tabela)                         # liczba abonentów w ryzyku pod wykresem
p2b <- ggplot(tabela, aes(t, plan, label = ryzyko, colour = plan)) + geom_text(size = 4.2, show.legend = FALSE) +
  scale_colour_manual(values = kol_plan) + scale_y_discrete(limits = rev(names(kol_plan))) +
  scale_x_continuous(breaks = seq(0, 18, 3), limits = c(0, 18)) +
  labs(x = "Miesiące od zakupu abonamentu", y = NULL, subtitle = "Liczba abonentów w ryzyku") + motyw +
  theme(panel.grid.major.y = element_blank())
p2 <- p2a / p2b + plot_layout(heights = c(4, 1))
p2   # zapis: ggsave("churn-kaplan-meier-plany.svg", p2, width = 10, height = 7)
Wynik w R
Call: survfit(formula = Surv(miesiace, odszedl) ~ plan, data = abonenci)

                   n events rmean* se(rmean) median 0.95LCL 0.95UCL
plan=miesięczny 1711    763   10.7     0.189     11      10      13
plan=roczny      689    114   15.2     0.213     NA      NA      NA
    * restricted mean with upper limit =  18
            strata time n.risk  surv lower upper
1  plan=miesięczny    3   1215 0.748 0.727 0.769
2  plan=miesięczny    4   1079 0.678 0.656 0.702
3  plan=miesięczny    6    796 0.629 0.605 0.654
4  plan=miesięczny   11    395 0.493 0.466 0.523
5  plan=miesięczny   12    343 0.476 0.448 0.506
6  plan=miesięczny   18     46 0.363 0.322 0.409
7      plan=roczny    3    584 0.958 0.943 0.973
8      plan=roczny    4    551 0.958 0.943 0.973
9      plan=roczny    6    460 0.958 0.943 0.973
10     plan=roczny   11    275 0.958 0.943 0.973
11     plan=roczny   12    235 0.611 0.555 0.674
12     plan=roczny   18     18 0.611 0.555 0.674
Call:
survdiff(formula = Surv(miesiace, odszedl) ~ plan, data = abonenci)

                   N Observed Expected (O-E)^2/E (O-E)^2/V
plan=miesięczny 1711      763      585      54.3       177
plan=roczny      689      114      292     108.7       177

 Chisq= 177  on 1 degrees of freedom, p= <2e-16
[1] 177.4
           miesięczny roczny
naiwnie          44.6   16.5
km_12_mies       52.4   38.9
            t
plan            0    3    6    9   12   15   18
  miesięczny 1711 1215  796  538  343  182   46
  roczny      689  584  460  346  235   73   18
3. Miesięczny hazard z przedziałami Wilsona: Rysunek 3
R
# Rysunek 3. Hazard w kolejnych miesiącach: jaka część wciąż aktywnych abonentów odchodzi w danym miesiącu
# (korzysta z abonenci i motyw z przepisu 1)
library(ggplot2)

abonenci$grupa <- with(abonenci, ifelse(plan == "roczny", "roczny",
                                        ifelse(kanal == "kod promocyjny", "miesięczny, kod promocyjny",
                                               "miesięczny, bez kodu")))
kol_grupa <- c("miesięczny, bez kodu" = "#D55E00", "miesięczny, kod promocyjny" = "#CC79A7", "roczny" = "#0072B2")
wilson <- function(d, n, z = 1.96) {          # 95% przedział Wilsona dla odsetka d/n
  p <- d / n; srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dol = srodek - pol, gora = srodek + pol)
}
hazard <- do.call(rbind, lapply(names(kol_grupa), function(g) {
  d <- subset(abonenci, grupa == g)
  do.call(rbind, lapply(1:18, function(k) {
    n_k <- sum(d$miesiace >= k)                       # w ryzyku: wciąż aktywni na początku miesiąca k
    d_k <- sum(d$miesiace == k & d$odszedl == 1)      # odeszli po miesiącu k
    data.frame(grupa = g, k, n_k, d_k, h = d_k / n_k, wilson(d_k, n_k))
  }))
}))
hazard$grupa <- factor(hazard$grupa, levels = names(kol_grupa))
hazard <- subset(hazard, n_k >= 30)                   # nie pokazujemy miesięcy z mniej niż 30 osobami w ryzyku
subset(transform(hazard, h = round(100 * h, 1), dol = round(100 * dol, 1), gora = round(100 * gora, 1)),
       k %in% c(1, 2, 3, 4, 5, 11, 12, 13))

p3 <- ggplot(hazard, aes(k, h, colour = grupa, shape = grupa, linetype = grupa)) +
  geom_linerange(aes(ymin = dol, ymax = gora), position = position_dodge(width = 0.5), linetype = "solid",
                 alpha = 0.6, linewidth = 0.8) +
  geom_line(position = position_dodge(width = 0.5), linewidth = 0.8) +
  geom_point(position = position_dodge(width = 0.5), size = 2.8, fill = "white", stroke = 1.1) +
  annotate("text", x = 4.4, y = 0.36, hjust = 0, size = 3.9, label = "4. miesiąc: koniec rabatu,\npierwsza pełna cena",
           colour = "#CC79A7") +
  annotate("text", x = 12.6, y = 0.43, hjust = 0, size = 3.9, label = "12. miesiąc:\nodnowienie roczne",
           colour = "#0072B2") +
  scale_colour_manual(values = kol_grupa, name = NULL) + scale_shape_manual(values = c(17, 15, 21), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  scale_x_continuous(breaks = 1:18) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "Kiedy abonenci odchodzą? Miesięczny hazard odejścia z 95% CI",
       x = "Miesiąc abonamentu", y = "Odeszło spośród wciąż aktywnych") + motyw
p3   # zapis: ggsave("churn-hazard-miesieczny.svg", p3, width = 10, height = 6)
Wynik w R
                        grupa  k  n_k d_k    h  dol gora
1        miesięczny, bez kodu  1 1299 174 13.4 11.7 15.4
2        miesięczny, bez kodu  2 1055 100  9.5  7.9 11.4
3        miesięczny, bez kodu  3  908  62  6.8  5.4  8.7
4        miesięczny, bez kodu  4  800  43  5.4  4.0  7.2
5        miesięczny, bez kodu  5  704  31  4.4  3.1  6.2
11       miesięczny, bez kodu 11  307  11  3.6  2.0  6.3
12       miesięczny, bez kodu 12  268   9  3.4  1.8  6.3
13       miesięczny, bez kodu 13  223  11  4.9  2.8  8.6
19 miesięczny, kod promocyjny  1  412  44 10.7  8.1 14.0
20 miesięczny, kod promocyjny  2  348  22  6.3  4.2  9.4
21 miesięczny, kod promocyjny  3  307  13  4.2  2.5  7.1
22 miesięczny, kod promocyjny  4  279  57 20.4 16.1 25.5
23 miesięczny, kod promocyjny  5  204   9  4.4  2.3  8.2
29 miesięczny, kod promocyjny 11   88   4  4.5  1.8 11.1
30 miesięczny, kod promocyjny 12   75   3  4.0  1.4 11.1
31 miesięczny, kod promocyjny 13   63   2  3.2  0.9 10.9
37                     roczny  1  689  29  4.2  2.9  6.0
38                     roczny  2  625   0  0.0  0.0  0.6
39                     roczny  3  584   0  0.0  0.0  0.7
40                     roczny  4  551   0  0.0  0.0  0.7
41                     roczny  5  511   0  0.0  0.0  0.7
47                     roczny 11  275   0  0.0  0.0  1.4
48                     roczny 12  235  85 36.2 30.3 42.5
49                     roczny 13  126   0  0.0  0.0  3.0
4. Model Coxa A i reszty Schoenfelda: Rysunek 4
R
# Rysunek 4. Model Coxa „jak z podręcznika” i sprawdzenie proporcjonalności hazardów resztami Schoenfelda
# (korzysta z abonenci i motyw z przepisu 1)
library(survival)
library(ggplot2)

abonenci$plan <- factor(abonenci$plan, levels = c("miesięczny", "roczny"))
abonenci$kanal <- factor(abonenci$kanal, levels = c("sklep z aplikacjami", "reklama społecznościowa", "kod promocyjny"))
model_a <- coxph(Surv(miesiace, odszedl) ~ plan + kanal + aktywne_dni, data = abonenci)
round(cbind(HR = exp(coef(model_a)), exp(confint(model_a)), p = summary(model_a)$coefficients[, "Pr(>|z|)"]), 3)
zph_a <- cox.zph(model_a)       # test proporcjonalności hazardów (skalowane reszty Schoenfelda)
data.frame(chi2 = round(zph_a$table[, "chisq"], 2), df = zph_a$table[, "df"], p = signif(zph_a$table[, "p"], 3))

# Skalowane reszty Schoenfelda dla planu rocznego (β + reszta): ich średnia w czasie przybliża log HR, β(t)
reszty <- data.frame(t = zph_a$time, r = zph_a$y[, "plan"])
srednie <- aggregate(r ~ t, data = reszty, FUN = mean)       # średnia reszt w każdym miesiącu zdarzeń
round(setNames(srednie$r, srednie$t), 2)
p4 <- ggplot(reszty, aes(t, r)) +
  geom_boxplot(aes(group = t), width = 0.55, outlier.shape = NA, colour = "grey50", fill = "grey92") +
  geom_hline(yintercept = coef(model_a)["planroczny"], colour = "#0072B2", linetype = "dashed", linewidth = 0.9) +
  geom_hline(yintercept = 0, colour = "grey30", linewidth = 0.4) +
  geom_line(data = srednie, colour = "#D55E00", linewidth = 1) +
  geom_point(data = srednie, colour = "#D55E00", size = 2.6) +
  annotate("text", x = 0.6, y = 1.2, hjust = 0, size = 4, colour = "#0072B2",
           label = sub("-", "−", sprintf("niebieska linia: jeden HR z modelu, log HR = %.2f (HR = %.2f)", coef(model_a)["planroczny"],
                                     exp(coef(model_a)["planroczny"])))) +
  annotate("text", x = 0.6, y = 4.5, hjust = 0, size = 4, colour = "#D55E00",
           label = "czerwona linia: średnia reszt w miesiącu;\nw 12. miesiącu efekt planu rocznego się odwraca") +
  scale_x_continuous(breaks = 1:18) +
  coord_cartesian(ylim = c(-4, 7.5)) +
  labs(title = "Czy efekt planu rocznego jest stały w czasie? Reszty Schoenfelda",
       x = "Miesiąc abonamentu (moment odejścia)", y = "β(t) dla planu rocznego (log HR)") + motyw
p4   # zapis: ggsave("churn-reszty-schoenfelda-plan.svg", p4, width = 10, height = 6)
Wynik w R
                                HR 2.5 % 97.5 %     p
planroczny                   0.317 0.259  0.389 0.000
kanalreklama społecznościowa 1.349 1.160  1.570 0.000
kanalkod promocyjny          1.123 0.934  1.349 0.217
aktywne_dni                  0.862 0.818  0.907 0.000
             chi2 df        p
plan        45.17  1 1.81e-11
kanal        0.37  2 8.30e-01
aktywne_dni  2.87  1 9.00e-02
GLOBAL      50.14  4 3.37e-10
    1     2     3     4     5     6     7     8     9    10    11    12    13
-1.04 -2.29 -2.27 -2.30 -2.45 -2.58 -2.62 -2.49 -2.68 -2.48 -2.86  5.37 -2.29
   14    15    16    17    18
-2.24 -2.10 -2.25 -1.76 -1.69
5. Model Coxa B – warstwy planu i okresy: Rysunek 5
R
# Rysunek 5. Lepszy model: osobne krzywe bazowe dla planów (warstwy) i efekt kodu promocyjnego osobno dla okresów
# (korzysta z abonenci, motyw z przepisu 1 i model_a z przepisu 4)
library(survival)
library(ggplot2)

# Dzielimy czas każdego abonenta na okresy: miesiące 1–3 (rabat), 4 (pierwsza pełna cena), 5 i dalej
okresy <- survSplit(Surv(miesiace, odszedl) ~ ., data = abonenci, cut = c(3, 4), episode = "okres")
okresy$kod_1_3 <- as.integer(okresy$kanal == "kod promocyjny" & okresy$okres == 1)
okresy$kod_4 <- as.integer(okresy$kanal == "kod promocyjny" & okresy$okres == 2)
okresy$kod_5plus <- as.integer(okresy$kanal == "kod promocyjny" & okresy$okres == 3)
okresy$reklama <- as.integer(okresy$kanal == "reklama społecznościowa")
model_b <- coxph(Surv(tstart, miesiace, odszedl) ~ reklama + kod_1_3 + kod_4 + kod_5plus + aktywne_dni +
                   strata(plan), data = okresy)
round(cbind(HR = exp(coef(model_b)), exp(confint(model_b)), p = summary(model_b)$coefficients[, "Pr(>|z|)"]), 3)
c(odejscia = model_b$nevent, wiersze_po_podziale = nrow(okresy))

# Wykres lasu: HR z 95% CI w obu modelach i mnożniki ryzyka ustawione w symulacji (oś logarytmiczna)
hr <- function(m, nazwy, etykiety, model) {
  data.frame(model, zmienna = etykiety, HR = exp(coef(m)[nazwy]), dol = exp(confint(m)[nazwy, 1]),
             gora = exp(confint(m)[nazwy, 2]), row.names = NULL)
}
lasy <- rbind(
  hr(model_a, c("planroczny", "kanalreklama społecznościowa", "kanalkod promocyjny", "aktywne_dni"),
     c("Plan roczny (vs miesięczny)", "Reklama społecznościowa", "Kod promocyjny: cały czas",
       "Aktywność: +1 dzień w 1. tygodniu"), "A: jeden HR na zmienną"),
  hr(model_b, c("reklama", "kod_1_3", "kod_4", "kod_5plus", "aktywne_dni"),
     c("Reklama społecznościowa", "Kod promocyjny: miesiące 1–3", "Kod promocyjny: miesiąc 4",
       "Kod promocyjny: miesiące 5+", "Aktywność: +1 dzień w 1. tygodniu"), "B: warstwy planu i okresy"))
kolejnosc <- c("Plan roczny (vs miesięczny)", "Reklama społecznościowa", "Aktywność: +1 dzień w 1. tygodniu",
               "Kod promocyjny: cały czas", "Kod promocyjny: miesiące 1–3", "Kod promocyjny: miesiąc 4",
               "Kod promocyjny: miesiące 5+")
lasy$zmienna <- factor(lasy$zmienna, levels = rev(kolejnosc))
ustawione <- data.frame(zmienna = factor(kolejnosc[c(2, 3, 5:7)], levels = rev(kolejnosc)),
                        HR = c(1.35, 0.85, 0.8, 4, 1.2))       # mnożniki z przepisu 1
transform(lasy, HR = round(HR, 2), dol = round(dol, 2), gora = round(gora, 2))
p5 <- ggplot(lasy, aes(HR, zmienna, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_point(data = ustawione, aes(HR, zmienna), inherit.aes = FALSE, shape = 4, size = 4, stroke = 1.3,
             colour = "grey20") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, linewidth = 0.9, orientation = "y",
                 position = position_dodge(width = 0.5)) +
  geom_point(size = 3.4, position = position_dodge(width = 0.5)) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4, 8), labels = c("0.25", "0.5", "1", "2", "4", "8")) +
  scale_y_discrete(limits = rev(kolejnosc)) +
  scale_colour_manual(values = c("#999999", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(title = "Iloraz hazardów odejścia z 95% CI w dwóch modelach Coxa",
       subtitle = "× – mnożnik ryzyka ustawiony w symulacji; HR < 1 = wolniejsze odchodzenie",
       x = "HR (skala logarytmiczna)", y = NULL) + motyw
p5   # zapis: ggsave("churn-cox-ilorazy-hazardow.svg", p5, width = 10, height = 6.4)
Wynik w R
               HR 2.5 % 97.5 %     p
reklama     1.363 1.171  1.585 0.000
kod_1_3     0.755 0.582  0.979 0.034
kod_4       4.327 2.887  6.487 0.000
kod_5plus   1.025 0.752  1.397 0.874
aktywne_dni 0.861 0.818  0.906 0.000
           odejscia wiersze_po_podziale
                877                5449
                      model                           zmienna   HR  dol gora
1    A: jeden HR na zmienną       Plan roczny (vs miesięczny) 0.32 0.26 0.39
2    A: jeden HR na zmienną           Reklama społecznościowa 1.35 1.16 1.57
3    A: jeden HR na zmienną         Kod promocyjny: cały czas 1.12 0.93 1.35
4    A: jeden HR na zmienną Aktywność: +1 dzień w 1. tygodniu 0.86 0.82 0.91
5 B: warstwy planu i okresy           Reklama społecznościowa 1.36 1.17 1.59
6 B: warstwy planu i okresy      Kod promocyjny: miesiące 1–3 0.75 0.58 0.98
7 B: warstwy planu i okresy         Kod promocyjny: miesiąc 4 4.33 2.89 6.49
8 B: warstwy planu i okresy       Kod promocyjny: miesiące 5+ 1.03 0.75 1.40
9 B: warstwy planu i okresy Aktywność: +1 dzień w 1. tygodniu 0.86 0.82 0.91
6. Czy paleta jest czytelna przy zaburzeniach widzenia barw?
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("miesięczny – roczny" = c("#D55E00", "#0072B2"),
             "miesięczny bez kodu – z kodem" = c("#D55E00", "#CC79A7"),
             "miesięczny z kodem – roczny" = c("#CC79A7", "#0072B2"),
             "model A – model B (rys. 5)" = c("#999999", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
miesięczny – roczny                        114.6        108.3       91.9
miesięczny bez kodu – z kodem               74.3         70.2       71.9
miesięczny z kodem – roczny                 53.6         42.0       22.5
model A – model B (rys. 5)                  44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i przedziały Wilsona – bazowy R (pakiety stats i base); estymator Kaplana–Meiera (survfit()), test log-rank (survdiff()), model Coxa (coxph()), test proporcjonalności (cox.zph()) i podział czasu (survSplit()) – pakiet survival. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Usuwanie aktywnych klientów albo liczenie ich jako „zostali”. Naiwny odsetek odejść w planie rocznym to 16.5%, a do 12. miesiąca odchodzi 38.9% (rysunki 1–2).
- Średni czas tylko wśród odchodzących (4.3 miesiąca) to nie „czas życia klienta”. Podaj medianę i RMST.
- Jeden HR przy skokach odejść. HR = 0.32 dla planu rocznego i nieistotny kod promocyjny ukrywały odnowienie i koniec rabatu (rysunki 4–5).
- Inne wyjście niż rezygnacja. Przejście z planu miesięcznego na roczny to nie churn. Zakoduj je jako cenzurowanie albo, gdy chcesz opisać oba wyjścia, jako ryzyka konkurencyjne.
- Zmienne z przyszłości. „Liczba lekcji w całym abonamencie” rośnie z czasem płacenia, więc pozornie chroni. Bierz tylko to, co znasz na starcie (np. pierwszy tydzień), albo zmienne zależne od czasu.
- Związek to nie przyczyna. HR kanału czy aktywności opisuje klientów, a nie skutek działania. Skutek pokaże dopiero eksperyment.
Najczęstsze pytania
Dlaczego do churnu nie wystarczy odsetek klientów, którzy odeszli?
Bo część klientów dołączyła niedawno i nie miała jeszcze czasu odejść. Ich obserwacje są cenzurowane: wiemy tylko, że do dnia pobrania danych płacili. W przykładzie naiwny odsetek odejść w planie miesięcznym to 44.6%, a krzywa Kaplana–Meiera pokazuje, że do 12. miesiąca odchodzi 52.4% abonentów.
Co to jest hazard odejścia klienta?
To odsetek klientów, którzy odchodzą w danym miesiącu, spośród tych, którzy byli aktywni na jego początku. Pokazuje, kiedy ludzie odchodzą: w przykładzie po końcu rabatu w 4. miesiącu odeszło 20.4% abonentów z kodem promocyjnym, a przy pierwszym odnowieniu planu rocznego – 36.2%.
Jak interpretować iloraz hazardów (HR) w modelu Coxa dla churnu?
HR porównuje tempo odejść dwóch grup w tym samym czasie od startu abonamentu: HR = 1.36 dla reklamy społecznościowej znaczy o 36% szybsze odchodzenie niż przy pobraniu ze sklepu z aplikacjami, przy tej samej aktywności. To nie jest różnica odsetków ani dowód, że reklama powoduje odejścia – klienci z różnych kanałów różnią się od siebie.
Co zrobić, gdy w modelu Coxa nie jest spełnione założenie proporcjonalnych hazardów?
Najpierw obejrzyj hazard w czasie i reszty Schoenfelda (w R cox.zph()). Zmienną, której efekt zmienia się w czasie, wpisz jako warstwę (strata()) albo podziel czas na okresy i oszacuj osobny HR dla każdego. W przykładzie kod promocyjny miał jeden HR = 1.12 (p = .217), a po podziale HR = 4.33 w 4. miesiącu, gdy kończył się rabat.
Czy model Coxa wskaże, którzy klienci zaraz odejdą?
Może dać ryzyko dla każdego klienta, ale do wyboru adresatów kampanii lepiej pasuje model przewidywania odejść oceniany na zbiorze testowym (gain, lift, kalibracja). Analiza przeżycia odpowiada przede wszystkim na pytania „jak długo?” i „kiedy?”, a to, czy kampania zatrzyma klienta, sprawdza dopiero eksperyment.
Powiązane hasła
Przeczytaj też
Model odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikModel BG/NBD – aktywni klienci
Sklep z przyprawami: BG/NBD napisany ręcznie w R, P(aktywny), prognoza zakupów na rok 2 i porównanie z regułą 180 dni – sześć rysunków.
Czytaj →PoradnikOkres próbny i freemium – analiza przeżycia
Ilu użytkowników kiedyś kupi i jak szybko? Kaplan–Meier, model frakcji wyleczonych i test 7 vs 14 dni okresu próbnego – z kodem R.
Czytaj →Analizujesz odejścia klientów do pracy z marketingu?
Pomożemy zakodować czas i cenzurowanie, narysować krzywe i hazard, dobrać model Coxa, sprawdzić proporcjonalność hazardów i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bolton, R. N. (1998). A dynamic model of the duration of the customer's relationship with a continuous service provider: The role of satisfaction. Marketing Science, 17(1), 45–65. https://doi.org/10.1287/mksc.17.1.45
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Datta, H., Foubert, B., & Van Heerde, H. J. (2015). The challenge of retaining customers acquired with free trials. Journal of Marketing Research, 52(2), 217–234. https://doi.org/10.1509/jmr.12.0160 ● Otwarty dostęp: pełny tekst
- Fader, P. S., & Hardie, B. G. S. (2007). How to project customer retention. Journal of Interactive Marketing, 21(1), 76–90. https://doi.org/10.1002/dir.20074 ● Otwarty dostęp: pełny tekst
- Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. https://doi.org/10.1093/biomet/81.3.515
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Schweidel, D. A., Fader, P. S., & Bradlow, E. T. (2008). Understanding service retention within and across cohorts using limited information. Journal of Marketing, 72(1), 82–94. https://doi.org/10.1509/jmkg.72.1.082
Cytowania BibTeX
@article{bolton1998dynamic, author={Bolton, Ruth N.}, title={{A dynamic model of the duration of the customer's relationship with a continuous service provider: The role of satisfaction}}, journal={Marketing Science}, year={1998}, volume={17}, number={1}, pages={45--65}, doi={10.1287/mksc.17.1.45}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{datta2015challenge, author={Datta, Hannes and Foubert, Bram and Van Heerde, Harald J.}, title={{The challenge of retaining customers acquired with free trials}}, journal={Journal of Marketing Research}, year={2015}, volume={52}, number={2}, pages={217--234}, doi={10.1509/jmr.12.0160}}@article{fader2007how, author={Fader, Peter S. and Hardie, Bruce G. S.}, title={{How to project customer retention}}, journal={Journal of Interactive Marketing}, year={2007}, volume={21}, number={1}, pages={76--90}, doi={10.1002/dir.20074}}@article{grambsch1994proportional, author={Grambsch, Patricia M. and Therneau, Terry M.}, title={{Proportional hazards tests and diagnostics based on weighted residuals}}, journal={Biometrika}, year={1994}, volume={81}, number={3}, pages={515--526}, doi={10.1093/biomet/81.3.515}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{schweidel2008understanding, author={Schweidel, David A. and Fader, Peter S. and Bradlow, Eric T.}, title={{Understanding service retention within and across cohorts using limited information}}, journal={Journal of Marketing}, year={2008}, volume={72}, number={1}, pages={82--94}, doi={10.1509/jmkg.72.1.082}}