Przykład: aplikacja do medytacji z okresem próbnym
Fikcyjna aplikacja do medytacji ma darmową wersję i płatną wersję premium. Nowy użytkownik dostaje na start okres próbny premium, a po nim wraca do wersji darmowej, chyba że wykupi subskrypcję. Dział marketingu pyta: ilu użytkowników w ogóle kiedyś kupi, jak szybko to robią i czy dłuższy okres próbny pomaga?
Dane obejmują 8000 instalacji z jednego roku. Przy instalacji aplikacja losowała długość okresu próbnego: 7 albo 14 dni (to test A/B). Znamy też źródło pozyskania: sklep z aplikacjami, reklama w mediach społecznościowych albo polecenie znajomego. Wynik to czas od instalacji do pierwszego zakupu premium w dniach. Dane pobrano 15 dni po ostatniej instalacji. Kto do tego dnia nie kupił, ma obserwację cenzurowaną.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie (lista przy kodzie): kiedyś kupi 12% użytkowników ze sklepu z aplikacjami, 7% z reklamy i 22% z polecenia; 14 dni okresu próbnego podnosi te odsetki nieznacznie. Kupujący po reklamie decydują się szybko, polecający – powoli. W dniach 330–336 roku była promocja z rabatem 40%. Po pierwszym uruchomieniu przesunęliśmy dzień analizy z 30 na 15 dni po ostatniej instalacji, żeby problem nowych użytkowników był wyraźniejszy; ziarna 700 nie zmienialiśmy. Dane pobierzesz jako okres-probny-aplikacja-medytacja.csv (kolumna kupilby_kiedys istnieje tylko w symulacji).
Do dnia analizy było 1060 zakupów, w tym 172 z rabatem. W analizie głównej liczymy 861 zakupów po cenie regularnej; mediana obserwacji to 123 dni. Inne tematy prac zebraliśmy we wpisie statystyka w pracy z marketingu.
Rysunek 1: dwie grupy w jednej krzywej
Większość użytkowników wersji darmowej nie zapłaci nigdy, choćby obserwować ich latami. Krzywa konwersji jest więc sumą dwóch grup: tych, którzy kiedyś kupią, i tych, którzy nie kupią nigdy.
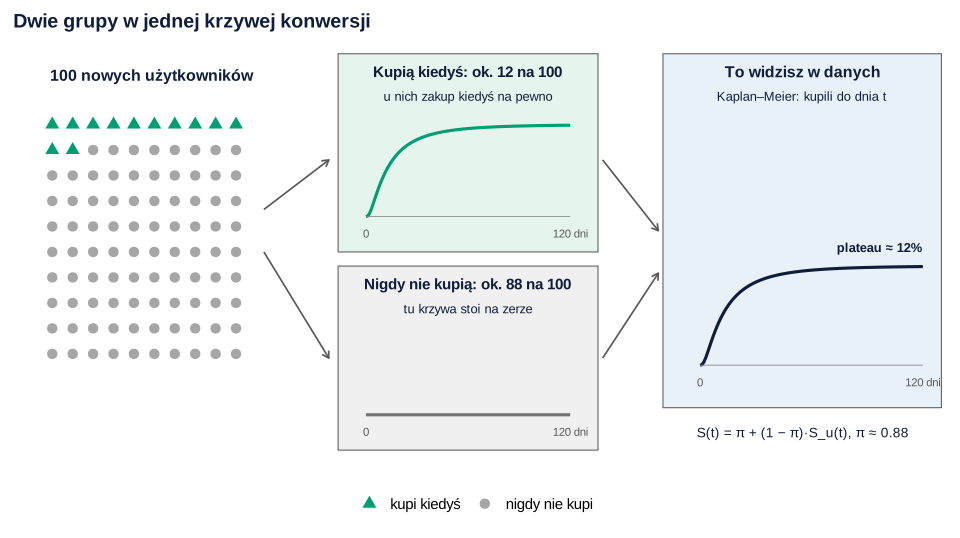
set.seed(700)).Co widać. Ze 100 nowych użytkowników ok. 12 kiedyś kupi; ich własna krzywa dochodzi do 100%. U pozostałych 88 krzywa stoi na zerze. W danych widać tylko sumę: krzywą, która rośnie kilka tygodni, a potem wypłaszcza się na ok. 12% (plateau). Opisuje je model frakcji wyleczonych: S(t) = π + (1 − π)·Su(t), gdzie π to udział „nigdy nie kupi”, a Su(t) – odsetek jeszcze niekupujących wśród przyszłych klientów. Nazwa pochodzi z medycyny: Berkson i Gage (1952) opisali przeżycie po leczeniu nowotworu odsetkiem „wyleczonych” i tempem zgonów u reszty. Tu „wyleczony” to użytkownik, który nie kupi.
Jak może zmylić. Nikt w danych nie ma etykiety „nigdy nie kupi” – model szacuje tylko udział takich osób (rysunek 4).
Rysunek 2: obcięcie obserwacji u nowych użytkowników
Najprostszy raport to odsetek kupujących według miesiąca instalacji: kupujący do dnia analizy podzieleni przez instalacje. Porównajmy go z prawdą i z odsetkiem z krzywej Kaplana–Meiera w oknie 30 dni.
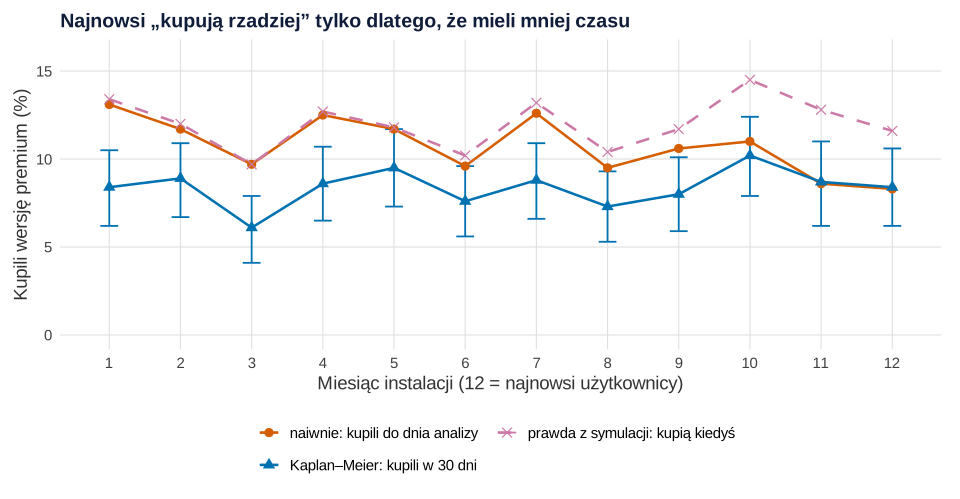
Co widać. W 1. miesiącu odsetek naiwny leży blisko prawdy (13.1% wobec 13.4%). W trzech ostatnich spada do 11.0%, 8.6% i 8.3%, przy prawdzie 14.5%, 12.8% i 11.6%. Najnowsi nie są gorszymi klientami – mieli mniej czasu (mediana obserwacji 24–38 dni wobec 312 w 1. miesiącu). Odsetek z Kaplana–Meiera w 30 dniach waha się od 6.1% do 10.2% bez trendu.
Jak może zmylić. W całym roku odsetek naiwny wynosi 10.76% przy prawdzie 12.03%. Taki wykres łatwo przeczytać jako „pogorszenie ruchu”. Kaplan i Meier (1958) zaproponowali estymator wykorzystujący obserwacje niepełne, przy założeniu, że cenzurowanie nie zależy od czasu do zdarzenia – tu zależy tylko od daty instalacji. Ten sam problem przy tabeli kohort omawia analiza kohortowa retencji klientów.
Rysunek 3: Kaplan–Meier – krzywa się wypłaszcza
Rysujemy dopełnienie krzywej Kaplana–Meiera, czyli skumulowany odsetek kupujących, osobno dla trzech źródeł. Procedurę opisuje wpis Kaplan–Meier i model Coxa, a odejścia abonentów – churn jako analiza przeżycia; tu zdarzeniem jest zakup. Kreski to krzywe z modelu frakcji.
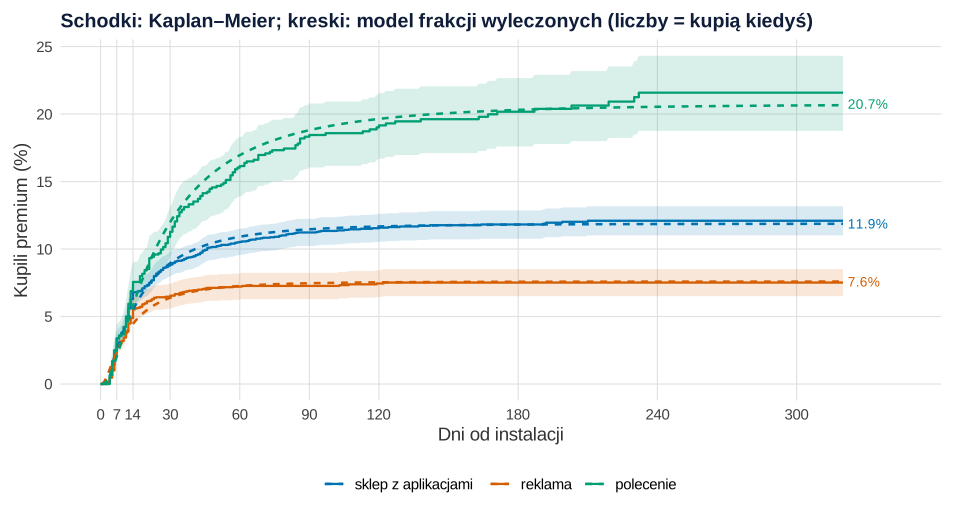
Co widać. Krzywe rosną stromo do końca okresów próbnych, potem coraz wolniej. W 30 dni kupiło 8.9% użytkowników ze sklepu, 6.5% z reklamy i 11.3% z polecenia, w 270 dni – 12.1%, 7.5% i 21.6%. Po 180. dniu było tylko 9 zakupów. Model frakcji idzie za schodkami. Źródła różnią się istotnie (test log-rank: χ²(2) = 96.7, p < .001).
Jak może zmylić. Ogon krzywej opiera się na niewielu osobach: w 270. dniu w ryzyku było 586 osób ze sklepu i 140 z polecenia. Płaski odcinek może wynikać z braku obserwacji – podaj liczbę osób w ryzyku. Test log-rank nie mówi, czy krzywe różnią się udziałem kupujących, czy tempem.
Rysunek 4: model frakcji wyleczonych – kto kupi i jak szybko
Przegląd regresyjnych modeli tego typu podają Amico i Van Keilegom (2018). Model mieszaninowy ma dwie części. Incydencja to regresja logistyczna dla tego, czy ktoś kiedyś kupi. Latencja to model czasu do zakupu tylko dla przyszłych kupujących – tu rozkład lognormalny, więc współczynniki mnożą medianę czasu. Obie części mają te same predyktory: źródło i długość okresu próbnego. Parametry szacuje metoda największej wiarygodności (pakiet flexsurvcure). Sy i Taylor (2000) wskazują je, gdy populacja zawiera osoby niepodatne na zdarzenie, a dane mają dużo cenzurowania pod koniec obserwacji – jak tutaj.
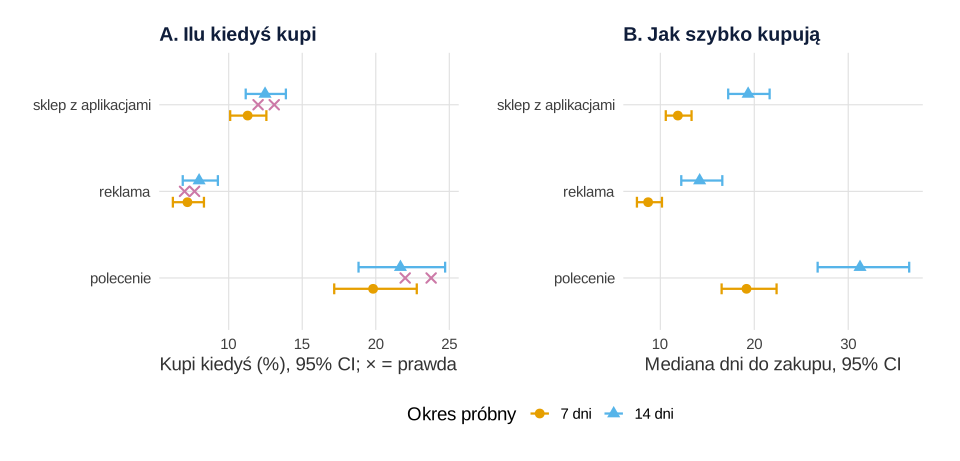
Co widać – panel A. Przy 7 dniach okresu próbnego kiedyś kupi 11.29% użytkowników ze sklepu (95% CI [10.10, 12.56]), 7.20% z reklamy [6.21, 8.32] i 19.82% z polecenia [17.18, 22.79]. Szanse zakupu kiedykolwiek: reklama wobec sklepu OR = 0.61 [0.51, 0.73], polecenie OR = 1.94 [1.61, 2.34]. Przy 14 dniach odsetki są nieco wyższe (OR = 1.12 [0.97, 1.29]), ale przedział obejmuje 1.
Co widać – panel B. Wśród przyszłych kupujących mediana czasu do zakupu wynosi 11.9 dnia po sklepie [10.6, 13.3], 8.7 po reklamie i 19.2 po poleceniu (7 dni okresu próbnego). Reklama skraca medianę 0.73 raza [0.62, 0.86], polecenie wydłuża ją 1.62 raza [1.37, 1.91]. Kanały różnią się więc w dwóch wymiarach naraz: reklama daje mniej, ale szybszych klientów, polecenie – więcej, ale wolniejszych.
Jak może zmylić. Wynik zależy od założonego rozkładu latencji, bo udział „nigdy nie kupi” leży poza danymi. Lognormalny dał AIC = 12 111.5, Weibull 12 361.5, uogólniony gamma 11 875.3, a odsetek kupujących ze sklepu (7 dni) odpowiednio 11.3%, 11.6% i 12.0%. Wnioski są zgodne, ale podaj ten test wrażliwości w pracy. Przy poleceniu model zaniża odsetek (19.8% wobec 22%): ci użytkownicy kupują powoli, a część obserwowano krótko.
Rysunek 5: a może regresja logistyczna „kupił w 30 dni”?
Popularna alternatywa to iloraz szans z regresji logistycznej dla „kupił w 30 dni od instalacji”. Wymaga pełnego okna, więc pomija 683 osoby obserwowane krócej (zostaje 7317, z czego 663 kupiło).
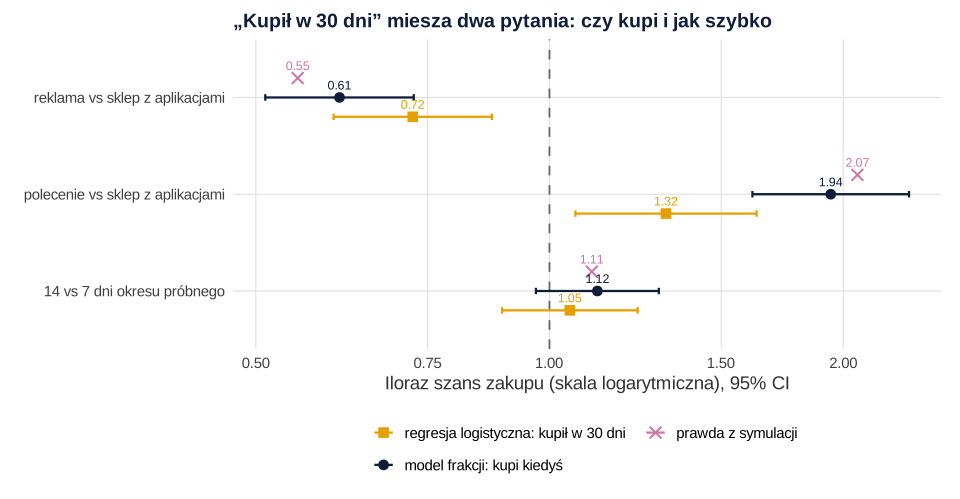
Co widać. Regresja „w 30 dni” daje dla reklamy OR = 0.72 [0.60, 0.87], a dla polecenia OR = 1.32 [1.06, 1.63]. Model frakcji: 0.61 i 1.94; prawda z symulacji: 0.55 i 2.07. Regresja zaniża przewagę polecenia, bo polecający kupują po 30. dniu, a reklama wygląda lepiej, bo jej klienci kupują szybko.
Jak może zmylić. Regresja logistyczna odpowiada na inne pytanie: ilu kupi w miesiącu. Przy oknie 7 albo 90 dni OR byłby inny; w modelu frakcji nie zależy od wyboru okna.
Rysunek 6: 7 czy 14 dni okresu próbnego?
Długość okresu próbnego była losowana. Pytamy, czy dłuższy okres zwiększa odsetek kupujących i czy opóźnia zakup.
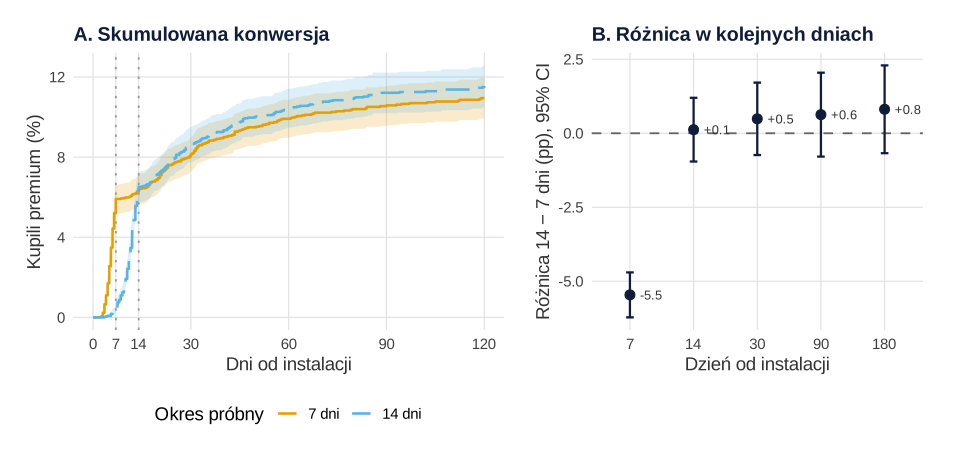
Co widać – panel A. Każda krzywa skacze tuż przed końcem swojego okresu próbnego. W 7. dniu kupiło 5.91% osób z krótszym okresem i 0.45% z dłuższym (różnica −5.46 pp, 95% CI [−6.22, −4.70]). Od 14. dnia krzywe biegną blisko siebie (w 180. dniu 11.14% i 11.95%).
Co widać – panel B. Po 14. dniu różnica jest mała i niepewna: +0.49 pp w 30. dniu [−0.74, 1.71], +0.81 pp w 180. dniu [−0.67, 2.29]. Model frakcji daje odsetek kupujących kiedykolwiek 11.12% przy 7 dniach i 12.27% przy 14 dniach: +1.15 pp [−0.34, 2.62]. Mediana czasu do zakupu u kupujących wydłuża się z 11.87 do 19.35 dnia (1.63 raza [1.43, 1.86]).
Jak może zmylić. Test zakończony po tygodniu „pokazałby” przewagę 7 dni o 5.5 pp – to tylko przesunięcie zakupów. Brak istotnej różnicy nie dowodzi braku efektu; przedział dopuszcza od −0.3 do +2.6 pp. Yoganarasimhan i in. (2023) w eksperymencie terenowym z oprogramowaniem w subskrypcji stwierdzili, że krótszy okres próbny przeciętnie dawał najwięcej klientów i najlepszą retencję – to wynik z jednej branży.
Zakupy po rabacie
W dniach 330–336 roku aplikacja dała rabat 40% użytkownikom po okresie próbnym. Część osób kupuje wtedy wcześniej, niż kupiłaby i tak, a część – tylko dlatego, że jest taniej. W danych 172 z 1060 zakupów (16.2%) było z rabatem, a 148 z tych kupujących w symulacji nie kupiłoby nigdy.
Gdy policzymy zakupy z rabatem jak każdy inny, model daje 15.54% kupujących kiedykolwiek. W analizie głównej cenzurujemy objętych promocją w dniu jej startu i dostajemy 11.70% przy prawdzie 12.03%. Promocja „podnosi” plateau, ale nie dlatego, że produkt lepiej się sprzedaje – przychód z tych osób jest niższy. Rabaty omawia wpis głębokość rabatu a sprzedaż.
Co z tym zrobić w marketingu
- Raportuj konwersję z Kaplana–Meiera w stałym oknie, nie „kupili do dziś / wszyscy”. Tło daje wpis lejek konwersji – etapy i test A/B.
- Oceniaj kanały dwiema liczbami: ilu użytkowników kiedyś kupi i po jakim czasie. Polecenie daje prawie trzy razy więcej kupujących niż reklama (19.8% wobec 7.2%), ale wolniej – nie oceniaj go po miesiącu.
- Nie wydłużaj okresu próbnego „na wszelki wypadek”. 14 dni opóźnia zakupy o ok. tydzień, a zysk w odsetku jest niepewny. Kolejny test zaplanuj tak, by wykrył ok. 1 pp.
- Zakupy z promocji licz osobno. Datta i in. (2015) pokazali, że klienci pozyskani darmowym okresem próbnym mają niższą wartość w czasie niż pozostali, więc patrz też na retencję (zob. wartość klienta (CLV)).
- Zmiany okresu próbnego sprawdzaj eksperymentem, jak w losowym teście ceny, nie porównaniem kohort przed i po.
Jak opisać w pracy
W Metodzie opisz początek obserwacji, zdarzenie, cenzurowanie i obie części modelu; w Wynikach najpierw krzywe, potem model.
Kod R: dane, Kaplan–Meier, model frakcji i eksperyment
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Krzywe Kaplana–Meiera i test log-rank to pakiet survival, model frakcji wyleczonych – flexsurvcure (oparty na flexsurv), losowanie parametrów do przedziałów – MASS::mvrnorm(). Ten sam model z latencją Coxa liczy pakiet smcure. Każdy przepis z rysunkiem kończy się nazwą wykresu (p2–p8), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepis 1 (set.seed(700)) i przepis 4 (set.seed(7004), 4000 losowań parametrów); ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 8000 instalacji rozłożonych równomiernie na 365 dni, dzień analizy 380, udziały źródeł (50% sklep z aplikacjami, 35% reklama, 15% polecenie), losowy przydział 7 lub 14 dni okresu próbnego (50/50), prawdziwy odsetek kupujących kiedyś przy 7 dniach (12%, 7%, 22%) i efekt 14 dni (+0.10 na skali logitu), odsetek zakupów w trakcie okresu próbnego (55%, 70%, 30%; czas = długość okresu × Beta(4, 1.3)), czas zakupu po okresie próbnym (lognormalny, mediana 25, 15 i 45 dni od końca okresu, sdlog 1.1) oraz promocję w dniach 330–336 (rabat 40%; kupuje 35% przyszłych kupujących, którzy jeszcze nie kupili, i 2.5% pozostałych). Po pierwszym uruchomieniu zmieniono dzień analizy z 395 na 380 (15 zamiast 30 dni po ostatniej instalacji), żeby obcięcie obserwacji u nowych użytkowników było wyraźniejsze; pozostałe parametry są takie jak w pierwszym uruchomieniu. Całość liczy się w kilkanaście sekund.
1. Paleta, motyw i dane
R
# Przepis 1. Fikcyjna aplikacja do medytacji: darmowa wersja, okres próbny premium (7 lub 14 dni,
# losowany przy instalacji) i czas od instalacji do zakupu wersji płatnej (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_zrodla <- c("sklep z aplikacjami" = "#0072B2", "reklama" = "#D55E00", "polecenie" = "#009E73")
kol_okres  <- c("7 dni" = "#E69F00", "14 dni" = "#56B4E9")
kol <- c(model = "#0f1d3a", prawda = "#CC79A7", szary = "grey55", jasny = "grey85", rabat = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ------------------------------------------------------------------
n            <- 8000      # nowe instalacje w ciągu roku (dni 1–365)
dzien_analizy <- 380      # dzień pobrania danych: 15 dni po ostatniej instalacji
udzialy      <- c("sklep z aplikacjami" = 0.50, "reklama" = 0.35, "polecenie" = 0.15)
# Prawdziwy odsetek osób, które KIEDYŚ kupią premium (przy 7-dniowym okresie próbnym)
p_kupi       <- c("sklep z aplikacjami" = 0.12, "reklama" = 0.07, "polecenie" = 0.22)
efekt_14     <- 0.10      # 14 dni zamiast 7: +0.10 na skali logitu odsetka kupujących
# Wśród kupujących: odsetek zakupów jeszcze w okresie próbnym i mediana dni od końca okresu
w_okresie    <- c("sklep z aplikacjami" = 0.55, "reklama" = 0.70, "polecenie" = 0.30)
mediana_po   <- c("sklep z aplikacjami" = 25, "reklama" = 15, "polecenie" = 45)
promocja     <- c(330, 337) # dni kalendarza z rabatem 40% dla użytkowników po okresie próbnym

set.seed(700)
uz <- data.frame(id = seq_len(n), dzien_instalacji = sample(1:365, n, replace = TRUE),
                 zrodlo = factor(sample(names(udzialy), n, replace = TRUE, prob = udzialy), levels = names(udzialy)),
                 okres_probny = factor(sample(c("7 dni", "14 dni"), n, replace = TRUE), levels = c("7 dni", "14 dni")))
dl <- ifelse(uz$okres_probny == "7 dni", 7, 14)                       # długość okresu próbnego
z  <- as.character(uz$zrodlo)
kupi <- rbinom(n, 1, plogis(qlogis(p_kupi[z]) + efekt_14 * (dl == 14)))   # „kiedyś kupi” – tylko w symulacji
# Czas do zakupu u kupujących: w okresie próbnym (najczęściej pod jego koniec) albo później
w_trakcie <- runif(n) < w_okresie[z]
T_zakup <- ifelse(w_trakcie, pmax(0.2, dl * rbeta(n, 4, 1.3)),
                  dl + rlnorm(n, log(mediana_po[z]), 1.1))
T_zakup[kupi == 0] <- Inf
# Promocja: rabat 40% w dniach 330–336 kalendarza dla osób po okresie próbnym bez zakupu
kal <- uz$dzien_instalacji + T_zakup                                 # dzień kalendarza zakupu
moze <- uz$dzien_instalacji + dl < promocja[1] & kal > promocja[1]
r_dzien <- runif(n, promocja[1], promocja[2])
rabat <- moze & ifelse(kupi == 1, runif(n) < 0.35, runif(n) < 0.025)  # część kupi wcześniej, część tylko z rabatem
kal[rabat] <- r_dzien[rabat]
# Obserwujemy do dnia analizy: później zakup jest nieznany (obserwacja cenzurowana)
uz$czas_dni <- round(pmin(kal, dzien_analizy) - uz$dzien_instalacji, 1)
uz$zakup    <- as.integer(kal <= dzien_analizy)
uz$rabat    <- as.integer(rabat & uz$zakup == 1)
uz$kupilby_kiedys <- kupi                                            # prawda znana tylko w symulacji
write.csv(uz, "okres-probny-aplikacja-medytacja.csv", row.names = FALSE)

# Analiza główna: zakup po cenie regularnej. Użytkowników objętych promocją cenzurujemy w dniu
# jej startu (od tego dnia nie obserwujemy już „zwykłej” konwersji).
uz$cenz_prom <- uz$dzien_instalacji + dl < promocja[1] & uz$dzien_instalacji + uz$czas_dni > promocja[1]
uz$czas <- ifelse(uz$cenz_prom, promocja[1] - uz$dzien_instalacji, uz$czas_dni)
uz$kupil <- ifelse(uz$cenz_prom, 0L, uz$zakup)

# Opis danych
c(instalacji = n, zakupow = sum(uz$zakup), w_tym_z_rabatem = sum(uz$rabat),
  zakupow_po_cenie_regularnej = sum(uz$kupil), mediana_obserwacji_dni = median(uz$czas))
table(uz$zrodlo, uz$okres_probny)
# Prawda z symulacji: odsetek osób, które kiedyś kupią (bez promocji), według źródła i okresu
round(100 * tapply(uz$kupilby_kiedys, list(uz$zrodlo, uz$okres_probny), mean), 1)
round(100 * mean(uz$kupilby_kiedys), 2)
Wynik w R
                 instalacji                     zakupow
                       8000                        1060
            w_tym_z_rabatem zakupow_po_cenie_regularnej
                        172                         861
     mediana_obserwacji_dni
                        123

                      7 dni 14 dni
  sklep z aplikacjami  2035   1998
  reklama              1388   1399
  polecenie             570    610
                    7 dni 14 dni
sklep z aplikacjami  11.6   12.5
reklama               7.3    7.7
polecenie            21.8   23.4
[1] 12.03
2. Obcięcie obserwacji: Rysunek 2
R
# Przepis 2. Obcięcie obserwacji: dlaczego „odsetek kupujących” myli u nowych użytkowników (Rysunek 2)
# Korzysta z obiektów przepisu 1: uz, kol, motyw. Nie losuje.
library(survival)

uz$miesiac <- factor(ceiling(uz$dzien_instalacji / 30.5), levels = 1:12)
# (a) Naiwnie: kupili do dnia analizy / wszyscy zainstalowani w danym miesiącu
naiwnie <- aggregate(cbind(kupil, kupilby_kiedys) ~ miesiac, data = uz, FUN = mean)
# (b) Kaplan–Meier w kohorcie miesiąca: odsetek kupujących w ciągu 30 dni od instalacji
km30 <- do.call(rbind, lapply(split(uz, uz$miesiac), function(d) {
  s <- summary(survfit(Surv(czas, kupil) ~ 1, data = d), times = 30)
  data.frame(miesiac = d$miesiac[1], km30 = 1 - s$surv, dolna = 1 - s$upper, gorna = 1 - s$lower,
             obserwacja_mediana = median(d$czas))
}))
tab <- merge(naiwnie, km30, by = "miesiac")
tab <- tab[order(as.integer(tab$miesiac)), ]; rownames(tab) <- NULL
tab[, c("kupil", "kupilby_kiedys", "km30", "dolna", "gorna")] <- round(100 * tab[, c("kupil", "kupilby_kiedys", "km30", "dolna", "gorna")], 1)
names(tab)[2:3] <- c("naiwnie_proc", "prawda_kiedys_proc")
tab
# Cały rok: odsetek naiwny i prawda z symulacji
round(c(naiwnie = 100 * mean(uz$kupil), prawda_kiedys = 100 * mean(uz$kupilby_kiedys)), 2)

wyk <- rbind(data.frame(miesiac = as.integer(tab$miesiac), proc = tab$naiwnie_proc, dolna = NA, gorna = NA,
                       miara = "naiwnie: kupili do dnia analizy"),
            data.frame(miesiac = as.integer(tab$miesiac), proc = tab$km30, dolna = tab$dolna, gorna = tab$gorna,
                       miara = "Kaplan–Meier: kupili w 30 dni"),
            data.frame(miesiac = as.integer(tab$miesiac), proc = tab$prawda_kiedys_proc, dolna = NA, gorna = NA,
                       miara = "prawda z symulacji: kupią kiedyś"))
wyk$miara <- factor(wyk$miara, levels = unique(wyk$miara))
p2 <- ggplot(wyk, aes(miesiac, proc, colour = miara, shape = miara, linetype = miara)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.25, na.rm = TRUE, linetype = "solid") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_colour_manual(values = c(kol[["rabat"]], "#0072B2", kol[["prawda"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 4), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:12) + coord_cartesian(ylim = c(0, 16)) +
  labs(x = "Miesiąc instalacji (12 = najnowsi użytkownicy)", y = "Kupili wersję premium (%)",
       title = "Najnowsi „kupują rzadziej” tylko dlatego, że mieli mniej czasu") +
  motyw + guides(colour = guide_legend(nrow = 2))
p2   # zapis: ggsave("okres-probny-obciecie-obserwacji.svg", p2, width = 10, height = 5.2)
Wynik w R
   miesiac naiwnie_proc prawda_kiedys_proc km30 dolna gorna obserwacja_mediana
1        1         13.1               13.4  8.4   6.2  10.5             312.00
2        2         11.7               12.0  8.9   6.7  10.9             282.00
3        3          9.7                9.7  6.1   4.1   7.9             252.00
4        4         12.5               12.7  8.6   6.5  10.7             220.00
5        5         11.7               11.8  9.5   7.3  11.7             190.75
6        6          9.6               10.2  7.6   5.6   9.6             161.00
7        7         12.6               13.2  8.8   6.6  10.9             129.00
8        8          9.5               10.4  7.3   5.3   9.3              99.00
9        9         10.6               11.7  8.0   5.9  10.1              69.00
10      10         11.0               14.5 10.2   7.9  12.4              38.00
11      11          8.6               12.8  8.7   6.2  11.0              24.00
12      12          8.3               11.6  8.4   6.2  10.6              28.00
      naiwnie prawda_kiedys
        10.76         12.03
3. Kaplan–Meier według źródła
R
# Przepis 3. Skumulowana konwersja z Kaplana–Meiera według źródła pozyskania: krzywa się wypłaszcza
# Korzysta z obiektów przepisu 1: uz. Nie losuje. Rysunek 3 powstaje w przepisie 4 (razem z modelem).
library(survival)

km <- survfit(Surv(czas, kupil) ~ zrodlo, data = uz)
s <- summary(km, times = c(7, 14, 30, 90, 180, 270), extend = TRUE)
km_tab <- data.frame(zrodlo = sub("zrodlo=", "", s$strata), dzien = s$time, kupilo_proc = 100 * (1 - s$surv),
                     dolna = 100 * (1 - s$upper), gorna = 100 * (1 - s$lower), w_ryzyku = s$n.risk)
km_tab[, 3:5] <- round(km_tab[, 3:5], 1)
km_tab
# Ile zakupów doszło między 180. a ostatnim obserwowanym dniem? (płaski ogon = plateau)
sapply(split(uz, uz$zrodlo), function(d) c(zakupow = sum(d$kupil), po_180_dniu = sum(d$kupil & d$czas > 180),
                                            najdluzsza_obserwacja = max(d$czas)))
survdiff(Surv(czas, kupil) ~ zrodlo, data = uz)   # test log-rank

# Schodki Kaplana–Meiera do rysunku (dzień po dniu)
sk <- summary(km, times = seq(0, 320, by = 1), extend = TRUE)
km_df <- data.frame(zrodlo = factor(sub("zrodlo=", "", sk$strata), levels = levels(uz$zrodlo)), czas = sk$time,
                    proc = 100 * (1 - sk$surv), dolna = 100 * (1 - sk$upper), gorna = 100 * (1 - sk$lower))
Wynik w R
                zrodlo dzien kupilo_proc dolna gorna w_ryzyku
1  sklep z aplikacjami     7         3.4   2.8   3.9     3897
2  sklep z aplikacjami    14         6.8   6.0   7.6     3730
3  sklep z aplikacjami    30         8.9   8.0   9.7     3343
4  sklep z aplikacjami    90        11.2  10.2  12.2     2387
5  sklep z aplikacjami   180        11.8  10.8  12.9     1474
6  sklep z aplikacjami   270        12.1  11.0  13.2      586
7              reklama     7         2.8   2.2   3.4     2709
8              reklama    14         5.5   4.7   6.4     2612
9              reklama    30         6.5   5.6   7.5     2374
10             reklama    90         7.3   6.3   8.2     1664
11             reklama   180         7.5   6.5   8.5     1038
12             reklama   270         7.5   6.5   8.5      432
13           polecenie     7         3.4   2.4   4.4     1140
14           polecenie    14         7.6   6.0   9.1     1083
15           polecenie    30        11.3   9.4  13.1      937
16           polecenie    90        18.4  16.0  20.8      636
17           polecenie   180        20.2  17.6  22.7      397
18           polecenie   270        21.6  18.8  24.3      140
                      sklep z aplikacjami reklama polecenie
zakupow                               447     202       212
po_180_dniu                             4       0         5
najdluzsza_obserwacja                 329     329       329
Call:
survdiff(formula = Surv(czas, kupil) ~ zrodlo, data = uz)

                              N Observed Expected (O-E)^2/E (O-E)^2/V
zrodlo=sklep z aplikacjami 4033      447      434     0.403     0.812
zrodlo=reklama             2787      202      303    33.787    52.179
zrodlo=polecenie           1180      212      124    62.446    72.997

 Chisq= 96.7  on 2 degrees of freedom, p= <2e-16
4. Model frakcji wyleczonych: Rysunki 3 i 4
R
# Przepis 4. Model frakcji wyleczonych (mieszaninowy): udział „nigdy nie kupi” i czas do zakupu
# u pozostałych według źródła i okresu próbnego (Rysunki 3 i 4).
# Korzysta z obiektów przepisów 1 i 3: uz, km_df, p_kupi, efekt_14, kol_zrodla, kol_okres, kol, motyw.
library(survival)
library(flexsurvcure)   # wczytuje też flexsurv
library(MASS)           # mvrnorm() do przedziałów z rozkładu parametrów

# Część „incydencji”: formuła -> theta = P(nigdy nie kupi), łącze logistyczne.
# Część „latencji”: czas do zakupu u kupujących ~ rozkład log-normalny, mediana zależy od źródła i okresu.
cure <- flexsurvcure(Surv(czas, kupil) ~ zrodlo + okres_probny, data = uz, dist = "lnorm",
                     link = "logistic", mixture = TRUE, anc = list(meanlog = ~ zrodlo + okres_probny))
round(cure$res[, 1:3], 3)
# Iloraz szans ZAKUPU (odwrotność ilorazu szans „nigdy nie kupi”) i mnożnik mediany czasu u kupujących
b <- coef(cure); se <- sqrt(diag(vcov(cure)))
inc <- c("zrodloreklama", "zrodlopolecenie", "okres_probny14 dni")
round(data.frame(OR_zakupu = exp(-b[inc]), dolna = exp(-b[inc] - 1.96 * se[inc]), gorna = exp(-b[inc] + 1.96 * se[inc]),
                 mnoznik_mediany = exp(b[paste0("meanlog(", inc, ")")]),
                 m_dolna = exp(b[paste0("meanlog(", inc, ")")] - 1.96 * se[paste0("meanlog(", inc, ")")]),
                 m_gorna = exp(b[paste0("meanlog(", inc, ")")] + 1.96 * se[paste0("meanlog(", inc, ")")])), 2)
# Porównanie rozkładów latencji (te same części incydencji) – AIC
round(sapply(c(lnorm = "lnorm", weibull = "weibull", gengamma = "gengamma"), function(d) {
  a <- switch(d, lnorm = list(meanlog = ~ zrodlo + okres_probny), weibull = list(scale = ~ zrodlo + okres_probny),
              gengamma = list(mu = ~ zrodlo + okres_probny))
  m <- flexsurvcure(Surv(czas, kupil) ~ zrodlo + okres_probny, data = uz, dist = d, anc = a)
  c(AIC = AIC(m), kupi_sklep_7dni_proc = 100 * (1 - m$res["theta", "est"]))
}), 1)

# Odsetek „kiedyś kupi” i mediana dni do zakupu w 6 grupach – 95% przedziały z 4000 losowań parametrów
grupy <- expand.grid(zrodlo = levels(uz$zrodlo), okres_probny = levels(uz$okres_probny))
X <- model.matrix(~ zrodlo + okres_probny, grupy)
set.seed(7004)
los <- mvrnorm(4000, b, vcov(cure))
th <- plogis(los[, c("theta", inc)] %*% t(X))                 # P(nigdy nie kupi) w każdej grupie
md <- exp(los[, c("meanlog", paste0("meanlog(", inc, ")"))] %*% t(X))   # mediana latencji (dni)
pr <- function(m) apply(m, 2, quantile, c(.025, .975))
wyn <- cbind(grupy,
             kupi_proc = 100 * (1 - plogis(drop(X %*% b[c("theta", inc)]))),
             k_dolna = 100 * (1 - pr(th)[2, ]), k_gorna = 100 * (1 - pr(th)[1, ]),
             prawda_proc = 100 * plogis(qlogis(p_kupi[as.character(grupy$zrodlo)]) + efekt_14 * (grupy$okres_probny == "14 dni")),
             mediana_dni = exp(drop(X %*% b[c("meanlog", paste0("meanlog(", inc, ")"))])),
             m_dolna = pr(md)[1, ], m_gorna = pr(md)[2, ])
print(wyn, digits = 3)
# Mediana czasu wśród kupujących widoczna w danych (tylko zakupy do dnia analizy)
aggregate(czas ~ zrodlo + okres_probny, data = uz[uz$kupil == 1, ], FUN = median)

# Rysunek 3: schodki Kaplana–Meiera i krzywe z modelu (średnio z obu długości okresu próbnego)
t_siatka <- c(seq(0.5, 30, by = 0.5), seq(31, 320, by = 1))
pred <- summary(cure, newdata = grupy, t = t_siatka, type = "survival", ci = FALSE, tidy = TRUE)
pred$proc <- 100 * (1 - pred$est)
pred <- aggregate(proc ~ time + zrodlo, data = pred, FUN = mean)
plateau <- aggregate(kupi_proc ~ zrodlo, data = wyn, FUN = mean)
p3 <- ggplot() +
  geom_ribbon(data = km_df, aes(czas, ymin = dolna, ymax = gorna, fill = zrodlo), alpha = 0.15) +
  geom_step(data = km_df, aes(czas, proc, colour = zrodlo), linewidth = 0.8) +
  geom_line(data = pred, aes(time, proc, colour = zrodlo), linetype = "22", linewidth = 0.9) +
  geom_text(data = plateau, aes(x = 322, y = kupi_proc, label = sprintf("%.1f%%", kupi_proc), colour = zrodlo),
            hjust = 0, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = kol_zrodla, name = NULL) + scale_fill_manual(values = kol_zrodla, guide = "none") +
  scale_x_continuous(breaks = c(0, 7, 14, 30, 60, 90, 120, 180, 240, 300), limits = c(0, 345)) +
  labs(x = "Dni od instalacji", y = "Kupili premium (%)",
       title = "Schodki: Kaplan–Meier; kreski: model frakcji wyleczonych (liczby = kupią kiedyś)") + motyw
p3   # zapis: ggsave("okres-probny-kaplan-meier-model.svg", p3, width = 10, height = 5.4)

# Rysunek 4: A – odsetek „kiedyś kupi”, B – mediana dni do zakupu u kupujących
pA <- ggplot(wyn, aes(kupi_proc, zrodlo, colour = okres_probny, shape = okres_probny)) +
  geom_errorbar(aes(xmin = k_dolna, xmax = k_gorna), width = 0.25, linewidth = 0.8, orientation = "y",
                position = position_dodge(width = 0.5)) +
  geom_point(size = 3, position = position_dodge(width = 0.5)) +
  geom_point(aes(x = prawda_proc), shape = 4, size = 2.6, colour = kol[["prawda"]], stroke = 1.1,
             position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = kol_okres, name = "Okres próbny") + scale_shape_manual(values = c(16, 17), name = "Okres próbny") +
  scale_y_discrete(limits = rev(levels(uz$zrodlo))) +
  labs(x = "Kupi kiedyś (%), 95% CI; × = prawda", y = NULL, title = "A. Ilu kiedyś kupi") + motyw
pB <- ggplot(wyn, aes(mediana_dni, zrodlo, colour = okres_probny, shape = okres_probny)) +
  geom_errorbar(aes(xmin = m_dolna, xmax = m_gorna), width = 0.25, linewidth = 0.8, orientation = "y",
                position = position_dodge(width = 0.5)) +
  geom_point(size = 3, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = kol_okres, name = "Okres próbny") + scale_shape_manual(values = c(16, 17), name = "Okres próbny") +
  scale_y_discrete(limits = rev(levels(uz$zrodlo))) +
  labs(x = "Mediana dni do zakupu, 95% CI", y = NULL, title = "B. Jak szybko kupują") +
  motyw + theme(axis.text.y = element_blank())
p4 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("okres-probny-frakcja-i-czas.svg", p4, width = 10, height = 4.8)
Wynik w R
                               est   L95%   U95%
theta                        0.887  0.874  0.899
meanlog                      2.474  2.358  2.589
sdlog                        0.948  0.899  1.000
zrodloreklama                0.495  0.320  0.671
zrodlopolecenie             -0.664 -0.849 -0.479
okres_probny14 dni          -0.113 -0.258  0.032
meanlog(zrodloreklama)      -0.310 -0.475 -0.145
meanlog(zrodlopolecenie)     0.480  0.314  0.645
meanlog(okres_probny14 dni)  0.489  0.355  0.623
                   OR_zakupu dolna gorna mnoznik_mediany m_dolna m_gorna
zrodloreklama           0.61  0.51  0.73            0.73    0.62    0.86
zrodlopolecenie         1.94  1.61  2.34            1.62    1.37    1.91
okres_probny14 dni      1.12  0.97  1.29            1.63    1.43    1.86
                       lnorm weibull gengamma
AIC                  12111.5 12361.5  11875.3
kupi_sklep_7dni_proc    11.3    11.6     12.0
               zrodlo okres_probny kupi_proc k_dolna k_gorna prawda_proc
1 sklep z aplikacjami        7 dni     11.29   10.10   12.56       12.00
2             reklama        7 dni      7.20    6.21    8.32        7.00
3           polecenie        7 dni     19.82   17.18   22.79       22.00
4 sklep z aplikacjami       14 dni     12.47   11.16   13.89       13.10
5             reklama       14 dni      7.99    6.88    9.27        7.68
6           polecenie       14 dni     21.68   18.83   24.72       23.76
  mediana_dni m_dolna m_gorna
1        11.9   10.58    13.3
2         8.7    7.51    10.2
3        19.2   16.52    22.4
4        19.3   17.22    21.6
5        14.2   12.23    16.6
6        31.3   26.74    36.5
               zrodlo okres_probny  czas
1 sklep z aplikacjami        7 dni  6.30
2             reklama        7 dni  6.00
3           polecenie        7 dni 21.00
4 sklep z aplikacjami       14 dni 12.95
5             reklama       14 dni 11.90
6           polecenie       14 dni 20.30
5. Regresja logistyczna „kupił w 30 dni”: Rysunek 5
R
# Przepis 5. Regresja logistyczna „kupił w 30 dni” a model frakcji wyleczonych (Rysunek 5)
# Korzysta z obiektów przepisów 1 i 4: uz, cure, b, se, inc, p_kupi, efekt_14, kol, motyw. Nie losuje.

# Do regresji logistycznej nadają się tylko osoby obserwowane co najmniej 30 dni (albo z zakupem wcześniej)
d30 <- uz[uz$czas >= 30 | uz$kupil == 1, ]
d30$kupil30 <- as.integer(d30$kupil == 1 & d30$czas <= 30)
c(w_analizie = nrow(d30), wykluczeni_krotka_obserwacja = nrow(uz) - nrow(d30), kupilo_w_30_dni = sum(d30$kupil30))
logit30 <- glm(kupil30 ~ zrodlo + okres_probny, family = binomial, data = d30)
round(cbind(OR = exp(coef(logit30)), exp(confint.default(logit30))), 2)

# Zestawienie: OR z regresji „w 30 dni”, OR zakupu „kiedyś” z modelu frakcji i prawdziwy OR z symulacji
odds <- function(p) p / (1 - p)
prawda <- c(odds(p_kupi[["reklama"]]) / odds(p_kupi[["sklep z aplikacjami"]]),
            odds(p_kupi[["polecenie"]]) / odds(p_kupi[["sklep z aplikacjami"]]), exp(efekt_14))
porown <- rbind(
  data.frame(efekt = inc, model = "regresja logistyczna: kupił w 30 dni", OR = exp(coef(logit30)[inc]),
             dolna = exp(confint.default(logit30)[inc, 1]), gorna = exp(confint.default(logit30)[inc, 2])),
  data.frame(efekt = inc, model = "model frakcji: kupi kiedyś", OR = exp(-b[inc]),
             dolna = exp(-b[inc] - 1.96 * se[inc]), gorna = exp(-b[inc] + 1.96 * se[inc])),
  data.frame(efekt = inc, model = "prawda z symulacji", OR = prawda, dolna = NA, gorna = NA))
porown$efekt <- factor(porown$efekt, levels = rev(inc),
                       labels = rev(c("reklama vs sklep z aplikacjami", "polecenie vs sklep z aplikacjami", "14 vs 7 dni okresu próbnego")))
porown$model <- factor(porown$model, levels = unique(porown$model))
rownames(porown) <- NULL
print(porown, digits = 3)

p5 <- ggplot(porown, aes(OR, efekt, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.8, orientation = "y",
                position = position_dodge(width = 0.6), na.rm = TRUE) +
  geom_point(size = 3, position = position_dodge(width = 0.6), stroke = 1.1) +
  geom_text(aes(label = sprintf("%.2f", OR)), position = position_dodge(width = 0.6), vjust = -0.9, size = 3.3,
            show.legend = FALSE) +
  scale_x_log10(breaks = c(0.5, 0.75, 1, 1.5, 2, 3)) +
  scale_colour_manual(values = c("#E69F00", kol[["model"]], kol[["prawda"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16, 4), name = NULL) +
  labs(x = "Iloraz szans zakupu (skala logarytmiczna), 95% CI", y = NULL,
       title = "„Kupił w 30 dni” miesza dwa pytania: czy kupi i jak szybko") +
  motyw + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p5   # zapis: ggsave("okres-probny-logistyczna-a-model-frakcji.svg", p5, width = 10, height = 5.2)
Wynik w R
                  w_analizie wykluczeni_krotka_obserwacja
                        7317                          683
             kupilo_w_30_dni
                         663
                     OR 2.5 % 97.5 %
(Intercept)        0.10  0.09   0.12
zrodloreklama      0.72  0.60   0.87
zrodlopolecenie    1.32  1.06   1.63
okres_probny14 dni 1.05  0.89   1.23
                             efekt                                model    OR
1   reklama vs sklep z aplikacjami regresja logistyczna: kupił w 30 dni 0.724
2 polecenie vs sklep z aplikacjami regresja logistyczna: kupił w 30 dni 1.317
3      14 vs 7 dni okresu próbnego regresja logistyczna: kupił w 30 dni 1.049
4   reklama vs sklep z aplikacjami           model frakcji: kupi kiedyś 0.609
5 polecenie vs sklep z aplikacjami           model frakcji: kupi kiedyś 1.942
6      14 vs 7 dni okresu próbnego           model frakcji: kupi kiedyś 1.120
7   reklama vs sklep z aplikacjami                   prawda z symulacji 0.552
8 polecenie vs sklep z aplikacjami                   prawda z symulacji 2.068
9      14 vs 7 dni okresu próbnego                   prawda z symulacji 1.105
  dolna gorna
1 0.601 0.873
2 1.063 1.630
3 0.894 1.231
4 0.511 0.726
5 1.614 2.336
6 0.969 1.295
7    NA    NA
8    NA    NA
9    NA    NA
6. Eksperyment 7 vs 14 dni: Rysunek 6
R
# Przepis 6. Eksperyment: okres próbny 7 vs 14 dni – różnica frakcji kupujących i czasu (Rysunek 6)
# Korzysta z obiektów przepisów 1 i 4: uz, cure, b, los, inc, kol_okres, motyw. Nie losuje.
library(survival)

km_o <- survfit(Surv(czas, kupil) ~ okres_probny, data = uz)
# (a) Skumulowana konwersja w ustalonych dniach i różnica 14 − 7 dni z 95% CI (błędy z Kaplana–Meiera)
dni <- c(7, 14, 30, 90, 180)
s <- summary(km_o, times = dni, extend = TRUE)
k7 <- s$strata == "okres_probny=7 dni"; k14 <- !k7
roz <- data.frame(dzien = dni, proc_7 = 100 * (1 - s$surv[k7]), proc_14 = 100 * (1 - s$surv[k14]))
roz$roznica_pp <- roz$proc_14 - roz$proc_7
roz$se <- 100 * sqrt(s$std.err[k7]^2 + s$std.err[k14]^2)
roz$dolna <- roz$roznica_pp - 1.96 * roz$se; roz$gorna <- roz$roznica_pp + 1.96 * roz$se
round(roz, 2)

# (b) Model frakcji: odsetek „kupi kiedyś” średnio w próbie (przy rozkładzie źródeł z danych),
#     gdyby wszyscy dostali 7 albo 14 dni; mediana czasu u kupujących (sklep z aplikacjami)
X7  <- model.matrix(~ zrodlo + okres_probny, transform(uz, okres_probny = factor("7 dni", levels(uz$okres_probny))))
X14 <- model.matrix(~ zrodlo + okres_probny, transform(uz, okres_probny = factor("14 dni", levels(uz$okres_probny))))
srednio <- function(beta, X) mean(1 - plogis(X %*% beta))
inc_k <- c("theta", inc)
kiedys <- c(dni_7 = srednio(b[inc_k], X7), dni_14 = srednio(b[inc_k], X14))
los_r <- apply(los[, inc_k], 1, function(bb) srednio(bb, X14) - srednio(bb, X7))
round(100 * c(kiedys, roznica = diff(kiedys), dolna = quantile(los_r, .025), gorna = quantile(los_r, .975)), 2)
mn <- "meanlog(okres_probny14 dni)"
round(c(mediana_7 = exp(b[["meanlog"]]), mediana_14 = exp(b[["meanlog"]] + b[[mn]]),
        mnoznik = exp(b[[mn]]), dolna = exp(b[[mn]] - 1.96 * sqrt(vcov(cure)[mn, mn])),
        gorna = exp(b[[mn]] + 1.96 * sqrt(vcov(cure)[mn, mn]))), 2)

# Rysunek 6: A – skumulowana konwersja w pierwszych 120 dniach, B – różnica 14 − 7 dni w czasie
sk <- summary(km_o, times = seq(0, 120, by = 0.5), extend = TRUE)
kr <- data.frame(okres = factor(sub("okres_probny=", "", sk$strata), levels = levels(uz$okres_probny)),
                 czas = sk$time, proc = 100 * (1 - sk$surv), dolna = 100 * (1 - sk$upper), gorna = 100 * (1 - sk$lower))
pA <- ggplot(kr, aes(czas, proc, colour = okres)) +
  geom_vline(xintercept = c(7, 14), colour = "grey60", linetype = "dotted") +
  geom_ribbon(aes(ymin = dolna, ymax = gorna, fill = okres), colour = NA, alpha = 0.2) +
  geom_step(aes(linetype = okres), linewidth = 0.9) +
  scale_colour_manual(values = kol_okres, name = "Okres próbny") + scale_fill_manual(values = kol_okres, guide = "none") +
  scale_linetype_manual(values = c("solid", "longdash"), name = "Okres próbny") +
  scale_x_continuous(breaks = c(0, 7, 14, 30, 60, 90, 120)) +
  labs(x = "Dni od instalacji", y = "Kupili premium (%)", title = "A. Skumulowana konwersja") + motyw
pB <- ggplot(roz, aes(factor(dzien), roznica_pp)) +
  geom_hline(yintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.12, linewidth = 0.8, colour = "#0f1d3a") +
  geom_point(size = 3, colour = "#0f1d3a") +
  geom_text(aes(label = sprintf("%+.1f", roznica_pp)), hjust = 0, nudge_x = 0.16, size = 3.4, colour = "grey20") +
  labs(x = "Dzień od instalacji", y = "Różnica 14 − 7 dni (pp), 95% CI", title = "B. Różnica w kolejnych dniach") + motyw
p6 <- pA + pB + plot_layout(widths = c(1.3, 1))
p6   # zapis: ggsave("okres-probny-7-czy-14-dni.svg", p6, width = 10, height = 4.8)
Wynik w R
  dzien proc_7 proc_14 roznica_pp   se dolna gorna
1     7   5.91    0.45      -5.46 0.39 -6.22 -4.70
2    14   6.39    6.51       0.12 0.55 -0.96  1.20
3    30   8.15    8.63       0.49 0.62 -0.74  1.71
4    90  10.58   11.21       0.63 0.72 -0.79  2.05
5   180  11.14   11.95       0.81 0.76 -0.67  2.29
         dni_7         dni_14 roznica.dni_14     dolna.2.5%    gorna.97.5%
         11.12          12.27           1.15          -0.34           2.62
 mediana_7 mediana_14    mnoznik      dolna      gorna
     11.87      19.35       1.63       1.43       1.86
7. Zakupy po rabacie
R
# Przepis 7. Zakupy po rabacie: co się stanie, gdy wrzucimy je do jednego worka z zakupami po cenie regularnej
# Korzysta z obiektów przepisów 1 i 4: uz, cure, b, inc. Nie losuje.
library(flexsurvcure)

# Ile zakupów było z rabatem i ilu z tych kupujących nie kupiłoby nigdy bez promocji (prawda z symulacji)?
c(zakupow = sum(uz$zakup), z_rabatem = sum(uz$rabat), proc_z_rabatem = round(100 * mean(uz$rabat[uz$zakup == 1]), 1),
  rabat_nigdy_by_nie_kupili = sum(uz$rabat == 1 & uz$kupilby_kiedys == 0))
# Model, w którym zakup z rabatem liczy się jak każdy inny (czas do dowolnego zakupu)
cure_wszystkie <- flexsurvcure(Surv(czas_dni, zakup) ~ zrodlo + okres_probny, data = uz, dist = "lnorm",
                               anc = list(meanlog = ~ zrodlo + okres_probny))
X <- model.matrix(~ zrodlo + okres_probny, uz)
kiedys <- function(m) 100 * mean(1 - plogis(X %*% coef(m)[c("theta", inc)]))
round(c(prawda_bez_promocji = 100 * mean(uz$kupilby_kiedys), model_cena_regularna = kiedys(cure),
        model_wszystkie_zakupy = kiedys(cure_wszystkie)), 2)
Wynik w R
                  zakupow                 z_rabatem            proc_z_rabatem
                   1060.0                     172.0                      16.2
rabat_nigdy_by_nie_kupili
                    148.0
   prawda_bez_promocji   model_cena_regularna model_wszystkie_zakupy
                 12.03                  11.70                  15.54
8. Grafika „dwie grupy w jednej krzywej”: Rysunek 1
R
# Przepis 8. Grafika „dwie grupy w jednej krzywej” (Rysunek 1) – liczby z modelu z przepisu 4
# Korzysta z obiektów przepisów 1 i 4: uz, cure, b, inc, kol_zrodla, kol. Nie losuje.
X <- model.matrix(~ zrodlo + okres_probny, uz)
kupi <- mean(1 - plogis(X %*% b[c("theta", inc)]))          # średni odsetek „kupi kiedyś” w próbie
na100 <- round(100 * kupi)
med <- exp(b[["meanlog"]]); sdl <- exp(b[["sdlog"]])           # latencja: sklep z aplikacjami, 7 dni
round(c(kupi_kiedys_proc = 100 * kupi, na_100_osob = na100, mediana_latencji_dni = med), 2)

# 100 osób jako kropki 10 × 10: pierwsze na100 to przyszli kupujący
kropki <- data.frame(x = rep(1:10, 10), y = rep(10:1, each = 10))
kropki$grupa <- ifelse(seq_len(100) <= na100, "kupi kiedyś", "nigdy nie kupi")
kropki <- transform(kropki, x = 2 + x * 2.2, y = 12 + y * 3.6)

# Małe krzywe w ramkach (oś czasu 0–120 dni przeskalowana do szerokości ramki)
t <- seq(0, 120, by = 1)
F_u <- plnorm(pmax(t, 0.01), log(med), sdl)                     # u kupujących: kiedyś kupią wszyscy
ramka <- function(x0, x1, y0, y1, wys) data.frame(x = x0 + (x1 - x0) * t / 120, y = y0 + (y1 - y0) * wys)
k_kupi <- ramka(38, 60, 35, 48, F_u)
k_nigdy <- ramka(38, 60, 7, 18, 0 * t)
k_suma <- ramka(74, 98, 14, 44, kupi * F_u / 0.25)               # oś Y krzywej łącznej: 0–25%
ramki <- data.frame(x0 = c(35, 35, 70), x1 = c(63, 63, 100), y0 = c(30, 2, 8), y1 = c(58, 28, 58),
                    wyp = c("kupi", "nigdy", "suma"))
tekst <- data.frame(
  x = c(15, 49, 49, 85, 49, 49, 85, 85, 98),
  y = c(55, 55.5, 25.5, 55.5, 52, 22, 52, 4.5, 14 + 30 * kupi / 0.25 + 2.6),
  lab = c("100 nowych użytkowników",
          sprintf("Kupią kiedyś: ok. %d na 100", na100), sprintf("Nigdy nie kupią: ok. %d na 100", 100 - na100),
          "To widzisz w danych", "u nich zakup kiedyś na pewno", "tu krzywa stoi na zerze",
          "Kaplan–Meier: kupili do dnia t", sprintf("S(t) = π + (1 − π)·S_u(t),  π ≈ %.2f", 1 - kupi),
          sprintf("plateau ≈ %.0f%%", 100 * kupi)),
  font = c(2, 2, 2, 2, 1, 1, 1, 1, 2), size = c(4.2, 4, 4, 4.2, 3.4, 3.4, 3.4, 3.6, 3.4),
  hjust = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 1))
p8 <- ggplot() +
  geom_rect(data = ramki, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1, fill = wyp), colour = "grey40", linewidth = 0.4) +
  scale_fill_manual(values = c(kupi = "#E6F4EE", nigdy = "grey94", suma = "#E8F1F8"), guide = "none") +
  geom_point(data = kropki, aes(x, y, colour = grupa, shape = grupa), size = 3.2) +
  scale_colour_manual(values = c("kupi kiedyś" = kol_zrodla[["polecenie"]], "nigdy nie kupi" = "grey65"), name = NULL) +
  scale_shape_manual(values = c("kupi kiedyś" = 17, "nigdy nie kupi" = 16), name = NULL) +
  geom_segment(aes(x = 27, y = c(36, 30), xend = 34, yend = c(43, 15)), arrow = arrow(length = unit(0.2, "cm")),
               colour = "grey35", linewidth = 0.6) +
  geom_segment(aes(x = 63.5, y = c(43, 15), xend = 69.5, yend = c(33, 27)), arrow = arrow(length = unit(0.2, "cm")),
               colour = "grey35", linewidth = 0.6) +
  geom_line(data = k_kupi, aes(x, y), colour = kol_zrodla[["polecenie"]], linewidth = 1.1) +
  geom_line(data = k_nigdy, aes(x, y), colour = "grey45", linewidth = 1.1) +
  geom_line(data = k_suma, aes(x, y), colour = "#0f1d3a", linewidth = 1.1) +
  geom_segment(aes(x = c(38, 74), y = c(35, 14), xend = c(60, 98), yend = c(35, 14)), colour = "grey55", linewidth = 0.3) +
  geom_text(data = tekst, aes(x, y, label = lab, fontface = font, size = size, hjust = hjust), colour = "#0f1d3a") +
  scale_size_identity() +
  annotate("text", x = c(38, 60, 38, 60, 74, 98), y = c(32.6, 32.6, 4.6, 4.6, 11.6, 11.6),
           label = c("0", "120 dni", "0", "120 dni", "0", "120 dni"),
           size = 3, colour = "grey35") +
  coord_cartesian(xlim = c(0, 100), ylim = c(0, 60), expand = FALSE, clip = "off") +
  labs(title = "Dwie grupy w jednej krzywej konwersji", x = NULL, y = NULL) +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p8   # zapis: ggsave("okres-probny-schemat-dwie-grupy.svg", p8, width = 10, height = 5.6)
Wynik w R
    kupi_kiedys_proc          na_100_osob mediana_latencji_dni
               11.70                12.00                11.87
9. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Przepis 9. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("sklep z aplikacjami – reklama" = c("#0072B2", "#D55E00"), "sklep z aplikacjami – polecenie" = c("#0072B2", "#009E73"),
             "reklama – polecenie" = c("#D55E00", "#009E73"), "7 dni – 14 dni" = c("#E69F00", "#56B4E9"),
             "model – prawda" = c("#0f1d3a", "#CC79A7"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
sklep z aplikacjami – reklama              114.6        108.3       91.9
sklep z aplikacjami – polecenie             70.1         55.4       58.0
reklama – polecenie                        102.4         53.5       37.3
7 dni – 14 dni                             113.1        111.4      101.5
model – prawda                              60.7         54.4       45.7
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie i regresja logistyczna – pakiety base i stats; Kaplan–Meier i log-rank – pakiet survival; model frakcji wyleczonych – pakiety flexsurvcure i flexsurv; losowanie parametrów – pakiet MASS). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- flexsurv (wersja 2.3.2): Jackson, C. (2016). flexsurv: A platform for parametric survival modeling in R. Journal of Statistical Software, 70(8), 1–33. https://doi.org/10.18637/jss.v070.i08
- flexsurvcure (wersja 1.3.3): Amdahl, J. (2025). flexsurvcure: Flexible parametric cure models (R package version 1.3.3) [Computer software]. https://doi.org/10.32614/CRAN.package.flexsurvcure
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Kupili do dziś / zainstalowali” według miesiąca. Najnowsi mieli mniej czasu – to obcięcie obserwacji, nie gorszy ruch.
- Plateau z kilku osób w ryzyku. Obserwacja musi być wyraźnie dłuższa niż typowy czas do zakupu.
- Jeden iloraz szans „w 30 dni” zamiast dwóch pytań: czy kupi i kiedy.
- Odczyt eksperymentu w trakcie okresu próbnego. W 7. dniu 14 dni „przegrywa” o 5.5 pp.
- Zakupy po rabacie liczone jak zwykłe. Plateau rośnie z 11.70% do 15.54%.
- Różnice między źródłami czytane jako efekt kanału. Źródła nie losowano – polecenie przyciąga innych ludzi. To ten sam błąd selekcji co we wpisie pozycja w wynikach wyszukiwania a klikalność.
- Ekstrapolacja daleko poza dane. „Kupi kiedyś” znaczy „w horyzoncie podobnym do obserwowanego”. Gdy model jest niepewny, porównaj grupy w ustalonym horyzoncie, np. RMST.
Najczęstsze pytania
Jak policzyć konwersję z okresu próbnego, gdy część użytkowników dopiero się zarejestrowała?
Potraktuj ją jako czas od instalacji do zakupu i użyj estymatora Kaplana–Meiera: osoby bez zakupu są obserwacjami cenzurowanymi w dniu analizy. Odsetek „kupili do dziś / wszyscy” zaniża konwersję nowych kohort – w przykładzie w ostatnim miesiącu 8.3% przy prawdziwych 11.6%. Porównuj kohorty w stałym oknie, np. 30 dni.
Co to jest model frakcji wyleczonych w marketingu?
To model przeżycia, w którym część osób nigdy nie doświadczy zdarzenia – tu nie kupi wersji płatnej. Ma dwie części: regresję logistyczną dla tego, czy ktoś kiedyś kupi, i model czasu do zakupu u przyszłych kupujących. Sygnałem jest plateau krzywej Kaplana–Meiera przy długiej obserwacji.
Czy wystarczy regresja logistyczna „kupił w 30 dni”?
Odpowiada na węższe pytanie: ilu kupi w miesiącu. Miesza udział kupujących z tempem zakupu i zależy od wybranego okna. W przykładzie dała dla polecenia OR = 1.32, a model frakcji 1.94 przy prawdziwym 2.07, bo polecający kupują często po 30. dniu.
Jak sprawdzić, czy dłuższy okres próbny zwiększa sprzedaż?
Losuj długość okresu przy instalacji i porównaj grupy dopiero wtedy, gdy oba okresy się skończą, najlepiej w kilku horyzontach i z modelem frakcji. W przykładzie 14 dni zamiast 7 wydłużyło medianę czasu do zakupu z 11.87 do 19.35 dnia, a odsetek kupujących zmienił się o +1.15 pp (95% CI [−0.34, 2.62]).
Jak traktować zakupy po rabacie w analizie konwersji?
Osobno. Promocja przyspiesza zakupy części klientów i ściąga osoby, które bez rabatu by nie kupiły. W przykładzie wliczenie zakupów z rabatem podniosło szacowany odsetek kupujących kiedyś z 11.70% do 15.54%. W analizie głównej cenzuruj objętych promocją w dniu jej startu albo analizuj rabat jako osobne zdarzenie.
Powiązane hasła
Przeczytaj też
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →PoradnikRabat na pierwszy miesiąc a rezygnacje
Konwersja rośnie, a co z retencją? Test A/B rabatu, Kaplan–Meier, Cox z resztami Schoenfelda i marża na odwiedzającego z bootstrapu – z kodem R.
Czytaj →Analizujesz konwersję z okresu próbnego albo piszesz o niej pracę?
Pomożemy przygotować dane z cenzurowaniem, dopasować krzywe Kaplana–Meiera i model frakcji wyleczonych oraz opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amico, M., & Van Keilegom, I. (2018). Cure models in survival analysis. Annual Review of Statistics and Its Application, 5(1), 311–342. https://doi.org/10.1146/annurev-statistics-031017-100101 ● Otwarty dostęp: pełny tekst
- Berkson, J., & Gage, R. P. (1952). Survival curve for cancer patients following treatment. Journal of the American Statistical Association, 47(259), 501–515. https://doi.org/10.1080/01621459.1952.10501187
- Datta, H., Foubert, B., & Van Heerde, H. J. (2015). The challenge of retaining customers acquired with free trials. Journal of Marketing Research, 52(2), 217–234. https://doi.org/10.1509/jmr.12.0160 ● Otwarty dostęp: pełny tekst
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Sy, J. P., & Taylor, J. M. G. (2000). Estimation in a Cox proportional hazards cure model. Biometrics, 56(1), 227–236. https://doi.org/10.1111/j.0006-341x.2000.00227.x ● Otwarty dostęp: pełny tekst
- Yoganarasimhan, H., Barzegary, E., & Pani, A. (2023). Design and evaluation of optimal free trials. Management Science, 69(6), 3220–3240. https://doi.org/10.1287/mnsc.2022.4507 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{amico2018cure, author={Amico, Maïlis and Van Keilegom, Ingrid}, title={{Cure models in survival analysis}}, journal={Annual Review of Statistics and Its Application}, year={2018}, volume={5}, number={1}, pages={311--342}, doi={10.1146/annurev-statistics-031017-100101}}@article{berkson1952survival, author={Berkson, Joseph and Gage, Robert P.}, title={{Survival curve for cancer patients following treatment}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={259}, pages={501--515}, doi={10.1080/01621459.1952.10501187}}@article{datta2015challenge, author={Datta, Hannes and Foubert, Bram and Van Heerde, Harald J.}, title={{The challenge of retaining customers acquired with free trials}}, journal={Journal of Marketing Research}, year={2015}, volume={52}, number={2}, pages={217--234}, doi={10.1509/jmr.12.0160}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{sy2000estimation, author={Sy, Judy P. and Taylor, Jeremy M. G.}, title={{Estimation in a Cox proportional hazards cure model}}, journal={Biometrics}, year={2000}, volume={56}, number={1}, pages={227--236}, doi={10.1111/j.0006-341x.2000.00227.x}}@article{yoganarasimhan2023design, author={Yoganarasimhan, Hema and Barzegary, Ebrahim and Pani, Abhishek}, title={{Design and evaluation of optimal free trials}}, journal={Management Science}, year={2023}, volume={69}, number={6}, pages={3220--3240}, doi={10.1287/mnsc.2022.4507}}