Co to jest rozkład lognormalny?
Rozkład lognormalny (ang. log-normal distribution, też: logarytmiczno-normalny) to rozkład dodatniej zmiennej X, której logarytm naturalny ln X ma rozkład normalny ze średnią μ i odchyleniem standardowym σ. Powstaje, gdy wiele czynników działa mnożąco, a nie addytywnie. Tak często zachowują się czasy reakcji, dochody, stężenia substancji we krwi czy czas powrotu do zdrowia.
Wzór, średnia i wariancja
- Mediana wynosi eμ i jest równa średniej geometrycznej.
- Średnia wynosi eμ + σ²/2, więc zawsze przewyższa medianę.
- Wariancja wynosi (eσ² − 1)·e2μ + σ² i rośnie razem ze średnią.
- Skośność jest prawostronna i tym większa, im większe σ.
Przykład w R
Przyjmijmy czasy reakcji, których logarytm ma średnią ln 600 i odchylenie standardowe 0.3. Mediana rozkładu wynosi 600 ms, średnia 627.6 ms, a SD 192.6 ms. W 1000 obserwacjach z rlnorm() średnia wyniosła 633.6 ms, mediana 600.4 ms, a średnia geometryczna 605.0 ms. Skośność surowych czasów to 0.80, a po logarytmowaniu −0.07.
Logarytmowanie zamienia więc rozkład lognormalny w normalny, co opisuje hasło transformacja logarytmiczna; ogólniejszą rodziną przekształceń jest transformacja Boxa–Coxa. Limpert, Stahel i Abbt (2001) zauważają, że rozkład normalny przyjmuje się zwykle bez sprawdzenia, także dla wielkości o rozkładzie skośnym. Feng i in. (2013) opisują częste błędy w interpretacji analiz na danych zlogarytmowanych. Lo i Andrews (2015) pokazują, że w czasach reakcji transformacja może zmienić wnioski, i proponują uogólnione modele mieszane bez przekształcania danych.
Na rysunku
Rysunek 1 pokazuje 1000 czasów reakcji z przykładu wyżej (to samo ziarno 4841) w dwóch skalach. Rysunek 2 nie losuje niczego – pokazuje ze wzorów, jak rozjeżdżają się średnia, mediana i moda, gdy rośnie σ.
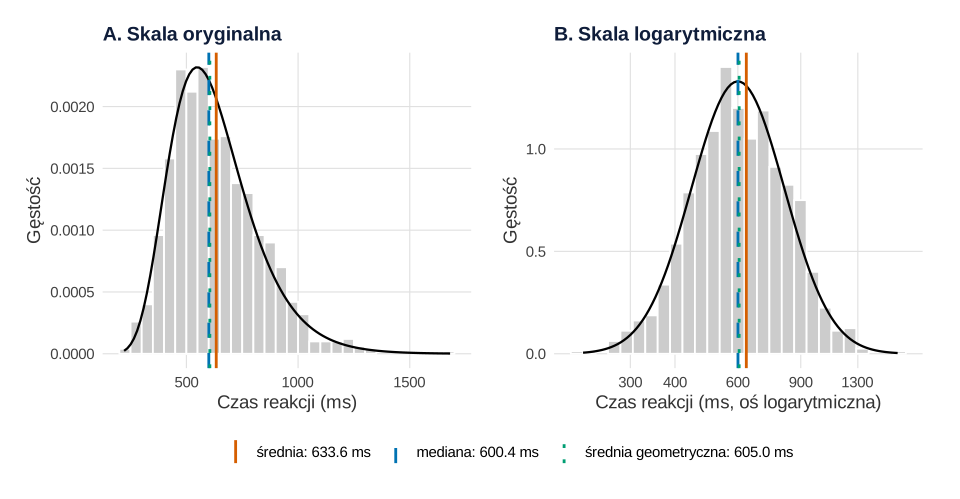
set.seed(4841)).Co widać. W milisekundach rozkład ma długi prawy ogon, a średnia (633.6 ms) leży na prawo od mediany (600.4 ms) i średniej geometrycznej (605.0 ms). Po logarytmowaniu ten sam histogram staje się symetryczny i pokrywa się z krzywą normalną; średnia logarytmów przeliczona z powrotem na milisekundy to właśnie średnia geometryczna.
Na co uważać. Przy σ = 0.3 trzy miary różnią się o kilka procent, więc na oko łatwo uznać rozkład za „prawie normalny”. Sam histogram nie odróżni też rozkładu lognormalnego od rozkładu gamma o podobnej skośności.
Podpis do pracy:
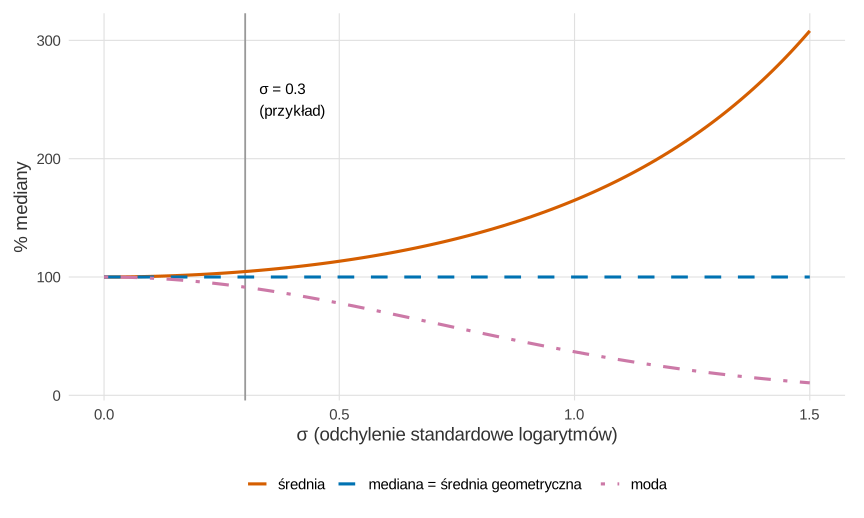
Co widać. Mediana (równa średniej geometrycznej) to eμ, a średnia to eμ + σ²/2, więc ich stosunek zależy tylko od σ. Przy σ = 0.3 średnia przewyższa medianę o 4.6%, przy σ = 0.5 o 13.3%, a przy σ = 1 o 64.9%; moda spada wtedy do 36.8% mediany.
Na co uważać. Krzywe opisują rozkład w populacji. W małej próbie z dużym σ średnia arytmetyczna mocno zależy od kilku najdłuższych czasów.
Podpis do pracy:
Na stronie rysunki mają motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej. Szerokości przedziałów histogramów (50 ms i 0.08 w skali logarytmu) dobrano ręcznie; ziarna nie zmieniano.
Kod R rysunków 1 i 2
# Rysunki 1–2: rozkład lognormalny w skali oryginalnej i po logarytmie; średnia, mediana, moda a σ
library(ggplot2)
library(patchwork)
kol <- c(srednia = "#D55E00", mediana = "#0072B2", geom = "#009E73")    # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1. 1000 czasów reakcji z przykładu (to samo ziarno): ln(czasu) ~ N(ln 600, 0.3)
mu <- log(600); sigma <- 0.3
set.seed(4841)
x <- rlnorm(1000, meanlog = mu, sdlog = sigma)
miary <- data.frame(miara = factor(c("średnia", "mediana", "średnia geometryczna"),
                                   levels = c("średnia", "mediana", "średnia geometryczna")),
                    wartosc = c(mean(x), median(x), exp(mean(log(x)))))
miary$wartosc <- round(miary$wartosc, 1)
miary
etykiety <- paste0(miary$miara, ": ", formatC(miary$wartosc, format = "f", digits = 1), " ms")
linie <- list(geom_vline(data = miary, aes(xintercept = wartosc, colour = miara, linetype = miara),
                         linewidth = 1),
              scale_colour_manual(values = unname(kol), name = NULL, labels = etykiety),
              scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL, labels = etykiety))
p1a <- ggplot(data.frame(x), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 50, boundary = 0,
                 fill = "grey80", colour = "white") +
  stat_function(fun = dlnorm, args = list(meanlog = mu, sdlog = sigma), linewidth = 0.8) +
  linie + labs(title = "A. Skala oryginalna", x = "Czas reakcji (ms)", y = "Gęstość") + motyw
p1b <- ggplot(data.frame(x), aes(log(x))) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.08, fill = "grey80", colour = "white") +
  stat_function(fun = dnorm, args = list(mean = mu, sd = sigma), linewidth = 0.8) +
  geom_vline(data = miary, aes(xintercept = log(wartosc), colour = miara, linetype = miara),
             linewidth = 1) +
  linie[2:3] +
  scale_x_continuous(breaks = log(c(300, 400, 600, 900, 1300)), labels = c(300, 400, 600, 900, 1300)) +
  labs(title = "B. Skala logarytmiczna", x = "Czas reakcji (ms, oś logarytmiczna)", y = "Gęstość") + motyw
p1 <- p1a + p1b + plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Rysunek 2. Średnia, mediana (= średnia geometryczna) i moda jako % mediany w funkcji σ (wzory, bez losowania)
s <- seq(0, 1.5, by = 0.01)
krzywe <- rbind(data.frame(sigma = s, proc = 100 * exp(s^2 / 2), miara = "średnia"),
                data.frame(sigma = s, proc = 100, miara = "mediana = średnia geometryczna"),
                data.frame(sigma = s, proc = 100 * exp(-s^2), miara = "moda"))
krzywe$miara <- factor(krzywe$miara, levels = c("średnia", "mediana = średnia geometryczna", "moda"))
round(sapply(c(sigma_0.3 = 0.3, sigma_0.5 = 0.5, sigma_1 = 1),
             function(v) c(srednia = 100 * exp(v^2 / 2), moda = 100 * exp(-v^2))), 1)
p2 <- ggplot(krzywe, aes(sigma, proc, colour = miara, linetype = miara)) +
  geom_vline(xintercept = sigma, colour = "grey60") +
  annotate("text", x = sigma + 0.03, y = 250, label = "σ = 0.3\n(przykład)", hjust = 0, size = 4) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = c("#D55E00", "#0072B2", "#CC79A7"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  labs(x = "σ (odchylenie standardowe logarytmów)", y = "% mediany") + motyw
p1
p2
Wynik w R
                 miara wartosc
1              średnia   633.6
2              mediana   600.4
3 średnia geometryczna   605.0
        sigma_0.3 sigma_0.5 sigma_1
srednia     104.6     113.3   164.9
moda         91.4      77.9    36.8
Jak opisać w pracy
Na co uważać
- Odwrócenie średniej logarytmów. exp(średnia z ln X) to średnia geometryczna (bliska medianie), a nie średnia arytmetyczna.
- Zera i wartości ujemne. Rozkład lognormalny dotyczy tylko wartości dodatnich; logarytm z zera nie istnieje.
- Nie każda skośność jest lognormalna. Zanim przyjmiesz ten model, sprawdź wykres kwantylowy logarytmów – sposoby opisuje poradnik jak sprawdzić normalność rozkładu.
Rozkład lognormalny w R
Kod liczy medianę, średnią i SD rozkładu lognormalnego, losuje 1000 czasów reakcji i porównuje średnią, medianę, średnią geometryczną oraz skośność przed logarytmowaniem i po nim.
Mediana, średnia, średnia geometryczna i skośność
R
mu <- log(600); sigma <- 0.3             # ln(czasu reakcji) ~ N(ln 600, 0.3)
round(c(mediana = exp(mu), srednia = exp(mu + sigma^2 / 2),
        SD = sqrt((exp(sigma^2) - 1) * exp(2 * mu + sigma^2))), 1)
set.seed(4841)
x <- rlnorm(1000, meanlog = mu, sdlog = sigma)
skosnosc <- function(v) mean((v - mean(v))^3) / sd(v)^3
round(c(srednia = mean(x), mediana = median(x),
        srednia_geom = exp(mean(log(x)))), 1)
round(c(skosnosc_x = skosnosc(x), skosnosc_log = skosnosc(log(x))), 2)
round(c(meanlog = mean(log(x)), sdlog = sd(log(x))), 3)
Wynik w R
mediana srednia      SD
  600.0   627.6   192.6
     srednia      mediana srednia_geom
       633.6        600.4        605.0
  skosnosc_x skosnosc_log
        0.80        -0.07
meanlog   sdlog
  6.405   0.305
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w przykładzie nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2, a panele złożono pakietem patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego w rozkładzie lognormalnym średnia jest większa od mediany?
Bo prawy ogon zawiera pojedyncze bardzo duże wartości, które podnoszą średnią. Mediana wynosi e^μ, a średnia e^(μ + σ²/2); dla μ = ln 600 i σ = 0.3 to 600 i 627.6.
Jakie parametry przyjmuje funkcja rlnorm() w R?
meanlog i sdlog, czyli średnią i odchylenie standardowe logarytmu zmiennej, a nie samej zmiennej. rlnorm(1000, meanlog = log(600), sdlog = 0.3) daje dane o medianie około 600.
Czy dane lognormalne trzeba logarytmować przed testem t?
Często to rozsądne, bo logarytmy mają rozkład normalny, a wynik dotyczy wtedy ilorazu średnich geometrycznych. Alternatywą jest model uogólniony dla dodatnich, skośnych danych, bez przekształcania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikCzas na stronie – skośne metryki
Portal z ofertami pracy: średnia, mediana i średnia geometryczna, Welch, logarytm, Mann–Whitney, bootstrap, boty i symulacja mocy – kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Feng, C., Wang, H., Lu, N., & Tu, X. M. (2013). Log transformation: Application and interpretation in biomedical research. Statistics in Medicine, 32(2), 230–239. https://doi.org/10.1002/sim.5486
- Limpert, E., Stahel, W. A., & Abbt, M. (2001). Log-normal distributions across the sciences: Keys and clues. BioScience, 51(5), 341–352. https://doi.org/10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2
- Lo, S., & Andrews, S. (2015). To transform or not to transform: Using generalized linear mixed models to analyse reaction time data. Frontiers in Psychology, 6, Article 1171. https://doi.org/10.3389/fpsyg.2015.01171 ● Otwarty dostęp
Cytowania BibTeX
@article{feng2013log, author={Feng, Changyong and Wang, Hongyue and Lu, Naiji and Tu, Xin M.}, title={{Log transformation: Application and interpretation in biomedical research}}, journal={Statistics in Medicine}, year={2013}, volume={32}, number={2}, pages={230--239}, doi={10.1002/sim.5486}}@article{limpert2001log, author={Limpert, Eckhard and Stahel, Werner A. and Abbt, Markus}, title={{Log-normal distributions across the sciences: Keys and clues}}, journal={BioScience}, year={2001}, volume={51}, number={5}, pages={341--352}, doi={10.1641/0006-3568(2001)051[0341:lndats]2.0.co;2}}@article{lo2015transform, author={Lo, Steson and Andrews, Sally}, title={{To transform or not to transform: Using generalized linear mixed models to analyse reaction time data}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={1171}, doi={10.3389/fpsyg.2015.01171}}