Co to jest transformacja Boxa–Coxa?
Transformacja Boxa–Coxa (ang. Box–Cox transformation) to rodzina potęgowych przekształceń dodatniej zmiennej zależnej z jednym parametrem λ, dobieranym tak, by model liniowy na przekształconych danych miał reszty możliwie bliskie normalnym i o stałej wariancji. Box i Cox (1964) zaproponowali wybór λ metodą największej wiarygodności i rozdzielili wkład normalności, stałości wariancji i addytywności w ten wybór. Stosuje się ją przy prawostronnej skośności czasów, stężeń czy kwot.
Jak liczyć
λ = 1 oznacza brak zmiany kształtu, λ = 0.5 to w praktyce pierwiastek, λ = 0 to logarytm, a λ = −1 odwrotność. W R funkcja MASS::boxcox() liczy profil wiarygodności dla modelu lm(), więc λ dobiera się do reszt modelu, a nie do surowej zmiennej. Wymaga ona wartości dodatnich.
Przykład
Porównano czas rozwiązania zadania w warunku presji i w grupie kontrolnej, po 50 osób (dane symulowane, od 9.1 do 118.5 s). Najlepsze λ wyniosło 0.36, 95% CI [0.02, 0.71]. Przedział wyklucza λ = 1, czyli dane bez zmian, a obejmuje pierwiastek (λ = 0.5). Po transformacji skośność reszt spadła z 0.75 do 0.08, a test Shapiro–Wilka przestał wskazywać odchylenie od normalności (p = .003 przed, .892 po). Różnica między warunkami pozostała istotna, t(98) = −2.74, p = .007.
Na rysunku
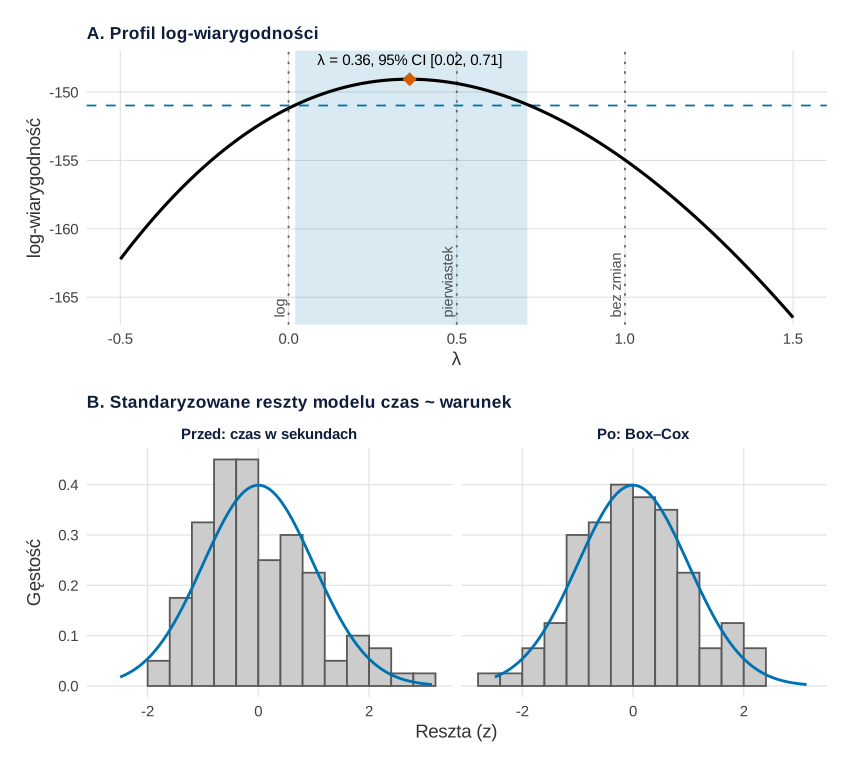
set.seed(192)).Co widać. To te same 100 czasów, co w przykładzie. Krzywa w panelu A pokazuje, jak dobrze model pasuje do danych przy każdym λ; szczyt wypada przy λ = 0.36. Przedział ufności to wszystkie λ, przy których log-wiarygodność spada od szczytu mniej niż o 1.92 (połowa wartości krytycznej χ² z 1 df) – tu od 0.02 do 0.71. Pierwiastek kosztuje tylko 0.31, logarytm 2.13, a pozostawienie danych bez zmian 5.90, więc tylko pierwiastek mieści się w przedziale. Panel B pokazuje skutek: skośność reszt spada z 0.75 do 0.08, a histogram zbliża się do krzywej normalnej.
Na co uważać. Płaski szczyt oznacza, że dane słabo rozstrzygają o λ. Wybór „okrągłej” wartości z przedziału (tu pierwiastka) prawie nic nie kosztuje, a ułatwia opis. Logarytm leży tuż za granicą przedziału – przy innej próbie mógłby się w nim znaleźć. Profil dotyczy reszt konkretnego modelu: dodanie predyktora zmienia krzywą. Rysunek nie mówi też, czy transformacja była potrzebna; ocenę reszt opisuje wpis normalność reszt czy zmiennych?.
Podpis do pracy:
Kod losuje te same dane co przykład wyżej, z tym samym ziarnem set.seed(192), ustalonym raz; siatkę λ zawężono do przedziału od −0.5 do 1.5, a szerokość słupków histogramu (0.4) ustalono ręcznie. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Profil log-wiarygodności λ z 95% CI (A) i reszty modelu przed transformacją Boxa–Coxa i po niej (B)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(MASS))   # MASS::area zasłania patchwork::area – tu bez znaczenia

# Paleta Okabe–Ito i prosty motyw
kol <- c(niebieski = "#0072B2", pomarancz = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold"), plot.background = element_rect(fill = "white", colour = NA))

set.seed(192)                                        # te same dane co w przykładzie wyżej
warunek <- factor(rep(c("kontrola", "presja"), each = 50))
czas <- rgamma(100, shape = 3, scale = ifelse(warunek == "presja", 14, 11)) + 5   # s (dane symulowane)
skos <- function(e) mean((e - mean(e))^3) / sd(e)^3

bc  <- boxcox(lm(czas ~ warunek), lambda = seq(-0.5, 1.5, 0.01), plotit = FALSE)
lam <- bc$x[which.max(bc$y)]
prog <- max(bc$y) - qchisq(0.95, 1) / 2              # granica 95% CI
ci  <- range(bc$x[bc$y > prog])
round(c(lambda = lam, CI_lo = ci[1], CI_hi = ci[2], spadek_dla_CI = qchisq(0.95, 1) / 2), 2)
round(sapply(c(log = 0, pierwiastek = 0.5, bez_zmian = 1), function(l) max(bc$y) - bc$y[which.min(abs(bc$x - l))]), 2)  # spadek logL

czas_bc <- (czas^lam - 1) / lam
r <- data.frame(stan = factor(rep(c("Przed: czas w sekundach", "Po: Box–Cox"), each = 100),
                              levels = c("Przed: czas w sekundach", "Po: Box–Cox")),
                z = c(scale(resid(lm(czas ~ warunek))), scale(resid(lm(czas_bc ~ warunek)))))
round(tapply(r$z, r$stan, skos), 2)                  # skośność reszt przed i po

pA <- ggplot(data.frame(lambda = bc$x, logL = bc$y), aes(lambda, logL)) +
  annotate("rect", xmin = ci[1], xmax = ci[2], ymin = -Inf, ymax = Inf, fill = kol[["niebieski"]], alpha = 0.15) +
  geom_vline(xintercept = c(0, 0.5, 1), linetype = "dotted", colour = "grey40") +
  annotate("text", x = c(0, 0.5, 1), y = min(bc$y), label = c("log", "pierwiastek", "bez zmian"),
           angle = 90, hjust = 0, vjust = -0.4, size = 3.8, colour = "grey30") +
  geom_hline(yintercept = prog, linetype = "dashed", colour = kol[["niebieski"]]) +
  geom_line(linewidth = 1.1) +
  annotate("point", x = lam, y = max(bc$y), size = 4.5, colour = kol[["pomarancz"]], shape = 18) +
  annotate("text", x = lam, y = max(bc$y), vjust = -1.3, size = 4,
           label = sprintf("λ = %.2f, 95%% CI [%.2f, %.2f]", lam, ci[1], ci[2])) +
  scale_y_continuous(expand = expansion(mult = c(0.03, 0.12))) +
  labs(title = "A. Profil log-wiarygodności", x = "λ", y = "log-wiarygodność") + motyw

pB <- ggplot(r, aes(z)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.4, boundary = 0, fill = "grey80", colour = "grey35") +
  stat_function(fun = dnorm, linewidth = 1, colour = kol[["niebieski"]]) +
  facet_wrap(~ stan) +
  labs(title = "B. Standaryzowane reszty modelu czas ~ warunek", x = "Reszta (z)", y = "Gęstość") + motyw

p1 <- pA / pB + plot_layout(heights = c(1.1, 1))
p1
Wynik w R
       lambda         CI_lo         CI_hi spadek_dla_CI
         0.36          0.02          0.71          1.92
        log pierwiastek   bez_zmian
       2.13        0.31        5.90
Przed: czas w sekundach             Po: Box–Cox
                   0.75                    0.08
Jak opisać w pracy
Na co uważać
- Przekształcona skala nie ma jednostek. Średnich po transformacji nie da się czytać w sekundach, dlatego opisuj wyniki medianami lub wartościami po transformacji odwrotnej.
- Zaokrąglij λ do wartości, którą da się zinterpretować, jeśli mieści się w przedziale ufności. Keene (1995) przekonuje, że logarytm ma szczególne zalety i decyzję o nim lepiej podjąć w protokole niż na podstawie danych.
- Transformacja to nie jedyna droga. Przy skośnych wynikach rozważ też model z innym rozkładem albo sprawdź, czy odchylenie od normalności w ogóle ma znaczenie przy Twojej liczebności.
Jak ocenić rozkład reszt przed decyzją o transformacji, pokazujemy we wpisie jak sprawdzić normalność rozkładu.
Box–Cox w R
Kod wyznacza λ z profilu wiarygodności, przekształca czas i porównuje skośność reszt oraz test Shapiro–Wilka przed transformacją i po niej.
Wybór λ funkcją MASS::boxcox()
R
library(MASS)
bc  <- boxcox(lm(czas ~ warunek), lambda = seq(-2, 2, 0.01), plotit = FALSE)
lam <- bc$x[which.max(bc$y)]
ci  <- range(bc$x[bc$y > max(bc$y) - qchisq(0.95, 1) / 2])   # 95% CI dla lambda
round(c(lambda = lam, CI_lo = ci[1], CI_hi = ci[2]), 2)
czas_bc <- (czas^lam - 1) / lam
round(c(skosnosc_przed = skos(resid(lm(czas ~ warunek))),
        skosnosc_po    = skos(resid(lm(czas_bc ~ warunek)))), 2)
round(c(SW_p_przed = shapiro.test(resid(lm(czas ~ warunek)))$p.value,
        SW_p_po    = shapiro.test(resid(lm(czas_bc ~ warunek)))$p.value), 3)
Wynik w R
lambda  CI_lo  CI_hi
  0.36   0.02   0.71
skosnosc_przed    skosnosc_po
          0.75           0.08
SW_p_przed    SW_p_po
     0.003      0.892
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem MASS. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co zrobić, gdy zmienna ma zera lub wartości ujemne przed transformacją Boxa–Coxa?
Klasyczny wzór wymaga wartości dodatnich. Można dodać stałą, ale jej wybór zmienia wynik. Przy zerach i zliczeniach lepiej rozważyć model z odpowiednim rozkładem.
Jak interpretować λ z transformacji Boxa–Coxa?
λ bliskie 1 oznacza, że transformacja jest zbędna, 0.5 to pierwiastek, 0 to logarytm, a −1 odwrotność. Jeśli przedział ufności obejmuje taką wartość, użyj jej.
Czy Box–Cox przekształca predyktory, czy zmienną zależną?
Klasycznie zmienną zależną, a λ dobiera się do reszt modelu z predyktorami. Do predyktorów stosuje się czasem osobne przekształcenia potęgowe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Keene, O. N. (1995). The log transformation is special. Statistics in Medicine, 14(8), 811–819. https://doi.org/10.1002/sim.4780140810
Cytowania BibTeX
@article{box1964analysis, author={Box, George E. P. and Cox, David R.}, title={{An analysis of transformations}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1964}, volume={26}, number={2}, pages={211--243}, doi={10.1111/j.2517-6161.1964.tb00553.x}}@article{keene1995log, author={Keene, Oliver N.}, title={{The log transformation is special}}, journal={Statistics in Medicine}, year={1995}, volume={14}, number={8}, pages={811--819}, doi={10.1002/sim.4780140810}}