Co to jest skośność?
Skośność (ang. skewness, współczynnik asymetrii) to miara asymetrii rozkładu zmiennej (Kim, 2013). Mówi, czy wyniki układają się symetrycznie wokół średniej, czy jeden „ogon” rozkładu jest wyraźnie dłuższy od drugiego. W rozkładzie symetrycznym, na przykład normalnym, skośność wynosi 0. Wartość dodatnia oznacza długi prawy ogon, a ujemna – długi lewy ogon.
Skośność jest jedną z dwóch liczb opisujących kształt rozkładu – drugą jest kurtoza, która dotyczy ciężkości ogonów. W psychologii asymetria jest regułą: Blanca i in. (2013) przeanalizowali 693 rozkłady z małych prób (n = 10–30) – wyniki testów zdolności poznawczych i innych miar psychologicznych. Skośność wahała się w nich od −2.49 do 2.33, a tylko 5.5% rozkładów miało skośność i kurtozę bliskie wartościom oczekiwanym przy normalności.
Skośność prawostronna i lewostronna – przykłady z psychologii
Kierunek skośności nazywa się od strony dłuższego ogona, a nie od miejsca, w którym skupia się większość wyników: w rozkładzie prawostronnie skośnym „garb” leży po lewej stronie.
| Cecha | Skośność prawostronna (dodatnia) | Skośność lewostronna (ujemna) |
|---|---|---|
| Długi ogon | po prawej: nieliczne bardzo wysokie wyniki | po lewej: nieliczne bardzo niskie wyniki |
| Średnia a mediana | zwykle średnia > mediana | zwykle średnia < mediana |
| Przykłady | czasy reakcji, objawy depresji w próbie nieklinicznej, liczba wypalanych papierosów | łatwy test wiedzy, zadowolenie z usługi, wyniki przy efekcie sufitu |
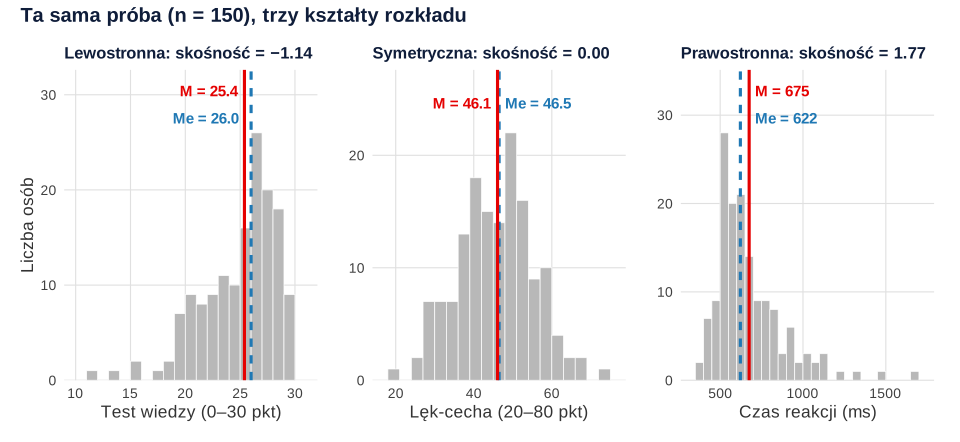
Test wiedzy okazał się łatwy (efekt sufitu): 6% osób zdobyło maksymalne 30 punktów, a długi lewy ogon tworzą nieliczne słabe wyniki (skośność −1.14). Lęk-cecha rozkłada się symetrycznie (0.00). Czas reakcji ma typowy dla tej miary długi prawy ogon: 55.3% osób odpowiadało w 500–700 ms, ale 12 osób potrzebowało ponad 1000 ms (1.77).
Ogon „ciągnie” za sobą średnią, bo każda skrajna wartość wchodzi do niej z pełną wagą. Dlatego w czasie reakcji średnia (675.06 ms) jest o 53 ms wyższa od mediany (622.00 ms), a w teście wiedzy – niższa (25.39 wobec 26.00). Ta podręcznikowa reguła zawodzi jednak zaskakująco często: w rozkładach wielomodalnych, w rozkładach z jednym ogonem długim, a drugim ciężkim, a najczęściej w rozkładach dyskretnych, np. przy wynikach w punktach (von Hippel, 2005). Kierunku skośności nie oceniaj więc tylko po różnicy średniej i mediany – policz współczynnik i obejrzyj histogram.
Wzór na skośność i różne estymatory
Skośność to standaryzowany trzeci moment centralny: średnia z sześcianów odchyleń od średniej podzielona przez odchylenie standardowe podniesione do trzeciej potęgi.
Trzecia potęga zachowuje znak odchylenia i wzmacnia duże odchylenia, więc kilka wyników daleko na prawo od średniej wystarczy, by skośność była wyraźnie dodatnia.
Programy nie liczą skośności jednakowo – Joanes i Gill (1998) porównali estymatory stosowane w różnych pakietach statystycznych i ich obciążenie. Trzy najczęstsze to:
| Estymator | Wzór | Gdzie go spotkasz | Czas reakcji (n = 150) |
|---|---|---|---|
| g1 | m3 / m23/2 | R: skew(x, type = 1) | 1.75 |
| G1 | g1 × √[n(n − 1)] / (n − 2) | SPSS, SAS, Excel (SKOŚNOŚĆ), R: type = 2 | 1.77 |
| b1 | g1 × [(n − 1) / n]3/2 | MINITAB, R: psych::describe() domyślnie | 1.73 |
Przy 150 osobach różnice są kosmetyczne, ale w małych próbach rosną: dla n = 20 wartość G1 jest o 17% wyższa niż b1, a dla n = 10 – aż o 39%. Dlatego w pracy podaj, jakim programem liczono skośność.
Aby ocenić, czy skośność wyraźnie odbiega od zera, dzieli się ją przez jej błąd standardowy: SE = √[6n(n − 1) / ((n − 2)(n + 1)(n + 3))] (wzór z SPSS). Dla n = 150 wynosi on 0.198, dla n = 20 – 0.512.
Kiedy skośność jest „duża”? Reguły z literatury
Nie ma jednego progu dla wszystkich sytuacji. Kim (2013) proponuje oceniać normalność na podstawie skośności i kurtozy razem z ich błędami standardowymi i dobierać kryterium do liczebności próby:
- n < 50 – rozkład uznaj za nienormalny, gdy |z| = |skośność / SE| przekracza 1.96;
- n od 50 do 300 – gdy |z| przekracza 3.29;
- n > 300 – nie licz z, tylko obejrzyj histogram i samą wartość: skośność o wartości bezwzględnej większej niż 2 wskazuje na znaczne odejście od normalności.
W dużej próbie błąd standardowy jest tak mały, że „istotna” staje się nawet nieważna asymetria – podobnie jak w teście Shapiro-Wilka. W naszym przykładzie (n = 150, próg 3.29) test wiedzy (z = −5.74) i czas reakcji (z = 8.92) wyraźnie odbiegają od symetrii, a lęk-cecha (z = −0.02) – nie.
Skośność warto zgłaszać zawsze. Cain i in. (2017) sprawdzili 1567 rozkładów jednowymiarowych z badań publikowanych w Psychological Science i American Educational Research Journal: 74% odbiegało od normalności, a przy typowych wartościach skośności i kurtozy błąd I rodzaju w teście t sięgał 17%. Progi traktuj jednak jako punkt orientacyjny, a nie test dopuszczalności analizy: w regresji i ANOVA założenie dotyczy reszt, a nie surowych wyników (sprawdzisz je na wykresie kwantylowym Q-Q), a w dużych próbach rozkład średnich zbliża się do normalnego (centralne twierdzenie graniczne).
Co zrobić, gdy rozkład jest skośny?
- Opisz rozkład uczciwie. Obok średniej i odchylenia standardowego podaj medianę i rozstęp ćwiartkowy.
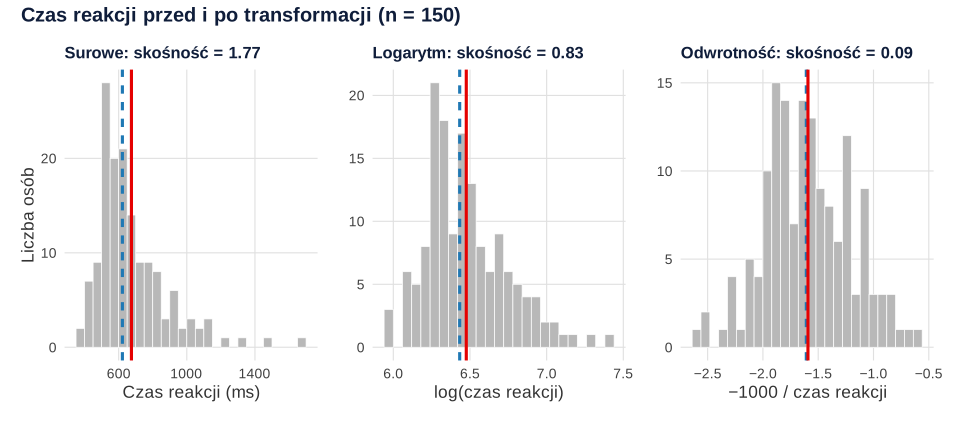
- Rozważ transformację. Logarytm zmniejszył skośność czasu reakcji z 1.77 do 0.83, a odwrotność (−1000 / czas, czyli szybkość) – do 0.09 (rysunek 2). Ceną jest interpretacja w jednostkach po przekształceniu; rozkład lewostronny trzeba przed transformacją odwrócić (np. 31 − wynik).
- Użyj metod odpornych. Porównania oparte na odpornych miarach położenia, np. średniej ucinanej, mogą mieć większą moc i trafność niż klasyczny test t i ANOVA na średnich (Wilcox i Keselman, 2003). W naszych danych 20% średnia ucinana czasu reakcji wynosi 630.6 ms. Alternatywą są testy nieparametryczne, np. test Manna-Whitneya.
- Dobierz model do danych. Liczebności (np. liczbę epizodów objawu) lepiej analizować regresją Poissona niż transformować.
Jak opisać skośność w pracy (APA)
Skośność i kurtozę podaje się w tabeli statystyk opisowych, obok średniej i odchylenia standardowego. Dla danych z przykładu (dane symulowane):
Tabela 1
Statystyki opisowe i wskaźniki kształtu rozkładu badanych zmiennych
| Zmienna | M | SD | Me | Min–Maks | Skośność | Kurtoza |
|---|---|---|---|---|---|---|
| Test wiedzy (0–30) | 25.39 | 3.50 | 26.00 | 11–30 | −1.14 | 1.61 |
| Lęk-cecha (20–80) | 46.09 | 9.74 | 46.50 | 20–73 | 0.00 | −0.19 |
| Czas reakcji (ms) | 675.06 | 207.28 | 622.00 | 382–1672 | 1.77 | 4.39 |
Uwaga. N = 150. Me = mediana. Skośność i kurtozę (nadmiarową, równą 0 dla rozkładu normalnego) obliczono estymatorami stosowanymi w SPSS; błąd standardowy skośności wynosi 0.20, a kurtozy 0.39.
W tekście opisz kształt rozkładu i to, co z niego wynika dla analizy:
Przykład w R
Kod tworzy dane z przykładu i liczy skośność, jej błąd standardowy, wartości z oraz skośność po transformacjach. W SPSS te same wskaźniki z błędami standardowymi dają Analiza → Opis statystyczny → Statystyki opisowe → Opcje („Skośność” i „Kurtoza”).
Skośność, jej błąd standardowy i transformacje
R
library(psych)
set.seed(220)
n <- 150
p_i    <- rbeta(n, 7, 1.4)
wiedza <- rbinom(n, 30, p_i)                           # test wiedzy, 0–30 pkt
lek    <- pmin(pmax(round(rnorm(n, 44, 9)), 20), 80)   # lęk-cecha, 20–80 pkt
rt     <- round(rnorm(n, 480, 50) + rexp(n, 1/200))    # czas reakcji (ms)
dane   <- data.frame(wiedza, lek, rt)

# type = 2: estymatory skośności i kurtozy takie jak w SPSS i Excelu
opis <- describe(dane, type = 2)
round(opis[, c("n", "mean", "sd", "median", "min", "max", "skew", "kurtosis")], 2)

# błąd standardowy skośności (wzór jak w SPSS) i wartość z
se_skos <- function(n) sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
round(se_skos(n), 3)
round(opis$skew / se_skos(n), 2)

# skośność czasu reakcji przed i po transformacji
round(c(surowe = skew(rt, type = 2), log = skew(log(rt), type = 2),
        odwrotnosc = skew(-1000 / rt, type = 2)), 2)
Wynik w R
         n   mean     sd median min  max  skew kurtosis
wiedza 150  25.39   3.50   26.0  11   30 -1.14     1.61
lek    150  46.09   9.74   46.5  20   73  0.00    -0.19
rt     150 675.06 207.28  622.0 382 1672  1.77     4.39
[1] 0.198
[1] -5.74 -0.02  8.92
    surowe        log odwrotnosc
      1.77       0.83       0.09
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Test istotności skośności w dużej próbie – przy kilkuset osobach prawie każda asymetria jest „istotna”; Kim (2013) radzi wtedy oceniać wartość skośności i histogram, a nie z.
- Ocena kierunku tylko po relacji średniej i mediany – w rozkładach dyskretnych i wielomodalnych ta reguła często zawodzi (von Hippel, 2005).
- Sprawdzanie skośności surowej zmiennej zależnej zamiast reszt modelu – w regresji i ANOVA o normalność pytamy w odniesieniu do reszt.
- Usuwanie wyników z ogona, żeby rozkład wyglądał symetrycznie – długi ogon to zwykle prawdziwa zmienność; o obserwacjach odstających decyduj według reguł ustalonych przed analizą.
Najczęstsze pytania
Co oznacza skośność dodatnia?
Skośność dodatnia (prawostronna) oznacza, że rozkład ma długi prawy ogon: większość osób ma wyniki niskie lub przeciętne, a nieliczne – bardzo wysokie. Tak wyglądają np. czasy reakcji. Średnia jest wtedy zwykle wyższa od mediany, bo przyciągają ją skrajne wyniki.
Jaka skośność jest dopuszczalna?
Nie ma jednego progu. Kim (2013) proponuje kryterium zależne od liczebności: przy n < 50 wartość z (skośność podzielona przez jej błąd standardowy) powyżej 1.96, przy n od 50 do 300 – powyżej 3.29, a przy n > 300 skośność o wartości bezwzględnej większej niż 2. To punkty orientacyjne: ważniejsze jest, czy asymetria wpływa na Twoją analizę, np. na rozkład reszt.
Jak obliczyć skośność w SPSS, Excelu i R?
W SPSS: Analiza → Opis statystyczny → Statystyki opisowe → Opcje → Skośność. W Excelu funkcja SKOŚNOŚĆ. W R: psych::describe(dane, type = 2) albo psych::skew(x, type = 2) – opcja type = 2 daje ten sam estymator co SPSS i Excel.
Czym różni się skośność od kurtozy?
Skośność opisuje asymetrię rozkładu – to, czy jeden ogon jest dłuższy od drugiego. Kurtoza opisuje ciężkość ogonów, czyli skłonność do wyników skrajnych po obu stronach. Rozkład może być symetryczny (skośność 0) i mieć bardzo ciężkie ogony.
Czy przy skośnym rozkładzie mogę użyć testu t lub ANOVA?
Często tak. Założenie normalności dotyczy reszt modelu, a przy większych próbach rozkład średnich zbliża się do normalnego. Przy silnej skośności i małych grupach rozważ transformację, metody odporne (np. średnie ucinane) albo test nieparametryczny i opisz swój wybór w pracy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Arnau, J., López-Montiel, D., Bono, R., & Bendayan, R. (2013). Skewness and kurtosis in real data samples. Methodology, 9(2), 78–84. https://doi.org/10.1027/1614-2241/a000057
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52 ● Otwarty dostęp
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2). https://doi.org/10.1080/10691898.2005.11910556 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{blanca2013skewness, author={Blanca, María J. and Arnau, Jaume and López-Montiel, Dolores and Bono, Roser and Bendayan, Rebecca}, title={{Skewness and kurtosis in real data samples}}, journal={Methodology}, year={2013}, volume={9}, number={2}, pages={78--84}, doi={10.1027/1614-2241/a000057}}@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{joanes1998comparing, author={Joanes, D. N. and Gill, C. A.}, title={{Comparing measures of sample skewness and kurtosis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1998}, volume={47}, number={1}, pages={183--189}, doi={10.1111/1467-9884.00122}}@article{kim2013assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis}}, journal={Restorative Dentistry \& Endodontics}, year={2013}, volume={38}, number={1}, pages={52--54}, doi={10.5395/rde.2013.38.1.52}}@article{vonhippel2005mean, author={von Hippel, Paul T.}, title={{Mean, median, and skew: Correcting a textbook rule}}, journal={Journal of Statistics Education}, year={2005}, volume={13}, number={2}, doi={10.1080/10691898.2005.11910556}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}