Co to jest test D’Agostino–Pearsona?
Test D’Agostino–Pearsona (ang. D’Agostino–Pearson omnibus test, test K²) sprawdza normalność rozkładu jednocześnie na podstawie skośności √b1 i kurtozy b2. D’Agostino i Pearson (1973) podali rozkłady obu statystyk w próbach z rozkładu normalnego i pokazali test „omnibus” łączący je w jeden wynik.
Jak liczyć
Skośność i kurtozę z próby przekształca się do statystyk z1 i z2, które przy normalności mają w przybliżeniu standardowy rozkład normalny. Następnie:
K² = z1² + z2²
Przy prawdziwej hipotezie o normalności K² ma w przybliżeniu rozkład χ² z 2 stopniami swobody, więc przy α = .05 wartość krytyczna wynosi 5.99. D’Agostino i in. (1990) zalecali ten test jako mocny i informacyjny: osobne z pokazują, czy odchylenie dotyczy asymetrii, czy ogonów rozkładu.
Przykład
Dwie próby po 100 obserwacji (dane symulowane). Dla próby z rozkładu normalnego skośność = 0.10, kurtoza = 2.40, K² = 2.30, p = .317 – brak podstaw do odrzucenia normalności (Shapiro–Wilk: p = .333). Dla próby prawoskośnej skośność = 1.03, kurtoza = 4.30, z1 = 3.84, z2 = 2.23, K² = 19.72, p < .001; większy udział ma skośność.
Na rysunku
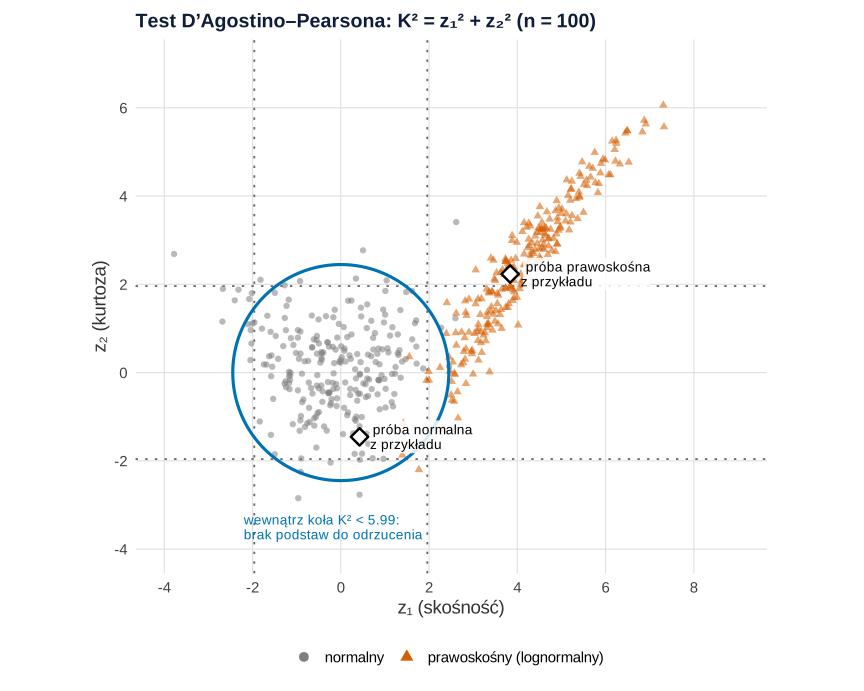
Co widać. Każdy punkt to jedna próba opisana dwiema liczbami: z1 ze skośności i z2 z kurtozy. Ponieważ K² = z1² + z2², próg 5.99 to koło o promieniu 2.45. Test odrzuca normalność dla każdego punktu poza kołem, bez względu na to, w którą stronę odchyla się próba. Próby z rozkładu normalnego skupiają się wokół zera i poza kołem znalazło się 5.5% z 2000, czyli tyle, ile wynosi α (błąd Monte Carlo 0.5 punktu procentowego). Próby lognormalne układają się w pas w prawo i w górę, bo prawostronna skośność idzie tu w parze z grubszym prawym ogonem. Poza kołem znalazło się 95.2% z nich. Romby to dwie próby z przykładu: normalna wewnątrz koła, prawoskośna wyraźnie poza nim, głównie z powodu z1.
Na co uważać. Test łączny nie zawsze jest najmocniejszy. W tej symulacji sam test skośności (|z1| > 1.96, kropkowane linie) odrzucił normalność w 97.5% prób lognormalnych, a sam test kurtozy w 60.7%. Dodanie słabszej składowej trochę obniżyło moc testu łącznego. Za to test łączny nie wymaga zgadywania z góry, jakie będzie odstępstwo. Koło zakłada, że z1 i z2 są przy normalności niezależne, co jest tylko przybliżeniem. Rozkład, n = 100 i liczbę prób dobrano ręcznie. Ten sam pomysł bez przekształcenia do z stosuje test Jarque–Bera, którego α przy małych próbach odbiega od 5%.
Podpis do pracy:
Kod rysunku ma dwa losujące bloki: set.seed(551) odtwarza próby z przykładu, a set.seed(2551) losuje 2000 prób z każdego rozkładu. Ziarna ustalono przed uruchomieniem i nie zmieniano. Wykonanie zajmuje kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Statystyki z skośności i kurtozy w próbach normalnych i prawoskośnych; obszar odrzucenia K²
library(ggplot2)
library(moments)

# Paleta Okabe–Ito i prosty motyw
kol <- c(normalny = "grey50", prawoskosny = "#D55E00", granica = "#0072B2", szary = "grey40")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

z12 <- function(x) c(z1 = unname(agostino.test(x)$statistic["z"]),    # skośność (D'Agostino)
                     z2 = unname(anscombe.test(x)$statistic["z"]))    # kurtoza (Anscombe–Glynn)
kryt <- qchisq(0.95, df = 2)                                          # 5.99, promień koła = √5.99 = 2.45

# Dwie próby z przykładu (ziarno jak w przykładzie)
set.seed(551)
x_norm <- rnorm(100, mean = 50, sd = 10)
x_skos <- rlnorm(100, meanlog = 3.9, sdlog = 0.4)
przyklad <- data.frame(rbind(z12(x_norm), z12(x_skos)), etyk = c("próba normalna\nz przykładu", "próba prawoskośna\nz przykładu"))

# 2000 prób po 100 obserwacji z każdego rozkładu
set.seed(2551)
R <- 2000
sym <- rbind(data.frame(t(replicate(R, z12(rnorm(100, 50, 10)))), rozklad = "normalny"),
             data.frame(t(replicate(R, z12(rlnorm(100, 3.9, 0.4)))), rozklad = "prawoskośny (lognormalny)"))
sym$odrzuca <- sym$z1^2 + sym$z2^2 > kryt
tab <- aggregate(odrzuca ~ rozklad, data = sym, FUN = mean)
tab$se <- sqrt(tab$odrzuca * (1 - tab$odrzuca) / R)                  # błąd Monte Carlo
tab$tylko_skosnosc <- tapply(abs(sym$z1) > 1.96, sym$rozklad, mean)  # osobny test skośności
tab$tylko_kurtoza <- tapply(abs(sym$z2) > 1.96, sym$rozklad, mean)   # osobny test kurtozy
print(transform(tab, odrzuca = round(odrzuca, 3), se = round(se, 3),
                tylko_skosnosc = round(tylko_skosnosc, 3), tylko_kurtoza = round(tylko_kurtoza, 3)), row.names = FALSE)

kolo <- data.frame(t = seq(0, 2 * pi, length.out = 361))
kolo$z1 <- sqrt(kryt) * cos(kolo$t); kolo$z2 <- sqrt(kryt) * sin(kolo$t)
cat(sprintf("Zakres z1: %.2f do %.2f; zakres z2: %.2f do %.2f (wszystkie 4000 prób)\n",
            min(sym$z1), max(sym$z1), min(sym$z2), max(sym$z2)))
pokaz <- do.call(rbind, lapply(split(sym, sym$rozklad), head, 250))  # na wykresie po 250 prób
p <- ggplot(pokaz, aes(z1, z2)) +
  geom_hline(yintercept = c(-1.96, 1.96), linetype = "dotted", colour = kol[["szary"]]) +
  geom_vline(xintercept = c(-1.96, 1.96), linetype = "dotted", colour = kol[["szary"]]) +
  geom_point(aes(colour = rozklad, shape = rozklad), alpha = 0.55, size = 1.8) +
  geom_path(data = kolo, colour = kol[["granica"]], linewidth = 1.1) +
  geom_point(data = przyklad, size = 4, shape = 23, fill = "white", stroke = 1.3) +
  geom_label(data = przyklad, aes(label = etyk), hjust = -0.1, size = 3.6, lineheight = 0.9,
             linewidth = 0, fill = "white", alpha = 0.85) +
  annotate("text", x = -2.2, y = -3.5, hjust = 0, size = 3.6, colour = kol[["granica"]], lineheight = 0.9,
           label = "wewnątrz koła K² < 5.99:\nbrak podstaw do odrzucenia") +
  scale_colour_manual(values = unname(kol[c("normalny", "prawoskosny")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(-4, 8, 2)) + scale_y_continuous(breaks = seq(-4, 6, 2)) +
  coord_equal(xlim = c(-4, 9), ylim = c(-4, 7)) +
  labs(title = "Test D’Agostino–Pearsona: K² = z₁² + z₂² (n = 100)",
       x = "z₁ (skośność)", y = "z₂ (kurtoza)") +
  guides(colour = guide_legend(override.aes = list(alpha = 1, size = 3))) +
  motyw
p
Wynik w R
                   rozklad odrzuca    se tylko_skosnosc tylko_kurtoza
                  normalny   0.055 0.005          0.046         0.057
 prawoskośny (lognormalny)   0.952 0.005          0.975         0.607
Zakres z1: -3.78 do 8.83; zakres z2: -3.91 do 6.88 (wszystkie 4000 prób)
Na tle innych testów
Test Jarque–Bera też łączy skośność i kurtozę, ale według wzoru asymptotycznego, bez przekształcenia do z. W symulacjach Yap i Sim (2011) testy D’Agostino i Shapiro–Wilka miały najlepszą moc przy rozkładach symetrycznych o krótkich ogonach, a przy asymetrycznych prowadził Shapiro–Wilk przed Andersonem–Darlingiem.
Jak opisać w pracy
Na co uważać
- Duża próba. Przy setkach obserwacji test wykrywa odchylenia bez znaczenia praktycznego; oceń też wykres Q-Q.
- Co testujesz. W regresji i ANOVA założenie dotyczy reszt, nie surowej zmiennej.
- Wynik nieistotny to nie dowód normalności, zwłaszcza w małej próbie.
Test D’Agostino–Pearsona w R
Pakiet moments nie ma gotowego testu K², więc kod łączy statystykę z testu skośności D’Agostino (agostino.test()) i testu kurtozy Anscombe’a–Glynna (anscombe.test()), a dla porównania podaje p testu Shapiro–Wilka.
Statystyka K² dla dwóch prób
R
library(moments)
set.seed(551)
x_norm <- rnorm(100, mean = 50, sd = 10)          # rozkład normalny
x_skos <- rlnorm(100, meanlog = 3.9, sdlog = 0.4) # rozkład prawoskośny
k2 <- function(x) {
  z1 <- unname(agostino.test(x)$statistic["z"])   # skośność (D'Agostino)
  z2 <- unname(anscombe.test(x)$statistic["z"])   # kurtoza (Anscombe–Glynn)
  K2 <- z1^2 + z2^2                               # statystyka omnibus K²
  c(skosnosc = skewness(x), kurtoza = kurtosis(x), z_skos = z1, z_kurt = z2,
    K2 = K2, p = pchisq(K2, df = 2, lower.tail = FALSE),
    p_Shapiro = shapiro.test(x)$p.value)
}
round(rbind(normalny = k2(x_norm), prawoskosny = k2(x_skos)), 3)
round(qchisq(0.95, df = 2), 2)                    # wartość krytyczna przy α = .05
Wynik w R
            skosnosc kurtoza z_skos z_kurt     K2     p p_Shapiro
normalny       0.098   2.403  0.425 -1.456  2.300 0.317     0.333
prawoskosny    1.030   4.301  3.838  2.233 19.716 0.000     0.000
[1] 5.99
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet moments). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- moments (wersja 0.14.1): Komsta, L., & Novomestky, F. (2022). moments: Moments, cumulants, skewness, kurtosis and related tests (R package version 0.14.1) [Computer software]. https://doi.org/10.32614/CRAN.package.moments
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test D’Agostino–Pearsona różni się od testu Jarque–Bera?
Oba łączą skośność i kurtozę. Test D’Agostino–Pearsona najpierw przekształca je do statystyk z, a Jarque–Bera stosuje wzór asymptotyczny dla surowych miar.
Jak policzyć test D’Agostino–Pearsona w R?
W pakiecie moments policz z ze skośności (agostino.test) i z kurtozy (anscombe.test), zsumuj ich kwadraty i odczytaj p z rozkładu χ² z 2 stopniami swobody.
Co oznacza istotny wynik testu D’Agostino–Pearsona?
Rozkład odbiega od normalnego. Sprawdź, które z dwóch z jest duże: skośność wskazuje asymetrię, a kurtoza – zbyt grube lub zbyt cienkie ogony.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikNormalność reszt czy zmiennych?
Dlaczego w regresji i ANOVA sprawdzasz reszty, a nie surową zmienną: przykład w R z dwugarbnym rozkładem, wykres Q-Q reszt i wpływ liczebności próby.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- D’Agostino, R. B., Belanger, A., & D’Agostino, R. B., Jr. (1990). A suggestion for using powerful and informative tests of normality. The American Statistician, 44(4), 316–321. https://doi.org/10.1080/00031305.1990.10475751
- D’Agostino, R., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of b2 and √b1. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- Yap, B. W., & Sim, C. H. (2011). Comparisons of various types of normality tests. Journal of Statistical Computation and Simulation, 81(12), 2141–2155. https://doi.org/10.1080/00949655.2010.520163 ● Otwarty dostęp
Cytowania BibTeX
@article{dagostino1990suggestion, author={D'Agostino, Ralph B. and Belanger, Albert and D'Agostino, Jr., Ralph B.}, title={{A suggestion for using powerful and informative tests of normality}}, journal={The American Statistician}, year={1990}, volume={44}, number={4}, pages={316--321}, doi={10.1080/00031305.1990.10475751}}@article{dagostino1973tests, author={D'Agostino, Ralph and Pearson, E. S.}, title={{Tests for departure from normality. Empirical results for the distributions of b2 and √b1}}, journal={Biometrika}, year={1973}, volume={60}, number={3}, pages={613--622}, doi={10.1093/biomet/60.3.613}}@article{yap2011comparisons, author={Yap, B. W. and Sim, C. H.}, title={{Comparisons of various types of normality tests}}, journal={Journal of Statistical Computation and Simulation}, year={2011}, volume={81}, number={12}, pages={2141--2155}, doi={10.1080/00949655.2010.520163}}