Co to jest test Jarque–Bera?
Test Jarque–Bera (ang. Jarque–Bera test, test JB) to test normalności oparty na dwóch miarach kształtu rozkładu: skośności i kurtozie z próby. Jarque i Bera (1987) przedstawili go jako test normalności zarówno obserwacji, jak i reszt regresji, dlatego jest popularny w ekonometrii i finansach. Hipoteza zerowa mówi, że dane pochodzą z rozkładu normalnego, czyli skośność wynosi 0, a kurtoza 3.
Jak się go liczy?
JB = n/6 · [S² + (K − 3)²/4], gdzie S to skośność, a K kurtoza (nie nadwyżka kurtozy) policzone z momentów próby. Przy dużym n statystyka ma w przybliżeniu rozkład chi-kwadrat z 2 stopniami swobody, więc wartość krytyczna przy α = .05 wynosi 5.99. Test reaguje na asymetrię i na zbyt grube lub zbyt cienkie ogony, ale nie widzi innych odstępstw: rozkład o S = 0 i K = 3 przejdzie test, nawet jeśli nie jest normalny.
Przykład w R
W 200 obserwacjach z rozkładu normalnego S = 0.096, K = 2.756 i JB = 0.81 (p = .668). W 200 obserwacjach z rozkładu logarytmiczno-normalnego S = 1.524, K = 6.233 i JB = 164.52 (p < .001), bo rozkład jest prawoskośny i ma grube ogony. Ten sam wynik daje funkcja jarque.bera.test() z pakietu tseries.
W małych próbach przybliżenie chi-kwadrat zawodzi. W 10 000 symulowanych próbach normalnych po 20 obserwacji test odrzucił hipotezę zerową w 2.7% przypadków zamiast w 5%, czyli jest zachowawczy. Thadewald i Büning (2007) stwierdzili, że wartości krytyczne z rozkładu chi-kwadrat nie sprawdzają się dobrze, a test ma słabą moc przy krótkich ogonach i rozkładach dwumodalnych. Przy małym n lepiej sięgnąć po test Shapiro–Wilka, który w symulacjach Yap i Sim (2011) był najmocniejszy przy rozkładach asymetrycznych.
Na rysunku
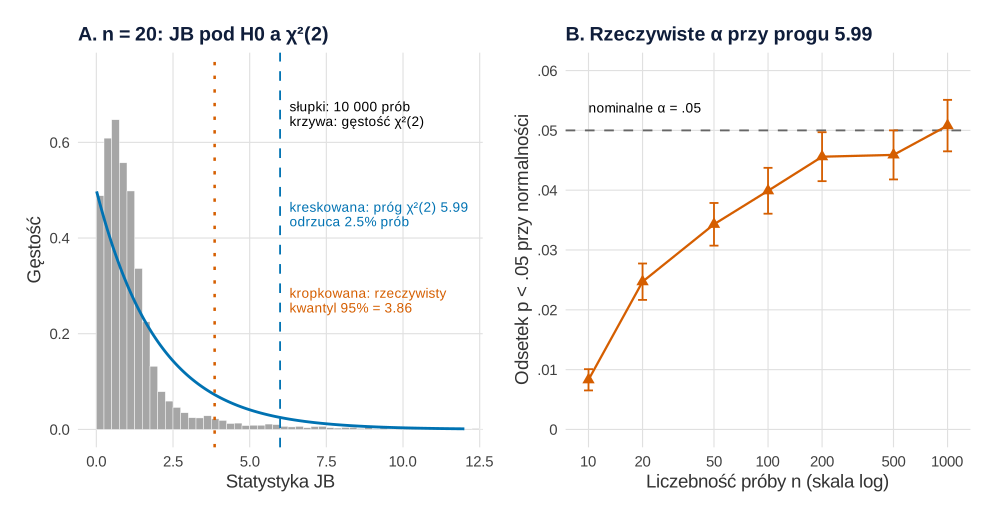
Co widać. Panel A pokazuje, skąd bierze się zachowawczość testu z przykładu. Przy 20 obserwacjach z rozkładu normalnego statystyka JB jest skupiona przy małych wartościach bardziej, niż zakłada rozkład χ² z 2 stopniami swobody. Jej rzeczywisty 95. percentyl to 3.86, a nie 5.99. Próg z tablic odcina więc tylko 2.5% prób zamiast 5%. Panel B pokazuje, jak wolno to się poprawia. Przy n = 10 test odrzuca prawdziwą normalność w 0.8% prób, przy n = 100 w 4.0%, a nominalne 5% osiąga dopiero przy kilkuset do tysiąca obserwacji (5.1% przy n = 1000). Błąd Monte Carlo nie przekraczał 0.22 punktu procentowego. Zbyt mała liczba fałszywych alarmów idzie w parze z mniejszą mocą: przy małym n test rzadziej wykrywa też prawdziwe odstępstwa.
Na co uważać. Rysunek dotyczy wyłącznie błędu I rodzaju przy danych normalnych. Nie pokazuje mocy przy konkretnych odstępstwach. Wartość p wyznaczona symulacyjnie dla danego n, a nie z rozkładu χ², usuwa ten problem. Liczebności i liczbę prób dobrano ręcznie. Test D’Agostino–Pearsona rozwiązuje ten problem inaczej: najpierw przekształca skośność i kurtozę do statystyk z (zob. test D’Agostino–Pearsona). Skąd rozkład χ² bierze się jako granica dla dużych prób, pokazuje wpis skąd się biorą rozkłady t, χ² i F.
Podpis do pracy:
Kod rysunku liczy JB ze wzoru z sekcji „Jak się go liczy” (to samo co jarque.bera.test(), ale dla wielu prób naraz) i losuje dane w jednym bloku z set.seed(434). Ziarno ustalono przed uruchomieniem i nie zmieniano. Wykonanie zajmuje kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozkład JB przy prawdziwej normalności (A) i rzeczywiste α testu JB w funkcji n (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(sym = "grey65", chi2 = "#0072B2", akcent = "#D55E00", szary = "grey40")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Statystyka JB dla każdego wiersza macierzy (wiersz = jedna próba)
jb_wiersze <- function(X) {
  n <- ncol(X); M <- X - rowMeans(X)
  m2 <- rowMeans(M^2); S <- rowMeans(M^3) / m2^1.5; K <- rowMeans(M^4) / m2^2
  n / 6 * (S^2 + (K - 3)^2 / 4)
}
kryt <- qchisq(0.95, df = 2)                          # 5.99 – wartość krytyczna z χ²(2)

# 10 000 prób z rozkładu normalnego dla każdego n
set.seed(434)
ns <- c(10, 20, 50, 100, 200, 500, 1000); R <- 10000
jb <- lapply(ns, function(n) jb_wiersze(matrix(rnorm(R * n), nrow = R)))
alfa <- data.frame(n = ns, alfa = sapply(jb, function(v) mean(v > kryt)),
                   kwantyl95 = sapply(jb, quantile, 0.95))
alfa$se <- sqrt(alfa$alfa * (1 - alfa$alfa) / R)       # błąd Monte Carlo
print(transform(alfa, alfa = round(alfa, 4), kwantyl95 = round(kwantyl95, 2), se = round(se, 4)), row.names = FALSE)

# A: n = 20 – histogram 10 000 wartości JB i gęstość χ²(2)
d20 <- data.frame(JB = jb[[which(ns == 20)]])
q20 <- alfa$kwantyl95[alfa$n == 20]
krzywa <- data.frame(x = seq(0.01, 12, by = 0.01)); krzywa$g <- dchisq(krzywa$x, df = 2)
cat(sprintf("n = 20: JB > 12 w %.1f%% prób (poza osią panelu A)\n", 100 * mean(d20$JB > 12)))
pA <- ggplot(d20, aes(JB)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.25, boundary = 0, fill = kol[["sym"]], colour = "white",
                 linewidth = 0.15) +
  geom_line(data = krzywa, aes(x, g), colour = kol[["chi2"]], linewidth = 1) +
  geom_vline(xintercept = kryt, linetype = "dashed", colour = kol[["chi2"]]) +
  geom_vline(xintercept = q20, linetype = "dotted", colour = kol[["akcent"]], linewidth = 0.9) +
  annotate("text", x = 6.3, y = 0.66, hjust = 0, size = 3.6, lineheight = 0.9,
           label = "słupki: 10 000 prób\nkrzywa: gęstość χ²(2)") +
  annotate("text", x = 6.3, y = 0.45, hjust = 0, size = 3.6, colour = kol[["chi2"]], lineheight = 0.9,
           label = sprintf("kreskowana: próg χ²(2) 5.99\nodrzuca %.1f%% prób", 100 * alfa$alfa[alfa$n == 20])) +
  annotate("text", x = 6.3, y = 0.27, hjust = 0, size = 3.6, colour = kol[["akcent"]], lineheight = 0.9,
           label = sprintf("kropkowana: rzeczywisty\nkwantyl 95%% = %.2f", q20)) +
  coord_cartesian(xlim = c(0, 12), ylim = c(0, 0.75)) +
  labs(title = "A. n = 20: JB pod H0 a χ²(2)", x = "Statystyka JB", y = "Gęstość") +
  motyw

# B: odsetek odrzuceń prawdziwej H0 przy wartości krytycznej 5.99
pB <- ggplot(alfa, aes(n, alfa)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = kol[["szary"]]) +
  annotate("text", x = 10, y = 0.053, hjust = 0, vjust = 0, size = 3.6, label = "nominalne α = .05") +
  geom_errorbar(aes(ymin = alfa - 1.96 * se, ymax = alfa + 1.96 * se), width = 0.05, colour = kol[["akcent"]]) +
  geom_line(colour = kol[["akcent"]], linewidth = 0.8) + geom_point(colour = kol[["akcent"]], size = 2.8, shape = 17) +
  scale_x_log10(breaks = ns) +
  scale_y_continuous(limits = c(0, 0.06), breaks = seq(0, 0.06, 0.01), labels = c("0", sprintf(".%02d", 1:6))) +
  labs(title = "B. Rzeczywiste α przy progu 5.99", x = "Liczebność próby n (skala log)",
       y = "Odsetek p < .05 przy normalności") +
  motyw

p <- pA + pB
p
Wynik w R
    n   alfa kwantyl95     se
   10 0.0083      2.56 0.0009
   20 0.0247      3.86 0.0016
   50 0.0343      4.73 0.0018
  100 0.0399      5.20 0.0020
  200 0.0456      5.73 0.0021
  500 0.0459      5.80 0.0021
 1000 0.0508      6.03 0.0022
n = 20: JB > 12 w 0.6% prób (poza osią panelu A)
Jak opisać w pracy
Na co uważać
- Duże próby. Przy tysiącach obserwacji test odrzuci normalność przy błahych odstępstwach. Oceniaj też wielkość S i K oraz wykres kwantylowy (zob. jak sprawdzić normalność rozkładu).
- Różne definicje. Wzór używa momentowych S i K, a nie poprawionych G1 i G2 z SPSS, które podaje kalkulator statystyk opisowych. Przy małym n wyniki programów mogą się różnić.
- Co testować. W regresji założenie dotyczy reszt, a nie samych zmiennych (zob. normalność reszt czy zmiennych).
Test Jarque–Bera w R
Kod liczy skośność, kurtozę i statystykę JB ze wzoru dla danych normalnych i prawoskośnych, porównuje wynik z funkcją jarque.bera.test() i sprawdza w symulacji, jak często test odrzuca normalność przy 20 obserwacjach.
Statystyka JB ze wzoru i z pakietu tseries
R
library(tseries)
set.seed(4341)
x_norm <- rnorm(200)                 # rozkład normalny
x_log  <- rlnorm(200, sdlog = 0.5)   # rozkład prawoskośny
jb <- function(x) {
  n <- length(x); m <- x - mean(x)
  S <- mean(m^3) / mean(m^2)^1.5     # skośność
  K <- mean(m^4) / mean(m^2)^2       # kurtoza (normalny: 3)
  JB <- n / 6 * (S^2 + (K - 3)^2 / 4)
  round(c(S = S, K = K, JB = JB, p = pchisq(JB, 2, lower.tail = FALSE)), 3)
}
rbind(normalny = jb(x_norm), lognormalny = jb(x_log))
jarque.bera.test(x_log)$statistic    # to samo w pakiecie tseries
round(qchisq(.95, df = 2), 2)        # wartość krytyczna przy α = .05
# Odsetek p < .05 dla danych normalnych przy małym n (powinno być 5%)
mean(replicate(10000, jarque.bera.test(rnorm(20))$p.value < .05))
Wynik w R
                S     K      JB     p
normalny    0.096 2.756   0.806 0.668
lognormalny 1.524 6.233 164.516 0.000
X-squared
 164.5161
[1] 5.99
[1] 0.0267
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (z pakietem tseries). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tseries (wersja 0.10.61): Trapletti, A., & Hornik, K. (2026). tseries: Time series analysis and computational finance (R package version 0.10-61) [Computer software]. https://doi.org/10.32614/CRAN.package.tseries
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy test Jarque–Bera nadaje się do małej próby?
Słabo. Przy 20 obserwacjach w naszej symulacji odrzucał normalność w 2.7% zamiast 5% przypadków, a przy krótkich ogonach ma małą moc. Przy małym n wybierz test Shapiro–Wilka.
Czym test Jarque–Bera różni się od testu Shapiro–Wilka?
Jarque–Bera patrzy tylko na skośność i kurtozę, a Shapiro–Wilk porównuje uporządkowane wyniki z oczekiwanymi przy normalności. W symulacjach Yap i Sim (2011) Shapiro–Wilk był co najmniej równie mocny.
Jak policzyć test Jarque–Bera w R?
Najprościej funkcją jarque.bera.test() z pakietu tseries; podaje statystykę X-squared, df = 2 i p. W regresji zastosuj ją do reszt modelu, np. residuals(model).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikNormalność reszt czy zmiennych?
Dlaczego w regresji i ANOVA sprawdzasz reszty, a nie surową zmienną: przykład w R z dwugarbnym rozkładem, wykres Q-Q reszt i wpływ liczebności próby.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
- Thadewald, T., & Büning, H. (2007). Jarque–Bera test and its competitors for testing normality – A power comparison. Journal of Applied Statistics, 34(1), 87–105. https://doi.org/10.1080/02664760600994539
- Yap, B. W., & Sim, C. H. (2011). Comparisons of various types of normality tests. Journal of Statistical Computation and Simulation, 81(12), 2141–2155. https://doi.org/10.1080/00949655.2010.520163 ● Otwarty dostęp
Cytowania BibTeX
@article{jarque1987test, author={Jarque, Carlos M. and Bera, Anil K.}, title={{A test for normality of observations and regression residuals}}, journal={International Statistical Review}, year={1987}, volume={55}, number={2}, pages={163--172}, doi={10.2307/1403192}}@article{thadewald2007jarque, author={Thadewald, Thorsten and Büning, Herbert}, title={{Jarque–Bera test and its competitors for testing normality – A power comparison}}, journal={Journal of Applied Statistics}, year={2007}, volume={34}, number={1}, pages={87--105}, doi={10.1080/02664760600994539}}@article{yap2011comparisons, author={Yap, B. W. and Sim, C. H.}, title={{Comparisons of various types of normality tests}}, journal={Journal of Statistical Computation and Simulation}, year={2011}, volume={81}, number={12}, pages={2141--2155}, doi={10.1080/00949655.2010.520163}}