Co to jest rozkład gamma?
Rozkład gamma (ang. gamma distribution) to rozkład ciągły dla wartości dodatnich z parametrem kształtu k i parametrem skali θ (albo tempa 1/θ). Jest prawostronnie skośny, a przy dużym k zbliża się do rozkładu normalnego. Opisuje czasy, koszty, opady i inne wielkości, które nie mogą być ujemne i mają długi prawy ogon. Wzory i związki z innymi rozkładami zestawiają Forbes i in. (2010).
Średnia, wariancja i związki z innymi rozkładami
- Wartość oczekiwana wynosi kθ, a wariancja kθ2. Odchylenie standardowe rośnie proporcjonalnie do średniej, a współczynnik zmienności 1/√k nie zależy od skali.
- Suma czasów oczekiwania. Suma k niezależnych zmiennych z rozkładu wykładniczego o średniej θ ma rozkład gamma(k, θ); przy k = 1 gamma jest po prostu rozkładem wykładniczym.
- Rozkład chi-kwadrat z df stopniami swobody to gamma o kształcie df/2 i skali 2.
Przykład w R
Niech czas wykonania zadania ma rozkład gamma o kształcie 2 i skali 5 minut. Średnia wynosi 10 minut, wariancja 50, a mediana 8.39 – mniej niż średnia, jak w rozkładzie prawoskośnym. P(X ≤ 20) = 0.908. Suma dwóch losowych czasów wykładniczych o średniej 5 (1000 powtórzeń) dała średnią 10.3 i wariancję 53.8, a dopasowanie funkcją fitdistr() z pakietu MASS – kształt 1.96 i skalę 5.24. Dla chi-kwadrat z df = 4 i gamma(2, 2) dystrybuanta w punkcie 5 jest ta sama: 0.7127.
Na rysunku
Panel A rysunku pokazuje rodzinę krzywych gamma, a panel B – 1000 sum dwóch czasów wykładniczych z przykładu wyżej (to samo ziarno 4991). Skalę θ = 2 w panelu A wybrano celowo: przy niej każdy rozkład gamma jest zarazem rozkładem chi-kwadrat.
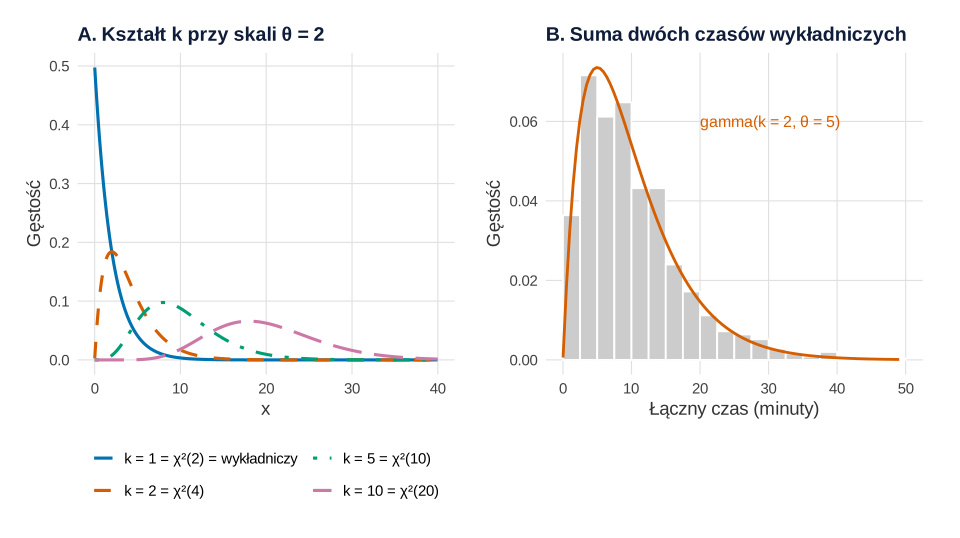
set.seed(4991)).Co widać. Przy k = 1 krzywa jest wykładnicza i maleje od zera. Wraz z k szczyt przesuwa się w prawo (średnia kθ rośnie), krzywa się rozszerza i staje się coraz bardziej symetryczna. Każda krzywa z panelu A to jednocześnie rozkład chi-kwadrat z df = 2k; skąd chi-kwadrat bierze się w testach, pokazuje wpis Skąd się biorą rozkłady t, χ² i F. W panelu B suma dwóch czasów wykładniczych ma średnią 10.27 i medianę 8.56 minuty (teoretycznie 10 i 8.39), a krzywa gamma(2, 5) przebiega przez słupki.
Na co uważać. Zgodność w panelu B jest wbudowana w symulację. Na prawdziwych danych podobny histogram dałby też rozkład lognormalny – różnią się głównie dalekim ogonem, którego w 1000 obserwacjach prawie nie widać. Wybór między nimi sprawdzaj wykresem kwantylowym albo porównaniem dopasowań, nie samym histogramem.
Podpis do pracy:
Na stronie rysunek ma motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej. Kształty k i szerokość przedziałów histogramu (2.5 minuty) dobrano ręcznie; ziarna nie zmieniano.
Kod R rysunku 1
# Rysunek 1: rodzina rozkładów gamma (A) i suma dwóch czasów wykładniczych (B)
library(ggplot2)
library(patchwork)
kol <- c("#0072B2", "#D55E00", "#009E73", "#CC79A7")          # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Kształt k = 1, 2, 5, 10 przy skali θ = 2: każda krzywa to też chi-kwadrat z df = 2k
ksztalty <- c(1, 2, 5, 10)
etyk <- paste0("k = ", ksztalty, " = χ²(", 2 * ksztalty, ")", c(" = wykładniczy", "", "", ""))
siatka <- expand.grid(x = seq(0.01, 40, by = 0.05), k = ksztalty)
siatka$gestosc <- dgamma(siatka$x, shape = siatka$k, scale = 2)
siatka$krzywa <- factor(siatka$k, levels = ksztalty, labels = etyk)
all.equal(dgamma(7, shape = 5, scale = 2), dchisq(7, df = 10))   # gamma(5, 2) = χ²(10)
p1a <- ggplot(siatka, aes(x, gestosc, colour = krzywa, linetype = krzywa)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "longdash"), name = NULL) +
  guides(colour = guide_legend(ncol = 2)) +
  labs(title = "A. Kształt k przy skali θ = 2", x = "x", y = "Gęstość") + motyw

# B. 1000 sum dwóch czasów wykładniczych o średniej 5 (to samo ziarno co w przykładzie)
set.seed(4991)
suma <- rexp(1000, rate = 1 / 5) + rexp(1000, rate = 1 / 5)
round(c(srednia = mean(suma), mediana = median(suma), teoria_mediana = qgamma(0.5, shape = 2, scale = 5)), 2)
p1b <- ggplot(data.frame(suma), aes(suma)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 2.5, boundary = 0,
                 fill = "grey80", colour = "white") +
  stat_function(fun = dgamma, args = list(shape = 2, scale = 5), linewidth = 1, colour = kol[2]) +
  annotate("text", x = 20, y = 0.06, hjust = 0, size = 4.2, colour = kol[2],
           label = "gamma(k = 2, θ = 5)") +
  labs(title = "B. Suma dwóch czasów wykładniczych", x = "Łączny czas (minuty)", y = "Gęstość") + motyw
p1 <- p1a + p1b
p1
Wynik w R
[1] TRUE
       srednia        mediana teoria_mediana
         10.27           8.56           8.39
Zastosowania
Husak, Michaelsen i Funk (2007) dopasowali rozkład gamma do miesięcznych opadów w Afryce i uznali go za odpowiedni w około 98% lokalizacji. Fay i Feuer (1997) oparli na rozkładzie gamma przedziały ufności dla współczynników standaryzowanych metodą bezpośrednią. Gdy średnia zmiennej o rozkładzie gamma zależy od predyktorów, stosuje się regresję gamma – to model warunkowej średniej, a nie opis samego rozkładu.
Na co uważać
- Parametryzacja. Sprawdź, czy program podaje skalę, czy tempo – w R domyślnie jest to tempo (
rate). - Zera. Rozkład gamma nie obejmuje zera. Dane z wieloma zerami, np. osoby bez żadnych kosztów, wymagają modelu dwuczęściowego, a przy cięższym ogonie lepszy bywa rozkład lognormalny.
Rozkład gamma w R
Kod liczy średnią, wariancję, dystrybuantę i medianę rozkładu gamma, sprawdza symulacją, że suma dwóch zmiennych wykładniczych ma rozkład gamma, dopasowuje parametry metodą największej wiarygodności i porównuje dystrybuantę chi-kwadrat z gamma.
Średnia, wariancja, symulacja i dopasowanie
R
k <- 2; theta <- 5                                  # kształt k = 2, skala theta = 5 (np. minuty)
c(srednia = k * theta, wariancja = k * theta^2)
round(pgamma(20, shape = k, scale = theta), 3)      # P(X <= 20)
round(qgamma(0.5, shape = k, scale = theta), 2)     # mediana (mniejsza od średniej)
# suma dwóch niezależnych czasów wykładniczych o średniej 5 ma rozkład gamma(2, 5)
set.seed(4991)
x <- rexp(1000, rate = 1 / 5) + rexp(1000, rate = 1 / 5)
round(c(srednia_sym = mean(x), wariancja_sym = var(x)), 1)
library(MASS)
dop <- fitdistr(x, "gamma")                         # metoda największej wiarygodności
round(c(ksztalt = dop$estimate[["shape"]], skala = 1 / dop$estimate[["rate"]]), 2)
# chi-kwadrat z df = 4 to gamma o kształcie 2 i skali 2
round(c(pchisq(5, df = 4), pgamma(5, shape = 2, scale = 2)), 4)
Wynik w R
  srednia wariancja
       10        50
[1] 0.908
[1] 8.39
  srednia_sym wariancja_sym
         10.3          53.8
ksztalt   skala
   1.96    5.24
[1] 0.7127 0.7127
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (z pakietem MASS). Rysunek 1 wykonano w pakiecie ggplot2, a panele złożono pakietem patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się parametr skali od parametru tempa w rozkładzie gamma?
Tempo (rate) to odwrotność skali: rate = 1/θ. W R funkcje dgamma() i pgamma() domyślnie przyjmują shape i rate, a skalę trzeba podać jawnie jako scale. Pomyłka zmienia średnią z kθ na k/θ.
Czym rozkład gamma różni się od regresji gamma?
Rozkład gamma opisuje samą zmienną. Regresja gamma zakłada, że warunkowo na predyktorach zmienna zależna ma rozkład gamma, i modeluje jej średnią, zwykle z łączem logarytmicznym.
Kiedy wybrać rozkład gamma, a kiedy lognormalny?
Oba opisują dodatnie, prawoskośne dane. W rozkładzie gamma współczynnik zmienności wynosi 1/√k i jest stały, a rozkład lognormalny ma zwykle cięższy prawy ogon. Porównaj dopasowanie na wykresie Q-Q albo kryterium AIC.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fay, M. P., & Feuer, E. J. (1997). Confidence intervals for directly standardized rates: A method based on the gamma distribution. Statistics in Medicine, 16(7), 791–801. https://doi.org/10.1002/(sici)1097-0258(19970415)16:7<791::aid-sim500>3.0.co;2-#
- Forbes, C., Evans, M., Hastings, N., & Peacock, B. (2010). Statistical distributions (4th ed.). Wiley. https://doi.org/10.1002/9780470627242
- Husak, G. J., Michaelsen, J., & Funk, C. (2007). Use of the gamma distribution to represent monthly rainfall in Africa for drought monitoring applications. International Journal of Climatology, 27(7), 935–944. https://doi.org/10.1002/joc.1441
Cytowania BibTeX
@article{fay1997confidence, author={Fay, Michael P. and Feuer, Eric J.}, title={{Confidence intervals for directly standardized rates: A method based on the gamma distribution}}, journal={Statistics in Medicine}, year={1997}, volume={16}, number={7}, pages={791--801}, doi={10.1002/(sici)1097-0258(19970415)16:7<791::aid-sim500>3.0.co;2-#}}@book{forbes2010statistical, author={Forbes, Catherine and Evans, Merran and Hastings, Nicholas and Peacock, Brian}, title={{Statistical distributions (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470627242}}@article{husak2007use, author={Husak, Gregory J. and Michaelsen, Joel and Funk, Chris}, title={{Use of the gamma distribution to represent monthly rainfall in Africa for drought monitoring applications}}, journal={International Journal of Climatology}, year={2007}, volume={27}, number={7}, pages={935--944}, doi={10.1002/joc.1441}}