Co to jest wartość oczekiwana?
Wartość oczekiwana (ang. expected value, oznaczenie E(X) lub μ) to średnia zmiennej losowej w populacji: suma jej możliwych wartości pomnożonych przez ich prawdopodobieństwa, E(X) = Σ x·P(X = x). Dla zmiennych ciągłych sumę zastępuje całka z x·f(x). To parametr rozkładu, a nie wynik z próby – średnia z próby jest jego oszacowaniem. Już Bernoulli (1738/1954) zaczyna swój wywód od tej reguły: każdy możliwy zysk mnoży się przez liczbę sposobów, na jakie może wystąpić, a sumę dzieli przez liczbę wszystkich przypadków.
Własności
- Liniowość. E(aX + b) = aE(X) + b oraz E(X + Y) = E(X) + E(Y), także dla zmiennych zależnych.
- Związek z wariancją. Wariancja to wartość oczekiwana kwadratu odchylenia: Var(X) = E(X2) − [E(X)]2.
- Znane rozkłady. W rozkładzie dwumianowym E(X) = np, w rozkładzie Poissona – λ, w normalnym – μ.
- Funkcja zmiennej. Zwykle E(g(X)) ≠ g(E(X)): średnia z logarytmów to nie logarytm średniej.
Przykład w R
Za zadanie testowe można dostać 0, 1 lub 2 punkty z prawdopodobieństwami .2, .5 i .3. Wartość oczekiwana wynosi 0·.2 + 1·.5 + 2·.3 = 1.10 punktu, E(X2) = 1.70, a wariancja 1.70 − 1.102 = 0.49. Po przeliczeniu wyniku na 3X + 1 wartość oczekiwana to 4.3. Średnia z próby wylosowanej z tego rozkładu wyniosła 1.2 przy 10 osobach, 1.09 przy 100 i 1.103 przy 10 000 – zbliża się do 1.10, jak mówi prawo wielkich liczb, którego historię od Jakuba Bernoulliego opisuje Seneta (2013).
Na rysunku
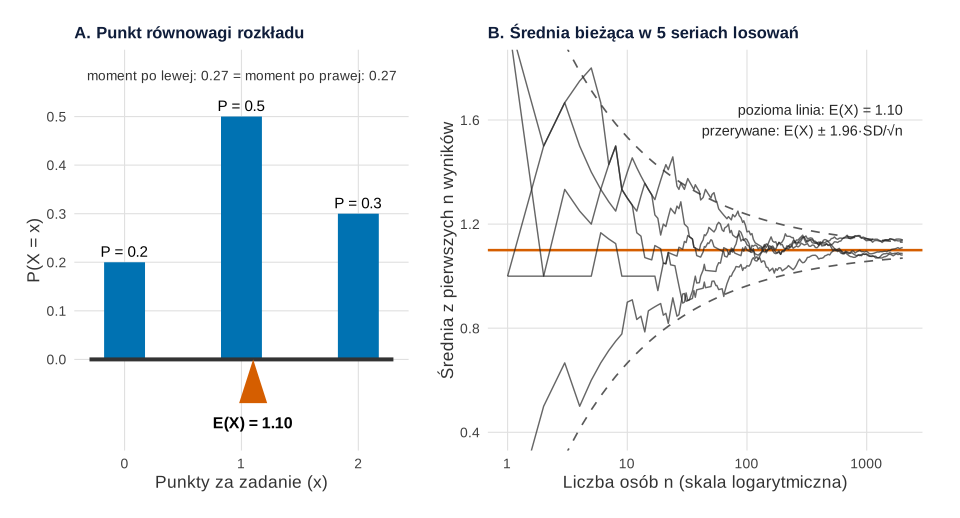
set.seed(4852)).Co widać. Panel A pokazuje rozkład z przykładu jako ciężarki ustawione na belce. Wartość oczekiwana 1.10 to miejsce, w którym belka jest w równowadze: suma iloczynów „prawdopodobieństwo × odległość od podparcia” po lewej stronie (0.2·1.1 + 0.5·0.1) i po prawej (0.3·0.9) wynosi tyle samo, 0.27. Panel B to pięć serii losowań z tego rozkładu, po 2000 osób każda. Po 10 osobach średnie bieżące rozchodzą się od 0.9 do 1.4, po 100 – od 1.04 do 1.17, a po 2000 – od 1.08 do 1.14. Mieszczą się w coraz węższym lejku E(X) ± 1.96·SD/√n, gdzie SD = 0.70. Liczbę serii i długość serii ustawiono ręcznie tak, żeby rysunek był czytelny; ziarna nie zmieniano.
Na co uważać. Oś liczby osób jest logarytmiczna. Lejek zwęża się proporcjonalnie do 1/√n, więc żeby zmniejszyć go o połowę, trzeba czterokrotnie zwiększyć próbę. Lejek wyznacza obszar, w którym średnia z próby tej wielkości leży w około 95% przypadków – pojedyncza seria może więc na chwilę z niego wyjść. Belka z panelu A pokazuje też, dlaczego wartość oczekiwana jest wrażliwa na rzadkie, odległe wyniki: mała waga daleko od podparcia przesuwa punkt równowagi tak samo jak duża waga blisko niego. Rysunek nie pokazuje rozkładów, które wartości oczekiwanej nie mają. Średnią bieżącą z rozkładu Cauchy’ego, która nigdy się nie stabilizuje, pokazuje hasło prawo wielkich liczb.
Podpis do pracy:
Kod rysunku losuje dane z ustalonym ziarnem set.seed(4852) i liczy się w ułamku sekundy. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wartość oczekiwana jako punkt równowagi rozkładu i granica średniej bieżącej
library(ggplot2)
library(patchwork)

# Prosty motyw (kolor nie niesie informacji: serie różnią się etykietą, a pas – typem linii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "none", plot.background = element_rect(fill = "white", colour = NA))

punkty <- c(0, 1, 2); p <- c(0.2, 0.5, 0.3)      # punkty za zadanie i ich prawdopodobieństwa
EX <- sum(punkty * p); SD <- sqrt(sum((punkty - EX)^2 * p))
# Punkt równowagi: suma „momentów” P(x)·(x − E(X)) po obu stronach jest taka sama
lewa  <- sum((p * (EX - punkty))[punkty < EX])
prawa <- sum((p * (punkty - EX))[punkty > EX])
round(c(EX = EX, SD = SD, moment_lewa = lewa, moment_prawa = prawa), 3)

# Panel A: słupki P(X = x) na „belce”, trójkąt podparcia w E(X)
dA <- data.frame(x = punkty, p = p)
podparcie <- data.frame(x = EX + c(-0.12, 0, 0.12), y = c(-0.09, 0, -0.09))
pA <- ggplot(dA, aes(x, p)) +
  geom_col(width = 0.35, fill = "#0072B2") +
  geom_text(aes(label = sprintf("P = %.1f", p)), vjust = -0.5, size = 4) +
  annotate("segment", x = -0.3, xend = 2.3, y = 0, yend = 0, linewidth = 1.4, colour = "grey20") +
  geom_polygon(data = podparcie, aes(x, y), fill = "#D55E00") +
  annotate("text", x = EX, y = -0.13, label = sprintf("E(X) = %.2f", EX), size = 4.2, fontface = "bold") +
  annotate("text", x = 1, y = 0.585, size = 3.6, colour = "grey20",
           label = sprintf("moment po lewej: %.2f = moment po prawej: %.2f", lewa, prawa)) +
  scale_x_continuous(breaks = punkty) + scale_y_continuous(limits = c(-0.15, 0.6), breaks = seq(0, 0.5, 0.1)) +
  labs(title = "A. Punkt równowagi rozkładu", x = "Punkty za zadanie (x)", y = "P(X = x)") +
  motyw

# Panel B: średnia bieżąca w 5 seriach po 2000 osób; przerywane linie = E(X) ± 1.96·SD/√n
set.seed(4852)
N <- 2000; serie <- 5
dB <- do.call(rbind, lapply(1:serie, function(s) {
  x <- sample(punkty, N, replace = TRUE, prob = p)
  data.frame(seria = s, n = 1:N, srednia = cumsum(x) / (1:N))
}))
print(reshape(dB[dB$n %in% c(10, 100, 2000), ], idvar = "seria", timevar = "n", direction = "wide"), row.names = FALSE, digits = 3)
siatka <- unique(round(10^seq(0, log10(N), length.out = 250)))   # do rysunku: 250 punktów na serię
lejek <- data.frame(n = siatka, dol = EX - 1.96 * SD / sqrt(siatka), gora = EX + 1.96 * SD / sqrt(siatka))
pB <- ggplot(dB[dB$n %in% siatka, ], aes(n, srednia, group = seria)) +
  geom_line(data = lejek, aes(n, dol), inherit.aes = FALSE, linetype = "dashed", colour = "grey35") +
  geom_line(data = lejek, aes(n, gora), inherit.aes = FALSE, linetype = "dashed", colour = "grey35") +
  geom_hline(yintercept = EX, colour = "#D55E00", linewidth = 0.9) +
  geom_line(colour = "grey15", alpha = 0.7, linewidth = 0.5) +
  annotate("text", x = N, y = 1.6, label = "pozioma linia: E(X) = 1.10\nprzerywane: E(X) ± 1.96·SD/√n", hjust = 1, size = 3.8, colour = "grey15") +
  scale_x_log10(breaks = c(1, 10, 100, 1000)) + coord_cartesian(ylim = c(0.4, 1.8)) +
  labs(title = "B. Średnia bieżąca w 5 seriach losowań", x = "Liczba osób n (skala logarytmiczna)",
       y = "Średnia z pierwszych n wyników") +
  motyw

wykres <- pA + pB + plot_layout(widths = c(1, 1.3))
wykres
Wynik w R
          EX           SD  moment_lewa moment_prawa
        1.10         0.70         0.27         0.27
 seria srednia.10 srednia.100 srednia.2000
     1        0.9        1.04         1.14
     2        1.4        1.14         1.14
     3        1.3        1.12         1.09
     4        1.0        1.10         1.11
     5        1.3        1.17         1.08
Jak opisać w pracy
Na co uważać
- Nie każdy rozkład ma wartość oczekiwaną. Rozkład Cauchy’ego jej nie ma: w 2000 symulacjach średnia przekraczała 1 co do modułu w 49.6% prób po 10 obserwacji i w 49.1% prób po 1000.
- Estymator a parametr. Estymator, którego wartość oczekiwana równa się parametrowi, to estymator nieobciążony; zbliżanie się do parametru przy rosnącym n opisuje estymator zgodny.
- Wartość oczekiwana to nie wynik typowy. Wynik 1.10 punktu w ogóle nie może wystąpić.
Wartość oczekiwana w R
Kod liczy wartość oczekiwaną, E(X²) i wariancję wyniku za zadanie, sprawdza liniowość, porównuje średnie z prób różnej wielkości z wartością oczekiwaną i pokazuje, że średnie z rozkładu Cauchy’ego się nie stabilizują.
Wartość oczekiwana, wariancja i średnie z prób
R
punkty <- c(0, 1, 2); p <- c(0.2, 0.5, 0.3)  # punkty za zadanie i ich P
EX <- sum(punkty * p); EX2 <- sum(punkty^2 * p)
c(EX = EX, EX2 = EX2, wariancja = EX2 - EX^2)
c(E_3X_plus_1 = 3 * EX + 1)              # liniowość: E(3X + 1)
set.seed(4851)
for (n in c(10, 100, 10000)) print(round(mean(sample(punkty, n, TRUE, p)), 3))
# Cauchy nie ma wartości oczekiwanej: odsetek średnich z |M| > 1
sapply(c(n10 = 10, n1000 = 1000), function(n)
  mean(abs(replicate(2000, mean(rcauchy(n)))) > 1))
Wynik w R
       EX       EX2 wariancja
     1.10      1.70      0.49
E_3X_plus_1
        4.3
[1] 1.2
[1] 1.09
[1] 1.103
  n10 n1000
0.496 0.491
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakietach ggplot2 i patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym wartość oczekiwana różni się od średniej z próby?
Wartość oczekiwana to stały parametr rozkładu w populacji. Średnia z próby jest zmienną losową, która go szacuje i zmienia się od próby do próby; przy rosnącym n zbliża się do wartości oczekiwanej.
Jak policzyć wartość oczekiwaną w R?
Dla zmiennej dyskretnej wystarczy sum(x * p), np. sum(c(0, 1, 2) * c(.2, .5, .3)) daje 1.1. Dla zmiennej ciągłej możesz użyć integrate() z funkcją x·f(x).
Czy wartość oczekiwana musi być jedną z możliwych wartości zmiennej?
Nie. Za zadanie oceniane na 0, 1 lub 2 punkty wartość oczekiwana wynosi 1.10, a w rzucie kostką 3.5, choć takich wyników nie da się uzyskać.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bernoulli, D. (1954). Exposition of a new theory on the measurement of risk. Econometrica, 22(1), 23–36. https://doi.org/10.2307/1909829
- Seneta, E. (2013). A tricentenary history of the law of large numbers. Bernoulli, 19(4), 1088–1121. https://doi.org/10.3150/12-bejsp12 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bernoulli1954exposition, author={Bernoulli, Daniel}, title={{Exposition of a new theory on the measurement of risk}}, journal={Econometrica}, year={1954}, volume={22}, number={1}, pages={23--36}, doi={10.2307/1909829}}@article{seneta2013tricentenary, author={Seneta, Eugene}, title={{A tricentenary history of the law of large numbers}}, journal={Bernoulli}, year={2013}, volume={19}, number={4}, pages={1088--1121}, doi={10.3150/12-bejsp12}}