Co to jest rozkład jednostajny?
Rozkład jednostajny (ang. uniform distribution, też: równomierny, prostokątny) to rozkład, w którym każda wartość z przedziału [a, b] jest jednakowo prawdopodobna. Gęstość ma stałą wysokość f(x) = 1/(b − a) wewnątrz przedziału i zero poza nim, więc wykres wygląda jak prostokąt. Wersja dyskretna przypisuje to samo prawdopodobieństwo każdej z k wartości, np. 1/6 każdemu wynikowi rzutu kostką.
Wzór, średnia i wariancja
- Wartość oczekiwana to środek przedziału: (a + b)/2.
- Wariancja wynosi (b − a)2/12 i zależy tylko od szerokości przedziału.
- Prawdopodobieństwo przedziału jest proporcjonalne do jego długości: P(c < X < d) = (d − c)/(b − a).
- Kształt. Rozkład jest symetryczny, ale bez wierzchołka i ogonów, więc wyraźnie różni się od rozkładu normalnego.
Przykład w R
Dla przedziału [0, 10] średnia wynosi 5, a wariancja 8.33. Prawdopodobieństwo wartości między 2 a 7 wynosi 0.5, bo ten odcinek zajmuje połowę przedziału. W 10 000 losowaniach z runif() średnia wyniosła 5.05, a wariancja 8.20. Dla rzutu kostką średnia to 3.50, a wariancja 2.92.
Rozkład jednostajny jest podstawą symulacji. Generatory liczb pseudolosowych, np. domyślny w R Mersenne Twister (Matsumoto i Nishimura, 1998), dają liczby z przedziału (0, 1), z których powstają próby z innych rozkładów i listy do randomizacji. Drugie ważne zastosowanie to wartość p: gdy hipoteza zerowa jest prawdziwa, a statystyka testowa ciągła, p ma rozkład jednostajny na (0, 1). W 10 000 testach t na danych bez efektu wynik p < .05 wypadł w 4.7% testów, a każdy z pięciu przedziałów szerokości 0.2 zebrał od 1933 do 2048 wyników. Murdoch, Tsai i Adcock (2008) proponują uczyć tego właśnie symulacją, bo wartość p jest zmienną losową.
Na rysunku
Rysunek 1 zestawia obie wersje rozkładu jednostajnego, a rysunek 2 pokazuje jego najważniejsze zastosowanie w analizie danych – rozkład wartości p. Rysunek 2 powstał z tej samej symulacji co przykład wyżej (ziarno 4821, 20 obserwacji w grupie), tylko z węższymi przedziałami.
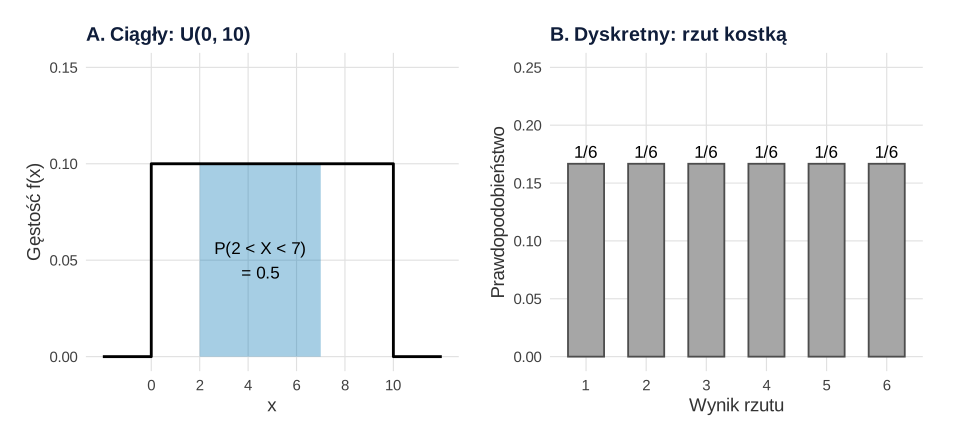
Co widać. W wersji ciągłej gęstość ma stałą wysokość 1/(b − a) = 0.10, więc prawdopodobieństwo przedziału to pole prostokąta: odcinek od 2 do 7 zajmuje połowę szerokości i daje 0.5. W wersji dyskretnej sześć słupków ma tę samą wysokość 1/6.
Na co uważać. Wysokość gęstości nie jest prawdopodobieństwem – dla przedziału [0, 0.5] wynosiłaby 2. W wersji ciągłej pojedynczy punkt ma prawdopodobieństwo zero; sens mają tylko przedziały.
Podpis do pracy:
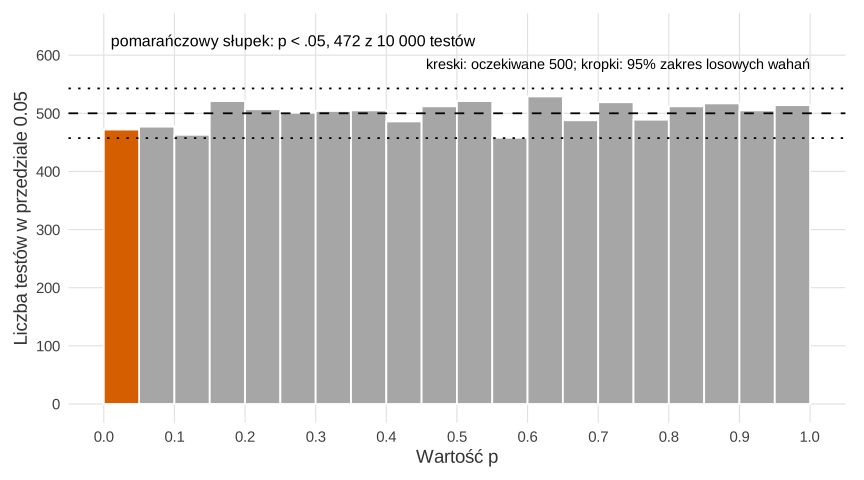
set.seed(4821)).Co widać. Wartości p rozłożyły się w 20 przedziałach prawie równo: od 458 do 529 wyników przy oczekiwanych 500. Żaden przedział nie wyszedł poza 95% zakres losowych wahań (457.3–542.7). Pierwszy słupek to wyniki p < .05: 472 z 10 000, czyli 4.7%, blisko nominalnego α.
Na co uważać. Płaski histogram pokazuje tylko zachowanie testu, gdy efektu nie ma. Nie mówi, jak często test wykrywa efekt, który istnieje – wtedy wartości p skupiają się przy zerze, co widać na histogramie mieszanki prawdziwych i fałszywych hipotez we wpisie Wielokrotne testy w obrazkach. Przy statystykach dyskretnych, np. w dokładnych testach na małych tabelach, rozkład p jest schodkowy, a nie płaski.
Podpis do pracy:
Na stronie rysunki mają motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej. Ziarno 4821 i kolejność losowań są te same co w przykładzie, więc liczby się zgadzają; ziarna nie zmieniano.
Kod R rysunków 1 i 2
# Rysunki 1–2: rozkład jednostajny ciągły i dyskretny oraz wartości p przy prawdziwej H0
library(ggplot2)
library(patchwork)
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", szary = "grey65")  # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1. A: gęstość U(0, 10) i pole P(2 < X < 7); B: rzut kostką
a <- 0; b <- 10
P_2_7 <- punif(7, a, b) - punif(2, a, b)
gest <- data.frame(x = c(-2, a, a, b, b, 12), y = c(0, 0, 1 / (b - a), 1 / (b - a), 0, 0))
p1a <- ggplot(gest, aes(x, y)) +
  annotate("rect", xmin = 2, xmax = 7, ymin = 0, ymax = 1 / (b - a),
           fill = kol[["niebieski"]], alpha = 0.35) +
  geom_path(linewidth = 1) +
  annotate("text", x = 4.5, y = 0.05, label = paste0("P(2 < X < 7)\n= ", P_2_7), size = 4.5) +
  scale_x_continuous(breaks = seq(0, 10, 2)) +
  scale_y_continuous(limits = c(0, 0.15)) +
  labs(title = "A. Ciągły: U(0, 10)", x = "x", y = "Gęstość f(x)") + motyw
kostka <- data.frame(wynik = 1:6, p = 1 / 6)
p1b <- ggplot(kostka, aes(factor(wynik), p)) +
  geom_col(width = 0.6, fill = kol[["szary"]], colour = "grey30") +
  geom_text(aes(label = "1/6"), vjust = -0.5, size = 4.5) +
  scale_y_continuous(limits = c(0, 0.25)) +
  labs(title = "B. Dyskretny: rzut kostką", x = "Wynik rzutu", y = "Prawdopodobieństwo") + motyw
p1 <- p1a + p1b

# Rysunek 2. 10 000 testów t przy prawdziwej H0 (to samo ziarno i kolejność losowań co w przykładzie)
set.seed(4821)
x <- runif(10000, a, b)                        # losowanie z przykładu – zachowuje sekwencję liczb
p <- replicate(10000, t.test(rnorm(20), rnorm(20))$p.value)
przedzialy <- table(cut(p, seq(0, 1, 0.05)))   # 20 przedziałów szerokości 0.05
oczek <- 10000 * 0.05                          # oczekiwana liczba wyników w przedziale
pasmo <- oczek + c(-1.96, 1.96) * sqrt(10000 * 0.05 * 0.95)  # 95% zakres losowych wahań
round(c(oczekiwana = oczek, pasmo_dol = pasmo[1], pasmo_gora = pasmo[2]), 1)
c(najmniej = min(przedzialy), najwiecej = max(przedzialy), p_ponizej_05 = przedzialy[[1]])
sum(przedzialy < pasmo[1] | przedzialy > pasmo[2])   # przedziały poza 95% zakresem
p2 <- ggplot(data.frame(p), aes(p, fill = p < .05)) +
  geom_histogram(breaks = seq(0, 1, 0.05), colour = "white", closed = "right") +
  geom_hline(yintercept = oczek, linetype = "dashed") +
  geom_hline(yintercept = pasmo, linetype = "dotted") +
  annotate("text", x = 0.01, y = 625, hjust = 0, size = 4.2,
           label = paste0("pomarańczowy słupek: p < .05, ", przedzialy[[1]], " z 10 000 testów")) +
  annotate("text", x = 1, y = 585, hjust = 1, size = 3.8,
           label = "kreski: oczekiwane 500; kropki: 95% zakres losowych wahań") +
  scale_fill_manual(values = c(`TRUE` = kol[["cynober"]], `FALSE` = kol[["szary"]]), guide = "none") +
  scale_x_continuous(breaks = seq(0, 1, 0.1)) +
  scale_y_continuous(limits = c(0, 640), breaks = seq(0, 600, 100)) +
  labs(x = "Wartość p", y = "Liczba testów w przedziale 0.05") + motyw
p1
p2
Wynik w R
oczekiwana  pasmo_dol pasmo_gora
     500.0      457.3      542.7
    najmniej    najwiecej p_ponizej_05
         458          529          472
[1] 0
Jak opisać w pracy
Na co uważać
- Zbyt dużo małych p. Gdy w wielu analizach bez efektu wartości p skupiają się przy zerze, test może mieć zawyżony błąd I rodzaju. Interpretację p wyjaśnia wpis wartość p – interpretacja.
- Losowanie w praktyce. Do przydziału uczestników używaj generatora z zapisanym ziarnem, np. generatora listy randomizacji, a nie „losowania z głowy”.
Rozkład jednostajny w R
Kod liczy średnią, wariancję i prawdopodobieństwo przedziału dla rozkładu jednostajnego na [0, 10], porównuje je z symulacją, liczy to samo dla rzutu kostką i pokazuje rozkład wartości p przy prawdziwej hipotezie zerowej.
Średnia, wariancja i rozkład wartości p
R
a <- 0; b <- 10                          # rozkład jednostajny na [0, 10]
c(srednia = (a + b) / 2, wariancja = round((b - a)^2 / 12, 2))
punif(7, a, b) - punif(2, a, b)          # P(2 < X < 7)
set.seed(4821)
x <- runif(10000, a, b)
round(c(srednia_sym = mean(x), wariancja_sym = var(x)), 2)
kostka <- 1:6                            # dyskretny: rzut kostką
round(c(srednia = mean(kostka), wariancja = mean((kostka - 3.5)^2)), 2)
p <- replicate(10000, t.test(rnorm(20), rnorm(20))$p.value)  # H0 prawdziwa
round(c(p_ponizej_05 = mean(p < .05), p_ponizej_50 = mean(p < .50)), 3)
table(cut(p, seq(0, 1, 0.2)))
Wynik w R
  srednia wariancja
     5.00      8.33
[1] 0.5
  srednia_sym wariancja_sym
         5.05          8.20
  srednia wariancja
     3.50      2.92
p_ponizej_05 p_ponizej_50
       0.047        0.495

  (0,0.2] (0.2,0.4] (0.4,0.6] (0.6,0.8]   (0.8,1]
     1933      2017      1977      2025      2048
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w przykładzie nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2, a panele złożono pakietem patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego wartości p mają rozkład jednostajny, gdy nie ma efektu?
Przy prawdziwej hipotezie zerowej i ciągłej statystyce testowej P(p ≤ α) = α dla każdego α. W symulacji 10 000 testów t odsetek p < .05 wyniósł .047, a p < .50 – .495.
Jak w R wylosować liczby z rozkładu jednostajnego?
runif(n, min, max) losuje liczby ciągłe, np. runif(10000, 0, 10). Dla wartości dyskretnych, np. rzutu kostką, użyj sample(1:6, n, replace = TRUE). Przed losowaniem ustaw set.seed(), by wynik dało się powtórzyć.
Czy rozkład jednostajny jest symetryczny?
Tak. Średnia i mediana leżą w środku przedziału, a skośność wynosi zero. Rozkład nie ma jednak wierzchołka ani ogonów, więc ma kurtozę niższą niż rozkład normalny.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995 ● Otwarty dostęp: pełny tekst
- Murdoch, D. J., Tsai, Y.-L., & Adcock, J. (2008). P-values are random variables. The American Statistician, 62(3), 242–245. https://doi.org/10.1198/000313008X332421
Cytowania BibTeX
@article{matsumoto1998mersenne, author={Matsumoto, Makoto and Nishimura, Takuji}, title={{Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator}}, journal={ACM Transactions on Modeling and Computer Simulation}, year={1998}, volume={8}, number={1}, pages={3--30}, doi={10.1145/272991.272995}}@article{murdoch2008pvalues, author={Murdoch, Duncan J. and Tsai, Yu-Ling and Adcock, James}, title={{P-values are random variables}}, journal={The American Statistician}, year={2008}, volume={62}, number={3}, pages={242--245}, doi={10.1198/000313008x332421}}