Jeden test to obietnica, dwadzieścia testów – loteria
Poziom istotności α = .05 obiecuje jedno: jeśli efektu nie ma, pojedynczy zaplanowany test da fałszywy alarm w 5% przypadków. W pracy dyplomowej testów jest zwykle kilkanaście (skale, podskale, podgrupy, korelacje) i wtedy pojawia się problem wielokrotnych porównań – rośnie szansa, że któryś z wyników będzie „istotny” tylko przez przypadek, czyli że popełnisz błąd I rodzaju.
Ten wpis nie powtarza definicji ani opisu poprawek – metody krok po kroku znajdziesz we wpisie poprawki na wielokrotne porównania, a to, czym jest wartość p i jak się zachowuje w pojedynczym badaniu – w tekście wartość p – interpretacja. Tu pokazujemy pięć symulacji w R, w których znamy prawdę. Przy każdym rysunku: co widać, czego wykres nie pokazuje, gotowy podpis i zdanie do pracy.
Dane są symulowane; każdy blok kodu zaczyna się od set.seed(567) – ziarno ustaliliśmy raz i nie dobieraliśmy go pod obraz. Przy odsetkach z wielu powtórzeń podajemy błąd Monte Carlo (MC).
Rysunek 1: dwadzieścia testów, żadnego efektu
Wyobraź sobie badanie, w którym dwie grupy po 30 osób porównujesz testem t dla prób niezależnych na 20 skalach. W symulacji obie grupy pochodzą z tej samej populacji, więc każda „istotna” różnica jest fałszywym alarmem. Takie badanie powtórzyliśmy 100 razy.
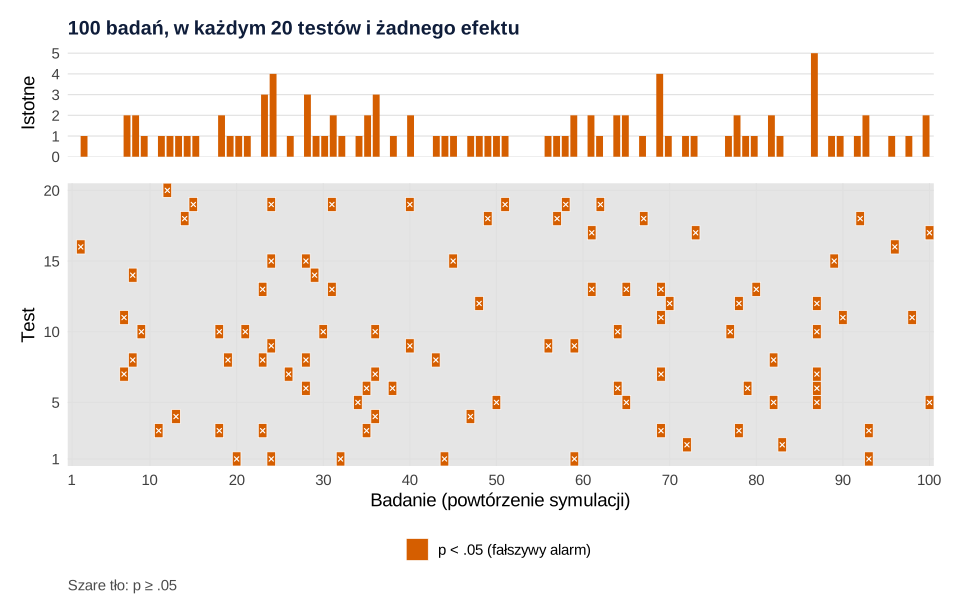
set.seed(567)).Co widać. Na 2000 testów 91 dało p < .05, czyli 4.55% – dokładnie tyle, ile obiecuje α. Problem widać dopiero w słupkach: 61 ze 100 badań ma przynajmniej jeden istotny wynik, a kilka ma ich trzy, cztery, a nawet pięć. Wzór 1 − 0.9520 daje .642, więc symulacja zgadza się z teorią. Fałszywe alarmy są rozsiane bez wzoru.
Czego ten wykres nie pokazuje. Że tak samo wygląda Twoje jedno badanie – tylko widzisz jeden wiersz siatki, a nie sto. Badanie z dwoma istotnymi wynikami na 20 wygląda jak odkrycie, choć w tej symulacji jest zwykłym szumem.
Podpis do pracy (np. w aneksie albo w prezentacji na obronę, gdy uzasadniasz korektę):
Zdanie do pracy (w opisie analiz, gdy testujesz wiele zmiennych):
Kod rysunku 1: siatka 100 badań × 20 testów
Uruchamiaj bloki po kolei w jednej sesji R – kolejne korzystają z motywu i palety z bloku 1, a bloki 3 i 4 – z tych samych 1000 wartości p. Te wartości pobierzesz też jako plik wielokrotne-testy-1000-wartosci-p.csv. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano jako SVG (w kodzie – zakomentowane wywołanie ggsave()). Paleta to kolory Okabe–Ito, a fałszywe alarmy odróżnia od reszty nie tylko kolor, ale też krzyżyk, kształt punktu albo rodzaj linii.
1. Motyw, paleta i 2000 testów t przy prawdziwej H0
R
# Rysunek 1. 100 powtórzeń badania z 20 testami t, wszystkie hipotezy zerowe prawdziwe (dane symulowane)
library(ggplot2)
library(patchwork)

# Motyw i paleta (Okabe–Ito: czytelna przy zaburzeniach widzenia barw)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), legend.position = "bottom",
        plot.caption = element_text(colour = "grey30", hjust = 0, size = rel(0.8)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
KOL <- c(alarm = "#D55E00", efekt = "#0072B2", h0 = "grey70", linia = "grey25", trzeci = "#E69F00")

set.seed(567)                     # ziarno ustalone raz, bez dobierania pod wynik
m <- 20; powtorzenia <- 100; n <- 30
siatka <- expand.grid(test = 1:m, badanie = 1:powtorzenia)
# każdy test: dwie grupy po 30 osób z tej samej populacji N(0, 1) – różnicy nie ma
siatka$p <- replicate(nrow(siatka), t.test(rnorm(n), rnorm(n), var.equal = TRUE)$p.value)
siatka$istotny <- siatka$p < .05

na_badanie <- aggregate(istotny ~ badanie, data = siatka, FUN = sum)
data.frame(testy = nrow(siatka), istotne = sum(siatka$istotny), odsetek = mean(siatka$istotny),
           badania_z_choc_jednym = sum(na_badanie$istotny > 0), wzor_1_minus_095_do_20 = round(1 - 0.95^m, 3))
table(liczba_istotnych_w_badaniu = na_badanie$istotny)

gora <- ggplot(na_badanie, aes(badanie, istotny)) +
  geom_col(fill = KOL[["alarm"]], width = 0.8) +
  scale_y_continuous(breaks = 0:5, expand = expansion(mult = c(0, 0.05))) +
  scale_x_continuous(expand = expansion(add = 0.5)) +
  labs(x = NULL, y = "Istotne", title = "100 badań, w każdym 20 testów i żadnego efektu") + motyw +
  theme(axis.text.x = element_blank(), panel.grid.major.x = element_blank())
dol <- ggplot(subset(siatka, istotny), aes(badanie, test)) +       # rysujemy tylko pola z p < .05; tło = p ≥ .05
  geom_tile(aes(fill = "p < .05 (fałszywy alarm)"), colour = "white", linewidth = 0.25) +
  geom_point(shape = 4, size = 1.1, colour = "white", stroke = 0.6) +
  scale_fill_manual(values = KOL[["alarm"]], name = NULL) +
  scale_x_continuous(limits = c(0.5, 100.5), breaks = c(1, seq(10, 100, 10)), expand = c(0, 0)) +
  scale_y_continuous(limits = c(0.5, 20.5), breaks = c(1, 5, 10, 15, 20), expand = c(0, 0)) +
  labs(x = "Badanie (powtórzenie symulacji)", y = "Test", caption = "Szare tło: p ≥ .05") + motyw +
  theme(panel.grid = element_blank(), panel.background = element_rect(fill = "grey90", colour = NA))
p1 <- gora / dol + plot_layout(heights = c(1, 2.6))
# p1   # wyświetl; zapis: ggsave("dwadziescia-testow.svg", p1, width = 10, height = 6.4)
Wynik w R
  testy istotne odsetek badania_z_choc_jednym wzor_1_minus_095_do_20
1  2000      91  0.0455                    61                  0.642
liczba_istotnych_w_badaniu
 0  1  2  3  4  5
39 41 14  3  2  1
Rysunek 2: krzywa rodzinnego błędu I rodzaju
Szansę na co najmniej jeden fałszywy alarm w całej rodzinie testów nazywa się rodzinnym błędem I rodzaju (FWER). Dla m niezależnych testów liczy się ją ze wzoru 1 − 0.95m. Samą krzywą pokazujemy w haśle o korekcie Bonferroniego, więc tu sprawdzamy coś innego: co się dzieje, gdy testy są ze sobą skorelowane. Tak bywa przy podskalach jednego kwestionariusza; każdy punkt to 10 000 badań.
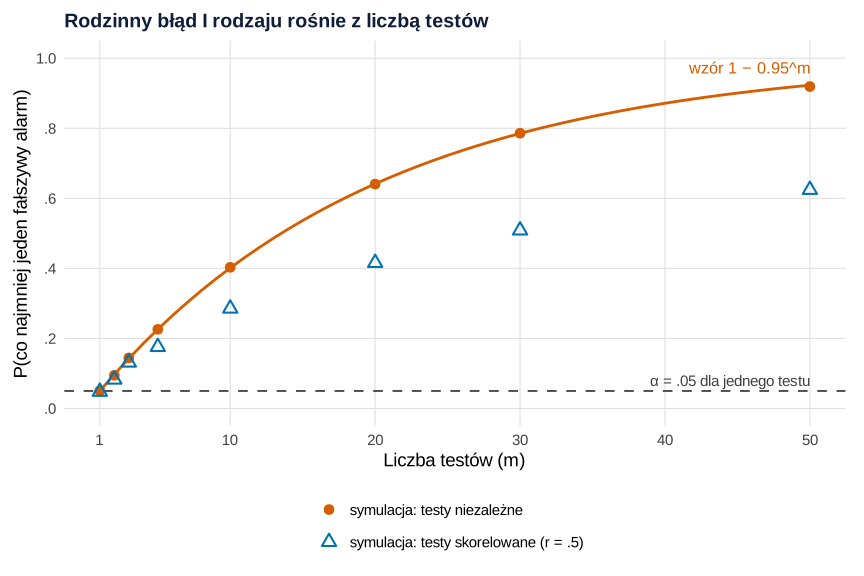
Co widać. Punkty dla testów niezależnych leżą na krzywej: przy 20 testach 64.1% (błąd MC 0.5 pp), przy 50 – 91.9%. Testy skorelowane (r = .5) rosną wolniej: 41.6% przy 20 i 62.4% przy 50 testach. To nadal wielokrotnie więcej niż 5%. Średnia liczba fałszywych alarmów jest w obu wariantach taka sama i wynosi około 0.05 × m (przy 20 testach 0.997 i 0.955). Korelacja nie zmniejsza więc liczby fałszywych alarmów, tylko je skupia – częściej przychodzą parami.
Czego ten wykres nie pokazuje. Że korelacja „rozwiązuje” problem – przy 50 skorelowanych testach fałszywy alarm nadal pojawia się w 62% badań. Nie pokazuje też ceny kontroli błędu, czyli spadku mocy (zob. moc testu w obrazkach). Korekta Bonferroniego przy skorelowanych testach jest bardziej zachowawcza, niż musi; procedura Benjaminiego–Hochberga kontroluje FDR także przy dodatniej zależności testów (Benjamini i Yekutieli, 2001).
Podpis do pracy:
Zdanie do pracy (gdy recenzent pyta, czy przy skorelowanych podskalach korekta jest potrzebna):
Kod rysunku 2: FWER ze wzoru i z symulacji
2. Testy niezależne i skorelowane, 10 000 badań w każdym punkcie
R
# Rysunek 2. FWER = 1 − 0.95^m: wzór i symulacja dla testów niezależnych i skorelowanych (kontynuacja: motyw, KOL)
set.seed(567)
B <- 10000                                    # liczba symulowanych badań w każdym punkcie
liczby_testow <- c(1, 2, 3, 5, 10, 20, 30, 50)
# m statystyk z ~ N(0, 1) (wszystkie H0 prawdziwe); rho = korelacja między testami (np. podskale jednej skali)
symuluj_fwer <- function(m, rho) {
  wspolny <- rnorm(B)
  Z <- sqrt(rho) * wspolny + sqrt(1 - rho) * matrix(rnorm(B * m), B, m)
  istotne <- rowSums(2 * pnorm(-abs(Z)) < .05)
  c(m = m, rho = rho, fwer = mean(istotne > 0), blad_mc = sqrt(mean(istotne > 0) * (1 - mean(istotne > 0)) / B),
    srednio_falszywych = mean(istotne))
}
sym <- as.data.frame(do.call(rbind, lapply(c(0, 0.5), function(r) t(sapply(liczby_testow, symuluj_fwer, rho = r)))))
sym$wzor <- 1 - 0.95^sym$m
round(sym, 3)

krzywa <- data.frame(m = 1:50, fwer = 1 - 0.95^(1:50))
sym$typ <- factor(ifelse(sym$rho == 0, "symulacja: testy niezależne", "symulacja: testy skorelowane (r = .5)"))
p2 <- ggplot(sym, aes(m, fwer)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = KOL[["linia"]]) +
  geom_line(data = krzywa, colour = KOL[["alarm"]], linewidth = 1) +
  geom_point(aes(shape = typ, colour = typ), size = 3, stroke = 1.1) +
  scale_shape_manual(values = c(16, 2), name = NULL) +
  scale_colour_manual(values = c(KOL[["alarm"]], KOL[["efekt"]]), name = NULL) +
  annotate("text", x = 50, y = 1 - 0.95^50 + 0.05, label = "wzór 1 − 0.95^m", hjust = 1, colour = KOL[["alarm"]], size = 4.3) +
  annotate("text", x = 50, y = 0.08, label = "α = .05 dla jednego testu", hjust = 1, colour = KOL[["linia"]], size = 4) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) sub("^0\\.", ".", format(x))) +
  scale_x_continuous(breaks = c(1, 10, 20, 30, 40, 50)) +
  labs(x = "Liczba testów (m)", y = "P(co najmniej jeden fałszywy alarm)",
       title = "Rodzinny błąd I rodzaju rośnie z liczbą testów") +
  motyw + guides(shape = guide_legend(nrow = 2), colour = guide_legend(nrow = 2))
# p2   # zapis: ggsave("krzywa-fwer.svg", p2, width = 9, height = 6)
Wynik w R
    m rho  fwer blad_mc srednio_falszywych  wzor
1   1 0.0 0.050   0.002              0.050 0.050
2   2 0.0 0.095   0.003              0.097 0.098
3   3 0.0 0.144   0.004              0.152 0.143
4   5 0.0 0.226   0.004              0.247 0.226
5  10 0.0 0.403   0.005              0.506 0.401
6  20 0.0 0.641   0.005              0.997 0.642
7  30 0.0 0.786   0.004              1.515 0.785
8  50 0.0 0.919   0.003              2.515 0.923
9   1 0.5 0.048   0.002              0.048 0.050
10  2 0.5 0.083   0.003              0.092 0.098
11  3 0.5 0.131   0.003              0.160 0.143
12  5 0.5 0.176   0.004              0.242 0.226
13 10 0.5 0.286   0.005              0.480 0.401
14 20 0.5 0.416   0.005              0.955 0.642
15 30 0.5 0.509   0.005              1.529 0.785
16 50 0.5 0.624   0.005              2.572 0.923
Rysunek 3: rozkład wartości p, gdy część efektów istnieje
Prawdziwe badania mieszają oba światy: część hipotez zerowych jest prawdziwa, część nie. Symulujemy 1000 porównań dwóch grup po 50 osób: w 800 różnicy nie ma, a w 200 istnieje efekt d = 0.5. Moc pojedynczego testu wynosi wtedy .697. Rozkłady p w każdym ze światów osobno pokazujemy we wpisie o wartości p; tu patrzymy na ich sumę, bo tylko taką widzi badacz.
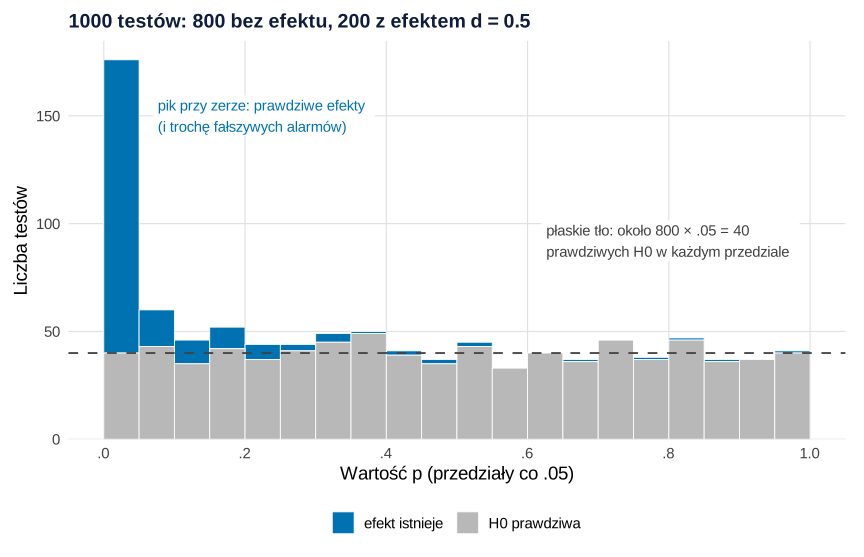
Co widać. Dwie warstwy. Prawdziwe hipotezy zerowe tworzą płaskie tło – około 40 testów w każdym przedziale, bo przy prawdziwej H0 wartość p ma rozkład jednostajny. Prawdziwe efekty tworzą pik przy zerze. W pierwszym słupku (p < .05) jest 176 testów, ale 40 z nich to fałszywe alarmy: 22.7% „odkryć” jest fałszywych, choć każdy test z osobna trzymał α = .05. Tak wygląda intuicja odsetka fałszywych odkryć (FDR). Colquhoun (2014) pokazuje na podobnych symulacjach, że w badaniach o małej mocy fałszywe odkrycia mogą stanowić nawet większość istotnych wyników.
Czego ten wykres nie pokazuje. Kolorów. W prawdziwych danych nie wiesz, który test jest szary, a który niebieski. Wysokość tła da się jednak oszacować z prawej części histogramu, gdzie prawie nie ma efektów: 401 wartości p > .5 daje oszacowanie 802 prawdziwych H0 przy faktycznych 800. Na tym pomyśle opiera się wartość q Storeya. Przy 20 testach histogram jest za mały – to rysunek dla setek testów.
Podpis do pracy:
Zdanie do pracy (w dyskusji, gdy testów było dużo, a wyniki są eksploracyjne):
Kod rysunku 3: mieszanka prawdziwych i fałszywych H0
3. 1000 wartości p: 800 bez efektu, 200 z efektem
R
# Rysunek 3. Rozkład 1000 wartości p: 800 prawdziwych H0 i 200 prawdziwych efektów (kontynuacja: motyw, KOL)
set.seed(567)
m0 <- 800; m1 <- 200; n <- 50; d <- 0.5; df <- 2 * n - 2
# statystyka t z testu t Studenta dla dwóch grup po 50 osób: przy H0 rozkład t(98),
# przy efekcie d = 0.5 – niecentralny t(98) z parametrem d * sqrt(n / 2) (to samo, co losowanie danych i t.test)
mix <- data.frame(prawda = rep(c("H0 prawdziwa", "efekt istnieje"), c(m0, m1)),
                  t = c(rt(m0, df), rt(m1, df, ncp = d * sqrt(n / 2))))
mix$p <- 2 * pt(-abs(mix$t), df)
mix$prawda <- factor(mix$prawda, levels = c("efekt istnieje", "H0 prawdziwa"))

power.t.test(n = n, delta = d, sd = 1)$power          # moc pojedynczego testu przy efekcie
table(mix$prawda, istotny = mix$p < .05)
c(istotne = sum(mix$p < .05), falszywe_wsrod_istotnych = round(mean(mix$prawda[mix$p < .05] == "H0 prawdziwa"), 3))
# poziom „płaskiego tła”: wartości p > .5 to prawie same prawdziwe H0, więc ich liczba / 0.5 szacuje m0
c(p_powyzej_05 = sum(mix$p > .5), m0_oszacowane = sum(mix$p > .5) / 0.5, tlo_na_przedzial = sum(mix$p > .5) / 0.5 * 0.05)

p3 <- ggplot(mix, aes(p, fill = prawda)) +
  geom_histogram(breaks = seq(0, 1, 0.05), colour = "white", linewidth = 0.3) +
  geom_hline(yintercept = m0 * 0.05, linetype = "dashed", colour = KOL[["linia"]]) +
  annotate("label", x = 0.62, y = 92, label = "płaskie tło: około 800 × .05 = 40\nprawdziwych H0 w każdym przedziale",
           hjust = 0, size = 3.9, border.colour = NA, fill = "white", colour = KOL[["linia"]]) +
  annotate("label", x = 0.07, y = 150, label = "pik przy zerze: prawdziwe efekty\n(i trochę fałszywych alarmów)",
           hjust = 0, size = 3.9, border.colour = NA, fill = "white", colour = KOL[["efekt"]]) +
  scale_fill_manual(values = c(`efekt istnieje` = KOL[["efekt"]], `H0 prawdziwa` = "grey72"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = function(x) sub("^0\\.", ".", format(x))) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.05))) +
  labs(x = "Wartość p (przedziały co .05)", y = "Liczba testów", title = "1000 testów: 800 bez efektu, 200 z efektem d = 0.5") +
  motyw
# p3   # zapis: ggsave("histogram-p.svg", p3, width = 9, height = 5.8)
Wynik w R
[1] 0.6968888
                istotny
                 FALSE TRUE
  efekt istnieje    64  136
  H0 prawdziwa     760   40
                 istotne falszywe_wsrod_istotnych
                 176.000                    0.227
    p_powyzej_05    m0_oszacowane tlo_na_przedzial
           401.0            802.0             40.1
Rysunek 4: posortowane p i trzy progi
Te same 1000 wartości p ustawiamy od najmniejszej do największej. Schweder i Spjøtvoll (1982) zaproponowali taki wykres do oceny wielu testów naraz: wartości p prawdziwych hipotez zerowych układają się wzdłuż prostej, a fałszywe od niej odstają. Na ten sam wykres można nanieść progi trzech procedur. Bonferroni to stały próg .05/m. Holm (1979) to schodki .05/(m − i + 1). Benjamini i Hochberg (1995) to prosta i/m × .05 – odrzucasz wszystkie hipotezy aż do ostatniego punktu, który leży pod tą prostą.
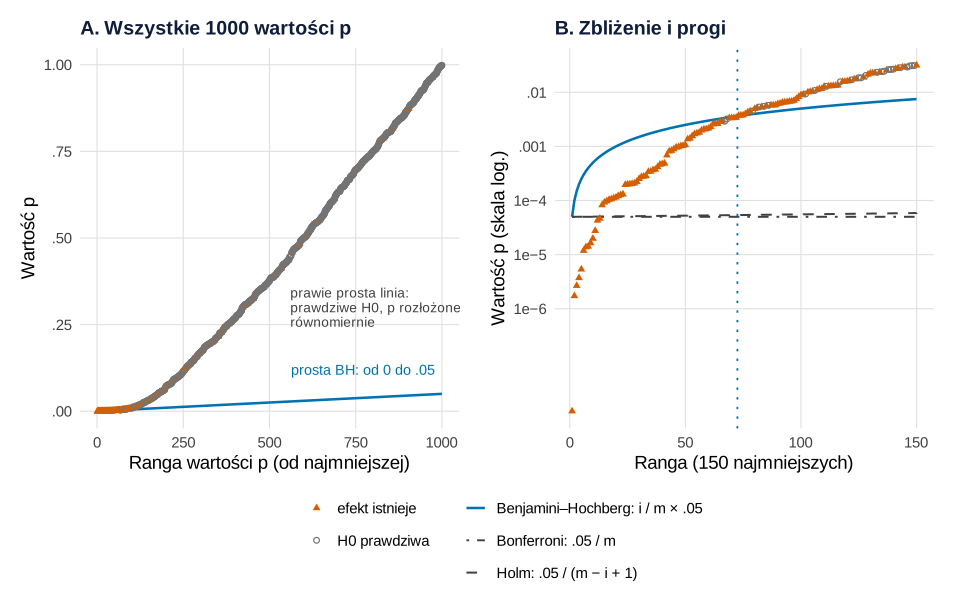
Co widać. W panelu A punkty od rangi około 200 do 1000 tworzą prawie prostą – to płaskie tło z rysunku 3 widziane z innej strony. W panelu B progi Bonferroniego i Holma niemal się pokrywają, bo przy 1000 testach schodki Holma rosną bardzo powoli. Obie procedury odrzucają po 13 hipotez, bez żadnego fałszywego odkrycia. Prosta Benjaminiego–Hochberga rośnie z rangą i odrzuca 72 hipotezy (ostatnia: p = .0034 przy progu .0036), w tym 2 fałszywe – to 2.8%. W 2000 powtórzeń całego badania średni odsetek fałszywych odkryć wyniósł: bez korekty .222, po Bonferronim .004, po BH .040 (błąd MC .0006). Wartość .040 to dokładnie .05 × 800/1000, tyle ile przewiduje teoria. Moc była jednak bardzo różna: .697 bez korekty, .048 po Bonferronim i .309 po BH.
Czego ten wykres nie pokazuje. Że BH jest „lepszy”. Kontroluje inny błąd: w 91.1% powtórzeń przepuścił co najmniej jeden fałszywy alarm, ale fałszywe alarmy stanowiły średnio tylko 4% odkryć. Wniosek oparty na pojedynczym wyniku wymaga kontroli FWER; przegląd wielu zmiennych w poszukiwaniu kandydatów – kontroli FDR. Ten sam problem przy macierzy korelacji opisujemy we wpisie korelacje na wykresie.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 4: progi i 2000 powtórzeń
4. Bonferroni, Holm i Benjamini–Hochberg na jednym wykresie
R
# Rysunek 4. Posortowane wartości p z rysunku 3 i progi Bonferroniego, Holma i Benjaminiego–Hochberga
# (kontynuacja: mix, m0, m1, n, d, df, motyw, KOL)
m <- nrow(mix); q <- .05
mix <- mix[order(mix$p), ]
mix$ranga <- 1:m
mix$prog_bonf <- q / m                          # stały próg
mix$prog_holm <- q / (m - mix$ranga + 1)        # schodki Holma
mix$prog_bh <- mix$ranga / m * q                # prosta Benjaminiego–Hochberga
odrzucone <- data.frame(
  metoda = c("bez korekty", "Bonferroni", "Holm", "Benjamini–Hochberg"),
  odkrycia = c(sum(mix$p < q), sum(p.adjust(mix$p, "bonferroni") < q), sum(p.adjust(mix$p, "holm") < q),
               sum(p.adjust(mix$p, "BH") < q)))
odrzucone$falszywe <- sapply(c("none", "bonferroni", "holm", "BH"),
                             function(k) sum(p.adjust(mix$p, k) < q & mix$prawda == "H0 prawdziwa"))
odrzucone$odsetek_falszywych <- round(odrzucone$falszywe / odrzucone$odkrycia, 3)
odrzucone
k_bh <- max(which(mix$p <= mix$prog_bh)); c(k_bh = k_bh, p_k = signif(mix$p[k_bh], 3), prog_k = mix$prog_bh[k_bh])

# Te same procedury w 2000 powtórzeń całego „badania” (FDR, FWER i moc to średnie po powtórzeniach)
set.seed(567)
R <- 2000
wyniki <- replicate(R, {
  p <- 2 * pt(-abs(c(rt(m0, df), rt(m1, df, ncp = d * sqrt(n / 2)))), df)
  efekt <- rep(c(FALSE, TRUE), c(m0, m1))
  sapply(c("none", "bonferroni", "holm", "BH"), function(k) {
    odrz <- p.adjust(p, k) < q
    c(FDR = sum(odrz & !efekt) / max(sum(odrz), 1), FWER = any(odrz & !efekt), moc = mean(odrz[efekt]))
  })
})                                                 # tablica 3 × 4 × 2000
round(apply(wyniki, 1:2, mean), 3)                 # średnie po powtórzeniach
round(apply(wyniki, 1:2, sd) / sqrt(R), 4)         # błąd Monte Carlo tych średnich

pA <- ggplot(mix, aes(ranga, p)) +
  geom_line(aes(y = prog_bh), colour = KOL[["efekt"]], linewidth = 0.9) +
  geom_point(aes(colour = prawda, shape = prawda), size = 1.6) +
  annotate("text", x = 980, y = 0.12, label = "prosta BH: od 0 do .05", hjust = 1, colour = KOL[["efekt"]], size = 3.8) +
  annotate("text", x = 560, y = 0.3, label = "prawie prosta linia:\nprawdziwe H0, p rozłożone\nrównomiernie", hjust = 0,
           colour = KOL[["linia"]], size = 3.6, lineheight = 0.9) +
  scale_colour_manual(values = c(`efekt istnieje` = KOL[["alarm"]], `H0 prawdziwa` = "grey45"), name = NULL) +
  scale_shape_manual(values = c(`efekt istnieje` = 17, `H0 prawdziwa` = 1), name = NULL) +
  scale_y_continuous(breaks = seq(0, 1, 0.25), labels = function(x) sub("^0\\.", ".", format(x))) +
  labs(x = "Ranga wartości p (od najmniejszej)", y = "Wartość p", title = "A. Wszystkie 1000 wartości p") + motyw
pB <- ggplot(subset(mix, ranga <= 150), aes(ranga, p)) +
  geom_line(aes(y = prog_bh, linetype = "Benjamini–Hochberg: i / m × .05"), colour = KOL[["efekt"]], linewidth = 0.9) +
  geom_step(aes(y = prog_holm, linetype = "Holm: .05 / (m − i + 1)"), colour = KOL[["linia"]], linewidth = 0.7) +
  geom_line(aes(y = prog_bonf, linetype = "Bonferroni: .05 / m"), colour = KOL[["linia"]], linewidth = 0.7) +
  geom_vline(xintercept = k_bh + 0.5, colour = KOL[["efekt"]], linetype = "dotted") +
  geom_point(aes(colour = prawda, shape = prawda), size = 1.6) +
  scale_colour_manual(values = c(`efekt istnieje` = KOL[["alarm"]], `H0 prawdziwa` = "grey45"), name = NULL) +
  scale_shape_manual(values = c(`efekt istnieje` = 17, `H0 prawdziwa` = 1), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotdash", "dashed"), name = NULL) +
  scale_y_log10(breaks = 10^(-6:0), labels = c("1e−6", "1e−5", "1e−4", ".001", ".01", ".1", "1")) +
  labs(x = "Ranga (150 najmniejszych)", y = "Wartość p (skala log.)", title = "B. Zbliżenie i progi") + motyw
p4 <- (pA | pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom") &
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), linetype = guide_legend(nrow = 3))
# p4   # zapis: ggsave("posortowane-p.svg", p4, width = 10, height = 6.4)
Wynik w R
              metoda odkrycia falszywe odsetek_falszywych
1        bez korekty      176       40              0.227
2         Bonferroni       13        0              0.000
3               Holm       13        0              0.000
4 Benjamini–Hochberg       72        2              0.028
    k_bh      p_k   prog_k
72.00000  0.00342  0.00360
      none bonferroni  holm    BH
FDR  0.222      0.004 0.004 0.040
FWER 1.000      0.036 0.036 0.911
moc  0.697      0.048 0.048 0.309
      none bonferroni   holm     BH
FDR  6e-04     0.0004 0.0004 0.0006
FWER 0e+00     0.0042 0.0042 0.0064
moc  7e-04     0.0003 0.0003 0.0012
Rysunek 5: ogród rozwidlających się ścieżek
Wielokrotne testy nie muszą być widoczne. Ogród rozwidlających się ścieżek to określenie Gelmana i Lokena (2014) na analizę, której postać wybiera się po zobaczeniu danych. Badacz wykonuje jeden test, ale przy innych danych wybrałby inny. Symulujemy taki ogród: 10 000 badań z dwiema grupami po 30 osób, bez żadnej różnicy w populacji. Każde badanie ma trzy rozsądne rozwidlenia:
- miara wyniku: skala A, skala B (skorelowane, r = .5) albo ich średnia,
- wartości odstające: zostawić albo usunąć wyniki dalsze niż 2.5 SD od średniej grupy,
- próba: wszyscy, same kobiety albo sami mężczyźni.
Razem 3 × 2 × 3 = 18 wersji analizy. Liczymy, w ilu badaniach choć jedna z nich daje p < .05. To górna granica ryzyka dla badacza, który idzie tam, gdzie „coś widać”.
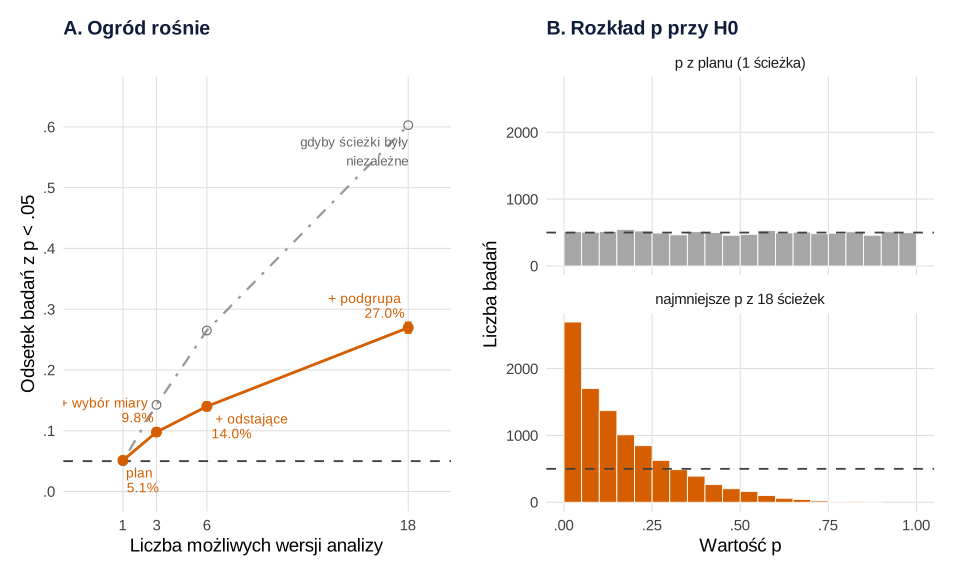
Co widać. Zaplanowana analiza (skala A, cała próba, bez usuwania) daje fałszywy alarm w 5.1% badań (błąd MC 0.2 pp). Wybór miary podnosi ten odsetek do 9.8%, decyzja o odstających – do 14.0%, a dodanie podgrup – do 27.0%. Co czwarte badanie bez efektu ma więc ścieżkę do „istotnego” wyniku. Ścieżki są do siebie podobne (p po usunięciu odstających koreluje z p z planu na .89), dlatego krzywa rośnie wolniej niż dla 18 niezależnych testów (60.3%). W panelu B p z planu ma płaski rozkład, jak przy prawdziwej H0. Najmniejsze p z ogrodu ma pik przy zerze: p < .01 wychodzi w 7.55% badań zamiast oczekiwanego 1%. Wygląda jak pik prawdziwych efektów z rysunku 3.
Czego ten wykres nie pokazuje. Że ktoś coś ukrywa. Wystarczy, że rozsądne decyzje zapadają po obejrzeniu wyników. Tym różni się ten mechanizm od p-hackingu, w którym wersje analizy próbuje się świadomie (w haśle o p-hackingu jest symulacja w duchu Simmonsa i in., 2011, z dobieraniem osób i kowariantem). Simmons i in. (2011) pokazali w symulacjach i eksperymentach, że taka elastyczność radykalnie zwiększa odsetek wyników fałszywie pozytywnych. W prawdziwym projekcie rozwidleń jest zwykle więcej niż trzy, np. przy analizie podgrup.
Podpis do pracy (w aneksie lub w części o ograniczeniach):
Zdanie do Metody (zamyka ogród, zanim go zobaczysz):
Kod rysunku 5: 18 ścieżek w 10 000 badań
5. Ogród rozwidlających się ścieżek przy prawdziwej H0
R
# Rysunek 5. Ogród rozwidlających się ścieżek: 10 000 badań bez efektu i 18 rozsądnych wersji analizy
# (kontynuacja: motyw, KOL)
set.seed(567)
B <- 10000; n <- 30                              # dwie grupy po 30 osób, różnicy w populacji nie ma
p_t <- function(y, g) {                          # p z testu t Studenta (wariancje równe), szybciej niż t.test()
  a <- y[g == 1]; b <- y[g == 0]; na <- length(a); nb <- length(b)
  s2 <- ((na - 1) * var(a) + (nb - 1) * var(b)) / (na + nb - 2)
  2 * pt(-abs((mean(a) - mean(b)) / sqrt(s2 * (1 / na + 1 / nb))), na + nb - 2)
}
bez_odstajacych <- function(y, g) {              # usuń wyniki dalej niż 2.5 SD od średniej własnej grupy
  z <- ave(y, g, FUN = function(x) abs(x - mean(x)) / sd(x)); z <= 2.5
}
sciezki <- expand.grid(miara = c("A", "B", "srednia"), odstajace = c("zostaw", "usun"),
                       proba = c("wszyscy", "kobiety", "mezczyzni"), stringsAsFactors = FALSE)
nrow(sciezki)                                    # 3 × 2 × 3 = 18 wersji analizy
jedno_badanie <- function() {
  g <- rep(0:1, each = n)
  kobieta <- rbinom(2 * n, 1, 0.5) == 1
  A <- rnorm(2 * n); Bm <- 0.5 * A + sqrt(1 - 0.5^2) * rnorm(2 * n)     # dwie miary stresu, r = .5
  miary <- list(A = A, B = Bm, srednia = (A + Bm) / 2)
  proby <- list(wszyscy = rep(TRUE, 2 * n), kobiety = kobieta, mezczyzni = !kobieta)
  sapply(seq_len(nrow(sciezki)), function(i) {
    y <- miary[[sciezki$miara[i]]]; w <- proby[[sciezki$proba[i]]]
    if (sciezki$odstajace[i] == "usun") w <- w & bez_odstajacych(y, g)
    p_t(y[w], g[w])
  })
}
P <- t(replicate(B, jedno_badanie()))            # B × 18 wartości p; kolumna 1 = plan: miara A, wszyscy, bez usuwania
colnames(P) <- paste(sciezki$miara, sciezki$odstajace, sciezki$proba, sep = "/")
# ogród rośnie: 1 ścieżka → +wybór miary (3) → +odstające (6) → +podgrupa (18)
kolumny <- list(`1` = 1, `3` = 1:3, `6` = 1:6, `18` = 1:18)
ogrod <- data.frame(sciezki = as.numeric(names(kolumny)),
                    odsetek = sapply(kolumny, function(k) mean(apply(P[, k, drop = FALSE], 1, min) < .05)))
ogrod$blad_mc <- sqrt(ogrod$odsetek * (1 - ogrod$odsetek) / B)
ogrod$niezalezne_wzor <- 1 - 0.95^ogrod$sciezki
round(ogrod, 3)
round(cor(P)[1, c(2, 3, 4, 7)], 2)               # jak bardzo ścieżki są do siebie podobne (korelacje p z planem)
c(plan_p_ponizej_05 = mean(P[, 1] < .05), najlepsza_p_ponizej_01 = mean(apply(P, 1, min) < .01))

ogrod$etykieta <- c("plan", "+ wybór miary", "+ odstające", "+ podgrupa")
pA <- ggplot(ogrod, aes(sciezki, odsetek)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = KOL[["linia"]]) +
  geom_line(aes(y = niezalezne_wzor), colour = "grey60", linewidth = 0.8, linetype = "dotdash") +
  geom_point(aes(y = niezalezne_wzor), shape = 1, size = 2.6, colour = "grey45") +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_mc, ymax = odsetek + 1.96 * blad_mc), width = 0.4, colour = KOL[["alarm"]]) +
  geom_line(colour = KOL[["alarm"]], linewidth = 1) + geom_point(colour = KOL[["alarm"]], size = 3) +
  geom_text(aes(label = paste0(etykieta, "\n", sprintf("%.1f%%", 100 * odsetek)),
                hjust = c(-0.12, 1.1, -0.12, 1.1), vjust = c(1.3, -0.4, 1.3, -0.4)), size = 3.6,
            colour = KOL[["alarm"]], lineheight = 0.9) +
  annotate("text", x = 18, y = 0.56, label = "gdyby ścieżki były\nniezależne", hjust = 1, size = 3.5, colour = "grey40") +
  scale_x_continuous(breaks = c(1, 3, 6, 18), limits = c(-1.5, 19.5)) +
  scale_y_continuous(limits = c(0, 0.65), breaks = seq(0, 0.6, 0.1), labels = function(x) sub("^0\\.", ".", format(x))) +
  labs(x = "Liczba możliwych wersji analizy", y = "Odsetek badań z p < .05", title = "A. Ogród rośnie") + motyw
naj <- data.frame(p = c(P[, 1], apply(P, 1, min)),
                  wersja = rep(c("p z planu (1 ścieżka)", "najmniejsze p z 18 ścieżek"), each = B))
naj$wersja <- factor(naj$wersja, levels = c("p z planu (1 ścieżka)", "najmniejsze p z 18 ścieżek"))
pB <- ggplot(naj, aes(p)) +
  geom_histogram(aes(fill = wersja), breaks = seq(0, 1, 0.05), colour = "white", linewidth = 0.3) +
  geom_hline(yintercept = B * 0.05, linetype = "dashed", colour = KOL[["linia"]]) +
  facet_wrap(~ wersja, ncol = 1) +
  scale_fill_manual(values = c("grey65", KOL[["alarm"]]), guide = "none") +
  scale_x_continuous(breaks = seq(0, 1, 0.25), labels = function(x) sub("^0\\.", ".", format(x))) +
  labs(x = "Wartość p", y = "Liczba badań", title = "B. Rozkład p przy H0") + motyw
p5 <- pA | pB
# p5   # zapis: ggsave("ogrod-sciezek.svg", p5, width = 10, height = 6)
Wynik w R
[1] 18
   sciezki odsetek blad_mc niezalezne_wzor
1        1   0.051   0.002           0.050
3        3   0.098   0.003           0.143
6        6   0.140   0.003           0.265
18      18   0.270   0.004           0.603
      B/zostaw/wszyscy srednia/zostaw/wszyscy         A/usun/wszyscy
                  0.16                   0.62                   0.89
      A/zostaw/kobiety
                  0.37
     plan_p_ponizej_05 najlepsza_p_ponizej_01
                0.0513                 0.0755
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, testy t, korekty p.adjust() i moc power.t.test() – pakiet stats). Rysunki wykonano w ggplot2 i patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Co z tego wynika dla Twojej pracy
Czy poprawka jest w ogóle potrzebna, zależy od tego, jaki wniosek wyciągasz – rozpisujemy to we wpisie czy muszę stosować poprawkę na wielokrotne porównania.
- Policz swoje testy, zanim policzysz dane. Rodzina testów to wszystkie testy, które razem mają potwierdzić jedną hipotezę. Jeśli nie umiesz ich policzyć, to znak, że ścieżki nie są zamknięte (rysunek 5). Najprostsze zamknięcie to prerejestracja albo choćby plan analizy zapisany przed otwarciem pliku.
- Dobierz błąd do pytania. Jeden wniosek oparty na „którymkolwiek istotnym wyniku” wymaga kontroli FWER (Holm). Przegląd wielu zmiennych bez ambicji potwierdzania każdej z osobna – kontroli FDR (Benjamini–Hochberg). Skorygowane wartości policzysz w kalkulatorze poprawek.
- Pokaż ścieżki, których nie da się zamknąć. Gdy rozsądnych wersji analizy jest kilka, zamiast wybierać jedną pokaż wszystkie – służy do tego analiza multiverse i krzywa specyfikacji. Szerokość przedziałów ufności przy pojedynczym badaniu pokazujemy we wpisie przedział ufności w obrazkach.
Najczęstsze błędy
- „Każdy test miał α = .05, więc wszystko w porządku”. Pojedynczy test tak, ale rodzina 20 testów daje co najmniej jeden fałszywy alarm w około 64% badań (rysunek 1).
- „Moje zmienne są skorelowane, więc korekta jest zbędna”. Korelacja obniża FWER, ale nie do .05 – przy 20 testach skorelowanych na .5 wciąż wychodzi .42 (rysunek 2).
- Traktowanie wszystkich wyników z p < .05 jako odkryć. Przy wielu testach i umiarkowanej mocy część z nich jest fałszywa – w przykładzie 22.7% (rysunek 3).
- Wybór procedury po tym, jak widać wynik. Sięganie po BH, bo Holm „zabił” wyniki, to kolejna ścieżka w ogrodzie. Procedurę wpisz do planu analizy.
- Raportowanie tylko ścieżki, która „wyszła”. Najmniejsze p z kilkunastu wersji analizy nie jest wartością p w zwykłym sensie – przy prawdziwej H0 jego rozkład nie jest płaski (rysunek 5).
Najczęstsze pytania
Ile fałszywie istotnych wyników daje 20 testów, gdy żadnego efektu nie ma?
Średnio jeden (20 × .05), a prawdopodobieństwo co najmniej jednego wynosi 1 − 0.9520 = .64, jeśli testy są niezależne. W symulacji 100 takich badań 61 miało przynajmniej jeden wynik z p < .05, a pojedyncze badania nawet trzy, cztery czy pięć.
Czy przy skorelowanych zmiennych trzeba stosować korektę na wielokrotne testy?
Zwykle tak. Korelacja zmniejsza szansę choćby jednego fałszywego alarmu, ale nie do .05: przy 20 testach skorelowanych na r = .5 symulacja daje .42. Średnia liczba fałszywych alarmów się nie zmienia – przychodzą one po prostu razem. Holm kontroluje ten błąd przy dowolnej zależności testów, a Bonferroni jest wtedy bardziej zachowawczy, niż musi.
Jak wygląda histogram wartości p przy wielu testach?
Prawdziwe hipotezy zerowe dają płaskie tło (rozkład jednostajny), a prawdziwe efekty – pik przy zerze. Wysokość tła odczytana z prawej części histogramu pozwala oszacować, ile hipotez zerowych jest prawdziwych, i zrozumieć, jaka część wyników z p < .05 może być fałszywa. Taki histogram ma sens przy setkach testów, nie przy kilkunastu.
Czym różni się korekta Holma od procedury Benjaminiego–Hochberga na wykresie?
Na wykresie posortowanych wartości p Holm to schodki .05/(m − i + 1), prawie płaskie przy wielu testach, a Benjamini–Hochberg to prosta i/m × .05 rosnąca z rangą. Holm kontroluje szansę choćby jednego fałszywego alarmu (FWER), BH – oczekiwany odsetek fałszywych odkryć (FDR), dlatego odrzuca więcej hipotez i ma większą moc.
Dlaczego ogród rozwidlających się ścieżek zawyża liczbę fałszywych alarmów?
Bo każda decyzja podjęta po obejrzeniu danych – którą miarę analizować, czy usunąć wartości odstające, czy analizować podgrupę – to niepoliczony test. W symulacji 18 takich wersji analizy dało co najmniej jedną „istotną” w 27.0% badań bez efektu zamiast w 5%. Zamknij ścieżki planem analizy albo pokaż je wszystkie w analizie multiverse.
Powiązane hasła
Przeczytaj też
Poprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikCzy muszę stosować poprawkę?
Kiedy poprawka na wielokrotne porównania jest potrzebna, a kiedy nie: rodzina testów, tabela tak/nie, przykład w R i wzór uzasadnienia w pracy.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →Masz w pracy kilkanaście testów i nie wiesz, czy korygować?
Pomożemy ustalić rodzinę testów, dobrać korektę do pytania badawczego i opisać wyniki tak, żebyś umiał(a) obronić te decyzje przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Benjamini, Y., & Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
- Colquhoun, D. (2014). An investigation of the false discovery rate and the misinterpretation of p-values. Royal Society Open Science, 1(3), Article 140216. https://doi.org/10.1098/rsos.140216 ● Otwarty dostęp
- Gelman, A., & Loken, E. (2014). The statistical crisis in science. American Scientist, 102(6), 460. https://doi.org/10.1511/2014.111.460
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Schweder, T., & Spjøtvoll, E. (1982). Plots of P-values to evaluate many tests simultaneously. Biometrika, 69(3), 493–502. https://doi.org/10.1093/biomet/69.3.493
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{benjamini2001control, author={Benjamini, Yoav and Yekutieli, Daniel}, title={{The control of the false discovery rate in multiple testing under dependency}}, journal={The Annals of Statistics}, year={2001}, volume={29}, number={4}, pages={1165--1188}, doi={10.1214/aos/1013699998}}@article{colquhoun2014investigation, author={Colquhoun, David}, title={{An investigation of the false discovery rate and the misinterpretation of p-values}}, journal={Royal Society Open Science}, year={2014}, volume={1}, number={3}, eid={140216}, doi={10.1098/rsos.140216}}@article{gelman2014statistical, author={Gelman, Andrew and Loken, Eric}, title={{The statistical crisis in science}}, journal={American Scientist}, year={2014}, volume={102}, number={6}, pages={460}, doi={10.1511/2014.111.460}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{schweder1982plots, author={Schweder, Tore and Spjøtvoll, Emil}, title={{Plots of P-values to evaluate many tests simultaneously}}, journal={Biometrika}, year={1982}, volume={69}, number={3}, pages={493--502}, doi={10.1093/biomet/69.3.493}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}