Stopnie swobody badacza i ogród rozwidlających się ścieżek
Między surowymi danymi a jedną liczbą w tabeli wyników leży kilkanaście decyzji. Kogo wykluczyć? Co zrobić z odstającymi czasami reakcji? Jak policzyć wynik? Które kowarianty dodać? Wicherts i in. (2016) zebrali 34 takie stopnie swobody badacza, od sformułowania hipotezy po raportowanie. Simmons i in. (2011) pokazali, że nieujawniona elastyczność w tych decyzjach radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Jak to wygląda w symulacji, pokazujemy w haśle p-hacking.
Gelman i Loken (2014) zwrócili uwagę na subtelniejszą wersję problemu, nazywaną ogrodem rozwidlających się ścieżek (garden of forking paths). Badacz nie musi niczego „łowić”. Wystarczy, że wykona jedną analizę, ale jej postać wybierze po zobaczeniu danych. Przy innych danych wybrałby inną ścieżkę, więc nominalne α = .05 przestaje opisywać rzeczywisty błąd I rodzaju. Że nie chodzi o teorię, pokazał projekt Silberzahna i in. (2018): 29 zespołów analizowało ten sam zbiór danych i 69% z nich uzyskało istotny efekt, a 31% nie.
Są dwie odpowiedzi na ten problem. Pierwsza to zamknięcie ścieżek przed zebraniem danych, czyli prerejestracja. Druga to pokazanie wszystkich rozsądnych ścieżek naraz. Ten wpis dotyczy drugiej: analizy wieloświatowej i krzywej specyfikacji z wnioskowaniem łącznym. Krótkie wprowadzenie do krzywej jako jednego z elementów analizy wrażliwości znajdziesz we wpisie analiza wrażliwości w artykule, a definicję w haśle krzywa specyfikacji.
Multiverse danych, multiverse modeli i krzywa specyfikacji
Steegen i in. (2016) zaproponowali analizę wieloświatową (multiverse analysis). Przetwarzanie surowych danych wymaga wyborów między kilkoma rozsądnymi sposobami wykluczania, przekształcania i kodowania. Zamiast jednego zbioru danych tworzysz więc wszystkie zbiory wynikające z tych wyborów i na każdym powtarzasz analizę. Wynik pokazuje, jak bardzo wniosek zależy od arbitralnych decyzji i które z nich ważą najwięcej. Steegen i in. skupili się na tym multiverse danych. Ten sam pomysł stosuje się do decyzji o modelu: zestawu kowariantów, rozkładu reszt czy estymatora. Mówi się wtedy o multiverse modeli. W praktyce obie przestrzenie krzyżuje się ze sobą.
Simonsohn i in. (2020) zauważają, że decyzje analityczne bywają jednocześnie uzasadnione, arbitralne i motywowane. Wprowadzają przy tym zmienność, której nie widać w błędach standardowych. Ich analiza krzywej specyfikacji (specification curve analysis) ma trzy kroki:
- wyznacz zbiór specyfikacji uzasadnionych teoretycznie, poprawnych statystycznie i nieredundantnych;
- pokaż wyniki na wykresie, z którego widać, które decyzje zmieniają wynik;
- przeprowadź wnioskowanie łączne ze wszystkich specyfikacji.
Trzeci krok odróżnia krzywą specyfikacji od samego wykresu wielu wariantów. Pytanie nie brzmi „ile wariantów jest istotnych?”, tylko „czy taka krzywa byłaby prawdopodobna, gdyby efektu nie było?”.
Które decyzje wpuścić do multiverse
Multiverse jest tak dobry jak lista decyzji. Del Giudice i Gangestad (2021) ostrzegają, że gdy alternatywy nie są naprawdę arbitralne, analiza może wprowadzać w błąd, a prawdziwy efekt może zginąć wśród słabo uzasadnionych wariantów. Proponują sprawdzić każdą decyzję pod kątem trzech rodzajów nierównoważności: pomiaru (czy opcje mierzą to samo), efektu (czy dotyczą tego samego efektu) oraz mocy i precyzji. Z tej oceny wynikają trzy typy decyzji:
- typ E (równoważność): opcje są naprawdę wymienne, więc wchodzą do multiverse;
- typ N (nierównoważność): jedna opcja jest lepsza z góry, więc nie ma jej w krzywej, tylko wybierasz ją w planie;
- typ U (niepewność): nie wiadomo, a wtedy analizę wieloświatową prowadzisz jawnie jako eksploracyjną.
W praktyce oznacza to zasadę „arbitralne, ale rozsądne”. Każdą opcję musisz umieć obronić przed recenzentem jako tak samo dobrą jak pozostałe. Model z pominiętą znaną zmienną zakłócającą, reguła wykluczeń, której nikt w danej dziedzinie nie stosuje, albo zmiana konstruktu w zmiennej zależnej nie są alternatywami, tylko błędami. Ich dodanie sztucznie poszerza krzywą.
Przykład: krótki trening uważności a efekt Stroopa
Studenci (N = 160) zostali losowo przydzieleni do 8-minutowego ćwiczenia uważności oddechu albo do słuchania audiobooka (zob. randomizacja). Przed manipulacją i po niej wykonali zadanie Stroopa. Wynikiem jest efekt interferencji, czyli o ile milisekund wolniej odpowiadano w próbach niezgodnych niż w zgodnych. Hipoteza była kierunkowa: po ćwiczeniu uważności interferencja będzie mniejsza. Dane są symulowane (set.seed(2190)): 15 360 prób, po 48 zgodnych i 48 niezgodnych na osobę.
W danych są typowe problemy. Odpowiedzi szybsze niż 200 ms stanowią 1.33% prób, a wolniejsze niż 2000 ms 1.43%. Dziewięć osób miało trafność poniżej 80%, z czego trzy poniżej 70%. Badacz ma więc cztery decyzje do podjęcia. Dla każdej opisujemy opcje i uzasadnienie:
| Decyzja | Opcje w multiverse | Dlaczego są rozsądne | Czego nie włączono |
|---|---|---|---|
| Odstające czasy reakcji (multiverse danych) | granice 200–2000 ms; ±2.5 SD w osobie i warunku; 3 MAD w osobie i warunku | stałe i względne punkty odcięcia to standardowe sposoby ograniczania wpływu odstających czasów, których skutki porównuje Ratcliff (1993); MAD jest odporną miarą rozproszenia (Leys i in., 2013) | brak przycinania: antycypacje poniżej 200 ms nie są reakcją na bodziec |
| Wynik (multiverse danych) | średnia albo mediana czasu w warunku | mediana jest mniej wrażliwa na obserwacje odstające (Ratcliff, 1993) | wskaźnik łączący czas i trafność, bo mierzy inny konstrukt (nierównoważność pomiaru) |
| Wykluczenie osób (multiverse danych) | trafność ≥ 80% albo ≥ 70% | oba progi odrzucają osoby odpowiadające przypadkowo (zob. nieuważne odpowiedzi) | wykluczanie według wyniku interferencji, bo zależy od zmiennej zależnej |
| Kowarianty (multiverse modeli) | brak; interferencja wyjściowa; interferencja wyjściowa i wiek | przy losowym przydziale każdy z tych modeli szacuje ten sam efekt bez obciążenia | kowarianty zmierzone po manipulacji |
Daje to 3 × 2 × 2 × 3 = 36 specyfikacji. Zwróć uwagę na ostatnią decyzję. Model z pomiarem wyjściowym (ANCOVA) jest przy korelacji przed–po r = .58 wyraźnie precyzyjniejszy niż porównanie samych wyników końcowych. To nierównoważność mocy w rozumieniu Del Giudice i Gangestada (2021), więc w planie analizy ANCOVA powinna być wybrana z góry (zob. ANCOVA w badaniu przed i po). Model bez kowariantów zostawiamy w krzywej celowo, żeby pokazać, jak precyzja wpływa na odsetek istotnych wyników.
Analiza zapisana w prerejestracji brzmiała: granice 200–2000 ms, średnia, trafność ≥ 80% i ANCOVA z pomiarem wyjściowym. Dała ona różnicę b = −17.6 ms, 95% CI [−29.5, −5.7], p = .004 (n = 151). Pytanie brzmi: na ile ten wynik zależy od przyjętych decyzji?
Krzywa specyfikacji krok po kroku
Obliczenia wymagają tylko bazowego R. Pakiety specr i multiverse automatyzują te kroki, ale pętla daje pełną kontrolę nad tym, co liczysz:
- Siatka decyzji.
expand.grid()tworzy ramkę danych, w której każdy wiersz to jedna specyfikacja. - Wynik osoby raz na wersję. Interferencja zależy tylko od przycinania i miary, więc liczysz ją sześć razy, a nie 36.
- Pętla po wierszach. Dla każdej specyfikacji wykluczasz osoby, dopasowujesz
lm()i zapisujesz b, SE, 95% CI i p. - Sortowanie od najsilniejszego efektu i rysunek.
Wszystkie 36 oszacowań jest ujemnych, od −19.9 do −6.5 ms, z medianą −14.5 ms. Wynik istotny (p < .05) dało 19 z 36 specyfikacji, czyli nieco ponad połowa. Rysunek 1 pokazuje, skąd ten podział.
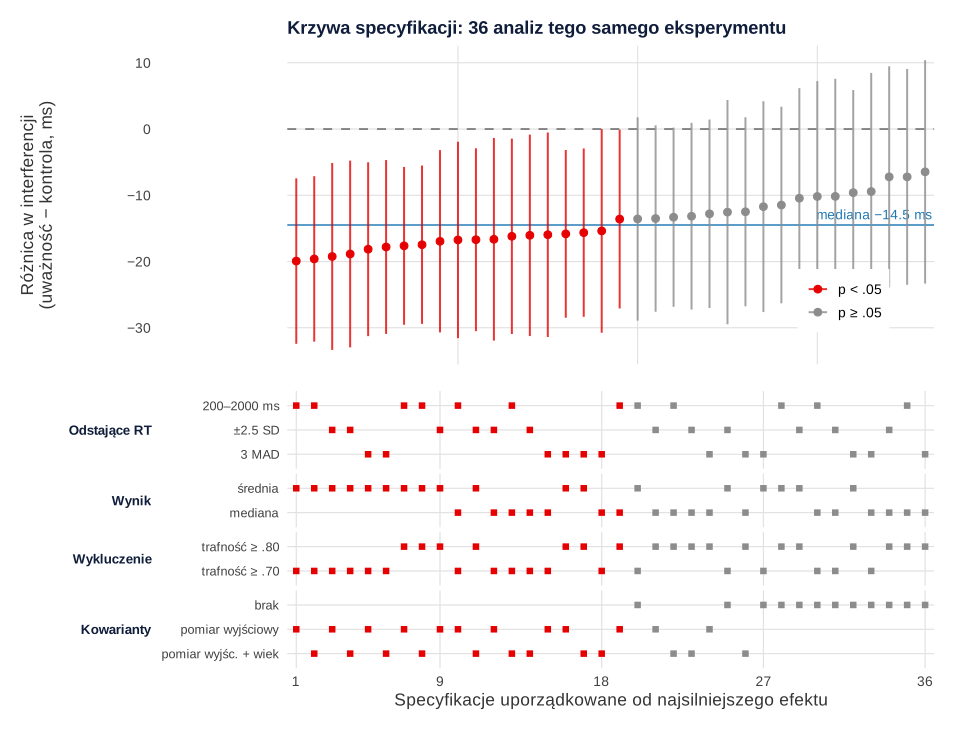
Dolny panel czyta się kolumnami. Najwięcej zmienia decyzja o kowariantach. Bez pomiaru wyjściowego żadna z 12 specyfikacji nie jest istotna (mediana −10.2 ms). Z samym pomiarem wyjściowym istotnych jest 10 z 12 (mediana −16.7 ms), a z pomiarem wyjściowym i wiekiem 9 z 12 (−16.1 ms). Drugą decyzją jest miara: średnia dała 12 istotnych wyników z 18, mediana 7. Łagodniejszy próg trafności (≥ 70%) dał 12 istotnych z 18, a ostrzejszy 7. Reguła przycinania prawie nic nie zmienia (6–7 istotnych z 12 przy każdej regule). Wniosek dla czytelnika: kierunek efektu jest stały, a o istotności decyduje głównie precyzja modelu.
Wnioskowanie łączne: permutacja przy H0
Czy 19 istotnych wyników na 36 to dużo? Tego nie widać z samego wykresu. Specyfikacje liczone na tych samych danych są silnie skorelowane, więc nie można ich traktować jak 36 niezależnych testów. Nie pomoże też zwykła poprawka na wielokrotne porównania. Potrzebny jest rozkład całej krzywej przy prawdziwej hipotezie zerowej.
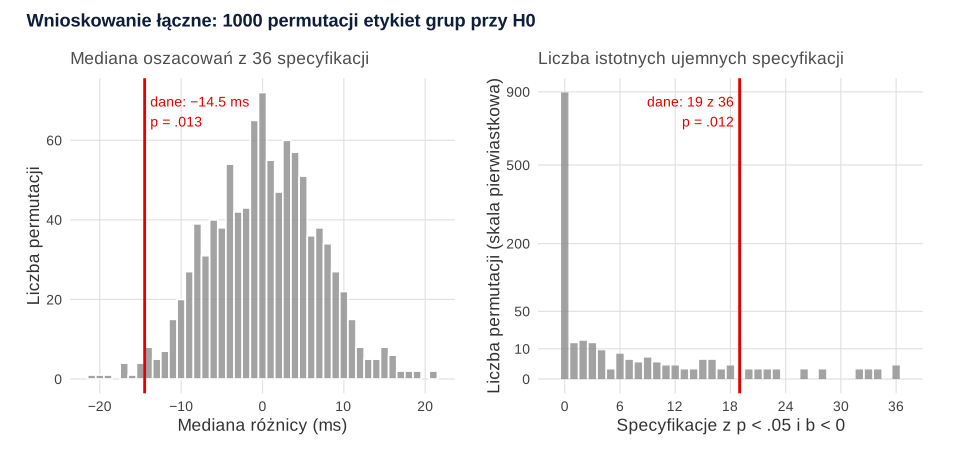
W eksperymencie z losowym przydziałem najprościej uzyskać go testem permutacyjnym. Etykiety grup tasujesz losowo, co niszczy ewentualny efekt, ale zachowuje wszystko inne: rozkłady czasów, wykluczenia, korelację z pomiarem wyjściowym. Na każdej permutacji liczysz wszystkie 36 specyfikacji i zapisujesz statystyki opisujące krzywą. W przykładzie są to mediana oszacowań i liczba istotnych specyfikacji w przewidywanym kierunku. Wartość p to odsetek permutacji, w których krzywa była co najmniej tak skrajna jak w danych.
Wyniki (testy jednostronne, zgodne z kierunkową hipotezą):
- mediana oszacowań: −14.5 ms w danych, a 95% permutacji mieściło się w przedziale od −12.4 do 14.0 ms; p = .013;
- liczba istotnych ujemnych specyfikacji: 19 w danych, przy H0 mediana 0, a 95. centyl 5; p = .012.
Krzywa jako całość jest więc mało prawdopodobna, gdy efektu nie ma, choć prawie połowa pojedynczych specyfikacji jest nieistotna. Permutacje pokazują też drugą stronę medalu. W 10.4% z nich choć jedna specyfikacja dała istotny wynik ujemny, choć efektu nie było. Tyle wynosiłoby ryzyko błędu badacza, który przegląda 36 wariantów i raportuje ten „udany”. Jedna z góry wybrana analiza z testem dwustronnym daje taki wynik w 2.5% przypadków.
Dane obserwacyjne. Gdy nie ma losowego przydziału, tasowanie predyktora niszczy też jego związki z kowariantami. Rozkład przy H0 uzyskuje się wtedy bootstrapem z wymuszoną hipotezą zerową. W każdej specyfikacji od zmiennej zależnej odejmujesz oszacowany efekt (y* = y − b · x), dzięki czemu efekt w tak zmienionych danych wynosi zero. Następnie losujesz obserwacje ze zwracaniem i na każdej próbie liczysz całą krzywą. Dalej postępujesz jak przy permutacjach.
Jak opisać analizę wieloświatową
Czytelnik musi zobaczyć cztery rzeczy:
- Listę decyzji z opcjami i uzasadnieniem, najlepiej w tabeli, oraz informację, co celowo pominięto i dlaczego.
- Podsumowanie krzywej: liczbę specyfikacji, zakres i medianę oszacowań, liczbę wyników istotnych w każdym kierunku.
- Decyzje, które zmieniają wynik: nazwane wprost, z liczbami dla każdej opcji.
- Wnioskowanie łączne: metodę (permutacja albo bootstrap, liczba powtórzeń), statystyki i ich wartości p.
Rysunek krzywej i pełną tabelę 36 wyników umieść w materiałach uzupełniających, razem z kodem (zob. pakiet replikacyjny; o układzie rysunków piszemy we wpisie tabele i rysunki do artykułu). W tekście wystarczy akapit:
Gdy recenzent prosi o taką analizę po złożeniu artykułu, przydadzą się wzory z wpisu odpowiedź recenzentom. Jeśli chcesz, żeby ktoś z zewnątrz sprawdził listę decyzji i kod permutacji, zrobimy to w ramach wsparcia statystycznego dla badaczy.
Multiverse a prerejestracja
Prerejestracja i multiverse nie konkurują ze sobą. Nosek i in. (2018) wskazują, że główną funkcją prerejestracji jest odróżnienie testowania przewidywań od wyjaśniania wyników po fakcie. Analiza główna zapisana z góry zachowuje swoje znaczenie konfirmacyjne. Krzywa specyfikacji odpowiada na inne pytanie: czy wniosek przetrwa decyzje, które równie dobrze mogły zapaść inaczej. Najlepiej zarejestrować obie rzeczy: analizę główną oraz listę decyzji do multiverse z wybranymi statystykami łącznymi. Jak przygotować taki plan, opisujemy we wpisie plan analizy statystycznej i prerejestracja.
Bez prerejestracji multiverse jest szczególnie cenny, bo pokazuje ścieżki, których autor nie wybrał. Pozostaje jednak analizą, którą trzeba opisać uczciwie. Jeśli lista decyzji powstała po obejrzeniu danych, napisz to. Gdy decyzje są typu U, nazwij całą analizę eksploracyjną (Del Giudice i Gangestad, 2021). Przy reanalizie cudzego artykułu multiverse służy do oceny kruchości opublikowanego wyniku, co pokazujemy we wpisie reanaliza i wtórna analiza danych. Krzywa specyfikacji pasuje też do formatu registered report i do praktyk otwartej nauki, bo w obu przypadkach liczy się pełny obraz, a nie jedna ścieżka.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji. Obliczenia (przepisy 1–3) wymagają tylko bazowego R: expand.grid(), pętli i lm(). Permutacje to 36 000 modeli i trwają kilkanaście sekund. Do rysunku potrzebne są pakiety ggplot2 i patchwork.
1. Dane i wynik osoby
R
# Dane symulowane: eksperyment z losowym przydziałem. 8-minutowe ćwiczenie uważności oddechu albo słuchanie audiobooka
# (kontrola), potem zadanie Stroopa: 48 prób zgodnych i 48 niezgodnych na osobę. Wynik: efekt interferencji (ms).
set.seed(2190)
n_os <- 160
osoby <- data.frame(id = 1:n_os, grupa = factor(rep(c("kontrola", "uwaznosc"), each = n_os / 2),
                                                 levels = c("kontrola", "uwaznosc")),
                    wiek = round(runif(n_os, 19, 35)))
tau <- rnorm(n_os, 85, 30)                                    # prawdziwa interferencja osoby (ms)
osoby$interf_pre <- round(tau + rnorm(n_os, 0, 25))           # interferencja zmierzona przed manipulacją
tau_po <- tau - 16 * (osoby$grupa == "uwaznosc") + rnorm(n_os, 0, 12)
baza <- 640 + 4 * (osoby$wiek - 25) + rnorm(n_os, 0, 80)      # ogólne tempo reakcji osoby
nieuwazni <- c(sample(1:80, 4), sample(81:160, 5))   # osoby odpowiadające bez skupienia
trafnosc_os <- ifelse(seq_len(n_os) %in% nieuwazni, runif(n_os, .62, .78), runif(n_os, .90, .99))

proby <- expand.grid(proba = 1:48, warunek = c("zgodna", "niezgodna"), id = 1:n_os)
proby <- proby[, c("id", "warunek", "proba")]
i <- proby$id
proby$rt <- baza[i] + tau_po[i] * (proby$warunek == "niezgodna") + rnorm(nrow(proby), 0, 90) + rexp(nrow(proby), 1 / 120)
los <- runif(nrow(proby))
proby$rt[los < .015] <- runif(sum(los < .015), 100, 200)                     # antycypacje
proby$rt[los > .985] <- runif(sum(los > .985), 2000, 4000)                   # zawieszenia uwagi
proby$rt[i %in% nieuwazni] <- runif(sum(i %in% nieuwazni), 250, 900)         # szybkie, przypadkowe odpowiedzi
proby$rt <- round(proby$rt)
proby$poprawna <- runif(nrow(proby)) < trafnosc_os[i]

# Trafność osoby (odsetek poprawnych odpowiedzi) i opis danych
osoby$trafnosc <- as.numeric(tapply(proby$poprawna, proby$id, mean))
c(osob = n_os, prob = nrow(proby), trafnosc_ponizej_80 = sum(osoby$trafnosc < .80), trafnosc_ponizej_70 = sum(osoby$trafnosc < .70))
round(c(rt_ponizej_200 = mean(proby$rt < 200), rt_powyzej_2000 = mean(proby$rt > 2000)) * 100, 2)   # odsetek prób (%)

# Reguła przycinania czasów reakcji w obrębie osoby (SD i MAD liczone osobno dla każdego warunku)
zostaw_proby <- function(rt, warunek, przycinanie) {
  switch(przycinanie,
    "200–2000 ms" = rt >= 200 & rt <= 2000,
    "±2.5 SD" = abs(rt - ave(rt, warunek)) <= 2.5 * ave(rt, warunek, FUN = sd),
    "3 MAD" = abs(rt - ave(rt, warunek, FUN = median)) <= 3 * ave(rt, warunek, FUN = mad))
}
# Interferencja jednej osoby: niezgodne − zgodne, tylko poprawne próby; miara: średnia albo mediana
interferencja <- function(rt, warunek, przycinanie, miara) {
  zostaw <- zostaw_proby(rt, warunek, przycinanie)
  f <- if (miara == "średnia") mean else median
  f(rt[zostaw & warunek == "niezgodna"]) - f(rt[zostaw & warunek == "zgodna"])
}
poprawne <- proby[proby$poprawna, ]
# Odsetek poprawnych prób usuniętych przez każdą regułę (%)
sapply(c("200–2000 ms", "±2.5 SD", "3 MAD"), function(r)
  round(100 * mean(!unlist(lapply(split(poprawne, poprawne$id), function(d) zostaw_proby(d$rt, d$warunek, r)))), 1))
Wynik w R
               osob                prob trafnosc_ponizej_80 trafnosc_ponizej_70
                160               15360                   9                   3
 rt_ponizej_200 rt_powyzej_2000
           1.33            1.43
200–2000 ms     ±2.5 SD       3 MAD
        2.8         2.8         5.1
2. Siatka decyzji, pętla i podsumowanie krzywej
R
# Krzywa specyfikacji: wszystkie kombinacje czterech decyzji (expand.grid) i jedna pętla
decyzje <- expand.grid(
  przycinanie = c("200–2000 ms", "±2.5 SD", "3 MAD"),                       # reguła dla odstających czasów reakcji
  miara = c("średnia", "mediana"),                                           # definicja wyniku
  prog_trafnosci = c(.80, .70),                                              # wykluczenie osób
  kowarianty = c("brak", "pomiar wyjściowy", "pomiar wyjściowy + wiek"),     # model
  stringsAsFactors = FALSE)
nrow(decyzje)

# Wynik osoby zależy tylko od przycinania i miary (6 wersji) – policz go raz dla każdej wersji
wersje <- unique(decyzje[c("przycinanie", "miara")])
wyniki_osob <- list()
for (w in seq_len(nrow(wersje))) {
  y <- sapply(split(poprawne, poprawne$id), function(d)
    interferencja(d$rt, d$warunek, wersje$przycinanie[w], wersje$miara[w]))
  wyniki_osob[[paste(wersje$przycinanie[w], wersje$miara[w])]] <- y
}

# Opis: interferencja (200–2000 ms, średnia) u osób z trafnością ≥ 80% i jej korelacja z pomiarem wyjściowym
y1 <- wyniki_osob[["200–2000 ms średnia"]][osoby$trafnosc >= .80]
g1 <- osoby$grupa[osoby$trafnosc >= .80]
table(g1)
round(rbind(M = tapply(y1, g1, mean), SD = tapply(y1, g1, sd)), 1)
round(cor(y1, osoby$interf_pre[osoby$trafnosc >= .80]), 2)

wzory <- c("brak" = "y ~ grupa", "pomiar wyjściowy" = "y ~ grupa + interf_pre",
           "pomiar wyjściowy + wiek" = "y ~ grupa + interf_pre + wiek")

# Jedna specyfikacja: różnica uważność − kontrola w interferencji (ms), SE, 95% CI, p
licz_spec <- function(s, grupa) {
  d <- osoby
  d$grupa <- grupa
  d$y <- wyniki_osob[[paste(decyzje$przycinanie[s], decyzje$miara[s])]]
  d <- d[d$trafnosc >= decyzje$prog_trafnosci[s], ]
  fit <- lm(as.formula(wzory[[decyzje$kowarianty[s]]]), data = d)
  m <- summary(fit)$coefficients["grupauwaznosc", ]
  c(n = nrow(d), b = m[[1]], se = m[[2]], t = m[[3]], p = m[[4]],
    dolny = m[[1]] - qt(.975, fit$df.residual) * m[[2]], gorny = m[[1]] + qt(.975, fit$df.residual) * m[[2]])
}

wyn <- matrix(NA, nrow(decyzje), 7, dimnames = list(NULL, c("n", "b", "se", "t", "p", "dolny", "gorny")))
for (s in seq_len(nrow(decyzje))) wyn[s, ] <- licz_spec(s, osoby$grupa)
spec <- cbind(decyzje, wyn)
spec <- spec[order(spec$b), ]
spec$ranga <- seq_len(nrow(spec))

# Podsumowanie krzywej
c(specyfikacji = nrow(spec), ujemnych = sum(spec$b < 0), istotnych_ujemnych = sum(spec$b < 0 & spec$p < .05),
  istotnych_dodatnich = sum(spec$b > 0 & spec$p < .05))
round(c(mediana_b = median(spec$b), min_b = min(spec$b), max_b = max(spec$b)), 1)
range(spec$n)

# Które decyzje ważą najwięcej: mediana b i liczba istotnych specyfikacji w obrębie każdej opcji
for (k in c("przycinanie", "miara", "prog_trafnosci", "kowarianty")) {
  print(do.call(rbind, lapply(split(spec, spec[[k]]), function(d)
    data.frame(specyfikacji = nrow(d), mediana_b = round(median(d$b), 1), istotnych = sum(d$p < .05)))))
}

# Pełna tabela (do materiałów uzupełniających)
print(transform(spec[c("ranga", "przycinanie", "miara", "prog_trafnosci", "kowarianty", "n")],
                b = round(spec$b, 1), dolny = round(spec$dolny, 1), gorny = round(spec$gorny, 1), p = round(spec$p, 3)),
      row.names = FALSE)
Wynik w R
[1] 36
g1
kontrola uwaznosc
      76       75
   kontrola uwaznosc
M      87.2     75.7
SD     43.0     49.1
[1] 0.58
       specyfikacji            ujemnych  istotnych_ujemnych istotnych_dodatnich
                 36                  36                  19                   0
mediana_b     min_b     max_b
    -14.5     -19.9      -6.5
[1] 151 157
            specyfikacji mediana_b istotnych
±2.5 SD               12     -14.8         6
200–2000 ms           12     -14.9         7
3 MAD                 12     -14.1         6
        specyfikacji mediana_b istotnych
mediana           18     -13.2         7
średnia           18     -16.8        12
    specyfikacji mediana_b istotnych
0.7           18     -16.1        12
0.8           18     -13.2         7
                        specyfikacji mediana_b istotnych
brak                              12     -10.2         0
pomiar wyjściowy                  12     -16.7        10
pomiar wyjściowy + wiek           12     -16.1         9
 ranga przycinanie   miara prog_trafnosci              kowarianty   n     b
     1 200–2000 ms średnia            0.7        pomiar wyjściowy 157 -19.9
     2 200–2000 ms średnia            0.7 pomiar wyjściowy + wiek 157 -19.6
     3     ±2.5 SD średnia            0.7        pomiar wyjściowy 157 -19.2
     4     ±2.5 SD średnia            0.7 pomiar wyjściowy + wiek 157 -18.9
     5       3 MAD średnia            0.7        pomiar wyjściowy 157 -18.1
     6       3 MAD średnia            0.7 pomiar wyjściowy + wiek 157 -17.8
     7 200–2000 ms średnia            0.8        pomiar wyjściowy 151 -17.6
     8 200–2000 ms średnia            0.8 pomiar wyjściowy + wiek 151 -17.5
     9     ±2.5 SD średnia            0.8        pomiar wyjściowy 151 -16.9
    10 200–2000 ms mediana            0.7        pomiar wyjściowy 157 -16.7
    11     ±2.5 SD średnia            0.8 pomiar wyjściowy + wiek 151 -16.7
    12     ±2.5 SD mediana            0.7        pomiar wyjściowy 157 -16.6
    13 200–2000 ms mediana            0.7 pomiar wyjściowy + wiek 157 -16.2
    14     ±2.5 SD mediana            0.7 pomiar wyjściowy + wiek 157 -16.0
    15       3 MAD mediana            0.7        pomiar wyjściowy 157 -16.0
    16       3 MAD średnia            0.8        pomiar wyjściowy 151 -15.8
    17       3 MAD średnia            0.8 pomiar wyjściowy + wiek 151 -15.6
    18       3 MAD mediana            0.7 pomiar wyjściowy + wiek 157 -15.4
    19 200–2000 ms mediana            0.8        pomiar wyjściowy 151 -13.6
    20 200–2000 ms średnia            0.7                    brak 157 -13.6
    21     ±2.5 SD mediana            0.8        pomiar wyjściowy 151 -13.5
    22 200–2000 ms mediana            0.8 pomiar wyjściowy + wiek 151 -13.3
    23     ±2.5 SD mediana            0.8 pomiar wyjściowy + wiek 151 -13.2
    24       3 MAD mediana            0.8        pomiar wyjściowy 151 -12.8
    25     ±2.5 SD średnia            0.7                    brak 157 -12.5
    26       3 MAD mediana            0.8 pomiar wyjściowy + wiek 151 -12.5
    27       3 MAD średnia            0.7                    brak 157 -11.7
    28 200–2000 ms średnia            0.8                    brak 151 -11.5
    29     ±2.5 SD średnia            0.8                    brak 151 -10.4
    30 200–2000 ms mediana            0.7                    brak 157 -10.2
    31     ±2.5 SD mediana            0.7                    brak 157 -10.2
    32       3 MAD średnia            0.8                    brak 151  -9.6
    33       3 MAD mediana            0.7                    brak 157  -9.4
    34     ±2.5 SD mediana            0.8                    brak 151  -7.2
    35 200–2000 ms mediana            0.8                    brak 151  -7.2
    36       3 MAD mediana            0.8                    brak 151  -6.5
 dolny gorny     p
 -32.4  -7.4 0.002
 -32.1  -7.1 0.002
 -33.3  -5.1 0.008
 -33.0  -4.8 0.009
 -31.3  -5.0 0.007
 -30.9  -4.7 0.008
 -29.5  -5.7 0.004
 -29.4  -5.5 0.004
 -30.7  -3.2 0.016
 -31.6  -1.9 0.027
 -30.5  -2.9 0.018
 -31.9  -1.3 0.033
 -30.9  -1.4 0.032
 -31.2  -0.8 0.039
 -31.4  -0.5 0.043
 -28.5  -3.2 0.015
 -28.3  -2.9 0.016
 -30.7   0.0 0.050
 -27.1  -0.1 0.048
 -28.9   1.8 0.083
 -27.6   0.6 0.060
 -26.8   0.2 0.054
 -27.3   0.9 0.067
 -27.0   1.4 0.078
 -29.5   4.4 0.145
 -26.8   1.8 0.086
 -27.6   4.2 0.148
 -26.3   3.4 0.129
 -27.1   6.2 0.216
 -27.6   7.2 0.250
 -27.9   7.6 0.260
 -25.1   5.9 0.223
 -27.3   8.5 0.300
 -23.9   9.5 0.394
 -23.5   9.1 0.383
 -23.3  10.4 0.450
3. Wnioskowanie łączne: permutacje
R
# Wnioskowanie łączne: rozkład statystyk krzywej przy H0 z permutacji etykiet grup (losowy przydział w eksperymencie)
statystyki <- function(grupa) {
  w <- t(sapply(seq_len(nrow(decyzje)), licz_spec, grupa = grupa))
  c(mediana_b = median(w[, "b"]), istotnych_ujemnych = sum(w[, "b"] < 0 & w[, "p"] < .05))
}
obserwowane <- statystyki(osoby$grupa)
obserwowane

set.seed(2191)
B <- 1000
h0 <- t(replicate(B, statystyki(sample(osoby$grupa))))   # 1000 × 36 modeli, kilkanaście sekund

# p łączne: odsetek permutacji co najmniej tak skrajnych jak dane (z poprawką +1)
p_mediana <- (sum(h0[, "mediana_b"] <= obserwowane[["mediana_b"]]) + 1) / (B + 1)
p_istotne <- (sum(h0[, "istotnych_ujemnych"] >= obserwowane[["istotnych_ujemnych"]]) + 1) / (B + 1)
round(c(p_mediana = p_mediana, p_istotne = p_istotne), 3)

# Jak wygląda krzywa, gdy efektu nie ma: typowa liczba istotnych specyfikacji przy H0
quantile(h0[, "istotnych_ujemnych"], c(.50, .95), type = 1)
round(mean(h0[, "istotnych_ujemnych"] > 0), 3)               # odsetek permutacji z choć jedną istotną ujemną
round(quantile(h0[, "mediana_b"], c(.025, .975)), 1)
Wynik w R
         mediana_b istotnych_ujemnych
         -14.48854           19.00000
p_mediana p_istotne
    0.013     0.012
50% 95%
  0   5
[1] 0.104
 2.5% 97.5%
-12.4  14.0
4. Dwupanelowy rysunek w ggplot2
R
# Dwupanelowa krzywa specyfikacji w ggplot2: u góry oszacowania z 95% CI, na dole decyzje każdej specyfikacji
library(ggplot2)
library(patchwork)
spec$wynik <- ifelse(spec$p < .05, "p < .05", "p ≥ .05")
kolory <- c("p < .05" = "#e50101", "p ≥ .05" = "grey55")

gora <- ggplot(spec, aes(ranga, b, colour = wynik)) +
  geom_hline(yintercept = 0, linetype = "dashed") +
  geom_hline(yintercept = median(spec$b), colour = "#1f78b4") +
  geom_errorbar(aes(ymin = dolny, ymax = gorny), width = 0) +
  geom_point(size = 2) +
  scale_colour_manual(values = kolory, name = NULL) +
  labs(x = NULL, y = "Uważność − kontrola (ms)") +
  theme_minimal() + theme(axis.text.x = element_blank())

# Dane długie do dolnego panelu: jedna linia = specyfikacja × decyzja
etykiety <- c(przycinanie = "odstające RT", miara = "wynik", prog_trafnosci = "trafność", kowarianty = "kowarianty")
dl <- do.call(rbind, lapply(names(etykiety), function(k)
  data.frame(ranga = spec$ranga, decyzja = etykiety[[k]], opcja = as.character(spec[[k]]), wynik = spec$wynik)))
dl$decyzja <- factor(dl$decyzja, levels = etykiety)
dim(dl)

dol <- ggplot(dl, aes(ranga, opcja, colour = wynik)) +
  geom_point(shape = 15) +
  facet_grid(decyzja ~ ., scales = "free_y", space = "free_y") +
  scale_colour_manual(values = kolory, guide = "none") +
  labs(x = "Specyfikacje od najsilniejszego efektu", y = NULL) +
  theme_minimal()

wykres <- gora / dol + plot_layout(heights = c(1.2, 1))
ggsave("krzywa-specyfikacji.png", wykres, width = 10, height = 7.5, dpi = 150, bg = "white")
Wynik w R
[1] 144 4Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje expand.grid(), lm(), replicate(), sample()); rysunki przygotowano w pakietach ggplot2 4.0.2 i patchwork 1.3.2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Opcje, których nikt by nie wybrał. Specyfikacje bez uzasadnienia rozmywają efekt albo go pompują. Każdą opcję uzasadnij tak, jakby miała być analizą główną.
- Zmiana konstruktu nazwana „definicją wyniku”. Inna zmienna zależna to inne pytanie, a nie kolejna gałąź multiverse.
- Liczenie istotnych specyfikacji bez wnioskowania łącznego. „19 z 36” nic nie mówi bez rozkładu przy H0. Specyfikacje są zależne, więc nie wystarczy porównać tej liczby z 5%.
- Wykluczenia zależne od zmiennej zależnej (np. usuwanie osób o skrajnej interferencji). Takie reguły łamią logikę permutacji i otwierają nowe ścieżki.
- Wybór „najlepszej” specyfikacji z krzywej jako wyniku głównego. To p-hacking z wykresem w tle; w przykładzie sięgnięcie po najkorzystniejszą z 36 ścieżek dawało fałszywy wynik w 10.4% permutacji.
- Brak nazwanej decyzji kluczowej. Ogólnik „wyniki były odporne” zastąp zdaniem, od której decyzji zależy istotność, z liczbami dla każdej opcji.
Najczęstsze pytania
Czym różni się analiza multiverse od krzywej specyfikacji?
Obie liczą tę samą analizę dla wielu kombinacji decyzji. Analiza wieloświatowa (Steegen i in., 2016) kładzie nacisk na zbiory danych powstające z różnych decyzji o wykluczeniach, przekształceniach i kodowaniu. Krzywa specyfikacji (Simonsohn i in., 2020) obejmuje wszystkie decyzje analityczne, także o modelu, pokazuje na wykresie, które z nich zmieniają wynik, i dodaje wnioskowanie łączne ze wszystkich specyfikacji.
Ile specyfikacji powinna mieć analiza wieloświatowa?
Tyle, ile wynika z rozsądnych decyzji, a nie z chęci uzyskania dużej liczby. Kilka decyzji o 2–3 opcjach daje zwykle kilkadziesiąt specyfikacji, jak 36 w przykładzie. Ważniejsze od liczby jest to, by każdą opcję dało się obronić jako równie dobrą. Słabo uzasadnione warianty tylko poszerzają krzywą (Del Giudice i Gangestad, 2021).
Jak policzyć łączną wartość p dla krzywej specyfikacji?
Wybierz statystyki opisujące całą krzywą, np. medianę oszacowań i liczbę istotnych wyników w przewidywanym kierunku. Potem wygeneruj ich rozkład przy prawdziwej H0: w eksperymencie permutując etykiety grup, w danych obserwacyjnych bootstrapem po odjęciu oszacowanego efektu. Wartość p to odsetek powtórzeń z wynikiem co najmniej tak skrajnym jak w danych.
Czy analizę multiverse trzeba zaplanować w prerejestracji?
Nie jest to warunek konieczny, ale bardzo ją wzmacnia. Zarejestruj analizę główną, listę decyzji z opcjami i statystyki łączne. Jeśli lista powstała po obejrzeniu danych albo decyzje są niepewne, opisz analizę jako eksploracyjną. Prerejestracja i multiverse odpowiadają na różne pytania, więc najlepiej stosować obie.
Jak zrobić krzywą specyfikacji w R bez pakietu specr?
Utwórz siatkę decyzji funkcją expand.grid(), w pętli dopasuj model dla każdego wiersza i zapisz oszacowanie, przedział ufności i p. Posortuj wyniki i narysuj dwa panele w ggplot2: oszacowania z przedziałami oraz macierz punktów pokazującą opcje każdej specyfikacji; połącz je pakietem patchwork. Pełny kod jest w sekcji z przykładem.
Powiązane hasła
Przeczytaj też
Analiza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikReanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →Recenzent pyta, czy wynik przetrwa inne decyzje analityczne?
Pomożemy dobrać uzasadnione specyfikacje, policzyć krzywą z wnioskowaniem łącznym i wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Del Giudice, M., & Gangestad, S. W. (2021). A traveler’s guide to the multiverse: Promises, pitfalls, and a framework for the evaluation of analytic decisions. Advances in Methods and Practices in Psychological Science, 4(1), Article 2515245920954925. https://doi.org/10.1177/2515245920954925 ● Otwarty dostęp
- Gelman, A., & Loken, E. (2014). The statistical crisis in science. American Scientist, 102(6), 460. https://doi.org/10.1511/2014.111.460
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Ratcliff, R. (1993). Methods for dealing with reaction time outliers. Psychological Bulletin, 114(3), 510–532. https://doi.org/10.1037/0033-2909.114.3.510
- Silberzahn, R., Uhlmann, E. L., Martin, D. P., Anselmi, P., Aust, F., Awtrey, E., Bahník, Š., Bai, F., Bannard, C., Bonnier, E., Carlsson, R., Cheung, F., Christensen, G., Clay, R., Craig, M. A., Dalla Rosa, A., Dam, L., Evans, M. H., Flores Cervantes, I., . . . Nosek, B. A. (2018). Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results. Advances in Methods and Practices in Psychological Science, 1(3), 337–356. https://doi.org/10.1177/2515245917747646 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Simonsohn, U., Simmons, J. P., & Nelson, L. D. (2020). Specification curve analysis. Nature Human Behaviour, 4(11), 1208–1214. https://doi.org/10.1038/s41562-020-0912-z
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
Cytowania BibTeX
@article{delgiudice2021traveler, author={Del Giudice, Marco and Gangestad, Steven W.}, title={{A traveler’s guide to the multiverse: Promises, pitfalls, and a framework for the evaluation of analytic decisions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={1}, eid={2515245920954925}, doi={10.1177/2515245920954925}}@article{gelman2014statistical, author={Gelman, Andrew and Loken, Eric}, title={{The statistical crisis in science}}, journal={American Scientist}, year={2014}, volume={102}, number={6}, pages={460}, doi={10.1511/2014.111.460}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{ratcliff1993methods, author={Ratcliff, Roger}, title={{Methods for dealing with reaction time outliers}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={510--532}, doi={10.1037/0033-2909.114.3.510}}@article{silberzahn2018many, author={Silberzahn, R. and Uhlmann, E. L. and Martin, D. P. and Anselmi, P. and Aust, F. and Awtrey, E. and Bahník, Š. and Bai, F. and Bannard, C. and Bonnier, E. and Carlsson, R. and Cheung, F. and Christensen, G. and Clay, R. and Craig, M. A. and Dalla Rosa, A. and Dam, L. and Evans, M. H. and Flores Cervantes, I. and Fong, N. and Gamez-Djokic, M. and Glenz, A. and Gordon-McKeon, S. and Heaton, T. J. and Hederos, K. and Heene, M. and Hofelich Mohr, A. J. and Högden, F. and Hui, K. and Johannesson, M. and Kalodimos, J. and Kaszubowski, E. and Kennedy, D. M. and Lei, R. and Lindsay, T. A. and Liverani, S. and Madan, C. R. and Molden, D. and Molleman, E. and Morey, R. D. and Mulder, L. B. and Nijstad, B. R. and Pope, N. G. and Pope, B. and Prenoveau, J. M. and Rink, F. and Robusto, E. and Roderique, H. and Sandberg, A. and Schlüter, E. and Schönbrodt, F. D. and Sherman, M. F. and Sommer, S. A. and Sotak, K. and Spain, S. and Spörlein, C. and Stafford, T. and Stefanutti, L. and Tauber, S. and Ullrich, J. and Vianello, M. and Wagenmakers, E.-J. and Witkowiak, M. and Yoon, S. and Nosek, B. A.}, title={{Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={337--356}, doi={10.1177/2515245917747646}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{simonsohn2020specification, author={Simonsohn, Uri and Simmons, Joseph P. and Nelson, Leif D.}, title={{Specification curve analysis}}, journal={Nature Human Behaviour}, year={2020}, volume={4}, number={11}, pages={1208--1214}, doi={10.1038/s41562-020-0912-z}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}