Po co analiza wrażliwości i czym nie jest
Każda analiza danych to ciąg decyzji: co zrobić z brakami, czy usunąć obserwacje odstające, które zmienne kontrolować, jak zdefiniować wynik. Większość z nich da się uzasadnić na kilka sposobów. Analiza wrażliwości (ang. sensitivity analysis, w ekonomii częściej robustness check) sprawdza, czy wniosek z analizy głównej przetrwa inne rozsądne wersje tych decyzji. Thabane i in. (2013) opisują ją jako ocenę, jak na wnioski wpływają kluczowe założenia: metoda analizy, definicja wyniku, odstępstwa od protokołu, braki danych i obserwacje odstające.
Pojęcie i jego drugie znaczenie, czyli analizę wrażliwości mocy, wyjaśniamy w haśle analiza wrażliwości. Ten wpis jest dla osób, które przygotowują artykuł albo rozdział rozprawy i muszą zdecydować, które warianty policzyć, jak je pokazać i co napisać, gdy któryś z nich zmienia wynik.
Analiza wrażliwości nie jest szukaniem wersji, w której wynik „wychodzi”. Analizę główną ustalasz przed zobaczeniem wyników, najlepiej w prerejestracji albo w planie analizy statystycznej. Warianty pokazujesz obok niej, a nie zamiast niej. Gdy raportujesz tylko wariant z p < .05, analiza wrażliwości staje się p-hackingiem.
Jak wybrać warianty: trzy pytania
Najczęstszy błąd to lista przypadkowych analiz, które nie mogą niczego podważyć. Morris i in. (2014) proponują sprawdzić każdy kandydujący wariant trzema pytaniami:
- Czy odpowiada na to samo pytanie co analiza główna? Analiza w podgrupie kobiet albo dla innego wyniku zadaje inne pytanie. To analiza podgrup lub analiza dodatkowa, a nie wrażliwości.
- Czy może dać inny wynik? Jeśli wariant z definicji musi dać ten sam wynik, niczego nie testuje.
- Czy przy rozbieżności nie byłoby jasne, któremu wynikowi wierzyć? Jeśli jeden wariant jest oczywiście błędny, rozbieżność niczego nie mówi o odporności.
Według autorów tylko wariant z trzema odpowiedziami „tak” jest analizą wrażliwości. Pozostałe mogą być ciekawe, ale nazwane analizą wrażliwości wprowadzają czytelnika w błąd. W praktyce każdy wariant powinien zmieniać jedno założenie analizy głównej:
| Rodzina | Założenie, które sprawdzasz | Przykładowe warianty |
|---|---|---|
| Braki danych | mechanizm braków (MAR czy MNAR) | przypadki kompletne, imputacja wielokrotna, imputacja z przesunięciem δ |
| Obserwacje odstające | czy kilka osób nie decyduje o wyniku | z nimi i bez nich, regresja odporna, wykluczenie obserwacji wpływowych |
| Założenia modelu | stała wariancja reszt, postać zależności | odporne błędy standardowe, transformacja, model nieliniowy |
| Specyfikacja | dobór kowariantów, definicja wyniku | inny zestaw kowariantów, wynik ciągły i dychotomiczny |
| Próba | reguły wykluczeń | z osobami, które nie zaliczyły pytania kontrolnego |
| Niezmierzone zakłócenia | brak pominiętej zmiennej zakłócającej | E-value, analiza ilościowa obciążenia |
Przykład: aktywność fizyczna a objawy depresji
W badaniu przekrojowym 520 dorosłych podało, ile godzin tygodniowo poświęca na aktywność fizyczną, i wypełniło PHQ-9 (0–27 pkt). Zebrano też wiek, płeć, chorobę przewlekłą i ocenę sytuacji materialnej (1–5). Dane są symulowane (set.seed(1990)) i możesz je pobrać jako plik CSV.
W danych są trzy typowe problemy. Wyniku PHQ-9 brakuje u 76 osób, a oceny sytuacji materialnej u 27. Trzydzieści osób nie zaliczyło pytania kontrolnego. Siedem osób podało aktywność powyżej 14.3 godziny tygodniowo, co według reguły Tukeya (Q3 + 3 × IQR) jest wartością skrajną. Średnia aktywność wyniosła 3.93 godziny (SD = 3.27), a średni wynik PHQ-9 10.05 (SD = 4.79).
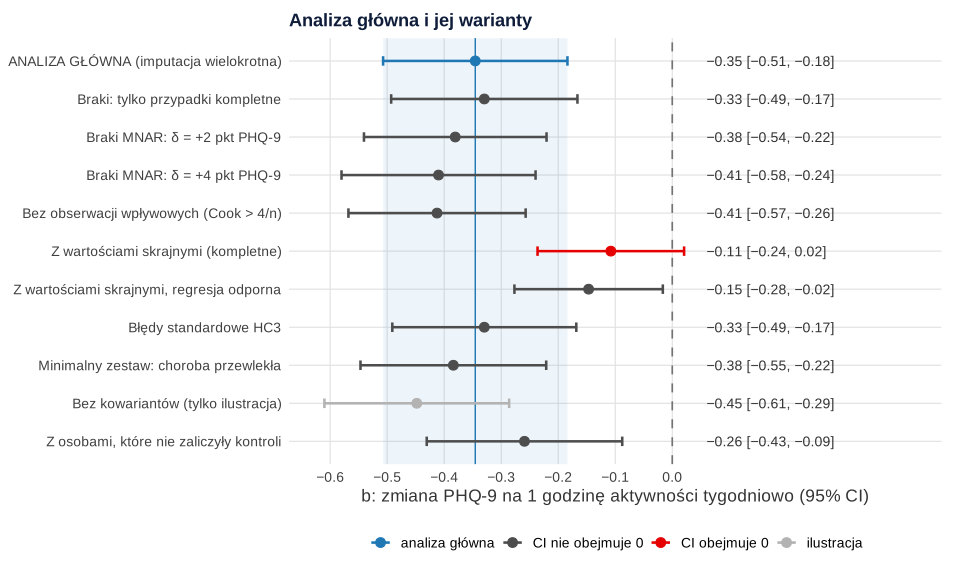
Analiza główna zapisana w planie: regresja liniowa PHQ-9 względem aktywności z czterema kowariantami. Do analizy weszły osoby, które zaliczyły pytanie kontrolne, bez wartości skrajnych aktywności (n = 484). Braki uzupełniono imputacją wielokrotną (20 zbiorów). Każda dodatkowa godzina aktywności tygodniowo wiązała się z wynikiem PHQ-9 niższym o 0.35 pkt, b = −0.35, 95% CI [−0.51, −0.18], p < .001. Pytanie brzmi: na ile ten wynik zależy od trzech decyzji o brakach, wartościach skrajnych i wykluczeniach?
Braki danych: od MAR do MNAR
Imputacja wielokrotna zakłada, że braki są losowe pod warunkiem zmiennych w modelu (MAR, zob. MCAR, MAR i MNAR). Tego założenia nie da się sprawdzić na danych, więc warto zobaczyć, co się stanie, gdy jest fałszywe. Pierwszy wariant to analiza przypadków kompletnych (n = 393): b = −0.33, 95% CI [−0.49, −0.17]. Jest to jednak wariant słabszy niż analiza główna, bo przy MAR może być obciążony. Szczegóły imputacji opisujemy w poradniku braki danych i imputacja wielokrotna w R.
Bardziej wymagający test to imputacja z przesunięciem δ (ang. δ-adjustment). Cro i in. (2020) opisują ją jako dodanie przesunięcia δ do wartości imputowanych. Sprawdzasz w ten sposób, co by było, gdyby osoby bez wyniku miały gorszą lub lepszą odpowiedź niż przewiduje model MAR. W przykładzie przyjęliśmy, że osoby bez PHQ-9 mają wynik wyższy o 2 albo 4 pkt. Efekt aktywności nawet się wzmocnił: b = −0.38 i −0.41. To dlatego, że braki były częstsze u osób mniej aktywnych. Gdy chcesz znaleźć wartość δ, przy której wniosek się zmienia (punkt krytyczny, tipping point), skorzystaj z procedury z wpisu plan analiz do wniosku grantowego.
Obserwacje odstające i wpływowe
Leys i in. (2019) radzą zapisać sposób wykrywania obserwacji odstających i postępowania z nimi w prerejestracji, a bez niej podać wyniki z nimi i bez nich. W przykładzie reguła była zapisana, ale warto sprawdzić jej skutki. Tu wynik okazał się czuły:
- bez dodatkowych obserwacji wpływowych (odległość Cooka > 4/n, 20 osób): b = −0.41, 95% CI [−0.57, −0.26];
- z siedmioma wartościami skrajnymi aktywności: b = −0.11, 95% CI [−0.24, 0.02], p = .100;
- z wartościami skrajnymi, ale w regresji odpornej (estymator M Hubera,
MASS::rlm): b = −0.15, 95% CI [−0.28, −0.02], p = .027.
Siedem osób, czyli niecałe 2% próby, zmniejsza efekt o dwie trzecie w porównaniu z analizą przypadków kompletnych (−0.33). Nie jest to powód, by je po cichu usunąć ani by porzucić analizę główną. To informacja, którą trzeba podać. Osoby bardzo aktywne i z silnymi objawami mogą być błędem pomiaru, ale też sygnałem, że zależność nie jest liniowa. Wtedy kolejnym krokiem jest model nieliniowy (zob. splajny i modele GAM). Kiedy usunięcie jest uzasadnione, omawiamy we wpisie wartości odstające: jak je wykryć.
Kowarianty, definicja wyniku i wykluczenia
Pozostałe warianty zmieniają model albo próbę. Dla prostoty liczyliśmy je na przypadkach kompletnych, więc porównuj je z wynikiem b = −0.33, a nie z analizą główną.
- Błędy standardowe. Odporne błędy standardowe HC3 nie wymagają założenia o stałej wariancji reszt (White, 1980). Przedział praktycznie się nie zmienił: [−0.49, −0.17].
- Kowarianty. Z minimalnym zestawem, czyli samą chorobą przewlekłą, efekt wyniósł b = −0.38, 95% CI [−0.55, −0.22]. Choroba przewlekła ogranicza aktywność i nasila objawy, więc jest zmienną zakłócającą. Model bez niej daje b = −0.45, ale nie jest wariantem analizy wrażliwości. Przy rozbieżności wiadomo, któremu wynikowi wierzyć, więc odpada trzecie pytanie Morrisa i in. (2014). Na rysunku 1 pokazujemy go tylko jako ilustrację. Dobór kowariantów uzasadnij przed analizą, np. grafem przyczynowym (zob. grafy przyczynowe DAG).
- Definicja wyniku. Z wynikiem dychotomicznym (PHQ-9 ≥ 10) w regresji logistycznej iloraz szans na godzinę aktywności wyniósł OR = 0.877, 95% CI [0.805, 0.955], p = .003. Kierunek i wniosek są te same, choć skala jest inna.
- Wykluczenia. Po włączeniu 30 osób, które nie zaliczyły pytania kontrolnego, efekt osłabł do b = −0.26, 95% CI [−0.43, −0.09]. Odpowiedzi przypadkowe rozmywają związek. O wykrywaniu takich osób piszemy we wpisie nieuważne odpowiedzi w ankietach online.
Krzywa specyfikacji: wszystkie kombinacje naraz
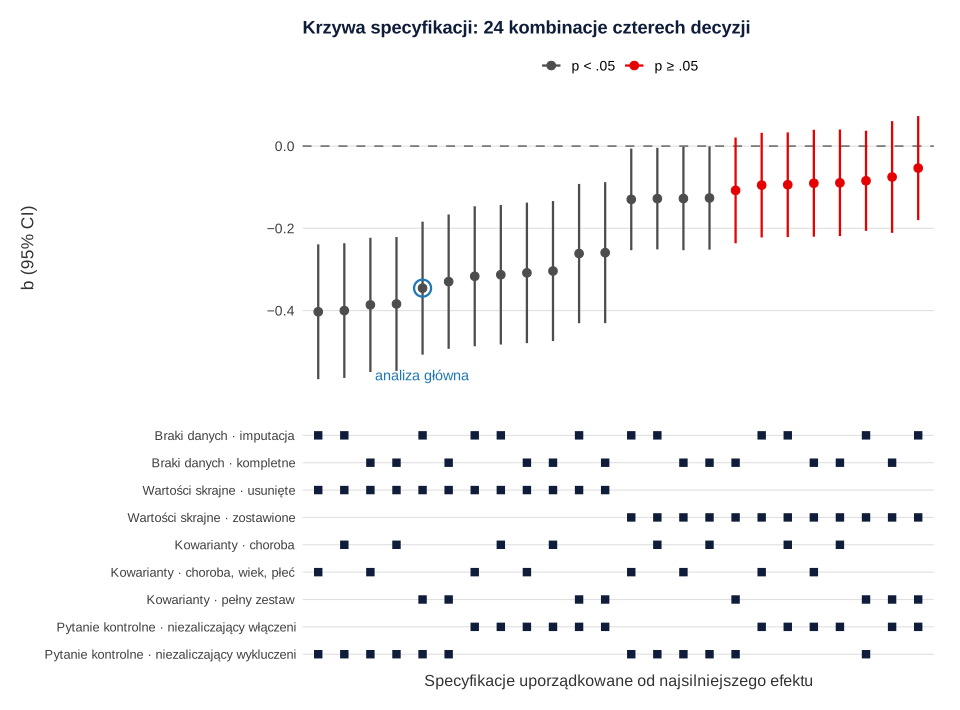
Warianty „po jednym” nie pokazują, co się dzieje, gdy kilka decyzji zmienia się jednocześnie. Steegen i in. (2016) proponują analizę wieloświatową (multiverse analysis): liczysz analizę na wszystkich zbiorach danych wynikających z rozsądnych decyzji i sprawdzasz, które decyzje ważą najwięcej. Simonsohn i in. (2020) opisują pokrewną krzywą specyfikacji w trzech krokach. Najpierw ustalasz zbiór specyfikacji uzasadnionych teoretycznie, poprawnych statystycznie i nieredundantnych. Potem pokazujesz wyniki na wykresie. Na końcu wnioskujesz ze wszystkich specyfikacji łącznie. Jak bardzo wyniki mogą zależeć od takich wyborów, pokazuje badanie Silberzahna i in. (2018). Dwadzieścia dziewięć zespołów analizowało te same dane i 69% z nich uzyskało istotny efekt, a 31% nie.
W przykładzie skrzyżowaliśmy cztery decyzje: braki (kompletne lub imputacja), wartości skrajne (usunięte lub zostawione), kowarianty (choroba przewlekła; choroba, wiek i płeć; pełny zestaw) i osoby, które nie zaliczyły pytania kontrolnego (wykluczone lub włączone). Każdy zestaw kowariantów zawiera zmienną zakłócającą, więc wszystkie specyfikacje są uzasadnione. Daje to 2 × 2 × 3 × 2 = 24 specyfikacje. Wszystkie dały ujemny współczynnik, od −0.40 do −0.05 (mediana −0.19), a 16 z 24 miało p < .05. Osiem nieistotnych specyfikacji łączy jedno: zostawione wartości skrajne. Średni współczynnik wynosił −0.33 przy usuniętych i −0.10 przy zostawionych wartościach skrajnych. Sposób postępowania z brakami prawie nic nie zmieniał (−0.22 w obu wersjach).
Pełną analizę wieloświatową z wnioskowaniem łącznym pokazujemy we wpisie reanaliza i wtórna analiza danych. We własnym artykule często wystarczy krzywa specyfikacji w materiałach uzupełniających i zdanie o decyzji, która ma największe znaczenie.
Niezmierzone zakłócenia: E-value
W badaniu obserwacyjnym żaden z powyższych wariantów nie odpowiada na pytanie recenzenta: „A gdyby istniała zmienna, której nie zmierzyliście?”. VanderWeele i Ding (2017) zaproponowali E-value. To najmniejsza siła związku, na skali ryzyka względnego, jaką niezmierzona zmienna zakłócająca musiałaby mieć jednocześnie z ekspozycją i z wynikiem, by całkowicie wyjaśnić obserwowany związek. Autorzy zalecają podawać ją dla oszacowania punktowego i dla granicy przedziału bliższej braku efektu. Wzór i przykład obliczeń dla wyniku dychotomicznego znajdziesz w kroku 7 wpisu propensity score: dopasowanie i ważenie.
Jak opisać analizy wrażliwości w artykule
Thabane i in. (2013) zalecają raportować planowane i dodane po fakcie analizy wrażliwości wraz z uzasadnieniem, wynikami i omówieniem skutków dla wniosków. W praktyce:
- Metoda: analiza główna i lista wariantów z informacją, które były zaplanowane;
- Wyniki: jeden akapit z zakresem oszacowań i nazwą decyzji, od której wynik zależy;
- Materiały uzupełniające: tabela wszystkich wariantów (n, oszacowanie, 95% CI, p) i krzywa specyfikacji, razem z kodem (zob. pakiet replikacyjny);
- Dyskusja: co rozbieżności znaczą dla wniosku, bez zamiany analizy głównej po fakcie.
Gdy recenzent prosi o analizy wrażliwości po złożeniu artykułu, przyda się zestaw wzorów z wpisu odpowiedź recenzentom. Jeśli chcesz, żeby ktoś z zewnątrz sprawdził listę wariantów i kod, możemy to zrobić w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik analiza-wrazliwosci-dane.csv (możesz go pobrać tutaj) i liczy analizę główną. Drugi liczy warianty z tabeli i rysunku 1, a trzeci krzywą specyfikacji. Cały kod wykonuje się w kilka sekund, a sama krzywa specyfikacji z czterema zestawami imputacji zajęła 1.8 s.
1. Dane i analiza główna
R
# Krok 1: dane i analiza główna zapisana w planie (dane symulowane)
# Badanie przekrojowe: aktywność fizyczna (godziny w tygodniu) a objawy depresji (PHQ-9, 0–27)
suppressPackageStartupMessages(library(mice))
set.seed(1990)
n <- 520
kobieta    <- rbinom(n, 1, 0.58)
wiek       <- round(runif(n, 20, 65))
przewlekla <- rbinom(n, 1, plogis(-1.6 + 0.04 * (wiek - 40)))               # choroba przewlekła
materialna <- pmin(pmax(round(rnorm(n, 3.2, 0.9)), 1), 5)                    # sytuacja materialna 1–5
aktywnosc  <- pmax(0, round(rgamma(n, shape = 2.2, rate = 0.55) - 1.2 * przewlekla + 0.3 * (materialna - 3), 1))
phq        <- 10.5 - 0.30 * aktywnosc + 2.2 * przewlekla + 0.9 * kobieta - 0.8 * (materialna - 3) -
              0.03 * (wiek - 40) + rnorm(n, 0, 4.3)
uwaga_ok   <- rbinom(n, 1, 0.95) == 1                                        # pytanie kontrolne zaliczone
phq[!uwaga_ok] <- runif(sum(!uwaga_ok), 0, 27)                               # odpowiedzi przypadkowe
# sześć osób z bardzo wysoką deklarowaną aktywnością i silnymi objawami (np. trening wyczynowy, przetrenowanie)
odst <- sample(which(uwaga_ok), 6); aktywnosc[odst] <- round(runif(6, 18, 26)); phq[odst] <- runif(6, 11, 17)
phq <- pmin(pmax(round(phq), 0), 27)
# braki PHQ-9 częstsze u młodszych i mniej aktywnych (MAR względem zmiennych w modelu)
brak_phq <- runif(n) < plogis(-1.7 - 0.03 * (wiek - 40) - 0.12 * (aktywnosc - 4))
phq[brak_phq] <- NA
materialna[runif(n) < 0.05] <- NA
# reguła z planu: wartość skrajna, gdy aktywność > Q3 + 3 × IQR (reguła Tukeya)
prog <- quantile(aktywnosc, .75) + 3 * IQR(aktywnosc)
dane <- data.frame(phq, aktywnosc, wiek, kobieta, przewlekla, materialna, uwaga_ok, skrajna = aktywnosc > prog)
write.csv(dane, "analiza-wrazliwosci-dane.csv", row.names = FALSE)

c(N = n, braki_phq = sum(is.na(dane$phq)), braki_materialna = sum(is.na(dane$materialna)),
  nie_zaliczyli_kontroli = sum(!dane$uwaga_ok), skrajne_aktywnosc = sum(dane$skrajna))
round(prog, 1)
round(c(M_akt = mean(dane$aktywnosc), SD_akt = sd(dane$aktywnosc),
        M_phq = mean(dane$phq, na.rm = TRUE), SD_phq = sd(dane$phq, na.rm = TRUE)), 2)

# Analiza główna (z planu): osoby, które zaliczyły pytanie kontrolne, bez wartości skrajnych aktywności,
# pełny zestaw kowariantów, braki uzupełnione imputacją wielokrotną (m = 20)
wzor_pelny <- phq ~ aktywnosc + wiek + kobieta + przewlekla + materialna
glowna <- subset(dane, uwaga_ok & !skrajna, select = phq:materialna)
imp <- mice(glowna, m = 20, method = "pmm", printFlag = FALSE, seed = 19901)
pool_glowna <- summary(pool(with(imp, lm(phq ~ aktywnosc + wiek + kobieta + przewlekla + materialna))), conf.int = TRUE)
print(cbind(term = as.character(pool_glowna$term), round(pool_glowna[, c("estimate", "std.error", "df", "p.value", "2.5 %", "97.5 %")], 3)),
      row.names = FALSE)
Wynik w R
                     N              braki_phq       braki_materialna nie_zaliczyli_kontroli
                   520                     76                     27                     30
     skrajne_aktywnosc
                     7
 75%
14.3
 M_akt SD_akt  M_phq SD_phq
  3.93   3.27  10.05   4.79
        term estimate std.error      df p.value  2.5 % 97.5 %
 (Intercept)   14.109     1.095 255.218   0.000 11.954 16.265
   aktywnosc   -0.345     0.082 331.206   0.000 -0.507 -0.184
        wiek   -0.006     0.016 361.017   0.692 -0.038  0.025
     kobieta    0.717     0.420 303.587   0.089 -0.109  1.544
  przewlekla    2.173     0.564 226.297   0.000  1.062  3.284
  materialna   -1.068     0.224 333.677   0.000 -1.509 -0.626
2. Zaplanowane warianty
R
# Krok 2: zaplanowane analizy wrażliwości – każda zmienia jedno założenie analizy głównej
# Wymaga obiektów z kroku 1 (dane, glowna, imp, pool_glowna, wzor_pelny)
suppressPackageStartupMessages({ library(MASS); library(sandwich); library(mice) })

wiersz <- function(wariant, est, se, df, n) {
  t <- qt(.975, df)
  data.frame(wariant, n, b = est, dolny = est - t * se, gorny = est + t * se, p = 2 * pt(-abs(est / se), df))
}
z_lm <- function(wariant, m, se = sqrt(diag(vcov(m)))[["aktywnosc"]])
  wiersz(wariant, coef(m)[["aktywnosc"]], se, df.residual(m), nobs(m))
z_pool <- function(wariant, imp_obj, wzor) {
  s <- summary(pool(with(imp_obj, lm(as.formula(paste(deparse(wzor), collapse = ""))))))
  s <- s[s$term == "aktywnosc", ]
  wiersz(wariant, s$estimate, s$std.error, s$df, nrow(imp_obj$data))
}

tab <- z_pool("Analiza główna: imputacja wielokrotna", imp, wzor_pelny)

# 1. Braki danych: analiza przypadków kompletnych
cc <- lm(wzor_pelny, data = glowna)
tab <- rbind(tab, z_lm("Braki: tylko przypadki kompletne", cc))

# 2. Braki MNAR: osoby bez PHQ-9 mają wynik gorszy o δ punktów niż przewiduje imputacja (δ-adjustment)
for (delta in c(2, 4)) {
  post <- imp$post
  post["phq"] <- paste0("imp[[j]][, i] <- imp[[j]][, i] + ", delta)
  imp_d <- mice(glowna, m = 20, method = "pmm", post = post, printFlag = FALSE, seed = 19901)
  tab <- rbind(tab, z_pool(paste0("Braki MNAR: δ = +", delta, " pkt PHQ-9"), imp_d, wzor_pelny))
}

# 3. Obserwacje odstające i wpływowe
cc_cook <- lm(wzor_pelny, data = model.frame(cc)[cooks.distance(cc) <= 4 / nobs(cc), ])
tab <- rbind(tab, z_lm("Bez obserwacji wpływowych (Cook > 4/n)", cc_cook))
pelne <- subset(dane, uwaga_ok, select = phq:materialna)               # z wartościami skrajnymi aktywności
tab <- rbind(tab, z_lm("Z wartościami skrajnymi (kompletne)", lm(wzor_pelny, data = pelne)))
rob <- rlm(wzor_pelny, data = pelne)                                   # regresja odporna (estymator M Hubera) z wartościami skrajnymi
n_rob <- length(rob$residuals)
tab <- rbind(tab, wiersz("Z wartościami skrajnymi, regresja odporna", coef(rob)[["aktywnosc"]],
                         summary(rob)$coefficients["aktywnosc", 2], n_rob - length(coef(rob)), n_rob))

# 4. Błędy standardowe odporne na heteroskedastyczność (HC3)
tab <- rbind(tab, z_lm("Błędy standardowe HC3", cc, sqrt(diag(vcovHC(cc, type = "HC3")))[["aktywnosc"]]))

# 5. Inne specyfikacje modelu
tab <- rbind(tab, z_lm("Minimalny zestaw: choroba przewlekła", lm(phq ~ aktywnosc + przewlekla, data = glowna)))
tab <- rbind(tab, z_lm("Bez kowariantów (tylko ilustracja)", lm(phq ~ aktywnosc, data = glowna)))   # pomija znany czynnik zakłócający
tab <- rbind(tab, z_lm("Z osobami, które nie zaliczyły kontroli",
                       lm(wzor_pelny, data = subset(dane, !skrajna))))

print(cbind(tab[1:2], round(tab[3:6], 3)), row.names = FALSE)

# 6. Inna definicja wyniku: PHQ-9 ≥ 10 (regresja logistyczna, iloraz szans na 1 godzinę aktywności)
lg <- glm(I(phq >= 10) ~ aktywnosc + wiek + kobieta + przewlekla + materialna, family = binomial, data = glowna)
round(exp(c(OR = coef(lg)[["aktywnosc"]], confint.default(lg)["aktywnosc", ])), 3)
round(summary(lg)$coefficients["aktywnosc", 4], 3)
write.csv(tab, "b199-warianty.csv", row.names = FALSE)
Wynik w R
                                   wariant   n      b  dolny  gorny     p
     Analiza główna: imputacja wielokrotna 484 -0.345 -0.507 -0.184 0.000
          Braki: tylko przypadki kompletne 393 -0.330 -0.493 -0.166 0.000
              Braki MNAR: δ = +2 pkt PHQ-9 484 -0.381 -0.541 -0.220 0.000
              Braki MNAR: δ = +4 pkt PHQ-9 484 -0.410 -0.580 -0.240 0.000
    Bez obserwacji wpływowych (Cook > 4/n) 373 -0.413 -0.568 -0.257 0.000
       Z wartościami skrajnymi (kompletne) 398 -0.108 -0.236  0.021 0.100
 Z wartościami skrajnymi, regresja odporna 398 -0.147 -0.277 -0.017 0.027
                     Błędy standardowe HC3 393 -0.330 -0.491 -0.168 0.000
      Minimalny zestaw: choroba przewlekła 412 -0.384 -0.547 -0.221 0.000
        Bez kowariantów (tylko ilustracja) 412 -0.448 -0.610 -0.286 0.000
   Z osobami, które nie zaliczyły kontroli 416 -0.259 -0.431 -0.088 0.003
    OR  2.5 % 97.5 %
 0.877  0.805  0.955
[1] 0.003
3. Krzywa specyfikacji
R
# Krok 3: krzywa specyfikacji – wszystkie kombinacje czterech rozsądnych decyzji (2 × 2 × 3 × 2 = 24)
# Wymaga obiektów z kroku 1 (dane)
suppressPackageStartupMessages(library(mice))
start <- Sys.time()
# każdy zestaw zawiera chorobę przewlekłą – znany czynnik zakłócający (model bez niej nie jest rozsądną specyfikacją)
kowarianty <- list("choroba" = " + przewlekla", "choroba, wiek, płeć" = " + przewlekla + wiek + kobieta",
                   "pełny zestaw" = " + przewlekla + wiek + kobieta + materialna")
decyzje <- expand.grid(braki = c("kompletne", "imputacja"), skrajne = c("usunięte", "zostawione"),
                       kowarianty = names(kowarianty), kontrola = c("wykluczeni", "włączeni"),
                       stringsAsFactors = FALSE)
imputacje <- list()                                    # jedna imputacja na podzbiór, wspólna dla modeli
spec <- do.call(rbind, lapply(seq_len(nrow(decyzje)), function(i) {
  d <- decyzje[i, ]
  pod <- dane[(dane$uwaga_ok | d$kontrola == "włączeni") & (!dane$skrajna | d$skrajne == "zostawione"),
              c("phq", "aktywnosc", "wiek", "kobieta", "przewlekla", "materialna")]
  wzor <- paste0("phq ~ aktywnosc", kowarianty[[d$kowarianty]])
  if (d$braki == "kompletne") {
    m <- lm(as.formula(wzor), data = pod)
    est <- coef(m)[["aktywnosc"]]; se <- sqrt(vcov(m)["aktywnosc", "aktywnosc"]); df <- df.residual(m)
  } else {
    klucz <- paste(d$skrajne, d$kontrola)
    if (is.null(imputacje[[klucz]]))
      imputacje[[klucz]] <<- mice(pod, m = 20, method = "pmm", printFlag = FALSE, seed = 19901)
    s <- summary(pool(with(imputacje[[klucz]], lm(as.formula(wzor)))))
    s <- s[s$term == "aktywnosc", ]; est <- s$estimate; se <- s$std.error; df <- s$df
  }
  cbind(d, b = est, dolny = est - qt(.975, df) * se, gorny = est + qt(.975, df) * se, p = 2 * pt(-abs(est / se), df))
}))
spec <- spec[order(spec$b), ]
print(cbind(spec[1:4], round(spec[5:8], 3)), row.names = FALSE)
c(specyfikacje = nrow(spec), ujemne = sum(spec$b < 0), istotne_p_05 = sum(spec$p < .05))
round(c(mediana_b = median(spec$b), min_b = min(spec$b), max_b = max(spec$b)), 3)
# Które decyzje ważą najwięcej: średnie b w obrębie każdej decyzji
for (k in c("braki", "skrajne", "kowarianty", "kontrola")) print(round(tapply(spec$b, spec[[k]], mean), 3))
cat("Czas (s):", round(as.numeric(difftime(Sys.time(), start, units = "secs")), 1), "\n")
write.csv(spec, "b199-specyfikacje.csv", row.names = FALSE)
Wynik w R
     braki    skrajne          kowarianty   kontrola      b  dolny  gorny     p
 imputacja   usunięte choroba, wiek, płeć wykluczeni -0.403 -0.567 -0.239 0.000
 imputacja   usunięte             choroba wykluczeni -0.400 -0.564 -0.236 0.000
 kompletne   usunięte choroba, wiek, płeć wykluczeni -0.386 -0.549 -0.223 0.000
 kompletne   usunięte             choroba wykluczeni -0.384 -0.547 -0.221 0.000
 imputacja   usunięte        pełny zestaw wykluczeni -0.345 -0.507 -0.184 0.000
 kompletne   usunięte        pełny zestaw wykluczeni -0.330 -0.493 -0.166 0.000
 imputacja   usunięte choroba, wiek, płeć   włączeni -0.317 -0.487 -0.146 0.000
 imputacja   usunięte             choroba   włączeni -0.313 -0.483 -0.143 0.000
 kompletne   usunięte choroba, wiek, płeć   włączeni -0.308 -0.479 -0.137 0.000
 kompletne   usunięte             choroba   włączeni -0.304 -0.474 -0.134 0.001
 imputacja   usunięte        pełny zestaw   włączeni -0.261 -0.431 -0.092 0.003
 kompletne   usunięte        pełny zestaw   włączeni -0.259 -0.431 -0.088 0.003
 imputacja zostawione choroba, wiek, płeć wykluczeni -0.130 -0.253 -0.006 0.040
 imputacja zostawione             choroba wykluczeni -0.128 -0.251 -0.004 0.043
 kompletne zostawione choroba, wiek, płeć wykluczeni -0.128 -0.253 -0.002 0.047
 kompletne zostawione             choroba wykluczeni -0.126 -0.252 -0.001 0.049
 kompletne zostawione        pełny zestaw wykluczeni -0.108 -0.236  0.021 0.100
 imputacja zostawione choroba, wiek, płeć   włączeni -0.095 -0.222  0.032 0.143
 imputacja zostawione             choroba   włączeni -0.094 -0.221  0.033 0.147
 kompletne zostawione choroba, wiek, płeć   włączeni -0.090 -0.220  0.040 0.172
 kompletne zostawione             choroba   włączeni -0.089 -0.219  0.040 0.176
 imputacja zostawione        pełny zestaw wykluczeni -0.084 -0.206  0.037 0.174
 kompletne zostawione        pełny zestaw   włączeni -0.075 -0.211  0.061 0.277
 imputacja zostawione        pełny zestaw   włączeni -0.054 -0.180  0.073 0.406
specyfikacje       ujemne istotne_p_05
          24           24           16
mediana_b     min_b     max_b
   -0.194    -0.403    -0.054
imputacja kompletne
   -0.219    -0.216
  usunięte zostawione
    -0.334     -0.100
            choroba choroba, wiek, płeć        pełny zestaw
             -0.230              -0.232              -0.190
  włączeni wykluczeni
    -0.188     -0.246
Czas (s): 1.8
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), glm(), pakiety mice 3.19.0, MASS 7.3.65 i sandwich 3.1.1); rysunki przygotowano w pakietach ggplot2 4.0.2 i patchwork 1.3.2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- sandwich (wersja 3.1.1): Zeileis, A. (2006). Object-oriented computation of sandwich estimators. Journal of Statistical Software, 16(9), 1–16. https://doi.org/10.18637/jss.v016.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Zamiana analizy głównej po wynikach. Jeśli wariant „wychodzi lepiej”, nadal pozostaje wariantem.
- Warianty, które nie mogą niczego zmienić. Dziesięć analiz z tym samym założeniem o brakach nie testuje odporności na mechanizm braków.
- Analiza podgrup nazwana analizą wrażliwości. Inne pytanie to analiza dodatkowa (Morris i in., 2014).
- Raport tylko zgodnych wariantów. Rozbieżność też jest wynikiem i należy do tabeli.
- Ogólnik „wyniki były odporne”. Podaj zakres oszacowań i nazwij decyzję, od której wynik zależy najbardziej.
- Nierozsądne specyfikacje w krzywej. Model bez znanej zmiennej zakłócającej albo z oczywistym błędem danych nie jest uzasadnioną specyfikacją (Simonsohn i in., 2020) i sztucznie poszerza zakres wyników.
Najczęstsze pytania
Czym różni się analiza wrażliwości od analizy dodatkowej?
Analiza wrażliwości odpowiada na to samo pytanie co analiza główna, tylko przy innym założeniu, np. o brakach danych. Analiza dodatkowa (np. w podgrupie albo dla innego wyniku) zadaje inne pytanie. Morris i in. (2014) przestrzegają, że nazywanie analiz dodatkowych analizami wrażliwości może wprowadzać czytelnika w błąd.
Ile analiz wrażliwości podać w artykule?
Tyle, ile jest decyzji, które realnie mogą zmienić wniosek, zwykle kilka. Dla każdej kluczowej decyzji (braki danych, obserwacje odstające, kowarianty, definicja wyniku) wystarczy jeden lub dwa warianty. Pełne wyniki umieść w tabeli w materiałach uzupełniających, a w tekście głównym streść je jednym akapitem.
Co zrobić, gdy analiza wrażliwości daje inny wynik niż analiza główna?
Nie zmieniaj analizy głównej po fakcie. Opisz rozbieżność, wskaż decyzję, która ją powoduje, i złagodź wniosek, np. „związek zależy od siedmiu osób o skrajnie wysokiej aktywności”. Taki wynik jest informacją dla czytelnika, a nie porażką analizy.
Czy analizę wrażliwości trzeba zaplanować w prerejestracji?
Najlepiej tak: zapisz analizę główną i listę wariantów przed analizą danych. Analizy dodane po obejrzeniu wyników też można podać, ale oznacz je jako nieplanowane. Thabane i in. (2013) zalecają raportować zarówno planowane, jak i post hoc analizy wrażliwości, z uzasadnieniem i omówieniem skutków dla wniosków.
Czy krzywa specyfikacji zastępuje analizę główną?
Nie. Krzywa specyfikacji pokazuje, jak wynik zmienia się w całym zbiorze rozsądnych kombinacji decyzji, i pomaga wskazać decyzje ważące najwięcej. Analiza główna nadal jest tą, którą zapisałeś w planie, a krzywa jest jej uzupełnieniem w części o odporności wyników.
Powiązane hasła
Przeczytaj też
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikReanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →PoradnikOdpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →Recenzent pyta o odporność wyników albo planujesz analizy wrażliwości?
Pomożemy wybrać warianty, które naprawdę testują Twoje założenia, policzyć je i przygotować tabelę do materiałów uzupełniających tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cro, S., Morris, T. P., Kenward, M. G., & Carpenter, J. R. (2020). Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide. Statistics in Medicine, 39(21), 2815–2842. https://doi.org/10.1002/sim.8569 ● Otwarty dostęp
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Morris, T. P., Kahan, B. C., & White, I. R. (2014). Choosing sensitivity analyses for randomised trials: Principles. BMC Medical Research Methodology, 14(1), Article 11. https://doi.org/10.1186/1471-2288-14-11 ● Otwarty dostęp
- Silberzahn, R., Uhlmann, E. L., Martin, D. P., Anselmi, P., Aust, F., Awtrey, E., Bahník, Š., Bai, F., Bannard, C., Bonnier, E., Carlsson, R., Cheung, F., Christensen, G., Clay, R., Craig, M. A., Dalla Rosa, A., Dam, L., Evans, M. H., Flores Cervantes, I., . . . Nosek, B. A. (2018). Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results. Advances in Methods and Practices in Psychological Science, 1(3), 337–356. https://doi.org/10.1177/2515245917747646 ● Otwarty dostęp
- Simonsohn, U., Simmons, J. P., & Nelson, L. D. (2020). Specification curve analysis. Nature Human Behaviour, 4(11), 1208–1214. https://doi.org/10.1038/s41562-020-0912-z
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Thabane, L., Mbuagbaw, L., Zhang, S., Samaan, Z., Marcucci, M., Ye, C., Thabane, M., Giangregorio, L., Dennis, B., Kosa, D., Borg Debono, V., Dillenburg, R., Fruci, V., Bawor, M., Lee, J., Wells, G., & Goldsmith, C. H. (2013). A tutorial on sensitivity analyses in clinical trials: The what, why, when and how. BMC Medical Research Methodology, 13(1), Article 92. https://doi.org/10.1186/1471-2288-13-92 ● Otwarty dostęp
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/m16-2607 ● Otwarty dostęp: pełny tekst
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Cytowania BibTeX
@article{cro2020sensitivity, author={Cro, Suzie and Morris, Tim P. and Kenward, Michael G. and Carpenter, James R.}, title={{Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={21}, pages={2815--2842}, doi={10.1002/sim.8569}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{morris2014choosing, author={Morris, Tim P. and Kahan, Brennan C. and White, Ian R.}, title={{Choosing sensitivity analyses for randomised trials: Principles}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={11}, doi={10.1186/1471-2288-14-11}}@article{silberzahn2018many, author={Silberzahn, R. and Uhlmann, E. L. and Martin, D. P. and Anselmi, P. and Aust, F. and Awtrey, E. and Bahník, Š. and Bai, F. and Bannard, C. and Bonnier, E. and Carlsson, R. and Cheung, F. and Christensen, G. and Clay, R. and Craig, M. A. and Dalla Rosa, A. and Dam, L. and Evans, M. H. and Flores Cervantes, I. and Fong, N. and Gamez-Djokic, M. and Glenz, A. and Gordon-McKeon, S. and Heaton, T. J. and Hederos, K. and Heene, M. and Hofelich Mohr, A. J. and Högden, F. and Hui, K. and Johannesson, M. and Kalodimos, J. and Kaszubowski, E. and Kennedy, D. M. and Lei, R. and Lindsay, T. A. and Liverani, S. and Madan, C. R. and Molden, D. and Molleman, E. and Morey, R. D. and Mulder, L. B. and Nijstad, B. R. and Pope, N. G. and Pope, B. and Prenoveau, J. M. and Rink, F. and Robusto, E. and Roderique, H. and Sandberg, A. and Schlüter, E. and Schönbrodt, F. D. and Sherman, M. F. and Sommer, S. A. and Sotak, K. and Spain, S. and Spörlein, C. and Stafford, T. and Stefanutti, L. and Tauber, S. and Ullrich, J. and Vianello, M. and Wagenmakers, E.-J. and Witkowiak, M. and Yoon, S. and Nosek, B. A.}, title={{Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={337--356}, doi={10.1177/2515245917747646}}@article{simonsohn2020specification, author={Simonsohn, Uri and Simmons, Joseph P. and Nelson, Leif D.}, title={{Specification curve analysis}}, journal={Nature Human Behaviour}, year={2020}, volume={4}, number={11}, pages={1208--1214}, doi={10.1038/s41562-020-0912-z}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{thabane2013tutorial, author={Thabane, Lehana and Mbuagbaw, Lawrence and Zhang, Shiyuan and Samaan, Zainab and Marcucci, Maura and Ye, Chenglin and Thabane, Marroon and Giangregorio, Lora and Dennis, Brittany and Kosa, Daisy and Borg Debono, Victoria and Dillenburg, Rejane and Fruci, Vincent and Bawor, Monica and Lee, Juneyoung and Wells, George and Goldsmith, Charles H.}, title={{A tutorial on sensitivity analyses in clinical trials: The what, why, when and how}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={92}, doi={10.1186/1471-2288-13-92}}@article{vanderweele2017sensitivity, author={VanderWeele, Tyler J. and Ding, Peng}, title={{Sensitivity analysis in observational research: Introducing the E-value}}, journal={Annals of Internal Medicine}, year={2017}, volume={167}, number={4}, pages={268--274}, doi={10.7326/m16-2607}}@article{white1980heteroskedasticity, author={White, Halbert}, title={{A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}