Reanaliza, analiza wtórna czy replikacja? Najpierw nazwij to, co robisz
Praca na cudzych danych kusi doktorantów i doktorantki z prostego powodu: zbiór już istnieje, często jest duży, a jego zebranie kosztowało kogoś lata pracy. Zanim jednak otworzysz plik, ustal, jaki rodzaj ponownej analizy wykonujesz. Od tego zależy, jakie pytanie stawiasz, czego wymagać od danych i jak mocno wolno potem formułować wnioski.
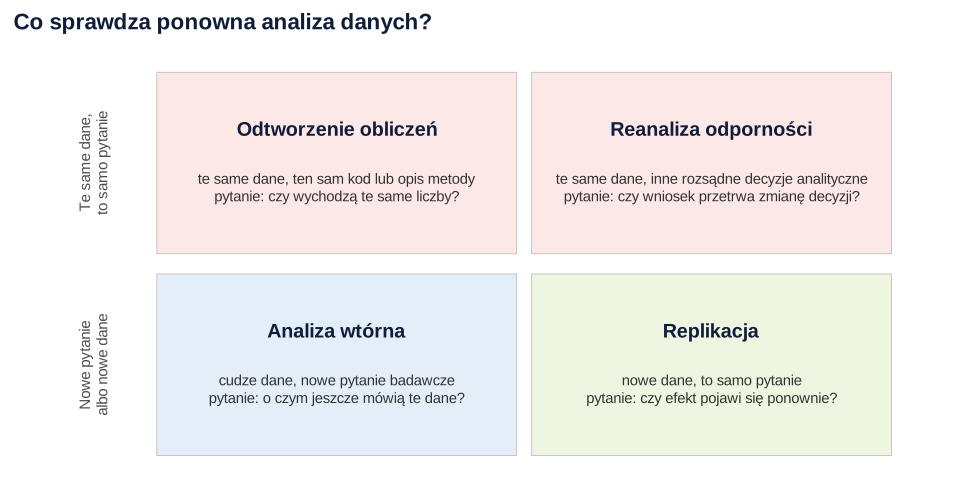
Raport National Academies of Sciences, Engineering, and Medicine (2019) odróżnia odtwarzalność (te same dane, te same kroki obliczeniowe, ten sam kod – oczekujesz niemal identycznych liczb) od replikowalności (nowe dane zebrane, by odpowiedzieć na to samo pytanie). Między tymi biegunami leżą dwie sytuacje, które w doktoracie zdarzają się najczęściej: reanaliza odporności i analiza wtórna. Rysunek 1 porządkuje wszystkie cztery.
| Rodzaj | Co sprawdzasz | Typowy wynik | Główne ryzyko |
|---|---|---|---|
| Odtworzenie obliczeń | Czy z udostępnionych danych i opisu metody wychodzą liczby z artykułu | Lista zgodnych i niezgodnych wartości | Uznanie każdej rozbieżności za błąd autorów |
| Reanaliza odporności | Czy wniosek przetrwa inne rozsądne decyzje: wykluczenia, kowarianty, sposób liczenia wyniku | Rozkład oszacowań z wielu wariantów analizy | Szukanie wariantu, który „obali” oryginał |
| Analiza wtórna | Nowe pytanie, na które autorzy zbioru nie odpowiadali | Nowy artykuł lub rozdział doktoratu | Zmienne zmierzone do innego celu, wiedza o danych przed analizą |
| Replikacja | Czy efekt pojawi się w nowej próbie | Nowe dane i porównanie z oryginałem | Zbyt mała próba, by rozstrzygnąć |
W praktyce te rodzaje się przeplatają. Jeśli planujesz analizę wtórną zbioru, który był już opisany w publikacjach, zacznij od krótkiego odtworzenia jednej czy dwóch tabel z oryginału. W ten sposób sprawdzisz, czy rozumiesz kodowanie zmiennych, zanim zbudujesz na nim własne modele.
Po co doktoratowi cudze dane
Weston i in. (2019) przypominają, że analiza danych wtórnych może być zarówno eksploracyjna, jak i konfirmacyjna, korelacyjna albo eksperymentalna. To pełnoprawne narzędzie badawcze, a nie zastępstwo „prawdziwego” badania. Dla doktoranta ma kilka konkretnych zalet:
- Liczebność. Ogólnokrajowe sondaże, badania panelowe i duże projekty zespołowe dają próby, których nie zbierzesz w ramach jednego grantu.
- Czas. Pierwszy artykuł z cyklu może powstać, zanim zakończysz własne badanie. O tym, jak zaplanować taki cykl bez dzielenia jednego badania na zbyt wiele artykułów, piszemy we wpisie doktorat z cyklu artykułów.
- Weryfikacja literatury. Reanaliza kluczowego badania w Twojej dziedzinie pokazuje, jak mocny jest fundament, na którym budujesz hipotezy.
Są też koszty. Zmienne zmierzono z myślą o innym pytaniu, więc Twój konstrukt bywa reprezentowany przez dwie pozycje z obszernej ankiety. Nie masz wpływu na dobór próby ani na moment pomiaru. Często znasz już wyniki opublikowane na tym zbiorze, a to – jak zobaczysz niżej – zmienia status Twoich analiz konfirmacyjnych.
Skąd wziąć dane i co z tego wynika
Cudze dane trafiają do Ciebie zwykle jedną z trzech dróg. Każda niesie inne pytania do sprawdzenia przed analizą.
| Źródło | Co sprawdzić |
|---|---|
| Repozytorium otwartych danych (ogólne, np. OSF lub Zenodo, albo dziedzinowe archiwum danych) | Licencję, numer wersji, identyfikator (np. DOI), książkę kodową, opis braków danych, wymóg cytowania zbioru |
| Materiały uzupełniające artykułu | Czy plik zawiera wszystkie zmienne z analiz, czy to dane surowe czy już przekształcone, czy dołączono kod |
| Prośba do autorów lub umowa z instytucją | Pisemne warunki użycia, zakres zgody uczestników, wymogi dotyczące ochrony danych, oczekiwania co do współautorstwa |
Na drogę „dane dostępne na prośbę” nie licz w harmonogramie. Wicherts i in. (2006) poprosili o dane z 141 artykułów w czterech czasopismach APA; po pół roku i ponad 400 e-mailach otrzymali 64 z 249 zbiorów (25.7%), choć autorzy zobowiązali się udostępniać dane do ponownej analizy. Lepiej działa obowiązkowa polityka czasopisma: w badaniu Hardwicke’a i in. (2018) po jej wprowadzeniu odsetek artykułów z danymi nadającymi się do ponownego użycia wzrósł z 22% do 62%.
Dobrze udokumentowany zbiór spełnia zasady FAIR: da się go znaleźć, uzyskać do niego dostęp, połączyć z innymi danymi i użyć ponownie (Wilkinson i in., 2016). Jeśli w zbiorze brakuje książki kodowej, zaplanuj czas na jej odtworzenie. Bez niej nie wiesz, czy „9” to wartość, czy kod braku danych. Szerzej o tym, co powinien zawierać porządnie przygotowany zbiór, piszemy w haśle otwarte dane i we wpisie o pakiecie replikacyjnym.
Licencje i warunki użycia: co wolno z danymi zrobić
Dostępność pliku nie oznacza zgody na każdy sposób jego użycia. Przeczytaj licencję albo umowę, zanim zaplanujesz publikację. Najczęściej spotkasz rozwiązania Creative Commons. Poniższe zestawienie opiera się na oficjalnych odpowiedziach Creative Commons (b.d.):
- CC0 nie jest licencją, tylko zrzeczeniem się praw. Uznanie autorstwa nie jest wtedy wymagane prawnie, ale dobra praktyka naukowa i tak wymaga zacytowania zbioru.
- CC BY 4.0 pozwala na ponowne użycie pod warunkiem uznania autorstwa. Licencje CC w wersji 4.0 obejmują też prawa do baz danych.
- Warianty NC i ND (bez użytku komercyjnego, bez utworów zależnych) Creative Commons odradza dla baz danych przeznaczonych do użytku naukowego. Jeśli trafisz na taki zbiór, sprawdź, czy planowany artykuł (np. w czasopiśmie komercyjnego wydawcy) i udostępnienie przekształconych danych mieszczą się w warunkach. W razie wątpliwości zapytaj dział prawny uczelni.
Licencja reguluje prawa autorskie, a nie ochronę danych osobowych ani etykę badań (Creative Commons, b.d.). Nawet zbiór na CC0 może zawierać dane, które pozwalają rozpoznać osoby. Nie łącz go z innymi źródłami w sposób, który zwiększa ryzyko identyfikacji. Nie próbuj też ustalać, kim są uczestnicy. Podstawy znajdziesz w hasłach anonimizacja i pseudonimizacja danych oraz świadoma zgoda i RODO w badaniach.
Czy analiza wtórna wymaga zgody komisji bioetycznej? To zależy od regulaminu Twojej uczelni, rodzaju danych (zanonimizowane czy z identyfikatorami) i od tego, na co zgodzili się uczestnicy. Nie zakładaj odpowiedzi z góry. Zapytaj komisję albo promotora i zachowaj odpowiedź w dokumentacji projektu.
Zanim policzysz: zapisz, co już wiesz o zbiorze
Największy problem analizy wtórnej nie jest techniczny. Kiedy znasz opublikowane wyniki, a może już przeglądałeś(-aś) korelacje, każda późniejsza „hipoteza” może być dopasowana do danych. To prosta droga do HARKingu i p-hackingu, nawet bez złej woli. Wicherts i in. (2016) wymieniają 34 stopnie swobody badacza: od decyzji o brakach danych i wykluczeniach po wybór modelu. W cudzym zbiorze masz ich zwykle więcej niż we własnym, bo nie Ty projektowałeś(-aś) pomiar.
Ochroną jest prerejestracja dostosowana do danych wtórnych. Szablon Van den Akkera i in. (2021) ma 25 pytań. Wymaga m.in. opisania wcześniejszej wiedzy o zbiorze (osobno dla każdego autora), podania dat pobrania i pierwszego dostępu do danych oraz listy wcześniejszych publikacji na tym zbiorze. Jako sposoby zaślepienia proponuje dodanie losowego szumu do zmiennej zależnej albo zamianę etykiet grup. Jak zarejestrować plan krok po kroku, opisujemy we wpisie plan analizy statystycznej i prerejestracja.
Nawet jeśli nie rejestrujesz planu, prowadź dziennik decyzji. Zapisuj w nim datę, decyzję, rozważane alternatywy, uzasadnienie i informację, czy decyzja zapadła przed obejrzeniem wyniku. Szablon z przykładowymi wierszami i wynikami analiz z tego wpisu możesz pobrać: dziennik decyzji reanalizy (xlsx).
Krok 1. Odtwórz to, co już opublikowano
Odtworzenie liczb z oryginału to najtańszy test, czy dobrze rozumiesz zbiór. Nie zawsze się udaje, nawet gdy dane i kod są dostępne. Hardwicke i in. (2018) próbowali odtworzyć 1324 wartości z 35 artykułów. 64 wartości nie dało się odtworzyć z dokładnością 10%. W 11 z 22 w pełni odtworzonych artykułów potrzebna była pomoc autorów, a w 13 artykułach co najmniej jednej wartości nie udało się odtworzyć nawet z tą pomocą.
Gdy nie masz surowych danych, możesz sprawdzić spójność opublikowanych statystyk. Dwa proste narzędzia:
- Zgodność p ze statystyką testu. Z podanego t i stopni swobody da się policzyć wartość p. Program statcheck sprawdził tak ponad 250 000 wartości p. W połowie artykułów był co najmniej jeden niezgodny wynik, a w co ósmym – niezgodność, która mogła zmienić wniosek statystyczny (Nuijten i in., 2016).
- Test GRIM. Średnia z odpowiedzi całkowitych (np. pozycji 1–5) może przyjmować tylko określone wartości przy danym n i liczbie pozycji. Brown i Heathers (2017) znaleźli co najmniej jedną niemożliwą średnią w około połowie z 71 artykułów, które dało się w ten sposób sprawdzić.
Przykład pokazuje, jak to wygląda w praktyce. Fikcyjny artykuł podaje wynik skali jako średnią z sześciu pozycji 1–5: grupa A (n = 41, M = 3.62, SD = 0.71), grupa B (n = 39, M = 3.27, SD = 0.80), podgrupa osób z grupy A powyżej 25 lat (n = 14, M = 3.47). W tekście: t(78) = 2.31, p = .012. Kod R jest w sekcji przykład w R, a wyniki zebrano w tabeli 1.
Tabela 1
Kontrola spójności statystyk opublikowanych w artykule przed reanalizą
| Wartość w artykule | Sprawdzenie | Wynik odtworzenia | Ocena |
|---|---|---|---|
| M = 3.62, n = 41 | GRIM (6 pozycji) | najbliższa możliwa 3.6220 | spójna |
| M = 3.27, n = 39 | GRIM (6 pozycji) | najbliższa możliwa 3.2692 | spójna |
| M = 3.47, n = 14 | GRIM (6 pozycji) | najbliższa możliwa 3.4643 | niemożliwa |
| p = .012 przy t(78) = 2.31 | p z t i df | dwustronne .024, jednostronne .012 | pasuje do testu jednostronnego |
| t(78) = 2.31 | t z M, SD i n | 2.07; przy zaokrągleniach 2.00–2.15 | niezgodna |
Uwaga. Dane fikcyjnego artykułu. Zakres t obejmuje wszystkie kombinacje średnich i odchyleń standardowych mieszczące się w zaokrągleniu do dwóch miejsc (±0.005). Test t Studenta dla prób niezależnych.
Wyniki można odczytać tak. Średnia podgrupy (3.47) nie może wyniknąć z 14 osób i sześciu pozycji: możliwe są tylko 3.46 albo 3.48. Podane p = .012 to połowa wartości dwustronnej, czyli wynik testu jednostronnego, o którym tekst nie wspomina. Statystyki t = 2.31 nie da się uzyskać z podanych średnich i odchyleń przy żadnym dopuszczalnym zaokrągleniu. Z tych danych wychodzi t(78) = 2.07, p = .042.
Żadna z tych rozbieżności nie dowodzi nieuczciwości. Średnia podgrupy mogła zostać policzona przy innym n, bo komuś brakowało odpowiedzi. Statystyka t mogła pochodzić z modelu z kowariantem, którego nie opisano. Takie sygnały traktuj jako pytania do autorów, a nie jako wnioski. Raport National Academies of Sciences, Engineering, and Medicine (2019) podkreśla, że brak zgodności może mieć wiele przyczyn, które nie muszą oznaczać błędu.
Krok 2. Sprawdź odporność wniosku: analiza wieloświatowa
Załóżmy, że liczby się zgadzają. Czy wniosek jest przez to mocny? Niekoniecznie. W projekcie Silberzahna i in. (2018) 29 zespołów odpowiadało na to samo pytanie na tym samym zbiorze. Oszacowania wahały się od 0.89 do 2.93 w jednostkach ilorazu szans. 20 zespołów (69%) uzyskało istotny efekt, a 9 (31%) nie. Zróżnicowania nie wyjaśniały ani wcześniejsze przekonania analityków, ani ich doświadczenie.
Steegen i in. (2016) zaproponowali odpowiedź na ten problem: analizę wieloświatową (multiverse analysis). Zamiast jednej ścieżki liczysz wszystkie kombinacje rozsądnych decyzji o wykluczeniach, przekształceniach i kodowaniu. Potem pokazujesz, jak bardzo wynik zależy od tych wyborów i które z nich ważą najwięcej. To systematyczna wersja analizy wrażliwości.
Przykład: media społecznościowe a dobrostan
Symulowany „otwarty” zbiór zawiera 900 dorosłych. Zmierzono dobrostan (6 pozycji 1–7), deklarowany dzienny czas w mediach społecznościowych, wiek, płeć i dochód (1–5) oraz pozycję kontrolną uwagi. Fikcyjny artykuł raportuje ujemny związek czasu z dobrostanem w regresji liniowej bez kowariantów. Przyjmujemy pięć decyzji, które rozsądny analityk mógłby podjąć inaczej:
- wynik skali: średnia z sześciu pozycji albo z czterech pozycji o najwyższej spójności;
- predyktor: godziny albo log(1 + godziny), bo rozkład czasu jest silnie prawoskośny;
- osoby, które nie zaliczyły pozycji kontrolnej (77 osób, 8.6%): zostają albo są wykluczone (zob. nieuważne odpowiedzi);
- wartości odstające: zostają albo usuwamy deklaracje powyżej 12 godzin na dobę (14 osób);
- kowarianty: brak, wiek i płeć, albo wiek, płeć i dochód.
To daje 2 × 2 × 2 × 2 × 3 = 48 analiz. W każdej predyktor i wynik są standaryzowane, więc β można porównywać między wariantami. Rysunek 2 przedstawia je jako krzywą specyfikacji. U góry są oszacowania od najmniejszego do największego z 95% CI, a pod spodem decyzje, które dały każde z nich.
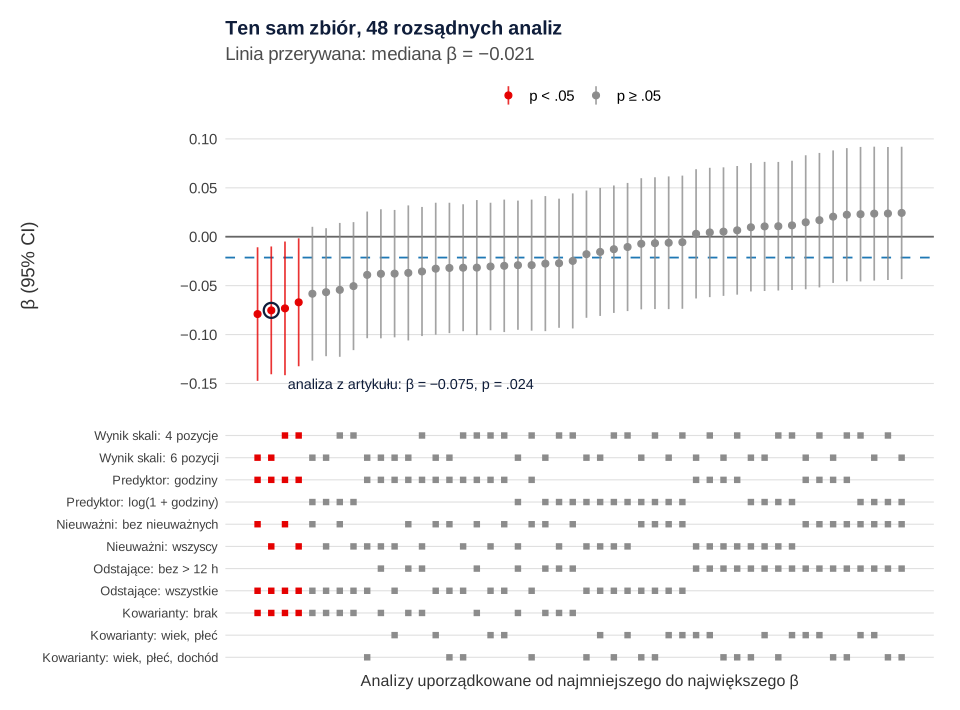
Analiza z artykułu daje β = −0.075, 95% CI [−0.141, −0.010], p = .024. To jednak jeden z zaledwie czterech istotnych wariantów na 48. Mediana β wynosi −0.021, a zakres – od −0.079 do 0.024. Wszystkie istotne wyniki łączą trzy decyzje: brak kowariantów, surowe godziny i pozostawienie wartości odstających. Tabela 2 pokazuje, która decyzja przesuwa wynik najbardziej.
Tabela 2
Średnie standaryzowane oszacowanie związku czasu w mediach społecznościowych z dobrostanem w zależności od decyzji analitycznej
| Decyzja | Opcja 1 | Średnie β | Opcja 2 (i 3) | Średnie β |
|---|---|---|---|---|
| Kowarianty | brak | −0.048 | wiek, płeć / + dochód | −0.004 / −0.003 |
| Wartości odstające | wszystkie | −0.036 | bez > 12 h | −0.001 |
| Predyktor | godziny | −0.025 | log(1 + godziny) | −0.011 |
| Pozycja kontrolna uwagi | wszyscy | −0.021 | bez nieuważnych | −0.015 |
| Wynik skali | 6 pozycji | −0.020 | 4 pozycje | −0.017 |
Uwaga. 48 specyfikacji (2 × 2 × 2 × 2 × 3); średnie z wariantów zawierających daną opcję. N = 810–900 zależnie od wykluczeń. Analiza najpełniej kontrolowana (log godzin, bez nieuważnych i bez odpowiedzi powyżej 12 h, wszystkie kowarianty): β = 0.024, 95% CI [−0.043, 0.092], p = .480, n = 810. Dane symulowane.
Najwięcej zmienia uwzględnienie wieku. Młodsze osoby spędzają w tym zbiorze więcej czasu w mediach społecznościowych, a wiek wiąże się z dobrostanem. Bez kontroli wieku jego efekt trafia do współczynnika czasu – to klasyczna zmienna zakłócająca. Drugie miejsce zajmuje kilkanaście nieprawdopodobnych odpowiedzi (np. 20 godzin dziennie), które przy surowej skali godzin mają dużą dźwignię.
Wniosek reanalizy nie brzmi „efektu nie ma”. Brzmi tak: ujemny związek z artykułu zależy od trzech konkretnych decyzji, a w większości rozsądnych wariantów oszacowanie jest bliskie zera i nieistotne. To informacja o kruchości wyniku, a nie dowód na brak efektu w populacji. Do takiego wniosku potrzebny byłby np. test równoważności z uzasadnioną najmniejszą interesującą wielkością efektu.
Dwie uwagi praktyczne. Po pierwsze, lista decyzji musi być ustalona z góry i uzasadniona merytorycznie. Jeśli dobierasz warianty po obejrzeniu wyników, analiza wieloświatowa staje się kolejną formą elastyczności. Po drugie, 48 wariantów to nie 48 niezależnych testów. Nie licz odsetka istotnych wyników jak wyniku metaanalizy i nie poprawiaj go na wielokrotne porównania. To opis przestrzeni wyników, a nie nowy test hipotezy.
Jak ostrożnie formułować wnioski
Reanaliza zmienia literaturę tylko wtedy, gdy jej wnioski są proporcjonalne do dowodów. Przykład Herndona i in. (2014) pokazuje, jak wiele może wnieść: po odtworzeniu arkusza kalkulacyjnego z głośnej analizy zadłużenia publicznego wykazali, że selektywne pominięcie danych, błędy kodowania i niewłaściwe ważenie zmieniły wynik. Średni realny wzrost PKB w krajach z długiem powyżej 90% PKB wyniósł 2.2% rocznie, a nie −0.1%. Taki wniosek był jednak możliwy, bo autorzy dotarli do arkusza oryginalnych analiz i wskazali konkretne źródła rozbieżności.
| Sytuacja | Zbyt mocno | Proporcjonalnie |
|---|---|---|
| Nie udało się odtworzyć jednej wartości | „Wyniki artykułu są błędne” | „Wartości t w tabeli 2 nie udało się odtworzyć z udostępnionych danych; autorzy zostali poproszeni o wyjaśnienie” |
| Efekt znika po dodaniu kowariantów | „Efekt nie istnieje” | „Związek okazał się wrażliwy na kontrolę wieku; dane nie pozwalają rozstrzygnąć, czy efekt jest bliski zera” |
| Analiza wtórna danych przekrojowych | „Czas w mediach obniża dobrostan” | „Dłuższy czas wiązał się z niższym dobrostanem; schemat nie pozwala na wnioski przyczynowe” |
| Nowe pytanie zadane po obejrzeniu danych | „Hipoteza została potwierdzona” | „Analiza eksploracyjna wskazała na związek wymagający sprawdzenia na niezależnych danych” |
Pamiętaj też o kontekście kryzysu replikacyjnego (zob. kryzys replikacyjny w psychologii). Reanalizy są potrzebne, ale ich autorzy też podejmują arbitralne decyzje. Twoja reanaliza powinna więc spełniać standardy, których oczekujesz od oryginału: udostępniony kod, opisane decyzje i jawne odstępstwa od planu.
Kontakt z autorami oryginału
Zanim opiszesz rozbieżność publicznie, napisz do autorów. Zwykle szybko wyjaśniają one niejasności w kodowaniu, a czasem ujawniają, że udostępniona wersja zbioru różni się od analizowanej. Pisz rzeczowo: wskaż konkretną wartość, pokaż, jak ją liczyłeś(-aś), i zapytaj o możliwe źródło różnicy.
Ustal też zasady autorstwa. Jeśli autorzy zbioru znacząco pomagają w interpretacji, porozmawiajcie o współautorstwie albo podziękowaniach. Sam fakt udostępnienia danych zwykle oznacza obowiązek cytowania zbioru, a nie współautorstwo. Szczegóły zależą jednak od warunków udostępnienia i zasad czasopisma.
Jak opisać reanalizę i analizę wtórną w pracy
Recenzenci pytają o to samo, o co pytałby recenzent oryginału, oraz o kilka rzeczy dodatkowych. W sekcji metod podaj:
- źródło danych z pełnym cytowaniem zbioru (autorzy, rok, tytuł, wersja, DOI lub adres), licencję i datę pobrania;
- pierwotny cel zbierania danych, schemat, sposób doboru próby i ewentualne wagi;
- co wiedziałeś(-aś) o zbiorze przed analizą i czy plan był zarejestrowany;
- wszystkie przekształcenia zmiennych w porównaniu z oryginałem i powody wykluczeń;
- wynik odtworzenia opublikowanych liczb, także wtedy, gdy wszystko się zgadza;
- listę wariantów analizy wrażliwości lub analizy wieloświatowej z wynikami w materiałach uzupełniających.
Jeśli reanaliza ma się stać artykułem, przygotuj się na pytania recenzentów o arbitralność wariantów i o to, czy krytykujesz oryginał uczciwie. Typowe zarzuty i sposoby odpowiedzi omawiamy we wpisie zarzuty recenzentów do statystyki. Jeżeli w doktoracie łączysz dane wtórne z własnym badaniem podłużnym, zajrzyj też do wpisu badanie podłużne w doktoracie. Ogólny plan analiz w rozprawie opisujemy we wpisie analiza statystyczna w doktoracie.
Gdy potrzebujesz kogoś, kto niezależnie odtworzy obliczenia albo sprawdzi, czy Twoja lista wariantów jest kompletna i uczciwa, możemy wykonać taką weryfikację analiz dla badaczy. Interpretacja i odpowiedzialność za wnioski pozostają po stronie autora lub autorki.
Przykład w R: kontrola spójności i analiza wieloświatowa
Kod odtwarza wszystkie liczby z tabel i rysunków. Przepis 1 jest niezależny. Przepis 2 zapisuje symulowany zbiór do pliku reanaliza-otwarty-zbior-dane.csv, a przepis 3 korzysta z obiektów z przepisów 1 i 2, więc uruchamiaj je w jednej sesji. Analiza wieloświatowa nie wymaga specjalnego pakietu: siatkę decyzji tworzy expand.grid(), a każdą specyfikację liczy lm().
1. Test GRIM, zgodność p z t i odtworzenie t ze średnich
R
# B81 – sprawdzenie spójności opublikowanych wyników przed reanalizą (przykład fikcyjnego artykułu)
# Artykuł podaje: wynik skali to średnia z 6 pozycji 1–5; grupa A: n = 41, M = 3.62, SD = 0.71;
# grupa B: n = 39, M = 3.27, SD = 0.80; podgrupa A powyżej 25 lat: n = 14, M = 3.47;
# w tekście: t(78) = 2.31, p = .012.

# 1. Test GRIM (Brown i Heathers): czy średnia z liczb całkowitych jest możliwa przy danym n i liczbie pozycji?
grim <- function(m, n, k = 1, miejsca = 2) {
  suma <- round(m * n * k)
  mozliwe <- round((suma + (-1:1)) / (n * k), miejsca)
  any(abs(mozliwe - m) < 1e-9)
}
spr <- data.frame(srednia = c("grupa A", "grupa B", "podgrupa A > 25 lat"), n = c(41, 39, 14), M = c(3.62, 3.27, 3.47))
spr$najblizsza_mozliwa <- round(round(spr$M * spr$n * 6) / (spr$n * 6), 4)
spr$GRIM_zgodna <- mapply(grim, spr$M, spr$n, MoreArgs = list(k = 6))
spr

# 2. Czy p zgadza się z podaną statystyką t i df? (logika programu statcheck)
p_z_t <- 2 * pt(-abs(2.31), df = 78)
round(c(p_dwustronne = p_z_t, p_jednostronne = p_z_t / 2), 4)

# 3. Czy t da się odtworzyć ze średnich i SD? Uwzględnij zaokrąglenia do dwóch miejsc
t_student <- function(m1, s1, n1, m2, s2, n2) {
  sp <- sqrt(((n1 - 1) * s1^2 + (n2 - 1) * s2^2) / (n1 + n2 - 2))
  (m1 - m2) / (sp * sqrt(1 / n1 + 1 / n2))
}
round(t_student(3.62, 0.71, 41, 3.27, 0.80, 39), 3)
# najbardziej sprzyjające i najmniej sprzyjające zaokrąglenia (±0.005)
siatka <- expand.grid(m1 = 3.62 + c(-.005, .005), s1 = 0.71 + c(-.005, .005), m2 = 3.27 + c(-.005, .005), s2 = 0.80 + c(-.005, .005))
round(range(with(siatka, t_student(m1, s1, 41, m2, s2, 39))), 3)
round(2 * pt(-abs(t_student(3.62, 0.71, 41, 3.27, 0.80, 39)), df = 78), 4)
Wynik w R
              srednia  n    M najblizsza_mozliwa GRIM_zgodna
1             grupa A 41 3.62             3.6220        TRUE
2             grupa B 39 3.27             3.2692        TRUE
3 podgrupa A > 25 lat 14 3.47             3.4643       FALSE
  p_dwustronne p_jednostronne
        0.0235         0.0118
[1] 2.072
[1] 2.000 2.145
[1] 0.0416
2. Analiza wieloświatowa: 48 specyfikacji regresji
R
# B81 – analiza wieloświatowa (multiverse) na „otwartym” zbiorze danych (dane symulowane, set.seed(8101))
# Pytanie wtórne: czy czas spędzany dziennie w mediach społecznościowych wiąże się z niższym dobrostanem?
# 900 dorosłych; dobrostan: 6 pozycji 1–7; godziny dziennie (samoopis); wiek, płeć, dochód (1–5);
# pozycja kontrolna uwagi (uwaga = 0: odpowiedź niezgodna z instrukcją).
set.seed(8101)
n <- 900
wiek <- round(runif(n, 18, 70))
plec <- factor(sample(c("kobieta", "mezczyzna"), n, replace = TRUE, prob = c(.54, .46)))
dochod <- pmin(5, pmax(1, round(2.6 + 0.012 * (wiek - 40) + rnorm(n, 0, 1.1))))
godz <- round(rgamma(n, shape = 2, rate = 2 / (3.2 - 0.035 * (wiek - 40))), 1)
godz[sample(n, 9)] <- c(14, 15, 16, 16, 18, 18, 20, 22, 24)      # kilka nieprawdopodobnych odpowiedzi
uwaga <- rbinom(n, 1, .92)
lat <- 0.012 * (wiek - 40) + 0.15 * (dochod - 3) - 0.06 * log1p(godz) + rnorm(n, 0, 1)
pozycje <- sapply(1:6, function(j) pmin(7, pmax(1, round(4.4 + c(.9, .9, .85, .85, .5, .45)[j] * lat + rnorm(n, 0, .8)))))
pozycje[uwaga == 0, ] <- sample(1:7, sum(uwaga == 0) * 6, replace = TRUE)   # odpowiedzi losowe
colnames(pozycje) <- paste0("dob", 1:6)
dane <- data.frame(id = 1:n, wiek, plec, dochod, godz, uwaga, pozycje)
write.csv(dane, "../reanaliza-otwarty-zbior-dane.csv", row.names = FALSE)
summary(dane[, c("wiek", "dochod", "godz")])
table(uwaga = dane$uwaga)
c(powyzej_12_h = sum(dane$godz > 12), powyzej_12_h_wsrod_uwaznych = sum(dane$godz > 12 & dane$uwaga == 1))

# Decyzje analityczne, które rozsądny analityk mógłby podjąć inaczej
decyzje <- expand.grid(wynik = c("6 pozycji", "4 pozycje"), predyktor = c("godziny", "log(1 + godziny)"),
                       uwaga = c("wszyscy", "bez nieuważnych"), odstajace = c("wszystkie", "bez > 12 h"),
                       kowarianty = c("brak", "wiek, płeć", "wiek, płeć, dochód"), stringsAsFactors = FALSE)
nrow(decyzje)
jedna <- function(w) {
  d <- dane
  if (w$uwaga == "bez nieuważnych") d <- d[d$uwaga == 1, ]
  if (w$odstajace == "bez > 12 h") d <- d[d$godz <= 12, ]
  d$y <- if (w$wynik == "6 pozycji") rowMeans(d[, paste0("dob", 1:6)]) else rowMeans(d[, paste0("dob", 1:4)])
  d$x <- if (w$predyktor == "godziny") d$godz else log1p(d$godz)
  d$y <- as.numeric(scale(d$y)); d$x <- as.numeric(scale(d$x))
  f <- switch(w$kowarianty, "brak" = y ~ x, "wiek, płeć" = y ~ x + wiek + plec, y ~ x + wiek + plec + dochod)
  s <- summary(lm(f, data = d)); m <- s$coefficients["x", ]
  c(beta = m[[1]], se = m[[2]], p = m[[4]], n = nrow(d), df = s$df[2])
}
wyniki <- cbind(decyzje, t(sapply(seq_len(nrow(decyzje)), function(i) jedna(decyzje[i, ]))))
wyniki$dolna <- wyniki$beta - qt(.975, wyniki$df) * wyniki$se
wyniki$gorna <- wyniki$beta + qt(.975, wyniki$df) * wyniki$se

# Podsumowanie wieloświata
round(c(mediana_beta = median(wyniki$beta), min = min(wyniki$beta), max = max(wyniki$beta)), 3)
c(istotne_ujemne = sum(wyniki$p < .05 & wyniki$beta < 0), nieistotne = sum(wyniki$p >= .05),
  istotne_dodatnie = sum(wyniki$p < .05 & wyniki$beta > 0))
# Która decyzja najbardziej zmienia wynik? Średnie beta dla każdej opcji
for (d in names(decyzje)) print(round(tapply(wyniki$beta, wyniki[[d]], mean), 3))
# Specyfikacja „pierwotnego artykułu”: 6 pozycji, godziny, wszyscy, wszystkie, bez kowariantów
pierwotna <- with(wyniki, wynik == "6 pozycji" & predyktor == "godziny" & uwaga == "wszyscy" &
                    odstajace == "wszystkie" & kowarianty == "brak")
round(wyniki[pierwotna, c("beta", "dolna", "gorna", "p", "n")], 3)
# Specyfikacja z najpełniejszą kontrolą: log, bez nieuważnych, bez > 12 h, wszystkie kowarianty, 6 pozycji
pelna <- with(wyniki, wynik == "6 pozycji" & predyktor == "log(1 + godziny)" & uwaga == "bez nieuważnych" &
                odstajace == "bez > 12 h" & kowarianty == "wiek, płeć, dochód")
round(wyniki[pelna, c("beta", "dolna", "gorna", "p", "n")], 3)
Wynik w R
      wiek           dochod           godz
 Min.   :18.00   Min.   :1.000   Min.   : 0.100
 1st Qu.:30.00   1st Qu.:2.000   1st Qu.: 1.500
 Median :45.00   Median :3.000   Median : 2.600
 Mean   :43.97   Mean   :2.712   Mean   : 3.362
 3rd Qu.:57.00   3rd Qu.:3.000   3rd Qu.: 4.300
 Max.   :70.00   Max.   :5.000   Max.   :24.000
uwaga
  0   1
 77 823
               powyzej_12_h powyzej_12_h_wsrod_uwaznych
                         14                          13
[1] 48
mediana_beta          min          max
      -0.021       -0.079        0.024
  istotne_ujemne       nieistotne istotne_dodatnie
               4               44                0
4 pozycje 6 pozycji
   -0.017    -0.020
         godziny log(1 + godziny)
          -0.025           -0.011
bez nieuważnych         wszyscy
         -0.015          -0.021
bez > 12 h  wszystkie
    -0.001     -0.036
              brak         wiek, płeć wiek, płeć, dochód
            -0.048             -0.004             -0.003
    beta  dolna gorna     p   n
1 -0.075 -0.141 -0.01 0.024 900
    beta  dolna gorna    p   n
47 0.024 -0.043 0.092 0.48 810
3. Plik do pobrania: dziennik decyzji z wynikami
R
# B81 – plik do pobrania: dziennik decyzji reanalizy (xlsx) z wynikami 48 specyfikacji
suppressPackageStartupMessages(library(openxlsx))
wb <- createWorkbook(creator = "Metodolog.pl", title = "Dziennik decyzji reanalizy")
addWorksheet(wb, "dziennik_decyzji")
writeData(wb, "dziennik_decyzji", data.frame(
  Data = "", Etap = c("dostęp do danych", "kontrola zgodności", "przygotowanie zmiennych", "wykluczenia", "model", "wrażliwość"),
  Decyzja = c("pobranie wersji zbioru (numer wersji, DOI lub adres)", "GRIM, p z t i df, odtworzenie tabeli 1",
              "sposób liczenia wyniku skali", "kryteria wykluczeń i obserwacje odstające", "kowarianty i postać predyktora",
              "warianty sprawdzone w analizie wieloświatowej"),
  Alternatywy = "", Uzasadnienie = "", Czy_przed_wglądem_w_wynik = "", Autor_decyzji = ""))
setColWidths(wb, "dziennik_decyzji", 1:7, c(12, 24, 52, 30, 40, 24, 16))
addWorksheet(wb, "kontrola_zgodnosci")
writeData(wb, "kontrola_zgodnosci", cbind(spr, uwagi = ""))
addWorksheet(wb, "specyfikacje")
w <- wyniki; w[, c("beta", "se", "dolna", "gorna")] <- round(w[, c("beta", "se", "dolna", "gorna")], 3); w$p <- round(w$p, 4)
writeData(wb, "specyfikacje", w[order(w$beta), ])
saveWorkbook(wb, "../reanaliza-dziennik-decyzji.xlsx", overwrite = TRUE)
library(readxl)
excel_sheets("../reanaliza-dziennik-decyzji.xlsx")
dim(read_excel("../reanaliza-dziennik-decyzji.xlsx", sheet = "specyfikacje"))
tmp <- tempfile(); unzip("../reanaliza-dziennik-decyzji.xlsx", "docProps/core.xml", exdir = tmp)
regmatches(x <- readLines(file.path(tmp, "docProps/core.xml"), warn = FALSE), gregexpr("<dc:creator>[^<]*</dc:creator>|<cp:lastModifiedBy>[^<]*</cp:lastModifiedBy>", x))[[1]]
dim(read.csv("../reanaliza-otwarty-zbior-dane.csv"))
Wynik w R
[1] "dziennik_decyzji"   "kontrola_zgodnosci" "specyfikacje"
[1] 48 12
[1] "<dc:creator>Metodolog.pl</dc:creator>"
[2] "<cp:lastModifiedBy>Metodolog.pl</cp:lastModifiedBy>"
[1] 900  12
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Plik xlsx zapisano w pakiecie openxlsx i sprawdzono w pakiecie readxl; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy pracy na cudzych danych
- Analiza bez książki kodowej. Kody braków (np. 9 albo 99) trafiają do średnich, a odwrócone pozycje nie zostają przekodowane. Zawsze odtwórz najpierw statystyki opisowe z oryginału.
- Licencja sprawdzona po fakcie. Zbiór na licencji NC albo z umową ograniczającą publikację utworów zależnych może zablokować udostępnienie Twojego pakietu replikacyjnego.
- Konfirmacja po obejrzeniu danych. Hipoteza sformułowana po przejrzeniu korelacji w tym samym zbiorze jest eksploracyjna, nawet jeśli brzmi teoretycznie.
- Jedna „poprawna” reanaliza. Zastąpienie decyzji autorów własnymi decyzjami bez pokazania wariantów to tylko inny ogród ścieżek. Pokaż całą przestrzeń rozsądnych analiz.
- Rozbieżność jako oskarżenie. Niespójna średnia albo inne p to powód do pytania, a nie do zarzutu. Najpierw napisz do autorów.
- Pominięcie schematu badania. Analiza wtórna danych przekrojowych nie staje się przyczynowa dzięki dużej próbie. Podobnie pominięcie wag sondażowych zmienia populację, do której się odnosisz.
- Brak cytowania zbioru. Cytuj zarówno artykuł, jak i sam zbiór danych z wersją. Bez tego czytelnik nie odtworzy Twoich analiz.
- Łączenie danych zwiększające ryzyko identyfikacji. Dołączanie danych z innych źródeł (np. kodów pocztowych) do zanonimizowanego zbioru może naruszyć warunki udostępnienia i zasady ochrony danych.
Najczęstsze pytania
Czym różni się reanaliza od analizy wtórnej danych?
Reanaliza odpowiada na to samo pytanie, co oryginał, i sprawdza, czy wyniki da się odtworzyć albo czy przetrwają inne rozsądne decyzje analityczne. Analiza wtórna stawia cudzym danym nowe pytanie, na które autorzy zbioru nie odpowiadali. Replikacja wymaga z kolei zebrania nowych danych.
Czy mogę opublikować artykuł na danych z licencją CC BY?
Zwykle tak: CC BY pozwala na ponowne użycie pod warunkiem uznania autorstwa, więc zacytuj zbiór z wersją i identyfikatorem. Warianty NC i ND mogą ograniczać publikację u komercyjnego wydawcy lub udostępnienie przekształconych danych. Licencja nie zwalnia też z zasad ochrony danych osobowych ani z wymogów komisji etycznej.
Jak prerejestrować analizę danych, które już widziałem?
Opisz w planie, co już wiesz o zbiorze (osobno dla każdego autora), podaj daty pobrania i pierwszego dostępu do danych oraz wcześniejsze publikacje na tym zbiorze. Szablon Van den Akkera i in. (2021) proponuje też zaślepienie, np. dodanie szumu do zmiennej zależnej. Analizy spoza planu oznacz jako eksploracyjne.
Co to jest test GRIM i kiedy go stosować?
Test GRIM sprawdza, czy średnia z odpowiedzi całkowitych (np. pozycji 1–5) jest w ogóle możliwa przy podanym n i liczbie pozycji. Przydaje się przed reanalizą, gdy nie masz surowych danych. Niespójna średnia to sygnał do pytania autorów, a nie dowód nieuczciwości.
Ile wariantów powinna mieć analiza wieloświatowa (multiverse)?
Tyle, ile wynika z rozsądnych, uzasadnionych merytorycznie alternatyw dla każdej decyzji: wykluczeń, przekształceń, sposobu liczenia wyniku i kowariantów. Listę ustal przed obejrzeniem wyników. W przykładzie z tego wpisu pięć decyzji daje 48 specyfikacji.
Powiązane hasła
Przeczytaj też
Pakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikDoktorat z cyklu artykułów a spójna analiza
Jeden zbiór danych w kilku artykułach: wspólny potok, mapa cyklu, kontrola liczb, hipotezy rozprawy i minimetaanaliza w omówieniu – z kodem R.
Czytaj →Reanalizujesz cudze dane do doktoratu lub artykułu?
Niezależnie odtworzymy opublikowane wyniki, zaplanujemy i policzymy analizę wieloświatową oraz wyjaśnimy, jak ostrożnie opisać wnioski, żebyś umiał(a) je obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Brown, N. J. L., & Heathers, J. A. J. (2017). The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology. Social Psychological and Personality Science, 8(4), 363–369. https://doi.org/10.1177/1948550616673876 ● Otwarty dostęp: pełny tekst
- Creative Commons. (b.d.). Frequently asked questions. Pobrano 26 października 2026 z https://creativecommons.org/faq/ ● Otwarty dostęp
- Hardwicke, T. E., Mathur, M. B., MacDonald, K., Nilsonne, G., Banks, G. C., Kidwell, M. C., Hofelich Mohr, A., Clayton, E., Yoon, E. J., Henry Tessler, M., Lenne, R. L., Altman, S., Long, B., & Frank, M. C. (2018). Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition. Royal Society Open Science, 5(8), Article 180448. https://doi.org/10.1098/rsos.180448 ● Otwarty dostęp
- Herndon, T., Ash, M., & Pollin, R. (2014). Does high public debt consistently stifle economic growth? A critique of Reinhart and Rogoff. Cambridge Journal of Economics, 38(2), 257–279. https://doi.org/10.1093/cje/bet075
- National Academies of Sciences, Engineering, and Medicine. (2019). Reproducibility and replicability in science. The National Academies Press. https://doi.org/10.17226/25303 ● Otwarty dostęp: pełny tekst
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
- Silberzahn, R., Uhlmann, E. L., Martin, D. P., Anselmi, P., Aust, F., Awtrey, E., Bahník, Š., Bai, F., Bannard, C., Bonnier, E., Carlsson, R., Cheung, F., Christensen, G., Clay, R., Craig, M. A., Dalla Rosa, A., Dam, L., Evans, M. H., Flores Cervantes, I., . . . Nosek, B. A. (2018). Many analysts, one data set: Making transparent how variations in analytic choices affect results. Advances in Methods and Practices in Psychological Science, 1(3), 337–356. https://doi.org/10.1177/2515245917747646 ● Otwarty dostęp
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Van den Akker, O. R., Weston, S., Campbell, L., Chopik, B., Damian, R., Davis-Kean, P., Hall, A., Kosie, J., Kruse, E., Olsen, J., Ritchie, S., Valentine, K. D., Van 't Veer, A., & Bakker, M. (2021). Preregistration of secondary data analysis: A template and tutorial. Meta-Psychology, 5. https://doi.org/10.15626/mp.2020.2625 ● Otwarty dostęp
- Weston, S. J., Ritchie, S. J., Rohrer, J. M., & Przybylski, A. K. (2019). Recommendations for increasing the transparency of analysis of preexisting data sets. Advances in Methods and Practices in Psychological Science, 2(3), 214–227. https://doi.org/10.1177/2515245919848684 ● Otwarty dostęp
- Wicherts, J. M., Borsboom, D., Kats, J., & Molenaar, D. (2006). The poor availability of psychological research data for reanalysis. American Psychologist, 61(7), 726–728. https://doi.org/10.1037/0003-066x.61.7.726
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., . . . Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), Article 160018. https://doi.org/10.1038/sdata.2016.18 ● Otwarty dostęp
Cytowania BibTeX
@article{brown2017grim, author={Brown, Nicholas J. L. and Heathers, James A. J.}, title={{The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={363--369}, doi={10.1177/1948550616673876}}@misc{creativecommonsndfaq, author={{Creative Commons}}, title={{Frequently asked questions}}, url={https://creativecommons.org/faq/}}@article{hardwicke2018data, author={Hardwicke, Tom E. and Mathur, Maya B. and MacDonald, Kyle and Nilsonne, Gustav and Banks, George C. and Kidwell, Mallory C. and Hofelich Mohr, Alicia and Clayton, Elizabeth and Yoon, Erica J. and Henry Tessler, Michael and Lenne, Richie L. and Altman, Sara and Long, Bria and Frank, Michael C.}, title={{Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition}}, journal={Royal Society Open Science}, year={2018}, volume={5}, number={8}, eid={180448}, doi={10.1098/rsos.180448}}@article{herndon2014does, author={Herndon, Thomas and Ash, Michael and Pollin, Robert}, title={{Does high public debt consistently stifle economic growth? A critique of Reinhart and Rogoff}}, journal={Cambridge Journal of Economics}, year={2014}, volume={38}, number={2}, pages={257--279}, doi={10.1093/cje/bet075}}@book{nasem2019reproducibility, author={{National Academies of Sciences, Engineering, and Medicine}}, title={{Reproducibility and replicability in science}}, year={2019}, publisher={The National Academies Press}, url={https://doi.org/10.17226/25303}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}@article{silberzahn2018many, author={Silberzahn, R. and Uhlmann, E. L. and Martin, D. P. and Anselmi, P. and Aust, F. and Awtrey, E. and Bahník, Š. and Bai, F. and Bannard, C. and Bonnier, E. and others and Nosek, B. A.}, title={{Many analysts, one data set: Making transparent how variations in analytic choices affect results}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={337--356}, doi={10.1177/2515245917747646}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{vandenakker2021preregistration, author={Van den Akker, Olmo R. and Weston, Sara and Campbell, Lorne and Chopik, Bill and Damian, Rodica and Davis-Kean, Pamela and Hall, Andrew and Kosie, Jessica and Kruse, Elliott and Olsen, Jerome and Ritchie, Stuart and Valentine, KD and Van 't Veer, Anna and Bakker, Marjan}, title={{Preregistration of secondary data analysis: A template and tutorial}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2020.2625}}@article{weston2019recommendations, author={Weston, Sara J. and Ritchie, Stuart J. and Rohrer, Julia M. and Przybylski, Andrew K.}, title={{Recommendations for increasing the transparency of analysis of preexisting data sets}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={3}, pages={214--227}, doi={10.1177/2515245919848684}}@article{wicherts2006poor, author={Wicherts, Jelte M. and Borsboom, Denny and Kats, Judith and Molenaar, Dylan}, title={{The poor availability of psychological research data for reanalysis}}, journal={American Psychologist}, year={2006}, volume={61}, number={7}, pages={726--728}, doi={10.1037/0003-066x.61.7.726}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}@article{wilkinson2016fair, author={Wilkinson, Mark D. and Dumontier, Michel and Aalbersberg, IJsbrand Jan and Appleton, Gabrielle and Axton, Myles and Baak, Arie and Blomberg, Niklas and Boiten, Jan-Willem and da Silva Santos, Luiz Bonino and Bourne, Philip E. and Bouwman, Jildau and Brookes, Anthony J. and Clark, Tim and Crosas, Mercè and Dillo, Ingrid and Dumon, Olivier and Edmunds, Scott and Evelo, Chris T. and Finkers, Richard and Gonzalez-Beltran, Alejandra and Gray, Alasdair J.G. and Groth, Paul and Goble, Carole and Grethe, Jeffrey S. and Heringa, Jaap and ’t Hoen, Peter A.C and Hooft, Rob and Kuhn, Tobias and Kok, Ruben and Kok, Joost and Lusher, Scott J. and Martone, Maryann E. and Mons, Albert and Packer, Abel L. and Persson, Bengt and Rocca-Serra, Philippe and Roos, Marco and van Schaik, Rene and Sansone, Susanna-Assunta and Schultes, Erik and Sengstag, Thierry and Slater, Ted and Strawn, George and Swertz, Morris A. and Thompson, Mark and van der Lei, Johan and van Mulligen, Erik and Velterop, Jan and Waagmeester, Andra and Wittenburg, Peter and Wolstencroft, Katherine and Zhao, Jun and Mons, Barend}, title={{The FAIR Guiding Principles for scientific data management and stewardship}}, journal={Scientific Data}, year={2016}, volume={3}, number={1}, eid={160018}, doi={10.1038/sdata.2016.18}}