Jeden projekt, trzy artykuły i trzy różne N
Typowa sytuacja w doktoracie z cyklu publikacji: jedno duże badanie ankietowe, z którego powstają trzy artykuły. Pierwszy opisuje właściwości skali, drugi testuje główną hipotezę, trzeci – moderator. Artykuły powstają w odstępie kilkunastu miesięcy, recenzują je różni recenzenci, a czasem analizy robią różne osoby z zespołu. Na etapie omówienia cyklu okazuje się, że w artykule pierwszym N = 396, w trzecim N = 411, a rzetelność tej samej skali różni się w trzecim miejscu po przecinku. Nikt niczego nie ukrywał – po prostu każdy artykuł przygotowywał dane trochę inaczej.
Recenzent rozprawy zauważy to w pięć minut, bo czyta wszystkie artykuły razem. Gorzej, jeśli zauważy to redakcja czasopisma, która zestawi nowy tekst z wcześniejszymi publikacjami z tego samego zbioru. Ten poradnik dotyczy właśnie tej warstwy doktoratu: jak zaplanować i prowadzić analizy, żeby kilka artykułów z jednego projektu było spójnych liczbowo i metodologicznie. Formalne podstawy rozprawy z cyklu artykułów, harmonogram, moc dla kolejnych badań i to, kiedy podział danych staje się salami slicing, omawiamy w poradniku analiza statystyczna w doktoracie. Tutaj skupiamy się na analizie danych.
Problem nie jest egzotyczny. W ankiecie, którą Merga i in. (2020) przeprowadzili wśród 246 osób, które niedawno obroniły doktorat na podstawie publikacji, trudność z zapewnieniem spójności rozprawy należała do najczęściej wymienianych. Nethsinghe i Southcott (2015) opisują taki doktorat jako „żonglowanie” między spójnością całości a wydzielaniem publikowalnych części. Spójność analiz to ta część żonglowania, którą da się w dużej mierze zaplanować.
Jedna wersja danych i jeden skrypt przygotowania
Najważniejsza zasada brzmi: wszystkie artykuły z cyklu korzystają z jednego, zamrożonego zbioru analitycznego, który powstaje z danych surowych jednym skryptem. Nie „plik, który ostatnio otwierałem”, nie kopia z poprawkami ręcznymi, nie osobny arkusz dla każdego artykułu. Sandve i in. (2013) w dziesięciu regułach odtwarzalności podkreślają, by zapisywać, jak powstał każdy wynik, unikać ręcznej obróbki danych, archiwizować wersje programów, trzymać skrypty pod kontrolą wersji i zapisywać ziarna losowania. Minimalnym wymaganiem jest to, żeby badacz sam umiał odtworzyć swoje wyniki – a w doktoracie trwającym cztery lata „ja sprzed dwóch lat” jest dla Ciebie prawie obcą osobą.
W praktyce wygląda to tak:
- Dane surowe tylko do odczytu. Plik eksportowany z platformy ankietowej zapisujesz raz, z datą, i nigdy go nie edytujesz. Jak przygotować bazę i nazwy zmiennych, pokazujemy w poradniku jak przygotować bazę danych do analizy.
- Jeden skrypt przygotowania (np.
01_przygotowanie.R) robi wszystko: rekodowanie, pozycje odwrócone, wykluczenia, wyniki skal, braki danych. Na końcu zapisuje zbiór analityczny z numerem wersji, np.analiza_v1.0.rds. - Zamrożenie wersji. Gdy zbiór analityczny jest gotowy, nadajesz mu wersję i zapisujesz liczbę wierszy oraz sumę kontrolną pliku. Każdy artykuł podaje w metodach, z której wersji korzysta.
- Osobne skrypty analiz dla artykułów (
A1_skala.R,A2_wsparcie.R,A3_moderacja.R) wczytują ten sam plik i niczego w nim nie zmieniają. Zmienna potrzebna tylko w jednym artykule powstaje w skrypcie wspólnym albo jest jawnie opisana w skrypcie artykułu. - Książka kodowa dla całego projektu, a nie dla artykułu: nazwy, etykiety, zakresy, kody braków, sposób liczenia wyników (zob. książka kodowa). Buchanan i in. (2021) pokazują, jak przejść od surowych odpowiedzi z ankiety do udostępnialnego zbioru z metadanymi zgodnymi z zasadami FAIR.
Ten układ przyda się też później: z takich plików powstaje pakiet replikacyjny z danymi i kodem, który możesz udostępnić przy każdym artykule, a w omówieniu cyklu – jeden pakiet dla całej rozprawy.
Które decyzje są wspólne dla całego cyklu
Simmons i in. (2011) pokazali w symulacjach i eksperymentach, że nieujawniona elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Wicherts i in. (2016) wymienili 34 takie „stopnie swobody badacza” – m.in. decyzje o brakach danych, obserwacjach odstających, kryteriach wykluczeń i wyborze modelu. W cyklu artykułów każdy z tych stopni swobody można wykorzystać kilka razy: raz na artykuł. Dlatego część decyzji musi zapaść raz, dla całego zbioru.
| Decyzja | Wspólna dla cyklu | Może się różnić między artykułami |
|---|---|---|
| Wykluczenia osób (pytanie kontrolne, czas wypełniania, kryteria włączenia) | Tak – jedna lista wykluczonych identyfikatorów | Tylko z uzasadnieniem merytorycznym (np. artykuł dotyczy podgrupy), opisanym w tekście |
| Wyniki skal: pozycje odwrócone, średnia czy suma, reguła braków w pozycjach | Tak | Nie – ta sama skala musi być liczona tak samo |
| Braki danych w zmiennych analizowanych | Tak – reguła ogólna (np. imputacja wielokrotna albo FIML) | Szczegóły modelu imputacji mogą zależeć od zmiennych w artykule |
| Obserwacje odstające | Tak – kryterium i postępowanie | Analiza wrażliwości bez nich – w każdym artykule tak samo |
| Kodowanie zmiennych demograficznych | Tak – te same kategorie płci, wykształcenia, wieku | Nie |
| Zmienne kontrolne | Domyślny zestaw dla cyklu | Tak, gdy wynika z pytania – opisz to w metodach |
| Model główny, hipotezy, wielkości efektu | Nie | Tak – to jest treść artykułu |
Wspólne decyzje zapisz w prerejestracji albo w planie analiz całego projektu, zanim zobaczysz dane (zob. plan analizy statystycznej i prerejestracja). Jeśli zmieniasz regułę w trakcie, zmieniasz ją dla wszystkich artykułów i przeliczasz te, które jeszcze nie zostały opublikowane. W opublikowanych zostaje stara reguła, a w nowym tekście opisujesz różnicę.
Przykład: trzy artykuły z jednego badania
Przykład opiera się na danych symulowanych. W badaniu online doktoranci i doktorantki wypełnili skale wsparcia społecznego (6 pozycji), stresu (6 pozycji), jakości snu (4 pozycje) i wypalenia (8 pozycji), wszystkie z odpowiedziami 1–5. Z danych powstają trzy artykuły:
- A1 – właściwości skali wypalenia: analiza pozycji, rzetelność i trafność zbieżna;
- A2 – czy wsparcie społeczne wiąże się z wypaleniem po kontroli wieku i płci (hipoteza H1);
- A3 – czy jakość snu moderuje związek stresu z wypaleniem (H2; zob. moderacja).
W planie projektu zapisano trzy wspólne reguły: wykluczenie osób z błędną odpowiedzią w pytaniu kontrolnym, wykluczenie osób, które wypełniły ankietę w czasie krótszym niż 300 sekund, oraz liczenie wyniku skali jako średniej pozycji, gdy brakuje co najwyżej 20% odpowiedzi. Z 520 osób błędnie na pytanie kontrolne odpowiedziało 36, a krócej niż 300 sekund wypełniało ankietę 41, przy czym 17 osób spełniało oba kryteria. Po wykluczeniach zostało 460 osób, a kolejne 64 nie miały wyniku co najmniej jednej skali (brak ponad 20% odpowiedzi – w czteropozycyjnej skali snu wystarczy do tego jeden brak). Wspólny zbiór analityczny liczy N = 396 osób, w tym 246 kobiet (62.1%), w wieku M = 29.08 roku (SD = 3.23).
| Skala | Pozycje | M | SD | α |
|---|---|---|---|---|
| Wsparcie społeczne | 6 | 3.02 | 0.82 | .83 |
| Stres | 6 | 3.02 | 0.77 | .79 |
| Jakość snu | 4 | 2.96 | 0.79 | .70 |
| Wypalenie | 8 | 3.01 | 0.82 | .88 |
Ta jedna tabela trafia – w całości albo we fragmentach – do wszystkich trzech artykułów. W A2 standaryzowany współczynnik regresji wsparcia dla wypalenia wynosi β = −0.39, 95% CI [−0.48, −0.30], p < .001 (zob. regresja liniowa). W A3 interakcja stresu i jakości snu wynosi b = −0.11, SE = 0.04, t(390) = −2.53, p = .012: przy lepszym śnie związek stresu z wypaleniem jest słabszy. Kod i wyniki znajdziesz w sekcji z kodem R.
Co się dzieje, gdy każdy artykuł przygotowuje dane po swojemu
Załóżmy teraz, że wspólnego skryptu nie ma. Każdy artykuł podejmuje trzy decyzje od nowa: czy wykluczyć osoby po pytaniu kontrolnym, czy wykluczyć osoby zbyt szybkie i czy liczyć wynik skali przy brakach, czy tylko z pełnych odpowiedzi. Daje to osiem wariantów tego samego zbioru. Rysunek 1 pokazuje efekt z artykułu A2 w każdym z nich.
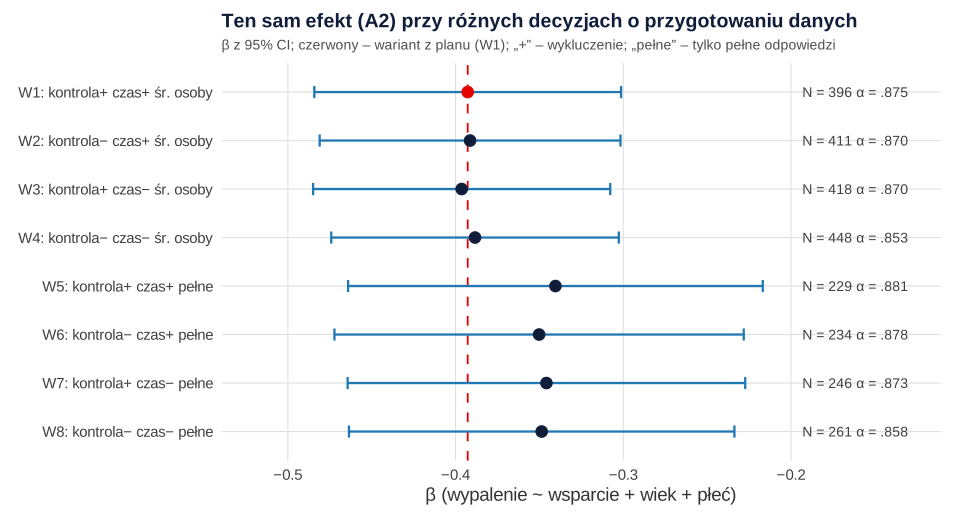
Wniosek merytoryczny się nie zmienia: we wszystkich wariantach wsparcie wiąże się z mniejszym wypaleniem, a interakcja z A3 pozostaje istotna (p od .009 do .029). Zmienia się za to wszystko, co czytelnik zestawi między artykułami. N waha się od 229 do 448, β od −0.40 do −0.34, a α skali wypalenia od .853 do .881. Największy skutek ma reguła braków danych: przy 24 pozycjach i kilku procentach braków w każdej z nich komplet odpowiedzi ma tylko 49.8% osób pozostałych po wykluczeniach. Wymóg kompletu zmniejsza więc próbę z 396 do 229 osób.
W tym przykładzie decyzje mają umiarkowane skutki, bo dane są symulowane i „grzeczne”. W prawdziwych danych bywa gorzej. W projekcie Silberzahna i in. (2018) 29 zespołów analizowało ten sam zbiór danych w odpowiedzi na to samo pytanie. Oszacowania wynosiły od 0.89 do 2.93 w jednostkach OR, 20 zespołów (69%) uzyskało istotny efekt, a 9 (31%) – nie. Analizy użyły 21 różnych zestawów zmiennych kontrolnych, a rozbieżności nie wyjaśniało ani doświadczenie analityków, ani ich wcześniejsze przekonania.
Zestawienie wszystkich rozsądnych wariantów, jak na rysunku 1, to w małej skali analiza wieloświatowa (multiverse analysis). Steegen i in. (2016) proponują ją jako sposób pokazania, na ile wnioski zależą od arbitralnych decyzji. W cyklu artykułów jej rola jest szczególna: nie zastępuje jednego, wcześniej ustalonego potoku, ale może być analizą wrażliwości w omówieniu cyklu (zob. analiza wrażliwości). Szerzej o takich analizach na cudzych danych piszemy w poradniku reanaliza i wtórna analiza danych. Wybieranie wariantu „najlepszego” osobno dla każdego artykułu to z kolei prosta droga do p-hackingu.
Mapa cyklu: który artykuł odpowiada na które pytanie
Drugie narzędzie to mapa zmiennych i artykułów. Prowadzisz ją od pierwszego planu projektu: w wierszach zmienne i decyzje, w kolumnach artykuły, w komórkach rola zmiennej. Mapa pokazuje od razu, czy artykuły rzeczywiście odpowiadają na różne pytania, czy powtarzają ten sam model w innym opakowaniu.
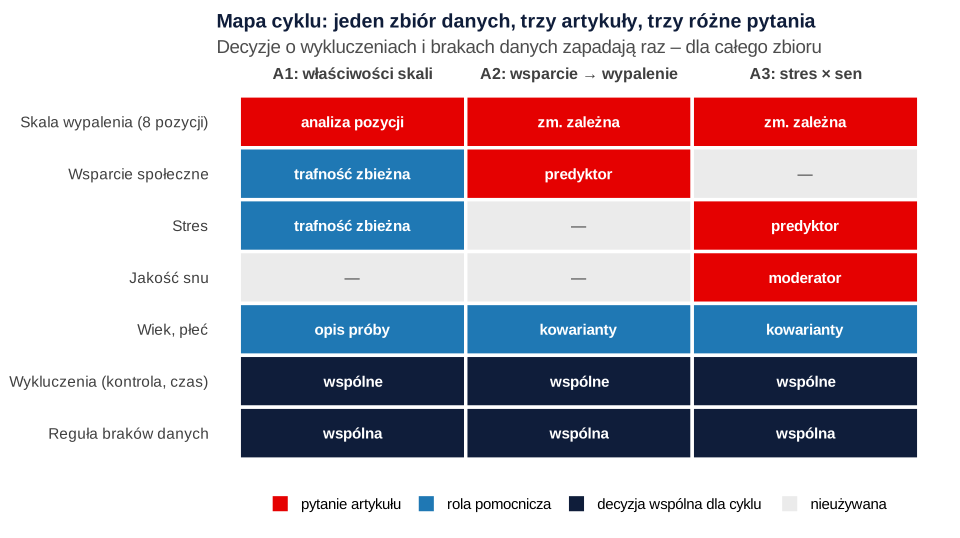
Zalecenia ICMJE dopuszczają kilka publikacji z jednego zbioru danych, jeśli artykuły istotnie się uzupełniają i cytują wcześniejsze publikacje z tego zbioru. Przy dużych badaniach zaplanowanych od początku jako seria osobnych pytań najważniejsza jest przejrzystość: czytelnik musi wiedzieć, że chodzi o tę samą próbę (International Committee of Medical Journal Editors, 2026). Mapa pomaga to wykazać. Jeśli jakiś wiersz wygląda w dwóch kolumnach identycznie, zastanów się, czy nie są to dwie części jednego artykułu.
Szablon mapy, rejestru decyzji i kontroli liczb (z liczbami z przykładu) możesz pobrać jako arkusz mapa-cyklu-artykulow-szablon.xlsx. W arkuszu „Decyzje” każda reguła ma datę ustalenia i listę artykułów, których dotyczy. Ta kolumna przyda się przy pytaniu recenzenta: „dlaczego w tym artykule wykluczyli Państwo inne osoby niż w poprzednim?”.
Kontrola spójności liczb między artykułami
Nawet przy wspólnym skrypcie artykuły się rozjeżdżają, zwłaszcza gdy jeden tekst powstał wcześniej, na wstępnej wersji danych. Dlatego przed wysłaniem każdego kolejnego artykułu i przed złożeniem rozprawy porównaj kluczowe liczby z każdego manuskryptu z wartościami ze wspólnego potoku: N, średnie i odchylenia standardowe głównych skal oraz ich rzetelność.
W przykładzie artykuł A3 przygotowano wcześniej, bez wykluczenia osób po pytaniu kontrolnym. Kontrola w R od razu go wskazuje: N = 411 zamiast 396, średnia wypalenia 2.99 zamiast 3.01 i α = .87 zamiast .88. Odchylenie standardowe akurat się zgadza (0.82), co pokazuje, że jedna zgodna liczba niczego nie dowodzi. W takiej sytuacji masz dwie uczciwe drogi: przeliczyć A3 na wspólnym zbiorze, jeśli tekst nie jest jeszcze opublikowany, albo – jeśli jest – opisać różnicę w kolejnych tekstach i w omówieniu cyklu oraz pokazać, że wnioski się nie zmieniają (rysunek 1).
| Co porównać | Gdzie zwykle jest w artykule | Typowa przyczyna niezgodności |
|---|---|---|
| N po wykluczeniach i liczba wykluczonych z powodami | Uczestnicy, schemat przepływu | Inna wersja danych, inne kryteria wykluczeń |
| M, SD i rzetelność wspólnych skal | Tabela statystyk opisowych, narzędzia | Inna reguła braków, pozycje odwrócone, suma zamiast średniej |
| Rozkład płci, wieku, innych cech | Uczestnicy | Różne kodowanie kategorii, inne wykluczenia |
| Korelacje między wspólnymi zmiennymi | Tabela korelacji | Pairwise zamiast listwise, inna wersja danych |
| Opis procedury i daty zbierania danych | Procedura | Kopiowanie opisu z wcześniejszej wersji projektu |
Hipotezy główne całego cyklu a błąd I rodzaju
W rozprawie z trzech badań i kilku artykułów łatwo uzbierać kilkanaście testów hipotez. Czy trzeba je korygować łącznie? Nie ma na to jednej reguły. Zależy to od tego, jakie twierdzenie formułujesz (zob. problem wielokrotnych porównań i poradnik poprawki na wielokrotne porównania). Jeśli każdy artykuł testuje odrębną hipotezę i wnioski formułujesz osobno dla każdej z nich, zwykle wystarczy kontrola błędu wewnątrz artykułu. Jeśli w omówieniu cyklu formułujesz wniosek łączny („teoria X znalazła potwierdzenie”), oparty na kilku testach, rodzinę hipotez warto określić z góry w planie rozprawy.
W przykładzie plan rozprawy wymienia cztery hipotezy główne: H1 (A2), H2 (A3) oraz związek wsparcia z wypaleniem w dwóch kolejnych, niezależnych badaniach cyklu. Po korekcie Holma wartości p dla H2 i H4 wynoszą .024 i .026, a H1 i H3 pozostają poniżej .001. Wszystkie cztery wyniki pozostają więc istotne przy α = .05. Ważniejsze od samej korekty jest to, że rodzina została zdefiniowana przed analizą, a nie po zobaczeniu, które wyniki „wyszły”.
Kolejny artykuł na tych samych danych: prerejestracja i odstępstwa
Pierwszy artykuł z projektu możesz zaplanować, zanim zobaczysz dane. Przy drugim i trzecim już je znasz – choćby z tabeli statystyk opisowych i korelacji. Taka analiza jest pod pewnymi względami podobna do analizy danych wtórnych. Van den Akker i in. (2021) proponują szablon prerejestracji analiz danych wtórnych. Wymaga on m.in. opisania, co każdy autor wiedział wcześniej o zbiorze, podania dat pierwszego dostępu do danych i wymienienia wcześniejszych publikacji z tego zbioru. W cyklu artykułów to dokładnie te informacje, które recenzent chce zobaczyć.
Plany i tak się zmieniają. Willroth i Atherton (2024) piszą, że odstępstwa od prerejestracji są raczej regułą niż wyjątkiem, a w psychologii zwykle nie są raportowane albo są raportowane niesystematycznie. Proponują tabelę odstępstw: co planowano, co zrobiono, dlaczego i jaki to ma wpływ na wnioski. W cyklu artykułów taka tabela jest jeszcze ważniejsza, bo jedno odstępstwo może dotyczyć kilku tekstów. Hipotez wymyślonych po zobaczeniu wyników nie przedstawiaj jako zaplanowanych (zob. HARKing) – w drugim i trzecim artykule z tego samego zbioru pokusa jest szczególnie silna.
Jak opisać w artykule, że dane są wspólne
Każdy artykuł z cyklu powinien zawierać w metodach krótką informację o projekcie, wcześniejszych publikacjach z tego zbioru i wspólnych regułach przygotowania danych. Wzór po polsku i po angielsku:
Jeśli artykuł powstał na innej wersji danych, napisz to wprost, np.: „Analizy w [odwołanie A3] wykonano na wcześniejszej wersji zbioru, bez wykluczenia osób po pytaniu kontrolnym (N = 411); w niniejszej rozprawie wszystkie analizy powtórzono na wspólnym zbiorze (N = 396), a wnioski się nie zmieniły (zob. Aneks [numer])”. Takie zdanie kosztuje mniej niż odpowiedź na zarzut recenzenta. Jak ją napisać, gdy zarzut już padł, pokazujemy w poradniku odpowiedź recenzentom – wzory.
Omówienie cyklu: minimetaanaliza zamiast wyliczanki
Część rozprawy, która łączy artykuły (wstęp, omówienie, dyskusja całości), często sprowadza się do streszczenia kolejnych tekstów. Jeśli kilka badań cyklu szacuje ten sam efekt, lepiej go połączyć. Goh i in. (2016) zachęcają do minimetaanalizy własnych badań. Przekonują, że metaanaliza nawet kilku badań jest uprawniona, nie wymaga eksperckiej wiedzy, a seria badań z takim podsumowaniem jest mocniejsza i łatwiejsza do zrozumienia. Technikę opisujemy w haśle metaanaliza i w poradniku metaanaliza krok po kroku.
W przykładzie związek wsparcia z wypaleniem zmierzono w trzech badaniach: w A2 (n = 396, r = −.39) i w dwóch kolejnych niezależnych próbach (n = 212, r = −.31; n = 158, r = −.18). Model z efektem stałym daje r = −.32, 95% CI [−.39, −.26]. Heterogeniczność jest jednak zauważalna: Q(2) = 5.92, p = .052, I² = 66.2%. Model z efektami losowymi daje r = −.30, 95% CI [−.41, −.18] – szerszy przedział, bo uwzględnia różnice między badaniami (zob. efekty stałe i losowe). Przy trzech badaniach oszacowanie heterogeniczności jest bardzo niepewne, więc w omówieniu podaj oba modele i opisz, czym badania się różniły.
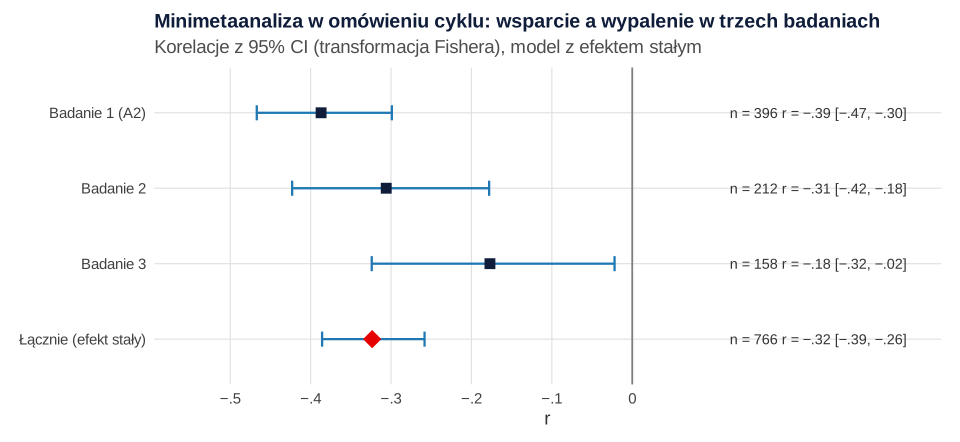
Uwaga: minimetaanaliza łączy tylko badania niezależne. Artykuły A1, A2 i A3 korzystają z tej samej próby, więc ich wyników nie łączysz – to ten sam efekt policzony kilka razy. ICMJE zwraca uwagę, że wielokrotne publikowanie tych samych wyników może prowadzić do niezamierzonego podwójnego liczenia danych w syntezach (International Committee of Medical Journal Editors, 2026). Dlatego wyraźne oznaczenie wspólnej próby w każdym artykule chroni też autorów przyszłych metaanaliz.
Kod R: wspólny potok danych, kontrola liczb i minimetaanaliza
Kod odtwarza wszystkie liczby z tekstu i rysunków. Przepis 1 symuluje dane, definiuje jedną funkcję przygotowania danych dla wszystkich artykułów, liczy statystyki opisowe i modele z A2 i A3, a potem powtarza analizę A2 w ośmiu wariantach przygotowania danych. Wyniki zapisuje do pliku b80-potok.rds, z którego korzysta przepis 2. Uruchom przepisy po kolei w jednym folderze. Rzetelność liczy pakiet psych, a minimetaanalizę – pakiet metafor.
1. Dane, wspólny potok i osiem wariantów przygotowania danych
R
# Doktorat z cyklu artykułów: jeden zbiór danych, wspólny potok przygotowania danych (dane symulowane)
# Projekt: badanie online doktorantów i doktorantek, pomiar wsparcia społecznego, stresu, jakości snu
# i wypalenia. Zbiór służy trzem artykułom: A1 (właściwości skali wypalenia), A2 (wsparcie a wypalenie),
# A3 (jakość snu jako moderator związku stresu z wypaleniem).
suppressPackageStartupMessages(library(psych))
set.seed(8020)
n <- 520
wiek <- round(pmin(45, pmax(24, rnorm(n, 29, 3.5))))
plec <- factor(sample(c("kobieta", "mężczyzna"), n, replace = TRUE, prob = c(.62, .38)))
wsparcie <- rnorm(n); stres <- -0.30 * wsparcie + rnorm(n, sd = 0.95); sen <- -0.25 * stres + rnorm(n, sd = 0.97)
wyp_lat <- -0.25 * wsparcie + 0.45 * stres - 0.15 * sen - 0.25 * stres * sen + rnorm(n, sd = 0.75)
pozycje <- function(lat, k, lad = .70) sapply(1:k, function(j) {
  x <- lad * as.numeric(scale(lat)) + sqrt(1 - lad^2) * rnorm(length(lat))
  as.integer(cut(x, c(-Inf, -1.3, -0.45, 0.45, 1.3, Inf)))})            # odpowiedzi 1–5
WYP <- pozycje(wyp_lat, 8, .72); colnames(WYP) <- paste0("wyp", 1:8)
WSP <- pozycje(wsparcie, 6, .70); colnames(WSP) <- paste0("wsp", 1:6)
STR <- pozycje(stres, 6, .68); colnames(STR) <- paste0("str", 1:6)
SEN <- pozycje(sen, 4, .65); colnames(SEN) <- paste0("sen", 1:4)
surowe <- data.frame(id = 1:n, wiek, plec, czas_s = round(rlnorm(n, log(720), 0.45)),
                     kontrola = 1L, WYP, WSP, STR, SEN)
# Osoby nieuważne: losowe odpowiedzi, szybkie wypełnianie, zła odpowiedź w pytaniu kontrolnym
niew <- sample(n, 38)
surowe[niew, 6:29] <- matrix(sample(1:5, 38 * 24, replace = TRUE), 38)
surowe$czas_s[niew] <- round(runif(38, 150, 420))
surowe$kontrola[sample(niew, 27)] <- 0L
surowe$kontrola[sample(setdiff(1:n, niew), 9)] <- 0L                    # kilka pomyłek u uważnych
# Braki danych w pozycjach (ok. 3% odpowiedzi)
for (v in 6:29) surowe[sample(n, round(n * runif(1, .01, .05))), v] <- NA

# ---------------- Wspólny potok: jedna funkcja dla wszystkich artykułów ----------------
przygotuj <- function(d, wyklucz_kontrola = TRUE, wyklucz_szybcy = TRUE, braki = c("srednia_osoby", "pelne")) {
  braki <- match.arg(braki)
  if (wyklucz_kontrola) d <- d[d$kontrola == 1, ]
  if (wyklucz_szybcy) d <- d[d$czas_s >= 300, ]
  wynik <- function(cols, maks_brak = .2) {
    x <- d[, cols]; ile_brak <- rowMeans(is.na(x))
    w <- if (braki == "pelne") ifelse(ile_brak == 0, rowMeans(x), NA) else ifelse(ile_brak <= maks_brak, rowMeans(x, na.rm = TRUE), NA)
    w }
  d$wypalenie <- wynik(paste0("wyp", 1:8)); d$wsparcie <- wynik(paste0("wsp", 1:6))
  d$stres <- wynik(paste0("str", 1:6)); d$sen <- wynik(paste0("sen", 1:4))
  d[complete.cases(d[, c("wypalenie", "wsparcie", "stres", "sen", "wiek", "plec")]), ]
}
cat("Liczebność surowa:", nrow(surowe), "\n")
cat("Błędna odpowiedź w pytaniu kontrolnym:", sum(surowe$kontrola == 0), "| czas < 300 s:", sum(surowe$czas_s < 300), "\n")
cat("Oba kryteria naraz:", sum(surowe$kontrola == 0 & surowe$czas_s < 300),
    "| po wykluczeniach (przed wynikami skal):", sum(surowe$kontrola == 1 & surowe$czas_s >= 300), "\n")
po_wykl <- surowe[surowe$kontrola == 1 & surowe$czas_s >= 300, ]
cat("Odsetek osób z kompletem 24 odpowiedzi:", sprintf("%.1f%%", 100 * mean(complete.cases(po_wykl[, 6:29]))), "\n")
analiza <- przygotuj(surowe)
cat("Zbiór analityczny (wspólny dla A1–A3):", nrow(analiza), "\n")

# Statystyki opisowe – jedna tabela, z której korzystają wszystkie artykuły
opis <- sapply(analiza[, c("wsparcie", "stres", "sen", "wypalenie")], function(x) c(M = mean(x), SD = sd(x)))
alfy <- c(wsparcie = psych::alpha(analiza[, paste0("wsp", 1:6)], warnings = FALSE)$total$raw_alpha,
          stres = psych::alpha(analiza[, paste0("str", 1:6)], warnings = FALSE)$total$raw_alpha,
          sen = psych::alpha(analiza[, paste0("sen", 1:4)], warnings = FALSE)$total$raw_alpha,
          wypalenie = psych::alpha(analiza[, paste0("wyp", 1:8)], warnings = FALSE)$total$raw_alpha)
print(round(rbind(opis, alfa = alfy), 2))
cat("Wiek: M =", round(mean(analiza$wiek), 2), "SD =", round(sd(analiza$wiek), 2), "| kobiety:", sum(analiza$plec == "kobieta"),
    sprintf("(%.1f%%)", 100 * mean(analiza$plec == "kobieta")), "\n")

# A2: wsparcie a wypalenie (z kontrolą wieku i płci), współczynnik standaryzowany
z <- function(x) as.numeric(scale(x))
m_a2 <- lm(z(wypalenie) ~ z(wsparcie) + z(wiek) + plec, data = analiza)
print(round(cbind(b = coef(m_a2), confint(m_a2))[2, , drop = FALSE], 3))
cat("A2 p:", format.pval(summary(m_a2)$coefficients[2, 4], digits = 3), "\n")
# A3: moderacja stres × sen
m_a3 <- lm(z(wypalenie) ~ z(stres) * z(sen) + z(wiek) + plec, data = analiza)
print(round(summary(m_a3)$coefficients[c(2, 3, 6), ], 3))

# ---------------- Co się dzieje, gdy każdy artykuł przygotowuje dane po swojemu ----------------
warianty <- expand.grid(kontrola = c(TRUE, FALSE), szybcy = c(TRUE, FALSE), braki = c("srednia_osoby", "pelne"),
                        stringsAsFactors = FALSE)
wyn <- do.call(rbind, lapply(seq_len(nrow(warianty)), function(i) {
  d <- przygotuj(surowe, warianty$kontrola[i], warianty$szybcy[i], warianty$braki[i])
  m <- lm(z(wypalenie) ~ z(wsparcie) + z(wiek) + plec, data = d)
  ci <- confint(m)[2, ]
  a <- psych::alpha(d[, paste0("wyp", 1:8)], warnings = FALSE)$total$raw_alpha
  m3 <- summary(lm(z(wypalenie) ~ z(stres) * z(sen) + z(wiek) + plec, data = d))$coefficients
  data.frame(warianty[i, ], N = nrow(d), beta = coef(m)[2], dolna = ci[1], gorna = ci[2], alfa_wyp = a,
             inter = m3["z(stres):z(sen)", 1], p_inter = m3["z(stres):z(sen)", 4],
             M_wyp = mean(d$wypalenie), SD_wyp = sd(d$wypalenie), row.names = NULL)
}))
wyn$wariant <- paste0("W", seq_len(nrow(wyn)))
print(within(wyn, { beta <- round(beta, 3); dolna <- round(dolna, 3); gorna <- round(gorna, 3); alfa_wyp <- round(alfa_wyp, 3); M_wyp <- round(M_wyp, 2); SD_wyp <- round(SD_wyp, 2); inter <- round(inter, 3); p_inter <- round(p_inter, 3) }))
cat("Zakres N:", range(wyn$N), "| zakres beta:", round(range(wyn$beta), 3), "| zakres alfa:", round(range(wyn$alfa_wyp), 3), "\n")
saveRDS(list(wyn = wyn, analiza = analiza, surowe = surowe), "b80-potok.rds")
Wynik w R
Liczebność surowa: 520
Błędna odpowiedź w pytaniu kontrolnym: 36 | czas < 300 s: 41
Oba kryteria naraz: 17 | po wykluczeniach (przed wynikami skal): 460
Odsetek osób z kompletem 24 odpowiedzi: 49.8%
Zbiór analityczny (wspólny dla A1–A3): 396
     wsparcie stres  sen wypalenie
M        3.02  3.02 2.96      3.01
SD       0.82  0.77 0.79      0.82
alfa     0.83  0.79 0.70      0.88
Wiek: M = 29.08 SD = 3.23 | kobiety: 246 (62.1%)
                 b  2.5 % 97.5 %
z(wsparcie) -0.393 -0.484 -0.301
A2 p: 6.11e-16
                Estimate Std. Error t value Pr(>|t|)
z(stres)           0.481      0.045  10.751    0.000
z(sen)            -0.060      0.044  -1.339    0.181
z(stres):z(sen)   -0.111      0.044  -2.525    0.012
  kontrola szybcy         braki   N   beta  dolna  gorna alfa_wyp  inter p_inter M_wyp SD_wyp
1     TRUE   TRUE srednia_osoby 396 -0.393 -0.484 -0.301    0.875 -0.111   0.012  3.01   0.82
2    FALSE   TRUE srednia_osoby 411 -0.391 -0.481 -0.302    0.870 -0.111   0.009  2.99   0.82
3     TRUE  FALSE srednia_osoby 418 -0.396 -0.485 -0.308    0.870 -0.107   0.014  3.00   0.82
4    FALSE  FALSE srednia_osoby 448 -0.388 -0.474 -0.303    0.853 -0.101   0.016  2.99   0.80
5     TRUE   TRUE         pelne 229 -0.340 -0.464 -0.217    0.881 -0.139   0.013  2.99   0.83
6    FALSE   TRUE         pelne 234 -0.350 -0.472 -0.228    0.878 -0.139   0.012  3.00   0.83
7     TRUE  FALSE         pelne 246 -0.346 -0.464 -0.227    0.873 -0.130   0.018  2.98   0.82
8    FALSE  FALSE         pelne 261 -0.349 -0.464 -0.234    0.858 -0.117   0.029  2.98   0.81
  wariant
1      W1
2      W2
3      W3
4      W4
5      W5
6      W6
7      W7
8      W8
Zakres N: 229 448 | zakres beta: -0.396 -0.34 | zakres alfa: 0.853 0.881
2. Kontrola spójności liczb, korekta Holma i minimetaanaliza
R
# Cykl artykułów: kontrola spójności liczb, korekta Holma dla hipotez głównych i minimetaanaliza
suppressPackageStartupMessages(library(metafor))
p <- readRDS("b80-potok.rds"); analiza <- p$analiza; wyn <- p$wyn

# 1. Kontrola spójności: liczby przepisane z trzech manuskryptów a wartości ze wspólnego potoku
wzorzec <- c(N = nrow(analiza), M_wyp = round(mean(analiza$wypalenie), 2), SD_wyp = round(sd(analiza$wypalenie), 2),
             alfa_wyp = round(psych::alpha(analiza[, paste0("wyp", 1:8)], warnings = FALSE)$total$raw_alpha, 2))
w2 <- wyn[wyn$wariant == "W2", ]   # A3 przygotowano wcześniej, bez wykluczenia po pytaniu kontrolnym
manuskrypty <- data.frame(artykul = c("A1", "A2", "A3"),
  N = c(wzorzec[["N"]], wzorzec[["N"]], w2$N),
  M_wyp = c(wzorzec[["M_wyp"]], wzorzec[["M_wyp"]], round(w2$M_wyp, 2)),
  SD_wyp = c(wzorzec[["SD_wyp"]], wzorzec[["SD_wyp"]], round(w2$SD_wyp, 2)),
  alfa_wyp = c(wzorzec[["alfa_wyp"]], wzorzec[["alfa_wyp"]], round(w2$alfa_wyp, 2)))
print(manuskrypty)
print(wzorzec)
roznice <- sapply(names(wzorzec), function(v) manuskrypty[[v]] != wzorzec[[v]])
rownames(roznice) <- manuskrypty$artykul
print(roznice)
cat("Artykuły z niezgodnymi liczbami:", rownames(roznice)[rowSums(roznice) > 0], "\n")

# 2. Hipotezy główne całego cyklu i korekta Holma (rodzina = hipotezy główne zapisane w planie rozprawy)
set.seed(8021)
badanie <- function(n, rho) { x <- rnorm(n); y <- rho * x + sqrt(1 - rho^2) * rnorm(n); cor.test(x, y) }
b1 <- cor.test(analiza$wsparcie, analiza$wypalenie)
b2 <- badanie(212, -.30)      # badanie 2: osobna próba doktorantów z innych uczelni
b3 <- badanie(158, -.22)      # badanie 3: próba młodszych pracowników naukowych
m_a3 <- lm(scale(wypalenie) ~ scale(stres) * scale(sen) + scale(wiek) + plec, data = analiza)
p_glowne <- c(H1_A2_wsparcie = b1$p.value, H2_A3_interakcja = summary(m_a3)$coefficients[6, 4],
              H3_B2_wsparcie = b2$p.value, H4_B3_wsparcie = b3$p.value)
print(data.frame(p = signif(p_glowne, 3), p_Holm = signif(p.adjust(p_glowne, "holm"), 3)))

# 3. Minimetaanaliza związku wsparcia z wypaleniem w trzech badaniach cyklu (z Fishera, efekt stały)
r <- c(b1$estimate, b2$estimate, b3$estimate); n <- c(nrow(analiza), 212, 158)
es <- escalc(measure = "ZCOR", ri = r, ni = n)
nazwy <- c("Badanie 1 (A2)", "Badanie 2", "Badanie 3")
fe <- rma(yi, vi, data = es, method = "FE")
re <- rma(yi, vi, data = es, method = "REML")
tab <- data.frame(badanie = nazwy, n = n, r = round(r, 3),
                  dolna = round(tanh(es$yi - 1.96 * sqrt(es$vi)), 3), gorna = round(tanh(es$yi + 1.96 * sqrt(es$vi)), 3))
print(tab)
pf <- predict(fe, transf = tanh); pr <- predict(re, transf = tanh)
cat(sprintf("Efekt stały: r = %.3f, 95%% CI [%.3f, %.3f], z = %.2f, p = %s\n", pf$pred, pf$ci.lb, pf$ci.ub, fe$zval, format.pval(fe$pval, digits = 3)))
cat(sprintf("Q(%d) = %.2f, p = %s, I2 = %.1f%%\n", fe$k - 1, fe$QE, sub("^0", "", sprintf("%.3f", fe$QEp)), fe$I2))   # p bez zera wiodącego (APA)
cat(sprintf("Efekty losowe (REML): r = %.3f, 95%% CI [%.3f, %.3f], tau2 = %.4f\n", pr$pred, pr$ci.lb, pr$ci.ub, re$tau2))
saveRDS(list(tab = tab, fe = c(pf$pred, pf$ci.lb, pf$ci.ub)), "b80-meta.rds")
Wynik w R
  artykul   N M_wyp SD_wyp alfa_wyp
1      A1 396  3.01   0.82     0.88
2      A2 396  3.01   0.82     0.88
3      A3 411  2.99   0.82     0.87
       N    M_wyp   SD_wyp alfa_wyp
  396.00     3.01     0.82     0.88
       N M_wyp SD_wyp alfa_wyp
A1 FALSE FALSE  FALSE    FALSE
A2 FALSE FALSE  FALSE    FALSE
A3  TRUE  TRUE  FALSE     TRUE
Artykuły z niezgodnymi liczbami: A3
                        p   p_Holm
H1_A2_wsparcie   1.45e-15 5.81e-15
H2_A3_interakcja 1.20e-02 2.39e-02
H3_B2_wsparcie   5.83e-06 1.75e-05
H4_B3_wsparcie   2.59e-02 2.59e-02
         badanie   n      r  dolna  gorna
1 Badanie 1 (A2) 396 -0.387 -0.467 -0.299
2      Badanie 2 212 -0.306 -0.423 -0.178
3      Badanie 3 158 -0.177 -0.324 -0.022
Efekt stały: r = -0.323, 95% CI [-0.386, -0.258], z = -9.23, p = <2e-16
Q(2) = 5.92, p = .052, I2 = 66.2%
Efekty losowe (REML): r = -0.302, 95% CI [-0.414, -0.182], tau2 = 0.0085
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunki przygotowano w pakiecie ggplot2 (zapis SVG: svglite), a arkusz do pobrania – w pakietach openxlsx i readxl (kontrola zawartości). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
Najczęstsze błędy
- Osobny plik danych dla każdego artykułu. Po roku nikt nie wie, który jest „właściwy”. Jeden zbiór analityczny z numerem wersji rozwiązuje ten problem.
- Ręczne poprawki w arkuszu. Usunięcie kilku wierszy „na oko” w Excelu jest niewidoczne w kodzie i nie do odtworzenia.
- Inna reguła braków w każdym artykule. W przykładzie sama ta decyzja zmienia N z 396 na 229.
- Wybieranie wariantu danych pod wynik. Jeśli w jednym artykule wykluczasz osoby szybkie, a w innym nie, bo „wtedy wychodzi”, to jest p-hacking, nawet jeśli każdy wariant da się osobno uzasadnić.
- Brak odwołań do wcześniejszych publikacji z tego samego zbioru. Redakcja i czytelnik muszą wiedzieć, że próba się powtarza.
- Łączenie w metaanalizie artykułów z tej samej próby. To podwójne liczenie tych samych osób.
- Kopiowanie opisu metod z wcześniejszego artykułu bez sprawdzenia liczb. Wspólny opis procedury jest w porządku, ale liczby muszą pochodzić z aktualnej analizy, a powtórzony tekst trzeba zgłosić zgodnie z zasadami czasopisma (zob. analiza statystyczna a system antyplagiatowy).
- Odstępstwa od planu opisane tylko w jednym artykule. Jeśli zmiana dotyczy wspólnego zbioru, opisz ją we wszystkich tekstach, których dotyczy, i w omówieniu cyklu.
Lista kontrolna dla cyklu artykułów
- Dane surowe są zapisane raz i tylko do odczytu, z datą eksportu.
- Jeden skrypt tworzy zbiór analityczny; zbiór ma numer wersji, liczbę wierszy i sumę kontrolną.
- Wspólne reguły (wykluczenia, wyniki skal, braki, obserwacje odstające, kodowanie demografii) są zapisane w planie projektu przed analizą.
- Mapa cyklu pokazuje, że każdy artykuł odpowiada na odrębne pytanie.
- Każdy artykuł podaje wersję danych, wcześniejsze publikacje z tego zbioru i link do danych oraz kodu.
- Przed wysłaniem kolejnego artykułu porównałem N, M, SD i rzetelność z wartościami ze wspólnego potoku.
- Rodzina hipotez głównych rozprawy jest określona w planie, a korekta (jeśli jest potrzebna) – opisana.
- Odstępstwa od planu są zebrane w jednej tabeli dla całego cyklu.
- Omówienie cyklu łączy wyniki niezależnych badań (minimetaanaliza), a nie artykułów z tej samej próby.
- Wszystkie analizy rozprawy da się odtworzyć jednym poleceniem z danych surowych.
Jeśli chcesz, żeby ktoś z zewnątrz przejrzał potok danych i spójność liczb przed złożeniem rozprawy albo kolejnego artykułu, zobacz ofertę analiz statystycznych dla badaczy. Za analizy i ich obronę odpowiadasz jednak sam, a pomoc z zewnątrz ujawniasz zgodnie z zasadami uczelni i czasopisma. Jak udostępniać kolejne artykuły jako preprinty i dbać o otwarty dostęp w całym cyklu, opisujemy w poradniku preprint, open access i ORCID w praktyce doktoranta.
Najczęstsze pytania
Czy w każdym artykule z jednego badania musi być to samo N?
Powinno być takie samo, jeśli artykuły korzystają z tego samego zbioru i tych samych kryteriów wykluczeń. Różne N jest dopuszczalne, gdy wynika z pytania (np. artykuł dotyczy podgrupy) albo z braków w zmiennych używanych tylko w danym artykule – wtedy opisz to w metodach. Różnica wynikająca z innej wersji danych wymaga wyjaśnienia albo przeliczenia.
Jak opisać, że artykuł korzysta z danych opublikowanych już w innym artykule?
W metodach podaj nazwę projektu, wcześniejsze publikacje z tego zbioru z pełnymi odwołaniami, pytanie, którym zajmował się każdy z nich, oraz to, że obecny artykuł odpowiada na odrębne pytanie. Dodaj informację o wspólnych regułach przygotowania danych, wersji zbioru i link do danych oraz kodu. O nakładających się tekstach poinformuj też redakcję w liście przewodnim.
Czy w rozprawie z cyklu artykułów trzeba robić korektę na wielokrotne testowanie dla wszystkich hipotez?
Nie ma jednej reguły. Jeśli artykuły testują odrębne hipotezy i każdą interpretujesz osobno, zwykle wystarczy kontrola błędu w artykule. Jeśli w omówieniu formułujesz wniosek łączny na podstawie kilku testów, określ rodzinę hipotez głównych w planie rozprawy i zastosuj korektę, np. Holma, opisując ją wprost.
Co to jest minimetaanaliza w omówieniu cyklu publikacji?
To metaanaliza kilku własnych, niezależnych badań, które szacują ten sam efekt, np. korelację tych samych zmiennych w różnych próbach. Daje łączne oszacowanie z przedziałem ufności i pokazuje heterogeniczność między badaniami. Nie łączy się w niej artykułów opartych na tej samej próbie, bo to podwójne liczenie tych samych osób.
Jak prerejestrować drugi artykuł z danych, które już znam?
Potraktuj go podobnie jak analizę danych wtórnych: w prerejestracji opisz, co wiesz o zbiorze, kiedy pierwszy raz miałeś dostęp do danych, jakie zmienne i wyniki już widziałeś oraz jakie publikacje z tego zbioru powstały. Użyj tych samych reguł przygotowania danych co w pierwszym artykule, a każde odstępstwo od planu zapisz w tabeli odstępstw.
Powiązane hasła
Przeczytaj też
Analiza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPreprint, open access i ORCID
Kiedy i gdzie udostępnić preprint, jak sprawdzić politykę czasopisma, którą licencję CC wybrać, zielony OA, zasady NCN i ORCID na start doktoratu.
Czytaj →Składasz rozprawę z kilku artykułów i liczby się nie zgadzają?
Uporządkujemy wspólny potok danych, sprawdzimy spójność analiz między artykułami i przygotujemy minimetaanalizę do omówienia cyklu.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Buchanan, E. M., Crain, S. E., Cunningham, A. L., Johnson, H. R., Stash, H., Papadatou-Pastou, M., Isager, P. M., Carlsson, R., & Aczel, B. (2021). Getting started creating data dictionaries: How to create a shareable data set. Advances in Methods and Practices in Psychological Science, 4(1), Article 2515245920928007. https://doi.org/10.1177/2515245920928007 ● Otwarty dostęp
- Goh, J. X., Hall, J. A., & Rosenthal, R. (2016). Mini Meta‐Analysis of Your Own Studies: Some Arguments on Why and a Primer on How. Social and Personality Psychology Compass, 10(10), 535–549. https://doi.org/10.1111/spc3.12267
- International Committee of Medical Journal Editors. (2026). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026). ICMJE. https://www.icmje.org/recommendations/ ● Otwarty dostęp: pełny tekst
- Merga, M. K., Mason, S., & Morris, J. E. (2020). ‘What do I even call this?’ Challenges and possibilities of undertaking a thesis by publication. Journal of Further and Higher Education, 44(9), 1245–1261. https://doi.org/10.1080/0309877X.2019.1671964
- Nethsinghe, R., & Southcott, J. (2015). A juggling act: Supervisor/candidate partnership in a doctoral thesis by publication. International Journal of Doctoral Studies, 10, 167–185. https://doi.org/10.28945/2256 ● Otwarty dostęp
- Sandve, G. K., Nekrutenko, A., Taylor, J., & Hovig, E. (2013). Ten Simple Rules for Reproducible Computational Research. PLoS Computational Biology, 9(10), Article e1003285. https://doi.org/10.1371/journal.pcbi.1003285 ● Otwarty dostęp
- Silberzahn, R., Uhlmann, E. L., Martin, D. P., Anselmi, P., Aust, F., Awtrey, E., Bahník, Š., Bai, F., Bannard, C., Bonnier, E., Carlsson, R., Cheung, F., Christensen, G., Clay, R., Craig, M. A., Dalla Rosa, A., Dam, L., Evans, M. H., Flores Cervantes, I., . . . Nosek, B. A. (2018). Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results. Advances in Methods and Practices in Psychological Science, 1(3), 337–356. https://doi.org/10.1177/2515245917747646 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Van den Akker, O. R., Weston, S., Campbell, L., Chopik, B., Damian, R., Davis-Kean, P., Hall, A., Kosie, J., Kruse, E., Olsen, J., Ritchie, S., Valentine, K. D., Van 't Veer, A., & Bakker, M. (2021). Preregistration of secondary data analysis: A template and tutorial. Meta-Psychology, 5. https://doi.org/10.15626/mp.2020.2625 ● Otwarty dostęp
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
- Willroth, E. C., & Atherton, O. E. (2024). Best laid plans: A guide to reporting preregistration deviations. Advances in Methods and Practices in Psychological Science, 7(1), Article 25152459231213802. https://doi.org/10.1177/25152459231213802 ● Otwarty dostęp
Cytowania BibTeX
@article{buchanan2021getting, author={Buchanan, Erin M. and Crain, Sarah E. and Cunningham, Ari L. and Johnson, Hannah R. and Stash, Hannah and Papadatou-Pastou, Marietta and Isager, Peder M. and Carlsson, Rickard and Aczel, Balazs}, title={{Getting started creating data dictionaries: How to create a shareable data set}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={1}, eid={2515245920928007}, doi={10.1177/2515245920928007}}@article{goh2016mini, author={Goh, Jin X. and Hall, Judith A. and Rosenthal, Robert}, title={{Mini Meta‐Analysis of Your Own Studies: Some Arguments on Why and a Primer on How}}, journal={Social and Personality Psychology Compass}, year={2016}, volume={10}, number={10}, pages={535--549}, doi={10.1111/spc3.12267}}@misc{icmje2026recommendations, author={{International Committee of Medical Journal Editors}}, title={{Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026)}}, howpublished={ICMJE}, year={2026}, publisher={International Committee of Medical Journal Editors}, url={https://www.icmje.org/recommendations/}}@article{merga2020what, author={Merga, Margaret K. and Mason, Shannon and Morris, Julia E.}, title={{‘What do I even call this?’ Challenges and possibilities of undertaking a thesis by publication}}, journal={Journal of Further and Higher Education}, year={2020}, volume={44}, number={9}, pages={1245--1261}, doi={10.1080/0309877x.2019.1671964}}@article{nethsinghe2015juggling, author={Nethsinghe, Rohan and Southcott, Jane}, title={{A juggling act: Supervisor/candidate partnership in a doctoral thesis by publication}}, journal={International Journal of Doctoral Studies}, year={2015}, volume={10}, pages={167--185}, doi={10.28945/2256}}@article{sandve2013ten, author={Sandve, Geir Kjetil and Nekrutenko, Anton and Taylor, James and Hovig, Eivind}, title={{Ten Simple Rules for Reproducible Computational Research}}, journal={PLoS Computational Biology}, year={2013}, volume={9}, number={10}, eid={e1003285}, doi={10.1371/journal.pcbi.1003285}}@article{silberzahn2018many, author={Silberzahn, R. and Uhlmann, E. L. and Martin, D. P. and Anselmi, P. and Aust, F. and Awtrey, E. and Bahník, Š. and Bai, F. and Bannard, C. and Bonnier, E. and Carlsson, R. and Cheung, F. and Christensen, G. and Clay, R. and Craig, M. A. and Dalla Rosa, A. and Dam, L. and Evans, M. H. and Flores Cervantes, I. and Fong, N. and Gamez-Djokic, M. and Glenz, A. and Gordon-McKeon, S. and Heaton, T. J. and Hederos, K. and Heene, M. and Hofelich Mohr, A. J. and Högden, F. and Hui, K. and Johannesson, M. and Kalodimos, J. and Kaszubowski, E. and Kennedy, D. M. and Lei, R. and Lindsay, T. A. and Liverani, S. and Madan, C. R. and Molden, D. and Molleman, E. and Morey, R. D. and Mulder, L. B. and Nijstad, B. R. and Pope, N. G. and Pope, B. and Prenoveau, J. M. and Rink, F. and Robusto, E. and Roderique, H. and Sandberg, A. and Schlüter, E. and Schönbrodt, F. D. and Sherman, M. F. and Sommer, S. A. and Sotak, K. and Spain, S. and Spörlein, C. and Stafford, T. and Stefanutti, L. and Tauber, S. and Ullrich, J. and Vianello, M. and Wagenmakers, E.-J. and Witkowiak, M. and Yoon, S. and Nosek, B. A.}, title={{Many Analysts, One Data Set: Making Transparent How Variations in Analytic Choices Affect Results}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={337--356}, doi={10.1177/2515245917747646}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{vandenakker2021preregistration, author={Van den Akker, Olmo R. and Weston, Sara and Campbell, Lorne and Chopik, Bill and Damian, Rodica and Davis-Kean, Pamela and Hall, Andrew and Kosie, Jessica and Kruse, Elliott and Olsen, Jerome and Ritchie, Stuart and Valentine, KD and Van 't Veer, Anna and Bakker, Marjan}, title={{Preregistration of secondary data analysis: A template and tutorial}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2020.2625}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}@article{willroth2024best, author={Willroth, Emily C. and Atherton, Olivia E.}, title={{Best laid plans: A guide to reporting preregistration deviations}}, journal={Advances in Methods and Practices in Psychological Science}, year={2024}, volume={7}, number={1}, eid={25152459231213802}, doi={10.1177/25152459231213802}}