Po co korygować wyniki przy wielu testach?
Poziom istotności α = .05 dotyczy jednego testu. Każdy kolejny test to następna szansa na fałszywy alarm, czyli błąd I rodzaju. Rośnie więc rodzinny błąd I rodzaju (FWER, ang. familywise error rate) – prawdopodobieństwo choćby jednego fałszywego alarmu w rodzinie testów. Dla m niezależnych testów, gdy wszystkie hipotezy zerowe są prawdziwe:
Przy dziesięciu testach FWER = 1 − .9510 = .401. Mechanizm problemu opisują hasła problem wielokrotnych porównań i korekta Bonferroniego. Tutaj liczymy popularne poprawki na jednym zestawie wartości p i podajemy reguły wyboru.
Rodzina testów: co do niej należy
Poprawkę liczysz w obrębie rodziny testów, czyli testów, z których wyciągasz jeden wniosek. Rubin (2021) argumentuje, że korekta jest właściwa wtedy, gdy do odrzucenia łącznej hipotezy wystarczy co najmniej jeden istotny wynik – np. „praca zarobkowa pogarsza funkcjonowanie studentów”, jeśli różnica wyjdzie na którymkolwiek z dziesięciu wskaźników. Do rodziny należą więc wskaźniki jednej hipotezy, pary grup porównywane po ANOVA i korelacje przeglądane w poszukiwaniu „czegoś istotnego”. Nie należą testy założeń (np. test Levene’a) ani osobne hipotezy z własnymi wnioskami. Rodzinę i metodę korekty ustal przed analizą, najlepiej w planie analizy statystycznej.
Metody kontrolujące FWER: Bonferroni, Šidák, Holm, Hochberg
Te metody nie pozwalają, by FWER przekroczył α. Procedury krokowe najpierw sortują wartości p rosnąco: p(1) ≤ … ≤ p(m).
- Bonferroni. Każdy test oceniasz na poziomie α/m albo mnożysz p przez m (najwyżej do 1). Działa przy dowolnej zależności testów, ale ma najmniejszą moc.
- Šidák. Próg wynosi 1 − (1 − α)1/m. Šidák (1967) udowodnił, że w testach dwustronnych opartych na wielowymiarowym rozkładzie normalnym reguła liczona jak dla niezależnych testów pozostaje zachowawcza przy dowolnej korelacji statystyk. Zysk jest symboliczny: przy dziesięciu testach próg .0051 zamiast .0050.
- Holm (procedura krokowa w dół). Od najmniejszego p porównujesz p(i) z progiem α/(m − i + 1) i zatrzymujesz się na pierwszym przekroczeniu progu. Procedura chroni przed błędem I rodzaju przy dowolnej kombinacji prawdziwych hipotez (Holm, 1979) i nigdy nie odrzuca mniej hipotez niż Bonferroni.
- Hochberg (procedura krokowa w górę). Progi są te same, ale idziesz od największego p: pierwsza hipoteza, której p mieści się pod progiem, jest odrzucana razem ze wszystkimi o mniejszym p. Hochberg (1988) pokazał, że jego procedura jest mocniejsza od procedury Holma. Według dokumentacji funkcji
p.adjust()w R wymaga jednak testów niezależnych albo dodatnio zależnych – tak jak metoda Hommela, która bywa od niej jeszcze trochę mocniejsza.
Metody kontrolujące FDR: Benjamini–Hochberg i Benjamini–Yekutieli
FDR (ang. false discovery rate) to oczekiwany odsetek fałszywych odkryć wśród odrzuconych hipotez. Kontrola FWER ogranicza ryzyko choćby jednego fałszywego alarmu, a kontrola FDR dopuszcza kilka, byle stanowiły mały odsetek odkryć. Benjamini i Hochberg (1995) zaproponowali ją jako praktyczną alternatywę, która daje wyraźny zysk mocy.
- Benjamini–Hochberg (BH). Znajdujesz największe i, dla którego p(i) ≤ i × α/m, i odrzucasz hipotezy od pierwszej do i-tej. Benjamini i Yekutieli (2001) udowodnili, że BH kontroluje FDR także przy dodatniej zależności testów, np. dodatnio skorelowanych wskaźników.
- Benjamini–Yekutieli (BY). Progi BH są dzielone przez 1 + 1/2 + … + 1/m (dla dziesięciu testów przez 2.929). Procedura kontroluje FDR przy dowolnej zależności testów (Benjamini i Yekutieli, 2001), ale płaci za to mocą.
FDR wybierz, gdy wynik ma wskazać kandydatów do dalszego sprawdzenia, a nie ostatecznie potwierdzić hipotezę: przy wielu wskaźnikach eksploracyjnych, przesiewie zmiennych albo dużej macierzy korelacji.
Poprawki wbudowane w testy post hoc
Wszystkie pary grup po ANOVA porównuj raczej testem post hoc niż serią poprawianych testów t. W większości takich testów kontrola błędu jest wbudowana w rozkład statystyki:
- test Tukeya (HSD) – wszystkie pary grup przy zbliżonych wariancjach;
- test Dunnetta – grupy porównywane tylko z jedną grupą kontrolną;
- test Scheffégo – dowolne kontrasty, także złożone i wybrane po obejrzeniu danych;
- test Gamesa–Howella – wszystkie pary przy nierównych wariancjach;
- test Dunna – pary grup po teście Kruskala–Wallisa, z korektą Holma.
Przy czterech grupach po 20 osób (6 par) różnica jest istotna w teście Tukeya od |t| = 2.63, a po korekcie Bonferroniego dopiero od 2.71. Wybór testu post hoc omawiamy w poradniku ANOVA krok po kroku.
Jeden przykład, siedem poprawek
Testem t Welcha porównujesz 70 osób studiujących, które pracują zarobkowo co najmniej 20 godzin tygodniowo, z 70 niepracującymi na dziesięciu wskaźnikach funkcjonowania (wyniki T; wyższy wynik – więcej problemów). Dane są symulowane, więc znamy prawdę: różnica w populacji dotyczy pięciu wskaźników, a wskaźniki korelują ze sobą (r = .30). Pogrubienie w tabeli oznacza p < .05.
| Wskaźnik | Różnica w populacji | p bez korekty | Bonferroni | Šidák | Holm | Hochberg | Hommel | BH | BY |
|---|---|---|---|---|---|---|---|---|---|
| Stres | tak | < .001 | .004 | .004 | .004 | .004 | .003 | .003 | .010 |
| Zmęczenie | tak | < .001 | .007 | .007 | .006 | .006 | .006 | .003 | .010 |
| Wypalenie akademickie | tak | .004 | .036 | .035 | .029 | .029 | .025 | .012 | .035 |
| Problemy ze snem | tak | .005 | .054 | .052 | .038 | .038 | .038 | .013 | .039 |
| Dolegliwości somatyczne | nie | .019 | .192 | .177 | .115 | .099 | .094 | .033 | .097 |
| Senność w ciągu dnia | tak | .020 | .199 | .182 | .115 | .099 | .094 | .033 | .097 |
| Objawy lęku | nie | .037 | .374 | .317 | .150 | .150 | .133 | .053 | .157 |
| Objawy depresji | nie | .067 | .667 | .499 | .200 | .200 | .200 | .083 | .244 |
| Samotność | nie | .259 | 1.000 | .950 | .519 | .361 | .361 | .288 | .844 |
| Prokrastynacja | nie | .361 | 1.000 | .989 | .519 | .361 | .361 | .361 | 1.000 |
| Odrzucone H0 | 7 | 3 | 3 | 4 | 4 | 4 | 6 | 4 | |
| Fałszywe alarmy | 2 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
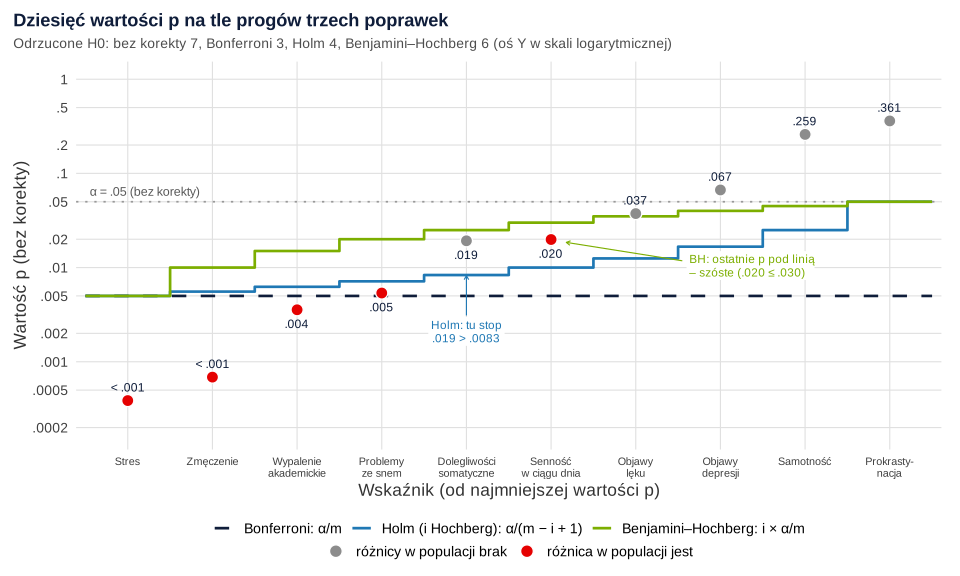
Bez korekty istotnych jest siedem wyników, w tym dwa fałszywe alarmy. Bonferroni i Šidák odrzucają po trzy hipotezy, Holm, Hochberg, Hommel i BY – po cztery, a BH – sześć. Metody FWER nie dały fałszywego alarmu, ale przeoczyły prawdziwe różnice. BH wykryła wszystkie pięć prawdziwych różnic, lecz jedno z jej sześciu odkryć jest fałszywe (16.7%). FDR = 5% to odsetek oczekiwany w wielu badaniach, a nie gwarancja dla każdego z nich.
Rysunek 1 pokazuje mechanizm. Stały próg Bonferroniego (.005) przekracza już czwarta wartość (.0054). Holm zatrzymuje się na piątej (.019 > .0083). Hochberg idzie od góry, ale nie znajduje pod progiem nic dalej niż czwarta wartość, więc odrzuca tyle samo hipotez co Holm. Linia BH rośnie najszybciej i obejmuje jeszcze szóstą wartość (.020 ≤ .030).
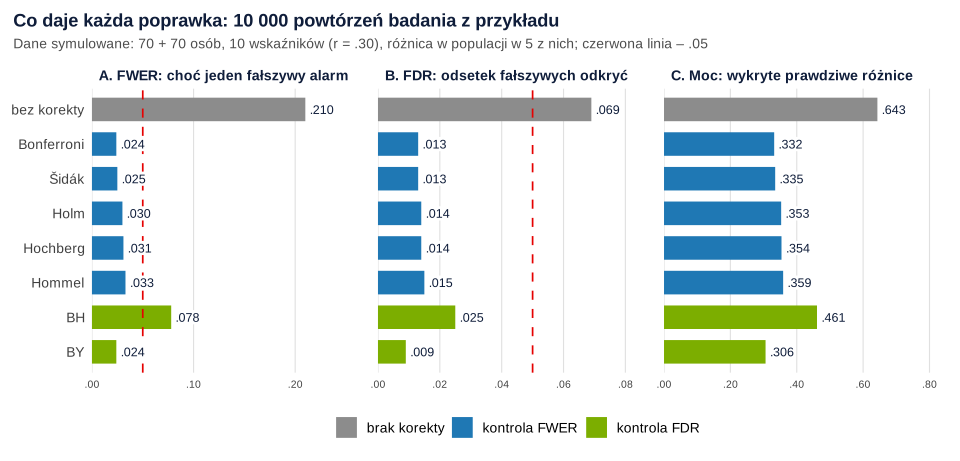
Jeden zbiór danych może przypadkiem sprzyjać którejś metodzie, dlatego badanie powtórzyliśmy 10 000 razy (rysunek 2). Bez korekty co najmniej jeden fałszywy alarm pojawił się w 21.0% badań, a przy metodach FWER – w 2.4–3.3%, przy mocy 33.2–35.9%. BH wykrywała 46.1% prawdziwych różnic przy FDR = .025, ale fałszywy alarm zdarzał się w 7.8% badań, więc BH nie kontroluje FWER. BY miała mniejszą moc niż nawet Bonferroni (30.6%).
Którą poprawkę wybrać?
| Sytuacja | Wybierz | Dlaczego |
|---|---|---|
| Jedna hipoteza główna ustalona przed badaniem | bez korekty | brak rodziny |
| Kilka hipotez lub wskaźników, wniosek z co najmniej jednego wyniku | Holm | FWER przy dowolnej zależności |
| Jak wyżej, testy niezależne lub dodatnio skorelowane | Hochberg lub Hommel | nieco większa moc |
| Wszystkie pary grup po ANOVA | Tukey; przy nierównych wariancjach Games–Howell | kontrola wbudowana w test |
| Grupy porównywane z jedną grupą kontrolną | Dunnett | mniej porównań |
| Kontrasty złożone lub wybrane po obejrzeniu danych | Scheffé | chroni wszystkie kontrasty |
| Pary grup po teście Kruskala–Wallisa | Dunn z korektą Holma | porównania na rangach |
| Dziesiątki wskaźników eksploracyjnych, przesiew zmiennych | Benjamini–Hochberg | większa moc, kontrola FDR |
| Jak wyżej, możliwa ujemna zależność testów | Benjamini–Yekutieli | FDR przy dowolnej zależności |
| Jeden próg dla wszystkich testów, np. do przedziałów ufności | Bonferroni lub Šidák | prostota kosztem mocy |
Gdy się wahasz, wybierz Holma.
Kiedy nie poprawiać albo poprawiać ostrożnie
Korekty mają krytyków. Rothman (1990) argumentuje, że zmniejszają one błąd I rodzaju kosztem błędu II rodzaju dla efektów, które naprawdę istnieją, a rutynowe korygowanie opiera się na „uniwersalnej hipotezie zerowej”, według której obserwowane zjawiska wyjaśnia przede wszystkim przypadek. Perneger (1998) dodaje, że interpretacja wyniku zaczyna wtedy zależeć od liczby innych testów, i zaleca raczej opisać, jakie testy wykonano i dlaczego.
Bender i Lange (2001) uznają jednak korekty za potrzebne w badaniach konfirmacyjnych zawsze, gdy wyniki wielu testów łączysz w jeden wniosek, a Rubin (2021) – za niewłaściwe, gdy każdy test sprawdza osobną hipotezę albo gdy hipoteza wymaga istotności wszystkich wyników naraz. W praktyce:
- jedna z góry wskazana hipoteza główna – testujesz ją na poziomie α = .05, a resztę opisujesz jako analizy dodatkowe;
- hipoteza wymagająca kilku wyników naraz („program obniża stres i poprawia sen”) – bez korekty, bo jeden przypadkowy wynik jej nie potwierdzi;
- analizy w pełni eksploracyjne – możesz ich nie korygować, jeśli nazwiesz je eksploracyjnymi, podasz liczbę wszystkich testów i nie przedstawisz wyników jako potwierdzonych.
Czego oczekują w tej sprawie recenzenci, piszemy w części „Wielokrotne porównania bez korekty” poradnika o zarzutach do statystyki.
Jak zapisać poprawkę w pracy (APA)
- Nazwij rodzinę testów, metodę i kontrolowany błąd (FWER czy FDR) – informację o kontrolowanym błędzie Bender i Lange (2001) uznają za pożądaną.
- Trzymaj się jednego zapisu: skorygowane p z indeksem (pHolm = .038) albo zwykłe p wobec skorygowanego progu (np. α = .005 dla 10 testów po korekcie Bonferroniego).
- W tabeli podaj kolumny p i pHolm, a skrót wyjaśnij w nocie. Obok p podaj statystykę testu i wielkość efektu – korekta zmienia decyzję, a nie wielkość różnicy.
Zdania dla innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA.
Najczęstsze błędy
- Korekta tylko części testów, np. liczenie m tylko z testów, które „wyszły”. Rodzina obejmuje wszystkie testy składające się na wniosek.
- Mieszanie p skorygowanych i nieskorygowanych w tekście lub tabeli bez oznaczenia, które są które.
- Dzielenie α po fakcie. Wybieranie rodziny, metody albo liczby m po obejrzeniu wyników, aż któraś poprawka „da” istotność, to p-hacking.
- Bonferroni zamiast testu Tukeya przy wszystkich parach – zbędna utrata mocy (przy sześciu parach próg |t| 2.71 zamiast 2.63).
- Skorygowane p większe niż 1. Wynik mnożenia obcinasz do 1: dla samotności .259 × 10 = 2.59, więc zapisujesz 1.000.
- Uznanie wyniku nieistotnego po korekcie za brak efektu. Korekta obniża moc testu: senność różniła się w populacji, a pHolm = .115 (zob. hipoteza się nie potwierdziła).
Jeśli chcesz, żeby ktoś sprawdził, czy rodzina testów i poprawka pasują do Twoich hipotez, zobacz analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Poprawki w R: funkcja p.adjust()
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 2 korzysta z obiektów z przepisu 1. Same poprawki liczy funkcja p.adjust() z podstawowego R; pakiet MASS służy tylko do wylosowania skorelowanych danych.
1. Dziesięć testów t i siedem poprawek
R
# Ile wynosi FWER przy 10 niezależnych testach, gdy wszystkie H0 są prawdziwe?
alfa <- .05; m <- 10
round(c(FWER = 1 - (1 - alfa)^m, srednio_falszywych_alarmow = m * alfa), 3)

# Przykład: 140 osób studiujących – 70 pracuje co najmniej 20 godzin tygodniowo, 70 nie pracuje.
# Grupy porównujemy testem t Welcha na 10 wskaźnikach (wyniki T; wyższy wynik = więcej problemów).
# Dane symulowane: wskaźniki korelują ze sobą (r = .30), różnicę w populacji ma tylko pierwszych pięć.
library(MASS)                                       # mvrnorm(): skorelowane wyniki z rozkładu normalnego
wskazniki <- c("Stres", "Zmęczenie", "Problemy ze snem", "Wypalenie akademickie", "Senność w ciągu dnia",
               "Prokrastynacja", "Samotność", "Objawy lęku", "Objawy depresji", "Dolegliwości somatyczne")
d_populacja <- c(0.45, 0.50, 0.40, 0.35, 0.30, 0, 0, 0, 0, 0)    # prawdziwe różnice (d Cohena)
R <- matrix(0.3, m, m); diag(R) <- 1                             # korelacje między wskaźnikami
set.seed(3148)
niepracujacy <- mvrnorm(70, mu = rep(0, m), Sigma = R) * 10 + 50
pracujacy    <- mvrnorm(70, mu = d_populacja, Sigma = R) * 10 + 50

# Test t Welcha dla każdego wskaźnika: t, df, p i d Cohena (pracujący − niepracujący)
wynik <- t(sapply(1:m, function(j) {
  test <- t.test(pracujacy[, j], niepracujacy[, j])              # Welch – domyślnie w t.test()
  c(t = unname(test$statistic), df = unname(test$parameter), p = test$p.value,
    d = (mean(pracujacy[, j]) - mean(niepracujacy[, j])) / sqrt((var(pracujacy[, j]) + var(niepracujacy[, j])) / 2))
}))
p <- setNames(wynik[, "p"], wskazniki)

# Wartości p po korekcie: sześć metod z p.adjust() i Šidák policzony ręcznie
skorygowane <- cbind(bez_korekty = p,
                     Bonferroni  = p.adjust(p, method = "bonferroni"),
                     Sidak       = 1 - (1 - p)^m,
                     Holm        = p.adjust(p, method = "holm"),
                     Hochberg    = p.adjust(p, method = "hochberg"),
                     Hommel      = p.adjust(p, method = "hommel"),
                     BH          = p.adjust(p, method = "BH"),
                     BY          = p.adjust(p, method = "BY"))
kolejnosc <- order(p)                                            # od najmniejszego p
data.frame(efekt = ifelse(d_populacja != 0, "tak", "nie"), round(skorygowane, 3))[kolejnosc, ]

# Ile hipotez zerowych odrzuca każda metoda (p < .05), ile z nich to fałszywe alarmy (brak efektu w populacji)
# i jaki to odsetek wszystkich odkryć
odrzucone <- colSums(skorygowane < alfa)
falszywe  <- colSums(skorygowane[d_populacja == 0, ] < alfa)
rbind(odrzucone, falszywe)
round(falszywe / pmax(odrzucone, 1), 3)                          # odsetek fałszywych wśród odkryć

# Progi dla posortowanych wartości p (i = ranga): Bonferroni, Šidák, Holm i Hochberg, BH, BY
i <- 1:m
round(data.frame(i, p = sort(p), Bonferroni = alfa / m, Sidak = 1 - (1 - alfa)^(1 / m),
                 Holm_Hochberg = alfa / (m - i + 1), BH = i * alfa / m, BY = i * alfa / (m * sum(1 / i))), 4)
round(sum(1 / (1:m)), 3)                                         # mianownik w BY: 1 + 1/2 + … + 1/10
round(c(p_razy_m = unname(p["Samotność"] * m), po_obcieciu = unname(skorygowane["Samotność", "Bonferroni"])), 3)  # p × m > 1

# Statystyki do opisu wyników (kolejność jak w tabeli)
data.frame(t = round(wynik[, "t"], 2), df = round(wynik[, "df"], 1), p = round(p, 4),
           p_Holm = round(skorygowane[, "Holm"], 3), p_BH = round(skorygowane[, "BH"], 3),
           d = round(wynik[, "d"], 2))[kolejnosc, ]
Wynik w R
                      FWER srednio_falszywych_alarmow
                     0.401                      0.500
                        efekt bez_korekty Bonferroni Sidak  Holm Hochberg Hommel    BH    BY
Stres                     tak       0.000      0.004 0.004 0.004    0.004  0.003 0.003 0.010
Zmęczenie                 tak       0.001      0.007 0.007 0.006    0.006  0.006 0.003 0.010
Wypalenie akademickie     tak       0.004      0.036 0.035 0.029    0.029  0.025 0.012 0.035
Problemy ze snem          tak       0.005      0.054 0.052 0.038    0.038  0.038 0.013 0.039
Dolegliwości somatyczne   nie       0.019      0.192 0.177 0.115    0.099  0.094 0.033 0.097
Senność w ciągu dnia      tak       0.020      0.199 0.182 0.115    0.099  0.094 0.033 0.097
Objawy lęku               nie       0.037      0.374 0.317 0.150    0.150  0.133 0.053 0.157
Objawy depresji           nie       0.067      0.667 0.499 0.200    0.200  0.200 0.083 0.244
Samotność                 nie       0.259      1.000 0.950 0.519    0.361  0.361 0.288 0.844
Prokrastynacja            nie       0.361      1.000 0.989 0.519    0.361  0.361 0.361 1.000
          bez_korekty Bonferroni Sidak Holm Hochberg Hommel BH BY
odrzucone           7          3     3    4        4      4  6  4
falszywe            2          0     0    0        0      0  1  0
bez_korekty  Bonferroni       Sidak        Holm    Hochberg      Hommel          BH          BY
      0.286       0.000       0.000       0.000       0.000       0.000       0.167       0.000
                         i      p Bonferroni  Sidak Holm_Hochberg    BH     BY
Stres                    1 0.0004      0.005 0.0051        0.0050 0.005 0.0017
Zmęczenie                2 0.0007      0.005 0.0051        0.0056 0.010 0.0034
Wypalenie akademickie    3 0.0036      0.005 0.0051        0.0063 0.015 0.0051
Problemy ze snem         4 0.0054      0.005 0.0051        0.0071 0.020 0.0068
Dolegliwości somatyczne  5 0.0192      0.005 0.0051        0.0083 0.025 0.0085
Senność w ciągu dnia     6 0.0199      0.005 0.0051        0.0100 0.030 0.0102
Objawy lęku              7 0.0374      0.005 0.0051        0.0125 0.035 0.0119
Objawy depresji          8 0.0667      0.005 0.0051        0.0167 0.040 0.0137
Samotność                9 0.2593      0.005 0.0051        0.0250 0.045 0.0154
Prokrastynacja          10 0.3606      0.005 0.0051        0.0500 0.050 0.0171
[1] 2.929
   p_razy_m po_obcieciu
      2.593       1.000
                           t    df      p p_Holm  p_BH    d
Stres                   3.64 137.3 0.0004  0.004 0.003 0.62
Zmęczenie               3.47 137.5 0.0007  0.006 0.003 0.59
Wypalenie akademickie   2.97 137.9 0.0036  0.029 0.012 0.50
Problemy ze snem        2.83 138.0 0.0054  0.038 0.013 0.48
Dolegliwości somatyczne 2.37 134.2 0.0192  0.115 0.033 0.40
Senność w ciągu dnia    2.36 138.0 0.0199  0.115 0.033 0.40
Objawy lęku             2.10 135.6 0.0374  0.150 0.053 0.36
Objawy depresji         1.85 137.0 0.0667  0.200 0.083 0.31
Samotność               1.13 135.7 0.2593  0.519 0.288 0.19
Prokrastynacja          0.92 135.6 0.3606  0.519 0.361 0.16
2. Symulacja: FWER, FDR i moc każdej poprawki
R
# Symulacja: 10 000 powtórzeń badania z przepisu 1 (70 + 70 osób, 10 wskaźników, r = .30, 5 prawdziwych różnic).
# Korzysta z obiektów m, alfa, R i d_populacja z przepisu 1.
# FWER – odsetek badań z co najmniej jednym fałszywym alarmem; FDR – średni odsetek fałszywych odkryć wśród
# odrzuconych hipotez (0, gdy nic nie odrzucono); moc – średni odsetek wykrytych prawdziwych różnic.
welch_p <- function(x, y) {                         # test t Welcha dla wszystkich kolumn naraz (jak t.test())
  vx <- apply(x, 2, var) / nrow(x); vy <- apply(y, 2, var) / nrow(y)
  t  <- (colMeans(x) - colMeans(y)) / sqrt(vx + vy)
  df <- (vx + vy)^2 / (vx^2 / (nrow(x) - 1) + vy^2 / (nrow(y) - 1))
  2 * pt(-abs(t), df)
}
all.equal(unname(welch_p(pracujacy, niepracujacy)), unname(p))   # zgodność z t.test() z przepisu 1

metody <- c("bez korekty", "Bonferroni", "Šidák", "Holm", "Hochberg", "Hommel", "BH", "BY")
koryguj <- function(p) cbind(p, p.adjust(p, "bonferroni"), 1 - (1 - p)^length(p), p.adjust(p, "holm"),
                             p.adjust(p, "hochberg"), p.adjust(p, "hommel"), p.adjust(p, "BH"), p.adjust(p, "BY"))
efekt <- d_populacja != 0
set.seed(43)
B <- 10000
wyniki <- replicate(B, {
  odrzuc <- koryguj(welch_p(MASS::mvrnorm(70, d_populacja, R), MASS::mvrnorm(70, rep(0, m), R))) < alfa
  V <- colSums(odrzuc[!efekt, ]); S <- colSums(odrzuc[efekt, ])          # fałszywe i prawdziwe odkrycia
  c(V >= 1, V / pmax(V + S, 1), S / sum(efekt))
})
podsumowanie <- data.frame(metoda = metody, FWER = rowMeans(wyniki[1:8, ]), FDR = rowMeans(wyniki[9:16, ]),
                           moc = rowMeans(wyniki[17:24, ]))
podsumowanie[, -1] <- round(podsumowanie[, -1], 3)
podsumowanie
Wynik w R
[1] TRUE
       metoda  FWER   FDR   moc
1 bez korekty 0.210 0.069 0.643
2  Bonferroni 0.024 0.013 0.332
3       Šidák 0.025 0.013 0.335
4        Holm 0.030 0.014 0.353
5    Hochberg 0.031 0.014 0.354
6      Hommel 0.033 0.015 0.359
7          BH 0.078 0.025 0.461
8          BY 0.024 0.009 0.306
3. Tukey a Bonferroni przy wszystkich parach
R
# Wszystkie pary grup po ANOVA: jak duża musi być statystyka |t| dla pary, żeby różnica była istotna (α = .05)?
# Grupy po 20 osób; Tukey HSD korzysta z rozkładu rozstępu studentyzowanego, Bonferroni i Šidák – z rozkładu t.
alfa <- .05
progi <- t(sapply(3:6, function(k) {
  pary <- choose(k, 2); df <- k * 20 - k                         # liczba par i df błędu w ANOVA
  c(grupy = k, pary = pary, df = df,
    Tukey      = qtukey(1 - alfa, nmeans = k, df = df) / sqrt(2),
    Bonferroni = qt(1 - alfa / (2 * pary), df),
    Sidak      = qt(1 - (1 - (1 - alfa)^(1 / pary)) / 2, df))
}))
round(progi, 3)
Wynik w R
     grupy pary  df Tukey Bonferroni Sidak
[1,]     3    3  57 2.406      2.467 2.460
[2,]     4    6  76 2.627      2.709 2.701
[3,]     5   10  95 2.781      2.874 2.866
[4,]     6   15 114 2.899      2.998 2.990
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats, w tym p.adjust(), t.test() i qtukey()); skorelowane dane wylosowano funkcją mvrnorm() z pakietu MASS, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Bonferroni i Šidák w SPSS
W SPSS poprawki dla par grup wybierasz w oknie Analyze → Compare Means → One-Way ANOVA… → Post Hoc. W grupie Equal Variances Assumed są m.in. Bonferroni (błąd każdego testu to łączny błąd podzielony przez liczbę testów), Sidak (ciaśniejsze granice niż Bonferroni), Tukey, Scheffe i Dunnett, a w grupie Equal Variances Not Assumed – m.in. Games-Howell; opcja LSD nie koryguje niczego (IBM Corp., b.d.). Uwaga: Hochberg's GT2 to test oparty na studentyzowanym maksymalnym module, podobny do testu Tukeya (IBM Corp., b.d.), a nie procedura Hochberga z tego wpisu. Metod Holma i BH w tym oknie nie ma – wartości p z osobnych testów skoryguj funkcją p.adjust() w R.
Najczęstsze pytania
Którą poprawkę na wielokrotne porównania wybrać?
Gdy kilka testów składa się na jeden wniosek konfirmacyjny, wybierz metodę Holma: kontroluje rodzinny błąd I rodzaju (FWER) przy dowolnej zależności testów i nigdy nie odrzuca mniej hipotez niż Bonferroni. Pary grup po ANOVA porównuj testem post hoc z wbudowaną kontrolą błędu (Tukey, Games–Howell, Dunnett), a przy wielu wskaźnikach eksploracyjnych użyj procedury Benjaminiego–Hochberga, która kontroluje odsetek fałszywych odkryć (FDR). Wybór zapisz przed analizą.
Co to jest rodzina testów przy korekcie na wielokrotne porównania?
To zestaw testów, z których wyciągasz jeden wspólny wniosek, np. wszystkie wskaźniki jednej hipotezy, wszystkie pary grup po ANOVA albo wszystkie korelacje przeglądane w poszukiwaniu istotnych. Korektę liczysz w obrębie rodziny, więc m to liczba jej testów, a nie wszystkich testów w pracy. Testy założeń i osobne hipotezy z własnymi wnioskami do rodziny nie należą.
Czym metoda Hochberga różni się od metody Holma?
Obie porównują posortowane wartości p z tymi samymi progami α/(m − i + 1). Holm zaczyna od najmniejszego p i zatrzymuje się na pierwszym przekroczeniu progu, a Hochberg zaczyna od największego i odrzuca pierwszą hipotezę, której p mieści się pod progiem, razem ze wszystkimi o mniejszym p. Hochberg jest więc co najmniej tak mocny jak Holm, ale wymaga testów niezależnych lub dodatnio zależnych; w przykładzie z tego wpisu obie metody odrzuciły po 4 hipotezy.
Kiedy użyć korekty Benjaminiego–Yekutieliego?
Gdy chcesz kontrolować odsetek fałszywych odkryć (FDR), a testy mogą być zależne w dowolny sposób, także ujemnie. Procedura Benjaminiego–Yekutieliego dzieli progi Benjaminiego–Hochberga przez 1 + 1/2 + … + 1/m (dla 10 testów przez 2.929), więc jest znacznie ostrzejsza. W naszej symulacji wykrywała średnio 30.6% prawdziwych różnic – mniej niż Bonferroni (33.2%) i Benjamini–Hochberg (46.1%) – dlatego przy dodatnio skorelowanych wskaźnikach zwykle wystarczy Benjamini–Hochberg.
Czy skorygowana wartość p może wynosić 1?
Tak. Korekta Bonferroniego mnoży p przez liczbę testów, więc wynik może przekroczyć 1 – wtedy obcina się go do 1, bo prawdopodobieństwo nie może być większe. W przykładzie z tego wpisu p = .259 przy 10 testach daje 2.59, a w tabeli zapisujesz 1.000. Funkcja p.adjust() w R robi to automatycznie; przy liczeniu ręcznym pilnuj tego sam(a).
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Nie wiesz, czy i jak korygować swoje testy?
Pomożemy ustalić rodzinę testów i dobrać poprawkę do Twoich hipotez, sprawdzimy obliczenia i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bender, R., & Lange, S. (2001). Adjusting for multiple testing—When and how? Journal of Clinical Epidemiology, 54(4), 343–349. https://doi.org/10.1016/S0895-4356(00)00314-0
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Benjamini, Y., & Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
- Hochberg, Y. (1988). A sharper Bonferroni procedure for multiple tests of significance. Biometrika, 75(4), 800–802. https://doi.org/10.1093/biomet/75.4.800
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- IBM Corp. (b.d.). One-Way ANOVA Post Hoc Tests. IBM SPSS Statistics 31.0.0 documentation. Pobrano 19 października 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-post-hoc-tests ● Otwarty dostęp
- Perneger, T. V. (1998). What's wrong with Bonferroni adjustments. BMJ, 316(7139), 1236–1238. https://doi.org/10.1136/bmj.316.7139.1236 ● Otwarty dostęp: pełny tekst
- Rothman, K. J. (1990). No adjustments are needed for multiple comparisons. Epidemiology, 1(1), 43–46. https://doi.org/10.1097/00001648-199001000-00010
- Rubin, M. (2021). When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing. Synthese, 199(3–4), 10969–11000. https://doi.org/10.1007/s11229-021-03276-4 ● Otwarty dostęp: pełny tekst
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
Cytowania BibTeX
@article{bender2001adjusting, author={Bender, Ralf and Lange, Stefan}, title={{Adjusting for multiple testing—When and how?}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={4}, pages={343--349}, doi={10.1016/s0895-4356(00)00314-0}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{benjamini2001control, author={Benjamini, Yoav and Yekutieli, Daniel}, title={{The control of the false discovery rate in multiple testing under dependency}}, journal={The Annals of Statistics}, year={2001}, volume={29}, number={4}, pages={1165--1188}, doi={10.1214/aos/1013699998}}@article{hochberg1988sharper, author={Hochberg, Yosef}, title={{A sharper Bonferroni procedure for multiple tests of significance}}, journal={Biometrika}, year={1988}, volume={75}, number={4}, pages={800--802}, doi={10.1093/biomet/75.4.800}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@misc{ibmndonewayposthoc, author={{IBM Corp.}}, title={{One-Way ANOVA Post Hoc Tests}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-post-hoc-tests}}@article{perneger1998whats, author={Perneger, Thomas V.}, title={{What's wrong with Bonferroni adjustments}}, journal={BMJ}, year={1998}, volume={316}, number={7139}, pages={1236--1238}, doi={10.1136/bmj.316.7139.1236}}@article{rothman1990no, author={Rothman, Kenneth J.}, title={{No adjustments are needed for multiple comparisons}}, journal={Epidemiology}, year={1990}, volume={1}, number={1}, pages={43--46}, doi={10.1097/00001648-199001000-00010}}@article{rubin2021when, author={Rubin, Mark}, title={{When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing}}, journal={Synthese}, year={2021}, volume={199}, number={3–4}, pages={10969--11000}, doi={10.1007/s11229-021-03276-4}}@article{sidak1967rectangular, author={Šidák, Zbyněk}, title={{Rectangular confidence regions for the means of multivariate normal distributions}}, journal={Journal of the American Statistical Association}, year={1967}, volume={62}, number={318}, pages={626--633}, doi={10.1080/01621459.1967.10482935}}