30 pytań, 5 zmiennych z metryczki, 150 testów
Ankieta jest zamknięta, eksport z formularza leży na dysku, a w nim 30 pytań merytorycznych i pięć pytań metryczki: płeć, wiek, rok studiów, miejsce zamieszkania i praca zarobkowa. Najprostszy pomysł na rozdział wyników wygląda tak: każde pytanie zestawić z każdą zmienną z metryczki i opisać to, co wyszło istotne. To 30 × 5 = 150 testów. Program policzy je w kilka sekund, a rozdział zapełni się tabelami krzyżowymi i wykresami kołowymi.
Problem polega na tym, że przy 150 testach kilka „istotnych” wyników pojawi się nawet wtedy, gdy w populacji nie ma żadnej różnicy. Nie odróżnisz ich od prawdziwych. Promotor albo recenzent zapyta, dlaczego testowałeś(-aś) akurat to i jak to się ma do hipotez. Na to pytanie trudno odpowiedzieć, gdy jedynym kryterium było „p < .05”.
Ten wpis pokazuje inną drogę w pięciu krokach. Najpierw każde pytanie dostaje rolę wynikającą z pytań badawczych i hipotez. Pytania opisowe trafiają do tabeli zbiorczej z odsetkami i przedziałami ufności, bez testów. Pozycje skali łączysz w jeden wynik. Testy liczysz tylko dla hipotez, a resztę opisujesz jako wyraźnie oznaczoną eksplorację. Na końcu z tych elementów powstaje rozdział wyników. Ogólną kolejność analizy ankiety, od eksportu po rzetelność, opisuje poradnik analiza ankiety do pracy dyplomowej. Tutaj zajmujemy się jednym problemem: co zrobić, gdy pytań jest dużo.
Przykład przewodni pochodzi ze zdrowia publicznego (dane symulowane). Ankietę „Zachowania zdrowotne studentów” wypełniło 214 osób. Ma ona dziesięciopozycyjną skalę zachowań prozdrowotnych (q01–q10, odpowiedzi 1–5), 16 pytań tak/nie (śniadanie, papierosy, napoje energetyczne, wizyta u dentysty…), pytanie o liczbę godzin snu, liczbę dni z aktywnością fizyczną, samoocenę zdrowia i odczuwany stres. Plik z odpowiedziami możesz pobrać: ankieta-zachowania-zdrowotne-30-pytan.csv (214 wierszy, 36 kolumn). Wszystkie liczby poniżej pochodzą z kodu w sekcji Kod R.
Co się dzieje, gdy policzysz wszystko ze wszystkim
Na poziomie istotności α = .05 każdy test, w którym naprawdę nie ma różnicy, ma 5% szans na fałszywy alarm, czyli błąd I rodzaju. Przy 150 testach oczekiwana liczba fałszywych alarmów wynosi 150 × .05 = 7.5. Sprawdziliśmy to symulacją. Wygenerowaliśmy 1000 ankiet o takim samym układzie jak przykładowa (214 osób, 30 pytań, pięć zmiennych z metryczki). Metryczka była w nich całkowicie niezależna od odpowiedzi, więc każdy wynik istotny był fałszywy. W każdej ankiecie policzyliśmy 150 testów, takich, jakie wybrałby student: test χ², test Manna–Whitneya, test Kruskala–Wallisa, test t Welcha albo korelację z wiekiem.
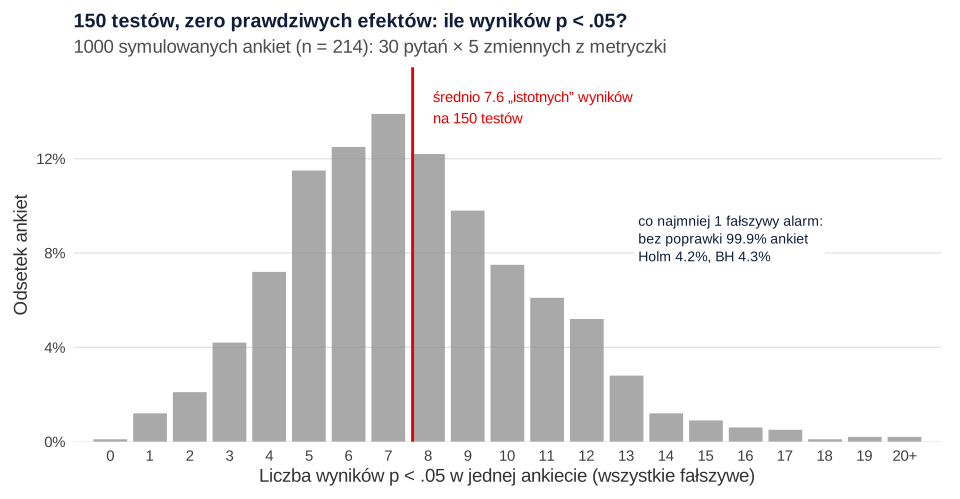
Średnio wychodziło 7.6 „istotnych” wyników na ankietę (SD = 3.15), a w 90% ankiet od 3 do 13. Co najmniej jeden fałszywy alarm pojawił się w 99.9% ankiet, co najmniej pięć – w 85.2%, a dziesięć lub więcej – w 25.3%. Rozrzut jest większy niż przy 150 niezależnych testach (SD = 2.67), bo pozycje jednej skali są ze sobą skorelowane i „wychodzą” razem. Simmons, Nelson i Simonsohn (2011) pokazali, że taka swoboda w wyborze analiz radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Wybieranie z serii testów tych, które wyszły, to p-hacking, nawet jeśli nikt nie robi tego celowo. Szerzej opisuje to hasło problem wielokrotnych porównań.
W ankiecie przykładowej wiemy, które związki są prawdziwe, bo sami je wbudowaliśmy w dane. Są cztery: praca zarobkowa skraca sen, osoby mieszkające z rodzicami częściej jedzą śniadanie, a płeć wiąże się z piciem napojów energetycznych i wizytami u dentysty. Gdy policzyć wszystkie 150 testów, istotnych wyników jest 12. Cztery to prawdziwe związki, a osiem to fałszywe alarmy z p od .032 do .049. Wśród nich są wiek a e-papierosy, rok studiów a skracanie snu z powodu nauki, płeć a samoocena zdrowia. Każdy z nich dałoby się „wyjaśnić” w dyskusji.
Odruchowa odpowiedź brzmi: poprawka na wszystko. Po korekcie Benjaminiego–Hochberga dla wszystkich 150 testów zostają jednak tylko dwa wyniki. Znika m.in. prawdziwy, choć niewielki efekt pracy zarobkowej na sen (p = .039 przed korektą), czyli wynik dla jednej z hipotez. Ani „testuj wszystko”, ani „poprawiaj wszystko” nie jest dobrym planem. Dobrym planem jest ograniczenie testów do tych, które wynikają z pytań badawczych.
Dla własnej liczby testów policz to w kalkulatorze fałszywych alarmów: podaje prawdopodobieństwo co najmniej jednego fałszywego alarmu i rozkład ich liczby.
Krok 1. Wróć do pytań badawczych i przypisz każdemu pytaniu rolę
Zanim otworzysz program statystyczny, weź kwestionariusz i obok każdego pytania zapisz, po co ono jest. Punktem wyjścia są pytania badawcze i hipotezy z rozdziału metodologicznego. Pytanie badawcze typu „jakie zachowania zdrowotne deklarują studenci?” jest opisowe i nie wymaga testu. Testu wymaga hipoteza badawcza, która przewiduje różnicę albo związek. W przykładzie są trzy:
- H1: studenci pracujący zarobkowo śpią krócej niż niepracujący (q17 × praca);
- H2: im wyższy wynik skali zachowań prozdrowotnych, tym lepsza samoocena zdrowia (q01–q10 × q27);
- H3: osoby mieszkające z rodzicami częściej jedzą codziennie śniadanie niż mieszkające poza domem (q11 × miejsce zamieszkania).
Pozostałe pytania nie znikają z pracy, tylko dostają inną rolę. Tabela poniżej pokazuje typowe role w ankiecie studenckiej i to, co z nimi zrobić.
| Rola pytania | Przykład w ankiecie | Co z nim zrobić | Testy |
|---|---|---|---|
| Metryczka | płeć, wiek, rok, miejsce zamieszkania, praca | Opis próby w Tabeli 1; w testach tylko wtedy, gdy zmienna występuje w hipotezie | Tylko w hipotezie |
| Pozycja skali | q01–q10 | Odwrócenie pozycji, jeden wynik skali, rzetelność | Brak na pojedynczych pozycjach |
| Pytanie opisowe | 15 pytań tak/nie, sen, aktywność, stres | Tabela zbiorcza: n, %, 95% CI albo M, SD | Brak |
| Zmienna z hipotezy | q11, q17, q27 i wynik skali | Jeden test zaplanowany przed analizą, wielkość efektu z CI | Po jednym na hipotezę |
| Pytanie warunkowe (po filtrze) | „Jeśli palisz – ile papierosów dziennie?” | Opis wśród osób, których pytanie dotyczy; mianownik w nocie | Zwykle brak |
| Pytanie wielokrotnego wyboru | „Skąd czerpiesz informacje o zdrowiu?” | Zmienne 0/1, % osób z CI | Tylko w hipotezie |
| Pytanie „z ciekawości” | płeć × każde pytanie tak/nie | Osobny podrozdział eksploracyjny albo pominięcie | Z korektą (rodzina eksploracyjna) |
Kilka wyjaśnień do tabeli. Metryczka służy przede wszystkim do opisu, kogo zbadano – jak go zrobić, pokazuje wpis Tabela 1 – charakterystyka próby. Kodowanie wieku, stażu i wykształcenia omawia wpis metryczka w ankiecie: jak zakodować wiek, staż i wykształcenie. To, że w ankiecie jest pytanie o płeć, nie oznacza, że trzeba porównywać płcie w każdym pytaniu. Przy pytaniach warunkowych najpierw ustal mianownik (zob. pytania filtrujące i „nie dotyczy”). Przy pytaniach wielokrotnego wyboru licz odsetek osób, nie zaznaczeń (zob. pytania wielokrotnego wyboru – kodowanie i liczenie).
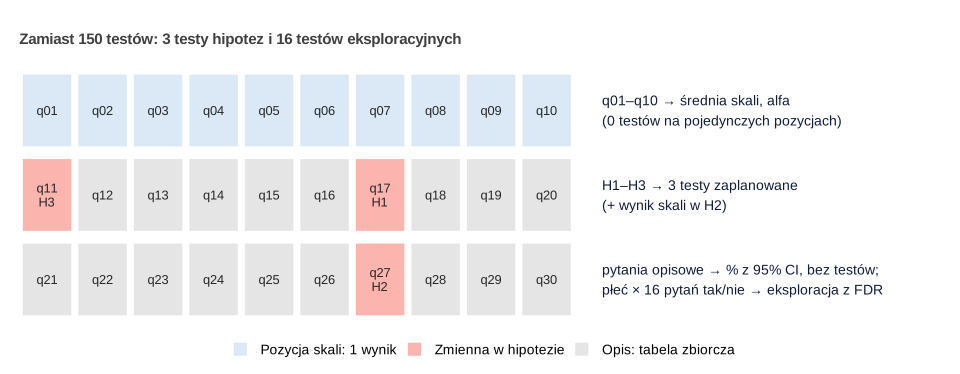
Taka mapa to w praktyce plan analizy statystycznej. Najlepiej zapisać go przed zebraniem danych, a najpóźniej przed obejrzeniem wyników. Jeśli plan powstaje po fakcie, łatwo dobrać hipotezy do tego, co wyszło. To HARKing.
Krok 2. Pytania opisowe: tabela zbiorcza zamiast testów
Pytanie „ilu studentów pije napoje energetyczne co najmniej raz w tygodniu?” ma odpowiedź liczbową: odsetek. Test nie jest tu potrzebny, bo nie porównujesz niczego z niczym. Potrzebujesz natomiast informacji, jak dokładne jest to oszacowanie. Daje ją przedział ufności dla proporcji. Brown, Cai i DasGupta (2001) pokazali, że popularny przedział Walda (odsetek ± 1.96 × błąd standardowy) ma zawodne pokrycie, i zalecają m.in. przedział Wilsona. W R daje go funkcja prop.test() z correct = FALSE.
Szesnaście pytań tak/nie z przykładu mieści się w jednej tabeli. Wiersze posortuj malejąco według odsetka, a nie w kolejności z kwestionariusza – czytelnik od razu zobaczy, co jest częste, a co rzadkie. Liczebność w drugiej kolumnie pokazuje mianownik, który różni się między pytaniami, bo część osób pominęła pojedyncze pytania.
Tabela 2
Zachowania zdrowotne deklarowane przez studentów
| Zachowanie | n | Tak | % | 95% CI |
|---|---|---|---|---|
| Ekran ponad godzinę przed snem | 209 | 151 | 72.2 | [65.8, 77.9] |
| Wizyta u dentysty w ostatnim roku | 210 | 142 | 67.6 | [61.0, 73.6] |
| Skracanie snu z powodu nauki (ostatni miesiąc) | 211 | 134 | 63.5 | [56.8, 69.7] |
| Co najmniej 1.5 l wody dziennie | 208 | 131 | 63.0 | [56.2, 69.3] |
| Codzienne śniadanie | 211 | 127 | 60.2 | [53.5, 66.6] |
| Warzywa codziennie | 210 | 95 | 45.2 | [38.7, 52.0] |
| Dojazd pieszo lub rowerem | 210 | 89 | 42.4 | [35.9, 49.1] |
| Alkohol co najmniej raz w tygodniu | 212 | 84 | 39.6 | [33.3, 46.3] |
| Kontakt z pomocą psychologiczną (kiedykolwiek) | 209 | 72 | 34.4 | [28.3, 41.1] |
| Badania krwi w ostatnim roku | 211 | 71 | 33.6 | [27.6, 40.3] |
| Fast food co najmniej raz w tygodniu | 210 | 70 | 33.3 | [27.3, 40.0] |
| Aplikacja do monitorowania zdrowia | 208 | 67 | 32.2 | [26.2, 38.8] |
| Napoje energetyczne co najmniej raz w tygodniu | 214 | 61 | 28.5 | [22.9, 34.9] |
| Szczepienie przeciw grypie w ostatnim sezonie | 209 | 35 | 16.7 | [12.3, 22.4] |
| E-papierosy | 211 | 34 | 16.1 | [11.8, 21.7] |
| Palenie papierosów | 211 | 27 | 12.8 | [8.9, 18.0] |
Uwaga. N = 214; n – liczba osób, które odpowiedziały na pytanie (pominięcia od 0 do 6 osób). Odsetki liczono od n. CI = przedział ufności Wilsona. Dane symulowane.
Ta sama tabela jako wykres zajmuje mniej miejsca niż szesnaście wykresów kołowych i pozwala porównać pytania jednym spojrzeniem (rysunek 3). Wykres kołowy pokazuje jedno pytanie naraz, a różnice kątów trudno ocenić. W pracy dyplomowej lepiej go unikać. Wystarczy jeden wykres słupkowy albo punktowy z przedziałami, posortowany tak jak tabela.
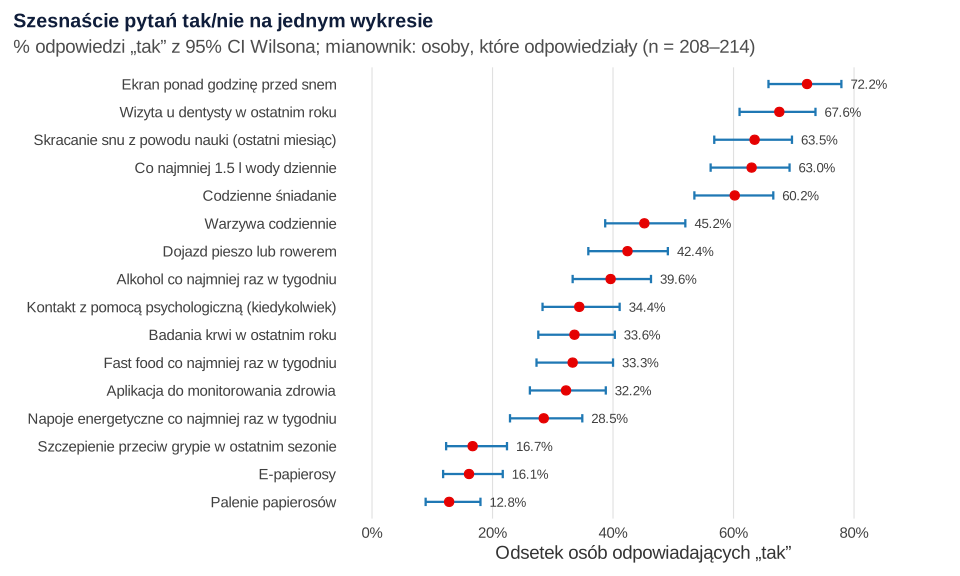
W tekście nie przepisuj całej tabeli. Wskaż najczęstsze i najrzadsze zachowania oraz te, o które pyta pytanie badawcze. Pytania na skali Likerta opisz rozkładem odpowiedzi, a nie średnią z dwoma miejscami po przecinku – gotowy układ tabeli i wykres rozbieżny pokazuje wpis odpowiedzi Likerta w raporcie. Pytania liczbowe opisz średnią i odchyleniem standardowym (w przykładzie sen: M = 6.91 h, SD = 0.98; dni z aktywnością: M = 2.98, SD = 2.12). Jeśli jakaś kategoria odpowiedzi jest bardzo rzadka, zastanów się nad jej połączeniem z sąsiednią, ale według reguły ustalonej przed analizą (zob. łączenie kategorii odpowiedzi przed analizą). Pełne rozkłady wszystkich 30 pytań możesz dać w aneksie.
Krok 3. Pytania tworzące skalę: jeden wynik, nie dziesięć testów
Dziesięć pozycji q01–q10 mierzy jeden konstrukt – dbałość o zdrowie. Testowanie każdej pozycji osobno z płcią czy rokiem studiów dałoby 50 testów o tej samej treści. Wynik takich porównań zależałby od przypadkowego brzmienia pojedynczego pytania. Pozycje skali łączysz w jeden wynik: najpierw odwracasz pozycje sformułowane przeciwnie (w przykładzie q04 i q08: 6 − odpowiedź), potem liczysz średnią. Krok po kroku pokazuje to poradnik jak policzyć wynik kwestionariusza.
W przykładzie wynik skali wyniósł M = 3.03, SD = 0.81 (zakres 1.0–5.0), a alfa Cronbacha α = .92. Rzetelność podajesz raz, dla wyniku całej skali – jak ją ocenić i opisać, wyjaśnia wpis alfa Cronbacha – rzetelność skali. Z dziesięciu pytań robi się w ten sposób jedna zmienna. W przykładzie trafia ona do hipotezy H2. Rozkłady odpowiedzi na pojedyncze pozycje możesz pokazać opisowo albo w aneksie, ale bez testów.
Jeśli ankieta zawiera gotowe narzędzie (np. skalę stresu), wynik liczysz według klucza autorów. Gdy pytania tylko wyglądają podobnie, ale nie były projektowane jako skala, nie sumuj ich na siłę – zostają pytaniami opisowymi.
Krok 4. Testy tylko dla hipotez – główne osobno, eksploracyjne osobno
Hipotezy H1–H3 testujesz po jednym teście każdą, tak jak zapisałeś(-aś) w planie. Dobór testu wynika z rodzaju zmiennych, a nie z tego, który test „wyjdzie”. Przy każdym wyniku podaj wielkość efektu, a nie samo p. W przykładzie wyniki wyglądały tak:
- H1. Pracujący spali średnio 6.76 h (SD = 0.96, n = 92), niepracujący 7.03 h (SD = 0.98, n = 122). Test t Welcha: t(199.01) = 2.07, p = .039. Różnica wyniosła 0.28 h, 95% CI [0.01, 0.54], d = 0.29, 95% CI [0.01, 0.56].
- H2. Wynik skali zachowań prozdrowotnych korelował z samooceną zdrowia (korelacja Spearmana): ρ = .27, p < .001, N = 214.
- H3. Codzienne śniadanie deklarowało 75.6% osób mieszkających z rodzicami (62 z 82) i 50.4% mieszkających poza domem (65 z 129). Test χ² niezależności: χ²(1, N = 211) = 13.31, p < .001, φ = .25.
Czy trzy hipotezy wymagają poprawki na wielokrotne porównania? Odpowiedź zależy od tego, jak z wyników powstaje wniosek. Rubin (2021) rozróżnia trzy sytuacje. Gdy każdy test sprawdza osobną hipotezę i prowadzi do osobnego wniosku (testowanie indywidualne), korekta nie jest potrzebna. Gdy do potwierdzenia jednej ogólnej tezy wystarcza którykolwiek z kilku wyników, korekta jest konieczna. Bender i Lange (2001) podkreślają, że w badaniach konfirmacyjnych korekty są potrzebne zawsze, gdy wyniki wielu testów łączy się w jeden końcowy wniosek. Hipotezy H1–H3 dotyczą trzech różnych zmiennych i każda ma osobny wniosek, dlatego testujemy je bez korekty i piszemy to w metodzie. Pełną listę sytuacji „tak / nie” znajdziesz we wpisie czy stosować poprawkę na wielokrotne porównania, a porównanie metod – w poradniku poprawki na wielokrotne porównania.
Pytania „z ciekawości” to osobna rodzina. W przykładzie promotor chciał wiedzieć, czy kobiety i mężczyźni różnią się w zachowaniach z Tabeli 2. To 16 testów χ² bez hipotez. Armstrong (2014) wskazuje, że korekta jest uzasadniona właśnie wtedy, gdy wykonuje się wiele testów bez wcześniej zaplanowanych hipotez. Przy analizach eksploracyjnych dobrym wyborem jest procedura Benjaminiego–Hochberga. Kontroluje ona oczekiwany odsetek fałszywych odkryć (FDR) i ma większą moc niż metody kontrolujące ryzyko choćby jednego błędu (Benjamini i Hochberg, 1995). Jeśli wolisz ostrzejszą kontrolę, wybierz poprawkę Holma.
Wynik eksploracji: dwie różnice pozostały istotne po korekcie. Napoje energetyczne co najmniej raz w tygodniu piło 19.4% kobiet i 50.9% mężczyzn, a u dentysty w ostatnim roku było 75.7% kobiet i 44.4% mężczyzn (w obu przypadkach skorygowane p < .001). Pozostałe 14 porównań było nieistotne już przed korektą (najmniejsze p = .220). W tym przykładzie obie metody korekty dały ten sam wynik, ale przy słabszych efektach BH zachowałby więcej odkryć niż Holm.
Wagenmakers i in. (2012) piszą, że za konfirmacyjne można uznać tylko analizy zaplanowane przed zobaczeniem danych, a pozostałe trzeba oznaczać jako eksploracyjne. Standardy JARS-Quant także dzielą hipotezy, analizy i wnioski na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018). Wynik eksploracyjny jest tropem do kolejnego badania, a nie potwierdzeniem hipotezy. Nawet jeśli różnica między płciami jest duża, nie przenoś jej do hipotez i nie dopisuj uzasadnienia teoretycznego po fakcie.
Krok 5. Układ rozdziału wyników ankiety
Rozdział wyników ma prowadzić od tego, kogo zbadano, przez to, co badani deklarują, do odpowiedzi na hipotezy. Kolejność wynika z logiki badania, a nie z kolejności pytań w kwestionariuszu. Dla ankiety z wieloma pytaniami sprawdza się taki układ:
| Podrozdział | Co zawiera | Forma |
|---|---|---|
| 4.1. Próba i przygotowanie danych | Liczba ankiet, wykluczenia, braki; charakterystyka próby (jeśli nie ma jej w metodzie) | Akapit i Tabela 1 |
| 4.2. Wyniki skal | Sposób liczenia, M, SD, zakres, rzetelność | Akapit, mała tabela przy kilku skalach |
| 4.3. Odpowiedzi na pytania opisowe | Odsetki z 95% CI, średnie zmiennych liczbowych | Jedna–dwie tabele zbiorcze i jeden wykres |
| 4.4. Weryfikacja hipotez | Każda hipoteza: statystyki opisowe, test, wielkość efektu z CI, zdanie o zgodności z hipotezą | Akapit na hipotezę, tabela przy wielu wynikach |
| 4.5. Analizy eksploracyjne | Liczba testów, korekta, wyniki istotne i informacja o pozostałych | Krótki akapit, wyraźnie oznaczony |
| 4.6. Podsumowanie | Decyzja o każdej hipotezie | Tabela hipotez |
W tym układzie każde z 30 pytań ma swoje miejsce. Żadne nie dostaje jednak osobnego podrozdziału, wykresu kołowego i testu. Rozkłady pojedynczych pytań, których nie ma w tabelach zbiorczych, przenieś do aneksu. Rozdział pozostaje czytelny, a nic nie ginie. Pełny, skomentowany przykład rozdziału wyników (dla badania z grupami i pomiarem przed i po) znajdziesz we wpisie wyniki badań własnych – przykładowy rozdział. Jak cały proces wygląda na surowym eksporcie z formularza, od nagłówków pytań po zdania APA, pokazuje wpis analiza ankiety z Google Forms krok po kroku.
Gotowy szkic: plan analiz i rozdział wyników (APA)
Poniższe akapity opisują przykład z tego wpisu. Potraktuj je jako szkielet: podmień liczby, nazwy zmiennych i hipotezy na własne. Pierwszy akapit należy do podrozdziału „Analiza statystyczna” w metodzie, pozostałe – do rozdziału wyników.
Metoda – plan analiz.
4.3. Odpowiedzi na pytania opisowe.
4.4. Weryfikacja hipotez.
4.5. Analizy eksploracyjne.
Jeśli chcesz, żeby statystyk sprawdził plan analiz przed liczeniem, zajrzyj do oferty analiz statystycznych dla studentów. Decyzje i ich uzasadnienie musisz jednak umieć obronić sam(a).
Najczęstsze błędy
- Test dla każdego pytania i każdej zmiennej z metryczki. Przy 150 testach średnio 7–8 wyników wyjdzie „istotnych” bez żadnego prawdziwego efektu.
- Opis tylko wyników istotnych. Czytelnik nie wie, ile testów wykonano, więc nie może ocenić, ile z nich to przypadek. Zawsze podaj liczbę testów w rodzinie.
- Korekta Bonferroniego na wszystkie testy w pracy naraz. Odbiera moc hipotezom, które były zaplanowane, a nie usuwa problemu złego planu.
- Testy na pojedynczych pozycjach skali. Pozycje skali łączysz w jeden wynik i dopiero ten wynik analizujesz.
- Test χ² zgodności dla pytania opisowego „żeby był jakiś test”. Sprawdzanie, czy odpowiedzi „tak” i „nie” są równie częste, zwykle nie odpowiada na żadne pytanie badawcze. Wystarczy odsetek z przedziałem ufności.
- Trzydzieści wykresów kołowych. Jeden posortowany wykres z przedziałami pokazuje więcej i zajmuje mniej miejsca.
- Wynik eksploracyjny opisany jak potwierdzona hipoteza albo dopisany do hipotez po fakcie.
- Odsetki bez mianownika. Gdy część osób pominęła pytanie, w tabeli musi być n dla każdego wiersza.
Ankieta z wieloma pytaniami w R: kod i wynik
Pierwszy skrypt symuluje 1000 ankiet bez żadnego prawdziwego efektu i liczy w każdej 150 testów. Drugi tworzy przykładową ankietę (zapisuje ją do pliku CSV w folderze nadrzędnym, ../), liczy wynik skali i alfę, tabelę zbiorczą z przedziałami Wilsona, testy hipotez H1–H3, eksplorację z korektą oraz – dla porównania – wszystkie 150 testów. Wystarczają funkcje bazowego R. Rysunki powstały w osobnym skrypcie na tych samych wynikach. Dane do pobrania: ankieta-zachowania-zdrowotne-30-pytan.csv.
1. Symulacja: 150 testów, zero efektów
R
# B429 – 30 pytań × 5 zmiennych z metryczki = 150 testów, gdy żaden efekt nie istnieje
# Każda ankieta: 214 osób; 12 pytań porządkowych 1–5 (10 z nich tworzy skalę), 16 pytań tak/nie,
# 2 pytania liczbowe. Metryczka (płeć, wiek, rok studiów, miejsce zamieszkania, praca) jest
# niezależna od wszystkich pytań, więc każdy „istotny” wynik to fałszywy alarm.
set.seed(4291)
n <- 214; powt <- 1000

jedna_ankieta <- function(n) {
  f <- rnorm(n)                                   # wspólny czynnik pozycji skali (pozycje są skorelowane)
  porz <- sapply(1:12, function(j) {
    z <- if (j <= 10) 0.7 * f + rnorm(n, sd = 0.7) else rnorm(n)
    findInterval(z, c(-1.3, -0.4, 0.4, 1.3)) + 1  # odpowiedzi 1–5
  })
  tn <- sapply(1:16, function(j) rbinom(n, 1, runif(1, 0.15, 0.80)))
  licz <- cbind(round(rnorm(n, 7, 1) * 2) / 2, sample(0:7, n, replace = TRUE))
  metr <- data.frame(plec = factor(sample(c("K", "M"), n, TRUE, prob = c(.73, .27))),
                     wiek = round(rnorm(n, 21.5, 1.8)),
                     rok = factor(sample(c("I", "II", "III"), n, TRUE)),
                     zamieszkanie = factor(sample(c("rodzice", "akademik", "wynajem"), n, TRUE, prob = c(.35, .25, .40))),
                     praca = factor(sample(c("tak", "nie"), n, TRUE, prob = c(.4, .6))))
  list(porz = porz, tn = tn, licz = licz, metr = metr)
}

# test, który student wybrałby dla danej pary zmiennych
test_p <- function(y, typ, x) {
  if (is.numeric(x)) {                            # wiek
    if (typ == "tn") return(wilcox.test(x ~ y, exact = FALSE)$p.value)
    return(cor.test(y, x, method = if (typ == "porz") "spearman" else "pearson", exact = FALSE)$p.value)
  }
  dwie <- nlevels(x) == 2
  if (typ == "tn") return(suppressWarnings(chisq.test(table(y, x), correct = FALSE)$p.value))
  if (typ == "porz") return(if (dwie) wilcox.test(y ~ x, exact = FALSE)$p.value else kruskal.test(y ~ x)$p.value)
  if (dwie) t.test(y ~ x)$p.value else oneway.test(y ~ x)$p.value
}

wszystkie_p <- function(a) {
  pyt <- c(lapply(1:12, function(j) list(a$porz[, j], "porz")),
           lapply(1:16, function(j) list(a$tn[, j], "tn")),
           lapply(1:2, function(j) list(a$licz[, j], "licz")))
  unlist(lapply(pyt, function(q) sapply(a$metr, function(x) test_p(q[[1]], q[[2]], x))))
}

p1 <- wszystkie_p(jedna_ankieta(n))
cat("Liczba testów w jednej ankiecie:", length(p1), "\n")
cat("Jedna ankieta: wyników p < .05 =", sum(p1 < .05), "; najmniejsze p =", sub("^0", "", sprintf("%.3f", min(p1))), "\n\n")

wyn <- t(replicate(powt, {
  p <- wszystkie_p(jedna_ankieta(n))
  c(bez = sum(p < .05), holm = sum(p.adjust(p, "holm") < .05), bh = sum(p.adjust(p, "BH") < .05))
}))

cat("SYMULACJA:", powt, "ankiet, w każdej 150 testów i zero prawdziwych efektów\n")
cat(sprintf("Średnia liczba fałszywych alarmów: %.2f (SD = %.2f; oczekiwana 150 × .05 = 7.5)\n",
            mean(wyn[, "bez"]), sd(wyn[, "bez"])))
cat(sprintf("Dla 150 niezależnych testów SD wynosiłoby %.2f (rozkład dwumianowy)\n", sqrt(150 * .05 * .95)))
cat("Mediana:", median(wyn[, "bez"]), "; 90% ankiet miało od", quantile(wyn[, "bez"], .05),
    "do", quantile(wyn[, "bez"], .95), "fałszywych alarmów\n")
cat(sprintf("Odsetek ankiet z co najmniej 1 / 5 / 10 fałszywymi alarmami: %.1f%% / %.1f%% / %.1f%%\n",
            100 * mean(wyn[, "bez"] >= 1), 100 * mean(wyn[, "bez"] >= 5), 100 * mean(wyn[, "bez"] >= 10)))
cat(sprintf("Po poprawce Holma – co najmniej 1 fałszywy alarm: %.1f%%\n", 100 * mean(wyn[, "holm"] >= 1)))
cat(sprintf("Po procedurze Benjaminiego–Hochberga – co najmniej 1: %.1f%%\n\n", 100 * mean(wyn[, "bh"] >= 1)))
cat("Rozkład liczby fałszywych alarmów (bez poprawki):\n")
print(table(cut(wyn[, "bez"], c(-1, 2, 4, 6, 8, 10, 12, 14, 100),
                labels = c("0–2", "3–4", "5–6", "7–8", "9–10", "11–12", "13–14", "15+"))))
write.csv(data.frame(powtorzenie = 1:powt, wyn), "b429-symulacja.csv", row.names = FALSE)
Wynik w R
Liczba testów w jednej ankiecie: 150
Jedna ankieta: wyników p < .05 = 12 ; najmniejsze p = .001

SYMULACJA: 1000 ankiet, w każdej 150 testów i zero prawdziwych efektów
Średnia liczba fałszywych alarmów: 7.61 (SD = 3.15; oczekiwana 150 × .05 = 7.5)
Dla 150 niezależnych testów SD wynosiłoby 2.67 (rozkład dwumianowy)
Mediana: 7 ; 90% ankiet miało od 3 do 13 fałszywych alarmów
Odsetek ankiet z co najmniej 1 / 5 / 10 fałszywymi alarmami: 99.9% / 85.2% / 25.3%
Po poprawce Holma – co najmniej 1 fałszywy alarm: 4.2%
Po procedurze Benjaminiego–Hochberga – co najmniej 1: 4.3%

Rozkład liczby fałszywych alarmów (bez poprawki):

  0–2   3–4   5–6   7–8  9–10 11–12 13–14   15+
   34   114   240   261   173   113    40    25
2. Przykładowa ankieta: tabela zbiorcza, hipotezy i eksploracja
R
# B429 – ankieta „Zachowania zdrowotne studentów” (dane symulowane): 30 pytań + metryczka (5 zmiennych)
# Plan: skala q01–q10 → jeden wynik; 16 pytań tak/nie → tabela zbiorcza bez testów;
# H1–H3 → po jednym teście; płeć × 16 pytań tak/nie → analiza eksploracyjna z FDR.
set.seed(429)
fp <- function(p) ifelse(p < .001, "< .001", sub("^0", "", sprintf("%.3f", p)))   # zapis p jak w APA
pz <- function(p) ifelse(p < .001, "< .001", paste("=", fp(p))) # „p = .039” albo „p < .001”
n <- 214
d <- data.frame(id = 1:n,
  plec = sample(c("Kobieta", "Mężczyzna", "Inna / wolę nie podawać"), n, TRUE, prob = c(.72, .26, .02)),
  wiek = pmin(pmax(round(rnorm(n, 21.6, 1.9)), 19), 30),
  rok = sample(c("I", "II", "III"), n, TRUE, prob = c(.36, .34, .30)),
  zamieszkanie = sample(c("Z rodzicami", "Akademik", "Wynajem"), n, TRUE, prob = c(.35, .25, .40)),
  praca = sample(c("Tak", "Nie"), n, TRUE, prob = c(.42, .58)))
M <- d$plec == "Mężczyzna"

# q01–q10: skala zachowań prozdrowotnych (1–5), q04 i q08 sformułowane odwrotnie
f <- rnorm(n)
for (j in 1:10) {
  z <- 0.75 * f + rnorm(n, sd = 0.65)
  if (j %in% c(4, 8)) z <- -z
  d[[sprintf("q%02d", j)]] <- findInterval(z, c(-1.4, -0.45, 0.35, 1.25)) + 1
}
# 16 pytań tak/nie (1 = tak); w danych prawdziwe są tylko trzy związki z metryczką
tak <- function(p) rbinom(n, 1, p)
d$q11_sniadanie   <- tak(ifelse(d$zamieszkanie == "Z rodzicami", .70, .50))   # H3
d$q12_papierosy   <- tak(.14)
d$q13_epapierosy  <- tak(.19)
d$q14_alkohol_tydz <- tak(.38)
d$q15_energetyki  <- tak(ifelse(M, .50, .22))                               # różnica płci (prawdziwa)
d$q16_pieszo_rower <- tak(.46)
d$q18_aplikacja   <- tak(.41)
d$q19_dentysta    <- tak(ifelse(M, .48, .72))                               # różnica płci (prawdziwa)
d$q20_badania     <- tak(.33)
d$q21_grypa       <- tak(.12)
d$q22_woda        <- tak(.57)
d$q23_warzywa     <- tak(.44)
d$q24_fastfood    <- tak(.36)
d$q25_ekran       <- tak(.74)
d$q26_pomoc_psych <- tak(.29)
d$q30_mniej_snu   <- tak(.63)
# pytania liczbowe i porządkowe
d$q17_sen_h <- round(pmin(pmax(rnorm(n, ifelse(d$praca == "Tak", 6.6, 7.0), 1.0), 4), 10) * 2) / 2   # H1
d$q27_zdrowie <- findInterval(0.45 * f + rnorm(n, sd = 0.9), c(-1.6, -0.6, 0.4, 1.4)) + 1        # H2
d$q28_stres <- findInterval(rnorm(n), c(-1.3, -0.4, 0.4, 1.3)) + 1
d$q29_dni_aktywnosci <- sample(0:7, n, TRUE, prob = c(.12, .14, .17, .17, .14, .11, .08, .07))
# braki pojedynczych odpowiedzi (0–3% w pytaniu)
tn <- c("q11_sniadanie", "q12_papierosy", "q13_epapierosy", "q14_alkohol_tydz", "q15_energetyki",
        "q16_pieszo_rower", "q18_aplikacja", "q19_dentysta", "q20_badania", "q21_grypa", "q22_woda",
        "q23_warzywa", "q24_fastfood", "q25_ekran", "q26_pomoc_psych", "q30_mniej_snu")
for (v in tn) d[[v]][sample(n, sample(0:6, 1))] <- NA
write.csv(d, "../ankieta-zachowania-zdrowotne-30-pytan.csv", row.names = FALSE, na = "")

cat("1. PRÓBA\n")
cat("N =", n, "; wiek M =", sprintf("%.2f", mean(d$wiek)), ", SD =", sprintf("%.2f", sd(d$wiek)), "\n")
for (v in c("plec", "praca", "zamieszkanie", "rok"))
  print(cbind(n = table(d[[v]]), proc = round(100 * prop.table(table(d[[v]])), 1)))

cat("\n2. SKALA q01–q10: jeden wynik zamiast 10 pytań\n")
poz <- d[, sprintf("q%02d", 1:10)]
poz$q04 <- 6 - poz$q04; poz$q08 <- 6 - poz$q08
k <- ncol(poz)
alfa <- k / (k - 1) * (1 - sum(apply(poz, 2, var)) / var(rowSums(poz)))
d$skala <- rowMeans(poz)
cat(sprintf("alfa Cronbacha = %.2f; wynik skali M = %.2f, SD = %.2f, zakres %.1f–%.1f\n",
            alfa, mean(d$skala), sd(d$skala), min(d$skala), max(d$skala)))

cat("\n3. TABELA ZBIORCZA: 16 pytań tak/nie, % z 95% CI Wilsona (bez testów)\n")
etyk <- c("Codzienne śniadanie", "Palenie papierosów", "E-papierosy", "Alkohol co najmniej raz w tygodniu",
          "Napoje energetyczne co najmniej raz w tygodniu", "Dojazd pieszo lub rowerem",
          "Aplikacja do monitorowania zdrowia", "Wizyta u dentysty w ostatnim roku",
          "Badania krwi w ostatnim roku", "Szczepienie przeciw grypie w ostatnim sezonie",
          "Co najmniej 1.5 l wody dziennie", "Warzywa codziennie", "Fast food co najmniej raz w tygodniu",
          "Ekran ponad godzinę przed snem", "Kontakt z pomocą psychologiczną (kiedykolwiek)",
          "Skracanie snu z powodu nauki (ostatni miesiąc)")
tab <- do.call(rbind, lapply(seq_along(tn), function(i) {
  x <- d[[tn[i]]]; nn <- sum(!is.na(x)); k1 <- sum(x, na.rm = TRUE)
  ci <- prop.test(k1, nn, correct = FALSE)$conf.int            # przedział Wilsona
  data.frame(pytanie = etyk[i], n = nn, tak = k1, proc = round(100 * k1 / nn, 1),
             ci_d = round(100 * ci[1], 1), ci_g = round(100 * ci[2], 1))
}))
tab <- tab[order(-tab$proc), ]; rownames(tab) <- NULL
print(tab)
write.csv(tab, "b429-tabela-zbiorcza.csv", row.names = FALSE)

cat("\nZmienne liczbowe i porządkowe (M, SD, Me)\n")
for (v in c("q17_sen_h", "q29_dni_aktywnosci", "q27_zdrowie", "q28_stres"))
  cat(sprintf("%-20s M = %.2f, SD = %.2f, Me = %.1f\n", v, mean(d[[v]]), sd(d[[v]]), median(d[[v]])))

cat("\n4. HIPOTEZY (trzy osobne hipotezy, każda jednym testem; bez poprawki)\n")
h1 <- t.test(q17_sen_h ~ praca, data = d)                       # Welch
m <- tapply(d$q17_sen_h, d$praca, mean); s <- tapply(d$q17_sen_h, d$praca, sd); nn <- table(d$praca)
sp <- sqrt(((nn[1] - 1) * s[1]^2 + (nn[2] - 1) * s[2]^2) / (sum(nn) - 2))
dc <- unname((m["Nie"] - m["Tak"]) / sp)
se_d <- sqrt(sum(nn) / prod(nn) + dc^2 / (2 * sum(nn)))
cat(sprintf("H1 sen: pracujący M = %.2f (SD = %.2f, n = %d), niepracujący M = %.2f (SD = %.2f, n = %d)\n",
            m["Tak"], s["Tak"], nn["Tak"], m["Nie"], s["Nie"], nn["Nie"]))
cat(sprintf("   t(%.2f) = %.2f, p %s, różnica = %.2f h, 95%% CI [%.2f, %.2f], d = %.2f, 95%% CI [%.2f, %.2f]\n",
            h1$parameter, abs(h1$statistic), pz(h1$p.value),
            m["Nie"] - m["Tak"], h1$conf.int[1], h1$conf.int[2], dc, dc - 1.96 * se_d, dc + 1.96 * se_d))
h2 <- cor.test(d$skala, d$q27_zdrowie, method = "spearman", exact = FALSE)
cat(sprintf("H2 skala a samoocena zdrowia: rho = %.2f, p %s, n = %d\n", h2$estimate, pz(h2$p.value), n))
grupa3 <- ifelse(d$zamieszkanie == "Z rodzicami", "Z rodzicami", "Poza domem")
t3 <- table(grupa3, d$q11_sniadanie)
h3 <- chisq.test(t3, correct = FALSE)
pr <- prop.table(t3, 1)[, "1"]
cat(sprintf("H3 śniadanie: z rodzicami %.1f%% (%d/%d), poza domem %.1f%% (%d/%d)\n",
            100 * pr["Z rodzicami"], t3["Z rodzicami", "1"], sum(t3["Z rodzicami", ]),
            100 * pr["Poza domem"], t3["Poza domem", "1"], sum(t3["Poza domem", ])))
cat(sprintf("   chi2(1, N = %d) = %.2f, p %s, phi = %.2f\n", sum(t3), h3$statistic, pz(h3$p.value),
            sqrt(h3$statistic / sum(t3))))

cat("\n5. ANALIZA EKSPLORACYJNA: płeć × 16 pytań tak/nie, korekta Benjaminiego–Hochberga\n")
km <- d$plec != "Inna / wolę nie podawać"
eks <- do.call(rbind, lapply(seq_along(tn), function(i) {
  t2 <- table(d$plec[km], d[[tn[i]]][km])
  data.frame(pytanie = etyk[i], K = round(100 * prop.table(t2, 1)["Kobieta", "1"], 1),
             M = round(100 * prop.table(t2, 1)["Mężczyzna", "1"], 1),
             p = suppressWarnings(chisq.test(t2, correct = FALSE)$p.value))
}))
eks$p_BH <- p.adjust(eks$p, "BH"); eks$p_Holm <- p.adjust(eks$p, "holm")
eks <- eks[order(eks$p), ]; rownames(eks) <- NULL
cat("p < .05 bez korekty:", sum(eks$p < .05), "; po BH:", sum(eks$p_BH < .05), "; po Holmie:", sum(eks$p_Holm < .05), "\n")
eks[c("p", "p_BH", "p_Holm")] <- lapply(eks[c("p", "p_BH", "p_Holm")], fp)
print(head(eks, 6))

cat("\n6. GDYBY POLICZYĆ WSZYSTKO: 30 pytań × 5 zmiennych z metryczki\n")
pyt <- c(sprintf("q%02d", 1:10), tn, "q17_sen_h", "q27_zdrowie", "q28_stres", "q29_dni_aktywnosci")
typ <- c(rep("porz", 10), rep("tn", 16), "licz", "porz", "porz", "licz")
metr <- data.frame(plec = factor(ifelse(km, d$plec, NA)), wiek = d$wiek, rok = factor(d$rok),
                   zamieszkanie = factor(d$zamieszkanie), praca = factor(d$praca))
test_p <- function(y, typ, x) {
  if (is.numeric(x)) {
    if (typ == "tn") return(wilcox.test(x ~ y, exact = FALSE)$p.value)
    return(cor.test(y, x, method = if (typ == "porz") "spearman" else "pearson", exact = FALSE)$p.value)
  }
  dwie <- nlevels(x) == 2
  if (typ == "tn") return(suppressWarnings(chisq.test(table(y, x), correct = FALSE)$p.value))
  if (typ == "porz") return(if (dwie) wilcox.test(y ~ x, exact = FALSE)$p.value else kruskal.test(y ~ x)$p.value)
  if (dwie) t.test(y ~ x)$p.value else oneway.test(y ~ x)$p.value
}
wsz <- expand.grid(metr = names(metr), pytanie = pyt, stringsAsFactors = FALSE)
wsz$p <- mapply(function(q, m) test_p(d[[q]], typ[match(q, pyt)], metr[[m]]), wsz$pytanie, wsz$metr)
prawdziwe <- paste(c("q11_sniadanie", "q15_energetyki", "q19_dentysta", "q17_sen_h"),
                   c("zamieszkanie", "plec", "plec", "praca"))
wsz$prawdziwy <- paste(wsz$pytanie, wsz$metr) %in% prawdziwe
ist <- wsz[wsz$p < .05, ]; ist <- ist[order(ist$p), ]; ist$p <- fp(ist$p); rownames(ist) <- NULL
cat("Testów:", nrow(wsz), "; p < .05:", nrow(ist), "; w tym prawdziwych związków:", sum(ist$prawdziwy),
    "; fałszywych alarmów:", sum(!ist$prawdziwy), "\n")
print(ist)
cat("Po korekcie BH dla wszystkich 150 testów istotne:", sum(p.adjust(wsz$p, "BH") < .05), "\n")
Wynik w R
1. PRÓBA
N = 214 ; wiek M = 21.79 , SD = 1.81
                          n proc
Inna / wolę nie podawać   4  1.9
Kobieta                 155 72.4
Mężczyzna                55 25.7
      n proc
Nie 122   57
Tak  92   43
             n proc
Akademik    60 28.0
Wynajem     72 33.6
Z rodzicami 82 38.3
     n proc
I   77 36.0
II  66 30.8
III 71 33.2

2. SKALA q01–q10: jeden wynik zamiast 10 pytań
alfa Cronbacha = 0.92; wynik skali M = 3.03, SD = 0.81, zakres 1.0–5.0

3. TABELA ZBIORCZA: 16 pytań tak/nie, % z 95% CI Wilsona (bez testów)
                                          pytanie   n tak proc ci_d ci_g
1                  Ekran ponad godzinę przed snem 209 151 72.2 65.8 77.9
2               Wizyta u dentysty w ostatnim roku 210 142 67.6 61.0 73.6
3  Skracanie snu z powodu nauki (ostatni miesiąc) 211 134 63.5 56.8 69.7
4                 Co najmniej 1.5 l wody dziennie 208 131 63.0 56.2 69.3
5                             Codzienne śniadanie 211 127 60.2 53.5 66.6
6                              Warzywa codziennie 210  95 45.2 38.7 52.0
7                       Dojazd pieszo lub rowerem 210  89 42.4 35.9 49.1
8              Alkohol co najmniej raz w tygodniu 212  84 39.6 33.3 46.3
9  Kontakt z pomocą psychologiczną (kiedykolwiek) 209  72 34.4 28.3 41.1
10                   Badania krwi w ostatnim roku 211  71 33.6 27.6 40.3
11           Fast food co najmniej raz w tygodniu 210  70 33.3 27.3 40.0
12             Aplikacja do monitorowania zdrowia 208  67 32.2 26.2 38.8
13 Napoje energetyczne co najmniej raz w tygodniu 214  61 28.5 22.9 34.9
14  Szczepienie przeciw grypie w ostatnim sezonie 209  35 16.7 12.3 22.4
15                                    E-papierosy 211  34 16.1 11.8 21.7
16                             Palenie papierosów 211  27 12.8  8.9 18.0

Zmienne liczbowe i porządkowe (M, SD, Me)
q17_sen_h            M = 6.91, SD = 0.98, Me = 7.0
q29_dni_aktywnosci   M = 2.98, SD = 2.12, Me = 3.0
q27_zdrowie          M = 3.06, SD = 0.95, Me = 3.0
q28_stres            M = 3.02, SD = 1.17, Me = 3.0

4. HIPOTEZY (trzy osobne hipotezy, każda jednym testem; bez poprawki)
H1 sen: pracujący M = 6.76 (SD = 0.96, n = 92), niepracujący M = 7.03 (SD = 0.98, n = 122)
   t(199.01) = 2.07, p = .039, różnica = 0.28 h, 95% CI [0.01, 0.54], d = 0.29, 95% CI [0.01, 0.56]
H2 skala a samoocena zdrowia: rho = 0.27, p < .001, n = 214
H3 śniadanie: z rodzicami 75.6% (62/82), poza domem 50.4% (65/129)
   chi2(1, N = 211) = 13.31, p < .001, phi = 0.25

5. ANALIZA EKSPLORACYJNA: płeć × 16 pytań tak/nie, korekta Benjaminiego–Hochberga
p < .05 bez korekty: 2 ; po BH: 2 ; po Holmie: 2
                                         pytanie    K    M      p   p_BH p_Holm
1 Napoje energetyczne co najmniej raz w tygodniu 19.4 50.9 < .001 < .001 < .001
2              Wizyta u dentysty w ostatnim roku 75.7 44.4 < .001 < .001 < .001
3 Kontakt z pomocą psychologiczną (kiedykolwiek) 36.4 27.3   .220   .979  1.000
4  Szczepienie przeciw grypie w ostatnim sezonie 15.1 20.8   .343   .979  1.000
5             Alkohol co najmniej raz w tygodniu 41.6 35.2   .411   .979  1.000
6 Skracanie snu z powodu nauki (ostatni miesiąc) 62.3 67.9   .465   .979  1.000

6. GDYBY POLICZYĆ WSZYSTKO: 30 pytań × 5 zmiennych z metryczki
Testów: 150 ; p < .05: 12 ; w tym prawdziwych związków: 4 ; fałszywych alarmów: 8
           metr            pytanie      p prawdziwy
1          plec     q15_energetyki < .001      TRUE
2          plec       q19_dentysta < .001      TRUE
3  zamieszkanie      q11_sniadanie   .001      TRUE
4          wiek     q13_epapierosy   .032     FALSE
5           rok      q30_mniej_snu   .033     FALSE
6         praca          q17_sen_h   .039      TRUE
7  zamieszkanie q29_dni_aktywnosci   .041     FALSE
8          plec        q27_zdrowie   .041     FALSE
9         praca        q27_zdrowie   .042     FALSE
10 zamieszkanie      q30_mniej_snu   .047     FALSE
11 zamieszkanie                q02   .048     FALSE
12         wiek          q25_ekran   .049     FALSE
Po korekcie BH dla wszystkich 150 testów istotne: 2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz rozdział wyników ankiety, sprawdź…
- Czy każde pytanie ankiety ma przypisaną rolę: metryczka, pozycja skali, pytanie opisowe, zmienna z hipotezy albo eksploracja?
- Czy liczba testów wynika z hipotez, a nie z liczby pytań razy liczba zmiennych w metryczce?
- Czy pytania opisowe są w tabeli zbiorczej z n, odsetkiem i 95% przedziałem ufności, posortowanej malejąco?
- Czy pozycje skali są połączone w jeden wynik z podaną rzetelnością?
- Czy przy każdej hipotezie jest test, dokładne p i wielkość efektu z przedziałem ufności?
- Czy w metodzie napisałeś(-aś), czy i dlaczego stosujesz korektę na wielokrotne testowanie?
- Czy analizy eksploracyjne są w osobnym podrozdziale, z liczbą testów, korektą i zastrzeżeniem, że wymagają potwierdzenia?
- Czy pełne rozkłady pozostałych pytań są w aneksie zamiast w kilkudziesięciu wykresach kołowych?
Najczęstsze pytania
Czy w pracy dyplomowej trzeba policzyć test dla każdego pytania ankiety?
Nie. Test odpowiada na pytanie o różnicę albo związek, więc liczysz go tylko tam, gdzie takie pytanie postawiłeś w hipotezie. Pytania opisowe („jak często…”, „ile osób…”) opisujesz odsetkiem z 95% przedziałem ufności, a pozycje skali łączysz w jeden wynik. W przykładzie z tego wpisu 30 pytań dało 3 testy hipotez i 16 testów eksploracyjnych zamiast 150.
Ile fałszywie istotnych wyników daje 150 testów na poziomie .05?
Średnio około 7.5, bo 150 × .05 = 7.5. W symulacji 1000 ankiet bez żadnego prawdziwego efektu średnia wyniosła 7.6, a w 90% ankiet było od 3 do 13 „istotnych” wyników. Co najmniej jeden fałszywy alarm pojawił się w 99.9% ankiet, więc pojedyncze p < .05 wyłowione z takiej serii niczego nie dowodzi.
Czy można dać poprawkę Bonferroniego na wszystkie testy z ankiety naraz?
Można, ale zwykle to zły pomysł. Korekta wszystkich 150 testów chroni przed fałszywymi alarmami, lecz zabiera moc testom, które naprawdę wynikają z hipotez – w przykładzie po korekcie zniknął prawdziwy efekt dla H1. Lepiej ograniczyć liczbę testów planem, hipotezy testować bez korekty (każda to osobny wniosek), a korektę zastosować do rodziny analiz eksploracyjnych.
Jak przedstawić odpowiedzi na kilkanaście pytań tak/nie w rozdziale wyników?
W jednej tabeli zbiorczej: pytanie, liczba osób, które odpowiedziały, odsetek odpowiedzi „tak” i 95% przedział ufności, wiersze posortowane malejąco. Zamiast kilkunastu wykresów kołowych wystarczy jeden wykres punktowy z przedziałami. W nocie podaj mianownik i metodę przedziału (np. Wilsona).
Gdzie w pracy opisać wyniki, których nie było w hipotezach?
W osobnym, ostatnim podrozdziale wyników, zatytułowanym np. „Analizy eksploracyjne”. Napisz, ile testów wykonano, jaką korektę zastosowano i że wyniki wymagają potwierdzenia w kolejnym badaniu. Nie przenoś ich do hipotez – to byłby HARKing.
Powiązane hasła
Przeczytaj też
Analiza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikCzy muszę stosować poprawkę?
Kiedy poprawka na wielokrotne porównania jest potrzebna, a kiedy nie: rodzina testów, tabela tak/nie, przykład w R i wzór uzasadnienia w pracy.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikAnaliza ankiety z Google Forms krok po kroku
Od surowego CSV do zdań APA: słownik zmiennych, kontrola jakości, przekodowanie pytań, tabela próby i trzy hipotezy w R.
Czytaj →Masz ankietę z kilkudziesięcioma pytaniami i nie wiesz, co policzyć?
Pomożemy przypisać pytania do hipotez, ułożyć plan analiz i tabele zbiorcze, policzymy testy w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Armstrong, R. A. (2014). When to use the Bonferroni correction. Ophthalmic and Physiological Optics, 34(5), 502–508. https://doi.org/10.1111/opo.12131
- Bender, R., & Lange, S. (2001). Adjusting for multiple testing—When and how? Journal of Clinical Epidemiology, 54(4), 343–349. https://doi.org/10.1016/S0895-4356(00)00314-0
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Rubin, M. (2021). When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing. Synthese, 199(3–4), 10969–11000. https://doi.org/10.1007/s11229-021-03276-4 ● Otwarty dostęp: pełny tekst
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wagenmakers, E.-J., Wetzels, R., Borsboom, D., van der Maas, H. L. J., & Kievit, R. A. (2012). An agenda for purely confirmatory research. Perspectives on Psychological Science, 7(6), 632–638. https://doi.org/10.1177/1745691612463078
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{armstrong2014when, author={Armstrong, Richard A.}, title={{When to use the Bonferroni correction}}, journal={Ophthalmic and Physiological Optics}, year={2014}, volume={34}, number={5}, pages={502--508}, doi={10.1111/opo.12131}}@article{bender2001adjusting, author={Bender, Ralf and Lange, Stefan}, title={{Adjusting for multiple testing—When and how?}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={4}, pages={343--349}, doi={10.1016/s0895-4356(00)00314-0}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{rubin2021when, author={Rubin, Mark}, title={{When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing}}, journal={Synthese}, year={2021}, volume={199}, number={3–4}, pages={10969--11000}, doi={10.1007/s11229-021-03276-4}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wagenmakers2012agenda, author={Wagenmakers, Eric-Jan and Wetzels, Ruud and Borsboom, Denny and van der Maas, Han L. J. and Kievit, Rogier A.}, title={{An agenda for purely confirmatory research}}, journal={Perspectives on Psychological Science}, year={2012}, volume={7}, number={6}, pages={632--638}, doi={10.1177/1745691612463078}}