Co pokazać przy pytaniach na skali Likerta
W ankiecie do pracy dyplomowej zwykle jest kilka lub kilkanaście stwierdzeń z odpowiedziami od „zdecydowanie się nie zgadzam” do „zdecydowanie się zgadzam”. Jeśli tworzą rzetelną skalę, liczysz z nich wynik (zob. skala Likerta). Promotor i czytelnik chcą jednak wiedzieć także, jak ludzie odpowiadali na poszczególne pytania. Ten wpis dotyczy właśnie raportu z pojedynczych pozycji: tabeli odsetków, wykresu rozbieżnego i porównania grup.
Pojedyncza pozycja to skala porządkowa. Sullivan i Artino (2013) zalecają opisywać ją rozkładem częstości i medianą. Średnia z jednego pytania ukrywa kształt odpowiedzi. Kiedy średnia ma sens, a kiedy nie, omawia wpis skala Likerta: średnia czy mediana. Tu zakładamy, że pokazujesz odsetki, i skupiamy się na tym, jak zrobić to czytelnie.
W dobrym raporcie z pozycji Likerta są trzy elementy:
- tabela odsetków wszystkich kategorii, z liczebnością i odsetkiem „nie wiem”;
- wykres rozbieżny, który pokazuje wszystkie pozycje naraz;
- jedno-dwa zdania w tekście o najważniejszych wynikach, z odsetkiem zgody i, gdy trzeba, z przedziałem ufności.
Przykład: opinie o zajęciach online
W badaniu symulowanym 240 osób studiujących (140 na studiach stacjonarnych i 100 na niestacjonarnych) oceniło sześć stwierdzeń o zajęciach online na skali 1–5. Ankieta miała też odpowiedź „nie wiem”, zakodowaną jako 9. Najczęściej wybierano ją przy stwierdzeniu o odpowiedziach prowadzących na pytania z czatu: 33 osoby, czyli 13.8%. Część osób po prostu nie zadawała pytań na czacie.
Tabela odsetków krok po kroku
Mianownik: od czego liczysz procenty
Najpierw zdecyduj, od jakiej liczby osób liczysz odsetki, i napisz to w nocie. „Nie wiem” to brak opinii, a nie środek skali. Dlatego nie koduj go jako 3 i nie wliczaj do kategorii 1–5 (zob. odpowiedź „nie wiem” i „trudno powiedzieć”). Krosnick (1991) zalicza tę odpowiedź do strategii satysfakcjonowania. Wysoki odsetek „nie wiem” bywa więc informacją o samym pytaniu i trzeba go podać osobno.
Różnica nie jest kosmetyczna. Ze stwierdzeniem o odpowiedziach z czatu zgodziło się 59.9% spośród 207 osób, które udzieliły odpowiedzi merytorycznej. Ta sama liczba osób to tylko 51.7% wszystkich 240 badanych. Oba odsetki są poprawne, ale odpowiadają na różne pytania. Wybierz jeden mianownik dla całej tabeli i trzymaj się go.
Zaokrąglenia i łączenie kategorii
Odsetki podawaj z jednym miejscem po przecinku, z kropką dziesiętną, tak jak inne wyniki. Zasady zapisu liczb i statystyk opisuje rozdział 6 podręcznika APA (American Psychological Association, 2020). Po zaokrągleniu suma wiersza może wynieść 99.9 albo 100.1. Nie poprawiaj wtedy ręcznie żadnej komórki. Wystarczy zdanie w nocie, że różnice wynikają z zaokrągleń. W przykładzie sumy wyszły równo 100.
W tekście wygodnie jest łączyć kategorie: „zgoda” to odpowiedzi 4 i 5, „niezgoda” – 1 i 2. W tabeli pokaż jednak wszystkie pięć kategorii. Sam odsetek zgody nie mówi, ile osób wybrało środek, a ile się nie zgadzało. Uporządkuj wiersze według odsetka zgody, a nie według kolejności w ankiecie. Wtedy od razu widać, co oceniano najlepiej, a co najgorzej. Jeśli interesuje Cię tylko najwyższa kategoria, czyli odsetek „top-box”, zajrzyj do analizy ankiety satysfakcji pacjentów.
Tabela 1
Rozkład odpowiedzi na stwierdzenia o zajęciach online (odsetki)
| Stwierdzenie | n | 1 | 2 | 3 | 4 | 5 | Nie wiem | Zgoda (4–5) |
|---|---|---|---|---|---|---|---|---|
| Nagrania zajęć pomagają mi w nauce | 233 | 1.3 | 4.7 | 15.0 | 39.5 | 39.5 | 2.9 | 79.0 |
| Materiały z zajęć są udostępniane na czas | 232 | 2.6 | 12.9 | 22.0 | 31.5 | 31.0 | 3.3 | 62.5 |
| Prowadzący odpowiadają na pytania z czatu | 207 | 2.4 | 16.9 | 20.8 | 43.5 | 16.4 | 13.8 | 59.9 |
| Wolę zajęcia online od stacjonarnych | 234 | 7.7 | 20.1 | 23.9 | 32.9 | 15.4 | 2.5 | 48.3 |
| Platforma e-learningowa działa sprawnie | 222 | 6.8 | 20.3 | 27.9 | 34.2 | 10.8 | 7.5 | 45.0 |
| Na zajęciach online łatwo mi się skupić | 237 | 11.8 | 26.2 | 35.4 | 22.8 | 3.8 | 1.2 | 26.6 |
Uwaga. N = 240. Odpowiedzi: 1 = zdecydowanie się nie zgadzam, 2 = raczej się nie zgadzam, 3 = ani się zgadzam, ani się nie zgadzam, 4 = raczej się zgadzam, 5 = zdecydowanie się zgadzam. Odsetki 1–5 i zgody liczono od n odpowiedzi merytorycznych; odsetek „nie wiem” – od wszystkich 240 osób. Stwierdzenia uporządkowano według odsetka zgody. Dane symulowane.
Tabela 1 pokazuje, że najwięcej zgody zebrało stwierdzenie o nagraniach zajęć (79.0%, Me = 4), a najmniej – o łatwości skupienia na zajęciach online (26.6%). Przy tym drugim 38.0% osób się nie zgadzało, a 35.4% wybrało środek skali. Mediana wyniosła 3. Jeśli chcesz podać precyzję odsetka, dodaj przedział ufności dla proporcji. Brown i in. (2001) pokazali, że prosty przedział Walda ma zawodne pokrycie, i zalecają m.in. przedział Wilsona. Dla nagrań zajęć daje on 79.0%, 95% CI [73.3, 83.7]. Ogólne zasady budowy takich tabel znajdziesz we wpisie tabele APA – wzory.
Jak działa wykres rozbieżny
Zwykły skumulowany wykres słupkowy zaczyna każdy słupek od zera. Przy kilku pozycjach trudno wtedy porównać środkowe kategorie, bo każda zaczyna się w innym miejscu. Wykres rozbieżny (ang. diverging stacked bar chart) ustawia słupki wokół wspólnej linii zera. Niezgoda leży po lewej stronie, zgoda po prawej. Heiberger i Robbins (2014) zalecają go jako podstawowy sposób prezentacji skal Likerta. Wspólna linia zera pozwala porównać pozycje jednym spojrzeniem.
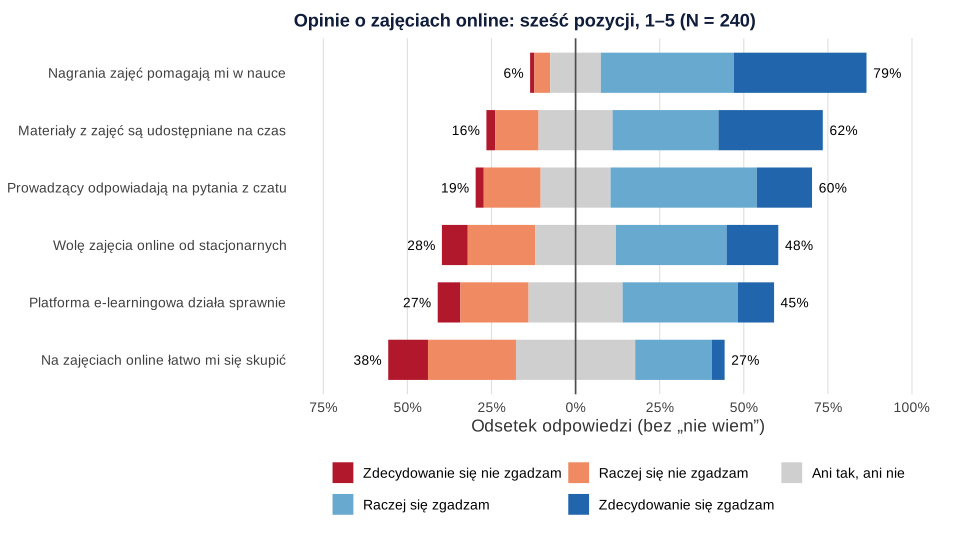
Przy budowie wykresu masz do podjęcia cztery decyzje:
- Środek skali. Na rysunku 1 kategoria „ani tak, ani nie” jest podzielona po połowie między obie strony, jak u Heibergera i Robbinsa (2014). Druga możliwość to osobny słupek z prawej strony wykresu. Jest czytelniejsza, gdy środek wybiera bardzo dużo osób.
- Kolejność pozycji. Sortuj według odsetka zgody, tak jak w tabeli. Kolejność z ankiety jest przypadkowa dla czytelnika.
- Kolory. Użyj palety rozbieżnej: dwa odcienie jednego koloru dla niezgody, dwa odcienie drugiego dla zgody i szary środek. Unikaj pary czerwony–zielony. Crameri i in. (2020) pokazują, że takie zestawienia są nieczytelne dla osób z zaburzeniami widzenia barw i zniekształcają odbiór danych. Rysunek 1 używa czerwieni dla niezgody, błękitu dla zgody i szarości dla środka.
- Etykiety. Na końcach słupków podaj łączne odsetki niezgody i zgody, zaokrąglone do całości. Dokładne wartości są w tabeli, więc na wykresie nie powtarzaj każdej komórki.
Odpowiedzi „nie wiem” nie umieszczaj na osi zgody. Podaj je w tabeli albo jako osobny mały słupek obok wykresu. Inne typy wykresów i ich zastosowania porządkuje wpis wykresy w pracy dyplomowej.
Wykres rozbieżny w ggplot2: cztery kroki
Gotowe funkcje do takich wykresów mają pakiety R, np. HH, w którym rozwiązanie pokazują Heiberger i Robbins (2014). Nie są jednak potrzebne. W samym ggplot2 cały wykres to kilkanaście linii, a każdy krok masz pod kontrolą. Pełny kod jest w sekcji R poniżej (krok 4 w kodzie). Logika jest następująca:
- Odsetki w formacie długim. Dla każdej pozycji policz odsetki kategorii 1–5 bez „nie wiem”. Jeden wiersz to jedna kategoria jednej pozycji.
- Znak minus dla niezgody. Kategorie 1 i 2 dostają wartości ujemne. Kategorię 3 rozbij na dwa wiersze: połowa z minusem, połowa z plusem.
- Kolejność układania. ggplot2 układa słupki ujemne i dodatnie osobno, od zera na zewnątrz. Zmienna
segmento poziomach 3a, 2, 1, 3b, 4, 5 iposition_stack(reverse = TRUE)sprawiają, że przy zerze leży środek, a skrajne odpowiedzi trafiają na końce. Kolor zależy od odpowiedzi (fill = odp), więc obie połówki środka mają ten sam szary kolor. - Oś i opisy. Etykiety osi pokazują wartości bezwzględne (
abs(x)), żeby po lewej nie było „−25%”. Pozycje mają poziomy czynnika w kolejności odsetka zgody, a łączne odsetki dopisujegeom_text().
Ten sam schemat działa przy skali 1–7: kategorie 1–3 są ujemne, 4 dzielisz na pół, a 5–7 są dodatnie. Przy parzystej liczbie kategorii, np. 1–4, nie ma czego dzielić. O wyborze liczby punktów skali pisze wpis ile stopni skali Likerta wybrać.
Porównanie grup: wykres i test
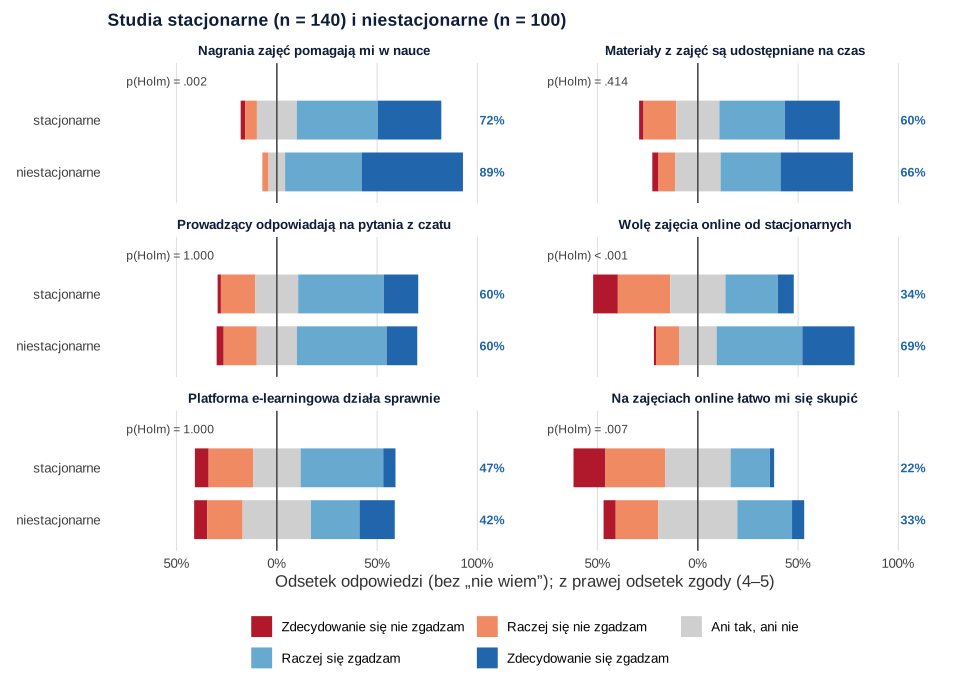
Najprostszy wykres dla dwóch grup to dwa słupki rozbieżne dla każdej pozycji, jeden pod drugim (rysunek 2). Od razu widać, gdzie grupy się rozjeżdżają, a gdzie odpowiadają prawie tak samo.
Do testu potrzebujesz metody, która uwzględnia porządek odpowiedzi. Dla dwóch grup zwykle jest to test Manna–Whitneya z korelacją rangowo-dwuseryjną jako wielkością efektu. Dla trzech i więcej grup – test Kruskala–Wallisa (zob. testy nieparametryczne krok po kroku). Test chi-kwadrat na tabeli 2 × 5 też jest możliwy, ale traktuje kategorie jak nazwy i pomija ich kolejność (zob. test chi-kwadrat krok po kroku). Gdy chcesz uwzględnić inne zmienne, np. wiek, użyj regresji porządkowej. Liddell i Kruschke (2018) pokazują, że modele metryczne zastosowane do danych porządkowych mogą dawać fałszywe alarmy, a nawet odwracać kierunek efektu.
Sześć pozycji to sześć testów, więc szansa na co najmniej jeden fałszywy alarm rośnie (zob. problem wielokrotnych porównań). W przykładzie zastosowaliśmy poprawkę Holma (Holm, 1979). Kontroluje ona ten błąd tak samo jak korekta Bonferroniego, ale ma większą moc. Kiedy poprawka jest potrzebna, a kiedy nie, wyjaśnia wpis czy muszę stosować poprawkę na wielokrotne porównania.
Największa różnica dotyczyła preferencji zajęć online. Zgodziło się z nią 68.8% osób niestacjonarnych i 34.1% stacjonarnych (Me = 4 wobec 3), U = 3777.0, p < .001, pHolm < .001, rrb = .43, 95% CI [.30, .54]. Różnica odsetków zgody wyniosła 34.7 punktu procentowego, 95% CI [21.9, 45.9]. Przedział policzono metodą Newcombe'a (1998), która łączy przedziały Wilsona dla obu grup. Więcej o różnicy odsetków piszemy we wpisie jak porównać odsetki w dwóch grupach.
Osoby niestacjonarne częściej zgadzały się też ze stwierdzeniem o nagraniach zajęć (88.7% wobec 72.1%; pHolm = .002, rrb = .25, 95% CI [.11, .39]) i o łatwości skupienia (33.3% wobec 21.7%; pHolm = .007, rrb = .23, 95% CI [.08, .36]). W tym drugim przypadku mediana wyniosła 3 w obu grupach. Test rangowy wykrył jednak przesunięcie całego rozkładu. To kolejny powód, by przy pozycjach Likerta nie raportować samych median. Przy pozostałych trzech stwierdzeniach różnice nie były istotne. Przykładowo przy odpowiedziach z czatu zgoda wyniosła 60.0% i 59.8%, pHolm = 1.000, rrb = −.02, 95% CI [−.18, .14].
Jak opisać odpowiedzi Likerta w pracy
Pierwszy wzór opisuje rozkład odpowiedzi i odsyła do tabeli. Drugi opisuje porównanie grup. W nawiasach kwadratowych wpisz dane własnego badania. Więcej gotowych zdań znajdziesz we wpisie jak opisać wyniki w stylu APA.
Pod rysunkiem napisz, jak liczono odsetki i co oznaczają liczby na końcach słupków. Czytelnik nie powinien zgadywać, czy „79%” to odsetek odpowiedzi 5, czy łączny odsetek 4 i 5.
Odsetki i wykres rozbieżny w R
Kod odtwarza wszystkie liczby z tekstu, tabelę 1 i rysunek 1 (obiekt wyk1; na stronie dodano tylko motyw graficzny serwisu). Wykres powstaje w samym pakiecie ggplot2, bez dodatkowych pakietów do skal Likerta. Przedziały ufności dla odsetka i różnicy odsetków liczy pakiet DescTools, a korelację rangowo-dwuseryjną – pakiet effectsize.
Pozycje Likerta: tabela, wykres rozbieżny, porównanie grup
R
# B213: odpowiedzi na pozycje Likerta w raporcie – odsetki, wykres rozbieżny i porównanie grup
# (dane symulowane, set.seed(2130)). 240 osób studiujących: stacjonarne (n = 140) i niestacjonarne (n = 100).
# Sześć stwierdzeń o zajęciach online, odpowiedzi 1–5 (1 = zdecydowanie się nie zgadzam,
# 5 = zdecydowanie się zgadzam) oraz 9 = „nie wiem” (osobny kod, w analizie brak danych).
suppressPackageStartupMessages({ library(ggplot2); library(effectsize); library(DescTools) })
set.seed(2130)
n <- c(stacjonarne = 140, niestacjonarne = 100)
tryb <- factor(rep(names(n), n), levels = names(n))
tresc <- c(p1 = "Nagrania zajęć pomagają mi w nauce",
           p2 = "Na zajęciach online łatwo mi się skupić",
           p3 = "Prowadzący odpowiadają na pytania z czatu",
           p4 = "Wolę zajęcia online od stacjonarnych",
           p5 = "Platforma e-learningowa działa sprawnie",
           p6 = "Materiały z zajęć są udostępniane na czas")
polozenie <- c(0.9, -0.5, 0.3, -0.3, 0.1, 0.6)    # ogólny poziom zgody z pozycją
efekt <- c(0.5, 0.3, 0.0, 0.8, 0.0, 0.1)          # przesunięcie u osób niestacjonarnych
nie_wiem <- c(0.02, 0.02, 0.12, 0.03, 0.08, 0.04) # szansa odpowiedzi „nie wiem”
ogolna <- rnorm(sum(n))                            # wspólna postawa wobec zajęć online
dane <- data.frame(tryb)
for (j in 1:6) {
  x <- polozenie[j] + efekt[j] * (tryb == "niestacjonarne") + 0.6 * ogolna + rnorm(sum(n), sd = 0.9)
  odp <- as.integer(cut(x, c(-Inf, -1.6, -0.6, 0.2, 1.3, Inf)))
  odp[runif(sum(n)) < nie_wiem[j]] <- 9L
  dane[[names(tresc)[j]]] <- odp
}
poz <- names(tresc)

# 1. Kontrola kodów i odsetek „nie wiem” (z wszystkich 240 osób)
print(sapply(dane[poz], function(x) table(factor(x, levels = c(1:5, 9)))))
dl <- dane
dl[poz] <- lapply(dane[poz], function(x) ifelse(x == 9, NA, x))   # „nie wiem” -> NA

# 2. Tabela odsetków: mianownikiem są odpowiedzi merytoryczne (bez „nie wiem”)
tabela <- t(sapply(poz, function(p) {
  x <- dl[[p]]; ok <- x[!is.na(x)]
  proc <- 100 * prop.table(table(factor(ok, levels = 1:5)))
  c(n = length(ok), round(proc, 1), suma = sum(round(proc, 1)),
    nie_wiem = round(100 * mean(is.na(x)), 1),
    nie_zgadza = round(100 * mean(ok <= 2), 1), zgadza = round(100 * mean(ok >= 4), 1),
    Me = median(ok))
}))
tabela <- tabela[order(tabela[, "zgadza"], decreasing = TRUE), ]
print(tabela)

# 3. Ten sam odsetek zgody dla p3 z dwoma mianownikami: odpowiedzi merytoryczne i wszystkie osoby
c(bez_nie_wiem = round(100 * mean(dl$p3 >= 4, na.rm = TRUE), 1),
  wszyscy = round(100 * mean(dane$p3 %in% 4:5), 1))
# Odsetek zgody z 95% CI Wilsona dla pozycji p1
k <- sum(dl$p1 >= 4, na.rm = TRUE); m <- sum(!is.na(dl$p1))
print(round(100 * BinomCI(k, m, method = "wilson"), 1))

# 4. Dane do wykresu rozbieżnego: kategoria 3 dzielona na pół, 1–2 i pół 3 na minusie
dlugie <- do.call(rbind, lapply(poz, function(p) {
  proc <- 100 * prop.table(table(factor(dl[[p]], levels = 1:5)))
  data.frame(pozycja = tresc[[p]],
             odp = factor(c(1, 2, 3, 3, 4, 5), levels = 1:5),
             segment = factor(c("1", "2", "3a", "3b", "4", "5"),
                              levels = c("3a", "2", "1", "3b", "4", "5")),
             proc = c(-proc[1], -proc[2], -proc[3] / 2, proc[3] / 2, proc[4], proc[5]))
}))
kolejnosc <- tresc[rownames(tabela)]                       # od najwyższego odsetka zgody
dlugie$pozycja <- factor(dlugie$pozycja, levels = rev(kolejnosc))
sumy <- data.frame(pozycja = factor(tresc[rownames(tabela)], levels = rev(kolejnosc)),
                   lewo = tabela[, "nie_zgadza"], prawo = tabela[, "zgadza"],
                   srodek = tabela[, "3"])
etykiety <- c("Zdecydowanie się nie zgadzam", "Raczej się nie zgadzam", "Ani tak, ani nie",
              "Raczej się zgadzam", "Zdecydowanie się zgadzam")
kolory <- c("1" = "#b2182b", "2" = "#ef8a62", "3" = "#cfcfcf", "4" = "#67a9cf", "5" = "#2166ac")
wyk1 <- ggplot(dlugie, aes(x = proc, y = pozycja, fill = odp, group = segment)) +
  geom_col(width = 0.7, position = position_stack(reverse = TRUE)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_text(data = sumy, aes(x = -lewo - srodek / 2 - 2, y = pozycja, label = sprintf("%.0f%%", lewo)),
            inherit.aes = FALSE, hjust = 1, size = 3.6) +
  geom_text(data = sumy, aes(x = prawo + srodek / 2 + 2, y = pozycja, label = sprintf("%.0f%%", prawo)),
            inherit.aes = FALSE, hjust = 0, size = 3.6) +
  scale_fill_manual(values = kolory, labels = etykiety, name = NULL) +
  scale_x_continuous(limits = c(-75, 100), breaks = seq(-75, 100, 25),
                     labels = function(x) paste0(abs(x), "%")) +
  labs(x = "Odsetek odpowiedzi (bez „nie wiem”)", y = NULL) +
  theme_minimal() + theme(legend.position = "bottom")

# 5. Porównanie trybów studiów: test Manna–Whitneya dla każdej pozycji, poprawka Holma
#    U to statystyka W z wilcox.test(); znak r_rb odwrócony: dodatnie = wyższe odpowiedzi osób niestacjonarnych
wyniki <- do.call(rbind, lapply(poz, function(p) {
  d <- dl[!is.na(dl[[p]]), c("tryb", p)]; names(d)[2] <- "y"
  w <- wilcox.test(y ~ tryb, data = d, exact = FALSE)
  rb <- rank_biserial(y ~ tryb, data = d)
  zg <- tapply(d$y >= 4, d$tryb, mean)
  data.frame(pozycja = p, n_s = sum(d$tryb == "stacjonarne"), n_n = sum(d$tryb == "niestacjonarne"),
             Me_s = median(d$y[d$tryb == "stacjonarne"]), Me_n = median(d$y[d$tryb == "niestacjonarne"]),
             zgoda_s = round(100 * zg[[1]], 1), zgoda_n = round(100 * zg[[2]], 1),
             U = unname(w$statistic), p = signif(w$p.value, 3),
             r_rb = round(-rb$r_rank_biserial, 2), CI_dol = round(-rb$CI_high, 2), CI_gora = round(-rb$CI_low, 2))
}))
wyniki$p_Holm <- signif(p.adjust(wyniki$p, method = "holm"), 3)
print(wyniki)

# 6. Różnica odsetków zgody dla p4 (niestacjonarne − stacjonarne) z 95% CI Newcombe'a
d4 <- dl[!is.na(dl$p4), ]
x <- tapply(d4$p4 >= 4, d4$tryb, sum); nn <- table(d4$tryb)
print(round(100 * BinomDiffCI(x[["niestacjonarne"]], nn[["niestacjonarne"]],
                              x[["stacjonarne"]], nn[["stacjonarne"]], method = "score"), 1))
Wynik w R
  p1 p2 p3 p4 p5 p6
1  3 28  5 18 15  6
2 11 62 35 47 45 30
3 35 84 43 56 62 51
4 92 54 90 77 76 73
5 92  9 34 36 24 72
9  7  3 33  6 18  8
     n    1    2    3    4    5 suma nie_wiem nie_zgadza zgadza Me
p1 233  1.3  4.7 15.0 39.5 39.5  100      2.9        6.0   79.0  4
p6 232  2.6 12.9 22.0 31.5 31.0  100      3.3       15.5   62.5  4
p3 207  2.4 16.9 20.8 43.5 16.4  100     13.8       19.3   59.9  4
p4 234  7.7 20.1 23.9 32.9 15.4  100      2.5       27.8   48.3  3
p5 222  6.8 20.3 27.9 34.2 10.8  100      7.5       27.0   45.0  3
p2 237 11.8 26.2 35.4 22.8  3.8  100      1.2       38.0   26.6  3
bez_nie_wiem      wszyscy
        59.9         51.7
     est lwr.ci upr.ci
[1,]  79   73.3   83.7
  pozycja n_s n_n Me_s Me_n zgoda_s zgoda_n      U        p  r_rb CI_dol CI_gora   p_Holm
1      p1 136  97    4    5    72.1    88.7 4941.0 4.82e-04  0.25   0.11    0.39 2.41e-03
2      p2 138  99    3    3    21.7    33.3 5269.5 1.81e-03  0.23   0.08    0.36 7.24e-03
3      p3 122  85    4    4    59.8    60.0 5280.5 8.13e-01 -0.02  -0.18    0.14 1.00e+00
4      p4 138  96    3    4    34.1    68.8 3777.0 7.99e-09  0.43   0.30    0.54 4.79e-08
5      p5 131  91    3    3    47.3    41.8 5715.5 5.90e-01  0.04  -0.11    0.19 1.00e+00
6      p6 135  97    4    4    60.0    66.0 5828.0 1.38e-01  0.11  -0.04    0.26 4.14e-01
      est lwr.ci upr.ci
[1,] 34.7   21.9   45.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (testy: funkcja wilcox.test() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
Najczęstsze błędy
- Słupki średnich zamiast rozkładu. Średnia 3 może oznaczać, że wszyscy wybrali środek, albo że grupa podzieliła się na dwa obozy. Pokaż odsetki.
- „Nie wiem” jako 3 albo w mianowniku bez informacji. Zawyża odsetek odpowiedzi środkowych albo zaniża odsetek zgody. Napisz w nocie, od jakiej liczby osób liczysz procenty.
- Osobny wykres kołowy dla każdego pytania. Sześć kół zajmuje sześć razy więcej miejsca, a i tak nie da się ich porównać. Jeden wykres rozbieżny pokazuje wszystkie pozycje.
- Kolejność pozycji z ankiety. Czytelnik musi sam szukać najwyższych i najniższych wyników. Sortuj według odsetka zgody.
- Kolory bez logiki. Pięć przypadkowych barw albo para czerwony–zielony utrudnia odczytanie kierunku odpowiedzi. Użyj palety rozbieżnej z szarym środkiem.
- Sześć testów bez poprawki i bez wielkości efektu. Podaj p po poprawce i rrb z przedziałem ufności, a w opisie także odsetki zgody w grupach.
- Same mediany przy porównaniu grup. Mediany 3 i 3 mogą ukrywać istotną różnicę rozkładów, jak przy łatwości skupienia w przykładzie.
Analizę całej ankiety, od czyszczenia danych po testy hipotez, opisuje wpis analiza ankiety do pracy dyplomowej, a planowanie badania ankietowego – przewodnik po ankietach i eksperymentach. Jeśli chcesz, żeby ktoś sprawdził tabele, wykresy i dobór testów w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak przedstawić odpowiedzi na pytania Likerta w pracy magisterskiej?
Podaj tabelę z odsetkami wszystkich kategorii dla każdego pytania, liczebnością i odsetkiem „nie wiem”, a obok wykres rozbieżny. W tekście opisz najważniejsze wyniki odsetkiem zgody (odpowiedzi 4–5) i medianą. Średnia z jednego pytania ukrywa rozkład odpowiedzi, więc nie zastępuj nią odsetków (Sullivan i Artino, 2013).
Jak zrobić wykres rozbieżny dla skali Likerta w R bez pakietu likert?
W ggplot2 nadaj kategoriom niezgody wartości ujemne, a środek skali podziel na dwie połowy. Potem użyj geom_col() z position_stack(reverse = TRUE) i osobną zmienną kolejności segmentów. Etykiety osi pokaż jako wartości bezwzględne. Pełny kod jest w sekcji z przykładem w R.
Od czego liczyć procenty, gdy część osób zaznaczyła „nie wiem”?
Najczęściej od liczby odpowiedzi merytorycznych (1–5), a odsetek „nie wiem” podajesz osobno, od wszystkich badanych. W przykładzie zgoda wyniosła 59.9% odpowiedzi merytorycznych, ale 51.7% wszystkich osób. Ważne, żeby w nocie do tabeli napisać, który mianownik wybrano.
Gdzie umieścić odpowiedź neutralną na wykresie rozbieżnym?
Najczęściej dzieli się ją po połowie między stronę niezgody i zgody, tak że środek słupka leży na linii zera (Heiberger i Robbins, 2014). Gdy środek wybiera bardzo dużo osób, czytelniejszy bywa osobny słupek z prawej strony wykresu. Odpowiedzi „nie wiem” nie umieszczaj na tej osi.
Jak porównać odpowiedzi na kilka pytań Likerta między dwiema grupami?
Dla każdego pytania użyj testu Manna–Whitneya z korelacją rangowo-dwuseryjną, a wartości p popraw na liczbę testów, np. metodą Holma. W opisie podaj też odsetki zgody w obu grupach. Gdy chcesz uwzględnić inne zmienne, użyj regresji porządkowej.
Powiązane hasła
Przeczytaj też
Skala Likerta: średnia czy mediana?
Pozycja jest porządkowa, wynik skali – zwykle ilościowy. Kiedy mediana i odsetki, kiedy M, SD i test t, z przykładem w R i opisem APA.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →Masz kilkanaście pytań Likerta i nie wiesz, jak je pokazać?
Sprawdzimy tabele, wykresy i dobór testów oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Krosnick, J. A. (1991). Response strategies for coping with the cognitive demands of attitude measures in surveys. Applied Cognitive Psychology, 5(3), 213–236. https://doi.org/10.1002/acp.2350050305
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{krosnick1991response, author={Krosnick, Jon A.}, title={{Response strategies for coping with the cognitive demands of attitude measures in surveys}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={3}, pages={213--236}, doi={10.1002/acp.2350050305}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}