Trzy kroki porównania dwóch odsetków
Pytania typu „czy osoby pracujące częściej mają problemy ze snem niż niepracujące?” dotyczą dwóch niezależnych grup i jednej zmiennej tak/nie. Takie porównanie zrób w trzech krokach:
- Tabela 2 × 2 z odsetkami w wierszach. Wiersze to grupy, kolumny – odpowiedź. Odsetki licz w obrębie grupy, bo to one są porównywane. Szczegóły układu opisuje hasło tabela krzyżowa.
- Test. Standardem jest test chi-kwadrat niezależności, który dla tabeli 2 × 2 jest tym samym co test dla dwóch proporcji (χ² = z²). Przy bardzo małych liczebnościach oczekiwanych sięgnij po test dokładny Fishera. Campbell (2007) zaleca wersję chi-kwadrat „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a test Fishera dopiero poniżej tej granicy. Kiedy który test, rozpisujemy we wpisie chi-kwadrat czy test Fishera.
- Różnica odsetków z 95% przedziałem ufności. To liczba, która odpowiada na pytanie „o ile częściej”. Podaj ją w punktach procentowych, z przedziałem policzonym metodą Newcombe’a.
Dlaczego właśnie ten przedział? Najprostszy wzór Walda (różnica ± 1.96 × SE) działa dobrze tylko w dużych grupach i przy odsetkach daleko od 0% i 100%. Newcombe (1998) porównał jedenaście metod i pokazał, że proste metody mają słabe pokrycie, a metoda łącząca przedziały Wilsona obu proporcji sprawdza się dobrze i łatwo ją policzyć. Fagerland i in. (2015) dochodzą do podobnego wniosku: różne przedziały mogą dawać wyraźnie różne wyniki, a tradycyjne sprawdzają się dopiero przy dużych próbach.
Przykład: praca zarobkowa a problemy ze snem
Student pyta 200 osób studiujących, czy w ostatnim miesiącu miały problemy ze snem co najmniej trzy noce w tygodniu (dane symulowane). Problemy zgłosiło 39 z 90 osób pracujących zarobkowo (43.3%) i 31 ze 110 niepracujących (28.2%).
| Grupa | Problemy ze snem: tak | Problemy ze snem: nie | Razem |
|---|---|---|---|
| Pracuje | 39 (43.3%) | 51 (56.7%) | 90 |
| Nie pracuje | 31 (28.2%) | 79 (71.8%) | 110 |
Najmniejsza liczebność oczekiwana wynosi 31.5, więc test chi-kwadrat jest w porządku. Test bez poprawki Yatesa dał χ²(1, N = 200) = 5.00, p = .025. Różnica odsetków wynosi 15.2 punktu procentowego, 95% CI [1.9, 27.9] (metoda Newcombe’a). Przedział Walda to [1.9, 28.4] – przy 200 osobach i odsetkach rzędu 30–40% obie metody dają prawie to samo. Różnice między nimi rosną w małych grupach i przy rzadkich zdarzeniach.
Przedział mówi więcej niż p. Dane są zgodne zarówno z bardzo małą przewagą osób pracujących (2 punkty procentowe), jak i z dużą (28 punktów). Wynik potwierdza kierunek różnicy, ale nie jej dokładną wielkość.
Pułapka: przedziały grup zachodzą na siebie
Częsty błąd to porównanie dwóch osobnych przedziałów ufności. W przykładzie 95% CI Wilsona wynosi [33.6, 53.6] dla osób pracujących i [20.6, 37.2] dla niepracujących. Przedziały zachodzą na siebie (rysunek 1A), a mimo to różnica jest istotna i jej przedział nie obejmuje zera (rysunek 1B).
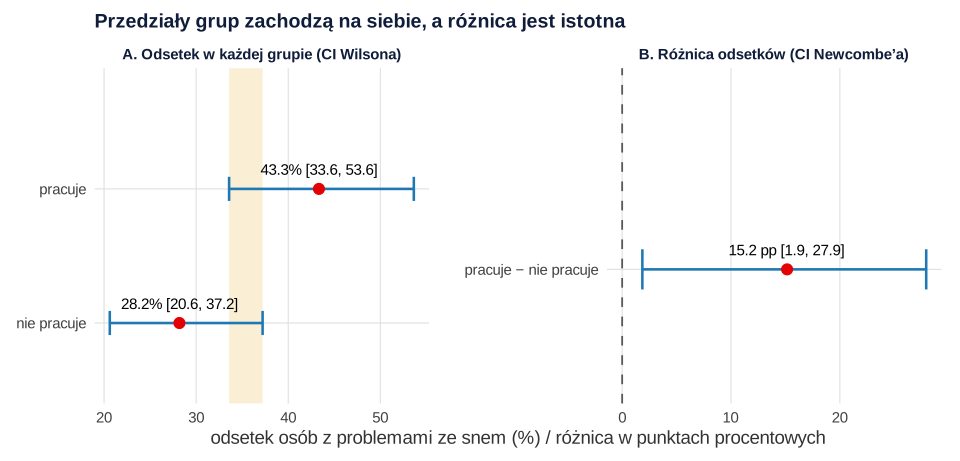
Schenker i Gentleman (2001) pokazali, że brak nakładania się przedziałów oznacza istotną różnicę, ale nakładanie się nie oznacza jej braku. Ocena „na oko” jest zbyt zachowawcza i częściej przeocza prawdziwe różnice, dlatego autorzy odradzają ją jako test istotności. Cumming i Finch (2005) omawiają, jak w ogóle czytać rysunki z przedziałami ufności. Wniosek praktyczny: jeśli na wykresie pokazujesz odsetki z przedziałami, w tekście i tak podaj przedział dla różnicy.
Różnica, ryzyko względne czy iloraz szans?
Te same dwa odsetki można opisać trzema miarami. Każda odpowiada na inne pytanie:
| Miara | Co mówi | Wynik w przykładzie | Kiedy jej użyć |
|---|---|---|---|
| Różnica odsetków | o ile punktów procentowych częściej | 15.2 pp, 95% CI [1.9, 27.9] | domyślnie w pracy dyplomowej – najłatwiej ją zrozumieć |
| Ryzyko względne (RR) | ile razy częściej | 1.54, 95% CI [1.05, 2.25] | gdy chcesz mówić o „razy częściej”, np. w naukach o zdrowiu |
| Iloraz szans (OR) | ile razy większa szansa (tak : nie) | 1.95, 95% CI [1.08, 3.51] | gdy wynik ma się zgadzać z regresją logistyczną albo w badaniu kliniczno-kontrolnym |
Uważaj na dwa skróty myślowe. Po pierwsze, procent to nie punkt procentowy: wzrost z 28.2% do 43.3% to różnica 15.2 punktu procentowego, ale zarazem odsetek wyższy o 54% (RR = 1.54). Po drugie, OR nie jest tym samym co RR. Przy częstych zdarzeniach jest od niego wyraźnie większy (tu 1.95 wobec 1.54), więc nie opisuj go jako „prawie dwa razy częściej”. Bland i Altman (2000) wyjaśniają, czym są szanse i dlaczego ilorazy szans są tak popularne: dają się liczyć w regresji logistycznej i w badaniach kliniczno-kontrolnych.
Kiedy potrzebujesz czegoś innego niż chi-kwadrat
- Te same osoby zbadane dwa razy (przed i po) – to nie są dwie niezależne grupy. Użyj testu McNemara; opisujemy go we wpisie test McNemara – pomiar przed i po.
- Więcej niż dwie grupy albo więcej niż dwie odpowiedzi – test chi-kwadrat dla większej tabeli, reszty standaryzowane i V Craméra. Całą procedurę pokazuje poradnik test chi-kwadrat krok po kroku.
- Trzeba uwzględnić wiek, płeć albo inne zmienne – regresja logistyczna, w której wynikiem dla grupy jest skorygowany iloraz szans.
Jeśli nie masz pewności, który test pasuje do Twojego pytania, skorzystaj z przewodnika testy statystyczne – przewodnik po wyborze. Pojedynczy przedział dla odsetka sprawdzisz w kalkulatorze przedziału ufności.
Jak to opisać w pracy
Podaj liczebności i odsetki w obu grupach, wynik testu oraz różnicę z przedziałem i metodą jego obliczenia:
Porównanie dwóch odsetków w R
Kod odtwarza wszystkie liczby z tekstu: tabelę 2 × 2 z odsetkami w wierszach, test chi-kwadrat bez poprawki Yatesa z najmniejszą liczebnością oczekiwaną, przedziały Wilsona dla każdej grupy, różnicę odsetków z przedziałami Walda i Newcombe’a (w DescTools nazwanym "score") oraz RR i OR z 95% CI.
Test chi-kwadrat, różnica odsetków z 95% CI, RR i OR
R
# B193 – porównanie odsetków w dwóch niezależnych grupach:
# test chi-kwadrat, różnica odsetków z 95% CI (Wald i Newcombe), RR i OR
# Dane symulowane: 200 osób studiujących; czy w ostatnim miesiącu miały problemy
# ze snem co najmniej trzy noce w tygodniu (tak/nie), osoby pracujące zarobkowo
# (n = 90) i niepracujące (n = 110).
library(DescTools)
set.seed(1941)
dane <- data.frame(
  praca = factor(rep(c("pracuje", "nie pracuje"), times = c(90, 110)),
                 levels = c("pracuje", "nie pracuje")),
  sen = c(rbinom(90, 1, .45), rbinom(110, 1, .29)))
dane$sen <- factor(dane$sen, levels = c(1, 0), labels = c("tak", "nie"))

# 1. Tabela 2 × 2 i odsetki w wierszach
tab <- table(dane$praca, dane$sen)
tab
round(100 * prop.table(tab, 1), 1)

# 2. Test chi-kwadrat bez poprawki Yatesa i najmniejsza liczebność oczekiwana
test <- chisq.test(tab, correct = FALSE)
test
round(min(test$expected), 1)

# 3. 95% CI dla każdego odsetka (Wilson)
x <- tab[, "tak"]; n <- rowSums(tab)
ci <- BinomCI(x, n, method = "wilson"); rownames(ci) <- names(n)
round(100 * ci, 1)

# 4. Różnica odsetków (pracujący − niepracujący) z 95% CI: Wald i Newcombe (score)
roznica <- BinomDiffCI(x[1], n[1], x[2], n[2], method = c("wald", "score"))
colnames(roznica)[1] <- "roznica"
round(100 * roznica, 1)

# 5. Ryzyko względne (RR) i iloraz szans (OR) z 95% CI
round(RelRisk(tab, conf.level = .95, method = "score"), 2)
round(OddsRatio(tab, conf.level = .95), 2)
Wynik w R
              tak nie
  pracuje      39  51
  nie pracuje  31  79

               tak  nie
  pracuje     43.3 56.7
  nie pracuje 28.2 71.8

	Pearson's Chi-squared test

data:  tab
X-squared = 4.995, df = 1, p-value = 0.02542

[1] 31.5
             est lwr.ci upr.ci
pracuje     43.3   33.6   53.6
nie pracuje 28.2   20.6   37.2
      roznica lwr.ci upr.ci
wald     15.2    1.9   28.4
score    15.2    1.9   27.9
rel. risk    lwr.ci    upr.ci
     1.54      1.05      2.25
odds ratio     lwr.ci     upr.ci
      1.95       1.08       3.51
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja chisq.test() z pakietu stats oraz funkcje BinomCI(), BinomDiffCI(), RelRisk() i OddsRatio() z pakietu DescTools); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy różnicę dwóch odsetków podaje się w procentach, czy w punktach procentowych?
Różnicę odsetków podawaj w punktach procentowych: 43.3% i 28.2% to różnica 15.2 punktu procentowego. Zdanie „o 54% częściej” opisuje co innego – stosunek odsetków, czyli ryzyko względne 1.54. Oba zapisy są poprawne, ale nie można ich mylić.
Czy jeśli przedziały ufności dwóch odsetków się nakładają, to różnica jest nieistotna?
Nie. Przedziały mogą się częściowo nakładać, a różnica i tak może być istotna statystycznie. O różnicy rozstrzyga przedział ufności dla samej różnicy albo test, a nie porównywanie dwóch osobnych przedziałów „na oko”. Brak nakładania się oznacza istotną różnicę, ale odwrotnie to nie działa.
Jak porównać odsetki w dwóch grupach, gdy trzeba uwzględnić wiek albo płeć?
Wtedy test chi-kwadrat nie wystarczy, bo porównuje tylko surowe odsetki. Użyj regresji logistycznej z grupą i zmiennymi kontrolnymi jako predyktorami; wynik dla grupy to skorygowany iloraz szans z przedziałem ufności.
Który przedział ufności dla różnicy odsetków wybrać?
Najprostszy przedział Walda działa dobrze dopiero przy dużych grupach i odsetkach daleko od 0% i 100%. Bezpieczniejszy jest przedział Newcombe’a, który łączy przedziały Wilsona obu odsetków. W R policzysz go funkcją BinomDiffCI() z pakietu DescTools z opcją method = "score".
Powiązane hasła
Przeczytaj też
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikTest McNemara – przed i po dla tak/nie
Tabela par, wybór wersji testu (asymptotyczna, dokładna, mid-p) i 95% CI dla sparowanej różnicy odsetków – z przykładem w R i wzorem opisu.
Czytaj →Porównujesz odsetki w swojej pracy?
Sprawdzimy, który test pasuje do Twoich danych, policzymy różnicę z przedziałem ufności i pomożemy opisać wynik tak, by obronił się przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Fagerland, M. W., Lydersen, S., & Laake, P. (2015). Recommended confidence intervals for two independent binomial proportions. Statistical Methods in Medical Research, 24(2), 224–254. https://doi.org/10.1177/0962280211415469
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Schenker, N., & Gentleman, J. F. (2001). On judging the significance of differences by examining the overlap between confidence intervals. The American Statistician, 55(3), 182–186. https://doi.org/10.1198/000313001317097960
Cytowania BibTeX
@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{fagerland2015recommended, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{Recommended confidence intervals for two independent binomial proportions}}, journal={Statistical Methods in Medical Research}, year={2015}, volume={24}, number={2}, pages={224--254}, doi={10.1177/0962280211415469}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{schenker2001judging, author={Schenker, Nathaniel and Gentleman, Jane F.}, title={{On judging the significance of differences by examining the overlap between confidence intervals}}, journal={The American Statistician}, year={2001}, volume={55}, number={3}, pages={182--186}, doi={10.1198/000313001317097960}}