Co policzyć w ankiecie satysfakcji pacjentów
Ankieta satysfakcji to jeden z najczęstszych tematów prac z pielęgniarstwa i zdrowia publicznego. Kilka do kilkunastu twierdzeń o opiece, odpowiedzi od „zdecydowanie nie” do „zdecydowanie tak”, czasem pytanie o ogólną ocenę i jedno pytanie otwarte. Zebranie danych wydaje się proste, ale analiza ma kilka pułapek. Odpowiedzi są porządkowe. Większość pacjentów zaznacza najwyższe kategorie, więc rozkłady są skrajnie skośne. Część pytań nie dotyczy części osób. Do tego ankietę oddaje tylko część pacjentów, a ci, którzy jej nie oddali, mogą oceniać opiekę inaczej.
Ten poradnik prowadzi przez całą analizę na jednym przykładzie: od zwrotów ankiet, przez rozkład odpowiedzi na każde pytanie i wynik skali, po porównanie oddziałów i pytanie otwarte. Ogólny plan statystyki w pracy z pielęgniarstwa – także dla badań wiedzy, edukacji i skal klinicznych – znajdziesz we wpisie statystyka w pracy z pielęgniarstwa. Tutaj skupiamy się wyłącznie na satysfakcji.
| Krok | Pytanie | Analiza | Co podać w pracy |
|---|---|---|---|
| 1. Zwroty i braki | Kto oddał ankietę i na które pytania odpowiedział? | odsetek zwrotów, braki w pozycjach, odpowiedzi „nie dotyczy” | liczba rozdanych i oddanych ankiet, odsetek zwrotów według oddziałów |
| 2. Pojedyncze pytania | Jak pacjenci oceniają każdy element opieki? | rozkład odpowiedzi, mediana, odsetek „top-box” z 95% CI | tabela odsetków, wykres skumulowany |
| 3. Wynik skali | Czy pytania tworzą spójną skalę? | średnia pozycji, reguła dla braków, alfa i omega | M, SD, Me, IQR, rzetelność z CI |
| 4. Efekt sufitu | Czy skala różnicuje zadowolonych pacjentów? | odsetek wyników maksymalnych, skośność, histogram | odsetek osób z wynikiem maksymalnym |
| 5. Porównanie grup | Czy oddziały się różnią? | test Kruskala–Wallisa z ε² i testem Dunna, top-box według grup, regresja porządkowa | statystyka testu, p, wielkość efektu, porównania parami |
| 6. Pytanie otwarte | Co pacjenci chcieliby zmienić? | kategorie, częstości, zgodność koderów | klucz kategorii, odsetki, kappa Cohena |
Badanie przykładowe: satysfakcja z opieki pielęgniarskiej na trzech oddziałach
Wyobraź sobie pracę licencjacką z pielęgniarstwa. Autorka rozdała przy wypisie 300 anonimowych ankiet – po 100 na oddziale chorób wewnętrznych, chirurgii i kardiologii. Ankieta jest własna (nie jest standaryzowanym narzędziem) i ma dziewięć twierdzeń z odpowiedziami od 1 („zdecydowanie nie”) do 5 („zdecydowanie tak”):
- P1–P6 – rdzeń skali: informowanie o badaniach i zabiegach, czas reakcji na wezwanie, szacunek i dbałość o intymność, życzliwość personelu, spokój i cisza w nocy oraz przygotowanie do wypisu;
- P7 i P8 – łagodzenie bólu i pomoc w higienie, z dodatkową odpowiedzią „nie dotyczy”, bo nie każdy pacjent odczuwał ból albo potrzebował pomocy;
- P9 – ogólna ocena opieki pielęgniarskiej (od 1 „bardzo źle” do 5 „bardzo dobrze”);
- pytanie otwarte: „Co powinniśmy poprawić?” oraz metryczka: wiek i płeć.
Dane są symulowane, ale ich rozkłady przypominają prawdziwe ankiety satysfakcji. Możesz je pobrać jako plik Excel: arkusz dane zawiera odpowiedzi 224 osób (w P7 i P8 kod 9 oznacza „nie dotyczy”, a pusta komórka – brak odpowiedzi), a arkusz kodowanie – opis zmiennych. Jak przygotować własną bazę w podobnym układzie, pokazujemy w poradniku jak przygotować bazę danych do analizy.
Ankieta wśród pacjentów to badanie z udziałem ludzi. Zanim rozdasz ankiety, sprawdź, czy potrzebujesz zgody dyrekcji szpitala i opinii komisji bioetycznej lub etycznej uczelni (zob. zgoda komisji bioetycznej). Wymagania ustala regulamin Twojej uczelni i komisji, więc zapytaj o nie promotora przed rozpoczęciem badania.
Krok 1. Zwroty ankiet, braki i odpowiedzi „nie dotyczy”
Zacznij od tego, ile ankiet wróciło. Z 300 rozdanych autorka odzyskała 224, czyli 74.7%. Na internie oddało ankietę 81 osób (81.0%), na chirurgii 68 (68.0%), a na kardiologii 75 (75.0%). Różnica w odsetkach zwrotów nie była istotna, χ²(2) = 4.48, p = .107, ale przy 100 ankietach na oddział test ma niewielką moc, więc nie wyciągaj z tego wniosku, że zwroty były „takie same”. Średni wiek osób, które oddały i nie oddały ankiety (z dokumentacji oddziału, w postaci zbiorczej), był identyczny: 64.3 roku.
Odsetek zwrotów nie jest formalnością. Pacjenci niezadowoleni mogą rzadziej oddawać ankietę albo – przeciwnie – chętniej z niej korzystać, żeby zgłosić skargę. W obu przypadkach wynik z próby różni się od wyniku całej populacji pacjentów. To błąd braku odpowiedzi. Nie da się go policzyć na podstawie samych oddanych ankiet, dlatego w pracy podaj odsetek zwrotów według oddziałów, porównaj osoby, które ankietę oddały i nie oddały, w tym, co wiesz o obu grupach, i opisz to jako ograniczenie.
„Nie dotyczy” to nie brak danych i nie „3”
W pozycjach P7 i P8 część osób wybrała „nie dotyczy”: 17.1% przy łagodzeniu bólu i 39.4% przy pomocy w higienie. Ten kod (tu 9) musisz zamienić na brak odpowiedzi przed jakimkolwiek liczeniem. Jeśli go zostawisz, średnia z P8 wzrośnie absurdalnie, bo 9 leży poza skalą 1–5. Równie błędne jest zastąpienie „nie dotyczy” środkiem skali. Odpowiedź „nie dotyczy” to informacja, że pacjent nie korzystał z danego elementu opieki, a nie ocena „ani dobrze, ani źle”. Podaj więc w tabeli osobno liczbę odpowiedzi na skali i odsetek „nie dotyczy”. Właśnie dlatego P7 i P8 nie weszły do wyniku skali: przy 39.4% odpowiedzi „nie dotyczy” wynik ogólny byłby liczony z różnych pytań u różnych osób.
Prawdziwe braki odpowiedzi, czyli pominięte pytania, dotyczyły od 5 do 12 osób w każdej z pozycji P1–P6 (liczebności n w tabeli w kroku 2). Ich znaczenie dla wyniku skali omawiamy w kroku 3, a ogólne mechanizmy braków – w haśle braki danych (MCAR, MAR, MNAR).
Krok 2. Rozkład odpowiedzi na każde pytanie i odsetek „top-box”
Pojedyncza pozycja skali Likerta jest zmienną porządkową: wiesz, że „4” to więcej niż „3”, ale nie wiesz, czy odstęp między nimi jest taki sam jak między „4” a „5”. Sullivan i Artino (2013) zalecają, by pojedyncze pozycje opisywać medianą i rozkładem częstości. Średnią możesz podać obok, ale nie zamiast rozkładu. W ankiecie satysfakcji mediana ma jednak poważną wadę: przy tak skośnych rozkładach większość pozycji ma medianę 4 albo 5, więc niewiele różnicuje.
Dlatego w badaniach satysfakcji podaje się często odsetek „top-box”, czyli odsetek osób, które wybrały najwyższą kategorię odpowiedzi („zdecydowanie tak”). Bywa też „top-two-box”, czyli odsetek odpowiedzi 4 lub 5. Taki odsetek ma prostą interpretację („80.8% pacjentów zdecydowanie zgodziło się, że personel dbał o ich intymność”) i lepiej różnicuje pytania niż mediana. Zawsze podaj go z przedziałem ufności dla proporcji. Brown i in. (2001) pokazali, że standardowy przedział Walda (p ± 1.96 × SE) ma zawodne pokrycie nawet w dużych próbach, i zalecają przedział Wilsona. W R daje go funkcja prop.test() z argumentem correct = FALSE.
| Pozycja | n | 1–2 | 3 | 4 | 5 | Me | M (SD) | Top-box, 95% CI |
|---|---|---|---|---|---|---|---|---|
| P1. Informowanie o badaniach | 219 | 1.0% | 9.6% | 37.9% | 51.6% | 5 | 4.40 (0.72) | 51.6% [45.0, 58.1] |
| P2. Czas reakcji na wezwanie | 214 | 6.0% | 19.6% | 31.3% | 43.0% | 4 | 4.10 (0.95) | 43.0% [36.5, 49.7] |
| P3. Szacunek i intymność | 214 | 0.0% | 3.3% | 15.9% | 80.8% | 5 | 4.78 (0.49) | 80.8% [75.0, 85.6] |
| P4. Życzliwość personelu | 219 | 0.5% | 2.7% | 15.1% | 81.7% | 5 | 4.78 (0.50) | 81.7% [76.1, 86.3] |
| P5. Spokój i cisza w nocy | 212 | 6.6% | 28.3% | 34.0% | 31.1% | 4 | 3.87 (0.99) | 31.1% [25.3, 37.7] |
| P6. Przygotowanie do wypisu | 217 | 1.8% | 14.3% | 33.2% | 50.7% | 5 | 4.33 (0.79) | 50.7% [44.1, 57.3] |
| P7. Łagodzenie bólu* | 179 | 1.2% | 12.8% | 27.9% | 58.1% | 5 | 4.42 (0.78) | 58.1% [50.8, 65.1] |
| P8. Pomoc w higienie* | 134 | 0.0% | 5.2% | 26.9% | 67.9% | 5 | 4.63 (0.58) | 67.9% [59.6, 75.2] |
| P9. Ogólna ocena opieki | 216 | 1.9% | 3.7% | 31.0% | 63.4% | 5 | 4.56 (0.68) | 63.4% [56.8, 69.6] |
* Bez odpowiedzi „nie dotyczy” (P7: 17.1%, P8: 39.4% osób, które odpowiedziały na pytanie). Kolumna „1–2” łączy dwie najniższe kategorie. Dane symulowane.
Tabela od razu pokazuje to, czego nie widać w średniej ogólnej. Personel oceniono jako życzliwy (81.7% odpowiedzi „zdecydowanie tak”) i szanujący intymność (80.8%). Najsłabiej wypadły cisza w nocy (31.1%) i czas reakcji na wezwanie (43.0%). Przedziały ufności dla tych dwóch pozycji nie zachodzą na przedziały dla P3 i P4, więc różnica jest wyraźnie większa od niepewności z próby. Zwróć uwagę na P1 i P6: obie mają medianę 5, a mimo to tylko około połowy pacjentów wybrało najwyższą odpowiedź. Mediana „5” znaczy tu tylko tyle, że co najmniej połowa osób wybrała 5.
Wykres skumulowany Likerta
Najlepszym wykresem dla zestawu pozycji Likerta jest skumulowany wykres rozbieżny (diverging stacked bar chart). Heiberger i Robbins (2014) zalecają go jako podstawowy sposób prezentacji takich skal: odpowiedzi negatywne leżą po lewej stronie linii zera, pozytywne po prawej, a kategoria środkowa jest dzielona po połowie. Uporządkuj pozycje według odsetka „top-box” albo odpowiedzi pozytywnych, a nie według kolejności w ankiecie. Wtedy mocne i słabe strony opieki widać na pierwszy rzut oka (rysunek 1).
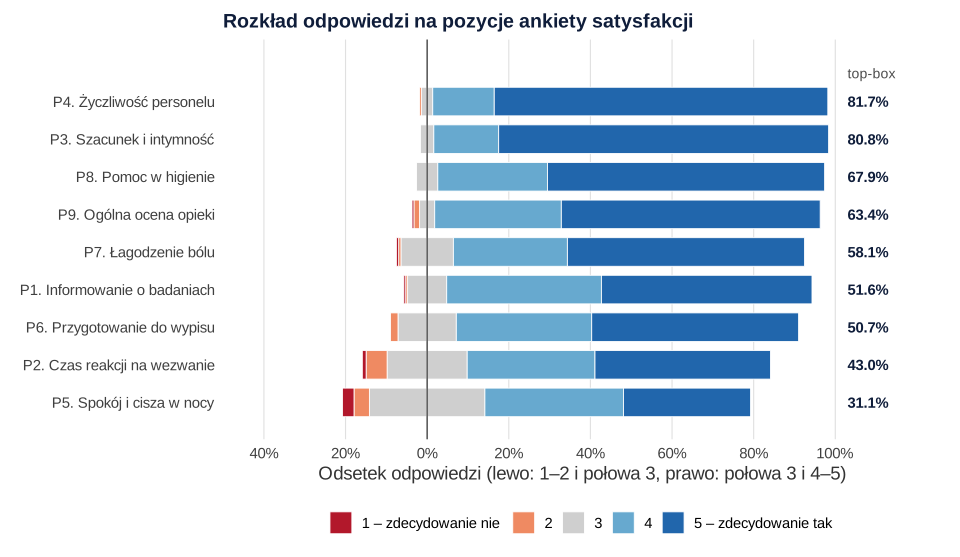
Na wykresie widać też, że lewa strona jest prawie pusta. Odpowiedzi 1 i 2 wybrało od 0% do 6.6% osób, zależnie od pytania. To typowe dla ankiet satysfakcji i ma konsekwencje dla całej dalszej analizy: różnice między oddziałami rozgrywają się głównie między odpowiedziami 4 i 5.
Krok 3. Wynik skali, reguła dla braków i rzetelność
Jeśli pozycje mierzą jedno zjawisko, możesz je połączyć w wynik skali. Sullivan i Artino (2013) podkreślają, że takie łączenie trzeba uzasadnić dowodami rzetelności lub struktury, a gdy to zrobisz, do wyniku skali możesz stosować testy parametryczne. Przy ankiecie własnej i jednym badaniu to zwykle spójność wewnętrzna i korelacje pozycji z resztą skali. Czy lepiej liczyć sumę, czy średnią, wyjaśniamy w haśle wynik skali – średnia czy suma. Tu wybieramy średnią z P1–P6, bo zostaje na skali odpowiedzi 1–5 i łatwo ją porównać z pojedynczymi pytaniami.
Ile braków dopuścić?
Na wszystkie sześć pytań rdzenia odpowiedziało 180 osób. Jedno pytanie pominęło 39 osób, a dwa – 5. Gdyby wynik skali liczyć tylko dla kompletnych ankiet, stracisz 44 z 224 osób (19.6%). Dlatego w planie analizy przyjęto umowną regułę: wynik skali to średnia z dostępnych pozycji, jeśli brakuje najwyżej jednej z sześciu. Dzięki temu wynik ma 219 osób. Średnia skali wyniosła 4.39 w kompletnych ankietach i 4.38 według reguły, więc wybór reguły prawie nie zmienił wniosku.
Taka reguła (proration) jest wygodna, ale nie neutralna. Zakłada, że brakująca odpowiedź byłaby podobna do pozostałych odpowiedzi tej samej osoby. Mazza i in. (2015) pokazali w symulacjach, że uśrednianie dostępnych pozycji może dawać obciążone wyniki nawet przy brakach całkowicie losowych, i proponują metody oparte na pełnej informacji. W pracy licencjackiej reguła „najwyżej jeden brak” zwykle wystarczy, pod warunkiem że ustalisz ją przed analizą, napiszesz o niej wprost i podasz, ile osób objęła. Gdy w oryginalnym narzędziu autorzy podają własną regułę dla braków, stosuj ją zamiast własnej.
Rzetelność: alfa i omega
Dla 180 kompletnych ankiet alfa Cronbacha wyniosła α = .86, 95% CI [.83, .89]. Korelacje pozycji z resztą skali mieściły się w zakresie od .53 (P3, szacunek i intymność) do .74 (P6, przygotowanie do wypisu). Najniższa wartość przy P3 ma prosty powód: przy 80.8% odpowiedzi „5” pozycja ma bardzo mało zmienności, a bez zmienności nie ma korelacji. Omega z jednoczynnikowej analizy czynnikowej wyniosła ω = .88. McNeish (2018) przypomina, że alfa opiera się na założeniach rzadko spełnionych w praktyce i zwykle zaniża rzetelność, dlatego warto podać obok niej omegę McDonalda. Jak interpretować alfę i jak ją opisać, pokazują wpisy alfa Cronbacha – rzetelność skali i wzór raportowania alfy Cronbacha.
Wysoka alfa nie dowodzi, że ankieta mierzy „satysfakcję” w jakimś głębszym sensie. Williams (1994) w przeglądzie badań zwrócił uwagę, że deklaracje zadowolenia słabo oddają złożone przekonania pacjentów o opiece, a wiele ankiet satysfakcji jedynie potwierdza stan istniejący. Jeśli Twoja ankieta jest własna, napisz, skąd wzięły się pytania (literatura, rozmowy z pacjentami, badanie pilotażowe), zamiast przypisywać jej trafność, której nie sprawdziłaś.
Krok 4. Efekt sufitu: kiedy prawie wszyscy są zadowoleni
W przykładzie średnia skali wynosi 4.38 (SD = 0.58), mediana 4.50 (IQR od 4.00 do 4.83), a skośność −1.03. Najwyższy możliwy wynik 5.00 uzyskało 18.3% osób. To jest efekt sufitu: skala nie pozwala odróżnić pacjenta „bardzo zadowolonego” od „zachwyconego”, bo obaj zaznaczają to samo. Terwee i in. (2007) uwzględnili efekty sufitu i podłogi wśród kryteriów jakości właściwości pomiarowych kwestionariuszy zdrowotnych. W praktyce często spotyka się umowny próg 15% osób z wynikiem maksymalnym. Lepiej jednak podać dokładny odsetek i ocenić, czy sufit przeszkadza w odpowiedzi na Twoje pytanie badawcze.
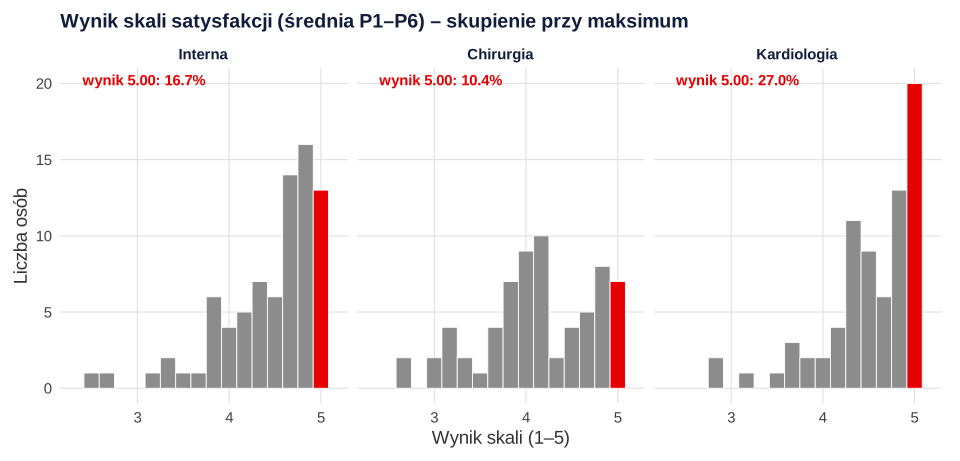
Sufit ma trzy konsekwencje dla analizy.
- Różnice między grupami są zaniżone. Šimkovic i Träuble (2019) pokazali w symulacjach, że efekty sufitu i podłogi zwiększają obciążenie i niepewność oszacowań, m.in. różnicy średnich i d Cohena. W ich badaniu najlepiej sprawdzały się testy rangowe i analizy na danych przekształconych.
- Średnia i odchylenie standardowe źle opisują rozkład. Podaj obok nich medianę, rozstęp ćwiartkowy i odsetek wyników maksymalnych. Pokaż histogram, a nie tylko tabelę.
- Wysoki wynik nie musi znaczyć dobrej opieki. Dunsch i in. (2018) w eksperymencie z udziałem ponad 2200 pacjentów pokazali, że przy twierdzeniach sformułowanych negatywnie deklarowana satysfakcja była istotnie niższa niż przy typowych twierdzeniach pozytywnych (87% wobec 95%). Wysoka satysfakcja w ankiecie prawdopodobnie zawyża jakość opieki. Do tego dochodzi aprobata społeczna: pacjent wypełniający ankietę na oddziale może nie chcieć krytykować osób, które się nim opiekują.
Co z tym zrobić? Na etapie projektu: formułuj pytania o konkretne doświadczenia („czy po wezwaniu pielęgniarka przyszła w ciągu kilku minut”), a nie o ogólne zadowolenie, i zbieraj ankiety tak, by pacjent nie oddawał ich osobie, którą ocenia. Na etapie analizy: raportuj odsetki „top-box”, które dobrze działają przy skupieniu odpowiedzi w górnej kategorii, i wybieraj metody porządkowe albo rangowe.
Krok 5. Porównanie oddziałów: test Kruskala–Wallisa i regresja porządkowa
Najczęstsze pytanie w takich pracach brzmi: czy satysfakcja różni się między oddziałami? Przy trzech grupach i skośnym wyniku skali z wyraźnym sufitem dobrym wyborem jest test Kruskala–Wallisa. Kruskal i Wallis (1952) oparli go na łącznym rangowaniu wszystkich obserwacji, więc nie wymaga normalności, a wiązania przy wyniku 5.00 uwzględnia poprawka na rangi wiązane. Ogólny poradnik testów rangowych znajdziesz we wpisie testy nieparametryczne krok po kroku.
| Oddział | n | M (SD) | Me [Q1, Q3] | Wynik 5.00 |
|---|---|---|---|---|
| Interna | 78 | 4.45 (0.54) | 4.60 [4.18, 4.83] | 16.7% |
| Chirurgia | 67 | 4.13 (0.62) | 4.17 [3.83, 4.67] | 10.4% |
| Kardiologia | 74 | 4.52 (0.51) | 4.67 [4.33, 5.00] | 27.0% |
Wynik: H(2) = 17.98, p < .001. Jako wielkość efektu podaj ε² = H / (n − 1) = 17.98 / 218 = .082, czyli różnice między oddziałami wiążą się z około 8% zmienności rang. Istotny test ogólny mówi tylko, że co najmniej jeden oddział się wyróżnia. Które to oddziały, pokazuje test Dunna (Dunn, 1964) z korektą Holma (zob. poprawki na wielokrotne porównania). Chirurgia różniła się od interny (z = −3.16, pHolm = .003) i od kardiologii (z = 4.07, pHolm < .001), a interna i kardiologia nie różniły się od siebie (z = 0.99, pHolm = .323). Znak z zależy tylko od kolejności grup w parze.
Wynik skali to średnia sześciu pytań, więc warto sprawdzić, które pytania odpowiadają za różnicę. W przykładzie najsilniej różnicowała pozycja P2, czas reakcji na wezwanie: H(2) = 21.78, p < .001. Gdy porównujesz po kolei wszystkie dziewięć pozycji, licz się z problemem wielokrotnych porównań i zastosuj korektę albo potraktuj te analizy jako eksploracyjne.
Ten sam wynik w kategoriach „top-box”
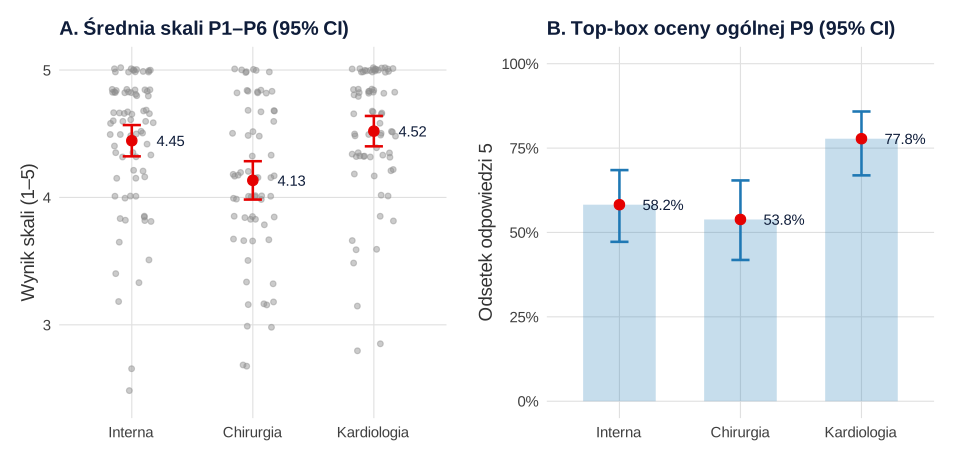
Odsetek odpowiedzi „bardzo dobrze” w ogólnej ocenie opieki (P9) wyniósł 58.2% na internie, 95% CI [47.2, 68.5], 53.8% na chirurgii [41.9, 65.4] i 77.8% na kardiologii [66.9, 85.8]. Różnica między oddziałami była istotna, χ²(2) = 9.88, p = .007. Rysunek 3 zestawia obie perspektywy. Średnia skali wskazuje chirurgię jako oddział odstający, a „top-box” ogólnej oceny – kardiologię jako oddział wyróżniający się na plus. To nie sprzeczność. Wynik skali i ogólna ocena to różne pytania, a „top-box” liczy tylko najwyższą kategorię.
Regresja porządkowa: gdy chcesz uwzględnić inne zmienne
Test Kruskala–Wallisa nie pozwala uwzględnić wieku, płci ani długości pobytu. Gdy oddziały różnią się wiekiem pacjentów, a wiek wiąże się z oceną opieki, porównanie oddziałów bez tej informacji może mylić. Wtedy sięgnij po regresję porządkową, która modeluje szansę wybrania wyższej kategorii odpowiedzi i nie zakłada równych odstępów między kategoriami. Liddell i Kruschke (2018) pokazali, że analizowanie danych porządkowych modelami dla zmiennych ilościowych może prowadzić do fałszywych alarmów, utraty mocy, a nawet odwrócenia kierunku efektu, i że uśrednianie wielu pozycji tego nie naprawia.
W przykładzie model proporcjonalnych szans dla ogólnej oceny opieki (P9; n = 216) z oddziałem, wiekiem i płcią wykazał, że pacjenci kardiologii mieli 2.29 razy większą szansę wyższej oceny niż pacjenci interny, OR = 2.29, 95% CI [1.13, 4.66], p = .022. Pacjenci chirurgii nie różnili się od pacjentów interny, OR = 0.83, 95% CI [0.43, 1.59], p = .565. Związek z wiekiem nie był istotny (OR = 0.83 na każde 10 lat, 95% CI [0.67, 1.04], p = .107). Iloraz szans w tym modelu dotyczy każdego progu naraz: „4 lub 5 zamiast 1–3” i „5 zamiast 1–4”. Takie jedno OR dla wszystkich progów to założenie proporcjonalnych szans, które warto sprawdzić. W pracy licencjackiej regresję porządkową możesz potraktować jako analizę uzupełniającą, a test Kruskala–Wallisa jako główną.
Krok 6. Pytanie otwarte: kodowanie i zgodność koderów
Pytanie „Co powinniśmy poprawić?” często daje najwięcej praktycznych wskazówek dla oddziału. Komentarz wpisało 98 z 224 osób (43.8%). Züll (2016) w wytycznych GESIS opisuje, kiedy stosować pytania otwarte i jak analizować odpowiedzi, m.in. za pomocą analizy treści. W pracy dyplomowej zwykle wystarczy prosta procedura, którą opisujemy szerzej w haśle kodowanie odpowiedzi otwartych:
- przeczytaj wszystkie odpowiedzi i zaproponuj wstępne kategorie;
- spisz klucz kategoryzacji: nazwa, definicja, przykład i przypadki graniczne;
- poproś drugą osobę, by niezależnie zakodowała odpowiedzi (wszystkie albo losową część);
- policz zgodność, omów rozbieżności i popraw klucz;
- podaj liczebności i odsetki kategorii, z jasną informacją, od czego liczysz odsetek.
| Kategoria | n | % komentarzy (n = 98) |
|---|---|---|
| Czas oczekiwania na pomoc | 39 | 39.8% |
| Cisza nocna | 23 | 23.5% |
| Pochwała, brak uwag | 15 | 15.3% |
| Informacja | 11 | 11.2% |
| Posiłki i warunki | 10 | 10.2% |
Kategorie z pytania otwartego potwierdzają wnioski z części ilościowej. Najczęściej pacjenci pisali o czasie oczekiwania na pomoc, a na chirurgii ta kategoria stanowiła 52.5% komentarzy, wobec 37.1% na internie i 21.7% na kardiologii. Pamiętaj, że to odsetki wśród osób, które coś napisały, a nie wśród wszystkich pacjentów. Osoby wpisujące komentarz zwykle różnią się od tych, które pole zostawiają puste.
Dwie koderki niezależnie przypisały kategorie wszystkim 98 komentarzom. Zgodziły się w 88.8% przypadków, a kappa Cohena, która koryguje zgodność przypadkową, wyniosła κ = .85, 95% CI [.77, .93]. O’Connor i Joffe (2020) przyznają, że ocena zgodności koderów budzi spory w badaniach jakościowych, ale zwiększa systematyczność i przejrzystość kodowania oraz pomaga przekonać czytelnika o wiarygodności analizy. Jak wybrać miarę zgodności przy większej liczbie koderów albo kategoriach porządkowych, pokazujemy w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Jak opisać wyniki ankiety satysfakcji w pracy (APA)
Poniżej gotowy opis, który możesz dopasować do swoich danych. Zawiera wszystkie elementy z kroków 1–6: zwroty, regułę dla braków, rzetelność, efekt sufitu, porównanie oddziałów i pytanie otwarte. Pojedyncze pozycje lepiej pokazać w tabeli niż opisywać zdanie po zdaniu. Ogólne zasady zapisu statystyk znajdziesz w poradniku jak opisać wyniki w stylu APA, a sposób opisania ankiety jako narzędzia – we wpisie opis narzędzia badawczego – wzór.
W dyskusji nie pisz, że „opieka na oddziałach jest bardzo dobra”, tylko że „pacjenci, którzy oddali ankietę, oceniali opiekę wysoko”. Wspomnij o odsetku zwrotów, o efekcie sufitu i o tym, że ankieta jest narzędziem własnym. Jak sformułować ograniczenia bez umniejszania całej pracy, pokazujemy w poradniku jak napisać dyskusję wyników.
Analiza ankiety satysfakcji w R: od zwrotów do pytań otwartych
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R, bo przepisy 2–4 korzystają z obiektu ankiety z przepisu 1. Rzetelność liczy pakiet psych (alfa) i lavaan (omega z jednoczynnikowej CFA), test Dunna – pakiet rstatix, a regresję porządkową – funkcja polr() z pakietu MASS. Przedziały Wilsona daje funkcja prop.test() z argumentem correct = FALSE. Plik Excel do pobrania powstaje w osobnym skrypcie z obiektu surowe (dane przed zamianą kodu 9 na brak).
1. Zwroty, „nie dotyczy” i rozkład odpowiedzi na pozycje
R
# Ankieta satysfakcji pacjentów z opieki pielęgniarskiej (dane symulowane, set.seed(5601)).
# 300 ankiet rozdanych przy wypisie na trzech oddziałach (po 100); 9 pozycji 1–5:
# P1–P6 – rdzeń skali, P7 i P8 – z odpowiedzią „nie dotyczy” (kod 9), P9 – ogólna ocena opieki.
set.seed(5601)
N <- 300
oddzial <- factor(rep(c("interna", "chirurgia", "kardiologia"), each = 100),
                  levels = c("interna", "chirurgia", "kardiologia"))
zwrot <- rbinom(N, 1, c(interna = .82, chirurgia = .68, kardiologia = .80)[as.character(oddzial)])
wiek_wszyscy <- round(pmin(95, pmax(18, rnorm(N, 63, 14))))
n_zw <- sum(zwrot)

ankiety <- data.frame(id = 1:n_zw, oddzial = oddzial[zwrot == 1], wiek = wiek_wszyscy[zwrot == 1],
                      plec = sample(c("K", "M"), n_zw, replace = TRUE, prob = c(.55, .45)))
eta <- rnorm(n_zw, c(interna = 0, chirurgia = -0.40, kardiologia = 0.15)[as.character(ankiety$oddzial)], 1)
progi <- c(-3.0, -2.4, -1.5, -0.45)                    # wspólne progi kategorii 1|2, 2|3, 3|4, 4|5
przes <- c(P1 = 0.2, P2 = 0.5, P3 = -0.4, P4 = -0.5, P5 = 0.9, P6 = 0.3, P7 = 0.1, P8 = -0.2, P9 = 0)
odp <- function(y) findInterval(y, progi) + 1
for (p in names(przes)) {
  y <- 0.85 * eta + rnorm(n_zw, 0, 0.55) - przes[[p]]
  if (p == "P2") y <- y - 0.35 * (ankiety$oddzial == "chirurgia")   # dłuższe czekanie na pomoc na chirurgii
  ankiety[[p]] <- odp(y)
}
for (p in paste0("P", 1:9)) ankiety[[p]][runif(n_zw) < .03] <- NA      # pominięte pytania (ok. 3%)
ankiety$P7[runif(n_zw) < .22] <- 9                                    # „nie dotyczy” – bez bólu
ankiety$P8[runif(n_zw) < .38] <- 9                                    # „nie dotyczy” – samodzielni pacjenci

# Komentarz w pytaniu otwartym i kategorie nadane przez dwie koderki
kat <- c("cisza nocna", "czas oczekiwania", "informacja", "posiłki i warunki", "pochwała")
pisze <- runif(n_zw) < plogis(-0.1 - 0.4 * eta)
ankiety$kod_A <- NA; ankiety$kod_B <- NA
for (i in which(pisze)) {
  w <- c(0.9, 0.8 + 0.6 * (ankiety$oddzial[i] == "chirurgia"), 0.6, 0.5, 0.4 + 1.2 * plogis(2 * eta[i]))
  ankiety$kod_A[i] <- sample(kat, 1, prob = w)
  ankiety$kod_B[i] <- if (runif(1) < .86) ankiety$kod_A[i] else sample(setdiff(kat, ankiety$kod_A[i]), 1)
}
surowe <- ankiety                                   # kopia z kodem 9 – do pliku do pobrania

# Zwroty ankiet według oddziałów
zw <- table(oddzial, zwrot)
cbind(rozdane = rowSums(zw), oddane = zw[, "1"], proc = round(100 * zw[, "1"] / rowSums(zw), 1))
round(100 * n_zw / N, 1)
chisq.test(zw)
round(c(wiek_oddali = mean(wiek_wszyscy[zwrot == 1]), wiek_nie_oddali = mean(wiek_wszyscy[zwrot == 0])), 1)

# „Nie dotyczy” (9) to nie odpowiedź na skali – zamień na NA i policz osobno
nd <- sapply(ankiety[, c("P7", "P8")], function(x) round(100 * mean(x == 9, na.rm = TRUE), 1))
nd
ankiety$P7[ankiety$P7 %in% 9] <- NA
ankiety$P8[ankiety$P8 %in% 9] <- NA

# Rozkład każdej pozycji, mediana, M (SD) i odsetek „top-box” (odpowiedź 5) z 95% CI Wilsona
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int * 100
opis_poz <- t(sapply(paste0("P", 1:9), function(p) {
  x <- ankiety[[p]]; x <- x[!is.na(x)]; n <- length(x)
  proc <- 100 * tabulate(x, 5) / n; tb <- sum(x == 5)
  c(n = n, round(proc, 1), Me = median(x), M = round(mean(x), 2), SD = round(sd(x), 2),
    top = round(100 * tb / n, 1), round(wilson(tb, n), 1), top2 = round(100 * mean(x >= 4), 1))
}))
colnames(opis_poz) <- c("n", "%1", "%2", "%3", "%4", "%5", "Me", "M", "SD", "top_box", "CI_d", "CI_g", "top2")
opis_poz
Wynik w R
            rozdane oddane proc
interna         100     81   81
chirurgia       100     68   68
kardiologia     100     75   75
[1] 74.7

	Pearson's Chi-squared test

data:  zw
X-squared = 4.476, df = 2, p-value = 0.1067

    wiek_oddali wiek_nie_oddali
           64.3            64.3
  P7   P8
17.1 39.4
     n  %1  %2   %3   %4   %5 Me    M   SD top_box CI_d CI_g top2
P1 219 0.5 0.5  9.6 37.9 51.6  5 4.40 0.72    51.6 45.0 58.1 89.5
P2 214 0.9 5.1 19.6 31.3 43.0  4 4.10 0.95    43.0 36.5 49.7 74.3
P3 214 0.0 0.0  3.3 15.9 80.8  5 4.78 0.49    80.8 75.0 85.6 96.7
P4 219 0.0 0.5  2.7 15.1 81.7  5 4.78 0.50    81.7 76.1 86.3 96.8
P5 212 2.8 3.8 28.3 34.0 31.1  4 3.87 0.99    31.1 25.3 37.7 65.1
P6 217 0.0 1.8 14.3 33.2 50.7  5 4.33 0.79    50.7 44.1 57.3 83.9
P7 179 0.6 0.6 12.8 27.9 58.1  5 4.42 0.78    58.1 50.8 65.1 86.0
P8 134 0.0 0.0  5.2 26.9 67.9  5 4.63 0.58    67.9 59.6 75.2 94.8
P9 216 0.5 1.4  3.7 31.0 63.4  5 4.56 0.68    63.4 56.8 69.6 94.4
2. Wynik skali, braki, efekt sufitu i rzetelność
R
# Wynik skali (średnia P1–P6), braki danych, rzetelność i efekt sufitu. Korzysta z obiektu ankiety z przepisu 1.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
rdzen <- paste0("P", 1:6)

# Braki w rdzeniu: ile pytań pominęła każda osoba?
ile_brakow <- rowSums(is.na(ankiety[, rdzen]))
table(ile_brakow)
round(100 * mean(ile_brakow > 0), 1)                  # % osób z co najmniej jednym brakiem

# Reguła przyjęta w planie analizy: średnia z dostępnych pozycji, jeśli brakuje najwyżej jednej z sześciu
ankiety$skala <- ifelse(ile_brakow <= 1, rowMeans(ankiety[, rdzen], na.rm = TRUE), NA)
pelne <- ile_brakow == 0
round(c(n_pelne = sum(pelne), n_regula = sum(!is.na(ankiety$skala)),
        M_pelne = mean(ankiety$skala[pelne]), M_regula = mean(ankiety$skala, na.rm = TRUE)), 2)

# Rozkład wyniku skali i efekt sufitu
s <- ankiety$skala[!is.na(ankiety$skala)]
round(c(n = length(s), M = mean(s), SD = sd(s), Me = median(s), Q1 = unname(quantile(s, .25)),
        Q3 = unname(quantile(s, .75)), skosnosc = skew(s), proc_max = 100 * mean(s == 5)), 2)

# Rzetelność: alfa Cronbacha (z 95% CI) i omega z jednoczynnikowej CFA dla pełnych odpowiedzi
a <- psych::alpha(ankiety[pelne, rdzen])
round(c(alfa = a$total$raw_alpha, CI_d = a$feldt$lower.ci$raw_alpha, CI_g = a$feldt$upper.ci$raw_alpha), 2)
round(a$item.stats[, "r.drop", drop = FALSE], 2)                 # korelacja pozycji z resztą skali
m <- cfa("S =~ P1 + P2 + P3 + P4 + P5 + P6", data = ankiety[pelne, ], std.lv = TRUE)
lam <- inspect(m, "std")$lambda; th <- diag(inspect(m, "std")$theta)
round(c(omega = sum(lam)^2 / (sum(lam)^2 + sum(th))), 2)
Wynik w R
ile_brakow
  0   1   2
180  39   5
[1] 19.6
 n_pelne n_regula  M_pelne M_regula
  180.00   219.00     4.39     4.38
       n        M       SD       Me       Q1       Q3 skosnosc proc_max
  219.00     4.38     0.58     4.50     4.00     4.83    -1.03    18.26
alfa CI_d CI_g
0.86 0.83 0.89
   r.drop
P1   0.69
P2   0.73
P3   0.53
P4   0.66
P5   0.73
P6   0.74
omega
 0.88
3. Porównanie oddziałów: Kruskal–Wallis, Dunn, top-box i regresja porządkowa
R
# Porównanie oddziałów: test Kruskala–Wallisa z epsilon kwadrat i testem Dunna, top-box ogólnej oceny,
# regresja porządkowa. Korzysta z obiektu ankiety z przepisów 1–2.
suppressPackageStartupMessages(library(MASS))
d <- ankiety[!is.na(ankiety$skala), ]
round(t(sapply(split(d$skala, d$oddzial), function(x)
  c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
    Q3 = unname(quantile(x, .75)), proc_max = 100 * mean(x == 5)))), 2)

kw <- kruskal.test(skala ~ oddzial, data = d)
kw
round(c(epsilon2 = unname(kw$statistic) / (nrow(d) - 1)), 3)
rstatix::dunn_test(d, skala ~ oddzial, p.adjust.method = "holm")[, c("group1", "group2", "statistic", "p", "p.adj")]

# Pozycja P2 (czas reakcji na wezwanie) – tu różnica jest największa
kruskal.test(P2 ~ oddzial, data = ankiety)

# Top-box ogólnej oceny (P9 = 5) według oddziałów, 95% CI Wilsona
tb <- t(sapply(split(ankiety$P9, ankiety$oddzial), function(x) {
  x <- x[!is.na(x)]; k <- sum(x == 5)
  c(n = length(x), k = k, proc = 100 * k / length(x), prop.test(k, length(x), correct = FALSE)$conf.int * 100)
}))
colnames(tb)[4:5] <- c("CI_d", "CI_g"); round(tb, 1)
chisq.test(table(ankiety$oddzial, ankiety$P9 == 5))

# Regresja porządkowa (model proporcjonalnych szans) dla ogólnej oceny: oddział, wiek i płeć
ankiety$P9o <- factor(ankiety$P9, levels = 1:5, ordered = TRUE)
mp <- polr(P9o ~ oddzial + I(wiek / 10) + plec, data = ankiety, Hess = TRUE)
or <- exp(cbind(OR = coef(mp), confint.default(mp)[names(coef(mp)), ]))
round(or, 2)
round(2 * pnorm(-abs(coef(summary(mp))[names(coef(mp)), "t value"])), 3)
nobs(mp)
Wynik w R
             n    M   SD   Me   Q1   Q3 proc_max
interna     78 4.45 0.54 4.60 4.18 4.83    16.67
chirurgia   67 4.13 0.62 4.17 3.83 4.67    10.45
kardiologia 74 4.52 0.51 4.67 4.33 5.00    27.03

	Kruskal-Wallis rank sum test

data:  skala by oddzial
Kruskal-Wallis chi-squared = 17.983, df = 2, p-value = 0.0001245

epsilon2
   0.082
# A tibble: 3 × 5
  group1    group2      statistic         p    p.adj
  <chr>     <chr>           <dbl>     <dbl>    <dbl>
1 interna   chirurgia      -3.16  0.00157   0.00313
2 interna   kardiologia     0.988 0.323     0.323
3 chirurgia kardiologia     4.07  0.0000462 0.000139

	Kruskal-Wallis rank sum test

data:  P2 by oddzial
Kruskal-Wallis chi-squared = 21.775, df = 2, p-value = 1.869e-05

             n  k proc CI_d CI_g
interna     79 46 58.2 47.2 68.5
chirurgia   65 35 53.8 41.9 65.4
kardiologia 72 56 77.8 66.9 85.8

	Pearson's Chi-squared test

data:  table(ankiety$oddzial, ankiety$P9 == 5)
X-squared = 9.8847, df = 2, p-value = 0.007138

                     OR 2.5 % 97.5 %
oddzialchirurgia   0.83  0.43   1.59
oddzialkardiologia 2.29  1.13   4.66
I(wiek/10)         0.83  0.67   1.04
plecM              1.18  0.67   2.08
  oddzialchirurgia oddzialkardiologia         I(wiek/10)              plecM
             0.565              0.022              0.107              0.571
[1] 216
4. Pytanie otwarte: kategorie i zgodność koderek
R
# Pytanie otwarte „Co powinniśmy poprawić?”: częstości kategorii i zgodność dwóch koderek.
# Korzysta z obiektu ankiety z przepisu 1.
kom <- ankiety[!is.na(ankiety$kod_A), ]
round(c(n_komentarzy = nrow(kom), proc_osob = 100 * nrow(kom) / nrow(ankiety)), 1)
tab <- sort(table(kom$kod_A), decreasing = TRUE)
cbind(n = tab, proc = round(100 * tab / nrow(kom), 1))
round(100 * prop.table(table(kom$oddzial, kom$kod_A == "czas oczekiwania"), 1)[, "TRUE"], 1)

# Zgodność koderek: odsetek zgodnych decyzji i kappa Cohena z 95% CI
round(100 * mean(kom$kod_A == kom$kod_B), 1)
k <- psych::cohen.kappa(table(kom$kod_A, kom$kod_B))
round(k$confid["unweighted kappa", ], 2)
Wynik w R
n_komentarzy    proc_osob
        98.0         43.8
                   n proc
czas oczekiwania  39 39.8
cisza nocna       23 23.5
pochwała          15 15.3
informacja        11 11.2
posiłki i warunki 10 10.2
    interna   chirurgia kardiologia
       37.1        52.5        21.7
[1] 88.8
   lower estimate    upper
    0.77     0.85     0.93
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje prop.test(), chisq.test() i kruskal.test() z pakietu stats); plik do pobrania zapisano pakietem openxlsx, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizie ankiety satysfakcji
- Kod „nie dotyczy” policzony jako liczba. Kod 9 albo 0 w średniej daje wyniki bez sensu. Zamień go na brak oceny i podaj odsetek osobno.
- Same średnie pojedynczych pytań. Średnia 4.78 nie mówi, ile osób było naprawdę zadowolonych. Podaj rozkład albo „top-box” z przedziałem ufności.
- Odsetki bez mianownika. Napisz, od czego liczysz procent: od wszystkich ankiet, od osób, które odpowiedziały na pytanie, czy od osób, które wpisały komentarz.
- Przedział Walda dla odsetków bliskich 100%. Przy odsetkach 80–95% przedział Walda bywa zbyt wąski albo wychodzi poza 100%. Wybierz przedział Wilsona (Brown i in., 2001).
- Pominięty efekt sufitu. Gdy prawie wszyscy zaznaczają 5, brak różnic między grupami może wynikać z narzędzia, a nie z braku różnic w opiece. Podaj odsetek wyników maksymalnych.
- Wniosek o całym oddziale z 68% zwrotów. Bez informacji o osobach, które nie oddały ankiety, wnioski dotyczą osób odpowiadających.
- Dziewięć testów Kruskala–Wallisa bez korekty. Jeśli testujesz każdą pozycję, zastosuj korektę albo nazwij te analizy eksploracyjnymi.
- Tylko jeden koder pytań otwartych. Druga osoba i miara zgodności zwiększają wiarygodność kategorii. Wystarczy losowa część komentarzy.
- Wysoka satysfakcja jako dowód jakości opieki. Deklarowana satysfakcja zależy też od sformułowania pytań i aprobaty społecznej (Dunsch i in., 2018).
Jeśli masz już dane z ankiety i chcesz sprawdzić, czy dobrze zakodowałaś odpowiedzi i wybrałaś testy, możesz omówić analizę ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki w pracy musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć odsetek top-box w ankiecie satysfakcji?
Policz, ile osób wybrało najwyższą odpowiedź (np. 5 – „zdecydowanie tak”), i podziel przez liczbę osób, które odpowiedziały na to pytanie (bez „nie dotyczy” i braków). Podaj wynik z 95% przedziałem ufności Wilsona, np. 81.7%, 95% CI [76.1, 86.3]. Odsetek odpowiedzi 4 lub 5 to „top-two-box”.
Czy w ankiecie satysfakcji podawać średnią czy medianę?
Dla pojedynczych pytań podaj rozkład odpowiedzi, medianę i odsetek „top-box”, a średnią najwyżej obok. Przy skośnych rozkładach mediana często wynosi 5 i niewiele mówi. Dla wyniku skali (średniej kilku pytań) możesz podać M i SD, ale dodaj medianę, IQR i odsetek wyników maksymalnych.
Co zrobić z odpowiedzią „nie dotyczy” w ankiecie?
Zamień ją na brak oceny przed liczeniem średnich i odsetków, a w tabeli podaj osobno, ile osób ją wybrało. Nie traktuj jej jak środka skali ani jak zera. Pytań, na które duża część osób odpowiada „nie dotyczy”, nie włączaj do wyniku ogólnego skali.
Jak porównać satysfakcję pacjentów między oddziałami?
Przy trzech oddziałach lub więcej i skośnym wyniku skali wybierz test Kruskala–Wallisa z wielkością efektu ε² i testem Dunna z korektą Holma dla par. Gdy chcesz uwzględnić wiek lub płeć, użyj regresji porządkowej. Porównaj też odsetki „top-box” testem χ².
Co oznacza efekt sufitu w ankiecie satysfakcji?
Efekt sufitu występuje, gdy duża część osób uzyskuje najwyższy możliwy wynik, więc skala nie odróżnia osób bardzo zadowolonych od zachwyconych. Podaj dokładny odsetek wyników maksymalnych; często przyjmuje się umowny próg 15%. Sufit zaniża różnice między grupami, dlatego lepiej sprawdzają się metody rangowe i odsetki „top-box”.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Masz ankietę satysfakcji i nie wiesz, jak ją przeanalizować?
Pomożemy zakodować odpowiedzi, dobrać testy do skośnych danych i wyjaśnić wyniki tak, abyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Dunsch, F., Evans, D. K., Macis, M., & Wang, Q. (2018). Bias in patient satisfaction surveys: A threat to measuring healthcare quality. BMJ Global Health, 3(2), Article e000694. https://doi.org/10.1136/bmjgh-2017-000694 ● Otwarty dostęp
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- O’Connor, C., & Joffe, H. (2020). Intercoder reliability in qualitative research: Debates and practical guidelines. International Journal of Qualitative Methods, 19, Article 1609406919899220. https://doi.org/10.1177/1609406919899220 ● Otwarty dostęp
- Šimkovic, M., & Träuble, B. (2019). Robustness of statistical methods when measure is affected by ceiling and/or floor effect. PLOS ONE, 14(8), Article e0220889. https://doi.org/10.1371/journal.pone.0220889 ● Otwarty dostęp
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
- Williams, B. (1994). Patient satisfaction: A valid concept? Social Science & Medicine, 38(4), 509–516. https://doi.org/10.1016/0277-9536(94)90247-x
- Züll, C. (2016). Open-ended questions. GESIS – Leibniz Institute for the Social Sciences. https://doi.org/10.15465/gesis-sg_en_002 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{dunsch2018bias, author={Dunsch, Felipe and Evans, David K. and Macis, Mario and Wang, Qiao}, title={{Bias in patient satisfaction surveys: A threat to measuring healthcare quality}}, journal={BMJ Global Health}, year={2018}, volume={3}, number={2}, eid={e000694}, doi={10.1136/bmjgh-2017-000694}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{oconnor2020intercoder, author={O'Connor, Clíodhna and Joffe, Hélène}, title={{Intercoder reliability in qualitative research: Debates and practical guidelines}}, journal={International Journal of Qualitative Methods}, year={2020}, volume={19}, eid={1609406919899220}, doi={10.1177/1609406919899220}}@article{simkovic2019robustness, author={Šimkovic, Matúš and Träuble, Birgit}, title={{Robustness of statistical methods when measure is affected by ceiling and/or floor effect}}, journal={PLOS ONE}, year={2019}, volume={14}, number={8}, eid={e0220889}, doi={10.1371/journal.pone.0220889}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}@article{williams1994patient, author={Williams, Brian}, title={{Patient satisfaction: A valid concept?}}, journal={Social Science \& Medicine}, year={1994}, volume={38}, number={4}, pages={509--516}, doi={10.1016/0277-9536(94)90247-x}}@techreport{zull2016open, author={Züll, Cornelia}, title={{Open-ended questions}}, year={2016}, institution={GESIS – Leibniz Institute for the Social Sciences}, doi={10.15465/gesis-sg_en_002}}