Pięć typowych projektów w pracy z pielęgniarstwa
Prace licencjackie i magisterskie z pielęgniarstwa powtarzają kilka schematów. Najczęściej jest to badanie ankietowe przeprowadzone raz w grupie pacjentów, opiekunów albo personelu, czyli schemat przekrojowy. Rzadziej spotyka się badanie z pomiarem przed i po edukacji. Za każdym z tych schematów stoi inny zestaw analiz. Tabela poniżej porządkuje pięć projektów, które omawiamy w tym poradniku. Dla każdego znajdziesz przykład liczbowy, wielkość efektu i gotowe zdanie do pracy.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Poziom wiedzy | Od czego zależy wiedza pacjentów o chorobie? | wynik testu wiedzy, cechy pacjentów | test Welcha, ANOVA Welcha, korelacja Spearmana, regresja wieloraka | g, ω², ρ, R² |
| 2. Skale oceny stanu pacjenta | Czy ryzyko odleżyn różni się między oddziałami? | wyniki i kategorie skal klinicznych | chi-kwadrat, korelacja Spearmana | V Craméra, ρ |
| 3. Satysfakcja | Czy pacjenci dwóch oddziałów są równie zadowoleni? | pozycje Likerta, wynik skali | test Manna–Whitneya, odsetek odpowiedzi najwyższych | korelacja rangowo-dwuseryjna |
| 4. Edukacja przed i po | Czy wiedza wzrosła po szkoleniu? | ten sam test w dwóch pomiarach | test t dla prób zależnych albo Wilcoxona, McNemar | dz |
| 5. Obciążenie i wypalenie personelu | Czy liczba pacjentów na pielęgniarkę wiąże się z wyczerpaniem? | kwestionariusz personelu, cechy oddziałów | regresja z uwzględnieniem oddziałów (model wielopoziomowy) | b z 95% CI, ICC |
Ten wpis uzupełnia dwa poradniki dla innych zawodów medycznych: statystyka dla fizjoterapeuty (ból, funkcja, pomiar przed i po terapii) i statystyka dla lekarza (ryzyko, NNT, testy diagnostyczne). Wszystkie dane w przykładach są symulowane. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem zmiennych) i powtórzyć analizy w swoim programie.
Zanim zaczniesz liczyć: trzy decyzje
Po pierwsze, ustal, jakiego rodzaju jest każda zmienna. Wykształcenie i oddział to kategorie nominalne lub porządkowe. Kategoria ryzyka z podręcznika skali to skala porządkowa. Suma punktów testu wiedzy albo średnia z kilkunastu pozycji skali satysfakcji zwykle może być traktowana jako zmienna ilościowa. Sullivan i Artino (2013) przypominają, że pojedyncza pozycja skali Likerta jest porządkowa i lepiej opisywać ją medianą i rozkładem odpowiedzi. Wynik całej skali można natomiast analizować testami parametrycznymi, jeśli połączenie pozycji uzasadniają dowody rzetelności lub struktury. Jak policzyć taki wynik, pokazujemy w poradniku jak policzyć wynik kwestionariusza.
Po drugie, zapisz hipotezy, zanim zobaczysz dane. W pracach z pielęgniarstwa często zbiera się kilkadziesiąt zmiennych metryczkowych i testuje „wszystko ze wszystkim”. Przy 30 testach kilka wyników istotnych pojawi się nawet wtedy, gdy żaden związek nie istnieje. Wybierz 3–5 głównych pytań, a resztę opisz jako analizy eksploracyjne.
Po trzecie, sprawdź, czy obserwacje są niezależne. Jeśli badasz pielęgniarki z kilkunastu oddziałów albo pacjentów kilku lekarzy rodzinnych, osoby z tej samej jednostki są do siebie podobne. Zwykłe testy tego nie uwzględniają. Wracamy do tego w projekcie 5.
Formalności – zgoda komisji bioetycznej, zgoda dyrekcji placówki, świadoma zgoda uczestników i ochrona danych – zależą od regulaminu uczelni i miejsca badania. Sprawdź je u promotora i w komisji przed rozpoczęciem zbierania danych, bo zgody nie da się uzyskać wstecz.
Projekt 1. Poziom wiedzy pacjentów i jego uwarunkowania
Przykład: 180 pacjentów poradni z nadciśnieniem tętniczym rozwiązało autorski test wiedzy o chorobie (20 pytań, wynik 0–20). Zebrano też wiek, wykształcenie, czas od rozpoznania i informację, czy pacjent przeszedł wcześniej edukację prowadzoną przez pielęgniarkę. Średni wynik wyniósł 13.19 punktu (SD = 3.68, Me = 13), czyli 65.9% poprawnych odpowiedzi. Punktację testu, rzetelność KR-20 i analizę pozycji opisujemy osobno w poradniku ankieta wiedzy – analiza krok po kroku. Tutaj skupiamy się na pytaniu, od czego wiedza zależy.
Dwie grupy: test Welcha
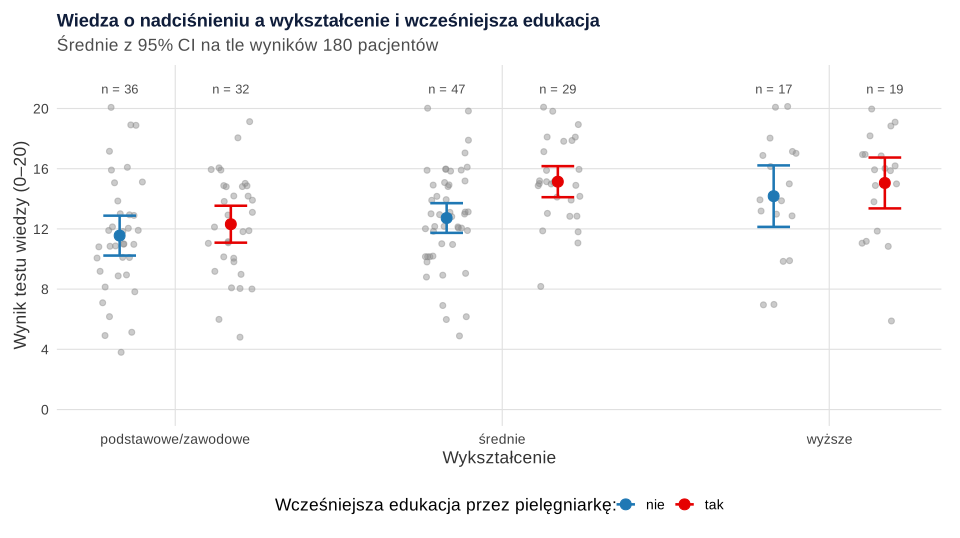
Osoby po wcześniejszej edukacji (n = 80) uzyskały średnio 13.99 punktu (SD = 3.44), a pozostałe (n = 100) – 12.55 punktu (SD = 3.75). Różnicę sprawdza test t Welcha, który nie zakłada równych wariancji: t(174.62) = 2.68, p = .008. Różnica wynosi 1.44 punktu, 95% CI [0.38, 2.50], a g Hedgesa = 0.40, 95% CI [0.10, 0.69]. Ostrożnie z interpretacją przyczynową. Pacjenci sami decydowali, czy skorzystają z edukacji, więc mogą różnić się motywacją i wykształceniem. Lakens (2013) pokazuje, jak liczyć i raportować wielkość efektu tak, aby wynik dało się porównać z innymi badaniami i wykorzystać w analizie mocy albo metaanalizie.
Trzy grupy: ANOVA Welcha albo test Kruskala–Wallisa
Średni wynik rósł z wykształceniem: 11.91 (podstawowe lub zawodowe, n = 68), 13.64 (średnie, n = 76) i 14.64 (wyższe, n = 36). ANOVA w wersji Welcha dała F(2, 91.13) = 7.51, p < .001, ω² = .12. Jeśli test jest krótki, a rozkład wyników wyraźnie skośny, wybierz test Kruskala–Wallisa: χ²(2) = 16.18, p < .001, ε² = .09. Po wyniku istotnym porównaj pary grup testem post hoc i podaj je w tabeli. Test rangowy i porównania parami pokazujemy krok po kroku w poradniku testy nieparametryczne krok po kroku.
Wiek: korelacja Spearmana
Związek wiedzy z wiekiem opisuje korelacja Spearmana: ρ = −.03, p = .645. W tej próbie wiek praktycznie nie wiązał się z wynikiem. Taki wynik też warto opisać, bo w wielu pracach przyjmuje się bez sprawdzenia, że starsi pacjenci wiedzą mniej.
Wszystkie czynniki razem: regresja wieloraka
Wykształcenie i wcześniejsza edukacja są ze sobą powiązane, więc osobne testy nie mówią, który czynnik „działa”. Odpowiedź przybliża regresja wieloraka z wszystkimi predyktorami naraz. Model wyjaśnił 13.8% wariancji wiedzy, F(5, 174) = 5.57, p < .001, R² = .138, skorygowane R² = .113.
| Predyktor | b | 95% CI | p |
|---|---|---|---|
| Wiek (lata) | −0.01 | [−0.06, 0.03] | .587 |
| Wykształcenie średnie (vs podstawowe/zawodowe) | 1.80 | [0.64, 2.95] | .002 |
| Wykształcenie wyższe (vs podstawowe/zawodowe) | 2.69 | [1.27, 4.10] | < .001 |
| Czas od rozpoznania (lata) | 0.08 | [−0.02, 0.18] | .101 |
| Wcześniejsza edukacja (tak vs nie) | 1.44 | [0.41, 2.47] | .007 |
Po uwzględnieniu wykształcenia, wieku i czasu choroby osoby po wcześniejszej edukacji miały wynik wyższy średnio o 1.44 punktu. To nadal związek, a nie dowód skuteczności edukacji. Pokazuje jednak, że różnicy z testu Welcha nie da się wyjaśnić samym wykształceniem. Zmienne kategorialne wprowadź do modelu jako zmienne zero-jedynkowe i napisz, która kategoria jest odniesieniem. Przed interpretacją sprawdź też założenia modelu, m.in. rozkład reszt i współliniowość predyktorów.
Częsty zwyczaj w pracach z pielęgniarstwa to zamiana wyniku na „niski, średni i wysoki poziom wiedzy” i liczenie testu chi-kwadrat. MacCallum i in. (2002) pokazali, że dzielenie zmiennej ilościowej na kategorie rzadko jest uzasadnione i często prowadzi do mylących wniosków. Poziomy możesz pokazać opisowo, ale testy licz na wyniku punktowym. Jak wyznaczyć poziomy, jeśli promotor ich wymaga, opisujemy w poradniku niski, przeciętny, wysoki wynik.
Projekt 2. Skale oceny stanu pacjenta: ryzyko odleżyn, samodzielność, ból, jakość życia
W pracach z pielęgniarstwa często wykorzystuje się standaryzowane skale oceny. Ocenia się nimi ryzyko odleżyn (np. skalą Braden), samodzielność w codziennych czynnościach (np. indeksem Barthel), natężenie bólu (np. skalą NRS) albo jakość życia. Bergstrom i in. (1987) opracowali skalę Braden z myślą o wczesnym rozpoznawaniu pacjentów zagrożonych odleżynami. Składa się ona z sześciu podskal, a autorzy sprawdzili jej rzetelność i trafność predykcyjną dla kolejnych punktów odcięcia. Collin i in. (1988) porównali cztery sposoby uzyskania wyniku indeksu Barthel, od samoopisu po ocenę dwóch niezależnych obserwatorów. Wyniki sumaryczne silnie ze sobą korelowały, a różnica 4 punktów w wersji 0–20 prawdopodobnie odzwierciedlała rzeczywistą różnicę w samodzielności. Przy skali NRS Farrar i in. (2001) powiązali spadek bólu o około 2 punkty albo o około 30% z poprawą, którą pacjenci oceniali jako istotną. Analizę skal bólu omawiamy w poradniku jak analizować skale bólu NRS i VAS.
Trzy zasady, które oszczędzą Ci poprawek:
- Wynik i kategorie licz według podręcznika lub publikacji autorów narzędzia i cytuj to źródło. Nie przepisuj pozycji skali do pracy ani do aneksu bez zgody właściciela praw. Wystarczy liczba pozycji, skala odpowiedzi i ogólny opis tego, czego dotyczą. Wzór opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór.
- Sprawdź warunki użycia polskiej wersji. Część narzędzi jest dostępna bezpłatnie do celów naukowych, a część dystrybuują wydawcy testów. Nie zakładaj, że skoro skala jest powszechnie stosowana w szpitalu, możesz ją dowolnie wykorzystać w pracy.
- Kategoria to nie diagnoza. Punkt odcięcia skali przesiewowej wskazuje osoby, które wymagają dokładniejszej oceny. W pracy pisz „wynik wskazujący na wysokie ryzyko”, a nie „pacjent z odleżyną” czy „pacjent zależny”.
Przykład: 150 pacjentów trzech oddziałów oceniono pod kątem ryzyka odleżyn (trzy kategorie według progów z podręcznika narzędzia), samodzielności (wskaźnik 0–100) i bólu w skali NRS (0–10).
| Oddział | Wysokie | Umiarkowane | Niskie lub brak |
|---|---|---|---|
| Internistyczny (n = 55) | 15 (27.3%) | 15 (27.3%) | 25 (45.5%) |
| Chirurgiczny (n = 50) | 8 (16.0%) | 17 (34.0%) | 25 (50.0%) |
| Opieka długoterminowa (n = 45) | 22 (48.9%) | 13 (28.9%) | 10 (22.2%) |
Związek oddziału z kategorią ryzyka sprawdza test chi-kwadrat niezależności: χ²(4) = 14.39, p = .006, V Craméra = .22. Najmniejsza liczebność oczekiwana wynosiła 13.5, więc warunek stosowania testu był spełniony. W oddziale opieki długoterminowej prawie połowa pacjentów miała wynik wskazujący na wysokie ryzyko. Odsetki podawaj w wierszach, czyli w obrębie oddziału, bo to one odpowiadają na pytanie badawcze. Samodzielność silnie korelowała z natężeniem bólu: ρ = −.64, p < .001. Pacjenci bardziej samodzielni zgłaszali mniejszy ból. Pamiętaj, że to badanie przekrojowe, więc kierunek zależności pozostaje nieznany.
Jeśli skalę wypełniają różne pielęgniarki, rzetelność oceny zależy także od osoby oceniającej. Zgodność kategorii sprawdzisz kappą, a wyników punktowych – ICC. Obie miary opisujemy w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa, a planowanie badania rzetelności pomiaru – w poradniku badanie rzetelności pomiaru klinicznego.
Projekt 3. Satysfakcja pacjentów z opieki pielęgniarskiej
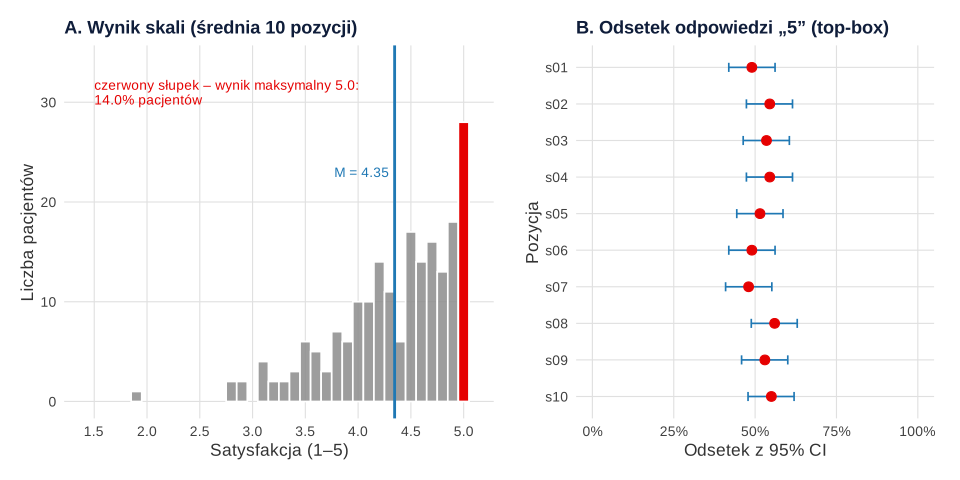
Ankiety satysfakcji mają jedną stałą cechę: wyniki są bardzo wysokie. W przykładzie 200 pacjentów dwóch oddziałów oceniło opiekę w 10 pozycjach od 1 do 5. Średnia z pozycji wyniosła 4.35 (SD = 0.58, Me = 4.50). Najwyższą możliwą ocenę we wszystkich pozycjach dało 14.0% pacjentów, a odpowiedź „5” stanowiła 52.4% wszystkich odpowiedzi. To efekt sufitu: skala słabo różnicuje osoby najbardziej zadowolone. Terwee i in. (2007) włączyli efekty podłogi i sufitu do kryteriów jakości kwestionariuszy zdrowotnych, obok rzetelności, trafności i responsywności.
Co z tego wynika dla analizy?
- Zamiast samej średniej podaj odsetek odpowiedzi najwyższych (top-box) z 95% CI dla każdej pozycji. Średnia 4.35 brzmi dobrze, ale nie mówi, w których obszarach pacjenci są mniej zadowoleni. Tu odsetek odpowiedzi „5” w pozycjach wahał się od 48.0% do 56.0%.
- Grupy porównuj testem rangowym, gdy rozkład jest silnie skośny. Na oddziale A mediana wyniosła 4.60 [4.20, 4.90], a na oddziale B 4.25 [3.88, 4.70]. Wynik testu Manna–Whitneya: W = 6274, p = .002, korelacja rangowo-dwuseryjna r = .25, 95% CI [.10, .40].
- Opisz sposób sformułowania pytań. Dunsch i in. (2018) w eksperymencie z udziałem ponad 2200 pacjentów pokazali, że twierdzenia sformułowane negatywnie dawały wyraźnie mniej deklaracji zadowolenia (87%) niż typowe twierdzenia pozytywne (95%). Wysoka satysfakcja z ankiety może więc zawyżać ocenę jakości opieki.
Pełną analizę ankiety satysfakcji, z wykresem skumulowanym, rzetelnością skali, brakami danych i kodowaniem pytań otwartych, opisujemy w poradniku analiza ankiety satysfakcji pacjentów.
Projekt 4. Edukacja zdrowotna z pomiarem przed i po
Pielęgniarki prowadzą edukację pacjentów i opiekunów, więc pytanie „czy wiedza wzrosła po szkoleniu” pojawia się w wielu pracach. Ten sam test rozwiązany przez te same osoby dwa razy wymaga analiz dla prób zależnych. Wynik sumaryczny porównasz testem t dla prób zależnych albo testem Wilcoxona, pojedyncze pytania – testem McNemara z korektą na wielokrotne porównania, a poziomy wiedzy – testem symetrii Bowkera. W przykładzie z poradnika badanie wiedzy przed i po szkoleniu 64 pacjentów rozpoczynających insulinoterapię poprawiło wynik testu z 6.59 do 8.84 punktu na 12 (t(63) = 7.96, p < .001, dz = 1.00). Tam pokazujemy wszystkie kroki z kodem R, także pomiar odroczony po trzech miesiącach.
Najważniejsze zastrzeżenie dotyczy schematu. Bez grupy porównawczej wzrostu nie przypiszesz wyłącznie edukacji, bo ten sam efekt dają ponowne rozwiązanie testu i regresja do średniej. W pracy napisz więc, że „wyniki po edukacji były wyższe”, a nie że „edukacja okazała się skuteczna”.
Projekt 5. Obciążenie pracą i wypalenie personelu pielęgniarskiego
Badania personelu pielęgniarskiego dotyczą najczęściej obciążenia pracą, stresu zawodowego i wypalenia. Maslach i Leiter (2016) przypominają, że większość badań nad wypaleniem prowadzono w zawodach pomocowych, zwłaszcza w ochronie zdrowia, a wciąż brakuje rzetelnych ocen interwencji, które miałyby mu zapobiegać. Do pomiaru wypalenia służą narzędzia licencjonowane. Ich użycie wymaga zwykle zakupu lub zgody wydawcy, także w pracy dyplomowej. Zanim wpiszesz narzędzie do projektu, sprawdź warunki licencji i to, czy uczelnia ma do niego dostęp. W przykładzie posługujemy się więc ogólnym, symulowanym wynikiem skali wyczerpania (średnia pozycji 1–5), bez odwoływania się do konkretnego kwestionariusza.
Przykład: 168 pielęgniarek z 12 oddziałów (po 14 z każdego). Zebrano wynik skali wyczerpania, informację o pracy zmianowej, staż pracy i średnią liczbę pacjentów przypadających na pielęgniarkę w oddziale. Ostatnia zmienna jest cechą oddziału, a nie osoby: wszystkie pielęgniarki z jednego oddziału mają tę samą wartość.
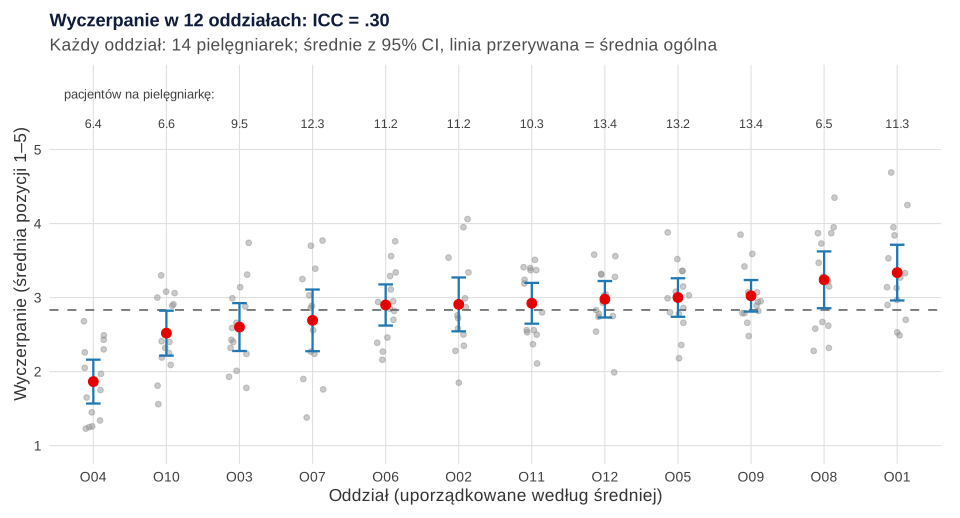
Średnie oddziałów różnią się wyraźnie. Korelacja wewnątrzklasowa z modelu pustego wynosi .30, co oznacza, że 30% zmienności wyczerpania przypada na różnice między oddziałami. Przy 14 osobach w oddziale efekt schematu wynosi 4.85. Pod względem precyzji szacowania 168 pielęgniarek odpowiada więc mniej więcej 35 niezależnym osobom.
Zobacz, co to oznacza dla wniosków. W zwykłej regresji liczba pacjentów na pielęgniarkę wiąże się z wyczerpaniem: b = 0.07, SE = 0.02, p < .001. W modelu wielopoziomowym z losowym wyrazem wolnym dla oddziału oszacowanie jest takie samo (b = 0.07), ale błąd standardowy jest ponad dwa razy większy: SE = 0.04, p = .128, 95% CI [−0.01, 0.15]. Zwykła regresja „liczy” 168 niezależnych obserwacji, podczas gdy informację o obciążeniu niesie tylko 12 oddziałów. Hox i in. (2017) opisują, jak w takich danych rozdzielić zmienność między poziomy i jak interpretować predyktory każdego poziomu. Procedurę krok po kroku pokazujemy w poradniku model wielopoziomowy krok po kroku.
Jeśli masz tylko kilka oddziałów, model wielopoziomowy nie oszacuje dobrze wariancji między nimi. Wtedy wprowadź oddział jako zmienną kontrolną i nie formułuj wniosków o cechach oddziałów. W badaniach personelu pamiętaj też, że wszystkie zmienne pochodzą zwykle z jednego kwestionariusza wypełnionego przez tę samą osobę. To zawyża korelacje (zob. wspólna wariancja metody), więc tam, gdzie to możliwe, korzystaj z danych obiektywnych, np. grafików i obsady zmian.
Wielkość efektu i zapis APA: ściąga
Promotorzy i recenzenci coraz częściej pytają nie tylko o to, czy wynik jest istotny, lecz także o to, jak duży jest efekt. Tabela zbiera miary z przykładów w tym wpisie.
| Analiza | Wielkość efektu | Przykład zapisu |
|---|---|---|
| Test t Welcha | g Hedgesa z 95% CI | t(174.62) = 2.68, p = .008, g = 0.40, 95% CI [0.10, 0.69] |
| ANOVA Welcha | ω² | F(2, 91.13) = 7.51, p < .001, ω² = .12 |
| Test Kruskala–Wallisa | ε² | χ²(2) = 16.18, p < .001, ε² = .09 |
| Korelacja Spearmana | ρ | ρ = −.64, p < .001 |
| Chi-kwadrat niezależności | V Craméra | χ²(4) = 14.39, p = .006, V = .22 |
| Test Manna–Whitneya | korelacja rangowo-dwuseryjna | W = 6274, p = .002, r = .25, 95% CI [.10, .40] |
| Test t dla prób zależnych | dz z 95% CI | t(63) = 7.96, p < .001, dz = 1.00, 95% CI [0.70, 1.29] |
| Regresja wieloraka | R², b z 95% CI | R² = .138, F(5, 174) = 5.57, p < .001 |
Zapisuj p dokładnie do trzech miejsc po kropce, a poniżej .001 jako „p < .001”. Wartości, które nie mogą przekroczyć 1 (p, r, ρ, V, ω²), podawaj bez zera przed kropką. Przy każdym teście dopisz też kierunek wyniku słowami, np. „wyższy wynik u osób po edukacji”.
Co opisać w metodzie: wytyczne STROBE i CROSS
Większość prac z pielęgniarstwa to badania obserwacyjne albo ankietowe. Dla obu typów istnieją listy kontrolne, które pomagają niczego nie pominąć. Lista STROBE dla badań obserwacyjnych ma 22 punkty dotyczące tytułu i streszczenia, wstępu, metod, wyników i dyskusji (von Elm i in., 2007). Lista CROSS dla badań ankietowych ma 40 punktów, m.in. opis kwestionariusza, jego pretestu i sposobu doboru próby (Sharma i in., 2021). Nie musisz odhaczać każdego punktu, ale dzięki nim sprawdzisz, czy opisałeś:
- miejsce i czas badania, kryteria włączenia i wyłączenia oraz sposób rekrutacji;
- liczbę osób zaproszonych, które odmówiły udziału, i tych, które weszły do analizy;
- każde narzędzie: autorów, liczbę pozycji, skalę odpowiedzi, sposób liczenia wyniku i źródło progów;
- postępowanie z brakami danych;
- analizy statystyczne, program i poziom istotności.
Jeśli potrzebujesz pomocy w doborze analiz do swojego projektu albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza liczby z projektów 1, 2, 3 i 5 oraz rysunki. Liczby z projektu 4 pochodzą z kodu w poradniku o badaniu wiedzy przed i po szkoleniu. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Ostatni przepis zapisuje też plik XLSX do pobrania. Wielkości efektu liczy pakiet effectsize, a model wielopoziomowy – pakiety lme4 i lmerTest.
1. Projekt 1: wiedza pacjentów – test Welcha, ANOVA Welcha, Kruskal–Wallis, Spearman i regresja
R
# Projekt 1: poziom wiedzy pacjentów z nadciśnieniem tętniczym i jego uwarunkowania (dane symulowane).
# 180 pacjentów poradni; autorski test wiedzy 0–20 pkt; wiek, wykształcenie, czas trwania choroby
# i to, czy pacjent przeszedł wcześniej edukację prowadzoną przez pielęgniarkę.
suppressPackageStartupMessages({ library(effectsize); library(openxlsx) })
set.seed(5401)
n <- 180
wyksztalcenie <- factor(sample(c("podstawowe/zawodowe", "średnie", "wyższe"), n, TRUE, prob = c(.35, .40, .25)),
                        levels = c("podstawowe/zawodowe", "średnie", "wyższe"))
wiek <- round(pmin(88, pmax(35, rnorm(n, 63, 11))))
staz <- round(pmax(0, rgamma(n, shape = 2, scale = 4)), 0)          # lata od rozpoznania
edukacja <- factor(ifelse(runif(n) < .45, "tak", "nie"), levels = c("nie", "tak"))
lp <- 10.5 + c(0, 1.6, 2.8)[as.integer(wyksztalcenie)] - 0.05 * (wiek - 63) + 0.10 * staz + 1.5 * (edukacja == "tak")
wiedza <- pmin(20, pmax(0, round(lp + rnorm(n, 0, 3.2))))
p1 <- data.frame(id = 1:n, wiek, wyksztalcenie, staz_lata = staz, edukacja_wczesniej = edukacja, wiedza)

round(c(M = mean(p1$wiedza), SD = sd(p1$wiedza), Me = median(p1$wiedza), proc = 100 * mean(p1$wiedza) / 20), 2)
round(tapply(p1$wiedza, p1$wyksztalcenie, function(x) c(n = length(x), M = mean(x), SD = sd(x))) |> simplify2array() |> t(), 2)
# Dwie grupy: test t Welcha i g Hedgesa
t.test(wiedza ~ edukacja_wczesniej, data = p1)
round(tapply(p1$wiedza, p1$edukacja_wczesniej, function(x) c(n = length(x), M = mean(x), SD = sd(x))) |> simplify2array() |> t(), 2)
g <- hedges_g(wiedza ~ edukacja_wczesniej, data = p1, pooled_sd = FALSE); round(unlist(as.data.frame(g)[, c(1, 3, 4)]), 2)
# Trzy grupy: ANOVA Welcha i ω² oraz – dla porównania – test Kruskala–Wallisa z ε²
w <- oneway.test(wiedza ~ wyksztalcenie, data = p1); w
om <- F_to_omega2(w$statistic, w$parameter[1], w$parameter[2]); round(unlist(as.data.frame(om)[, c(1, 3, 4)]), 2)
kruskal.test(wiedza ~ wyksztalcenie, data = p1)
eps <- rank_epsilon_squared(wiedza ~ wyksztalcenie, data = p1); round(unlist(as.data.frame(eps)[, c(1, 3, 4)]), 2)
# Związek z wiekiem: korelacja Spearmana
cor.test(p1$wiedza, p1$wiek, method = "spearman", exact = FALSE)
# Wszystkie czynniki razem: regresja liniowa wieloraka
m1 <- lm(wiedza ~ wiek + wyksztalcenie + staz_lata + edukacja_wczesniej, data = p1)
round(cbind(b = coef(m1), confint(m1), p = summary(m1)$coefficients[, 4]), 3)
s <- summary(m1); round(c(R2 = s$r.squared, R2_skor = s$adj.r.squared, F = unname(s$fstatistic[1]),
                          df1 = unname(s$fstatistic[2]), df2 = unname(s$fstatistic[3]),
                          p = pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE)), 3)
Wynik w R
    M    SD    Me  proc
13.19  3.68 13.00 65.94
                     n     M   SD
podstawowe/zawodowe 68 11.91 3.68
średnie             76 13.64 3.33
wyższe              36 14.64 3.70

	Welch Two Sample t-test

data:  wiedza by edukacja_wczesniej
t = -2.6767, df = 174.62, p-value = 0.008144
alternative hypothesis: true difference in means between group nie and group tak is not equal to 0
95 percent confidence interval:
 -2.4974412 -0.3775588
sample estimates:
mean in group nie mean in group tak
          12.5500           13.9875

      n     M   SD
nie 100 12.55 3.75
tak  80 13.99 3.44
Hedges_g   CI_low  CI_high
   -0.40    -0.69    -0.10

	One-way analysis of means (not assuming equal variances)

data:  wiedza and wyksztalcenie
F = 7.5113, num df = 2.000, denom df = 91.127, p-value = 0.000956

Omega2_partial         CI_low        CI_high
          0.12           0.03           1.00

	Kruskal-Wallis rank sum test

data:  wiedza by wyksztalcenie
Kruskal-Wallis chi-squared = 16.184, df = 2, p-value = 0.000306

rank_epsilon_squared               CI_low              CI_high
                0.09                 0.03                 1.00

	Spearman's rank correlation rho

data:  p1$wiedza and p1$wiek
S = 1005622, p-value = 0.6445
alternative hypothesis: true rho is not equal to 0
sample estimates:
        rho
-0.03462218

                           b  2.5 % 97.5 %     p
(Intercept)           11.432  8.139 14.725 0.000
wiek                  -0.013 -0.060  0.034 0.587
wyksztalcenieśrednie   1.795  0.643  2.946 0.002
wyksztalceniewyższe    2.686  1.273  4.099 0.000
staz_lata              0.081 -0.016  0.177 0.101
edukacja_wczesniejtak  1.437  0.405  2.470 0.007
     R2 R2_skor       F     df1     df2 p.value
  0.138   0.113   5.569   5.000 174.000   0.000
2. Projekty 2 i 3: skale oceny stanu pacjenta i satysfakcja
R
# Projekt 2: skale oceny stanu pacjenta (dane symulowane, narzędzia opisane ogólnie).
# 150 pacjentów trzech oddziałów; kategoria ryzyka odleżyn (wyznaczona wg progów z podręcznika narzędzia),
# wskaźnik samodzielności 0–100 (wyższy = większa samodzielność) i natężenie bólu w skali NRS 0–10.
set.seed(5402)
n2 <- 150
oddzial <- factor(rep(c("internistyczny", "chirurgiczny", "opieka długoterminowa"), c(55, 50, 45)),
                  levels = c("internistyczny", "chirurgiczny", "opieka długoterminowa"))
z <- rnorm(n2) - c(0, -0.3, 1.0)[as.integer(oddzial)]               # ukryta sprawność
samodzielnosc <- round(pmin(100, pmax(0, 62 + 22 * z)) / 5) * 5
ryzyko <- cut(z + rnorm(n2, 0, .7), c(-Inf, -0.9, 0.2, Inf), labels = c("wysokie", "umiarkowane", "niskie/brak"))
bol <- pmin(10, pmax(0, round(4 - 0.9 * z + rnorm(n2, 0, 1.8))))
p2 <- data.frame(id = 1:n2, oddzial, ryzyko_odlezyn = ryzyko, samodzielnosc, bol_NRS = bol)
tab <- table(p2$oddzial, p2$ryzyko_odlezyn); tab
round(100 * prop.table(tab, 1), 1)
chi <- chisq.test(tab); chi; round(chi$expected, 1)
round(unlist(as.data.frame(effectsize::cramers_v(tab, adjust = FALSE))[, c(1, 3, 4)]), 2)
cor.test(p2$samodzielnosc, p2$bol_NRS, method = "spearman", exact = FALSE)

# Projekt 3: satysfakcja z opieki pielęgniarskiej – 10 pozycji 1–5 (dane symulowane), dwa oddziały
set.seed(5403)
n3 <- 200
odd3 <- factor(rep(c("A", "B"), each = 100))
cecha <- rnorm(n3, ifelse(odd3 == "A", 1.35, 1.05), .9)
pozycje <- sapply(1:10, function(j) pmin(5, pmax(1, round(3.4 + cecha + rnorm(n3, 0, .75)))))
p3 <- data.frame(id = 1:n3, oddzial = odd3, pozycje); names(p3)[3:12] <- sprintf("s%02d", 1:10)
p3$satysfakcja <- rowMeans(pozycje)
round(c(M = mean(p3$satysfakcja), SD = sd(p3$satysfakcja), Me = median(p3$satysfakcja),
        proc_wynik_max = 100 * mean(p3$satysfakcja == 5), proc_top_box_pozycji = 100 * mean(pozycje == 5)), 2)
round(100 * colMeans(pozycje == 5), 1)                              # top-box w każdej pozycji
round(tapply(p3$satysfakcja, p3$oddzial, function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)))) |> simplify2array() |> t(), 2)
wilcox.test(satysfakcja ~ oddzial, data = p3, exact = FALSE)
round(unlist(as.data.frame(effectsize::rank_biserial(satysfakcja ~ oddzial, data = p3))[, c(1, 3, 4)]), 2)
Wynik w R
                        wysokie umiarkowane niskie/brak
  internistyczny             15          15          25
  chirurgiczny                8          17          25
  opieka długoterminowa      22          13          10

                        wysokie umiarkowane niskie/brak
  internistyczny           27.3        27.3        45.5
  chirurgiczny             16.0        34.0        50.0
  opieka długoterminowa    48.9        28.9        22.2

	Pearson's Chi-squared test

data:  tab
X-squared = 14.391, df = 4, p-value = 0.006146


                        wysokie umiarkowane niskie/brak
  internistyczny           16.5        16.5          22
  chirurgiczny             15.0        15.0          20
  opieka długoterminowa    13.5        13.5          18
Cramers_v    CI_low   CI_high
     0.22      0.09      1.00

	Spearman's rank correlation rho

data:  p2$samodzielnosc and p2$bol_NRS
S = 922393, p-value < 2.2e-16
alternative hypothesis: true rho is not equal to 0
sample estimates:
       rho
-0.6398823

                   M                   SD                   Me       proc_wynik_max proc_top_box_pozycji
                4.35                 0.58                 4.50                14.00                52.40
 [1] 49.0 54.5 53.5 54.5 51.5 49.0 48.0 56.0 53.0 55.0
    Me   Q1  Q3
A 4.60 4.20 4.9
B 4.25 3.88 4.7

	Wilcoxon rank sum test with continuity correction

data:  satysfakcja by oddzial
W = 6274, p-value = 0.001801
alternative hypothesis: true location shift is not equal to 0

r_rank_biserial          CI_low         CI_high
           0.25            0.10            0.40
3. Projekt 5: pielęgniarki w oddziałach – ICC, efekt schematu i model wielopoziomowy
R
# Projekt 5: obciążenie pracą i wyczerpanie personelu – pielęgniarki zagnieżdżone w oddziałach (dane symulowane).
# 168 pielęgniarek z 12 oddziałów; wynik skali wyczerpania jako średnia pozycji 1–5 (narzędzie licencjonowane,
# tu tylko symulowany wynik), praca zmianowa (tak/nie), staż pracy i liczba pacjentów na pielęgniarkę (cecha oddziału).
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(openxlsx) })
set.seed(5404)
J <- 12; m <- 14
odd <- data.frame(oddzial = sprintf("O%02d", 1:J), pacjenci_na_piel = round(runif(J, 6, 14), 1))
odd$u <- rnorm(J, 0, .32)
p5 <- odd[rep(1:J, each = m), ]
p5$zmianowa <- factor(ifelse(runif(J * m) < .7, "tak", "nie"), levels = c("nie", "tak"))
p5$staz <- round(pmax(1, rnorm(J * m, 16, 9)))
p5$wyczerpanie <- round(pmin(5, pmax(1, 1.75 + 0.09 * p5$pacjenci_na_piel + 0.25 * (p5$zmianowa == "tak") +
                               0.008 * p5$staz + p5$u + rnorm(J * m, 0, .55))), 2)
p5$u <- NULL; p5$id <- seq_len(nrow(p5))
round(c(M = mean(p5$wyczerpanie), SD = sd(p5$wyczerpanie)), 2)
m0 <- lmer(wyczerpanie ~ 1 + (1 | oddzial), data = p5)
vc <- as.data.frame(VarCorr(m0)); icc <- vc$vcov[1] / sum(vc$vcov)
round(c(ICC = icc, efekt_schematu = 1 + (m - 1) * icc, n_efektywne = nrow(p5) / (1 + (m - 1) * icc)), 2)
# Ten sam model regresji bez i z uwzględnieniem oddziałów
ols <- lm(wyczerpanie ~ pacjenci_na_piel + zmianowa + staz, data = p5)
mm  <- lmer(wyczerpanie ~ pacjenci_na_piel + zmianowa + staz + (1 | oddzial), data = p5)
round(summary(ols)$coefficients, 3)
round(summary(mm)$coefficients, 3)
round(confint(mm, parm = "pacjenci_na_piel", method = "Wald"), 3)

# Plik do pobrania: dane czterech projektów (autor w metadanych: Metodolog.pl)
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z pielęgniarstwa – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
for (ark in list(list("1_wiedza_pacjentow", p1), list("2_skale_oceny", p2), list("3_satysfakcja", p3), list("5_personel", p5[, c("id", "oddzial", "pacjenci_na_piel", "zmianowa", "staz", "wyczerpanie")]))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); freezePane(wb, ark[[1]], firstRow = TRUE) }
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 5401–5404) – metodolog.pl, wpis „Statystyka w pracy z pielęgniarstwa”.",
                       "1_wiedza_pacjentow: wiedza = wynik autorskiego testu 0–20; staz_lata = lata od rozpoznania nadciśnienia.",
                       "2_skale_oceny: ryzyko_odlezyn = kategoria wg progów z podręcznika narzędzia; samodzielnosc 0–100; bol_NRS 0–10.",
                       "3_satysfakcja: s01–s10 = pozycje 1–5; satysfakcja = średnia pozycji.",
                       "5_personel: wyczerpanie = średnia pozycji 1–5; pacjenci_na_piel = cecha oddziału."))
saveWorkbook(wb, "../statystyka-pielegniarstwo-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-pielegniarstwo-dane-przyklad.xlsx"); spr
sapply(spr[1:4], function(a) nrow(readxl::read_excel("../statystyka-pielegniarstwo-dane-przyklad.xlsx", sheet = a)))
Wynik w R
   M   SD
2.83 0.65
           ICC efekt_schematu    n_efektywne
          0.30           4.85          34.65
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)         2.061      0.233   8.836    0.000
pacjenci_na_piel    0.068      0.019   3.577    0.000
zmianowatak         0.137      0.106   1.291    0.199
staz               -0.002      0.005  -0.372    0.711
                 Estimate Std. Error      df t value Pr(>|t|)
(Intercept)         1.953      0.452  11.000   4.318    0.001
pacjenci_na_piel    0.068      0.041   9.912   1.662    0.128
zmianowatak         0.161      0.095 156.712   1.696    0.092
staz                0.003      0.005 159.377   0.684    0.495
                  2.5 % 97.5 %
pacjenci_na_piel -0.012  0.148
[1] "1_wiedza_pacjentow" "2_skale_oceny"      "3_satysfakcja"      "5_personel"         "opis"
1_wiedza_pacjentow      2_skale_oceny      3_satysfakcja         5_personel
               180                150                200                168
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), oneway.test(), kruskal.test(), cor.test(), chisq.test(), wilcox.test() i lm() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizach prac z pielęgniarstwa
- Kilkadziesiąt testów bez hipotez. Każda zmienna metryczkowa „przetestowana” z każdym wynikiem daje przypadkowe istotności. Wybierz główne pytania przed analizą.
- Średnia z pojedynczej pozycji Likerta jako jedyny opis. Podaj rozkład odpowiedzi albo odsetek odpowiedzi najwyższych, a średnią licz dla całej skali.
- Poziomy wiedzy zamiast wyniku punktowego jako podstawa testów. Dzielenie wyniku na kategorie traci informację (MacCallum i in., 2002).
- Punkt odcięcia skali klinicznej z nieznanego źródła albo opis kategorii jako rozpoznania. Progi bierz z publikacji autorów narzędzia i nazywaj je wynikami przesiewowymi.
- Przedruk pozycji licencjonowanego narzędzia w aneksie pracy bez zgody właściciela praw.
- Ignorowanie oddziałów w badaniach personelu. Przy wysokim ICC zwykła regresja daje zbyt małe p.
- Wnioski przyczynowe z badania przekrojowego, np. „edukacja zwiększa wiedzę” na podstawie porównania osób, które same wybrały udział w edukacji.
- Brak wielkości efektu i przedziałów ufności przy wynikach testów.
- „Przed i po” bez grupy kontrolnej opisane jako dowód skuteczności szkolenia albo interwencji pielęgniarskiej.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy licencjackiej z pielęgniarstwa?
Zależy to od pytania i rodzaju danych. Dwie grupy porównaj testem t Welcha albo testem Manna–Whitneya, trzy i więcej – ANOVA Welcha albo testem Kruskala–Wallisa, związek dwóch zmiennych ilościowych lub porządkowych – korelacją Spearmana, a dwóch zmiennych kategorialnych – testem chi-kwadrat z V Craméra. Gdy chcesz ocenić kilka czynników naraz, użyj regresji wielorakiej.
Jak analizować wyniki skali Braden lub indeksu Barthel w pracy?
Policz wynik i kategorie dokładnie według publikacji autorów narzędzia albo podręcznika i zacytuj to źródło. Wynik punktowy analizuj testami dla zmiennych ilościowych lub rangowymi, a kategorie – w tabeli krzyżowej testem chi-kwadrat. Nie przedrukowuj pozycji skali i opisuj kategorie jako wynik przesiewowy, a nie diagnozę.
Dlaczego w ankiecie satysfakcji pacjentów prawie wszyscy są zadowoleni?
Ankiety satysfakcji mają zwykle silny efekt sufitu: wielu pacjentów wybiera najwyższe odpowiedzi, a na wynik wpływa też sposób sformułowania pytań. Dlatego obok średniej podaj odsetek odpowiedzi najwyższych z przedziałem ufności, grupy porównuj testem rangowym i opisz w ograniczeniach, że skala słabo różnicuje osoby najbardziej zadowolone.
Jak uwzględnić oddziały w badaniu pielęgniarek z kilku oddziałów?
Pielęgniarki z jednego oddziału są do siebie podobne, więc ich wyniki nie są niezależne. Policz korelację wewnątrzklasową (ICC) i, gdy oddziałów jest kilkanaście lub więcej, użyj modelu wielopoziomowego z losowym wyrazem wolnym dla oddziału. Przy kilku oddziałach wprowadź oddział jako zmienną kontrolną i nie wyciągaj wniosków o cechach oddziałów.
Czy w pracy z pielęgniarstwa można użyć kwestionariusza wypalenia zawodowego?
Tak, ale najpopularniejsze narzędzia do pomiaru wypalenia są licencjonowane, a ich użycie wymaga zwykle zakupu lub zgody wydawcy, także w pracy dyplomowej. Przed zaplanowaniem badania sprawdź warunki licencji i dostęp przez uczelnię, nie przedrukowuj pozycji w aneksie i opisz narzędzie według podręcznika.
Powiązane hasła
Przeczytaj też
Badanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikAnaliza ankiety satysfakcji pacjentów
Rozkład pozycji Likerta, top-box z 95% CI, alfa i omega, efekt sufitu, porównanie oddziałów, pytania otwarte – z danymi do pobrania, kodem R i opisem APA.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →Piszesz pracę z pielęgniarstwa i nie wiesz, jakie analizy wybrać?
Pomożemy dobrać testy do Twojego projektu, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bergstrom, N., Braden, B. J., Laguzza, A., & Holman, V. (1987). The Braden Scale for predicting pressure sore risk. Nursing Research, 36(4), 205–210. https://doi.org/10.1097/00006199-198707000-00002
- Collin, C., Wade, D. T., Davies, S., & Horne, V. (1988). The Barthel ADL Index: A reliability study. International Disability Studies, 10(2), 61–63. https://doi.org/10.3109/09638288809164103
- Dunsch, F., Evans, D. K., Macis, M., & Wang, Q. (2018). Bias in patient satisfaction surveys: A threat to measuring healthcare quality. BMJ Global Health, 3(2), Article e000694. https://doi.org/10.1136/bmjgh-2017-000694 ● Otwarty dostęp
- Farrar, J. T., Young, J. P., Jr., LaMoreaux, L., Werth, J. L., & Poole, R. M. (2001). Clinical importance of changes in chronic pain intensity measured on an 11-point numerical pain rating scale. Pain, 94(2), 149–158. https://doi.org/10.1016/s0304-3959(01)00349-9
- Hox, J. J., Moerbeek, M., & van de Schoot, R. (2017). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Maslach, C., & Leiter, M. P. (2016). Understanding the burnout experience: Recent research and its implications for psychiatry. World Psychiatry, 15(2), 103–111. https://doi.org/10.1002/wps.20311 ● Otwarty dostęp
- Sharma, A., Minh Duc, N. T., Luu Lam Thang, T., Nam, N. H., Ng, S. J., Abbas, K. S., Huy, N. T., Marušić, A., Paul, C. L., Kwok, J., Karbwang, J., de Waure, C., Drummond, F. J., Kizawa, Y., Taal, E., Vermeulen, J., Lee, G. H. M., Gyedu, A., To, K. G., . . . Karamouzian, M. (2021). A consensus-based Checklist for Reporting of Survey Studies (CROSS). Journal of General Internal Medicine, 36(10), 3179–3187. https://doi.org/10.1007/s11606-021-06737-1 ● Otwarty dostęp
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@article{bergstrom1987braden, author={Bergstrom, Nancy and Braden, Barbara J. and Laguzza, Antoinette and Holman, Victoria}, title={{The Braden Scale for predicting pressure sore risk}}, journal={Nursing Research}, year={1987}, volume={36}, number={4}, pages={205--210}, doi={10.1097/00006199-198707000-00002}}@article{collin1988barthel, author={Collin, C. and Wade, D. T. and Davies, S. and Horne, V.}, title={{The Barthel ADL Index: A reliability study}}, journal={International Disability Studies}, year={1988}, volume={10}, number={2}, pages={61--63}, doi={10.3109/09638288809164103}}@article{dunsch2018bias, author={Dunsch, Felipe and Evans, David K. and Macis, Mario and Wang, Qiao}, title={{Bias in patient satisfaction surveys: A threat to measuring healthcare quality}}, journal={BMJ Global Health}, year={2018}, volume={3}, number={2}, eid={e000694}, doi={10.1136/bmjgh-2017-000694}}@article{farrar2001clinical, author={Farrar, John T. and Young, James P., Jr. and LaMoreaux, Linda and Werth, John L. and Poole, Michael R.}, title={{Clinical importance of changes in chronic pain intensity measured on an 11-point numerical pain rating scale}}, journal={Pain}, year={2001}, volume={94}, number={2}, pages={149--158}, doi={10.1016/s0304-3959(01)00349-9}}@book{hox2017multilevel, author={Hox, Joop J. and Moerbeek, Mirjam and van de Schoot, Rens}, title={{Multilevel analysis: Techniques and applications (3rd ed.)}}, year={2017}, publisher={Routledge}, doi={10.4324/9781315650982}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{maslach2016understanding, author={Maslach, Christina and Leiter, Michael P.}, title={{Understanding the burnout experience: Recent research and its implications for psychiatry}}, journal={World Psychiatry}, year={2016}, volume={15}, number={2}, pages={103--111}, doi={10.1002/wps.20311}}@article{sharma2021consensus, author={Sharma, Akash and Minh Duc, Nguyen Tran and Luu Lam Thang, Tai and Nam, Nguyen Hai and Ng, Sze Jia and Abbas, Kirellos Said and Huy, Nguyen Tien and Marušić, Ana and Paul, Christine L. and Kwok, Janette and Karbwang, Juntra and de Waure, Chiara and Drummond, Frances J. and Kizawa, Yoshiyuki and Taal, Erik and Vermeulen, Joeri and Lee, Gillian H. M. and Gyedu, Adam and To, Kien Gia and Verra, Martin L. and Jacqz-Aigrain, Évelyne M. and Leclercq, Wouter K. G. and Salminen, Simo T. and Sherbourne, Cathy Donald and Mintzes, Barbara and Lozano, Sergi and Tran, Ulrich S. and Matsui, Mitsuaki and Karamouzian, Mohammad}, title={{A consensus-based Checklist for Reporting of Survey Studies (CROSS)}}, journal={Journal of General Internal Medicine}, year={2021}, volume={36}, number={10}, pages={3179--3187}, doi={10.1007/s11606-021-06737-1}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}