Rzetelność czy zgodność: dwa pytania o ten sam pomiar
Goniometr, dynamometr ręczny, inklinometr w smartfonie czy test „wstań i idź” dają liczbę, którą łatwo zapisać w karcie pacjenta. Trudniej odpowiedzieć na pytanie, ile ta liczba jest warta. Badanie rzetelności pomiaru klinicznego odpowiada na nie w dwóch krokach, które w literaturze często się myli.
- Rzetelność (ang. reliability) mówi, czy mimo błędu pomiaru da się odróżnić od siebie osoby badane. Mierzy ją najczęściej współczynnik korelacji wewnątrzklasowej (ICC).
- Zgodność (ang. agreement) mówi, jak daleko od siebie leżą powtórzone wyniki tej samej osoby, w jednostkach pomiaru. Mierzą ją standardowy błąd pomiaru (SEM), minimalna wykrywalna zmiana (MDC) i granice zgodności z metody Blanda–Altmana.
de Vet i in. (2006) pokazali tę różnicę na przykładzie fizjoterapeutów mierzących zakres ruchu w stawie ramiennym. Parametry rzetelności silnie zależą od zróżnicowania próby, a parametry zgodności są w większym stopniu cechą samego narzędzia. Wniosek praktyczny: jeśli chcesz odróżniać pacjentów, raportuj rzetelność. Jeśli chcesz mierzyć zmianę u pacjenta, a tak jest zwykle w fizjoterapii, ważniejsza jest zgodność. Atkinson i Nevill (1998) piszą o tym samym jako o rzetelności względnej i bezwzględnej. Ostrzegają, że korelacja powyżej .90 nie przesądza jeszcze o akceptowalnej rzetelności, bo silnie zależy od zakresu wartości w próbie.
Ten poradnik prowadzi przez badanie rzetelności od planu do raportu. Obejmuje błąd systematyczny, wybór formy ICC, SEM i MDC95, wykres Blanda–Altmana oraz porównanie dwóch urządzeń. Pokazuje też, dlaczego sama korelacja Pearsona do tego nie wystarcza. Zgodność sędziów kodujących kategorie (kappa Cohena, alfa Krippendorffa) opisujemy osobno w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa. Tutaj chodzi o pomiar ilościowy w stopniach, kilogramach albo sekundach.
Plan badania powtarzalności: kto mierzy, ile razy i kiedy
Większość problemów z badaniem rzetelności powstaje przed zebraniem danych. Zanim zmierzysz pierwszą osobę, zapisz odpowiedzi na pięć pytań.
| Decyzja | Możliwości | Co z tego wynika |
|---|---|---|
| Jakie źródło zmienności badasz? | ta sama osoba mierzy dwa razy (wewnątrzosobnicza, intra-rater); różne osoby mierzą raz (międzyosobnicza, inter-rater); ten sam badający, inne urządzenie | Każde pytanie to osobna analiza i osobny wynik. Rzetelność jednego badającego nie mówi nic o zgodności dwóch. |
| Odstęp między pomiarami | ta sama sesja (kilkadziesiąt minut); kilka dni | Za krótki odstęp – badający pamięta wynik, a pacjent jest „rozgrzany”. Za długi – zmienia się sam stan pacjenta. Odstęp uzasadnij klinicznie. |
| Kolejność i zaślepienie | losowa kolejność badających; badający nie widzi wyników poprzednika ani swoich poprzednich | Bez kontrbalansowania efekt kolejności miesza się z różnicą między badającymi; bez zaślepienia zgodność bywa sztucznie zawyżona. |
| Kto jest w próbie | pacjenci z populacji docelowej; zdrowi ochotnicy | ICC rośnie ze zróżnicowaniem próby. Wynik z jednorodnej grupy zdrowych studentów nie przenosi się na pacjentów po operacji. |
| Liczba osób i pomiarów | zwykle 30–60 osób, 2–3 pomiary na osobę | Od tego zależy szerokość przedziału ufności ICC i granic zgodności (rysunek 1). |
Polit (2014) w krytyce badań test–retest zwraca uwagę na nieuzasadniony wybór odstępu między pomiarami i akceptowanie niskich współczynników. Zaleca uzasadniony interwał, ustalone z góry kryteria akceptowalności oraz duże, zróżnicowane próby. Ogólne zasady planowania pomiaru powtórzonego opisuje hasło rzetelność test–retest. Przy testach funkcjonalnych pamiętaj o efekcie uczenia się, bo drugie wykonanie testu bywa lepsze niż pierwsze.
Ile osób zbadać?
Walter i in. (1998) podali przybliżoną metodę obliczania liczby osób dla ICC. Pokazali też, że przy rzetelności około .40 lub wyższej łączną liczbę pomiarów minimalizują dwa albo trzy pomiary na osobę. W praktyce planowanie warto oprzeć na precyzji: jak szeroki będzie przedział ufności przy założonym ICC? Rysunek 1 pokazuje wynik symulacji. Prawdziwy ICC(2,1) wynosił w niej .90 i nie było błędu systematycznego.
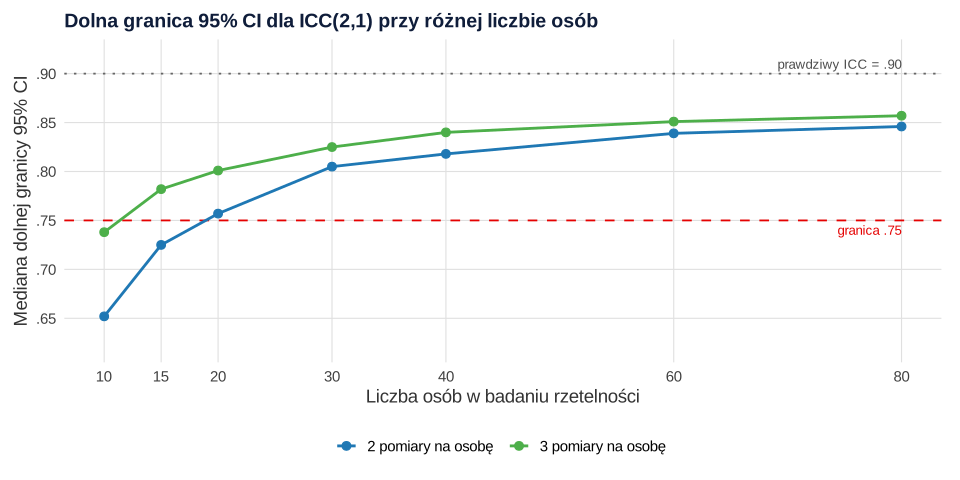
Przy 10 osobach i dwóch pomiarach dolna granica przedziału spadała poniżej .75 w 71.8% symulowanych badań, choć prawdziwy ICC wynosił .90. Przy 30 osobach odsetek ten zmalał do 23.2%, a przy 60 – do 3.2%. Trzeci pomiar na osobę daje mniej więcej tyle, co zwiększenie próby o połowę. Przy 20 osobach i trzech pomiarach mediana dolnej granicy wyniosła .801, a przy 30 osobach i dwóch pomiarach – .805. Ogólne zasady doboru liczebności znajdziesz w poradniku dobór liczebności próby. Mniejsze, wstępne badanie możesz traktować jak badanie pilotażowe, ale nie wyciągaj z niego mocnych wniosków o rzetelności.
Badanie przykładowe: zgięcie kolana po endoprotezoplastyce
Czterdzieści osób sześć tygodni po endoprotezoplastyce stawu kolanowego zbadano jednego dnia. Fizjoterapeutka A zmierzyła czynny zakres zgięcia kolana goniometrem dwukrotnie, w odstępie 60 minut (sesja 1 i 2). Fizjoterapeuta B zmierzył go raz, w sesji 1, nie znając wyniku A. Dodatkowo A zmierzyła zgięcie inklinometrem w aplikacji na smartfonie. Na tych danych odpowiemy na trzy pytania:
- Jak powtarzalny jest pomiar tej samej fizjoterapeutki (rzetelność wewnątrzosobnicza)?
- Czy dwóch fizjoterapeutów daje te same wyniki (rzetelność międzyosobnicza)?
- Czy aplikacja może zastąpić goniometr (zgodność dwóch metod)?
| Pomiar | M | SD | Zakres |
|---|---|---|---|
| Goniometr, A, sesja 1 | 103.25° | 12.68 | 70–121 |
| Goniometr, A, sesja 2 | 104.47° | 13.30 | 71–126 |
| Goniometr, B, sesja 1 | 107.28° | 13.78 | 76–131 |
| Aplikacja, A, sesja 1 | 102.65° | 10.54 | 78–122 |
Dane są symulowane, a liczby nie opisują żadnego rzeczywistego urządzenia ani zespołu. Możesz pobrać plik badanie-rzetelnosci-dane-przyklad.xlsx (arkusze Dane i Instrukcja, 9 KB) i powtórzyć analizy w swoim programie. Kod R odtwarzający wszystkie liczby znajdziesz w sekcji Przykład w R.
Krok 1. Sprawdź błąd systematyczny
Zanim policzysz jakikolwiek współczynnik, sprawdź, czy średnie pomiarów się różnią. Weir (2005) zwraca uwagę, że test różnicy średnich między pomiarami pomaga wykryć błąd systematyczny, np. efekt uczenia się albo zmęczenia. Najprościej zrobić to testem t dla prób zależnych z 95% przedziałem ufności różnicy.
- Sesja 2 a sesja 1 (A): średnio o 1.23° więcej, 95% CI [0.32, 2.13], t(39) = 2.73, p = .010. Pacjenci po pierwszym pomiarze nieco „rozruszali” kolano – to typowy efekt powtórzenia w tej samej sesji.
- Fizjoterapeuta B a fizjoterapeutka A: średnio o 4.03° więcej, 95% CI [2.46, 5.59], t(39) = 5.20, p < .001. B ustawia ramiona goniometru inaczej albo mocniej dociska podudzie – przyczyny trzeba szukać w protokole pomiaru.
Nieistotny wynik testu nie dowodzi braku błędu systematycznego, zwłaszcza w małej próbie. Patrz więc na przedział ufności różnicy, a nie tylko na p. Błąd systematyczny nie dyskwalifikuje narzędzia, ale przesądza o tym, którą formę ICC i który SEM raportujesz.
Krok 2. Wybierz formę ICC przed analizą
Shrout i Fleiss (1979) opisali sześć form ICC, a McGraw i Wong (1996) uporządkowali rozróżnienia między nimi i podali procedury wnioskowania. Koo i Li (2016) wymagają, żeby w raporcie zawsze podać model (jedno- lub dwuczynnikowy, losowy lub mieszany), typ (pojedynczy pomiar czy średnia) i definicję (zgodność absolutna czy spójność). Szczegółowe omówienie tych trzech decyzji i przykład z trzema sędziami znajdziesz we wpisie o zgodności sędziów. W badaniach klinicznych zwykle wystarczą dwie reguły:
- Rzetelność międzyosobnicza: badający są próbą z populacji fizjoterapeutów, a wynik ma znaczyć to samo niezależnie od tego, kto mierzył. Właściwy jest więc dwuczynnikowy model losowy, zgodność absolutna i pojedynczy pomiar: ICC(A,1), w zapisie Shrouta i Fleissa ICC(2,1).
- Rzetelność wewnątrzosobnicza: interesuje Cię jedna konkretna osoba mierząca, więc model jest mieszany. Definicję zgodności absolutnej i tak warto zachować, bo przesunięcie między sesjami to część błędu, który zobaczysz u pacjenta.
Formę średniej z k pomiarów, np. ICC(2,2), raportuj tylko wtedy, gdy w praktyce też będziesz uśredniać dwa pomiary. Wybór formy po obejrzeniu wyników, czyli tej, która „wyszła najwyżej”, to błąd analogiczny do p-hackingu.
| Forma ICC | A: sesja 1 i 2 | A i B |
|---|---|---|
| Jednoczynnikowy, pojedynczy – ICC(1) | .972 [.948, .985] | .890 [.802, .940] |
| Dwuczynnikowy losowy, zgodność absolutna – ICC(A,1) = ICC(2,1) | .972 [.941, .986] | .892 [.586, .959] |
| Dwuczynnikowy mieszany, spójność – ICC(C,1) = ICC(3,1) | .976 [.955, .987] | .932 [.875, .963] |
| Średnia z dwóch pomiarów, zgodność absolutna – ICC(A,2) | .986 [.970, .993] | .943 [.739, .979] |
Dla jednej fizjoterapeutki wszystkie formy są prawie równe (.972–.976), bo przesunięcie o 1.23° jest małe wobec zróżnicowania pacjentów. Dla dwóch fizjoterapeutów ICC spójności wynosi .932, a ICC zgodności absolutnej .892. Liljequist i in. (2019) zalecają właśnie takie porównanie: wyraźnie wyższy ICC spójności sygnalizuje błąd systematyczny. Uwagę zwraca przede wszystkim przedział ufności ICC(A,1), od .586 do .959. Według kryteriów Koo i Li (2016), opartych na przedziale ufności, uczciwy opis brzmi: rzetelność międzyosobnicza od umiarkowanej do doskonałej. Systematyczne przesunięcie o 4° zwiększa niepewność oszacowania, bo przy dwóch badających wariancję „badającego” szacuje się z jednej różnicy średnich.
Krok 3. SEM i MDC95: błąd w stopniach, nie w ułamkach
ICC = .97 brzmi świetnie, ale pacjent i fizjoterapeuta myślą w stopniach. Standardowy błąd pomiaru przelicza rzetelność na jednostki pomiaru. Weir (2005) pokazuje, że SEM służy do budowania przedziałów ufności dla wyniku pojedynczej osoby i do ustalenia najmniejszej różnicy, przy której można uznać, że u danej osoby zaszła rzeczywista zmiana. Najczęściej spotkasz trzy wzory:
MDC95 = 1.96 × √2 × SEM
MSreszt to średni kwadrat reszt z ANOVA osoba × pomiar, a σ²badających – wariancja związana z pomiarem lub badającym, czyli błąd systematyczny. Czynnik √2 bierze się stąd, że zmiana to różnica dwóch pomiarów, a każdy z nich obciąża błąd. Trzeci wzór zależy od SD próby i od wybranej formy ICC. W raporcie zawsze napisz, którego wzoru użyłeś.
| Wielkość | A: sesja 1 i 2 | A i B |
|---|---|---|
| SEM spójności (√MSreszt) | 2.01° | 3.46° |
| SEM zgodności (z błędem systematycznym) | 2.17° | 4.45° |
| SEM = SD × √(1 − ICC(2,1)) | 2.15° | 4.38° |
| MDC95 ze SEM spójności | 5.57° | 9.60° |
| MDC95 ze SEM zgodności | 6.00° | 12.33° |
| SEM zgodności jako % średniej | 2.08% | 4.23% |
Interpretacja jest bezpośrednia. Jeśli ta sama fizjoterapeutka mierzy pacjenta przed terapią i po niej, zmiana o mniej niż około 6° mieści się w błędzie pomiaru. Jeśli pomiary wykonują różne osoby, próg rośnie do ponad 12°. U pacjenta, który „poprawił się” o 8° między wizytą u A a wizytą u B, nie odróżnisz tej poprawy od różnicy między badającymi. Dlatego w protokole badania interwencyjnego warto zapisać, że pomiary przed i po wykonuje ta sama osoba.
MDC to próg wynikający z precyzji narzędzia. Nie myl go z MCID, który mówi, jaka zmiana jest ważna dla pacjenta. Nie myl go też ze wskaźnikiem wiarygodnej zmiany (RCI), czyli testem dla pojedynczej osoby. Jak łączyć te progi w analizie wyników terapii, pokazujemy w poradniku wiarygodna i klinicznie istotna zmiana: RCI, MDC i MCID.
Krok 4. Wykres Blanda–Altmana: średnia różnica i granice zgodności
Bland i Altman (1986) zaproponowali analizę opartą na różnicach między pomiarami zamiast na korelacji. Na osi poziomej zaznaczasz średnią z dwóch pomiarów danej osoby, a na pionowej – ich różnicę. Na wykres nanosisz trzy linie:
95% granice zgodności = d̄ ± 1.96 × SDd
SE granic ≈ √(3 × SDd² / n)
Granice zgodności to przedział, w którym leży około 95% różnic między dwoma pomiarami tej samej osoby (Bland i Altman, 1999). Same granice są oszacowaniami z próby, więc podawaj je z 95% przedziałami ufności. Przy 40 osobach górna granica może się „przesunąć” o kilka stopni. Rysunek 2A pokazuje porównanie dwóch fizjoterapeutów.
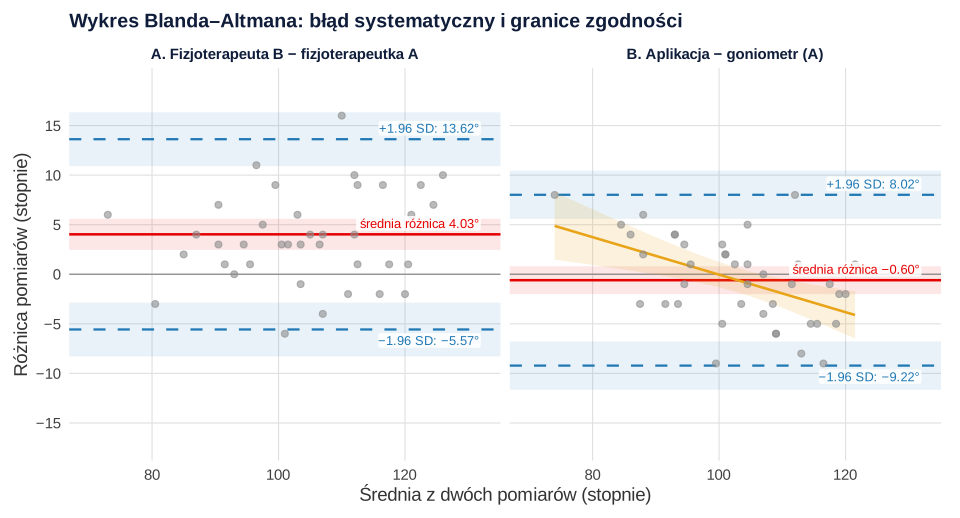
Fizjoterapeuta B mierzy średnio o 4.03° więcej, 95% CI [2.46, 5.59]. Granice zgodności wynoszą od −5.57°, 95% CI [−8.28, −2.86], do 13.62°, 95% CI [10.91, 16.33]. W praktyce: u jednego pacjenta B może zmierzyć o 5° mniej niż A, a u innego aż o 14° więcej. Poza granicami znalazły się trzy osoby z 40, czyli tyle, ile się spodziewamy. Dla dwóch pomiarów tej samej fizjoterapeutki granice są dużo węższe: od −4.35° do 6.80° przy średniej różnicy 1.23°.
Czy takie granice są dobre? Wykres tego nie rozstrzyga. Giavarina (2015) podkreśla, że akceptowalne granice trzeba ustalić z góry, na podstawie potrzeb klinicznych albo innych celów. W planie badania zapisz więc na przykład: „uznamy zgodność za wystarczającą, jeśli 95% granice zgodności zmieszczą się w ±10°”. Dopiero wtedy wynik ma jasną interpretację – tutaj górna granica 13.62° to kryterium przekracza.
Co jeszcze sprawdzić na wykresie
- Błąd proporcjonalny. Czy różnica rośnie lub maleje wraz z wielkością pomiaru? Sprawdź to regresją różnic na średnich. Dla dwóch fizjoterapeutów nachylenie wyniosło 0.086, p = .156, więc różnica była w przybliżeniu stała.
- Rozrzut zależny od wielkości. Czy punkty rozchodzą się wachlarzowato przy dużych wartościach? To heteroskedastyczność, częsta np. w pomiarach siły. Atkinson i Nevill (1998) zalecają wtedy transformację logarytmiczną i podawanie błędu w postaci ilorazów, np. „pomiar B wynosi od 0.92 do 1.10 pomiaru A”. Giavarina (2015) opisuje też wykres różnic procentowych.
- Obserwacje odstające. Pojedyncza osoba z różnicą 20° to często błąd zapisu albo inna pozycja pacjenta. Sprawdź ją w dokumentacji, zanim usuniesz ją z analizy.
Dla dwóch pomiarów tej samej osoby Bland i Altman (1986) wiążą analizę zgodności z oceną powtarzalności. W przykładzie 1.96 × SD różnic sesji 1 i 2 wynosi 5.57° – dokładnie tyle co MDC95 ze SEM spójności. To nie przypadek: przy dwóch pomiarach SD różnic równa się √2 × SEM. MDC i granice zgodności to więc dwa sposoby opisu tej samej precyzji, przy czym granice zgodności dodatkowo pokazują przesunięcie.
Krok 5. Dwa urządzenia: dlaczego korelacja Pearsona nie wystarcza
Najczęstszy błąd w porównaniu metod pomiaru to wniosek „aplikacja jest zgodna z goniometrem, bo r = .94”. Bland i Altman (1986) piszą wprost, że korelacja w takich badaniach wprowadza w błąd. Korelacja Pearsona mierzy, czy punkty układają się wzdłuż jakiejkolwiek prostej, a nie czy leżą na przekątnej, gdzie oba pomiary są równe. Berchtold (2016) krytykuje opieranie oceny powtarzalności wyłącznie na r z tego samego powodu: korelacja opisuje zachowanie kolejności osób, a nie uzyskanie tych samych wartości. Rysunek 3 pokazuje trzy pary pomiarów o identycznej korelacji.
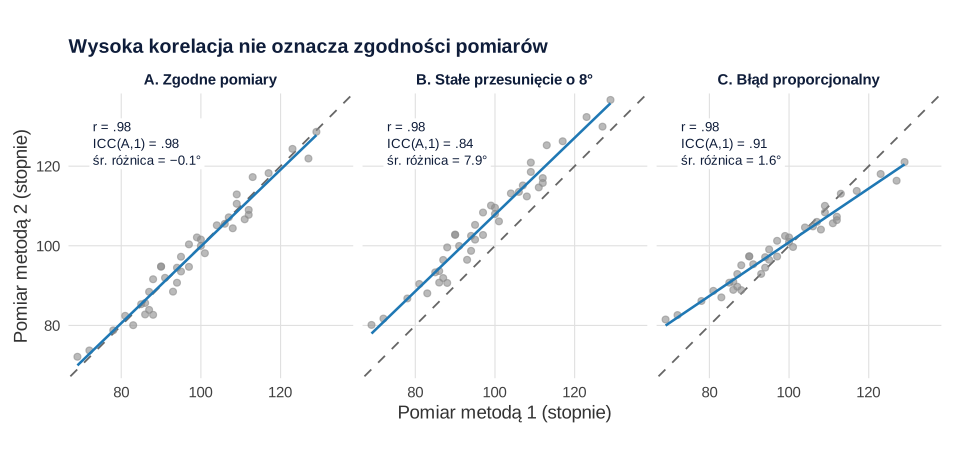
W scenariuszu B druga metoda zawyża każdy wynik o około 8°. Korelacja pozostaje równa .98, a ICC(A,1) spada do .84. W scenariuszu C metoda 2 zawyża małe kąty i zaniża duże. Średnia różnica wynosi wtedy tylko 1.6°, ale SD różnic rośnie z 2.93° do 5.00°. Dlatego sam ICC też nie wystarczy – potrzebny jest wykres Blanda–Altmana.
Wróćmy do aplikacji z badania przykładowego. Korelacja z goniometrem jest wysoka: r = .94, 95% CI [.90, .97], a ICC(A,1) = .929, 95% CI [.871, .962]. Średnia różnica wynosi zaledwie −0.60°, 95% CI [−2.01, 0.81]. Wnioskiem byłaby „doskonała zgodność”, gdyby nie panel B rysunku 2. Nachylenie regresji różnic na średnich wyniosło −0.189 (SE = 0.054, p = .001). Przy kącie około 85° aplikacja zawyża wynik średnio o 2.80°, a przy 120° zaniża go o 3.83°. W samej regresji aplikacji na goniometr nachylenie wyniosło 0.786 zamiast 1. Dla pacjenta tuż po operacji, z małym zakresem ruchu, i dla pacjenta pod koniec rehabilitacji błąd ma więc przeciwny znak. Zmiana mierzona aplikacją będzie systematycznie mniejsza niż zmiana mierzona goniometrem.
Gdy różnica zależy od wielkości pomiaru, Bland i Altman (1999) proponują granice zgodności z regresji: średnią różnicę zastępuje linia regresji różnic na średnich, a szerokość granic opiera się na SD reszt. W przykładzie SD reszt wyniosło 3.88°. Granice zgodności wynoszą więc od −4.80° do 10.39° przy 85° i od −11.42° do 3.77° przy 120°. Taki wynik zapisz w raporcie zamiast jednej pary granic dla całego zakresu.
Nie myl tego problemu z rzetelnością samej aplikacji. Narzędzie może być bardzo powtarzalne, czyli dawać przy kolejnych pomiarach ciągle te same, ale błędne wyniki. Rzetelność każdej metody z osobna i zgodność metod między sobą to dwa różne pytania, a Bland i Altman (1999) zalecają ocenę obu.
Krok 6. Raport według wytycznych GRRAS
Kottner i in. (2011) opracowali wytyczne GRRAS (Guidelines for Reporting Reliability and Agreement Studies). To lista 15 zagadnień, które należy opisać w raporcie z badania rzetelności i zgodności, uporządkowana według części publikacji. Obejmuje dobór próby, schemat badania i analizę statystyczną. Autorzy przygotowali je dlatego, że dotychczasowe raporty były często niepełne. Pełną listę znajdziesz w artykule. W praktyce w raporcie z badania pomiaru ilościowego nie może zabraknąć:
- opisu narzędzia i procedury pomiaru (pozycja pacjenta, punkty orientacyjne, liczba prób, który wynik zapisywano);
- opisu osób mierzących (wykształcenie, doświadczenie, szkolenie przed badaniem) i pacjentów (kryteria, zakres wartości w próbie);
- schematu: kto, ile razy, w jakim odstępie i kolejności, czy z zaślepieniem;
- uzasadnienia liczebności;
- pełnej nazwy formy ICC z 95% CI, testu błędu systematycznego, SEM z podanym wzorem, MDC95 oraz średniej różnicy i granic zgodności z przedziałami ufności;
- kryterium akceptowalności ustalonego przed badaniem.
Wyniki dla kilku narzędzi albo kilku stron ciała zbierz w jednej tabeli. Wzór układu podaje hasło tabela rzetelności w APA, a ogólne zasady opisu metod w czasopismach medycznych – poradnik statystyka w publikacji medycznej.
Wzór opisu metod i wyników
Poniższe fragmenty dopasuj do swojego badania: zmień narzędzie, liczby i kryterium akceptowalności. Zostaw konkretne nazwy form ICC i wzorów – recenzent na pewno o nie zapyta.
Jeśli przygotowujesz artykuł z badania rzetelności i chcesz, żeby ktoś sprawdził plan analizy, wybór formy ICC albo odpowiedź na uwagi recenzentów, zajrzyj do oferty analiz statystycznych dla badaczy. Interpretacja i odpowiedzialność za wnioski zostają przy autorach, a pomoc warto ujawnić zgodnie z zasadami czasopisma.
Przykład w R
Kod generuje dane z pliku do pobrania i odtwarza wszystkie liczby z tekstu. Przepis 1 korzysta z pakietu psych (funkcja ICC() z argumentem lmer = FALSE liczy formy ICC ze średnich kwadratów ANOVA). Przepis 2 to symulacja z rysunku 1; trwa około 20 sekund. Rysunki powstają w skrypcie b58-rysunki.R z pakietem ggplot2.
1. Błąd systematyczny, ICC, SEM, MDC i Bland–Altman
R
# Badanie rzetelności pomiaru zgięcia kolana (dane symulowane, set.seed(5801)).
# 40 osób 6 tygodni po endoprotezoplastyce stawu kolanowego. Czynny zakres zgięcia kolana (stopnie):
#   gonio_A1 – goniometr, fizjoterapeutka A, sesja 1;  gonio_A2 – goniometr, fizjoterapeutka A, sesja 2 (po 60 min);
#   gonio_B1 – goniometr, fizjoterapeuta B, sesja 1;   aplikacja – inklinometr w smartfonie (A, sesja 1).
library(psych)      # ICC(): sześć form ICC z 95% CI
set.seed(5801)
n <- 40
prawdziwe <- rnorm(n, mean = 102, sd = 13)
dane <- data.frame(
  id        = 1:n,
  gonio_A1  = round(prawdziwe + rnorm(n, 0, 2.6)),
  gonio_A2  = round(prawdziwe + 0.8 + rnorm(n, 0, 2.6)),
  gonio_B1  = round(prawdziwe + 3.5 + rnorm(n, 0, 3.4)),
  aplikacja = round(22 + 0.78 * prawdziwe + rnorm(n, 0, 2.4))
)
write.csv(dane, "b58-dane.csv", row.names = FALSE)   # kopia robocza (plik do pobrania tworzy b58-3-plik.R)

opis <- function(x) round(c(M = mean(x), SD = sd(x), min = min(x), max = max(x)), 2)
t(sapply(dane[, -1], opis))

# ---- 1. Wewnątrzosobnicza powtarzalność (A1 vs A2) i międzyosobnicza zgodność (A1 vs B1)
wynik_icc <- function(m) {
  ic <- ICC(m, lmer = FALSE)$results
  out <- ic[ic$type %in% c("ICC1", "ICC2", "ICC3", "ICC2k"), c("type", "ICC", "lower bound", "upper bound")]
  out[, 2:4] <- round(out[, 2:4], 3); out
}
wewn <- as.matrix(dane[, c("gonio_A1", "gonio_A2")])
miedzy <- as.matrix(dane[, c("gonio_A1", "gonio_B1")])
cat("\nICC wewnątrzosobniczy (A1, A2):\n"); print(wynik_icc(wewn))
cat("\nICC międzyosobniczy (A1, B1):\n");   print(wynik_icc(miedzy))

# Błąd systematyczny: test t dla par
roznica_test <- function(x, y) { t <- t.test(y, x, paired = TRUE)
  round(c(M_roznicy = unname(t$estimate), CI_d = t$conf.int[1], CI_g = t$conf.int[2],
          t = unname(t$statistic), df = unname(t$parameter), p = t$p.value), 4) }
rbind(A2_minus_A1 = roznica_test(dane$gonio_A1, dane$gonio_A2),
      B1_minus_A1 = roznica_test(dane$gonio_A1, dane$gonio_B1))

# ---- 2. SEM i MDC95
# SEM spójności = pierwiastek ze średniego kwadratu reszt (MSE) z ANOVA osoba × pomiar;
# SEM zgodności = pierwiastek z (wariancja pomiarów/badających + MSE), czyli z błędem systematycznym;
# dla porównania SEM = SD × sqrt(1 − ICC(2,1)).
sem_mdc <- function(m) {
  ic <- ICC(m, lmer = FALSE)
  s <- ic$summary[[1]]                     # wiersze: 1 – osoby, 2 – pomiary/badający, 3 – reszta
  nn <- nrow(m)
  mse <- s[3, "Mean Sq"]
  var_pomiaru <- max(0, (s[2, "Mean Sq"] - mse) / nn)
  icc2 <- ic$results[ic$results$type == "ICC2", "ICC"]
  sd_all <- sd(as.vector(m))
  sem_c <- sqrt(mse); sem_a <- sqrt(var_pomiaru + mse); sem_i <- sd_all * sqrt(1 - icc2)
  round(c(SD_wszystkich = sd_all, SEM_spojnosc = sem_c, SEM_zgodnosc = sem_a, SEM_z_ICC2 = sem_i,
          MDC95_spojnosc = 1.96 * sqrt(2) * sem_c, MDC95_zgodnosc = 1.96 * sqrt(2) * sem_a,
          MDC95_z_ICC2 = 1.96 * sqrt(2) * sem_i, SEM_proc_sredniej = 100 * sem_a / mean(m)), 2)
}
rbind(wewnatrz_A = sem_mdc(wewn), miedzy_AB = sem_mdc(miedzy))

# ---- 3. Bland–Altman: granice zgodności z 95% CI (przybliżenie SE = sqrt(3 s^2 / n))
bland_altman <- function(x, y) {
  d <- y - x; m <- (x + y) / 2; nn <- length(d)
  bias <- mean(d); s <- sd(d)
  se_bias <- s / sqrt(nn); se_loa <- sqrt(3 * s^2 / nn); tq <- qt(.975, nn - 1)
  prop <- summary(lm(d ~ m))$coefficients
  round(c(bias = bias, bias_CI_d = bias - tq * se_bias, bias_CI_g = bias + tq * se_bias, SD_roznic = s,
          LoA_dolna = bias - 1.96 * s, LoA_dolna_CI_d = bias - 1.96 * s - tq * se_loa, LoA_dolna_CI_g = bias - 1.96 * s + tq * se_loa,
          LoA_gorna = bias + 1.96 * s, LoA_gorna_CI_d = bias + 1.96 * s - tq * se_loa, LoA_gorna_CI_g = bias + 1.96 * s + tq * se_loa,
          nachylenie = prop["m", 1], nachylenie_SE = prop["m", 2], nachylenie_p = prop["m", 4],
          poza_LoA = sum(d < bias - 1.96 * s | d > bias + 1.96 * s)), 3)
}
ba <- rbind(A2_vs_A1 = bland_altman(dane$gonio_A1, dane$gonio_A2),
            B1_vs_A1 = bland_altman(dane$gonio_A1, dane$gonio_B1),
            aplikacja_vs_A1 = bland_altman(dane$gonio_A1, dane$aplikacja))
t(ba)

# Współczynnik powtarzalności (Bland i Altman): 1.96 * SD różnic powtórzeń tej samej osoby
round(1.96 * sd(dane$gonio_A2 - dane$gonio_A1), 2)

# ---- 4. Aplikacja vs goniometr: korelacja a zgodność
cor.test(dane$gonio_A1, dane$aplikacja)
round(lm(aplikacja ~ gonio_A1, data = dane)$coefficients, 3)
print(wynik_icc(as.matrix(dane[, c("gonio_A1", "aplikacja")])))
# Granice zgodności zależne od wielkości pomiaru (regresja różnic na średnich): różnica przy 85° i 120°
d <- dane$aplikacja - dane$gonio_A1; m <- (dane$aplikacja + dane$gonio_A1) / 2
fit <- lm(d ~ m)
round(predict(fit, newdata = data.frame(m = c(85, 120))), 2)
# Rozrzut różnic wokół linii regresji (SD reszt) i granice zależne od średniej
s_res <- sigma(fit)
round(c(SD_reszt = s_res, LoA_85_d = predict(fit, data.frame(m = 85)) - 1.96 * s_res,
        LoA_85_g = predict(fit, data.frame(m = 85)) + 1.96 * s_res,
        LoA_120_d = predict(fit, data.frame(m = 120)) - 1.96 * s_res,
        LoA_120_g = predict(fit, data.frame(m = 120)) + 1.96 * s_res), 2)
Wynik w R
               M    SD min max
gonio_A1  103.25 12.68  70 121
gonio_A2  104.47 13.30  71 126
gonio_B1  107.28 13.78  76 131
aplikacja 102.65 10.54  78 122

ICC wewnątrzosobniczy (A1, A2):
                        type   ICC lower bound upper bound
Single_raters_absolute  ICC1 0.972       0.948       0.985
Single_random_raters    ICC2 0.972       0.941       0.986
Single_fixed_raters     ICC3 0.976       0.955       0.987
Average_random_raters  ICC2k 0.986       0.970       0.993

ICC międzyosobniczy (A1, B1):
                        type   ICC lower bound upper bound
Single_raters_absolute  ICC1 0.890       0.802       0.940
Single_random_raters    ICC2 0.892       0.586       0.959
Single_fixed_raters     ICC3 0.932       0.875       0.963
Average_random_raters  ICC2k 0.943       0.739       0.979
            M_roznicy   CI_d   CI_g      t df      p
A2_minus_A1     1.225 0.3161 2.1339 2.7262 39 0.0095
B1_minus_A1     4.025 2.4591 5.5909 5.1991 39 0.0000
           SD_wszystkich SEM_spojnosc SEM_zgodnosc SEM_z_ICC2 MDC95_spojnosc MDC95_zgodnosc
wewnatrz_A         12.92         2.01         2.17       2.15           5.57           6.00
miedzy_AB          13.31         3.46         4.45       4.38           9.60          12.33
           MDC95_z_ICC2 SEM_proc_sredniej
wewnatrz_A         5.96              2.08
miedzy_AB         12.13              4.23
               A2_vs_A1 B1_vs_A1 aplikacja_vs_A1
bias              1.225    4.025          -0.600
bias_CI_d         0.316    2.459          -2.006
bias_CI_g         2.134    5.591           0.806
SD_roznic         2.842    4.896           4.396
LoA_dolna        -4.345   -5.572          -9.216
LoA_dolna_CI_d   -5.919   -8.284         -11.651
LoA_dolna_CI_g   -2.771   -2.860          -6.781
LoA_gorna         6.795   13.622           8.016
LoA_gorna_CI_d    5.221   10.910           5.581
LoA_gorna_CI_g    8.369   16.334          10.451
nachylenie        0.048    0.086          -0.189
nachylenie_SE     0.035    0.059           0.054
nachylenie_p      0.173    0.156           0.001
poza_LoA          3.000    3.000           0.000
[1] 5.57

	Pearson's product-moment correlation

data:  dane$gonio_A1 and dane$aplikacja
t = 17.771, df = 38, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.8973622 0.9706226
sample estimates:
      cor
0.9447729

(Intercept)    gonio_A1
     21.541       0.786
                        type   ICC lower bound upper bound
Single_raters_absolute  ICC1 0.929       0.871       0.962
Single_random_raters    ICC2 0.929       0.871       0.962
Single_fixed_raters     ICC3 0.929       0.870       0.962
Average_random_raters  ICC2k 0.963       0.931       0.981
    1     2
 2.80 -3.83
   SD_reszt  LoA_85_d.1  LoA_85_g.1 LoA_120_d.1 LoA_120_g.1
       3.88       -4.80       10.39      -11.42        3.77
2. Ile osób do badania rzetelności: precyzja ICC(2,1)
R
# Ile osób do badania rzetelności? Symulacja precyzji ICC(2,1) (dane symulowane, set.seed(5802)).
# Prawdziwy ICC = .90, brak błędu systematycznego; k = 2 lub 3 pomiary na osobę; 1000 powtórzeń dla każdego n.
library(psych)
set.seed(5802)
symuluj <- function(n, k, rho = .90, R = 1000) {
  wyn <- replicate(R, {
    osoba <- rnorm(n, 0, sqrt(rho)); m <- osoba + matrix(rnorm(n * k, 0, sqrt(1 - rho)), n, k)
    r <- ICC(m, lmer = FALSE)$results
    unlist(r[r$type == "ICC2", c("ICC", "lower bound", "upper bound")])
  })
  c(n = n, k = k, mediana_ICC = median(wyn[1, ]), mediana_dolnej = median(wyn[2, ]),
    mediana_szerokosci = median(wyn[3, ] - wyn[2, ]), odsetek_dolna_ponizej_75 = 100 * mean(wyn[2, ] < .75))
}
siatka <- expand.grid(n = c(10, 15, 20, 30, 40, 60, 80), k = c(2, 3))
precyzja <- t(mapply(symuluj, siatka$n, siatka$k))
precyzja <- as.data.frame(round(precyzja, 3))
precyzja
write.csv(precyzja, "b58-precyzja-icc.csv", row.names = FALSE)
Wynik w R
    n k mediana_ICC mediana_dolnej mediana_szerokosci odsetek_dolna_ponizej_75
1  10 2       0.901          0.652              0.323                     71.8
2  15 2       0.900          0.725              0.240                     58.7
3  20 2       0.897          0.757              0.202                     47.1
4  30 2       0.902          0.805              0.148                     23.2
5  40 2       0.900          0.818              0.128                     13.6
6  60 2       0.901          0.839              0.101                      3.2
7  80 2       0.899          0.846              0.088                      0.7
8  10 3       0.898          0.738              0.233                     52.9
9  15 3       0.899          0.782              0.180                     35.8
10 20 3       0.898          0.801              0.154                     24.7
11 30 3       0.899          0.825              0.122                     10.0
12 40 3       0.901          0.840              0.103                      4.5
13 60 3       0.900          0.851              0.084                      0.3
14 80 3       0.898          0.857              0.073                      0.0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2, a plik do pobrania – w pakiecie openxlsx. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
Najczęstsze błędy w badaniach rzetelności pomiaru
- Korelacja Pearsona jako dowód zgodności. r = .94 może współistnieć z błędem proporcjonalnym albo stałym przesunięciem o kilka stopni (rysunek 3).
- „ICC = .89” bez nazwy formy i bez przedziału ufności. Przy dwóch badających i błędzie systematycznym ICC(A,1) i ICC(C,1) różnią się wyraźnie, a przedział może sięgać od .59 do .96.
- Wybór formy ICC po obejrzeniu wyników. Formę wynikającą z pytania badawczego zapisz w planie analizy.
- Sam ICC bez SEM i MDC. Klinicysta potrzebuje błędu w stopniach, kilogramach albo sekundach, a nie ułamka.
- SEM bez podanego wzoru. W przykładzie SEM międzyosobniczy wynosi 3.46° albo 4.45° zależnie od tego, czy uwzględnisz błąd systematyczny.
- Brak kryterium akceptowalności. Bez progu ustalonego z góry każdy wynik da się opisać jako „dobry”.
- Jednorodna próba zdrowych ochotników. Niskie zróżnicowanie obniża ICC, a wysokie je zawyża; badaj osoby z populacji, w której narzędzie będzie używane.
- Jeden badający i wniosek o rzetelności „narzędzia”. Powtarzalność jednej osoby nie mówi, jak zgodni są różni fizjoterapeuci.
- Granice zgodności bez przedziałów ufności. Przy 40 osobach górna granica może się różnić o kilka stopni między badaniami.
- Pominięcie efektu uczenia się. Lepszy wynik w drugim wykonaniu testu funkcjonalnego to błąd systematyczny, który trzeba opisać, a nie ukryć w ICC.
Jeśli Twoje badanie interwencyjne ma pomiar przed i po, wyniki rzetelności przydadzą się w analizie zmiany – zob. statystyka dla fizjoterapeuty oraz ANCOVA w badaniu przed i po. Analizę samych skal bólu opisujemy we wpisie jak analizować skale bólu NRS i VAS.
Najczęstsze pytania
Ile osób potrzeba do badania rzetelności pomiaru klinicznego?
Zależy to od zakładanego ICC i precyzji, jakiej potrzebujesz. W symulacji z tego wpisu, przy prawdziwym ICC = .90 i dwóch pomiarach, dolna granica 95% CI spadała poniżej .75 w 71.8% badań z 10 osobami, w 23.2% z 30 osobami i w 3.2% z 60 osobami. Walter i in. (1998) pokazali, że przy rzetelności około .40 lub wyższej dwa albo trzy pomiary na osobę minimalizują łączną liczbę pomiarów.
Czym różni się rzetelność intra-rater od inter-rater?
Rzetelność wewnątrzosobnicza (intra-rater) opisuje, jak powtarzalne są pomiary tej samej osoby mierzącej. Międzyosobnicza (inter-rater) mówi, czy różni badający dają te same wyniki. To dwa osobne pytania: w przykładzie we wpisie SEM jednej fizjoterapeutki wynosił 2.17°, a SEM dla dwóch fizjoterapeutów – 4.45°.
Jak policzyć MDC95 z SEM?
MDC95 = 1.96 × √2 × SEM. Czynnik √2 wynika z tego, że zmiana jest różnicą dwóch pomiarów obciążonych błędem. Przy SEM = 2.17° MDC95 wynosi 6.00°, czyli mniejsza zmiana mieści się w błędzie pomiaru. W raporcie podaj, czy SEM liczono ze średniego kwadratu reszt ANOVA, czy ze wzoru SD × √(1 − ICC).
Jak czytać wykres Blanda-Altmana?
Na osi poziomej jest średnia z dwóch pomiarów osoby, na pionowej – ich różnica. Czerwona linia (średnia różnica) pokazuje błąd systematyczny, a granice zgodności, średnia ± 1.96 SD różnic, przedział, w którym leży około 95% różnic. Sprawdź też, czy różnice nie rosną lub nie maleją wraz z wielkością pomiaru (błąd proporcjonalny) i czy granice mieszczą się w progu ustalonym przed badaniem.
Czy wysoka korelacja dwóch urządzeń oznacza, że można ich używać zamiennie?
Nie. Korelacja mówi tylko, czy wyniki układają się wzdłuż jakiejś prostej, a nie czy są równe. W przykładzie we wpisie aplikacja korelowała z goniometrem na poziomie r = .94, a mimo to zawyżała małe kąty i zaniżała duże. Zgodność urządzeń oceniaj wykresem Blanda–Altmana i ICC zgodności absolutnej.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikRCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →Planujesz badanie rzetelności albo zgodności urządzeń?
Pomożemy dobrać schemat i liczebność, wybrać formę ICC, policzyć SEM, MDC i granice zgodności oraz przygotować opis metod i wyników do artykułu.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Atkinson, G., & Nevill, A. M. (1998). Statistical methods for assessing measurement error (reliability) in variables relevant to sports medicine. Sports Medicine, 26(4), 217–238. https://doi.org/10.2165/00007256-199826040-00002
- Berchtold, A. (2016). Test–retest: Agreement or reliability? Methodological Innovations, 9, Article 2059799116672875. https://doi.org/10.1177/2059799116672875 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/s0140-6736(86)90837-8
- Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
- de Vet, H. C. W., Terwee, C. B., Knol, D. L., & Bouter, L. M. (2006). When to use agreement versus reliability measures. Journal of Clinical Epidemiology, 59(10), 1033–1039. https://doi.org/10.1016/j.jclinepi.2005.10.015 ● Otwarty dostęp
- Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/bm.2015.015 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Shoukri, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96–106. https://doi.org/10.1016/j.jclinepi.2010.03.002
- Liljequist, D., Elfving, B., & Skavberg Roaldsen, K. (2019). Intraclass correlation – A discussion and demonstration of basic features. PLOS ONE, 14(7), Article e0219854. https://doi.org/10.1371/journal.pone.0219854 ● Otwarty dostęp
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Polit, D. F. (2014). Getting serious about test–retest reliability: A critique of retest research and some recommendations. Quality of Life Research, 23(6), 1713–1720. https://doi.org/10.1007/s11136-014-0632-9
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Walter, S. D., Eliasziw, M., & Donner, A. (1998). Sample size and optimal designs for reliability studies. Statistics in Medicine, 17(1), 101–110. https://doi.org/10.1002/(sici)1097-0258(19980115)17:1<101::aid-sim727>3.0.co;2-e
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. Journal of Strength and Conditioning Research, 19(1), 231–240. https://doi.org/10.1519/15184.1
Cytowania BibTeX
@article{atkinson1998statistical, author={Atkinson, Greg and Nevill, Alan M.}, title={{Statistical methods for assessing measurement error (reliability) in variables relevant to sports medicine}}, journal={Sports Medicine}, year={1998}, volume={26}, number={4}, pages={217--238}, doi={10.2165/00007256-199826040-00002}}@article{berchtold2016test, author={Berchtold, André}, title={{Test–retest: Agreement or reliability?}}, journal={Methodological Innovations}, year={2016}, volume={9}, eid={2059799116672875}, doi={10.1177/2059799116672875}}@article{bland1986statistical, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistical methods for assessing agreement between two methods of clinical measurement}}, journal={The Lancet}, year={1986}, volume={327}, number={8476}, pages={307--310}, doi={10.1016/s0140-6736(86)90837-8}}@article{bland1999measuring, author={Bland, J. Martin and Altman, Douglas G.}, title={{Measuring agreement in method comparison studies}}, journal={Statistical Methods in Medical Research}, year={1999}, volume={8}, number={2}, pages={135--160}, doi={10.1177/096228029900800204}}@article{devet2006when, author={de Vet, Henrica C. W. and Terwee, Caroline B. and Knol, Dirk L. and Bouter, Lex M.}, title={{When to use agreement versus reliability measures}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={10}, pages={1033--1039}, doi={10.1016/j.jclinepi.2005.10.015}}@article{giavarina2015understanding, author={Giavarina, Davide}, title={{Understanding Bland Altman analysis}}, journal={Biochemia Medica}, year={2015}, volume={25}, number={2}, pages={141--151}, doi={10.11613/bm.2015.015}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{kottner2011guidelines, author={Kottner, Jan and Audigé, Laurent and Brorson, Stig and Donner, Allan and Gajewski, Byron J. and Hróbjartsson, Asbjørn and Roberts, Chris and Shoukri, Mohamed and Streiner, David L.}, title={{Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={1}, pages={96--106}, doi={10.1016/j.jclinepi.2010.03.002}}@article{liljequist2019intraclass, author={Liljequist, David and Elfving, Britt and Skavberg Roaldsen, Kirsti}, title={{Intraclass correlation – A discussion and demonstration of basic features}}, journal={PLOS ONE}, year={2019}, volume={14}, number={7}, eid={e0219854}, doi={10.1371/journal.pone.0219854}}@article{mcgraw1996forming, author={McGraw, Kenneth O. and Wong, S. P.}, title={{Forming inferences about some intraclass correlation coefficients}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={30--46}, doi={10.1037/1082-989x.1.1.30}}@article{polit2014getting, author={Polit, Denise F.}, title={{Getting serious about test–retest reliability: A critique of retest research and some recommendations}}, journal={Quality of Life Research}, year={2014}, volume={23}, number={6}, pages={1713--1720}, doi={10.1007/s11136-014-0632-9}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}@article{walter1998sample, author={Walter, S. D. and Eliasziw, M. and Donner, A.}, title={{Sample size and optimal designs for reliability studies}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={1}, pages={101--110}, doi={10.1002/(sici)1097-0258(19980115)17:1<101::aid-sim727>3.0.co;2-e}}@article{weir2005quantifying, author={Weir, Joseph P.}, title={{Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM}}, journal={Journal of Strength and Conditioning Research}, year={2005}, volume={19}, number={1}, pages={231--240}, doi={10.1519/15184.1}}