Zmiana w grupie a zmiana u konkretnego pacjenta
Badanie interwencyjne odpowiada zwykle na pytanie o grupę: czy średnio pacjenci po programie mają mniejsze ograniczenia niż pacjenci po opiece standardowej. Recenzenci i klinicyści pytają jednak także o pojedyncze osoby. U ilu pacjentów zmiana była na tyle duża, że nie da się jej wyjaśnić błędem pomiaru? U ilu poprawa była odczuwalna? Ilu wróciło do poziomu typowego dla osób zdrowych? Na te trzy pytania odpowiadają trzy różne narzędzia: wskaźnik wiarygodnej zmiany (RCI) i minimalna wykrywalna zmiana (MDC), minimalna istotna klinicznie różnica (MCID) oraz kryteria klinicznie istotnej zmiany Jacobsona i Truaxa.
We wpisie statystyka dla fizjoterapeuty pokazaliśmy skrótowo odsetek pacjentów z poprawą o co najmniej MCID dla bólu w skali NRS. Tutaj przechodzimy przez całą procedurę: od źródła błędu pomiaru, przez RCI i punkty odcięcia, po wyznaczanie MCID i analizę responderów. Na końcu pokazujemy też, ile mocy kosztuje zamiana wyniku ciągłego na kategorie.
| Miara | Pytanie | Podstawa | Wynik w przykładzie |
|---|---|---|---|
| SEM | O ile może się różnić wynik obserwowany od prawdziwego? | SD i rzetelność (test–retest lub alfa) | 2.57 punktu |
| MDC95 | Jaka zmiana przekracza błąd pomiaru? | 1.96 × √2 × SEM | 7.11 punktu |
| RCI | Czy zmiana tej osoby jest wiarygodna? | zmiana / (√2 × SEM), próg ±1.96 | dla każdej osoby |
| Kryteria a, b, c | Czy osoba wyszła z zakresu populacji klinicznej? | M i SD populacji klinicznej i zdrowej | c = 10.84 punktu |
| MCID | Czy zmiana jest odczuwalna dla pacjenta? | kotwica (ocena pacjenta) lub rozkład | 6 punktów (kotwica) |
Jedno zastrzeżenie na początek. Wszystkie te miary dotyczą pojedynczych osób i ich zliczanie daje odsetki. Nie zastępują porównania grup na wyniku ciągłym, które ma większą moc. Wracamy do tego w kroku 7.
Badanie przykładowe: program ćwiczeń w przewlekłym bólu krzyża
Przykład dotyczy badania z losowym przydziałem: 120 osób z przewlekłym bólem krzyża przydzielono po równo do ośmiotygodniowego programu ćwiczeń albo do opieki standardowej. Wynikiem jest skala ograniczeń funkcjonalnych SOF. To narzędzie fikcyjne, wymyślone na potrzeby przykładu: 20 pozycji ocenianych od 0 do 2, wynik od 0 do 40, wyższy wynik oznacza większe ograniczenia. Dzięki temu możemy pokazać całą procedurę bez przypisywania prawdziwym kwestionariuszom wartości, których nie sprawdziliśmy. Dla prawdziwego narzędzia wartości SEM, MDC i MCID weź z publikacji walidacyjnych albo wyznacz je sam według tej samej procedury.
Do pełnej analizy potrzebujesz trzech zbiorów danych, a nie jednego:
- badanie główne – SOF przed i po 8 tygodniach oraz globalna ocena zmiany po zakończeniu (od −3 „dużo gorzej” do +3 „dużo lepiej”);
- próba normatywna – SOF u 200 osób bez dolegliwości bólowych, potrzebna do kryteriów b i c;
- próba powtarzalności – 50 pacjentów w stabilnym stanie, zbadanych dwukrotnie w odstępie 7 dni, potrzebna do SEM z rzetelności test–retest.
Dane są symulowane. Możesz je pobrać jako plik Excel z arkuszami badanie, norma, retest i opis.
| Zbiór i pomiar | n | M | SD | Zakres |
|---|---|---|---|---|
| Próba normatywna (bez dolegliwości) | 200 | 4.31 | 3.89 | 0–25 |
| Badanie główne, przed terapią | 120 | 22.63 | 7.03 | 4–39 |
| Program ćwiczeń, po 8 tygodniach | 60 | 15.77 | 8.46 | 2–38 |
| Opieka standardowa, po 8 tygodniach | 60 | 19.58 | 8.38 | 1–36 |
| Próba powtarzalności, pierwszy pomiar | 50 | 24.98 | 6.29 | 11–37 |
Średnia zmiana wyniosła −7.50 punktu (SD = 6.22) w grupie ćwiczeń i −2.42 punktu (SD = 4.72) w grupie opieki standardowej. Za tymi średnimi kryją się bardzo różne losy pojedynczych pacjentów, i to je będziemy teraz klasyfikować.
Krok 1. Standardowy błąd pomiaru: z jakiej rzetelności go liczyć
Każdy pomiar zawiera błąd. Standardowy błąd pomiaru (SEM, standard error of measurement) to odchylenie standardowe tego błędu, wyrażone w jednostkach skali. W klasycznej teorii testów liczy się go z odchylenia standardowego wyników i rzetelności:
Nie myl SEM ze standardowym błędem średniej. Błąd standardowy średniej maleje wraz z liczebnością próby, a SEM jest cechą narzędzia w danej populacji i od liczebności nie zależy. Weir (2005) opisuje, jak liczyć SEM na podstawie ICC i jak z niego wyznaczyć najmniejszą różnicę, przy której u danej osoby zaszła rzeczywista zmiana.
Kluczowa decyzja dotyczy rzetelności rxx. Masz zwykle dwie możliwości:
- Rzetelność test–retest, np. ICC(2,1) dla zgodności bezwzględnej z próby pacjentów w stabilnym stanie. Obejmuje wahania wyniku z dnia na dzień, a przy pomiarach wykonywanych przez badającego – także różnice między pomiarami. W przykładzie ICC(2,1) = .867, 95% CI [.777, .922], a średnia różnica między pomiarami wyniosła −0.28 punktu, więc nie było wyraźnego błędu systematycznego.
- Spójność wewnętrzna, np. alfa Cronbacha z pomiaru wyjściowego. W przykładzie α = .888. Alfa opisuje zgodność pozycji w jednym pomiarze, ale nie obejmuje zmienności w czasie.
Przy odchyleniu standardowym pomiaru wyjściowego SD = 7.03 daje to SEM = 2.57 punktu z ICC i SEM = 2.35 punktu z alfy. Gdy pytasz o zmianę między dwoma pomiarami, wybierz rzetelność test–retest, bo to ona odpowiada źródłu błędu, które chcesz wykluczyć. SEM z alfy jest zwykle mniejszy i daje bardziej liberalne kryterium zmiany. W kroku 4 zobaczysz, ilu pacjentów zmienia przez to kategorię.
Wybierz też, które SD wstawić do wzoru. Najczęściej bierze się SD pomiaru wyjściowego w badanej populacji, bo rzetelność i SD powinny pochodzić z podobnej grupy osób. Jak zaplanować badanie powtarzalności, ile osób zbadać i którą formę ICC wybrać, pokazujemy w poradniku badanie rzetelności pomiaru klinicznego.
Krok 2. Minimalna wykrywalna zmiana (MDC95)
Różnica dwóch pomiarów zawiera dwa błędy, więc jej błąd standardowy wynosi √2 × SEM. Minimalna wykrywalna zmiana na poziomie 95% to:
Gdy prawdziwy wynik się nie zmienił, 95% różnic między dwoma pomiarami ma wartość bezwzględną mniejszą niż 7.11 punktu. Ponieważ SOF przyjmuje tylko całkowite wartości, wiarygodna poprawa oznacza w praktyce spadek o co najmniej 8 punktów. Z SEM liczonego z alfy MDC95 wyniósłby 6.51 punktu.
MDC to cecha narzędzia, a nie pacjenta. de Vet i in. (2006) podkreślają, że minimalna wykrywalna zmiana i minimalna istotna zmiana to dwa odrębne punkty odniesienia na skali. Dopiero gdy znasz oba, możesz ocenić, czy narzędzie jest dość precyzyjne, by u pojedynczej osoby wykryć zmianę ważną dla pacjenta. W naszym przykładzie odpowiedź będzie niewygodna (krok 6).
Krok 3. Wskaźnik wiarygodnej zmiany (RCI) według Jacobsona i Truaxa
Jacobson i Truax (1991) zaproponowali wskaźnik wiarygodnej zmiany (reliable change index), który ocenia, czy zmiana u danej osoby jest statystycznie wiarygodna. To zmiana podzielona przez błąd standardowy różnicy:
Wartość |RCI| > 1.96 oznacza zmianę, której prawdopodobieństwo przy samym błędzie pomiaru jest mniejsze niż 5%. Kryterium RCI ≤ −1.96 jest więc równoważne zmianie o co najmniej MDC95: oba opierają się na tym samym SEM i tej samej wartości 1.96. Na skali SOF ujemne RCI oznacza poprawę, a dodatnie – pogorszenie.
| Pacjent | Przed | Po | Zmiana | RCI | Decyzja |
|---|---|---|---|---|---|
| 1 | 32 | 16 | −16 | −4.41 | wiarygodna poprawa |
| 2 | 16 | 9 | −7 | −1.93 | zmiana mieści się w błędzie pomiaru |
| 3 | 23 | 15 | −8 | −2.21 | wiarygodna poprawa |
Pacjenci 2 i 3 różnią się zmianą o jeden punkt, a trafiają do różnych kategorii. To nieunikniona cena każdego progu i powód, dla którego kategorie nie powinny być jedyną analizą. Wynik pacjenta 2 nie znaczy też, że „nic się nie zmieniło”. Znaczy tylko, że tej zmiany nie da się odróżnić od błędu pomiaru.
Krok 4. Klinicznie istotna zmiana: punkty odcięcia a, b i c
RCI mówi, czy zmiana jest wiarygodna, ale nie mówi, dokąd pacjent doszedł. Spadek z 39 do 31 punktów jest wiarygodny, a pacjent wciąż ma duże ograniczenia. Dlatego Jacobson i Truax (1991) połączyli RCI z drugim warunkiem, który operacjonalizuje wcześniejszą definicję klinicznie istotnej zmiany zaproponowaną przez Jacobsona i współpracowników: po terapii pacjent powinien wyjść poza zakres populacji z zaburzeniem albo znaleźć się w zakresie populacji funkcjonującej prawidłowo. Ten drugi warunek operacjonalizują trzy punkty odcięcia (szczegóły w haśle klinicznie istotna zmiana Jacobsona–Truaxa):
b = Mnorm + 2 SDnorm = 4.31 + 2 × 3.89 = 12.08
c = (SDnorm × Mklin + SDklin × Mnorm) / (SDnorm + SDklin) = 10.84
- a – wynik leży ponad 2 SD od średniej populacji klinicznej w kierunku zdrowia. Wymaga tylko danych klinicznych, ale przy dużym rozproszeniu wyników bywa bardzo surowy.
- b – wynik mieści się w granicy 2 SD od średniej populacji bez zaburzeń. Wymaga norm dla populacji zdrowej.
- c – wynik jest bliżej średniej populacji zdrowej niż klinicznej, z uwzględnieniem rozproszenia obu populacji. Wymaga danych z obu populacji i wykorzystuje najwięcej informacji, dlatego gdy masz takie dane, jest naturalnym wyborem.
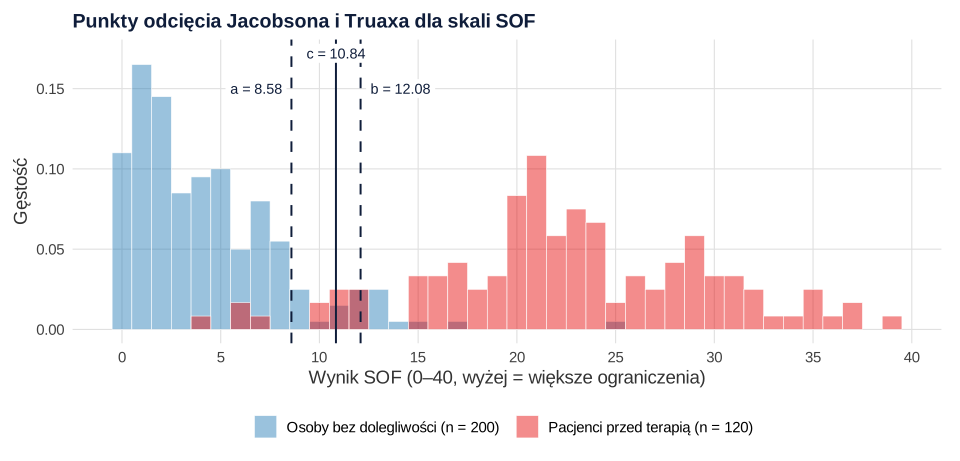
W przykładzie a < b, bo rozkłady obu populacji częściowo na siebie zachodzą. Punkt c leży między nimi. Wybór punktu podaj w metodach przed analizą, a w analizie wrażliwości możesz pokazać wyniki dla pozostałych. Sprawdź też, kto już na starcie był poniżej punktu c: w przykładzie 6 osób. Formalnie nie mogą one „wyzdrowieć”, bo przed terapią nie były w zakresie klinicznym. Wszystkie sześć trafiło do kategorii „bez zmiany”. W raporcie podaj ich liczbę albo opisz, jak je potraktowano.
Krok 5. Analiza responderów: wyzdrowienie, poprawa, bez zmiany, pogorszenie
Połączenie RCI z punktem c daje cztery kategorie, które stosuje się w analizie responderów:
- wyzdrowienie – wiarygodna poprawa (RCI ≤ −1.96) i wynik po terapii poniżej c;
- poprawa – wiarygodna poprawa, ale wynik po terapii wciąż co najmniej równy c;
- bez zmiany – |RCI| < 1.96;
- pogorszenie – wiarygodne pogorszenie (RCI ≥ 1.96).
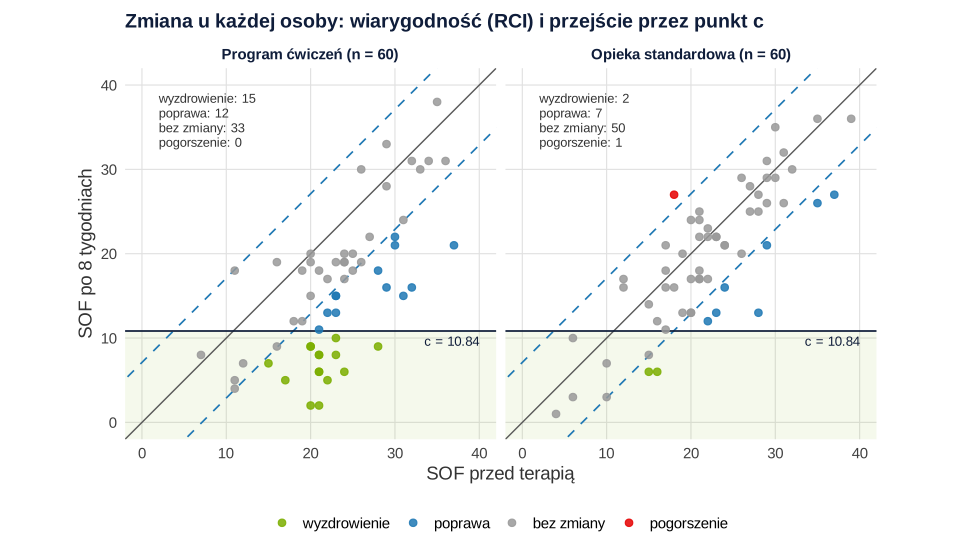
| Kategoria | Program ćwiczeń (n = 60) | Opieka standardowa (n = 60) |
|---|---|---|
| Wyzdrowienie | 15 (25.0%) [15.8, 37.2] | 2 (3.3%) [0.9, 11.4] |
| Poprawa | 12 (20.0%) [11.8, 31.8] | 7 (11.7%) [5.8, 22.2] |
| Bez zmiany | 33 (55.0%) [42.5, 66.9] | 50 (83.3%) [72.0, 90.7] |
| Pogorszenie | 0 (0.0%) [0.0, 6.0] | 1 (1.7%) [0.3, 8.9] |
W nawiasach kwadratowych podano 95% CI Wilsona; Brown i in. (2001) zalecają ten przedział zamiast przedziału Walda, zwłaszcza przy odsetkach bliskich 0% lub 100%, jak w kategorii „pogorszenie”. Rozkład kategorii różnił się między grupami (dokładny test Fishera, p < .001). Wyzdrowienie lub poprawę osiągnęło 45.0% osób w grupie ćwiczeń i 15.0% w grupie opieki standardowej. Różnica wynosi 30.0 punktu procentowego, 95% CI [13.7, 44.3]. Przedział dla różnicy dwóch odsetków policzono metodą Newcombe’a, która łączy przedziały Wilsona dla obu grup i według porównania jedenastu metod dobrze trzyma nominalne pokrycie (Newcombe, 1998).
Ile zależy od wyboru SEM?
Tę samą klasyfikację powtórzyliśmy z SEM liczonym z alfy (2.35 zamiast 2.57 punktu). Kategorię zmieniło 12 osób: 4 przeszły z „bez zmiany” do „wyzdrowienia”, 7 – do „poprawy”, a 1 – do „pogorszenia”. To 10% próby przesunięte tylko przez decyzję o źródle rzetelności. Bauer i in. (2004) porównali pięć metod oceny klinicznie istotnej zmiany u 386 pacjentów psychoterapii i stwierdzili, że wybór metody wpływa na szacowany odsetek zmian. Metoda Jacobsona i Truaxa dawała umiarkowane oszacowania i autorzy zalecili ją do badań nad skutecznością. Wniosek praktyczny: w metodach podaj źródło rzetelności, wartość SEM i wybrany punkt odcięcia, tak aby czytelnik mógł odtworzyć kategorie.
Krok 6. MCID: metoda zakotwiczona i metody rozkładowe
RCI i MDC mówią, czy zmiana jest większa od błędu pomiaru. Nie mówią, czy pacjent ją odczuł. Do tego służy minimalna istotna klinicznie różnica (MCID). Jaeschke i in. (1989) zaproponowali, by wyznaczać ją przez porównanie zmiany wyniku kwestionariusza z globalną oceną zmiany dokonaną przez samego pacjenta. Copay i in. (2007) dzielą metody wyznaczania MCID na dwie rodziny – zakotwiczone i rozkładowe – i pokazują, że każda ma słabości. Ogólne ograniczenia całego pojęcia to wielość oszacowań MCID, utrata perspektywy pacjenta i zależność zmiany od wyniku wyjściowego.
Metoda zakotwiczona
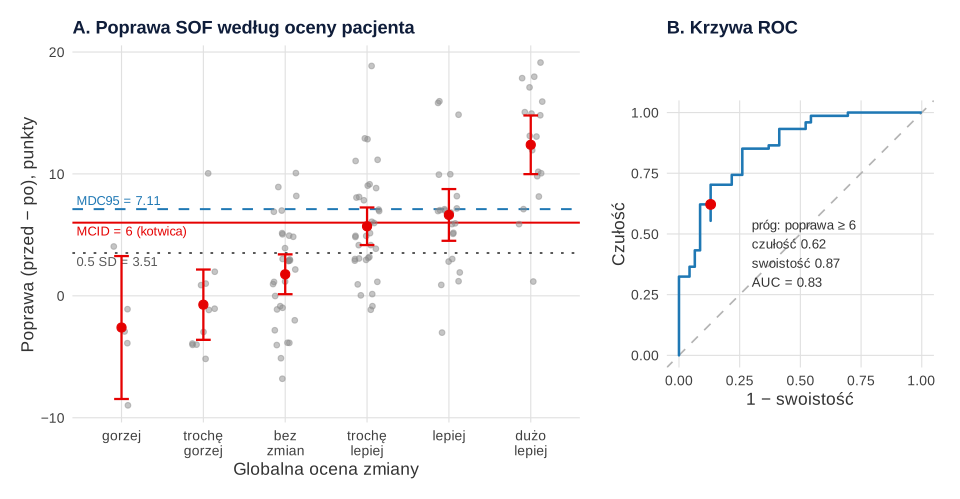
Kotwicą jest tu globalna ocena zmiany po 8 tygodniach. Najprostsze oszacowanie to średnia poprawa u osób, które oceniły swój stan jako „trochę lepiej”.
| Globalna ocena zmiany | n | Poprawa SOF, M (SD) |
|---|---|---|
| Gorzej (−2) | 5 | −2.60 (4.72) |
| Trochę gorzej (−1) | 11 | −0.73 (4.29) |
| Bez zmian (0) | 30 | 1.77 (4.38) |
| Trochę lepiej (+1) | 34 | 5.71 (4.42) |
| Lepiej (+2) | 22 | 6.64 (4.79) |
| Dużo lepiej (+3) | 18 | 12.39 (4.84) |
Poprawa to wynik przed minus wynik po, więc wartości dodatnie oznaczają mniejsze ograniczenia. Nikt nie wybrał odpowiedzi „dużo gorzej”. Średnia poprawa w grupie „trochę lepiej” wyniosła 5.71 punktu, 95% CI [4.16, 7.25]. Drugie podejście to krzywa ROC: szukamy progu poprawy, który najlepiej odróżnia osoby oceniające swój stan co najmniej jako „trochę lepiej” od pozostałych. Pole pod krzywą wyniosło AUC = .83, 95% CI [.76, .91], a próg wybrany indeksem Youdena to poprawa o co najmniej 6 punktów, przy czułości .62 i swoistości .87. Obie metody dają zbliżoną wartość, więc za MCID przyjmujemy 6 punktów.
Metody rozkładowe
Metody rozkładowe nie pytają pacjenta, tylko odnoszą zmianę do rozproszenia wyników. Najczęściej spotkasz dwie:
- pół odchylenia standardowego – Norman i in. (2003) w przeglądzie 38 badań stwierdzili, że oszacowania minimalnej istotnej różnicy dla narzędzi jakości życia były w większości bliskie 0.5 SD; w przykładzie 0.5 × 7.03 = 3.51 punktu;
- jeden SEM – Wyrwich i in. (1999) pokazali u pacjentów z POChP, że 1 SEM był bliski ustalonym wartościom MCID dla wymiarów kwestionariusza CRQ; w przykładzie 2.57 punktu.
Oba progi są tu wyraźnie niższe od wartości z kotwicy. de Vet i in. (2006) zwracają uwagę, że część metod rozkładowych opisuje w istocie minimalną wykrywalną zmianę, a nie zmianę ważną dla pacjenta, i do wyznaczania tej drugiej zalecają metody zakotwiczone. Revicki i in. (2008) idą w tym samym kierunku: MCID nie jest stałą cechą narzędzia, zależy od populacji i kontekstu, powinna wynikać z kilku metod, a podstawą są kotwice oparte na ocenie pacjenta lub klinicysty. Metody rozkładowe mają je wspierać albo zastępować tylko wtedy, gdy kotwicy brak. Jeśli korzystasz z MCID z literatury, wybierz wartość wyznaczoną w populacji podobnej do Twojej i podaj jej źródło – tak jak we wpisie o fizjoterapii, gdzie dla bólu w skali NRS przyjęliśmy wartość ze źródła (zob. też jak analizować skale bólu NRS i VAS). MCID wyznaczona przed badaniem może też posłużyć jako najmniejszy interesujący efekt w analizie mocy.
Kiedy MDC jest większa niż MCID
W przykładzie MCID (6 punktów) jest mniejsza niż MDC95 (7.11 punktu). To częsta i niewygodna sytuacja: narzędzie nie pozwala u pojedynczego pacjenta odróżnić zmiany minimalnie ważnej od błędu pomiaru. 16 osób poprawiło się o co najmniej 6 punktów, ale o mniej niż MDC95. Ich zmiana jest „istotna klinicznie” według MCID, a jednocześnie mieści się w błędzie pomiaru. Na poziomie grupy to nie przeszkadza, bo błędy losowe się uśredniają. Na poziomie decyzji o konkretnym pacjencie – tak.
Odsetek osób z poprawą o co najmniej MCID
Poprawę o co najmniej 6 punktów uzyskało 36 z 60 osób w grupie ćwiczeń (60.0%, 95% CI [47.4, 71.4]) i 16 z 60 w grupie opieki standardowej (26.7%, 95% CI [17.1, 39.0]). Różnica wynosi 33.3 punktu procentowego, 95% CI [15.7, 48.2], χ²(1) = 13.58, p < .001. Porównanie dwóch odsetków omawiamy w haśle test dla dwóch proporcji. Gdy różnicę odsetków chcesz przedstawić klinicystom, możesz ją przeliczyć na NNT.
W badaniach edukacyjnych, gdzie wynikiem jest test wiedzy z górną granicą, zamiast MCID stosuje się czasem znormalizowany przyrost, czyli zmianę odniesioną do tego, ile punktów pozostało do maksimum. Procedurę dla takiego schematu pokazujemy we wpisie badanie wiedzy przed i po szkoleniu.
Krok 7. Cena kategorii: dlaczego analiza główna powinna dotyczyć wyniku ciągłego
Kategorie przemawiają do klinicystów, ale tracą informację. Altman i Royston (2006) podsumowują koszty dychotomizacji zmiennej ciągłej: utratę mocy (podział w medianie obniża ją tak, jak odrzucenie około jednej trzeciej danych), zaniżenie zmienności wyników w grupach i ukrycie nieliniowości. Osoby tuż po obu stronach progu traktuje się jak bardzo różne, choć są do siebie podobne – jak pacjenci 2 i 3 z kroku 3. Snapinn i Jiang (2007) dodają, że analiza responderów może znacznie obniżać efektywność statystyczną i nie osiąga swojego głównego celu, czyli wykazania klinicznie istotnego efektu. Zalecają osobno ocenić istotność statystyczną, a osobno znaczenie kliniczne. Szerzej o tym problemie piszemy w haśle dzielenie medianą.
Na tych samych danych ANCOVA wyniku po terapii z pomiarem wyjściowym jako kowariantem dała różnicę 4.97 punktu na korzyść programu ćwiczeń, 95% CI [2.97, 6.97], t(117) = 4.92, p < .001. Dlaczego ANCOVA jest zwykle lepsza od porównania samych wyników różnicowych, pokazujemy we wpisie ANCOVA w badaniu przed i po.
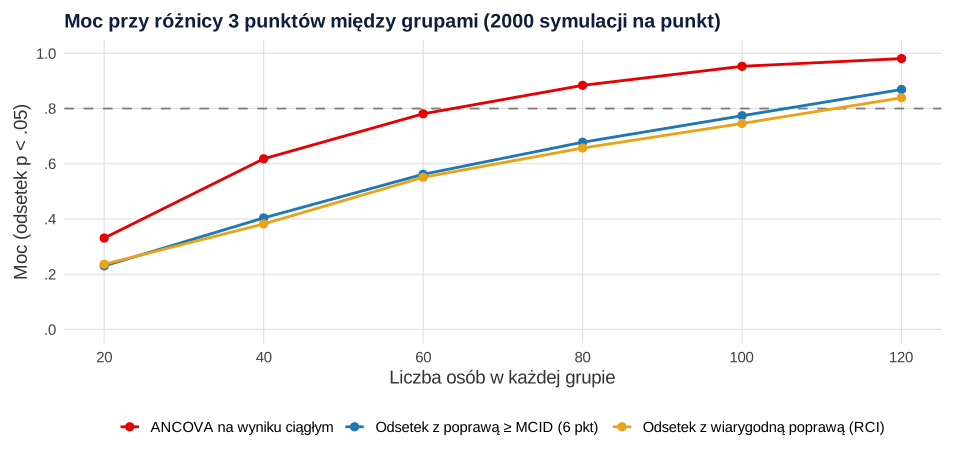
Ile mocy tracimy, licząc tylko odsetki? Rysunek 4 pokazuje symulację: prawdziwa różnica między grupami wynosi 3 punkty, czyli połowę MCID, a pozostałe parametry odpowiadają przykładowi. Dla każdej liczebności powtórzyliśmy badanie 2000 razy i porównaliśmy trzy analizy.
| Osób w grupie | ANCOVA | Poprawa ≥ MCID | Wiarygodna poprawa (RCI) |
|---|---|---|---|
| 20 | .331 | .230 | .236 |
| 40 | .618 | .404 | .382 |
| 60 | .781 | .562 | .551 |
| 80 | .884 | .678 | .657 |
| 100 | .953 | .774 | .746 |
| 120 | .981 | .869 | .839 |
Do mocy .80 ANCOVA potrzebuje około 64 osób na grupę (interpolacja z siatki symulacji), porównanie odsetków z poprawą ≥ MCID – około 105, a porównanie odsetków z wiarygodną poprawą – około 112. Analiza odsetków wymaga więc w tym scenariuszu próby większej o 64–75%. Zaplanuj badanie pod analizę wyniku ciągłego, a odsetki responderów podaj jako analizę drugorzędną, która tłumaczy wynik na język kliniczny. Jak liczyć moc i liczebność dla analizy głównej, opisujemy w poradniku dobór liczebności próby.
Jak opisać RCI, MCID i kategorie zmiany w artykule
W metodach podaj: źródło i wartość rzetelności, SD użyte do SEM, wartość SEM, MDC95, wybrany punkt odcięcia ze źródłem danych normatywnych, definicje kategorii oraz źródło MCID. Kategorie i MCID ustal przed analizą, najlepiej w planie analizy statystycznej (zob. plan analizy statystycznej i prerejestracja). W wynikach najpierw podaj analizę wyniku ciągłego, potem kategorie z odsetkami i przedziałami ufności.
RCI, kryteria Jacobsona–Truaxa i MCID w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepisy 2–4 korzystają z obiektów badanie, norma, sem_icc i mdc95 z przepisu 1, a przepis 3 – z funkcji newcombe() z przepisu 2. ICC(2,1) i alfę liczy pakiet psych, krzywą ROC – pakiet pROC; RCI, punkty odcięcia, przedziały Wilsona i Newcombe’a liczymy wprost ze wzorów. Symulacja mocy w przepisie 4 trwa kilka sekund. Plik Excel do pobrania powstaje w osobnym skrypcie z obiektów z przepisu 1.
1. Dane, rzetelność, SEM i MDC95
R
# Program ćwiczeń a ograniczenia funkcjonalne w przewlekłym bólu krzyża (dane symulowane, set.seed(5701)).
# Skala ograniczeń funkcjonalnych SOF – narzędzie fikcyjne: 20 pozycji 0–2, wynik 0–40, wyższy = większe ograniczenia.
# Trzy zbiory: badanie z losowym przydziałem (ćwiczenia vs opieka standardowa, po 60 osób, pomiar przed i po 8 tygodniach),
# próba osób bez dolegliwości (n = 200) i próba do oceny powtarzalności (n = 50, dwa pomiary w odstępie 7 dni).
suppressPackageStartupMessages(library(psych))
set.seed(5701)
b1 <- seq(-1.6, 0.9, length.out = 20); b2 <- b1 + 1.3            # progi pozycji (model odpowiedzi stopniowanych)
sof <- function(theta, a = 2.4) {                                 # suma 20 pozycji 0–2 dla wektora theta
  p1 <- plogis(a * outer(theta, b1, "-")); p2 <- plogis(a * outer(theta, b2, "-"))
  u <- matrix(runif(length(p1)), nrow(p1))
  pozycje <- (u < p1) + (u < p2)
  list(suma = rowSums(pozycje), pozycje = pozycje)
}
n_gr <- 60
grupa <- factor(rep(c("ćwiczenia", "standard"), each = n_gr), levels = c("ćwiczenia", "standard"))
th_przed <- rnorm(2 * n_gr, 0.55, 0.55)
zmiana_lat <- ifelse(grupa == "ćwiczenia", -0.65, -0.25) + rnorm(2 * n_gr, 0, 0.45)
th_po <- th_przed + zmiana_lat
pomiar_przed <- sof(th_przed)
badanie <- data.frame(id = 1:(2 * n_gr), grupa, przed = pomiar_przed$suma, po = sof(th_po)$suma)
# Globalna ocena zmiany po 8 tygodniach (kotwica): od −3 „dużo gorzej” do +3 „dużo lepiej”
g <- -zmiana_lat / 0.4 + rnorm(2 * n_gr, 0, 0.8)
badanie$groc <- as.integer(cut(g, c(-Inf, -2.5, -1.5, -0.6, 0.6, 1.6, 2.6, Inf))) - 4L
norma <- data.frame(id = 1:200, sof = sof(rnorm(200, -1.35, 0.6))$suma)
th_ret <- rnorm(50, 0.55, 0.55)
retest <- data.frame(id = 1:50, pomiar1 = sof(th_ret)$suma, pomiar2 = sof(th_ret + rnorm(50, 0, 0.08))$suma)

# Statystyki opisowe trzech zbiorów
opis <- function(x) round(c(n = length(x), M = mean(x), SD = sd(x), min = min(x), max = max(x)), 2)
rbind(norma = opis(norma$sof), badanie_przed = opis(badanie$przed), retest_1 = opis(retest$pomiar1),
      cwiczenia_po = opis(badanie$po[grupa == "ćwiczenia"]), standard_po = opis(badanie$po[grupa == "standard"]))

# Rzetelność 1: alfa Cronbacha w pomiarze wyjściowym badania
alfa <- psych::alpha(pomiar_przed$pozycje, warnings = FALSE)$total$raw_alpha
# Rzetelność 2: test–retest, ICC(2,1) – zgodność bezwzględna pojedynczego pomiaru
icc <- psych::ICC(retest[, c("pomiar1", "pomiar2")], lmer = FALSE)$results
icc21 <- icc["Single_random_raters", "ICC"]
round(c(alfa = alfa, ICC_2_1 = icc21, ICC_CI_d = icc["Single_random_raters", "lower bound"],
        ICC_CI_g = icc["Single_random_raters", "upper bound"],
        roznica_M = mean(retest$pomiar2 - retest$pomiar1)), 3)

# SEM = SD × √(1 − r): SD z pomiaru wyjściowego badania, r z test–retest albo z alfy
sd0 <- sd(badanie$przed)
sem_icc <- sd0 * sqrt(1 - icc21); sem_alfa <- sd0 * sqrt(1 - alfa)
mdc95 <- 1.96 * sqrt(2) * sem_icc
round(c(SD_przed = sd0, SEM_icc = sem_icc, SEM_alfa = sem_alfa, S_diff = sqrt(2) * sem_icc,
        MDC95 = mdc95, MDC95_alfa = 1.96 * sqrt(2) * sem_alfa), 2)
Wynik w R
                n     M   SD min max
norma         200  4.31 3.89   0  25
badanie_przed 120 22.63 7.03   4  39
retest_1       50 24.98 6.29  11  37
cwiczenia_po   60 15.77 8.46   2  38
standard_po    60 19.58 8.38   1  36
     alfa   ICC_2_1  ICC_CI_d  ICC_CI_g roznica_M
    0.888     0.867     0.777     0.922    -0.280
  SD_przed    SEM_icc   SEM_alfa     S_diff      MDC95 MDC95_alfa
      7.03       2.57       2.35       3.63       7.11       6.51
2. RCI, punkty odcięcia a, b, c i kategorie zmiany
R
# RCI, punkty odcięcia a, b, c i kategorie zmiany według Jacobsona i Truaxa (1991).
# Korzysta z obiektów badanie, norma, sem_icc i sem_alfa z przepisu 1. Niższy wynik SOF = mniej ograniczeń.
badanie$zmiana <- badanie$po - badanie$przed
s_diff <- sqrt(2) * sem_icc
badanie$rci <- badanie$zmiana / s_diff
round(t(sapply(split(badanie$zmiana, badanie$grupa), function(x) c(M = mean(x), SD = sd(x)))), 2)
head(data.frame(badanie[, c("grupa", "przed", "po", "zmiana")], rci = round(badanie$rci, 2)), 3)

# Punkty odcięcia: populacja z dolegliwościami (pomiar przed) i bez dolegliwości (próba normatywna)
M1 <- mean(badanie$przed); S1 <- sd(badanie$przed); M0 <- mean(norma$sof); S0 <- sd(norma$sof)
pkt_a <- M1 - 2 * S1                                   # a: 2 SD poniżej średniej populacji klinicznej
pkt_b <- M0 + 2 * S0                                   # b: 2 SD powyżej średniej populacji zdrowej
pkt_c <- (S0 * M1 + S1 * M0) / (S0 + S1)               # c: punkt między rozkładami obu populacji
round(c(a = pkt_a, b = pkt_b, c = pkt_c), 2)
table(przed_ponizej_c = badanie$przed < pkt_c)          # osoby, które już na starcie były poniżej c

# Kategorie: wyzdrowienie (wiarygodna poprawa i wynik po < c), poprawa, bez zmiany, pogorszenie
kategoria <- function(rci, po, c) factor(ifelse(rci <= -1.96 & po < c, "wyzdrowienie",
                                         ifelse(rci <= -1.96, "poprawa", ifelse(rci >= 1.96, "pogorszenie", "bez zmiany"))),
                                         levels = c("wyzdrowienie", "poprawa", "bez zmiany", "pogorszenie"))
badanie$kat <- kategoria(badanie$rci, badanie$po, pkt_c)
table(badanie$kat[badanie$przed < pkt_c])
wilson <- function(k, n) prop.test(k, n, correct = FALSE)$conf.int * 100
tabela <- do.call(rbind, lapply(levels(badanie$grupa), function(g) {
  k <- table(badanie$kat[badanie$grupa == g]); n <- sum(k)
  data.frame(grupa = g, kategoria = names(k), n = as.vector(k), proc = round(100 * as.vector(k) / n, 1),
             t(sapply(k, function(x) round(wilson(x, n), 1))), row.names = NULL)
}))
names(tabela)[5:6] <- c("CI_d", "CI_g"); tabela
fisher.test(table(badanie$grupa, badanie$kat))

# Różnica odsetków „wyzdrowienie lub poprawa” z 95% CI Newcombe’a (metoda hybrydowa Wilsona)
newcombe <- function(k1, n1, k2, n2) {
  k1 <- unname(k1); k2 <- unname(k2); p1 <- k1 / n1; p2 <- k2 / n2; w1 <- wilson(k1, n1) / 100; w2 <- wilson(k2, n2) / 100
  c(roznica = p1 - p2, CI_d = p1 - p2 - sqrt((p1 - w1[1])^2 + (w2[2] - p2)^2),
    CI_g = p1 - p2 + sqrt((w1[2] - p1)^2 + (p2 - w2[1])^2)) * 100
}
popr <- tapply(badanie$kat %in% c("wyzdrowienie", "poprawa"), badanie$grupa, sum)
round(100 * popr / 60, 1)                              # odsetek „wyzdrowienie lub poprawa”
round(newcombe(popr[1], 60, popr[2], 60), 1)

# Ta sama decyzja przy SEM z alfy: mniejszy SEM, więc więcej „wiarygodnych” zmian
kat_alfa <- kategoria(badanie$zmiana / (sqrt(2) * sem_alfa), badanie$po, pkt_c)
table(SEM_z_ICC = badanie$kat, SEM_z_alfy = kat_alfa)
c(zmiana_kategorii = sum(badanie$kat != kat_alfa), proc = round(100 * mean(badanie$kat != kat_alfa), 1))

# Dla porównania: analiza wyniku ciągłego – ANCOVA z pomiarem wyjściowym
m <- lm(po ~ przed + grupa, data = badanie)
round(c(roznica = unname(coef(m)["grupastandard"]), confint(m)["grupastandard", ]), 2)
summary(m)$coefficients["grupastandard", c("t value", "Pr(>|t|)")]
Wynik w R
              M   SD
ćwiczenia -7.50 6.22
standard  -2.42 4.72
      grupa przed po zmiana   rci
1 ćwiczenia    32 16    -16 -4.41
2 ćwiczenia    16  9     -7 -1.93
3 ćwiczenia    23 15     -8 -2.21
    a     b     c
 8.58 12.08 10.84
przed_ponizej_c
FALSE  TRUE
  114     6

wyzdrowienie      poprawa   bez zmiany  pogorszenie
           0            0            6            0
      grupa    kategoria  n proc CI_d CI_g
1 ćwiczenia wyzdrowienie 15 25.0 15.8 37.2
2 ćwiczenia      poprawa 12 20.0 11.8 31.8
3 ćwiczenia   bez zmiany 33 55.0 42.5 66.9
4 ćwiczenia  pogorszenie  0  0.0  0.0  6.0
5  standard wyzdrowienie  2  3.3  0.9 11.4
6  standard      poprawa  7 11.7  5.8 22.2
7  standard   bez zmiany 50 83.3 72.0 90.7
8  standard  pogorszenie  1  1.7  0.3  8.9

	Fisher's Exact Test for Count Data

data:  table(badanie$grupa, badanie$kat)
p-value = 0.0004562
alternative hypothesis: two.sided

ćwiczenia  standard
       45        15
roznica    CI_d    CI_g
   30.0    13.7    44.3
              SEM_z_alfy
SEM_z_ICC      wyzdrowienie poprawa bez zmiany pogorszenie
  wyzdrowienie           17       0          0           0
  poprawa                 0      19          0           0
  bez zmiany              4       7         71           1
  pogorszenie             0       0          0           1
zmiana_kategorii             proc
              12               10
roznica   2.5 %  97.5 %
   4.97    2.97    6.97
     t value     Pr(>|t|)
4.918534e+00 2.876166e-06
3. MCID: kotwica, krzywa ROC i metody rozkładowe
R
# MCID: metoda zakotwiczona (globalna ocena zmiany) i metody rozkładowe; odsetek osób z poprawą ≥ MCID.
# Korzysta z obiektów badanie, sd0, sem_icc i mdc95 z przepisów 1–2.
suppressPackageStartupMessages(library(pROC))
badanie$poprawa <- -badanie$zmiana                    # dodatnia wartość = zmniejszenie ograniczeń
etyk <- c("-3" = "dużo gorzej", "-2" = "gorzej", "-1" = "trochę gorzej", "0" = "bez zmian",
          "1" = "trochę lepiej", "2" = "lepiej", "3" = "dużo lepiej")
kot <- t(sapply(split(badanie$poprawa, factor(badanie$groc, levels = -3:3)), function(x)
  if (length(x)) c(n = length(x), M = mean(x), SD = sd(x)) else c(n = 0, M = NA, SD = NA)))
rownames(kot) <- etyk[rownames(kot)]; round(kot, 2)

# 1. Średnia zmiana w grupie „trochę lepiej” (z 95% CI)
x <- badanie$poprawa[badanie$groc == 1]
round(c(MCID_srednia = mean(x), mean(x) + c(-1, 1) * qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))), 2)

# 2. Krzywa ROC: co najmniej „trochę lepiej” vs „bez zmian” lub gorzej; próg z indeksu Youdena
badanie$lepiej <- as.integer(badanie$groc >= 1)
r <- roc(badanie$lepiej, badanie$poprawa, levels = c(0, 1), direction = "<", quiet = TRUE)
round(c(AUC = as.numeric(auc(r)), as.numeric(ci.auc(r))[c(1, 3)]), 3)
coords(r, "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"))

# 3. Metody rozkładowe: 0.5 SD pomiaru wyjściowego i 1 SEM – zestawione z MDC95
round(c(pol_SD = 0.5 * sd0, jeden_SEM = sem_icc, MDC95 = mdc95), 2)

# Analiza responderów: poprawa o co najmniej 6 punktów (zaokrąglone MCID z kotwicy)
mcid <- 6
resp <- t(sapply(split(badanie$poprawa >= mcid, badanie$grupa), function(v) {
  k <- sum(v); n <- length(v); c(n = n, k = k, proc = 100 * k / n, prop.test(k, n, correct = FALSE)$conf.int * 100) }))
colnames(resp)[4:5] <- c("CI_d", "CI_g"); round(resp, 1)
round(newcombe(resp[1, "k"], 60, resp[2, "k"], 60), 1)
chisq.test(table(badanie$grupa, badanie$poprawa >= mcid), correct = FALSE)
# Ile osób z poprawą ≥ MCID nie przekroczyło MDC95 (zmiana możliwa do pomylenia z błędem pomiaru)?
sum(badanie$poprawa >= mcid & badanie$poprawa < mdc95)
Wynik w R
               n     M   SD
dużo gorzej    0    NA   NA
gorzej         5 -2.60 4.72
trochę gorzej 11 -0.73 4.29
bez zmian     30  1.77 4.38
trochę lepiej 34  5.71 4.42
lepiej        22  6.64 4.79
dużo lepiej   18 12.39 4.84
MCID_srednia
        5.71         4.16         7.25
  AUC
0.834 0.761 0.907
  threshold sensitivity specificity
1       5.5   0.6216216   0.8695652
   pol_SD jeden_SEM     MDC95
     3.51      2.57      7.11
           n  k proc CI_d CI_g
ćwiczenia 60 36 60.0 47.4 71.4
standard  60 16 26.7 17.1 39.0
roznica    CI_d    CI_g
   33.3    15.7    48.2

	Pearson's Chi-squared test

data:  table(badanie$grupa, badanie$poprawa >= mcid)
X-squared = 13.575, df = 1, p-value = 0.0002293

[1] 16
4. Symulacja: moc ANCOVA a moc analizy responderów
R
# Koszt dychotomizacji: moc ANCOVA na wyniku ciągłym a moc porównania odsetków responderów.
# Uproszczony model normalny o parametrach z przykładu: SD pomiaru wyjściowego 7, SEM 2.6,
# zmienność prawdziwej zmiany między osobami SD 4.8; prawdziwa różnica między grupami 3 punkty.
set.seed(5704)
moc_jednej <- function(n, efekt = 3, R = 2000, sem = 2.6, sd_t = sqrt(7^2 - 2.6^2), sd_zm = 4.8,
                       mcid = 6, mdc = 7.11) {
  wyn <- replicate(R, {
    g <- rep(0:1, each = n)                            # 0 = opieka standardowa, 1 = ćwiczenia
    t0 <- rnorm(2 * n, 22.6, sd_t)
    t1 <- t0 - 2.4 - efekt * g + rnorm(2 * n, 0, sd_zm)
    x0 <- t0 + rnorm(2 * n, 0, sem); x1 <- t1 + rnorm(2 * n, 0, sem)
    p_ancova <- summary(lm(x1 ~ x0 + g))$coefficients["g", 4]
    test_odsetkow <- function(v) {                     # test chi-kwadrat 2 × 2 bez poprawki
      k <- c(sum(v[g == 1]), sum(v[g == 0])); if (sum(k) %in% c(0, 2 * n)) return(1)
      suppressWarnings(prop.test(k, c(n, n), correct = FALSE)$p.value)
    }
    c(ANCOVA = p_ancova, MCID = test_odsetkow(x0 - x1 >= mcid), RCI = test_odsetkow(x0 - x1 >= mdc))
  })
  rowMeans(wyn < .05)
}
n_grupy <- c(20, 40, 60, 80, 100, 120)
moc <- t(sapply(n_grupy, moc_jednej))
moc <- data.frame(n_na_grupe = n_grupy, round(moc, 3)); moc
# Ile osób na grupę potrzeba do mocy .80 (interpolacja liniowa między punktami siatki)?
n80 <- sapply(moc[, -1], function(m) round(approx(m, n_grupy, xout = .80)$y)); n80
round(100 * (n80 / n80["ANCOVA"] - 1))                 # o ile % większa próba niż dla ANCOVA
Wynik w R
  n_na_grupe ANCOVA  MCID   RCI
1         20  0.331 0.230 0.236
2         40  0.618 0.404 0.382
3         60  0.781 0.562 0.551
4         80  0.884 0.678 0.657
5        100  0.953 0.774 0.746
6        120  0.981 0.869 0.839
ANCOVA   MCID    RCI
    64    105    112
ANCOVA   MCID    RCI
     0     64     75
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), prop.test(), fisher.test() i chisq.test() z pakietu stats); plik do pobrania zapisano pakietem openxlsx, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy RCI, MDC i MCID
- Mylenie MDC z MCID. MDC mówi, jaka zmiana przekracza błąd pomiaru, MCID – jaka zmiana jest ważna dla pacjenta. Liczy się je z innych danych i odpowiadają na inne pytania (de Vet i in., 2006).
- SEM z alfy bez uzasadnienia. Alfa nie obejmuje zmienności w czasie, więc zwykle daje mniejszy SEM i więcej „wiarygodnych” zmian. Gdy masz dane test–retest, użyj ich, a wybór opisz w metodach.
- SEM z innej populacji. Rzetelność i SD z próby studentów nie pasują do pacjentów w ostrym stanie. Weź wartości z populacji podobnej do badanej.
- MCID przepisana z innego narzędzia lub innej choroby. MCID zależy od populacji i kontekstu (Revicki i in., 2008). Podaj źródło i oceń, czy pasuje do Twojej grupy.
- Metoda rozkładowa przedstawiona jako MCID. 0.5 SD lub 1 SEM to przybliżenia; nazwij je wprost i nie traktuj jak wartości z kotwicy.
- Odsetki bez przedziałów ufności. Przy 60 osobach w grupie 95% CI dla odsetka 25% sięga od około 16% do 37%. Podaj go zawsze.
- Kategorie jako jedyna analiza. Analiza responderów ma mniejszą moc (Snapinn i Jiang, 2007; Altman i Royston, 2006). Analiza główna powinna dotyczyć wyniku ciągłego.
- Próg wybrany po obejrzeniu wyników. Punkt odcięcia, źródło SEM i MCID ustal przed analizą. Wybieranie progu, który daje najmniejsze p, prowadzi do fałszywych wyników.
- „Wyzdrowienie” osób, które startowały w zakresie normy. Sprawdź, ile osób było poniżej punktu c przed terapią, i opisz, jak je potraktowano.
- Zmiana w jednej grupie jako dowód skuteczności. Część poprawy to regresja do średniej i naturalny przebieg. Porównuj odsetki z grupą kontrolną, nie z zerem.
Jeśli przygotowujesz artykuł z badania interwencyjnego i chcesz, by ktoś sprawdził definicje kategorii, źródło SEM i analizę główną przed wysłaniem do czasopisma, możesz skonsultować projekt w ramach oferty analizy statystyczne dla badaczy.
Najczęstsze pytania
Jak policzyć wskaźnik wiarygodnej zmiany RCI?
Policz SEM = SD × √(1 − r), najlepiej z rzetelnością test–retest, a potem Sdiff = √2 × SEM. RCI to różnica wyników po i przed podzielona przez Sdiff. Wartość |RCI| > 1.96 oznacza zmianę wiarygodną na poziomie 95% (Jacobson i Truax, 1991).
Czym różni się MDC od MCID?
MDC (minimalna wykrywalna zmiana) wynika z błędu pomiaru i mówi, jaka zmiana przekracza szum narzędzia. MCID (minimalna istotna klinicznie różnica) mówi, jaka zmiana jest odczuwalna lub ważna dla pacjenta, i wyznacza się ją głównie z oceny pacjenta. Gdy MDC jest większa od MCID, narzędzie nie wykrywa wiarygodnie minimalnie ważnej zmiany u pojedynczej osoby.
Który punkt odcięcia Jacobsona i Truaxa wybrać: a, b czy c?
Punkt a wymaga tylko danych klinicznych (2 SD od średniej pacjentów), b – norm dla populacji zdrowej, a c łączy informacje o obu populacjach. Gdy masz dane normatywne, c wykorzystuje najwięcej informacji. Wybór podaj w metodach przed analizą.
Jak wyznaczyć MCID metodą zakotwiczoną?
Zbierz po terapii globalną ocenę zmiany przez pacjenta (np. od „dużo gorzej” do „dużo lepiej”). MCID to średnia zmiana u osób, które oceniły swój stan jako „trochę lepiej”, albo próg z krzywej ROC odróżniający osoby z poprawą od pozostałych. Metody rozkładowe (0.5 SD, 1 SEM) traktuj jako uzupełnienie.
Czy analiza responderów może zastąpić analizę wyniku ciągłego?
Nie. Zamiana wyniku ciągłego na kategorie zmniejsza moc i może nie wykazać efektu, który wykrywa analiza ciągła. Analiza główna powinna dotyczyć wyniku ciągłego (np. ANCOVA), a odsetki responderów z 95% CI warto podać jako analizę drugorzędną.
Powiązane hasła
Przeczytaj też
Statystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →PoradnikBadanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →Raportujesz zmianę kliniczną w artykule?
Sprawdzimy źródło SEM, definicje kategorii zmiany i MCID oraz analizę główną, tak aby wyniki były spójne i odporne na uwagi recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Royston, P. (2006). The cost of dichotomising continuous variables. BMJ, 332(7549), 1080. https://doi.org/10.1136/bmj.332.7549.1080 ● Otwarty dostęp
- Bauer, S., Lambert, M. J., & Nielsen, S. L. (2004). Clinical significance methods: A comparison of statistical techniques. Journal of Personality Assessment, 82(1), 60–70. https://doi.org/10.1207/s15327752jpa8201_11
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Copay, A. G., Subach, B. R., Glassman, S. D., Polly, D. W., Jr., & Schuler, T. C. (2007). Understanding the minimum clinically important difference: A review of concepts and methods. The Spine Journal, 7(5), 541–546. https://doi.org/10.1016/j.spinee.2007.01.008
- de Vet, H. C. W., Terwee, C. B., Ostelo, R. W. J. G., Beckerman, H., Knol, D. L., & Bouter, L. M. (2006). Minimal changes in health status questionnaires: Distinction between minimally detectable change and minimally important change. Health and Quality of Life Outcomes, 4(1), Article 54. https://doi.org/10.1186/1477-7525-4-54 ● Otwarty dostęp
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006x.59.1.12
- Jaeschke, R., Singer, J., & Guyatt, G. H. (1989). Measurement of health status: Ascertaining the minimal clinically important difference. Controlled Clinical Trials, 10(4), 407–415. https://doi.org/10.1016/0197-2456(89)90005-6
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Norman, G. R., Sloan, J. A., & Wyrwich, K. W. (2003). Interpretation of changes in health-related quality of life: The remarkable universality of half a standard deviation. Medical Care, 41(5), 582–592. https://doi.org/10.1097/01.mlr.0000062554.74615.4c
- Revicki, D., Hays, R. D., Cella, D., & Sloan, J. (2008). Recommended methods for determining responsiveness and minimally important differences for patient-reported outcomes. Journal of Clinical Epidemiology, 61(2), 102–109. https://doi.org/10.1016/j.jclinepi.2007.03.012
- Snapinn, S. M., & Jiang, Q. (2007). Responder analyses and the assessment of a clinically relevant treatment effect. Trials, 8(1), Article 31. https://doi.org/10.1186/1745-6215-8-31 ● Otwarty dostęp
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. Journal of Strength and Conditioning Research, 19(1), 231–240. https://doi.org/10.1519/15184.1
- Wyrwich, K. W., Tierney, W. M., & Wolinsky, F. D. (1999). Further evidence supporting an SEM-based criterion for identifying meaningful intra-individual changes in health-related quality of life. Journal of Clinical Epidemiology, 52(9), 861–873. https://doi.org/10.1016/s0895-4356(99)00071-2
Cytowania BibTeX
@article{altman2006cost, author={Altman, Douglas G. and Royston, Patrick}, title={{The cost of dichotomising continuous variables}}, journal={BMJ}, year={2006}, volume={332}, number={7549}, pages={1080}, doi={10.1136/bmj.332.7549.1080}}@article{bauer2004clinical, author={Bauer, Stephanie and Lambert, Michael J. and Nielsen, Scott L.}, title={{Clinical significance methods: A comparison of statistical techniques}}, journal={Journal of Personality Assessment}, year={2004}, volume={82}, number={1}, pages={60--70}, doi={10.1207/s15327752jpa8201_11}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{copay2007understanding, author={Copay, Anne G. and Subach, Brian R. and Glassman, Steven D. and Polly, Jr., David W. and Schuler, Thomas C.}, title={{Understanding the minimum clinically important difference: A review of concepts and methods}}, journal={The Spine Journal}, year={2007}, volume={7}, number={5}, pages={541--546}, doi={10.1016/j.spinee.2007.01.008}}@article{devet2006minimal, author={de Vet, Henrica C. W. and Terwee, Caroline B. and Ostelo, Raymond W. J. G. and Beckerman, Heleen and Knol, Dirk L. and Bouter, Lex M.}, title={{Minimal changes in health status questionnaires: Distinction between minimally detectable change and minimally important change}}, journal={Health and Quality of Life Outcomes}, year={2006}, volume={4}, number={1}, eid={54}, doi={10.1186/1477-7525-4-54}}@article{jacobson1991clinical, author={Jacobson, Neil S. and Truax, Paula}, title={{Clinical significance: A statistical approach to defining meaningful change in psychotherapy research}}, journal={Journal of Consulting and Clinical Psychology}, year={1991}, volume={59}, number={1}, pages={12--19}, doi={10.1037/0022-006x.59.1.12}}@article{jaeschke1989measurement, author={Jaeschke, Roman and Singer, Joel and Guyatt, Gordon H.}, title={{Measurement of health status: Ascertaining the minimal clinically important difference}}, journal={Controlled Clinical Trials}, year={1989}, volume={10}, number={4}, pages={407--415}, doi={10.1016/0197-2456(89)90005-6}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{norman2003interpretation, author={Norman, Geoffrey R. and Sloan, Jeff A. and Wyrwich, Kathleen W.}, title={{Interpretation of changes in health-related quality of life: The remarkable universality of half a standard deviation}}, journal={Medical Care}, year={2003}, volume={41}, number={5}, pages={582--592}, doi={10.1097/01.mlr.0000062554.74615.4c}}@article{revicki2008recommended, author={Revicki, Dennis and Hays, Ron D. and Cella, David and Sloan, Jeff}, title={{Recommended methods for determining responsiveness and minimally important differences for patient-reported outcomes}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={2}, pages={102--109}, doi={10.1016/j.jclinepi.2007.03.012}}@article{snapinn2007responder, author={Snapinn, Steven M. and Jiang, Qi}, title={{Responder analyses and the assessment of a clinically relevant treatment effect}}, journal={Trials}, year={2007}, volume={8}, number={1}, eid={31}, doi={10.1186/1745-6215-8-31}}@article{weir2005quantifying, author={Weir, Joseph P.}, title={{Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM}}, journal={Journal of Strength and Conditioning Research}, year={2005}, volume={19}, number={1}, pages={231--240}, doi={10.1519/15184.1}}@article{wyrwich1999further, author={Wyrwich, Kathleen W. and Tierney, William M. and Wolinsky, Fredric D.}, title={{Further evidence supporting an SEM-based criterion for identifying meaningful intra-individual changes in health-related quality of life}}, journal={Journal of Clinical Epidemiology}, year={1999}, volume={52}, number={9}, pages={861--873}, doi={10.1016/s0895-4356(99)00071-2}}