Szkolenie, dwa pomiary i jedno pytanie: czy wiedza wzrosła?
Typowy projekt w pracy z pielęgniarstwa, położnictwa czy zdrowia publicznego wygląda tak: przed szkoleniem uczestnicy rozwiązują krótki test wiedzy, potem odbywa się sesja edukacyjna, a po niej ten sam test wypełniają jeszcze raz. Czasem dochodzi trzeci pomiar po kilku tygodniach. To schemat pretest–posttest w jednej grupie, bez grupy kontrolnej. Taki plan odpowiada na pytanie, czy wyniki po szkoleniu są wyższe niż przed nim. Nie odpowiada natomiast w pełni na pytanie, czy wzrost spowodowało szkolenie. O tej różnicy piszemy szerzej w części o ograniczeniach. Warto ją jednak mieć w głowie od początku, bo od niej zależy, jak sformułujesz cel pracy i wnioski.
Ten poradnik dotyczy porównania dwóch lub trzech pomiarów u tych samych osób. Jak zbudować test wiedzy, punktować odpowiedzi, policzyć KR-20 i zrobić analizę pozycji w jednorazowej ankiecie, opisujemy w poradniku ankieta wiedzy – analiza krok po kroku. Zakładamy, że masz już klucz odpowiedzi i każdą odpowiedź zapisaną jako 1 (zgodna z kluczem) albo 0 (błędna lub „nie wiem”). Inne typowe projekty prac pielęgniarskich znajdziesz w poradniku statystyka w pracy z pielęgniarstwa.
Badanie przykładowe: edukacja przed insulinoterapią
Wyobraź sobie pracę licencjacką z pielęgniarstwa. W poradni diabetologicznej 64 pacjentów z cukrzycą typu 2, którym lekarz zalecił rozpoczęcie insulinoterapii, wzięło udział w sesji edukacyjnej prowadzonej przez pielęgniarkę. Wiedzę mierzono autorskim testem z 12 pytań jednokrotnego wyboru (m.in. o przechowywaniu insuliny, miejscach wstrzyknięć i postępowaniu przy niedocukrzeniu). Test wypełniono trzy razy: przed sesją (T1), bezpośrednio po niej (T2) i podczas wizyty kontrolnej po trzech miesiącach (T3). Na wizytę kontrolną nie przyszło 14 osób. Dane są symulowane, ale mają typowe dla takich badań własności. Możesz je pobrać jako plik XLSX (odpowiedzi 0/1 na każde pytanie w każdym pomiarze, sumy punktów i arkusz z opisem zmiennych).
| Pomiar | n | M | SD | Me [Q1, Q3] | Poprawne odpowiedzi |
|---|---|---|---|---|---|
| T1: przed sesją | 64 | 6.59 | 2.36 | 7 [5, 8] | 54.9% |
| T2: bezpośrednio po | 64 | 8.84 | 2.57 | 9 [8, 11] | 73.7% |
Średnio uczestnicy odpowiadali poprawnie na nieco ponad połowę pytań przed sesją i na blisko trzy czwarte po niej. To jednak dopiero opis. Analiza ma odpowiedzieć na pięć pytań, a każde wymaga innego narzędzia.
| Krok | Pytanie | Analiza | Wielkość efektu |
|---|---|---|---|
| 1 | Czy wynik testu wzrósł? | test t dla prób zależnych albo test Wilcoxona | dz, korelacja rangowo-dwuseryjna |
| 2 | Które pytania się poprawiły? | test McNemara dla każdego pytania, korekta Holma | odsetki przed i po, pary niezgodne |
| 3 | Jaką część możliwego przyrostu osiągnięto? | znormalizowany przyrost | ⟨g⟩ albo średnie c |
| 4 | Czy zmienił się odsetek osób z wysokim poziomem wiedzy? | test Bowkera (3 × 3) albo McNemara (2 × 2) | odsetki w kategoriach |
| 5 | Czy wiedza utrzymała się po trzech miesiącach? | test Friedmana albo model mieszany | W Kendalla, różnice średnich z CI |
Główną hipotezę zawsze testuj na wyniku sumarycznym (krok 1). Analizy pytań, przyrostu i poziomów są uzupełnieniem. Ustal tę kolejność przed obejrzeniem danych i zapisz ją w planie analiz, bo inaczej łatwo wybrać tę analizę, która „wyszła najlepiej”.
Krok 1. Wynik sumaryczny: test t dla prób zależnych czy test Wilcoxona?
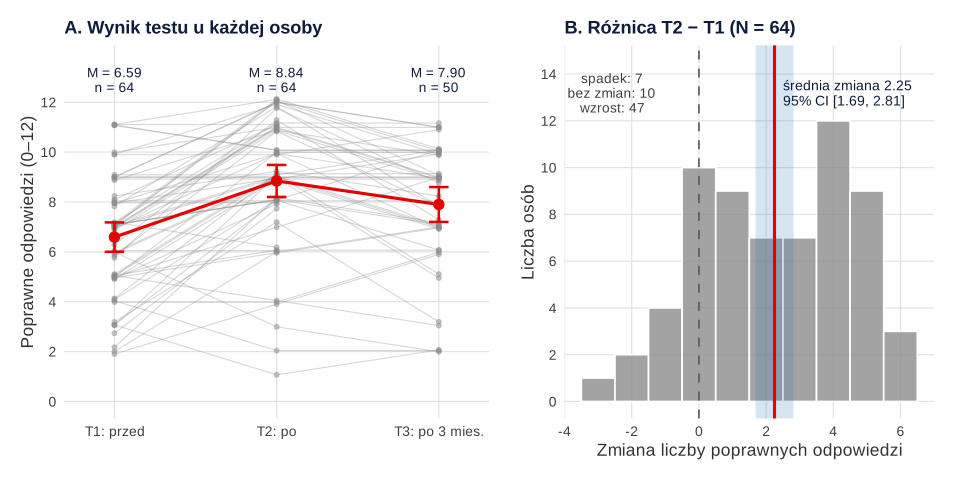
Każda osoba ma dwa wyniki, więc porównujesz różnice wewnątrz osób, a nie dwie niezależne grupy. Policz dla każdego pacjenta różnicę T2 − T1 i dopiero ją opisz. W przykładzie średnia różnica wynosi 2.25 punktu (SD = 2.26). Wynik poprawił się u 47 osób, nie zmienił u 10, a pogorszył u 7. Wyniki z obu pomiarów są ze sobą skorelowane (r = .58). Ta korelacja pomiarów przed i po jest powodem, dla którego test dla prób zależnych ma większą moc niż porównanie dwóch niezależnych grup.
Test t dla prób zależnych i dz
Test t dla prób zależnych sprawdza, czy średnia różnic odbiega od zera. Założenie o normalności dotyczy rozkładu różnic, a nie wyników z każdego pomiaru. Test Shapiro–Wilka dla różnic dał tu W = 0.95, p = .013, ale histogram na rysunku 1B nie pokazuje skrajnej skośności, a przy 64 parach test t dobrze znosi takie odstępstwa. Wynik: t(63) = 7.96, p < .001, średnia zmiana 2.25 punktu, 95% CI [1.69, 2.81].
Wielkość efektu w planie wewnątrzosobowym możesz wystandaryzować na dwa sposoby. dz to średnia różnic podzielona przez SD różnic: dz = 1.00, 95% CI [0.70, 1.29]. dav dzieli średnią różnicę przez średnie SD obu pomiarów: dav = 0.91, 95% CI [0.69, 1.14]. Lakens (2013) pokazuje, że te miary odpowiadają na różne pytania i nie są wymienne. dz mówi o spójności zmiany u poszczególnych osób, a dav łatwiej porównać z badaniami, w których porównywano niezależne grupy. W pracy napisz, którą policzyłeś. Więcej o wyborze piszemy w haśle wielkość efektu dla prób zależnych, a całą procedurę testu t – w poradniku test t Studenta krok po kroku.
Test Wilcoxona: kiedy go wybrać i co zrobić z zerami
Test wiedzy z kilkunastu pytań daje wynik całkowity w wąskim zakresie, często z wyraźnym efektem sufitu po szkoleniu. Gdy pytań jest mało (np. 5–8), próba mała, a różnice bardzo skośne, rozsądniej wybrać test Wilcoxona dla par. Odpowiada on na nieco inne pytanie niż test t: nie porównuje średnich, tylko sprawdza, czy dodatnie zmiany przeważają nad ujemnymi, biorąc pod uwagę ich rangi. Szczegółowo opisujemy go w poradniku testy nieparametryczne krok po kroku.
W testach wiedzy szczególny problem stanowią zera, czyli osoby z identycznym wynikiem w obu pomiarach. W przykładzie jest ich 10. Klasyczna procedura usuwa je przed rangowaniem. Tak działa funkcja wilcox.test() w R: V = 1394.5, p < .001, a w wersji z pakietu coin Z = 5.64. Pratt (1959) pokazał, że usuwanie zer może prowadzić do paradoksalnych wyników, i zaproponował, by rangować je razem z pozostałymi różnicami, a dopiero potem pominąć ich rangi. W tej wersji Z = 5.73, p < .001. Wniosek jest tu ten sam, ale przy wielu zerach i małej próbie wersje mogą się różnić, więc w pracy napisz, jak potraktowałeś osoby bez zmiany.
Jako wielkość efektu podaj korelację rangowo-dwuseryjną dla par: r = .88, 95% CI [.80, .93]. Kerby (2014) proponuje prosty sposób jej rozumienia: to różnica między odsetkiem sumy rang „za” hipotezą (wzrost) a odsetkiem sumy rang „przeciw” niej (spadek). Wartość .88 oznacza, że rangi wzrostów zdecydowanie przeważają.
Krok 2. Pojedyncze pytania: test McNemara z korektą Holma
Promotorzy często proszą o pokazanie, które zagadnienia uczestnicy opanowali, a które nadal sprawiają trudność. Do porównania odpowiedzi 0/1 na to samo pytanie przed i po szkoleniu służy test McNemara. McNemar (1947) zaproponował go do oceny różnicy między proporcjami skorelowanymi, czyli takimi, które pochodzą od tych samych osób.
Logika testu jest prosta. Osoby, które odpowiedziały tak samo w obu pomiarach (dwa razy dobrze albo dwa razy źle), nie mówią nic o zmianie. Liczą się tylko pary niezgodne: b osób, które przed szkoleniem odpowiedziały dobrze, a po nim źle, i c osób, które przeszły od złej do dobrej odpowiedzi. Gdyby szkolenie nic nie zmieniało, oba kierunki byłyby równie częste. Statystyka asymptotyczna ma postać:
W pytaniu 4 (miejsca wstrzyknięć) tylko 1 osoba przeszła od dobrej do złej odpowiedzi, a 27 od złej do dobrej: χ²(1) = 24.14, p < .001. Pembury Smith i Ruxton (2020) zauważają, że w publikacjach często stosuje się tu zwykły test chi-kwadrat niezależności. To błąd, bo sprawdza on inną hipotezę zerową niż test McNemara. Autorzy podkreślają też, że rzadko podaje się, który wariant testu McNemara zastosowano. Fagerland i in. (2013) porównali te warianty w 9595 scenariuszach. Test mid-p nie przekroczył w nich nominalnego poziomu istotności i miał moc prawie taką jak test asymptotyczny. Natomiast test dokładny warunkowy i test asymptotyczny z poprawką na ciągłość nie sprawdziły się w żadnym scenariuszu. Funkcja mcnemar.test() w R domyślnie stosuje poprawkę na ciągłość, więc dopisz correct = FALSE albo policz mid-p, tak jak w kodzie na końcu wpisu.
Dwanaście testów naraz: korekta Holma
Dwanaście pytań oznacza dwanaście testów. Przy poziomie .05 dla każdego z nich szansa na co najmniej jeden fałszywy alarm wyraźnie rośnie (zob. problem wielokrotnych porównań). Holm (1979) zaproponował procedurę, która porządkuje wartości p od najmniejszej i porównuje je z coraz łagodniejszymi progami. Kontroluje ona ryzyko błędu dla całej rodziny testów i jest zawsze co najmniej tak mocna jak korekta Bonferroniego. Porównanie metod korekty znajdziesz w poradniku poprawki na wielokrotne porównania.
| Pytanie | T1 | T2 | b (1 → 0) | c (0 → 1) | p (mid-p) | p po korekcie Holma |
|---|---|---|---|---|---|---|
| 1 | 89.1% | 90.6% | 6 | 7 | .791 | 1.000 |
| 2 | 84.4% | 90.6% | 3 | 7 | .227 | .680 |
| 3 | 71.9% | 84.4% | 4 | 12 | .049 | .294 |
| 4 | 53.1% | 93.8% | 1 | 27 | < .001 | < .001 |
| 5 | 57.8% | 60.9% | 13 | 15 | .711 | 1.000 |
| 6 | 53.1% | 78.1% | 5 | 21 | .002 | .014 |
| 7 | 57.8% | 73.4% | 10 | 20 | .071 | .354 |
| 8 | 45.3% | 79.7% | 1 | 23 | < .001 | < .001 |
| 9 | 25.0% | 46.9% | 6 | 20 | .006 | .041 |
| 10 | 28.1% | 53.1% | 8 | 24 | .005 | .036 |
| 11 | 29.7% | 43.8% | 10 | 19 | .099 | .395 |
| 12 | 64.1% | 89.1% | 3 | 19 | < .001 | .005 |
Bez korekty istotna byłaby zmiana w siedmiu pytaniach, po korekcie Holma – w sześciu. Pytanie 3 (p = .049) „wypadło”, bo przy dwunastu testach pojedyncze p tuż pod .05 to zbyt słaby dowód. Rysunek 2 pokazuje te same wyniki w formie łatwiejszej do odczytania niż tabela.
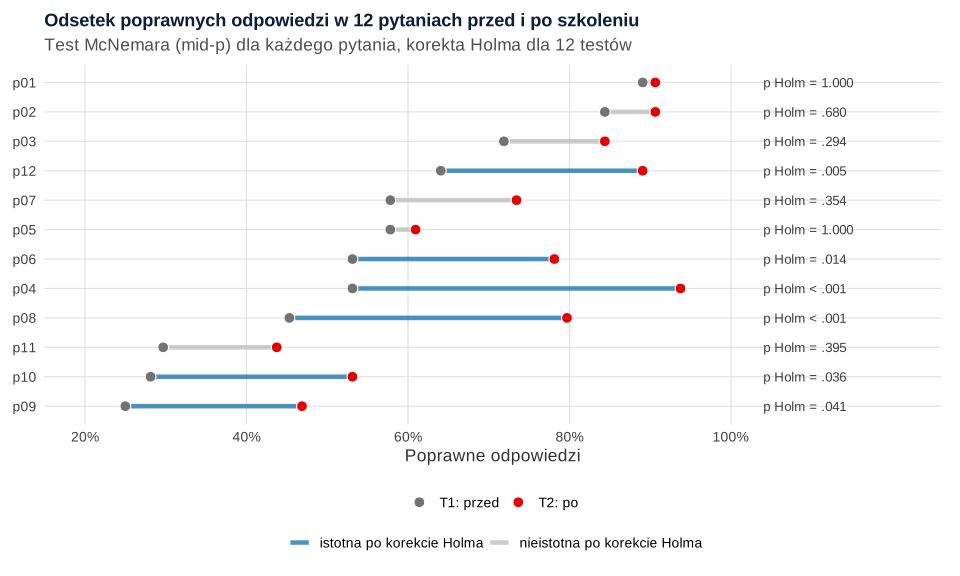
Wykres przydaje się także w dyskusji. Pytania 1 i 2 były łatwe już przed szkoleniem, więc nie było w nich miejsca na poprawę. Pytania 9–11 pozostały trudne także po szkoleniu: mniej niż 55% poprawnych odpowiedzi w T2. To konkretna informacja dla zespołu, który planuje kolejną edycję edukacji. Pytanie 5 zmieniło się w obu kierunkach niemal po równo (13 i 15 osób). Taki wzór sugeruje zgadywanie albo niejednoznaczne sformułowanie pytania, więc warto do niego wrócić podczas analizy pozycji.
Krok 3. Znormalizowany przyrost: ile z możliwego przyrostu osiągnięto?
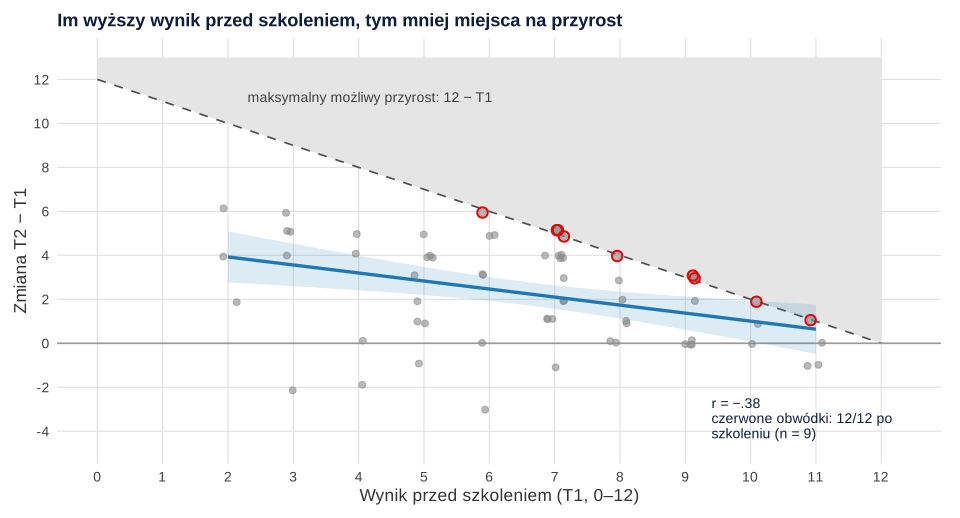
Osoba, która przed szkoleniem miała 11 punktów na 12, może zyskać najwyżej 1 punkt. Osoba z 3 punktami może zyskać 9. Surowa różnica karze więc tych, którzy już na starcie wiedzieli dużo. Rysunek 3 pokazuje to wprost: przerywana linia wyznacza maksymalny możliwy przyrost (12 − T1), a dziewięć osób z wynikiem 12/12 po szkoleniu leży dokładnie na tej granicy. To przykład efektu sufitu.
Odpowiedzią na ten problem jest znormalizowany przyrost. Hake (1998) przeanalizował wyniki przed i po w 62 kursach fizyki i jako miarę skuteczności kursu przyjął średni znormalizowany przyrost ⟨g⟩: rzeczywisty przyrost średniego odsetka poprawnych odpowiedzi podzielony przez maksymalny możliwy przyrost:
W przykładzie ⟨g⟩ = (73.7 − 54.9) / (100 − 54.9) = 0.42. Grupa osiągnęła więc około 42% przyrostu, który był jeszcze możliwy. Hake liczył tę miarę ze średnich całej grupy, ale można ją też policzyć dla każdej osoby: g = (T2 − T1) / (12 − T1). Średnia z indywidualnych wartości g wynosi tu 0.39, a mediana 0.50. Te liczby nie muszą być równe ⟨g⟩ i nie są. Wersję indywidualną zaburzają dwie rzeczy. Po pierwsze, nie da się jej policzyć dla osoby, która przed szkoleniem miała komplet punktów (dzielenie przez zero). Po drugie, gdy wynik spada, wartość potrafi być skrajnie ujemna. W przykładzie osoba, która miała 11 punktów, a po szkoleniu 10, ma g = −1.00. Pojedyncza taka obserwacja mocno obniża średnią.
Marx i Cummings (2007) zaproponowali dlatego znormalizowaną zmianę c. Przy wzroście dzieli się przyrost przez maksymalny możliwy przyrost, a przy spadku – spadek przez maksymalny możliwy spadek. Autorzy zalecają raportowanie średniej z indywidualnych wartości c. W przykładzie średnie c wynosi 0.41. Praktyczne wskazówki:
- podaj, którą wersję liczysz (⟨g⟩ ze średnich, średnią z g czy średnie c), i opisz, co zrobiłeś z osobami z kompletem punktów przed szkoleniem;
- traktuj znormalizowany przyrost jako opis, a nie zamiennik testu z kroku 1;
- nie porównuj ⟨g⟩ z wartościami z innych badań, jeśli testy miały inną trudność i długość.
Na rysunku 3 surowa zmiana koreluje z wynikiem wyjściowym (r = −.38), a indywidualne g – znacznie słabiej (r = −.11). Normalizacja usuwa więc większość tej zależności, ale nie usuwa regresji do średniej, o której piszemy niżej.
Krok 4. Poziomy wiedzy przed i po: test Bowkera i McNemara
W wielu pracach wynik zamienia się na poziomy wiedzy. W przykładzie przyjęliśmy ten sam umowny podział co w poradniku o ankiecie wiedzy: poniżej 60% poprawnych odpowiedzi – poziom niski (0–7 pkt), 60–79% – średni (8–9 pkt), co najmniej 80% – wysoki (10–12 pkt). Takie progi nie wynikają z właściwości testu, dlatego ustal je przed analizą i podaj ich uzasadnienie. Sposoby wyznaczania poziomów i ich wady opisujemy w poradniku niski, przeciętny, wysoki wynik.
| Przed szkoleniem (T1) | Po: niski | Po: średni | Po: wysoki | Razem T1 |
|---|---|---|---|---|
| niski | 13 | 17 | 13 | 43 (67.2%) |
| średni | 0 | 8 | 6 | 14 (21.9%) |
| wysoki | 0 | 0 | 7 | 7 (10.9%) |
| Razem T2 | 13 (20.3%) | 25 (39.1%) | 26 (40.6%) | 64 |
To tabela krzyżowa, ale nie zwykła. W wierszach i kolumnach są te same kategorie zmierzone u tych samych osób. Na przekątnej leżą osoby bez zmiany poziomu (13 + 8 + 7 = 28), nad nią – osoby, które awansowały (36), a pod nią – te, które spadły (tu nikt). Test chi-kwadrat niezależności nie ma tu sensu. Sprawdzałby, czy poziom po szkoleniu jest związany z poziomem przed nim, a to oczywiste.
Właściwe narzędzie to test symetrii Bowkera. Bowker (1948) opisał go dla kwadratowej tabeli m × m, w której kategorie obu klasyfikacji sobie odpowiadają. Test sprawdza symetrię tabeli, czyli to, czy przejścia w obu kierunkach są równie prawdopodobne, np. „niski → średni” i „średni → niski”. Dla tabeli 2 × 2 sprowadza się do testu McNemara. W przykładzie χ²(3) = 36.00, p < .001. W R wystarczy podać tabelę 3 × 3 funkcji mcnemar.test(), która dla tabel większych niż 2 × 2 liczy właśnie test Bowkera. Uważaj na pary komórek, w których obie liczebności są zerowe: wtedy test się nie policzy i trzeba połączyć kategorie. Uzupełniająco możesz podać test Stuarta–Maxwella, który porównuje same rozkłady brzegowe (odsetki poziomów w T1 i T2): χ²(2) = 32.69, p < .001.
Gdy hipoteza dotyczy jednej granicy, np. „po szkoleniu więcej osób osiągnie wysoki poziom wiedzy”, wystarczy tabela 2 × 2 i test McNemara. W przykładzie 19 osób przeszło do poziomu wysokiego, a nikt z niego nie spadł: χ²(1) = 19.00, p < .001. Odsetek osób z wysokim poziomem wzrósł z 10.9% do 40.6%.
Analiza poziomów nie zastępuje analizy wyniku ciągłego. Osoba, która przeszła z 3 do 7 punktów, w tabeli „nie zmieniła się”, a osoba z wynikiem 9 → 10 „awansowała”. MacCallum i in. (2002) pokazali, że dzielenie zmiennej ilościowej na kategorie rzadko jest uzasadnione i często prowadzi do mylących wniosków (zob. też dzielenie medianą). Poziomy pokaż więc jako opis, a wnioski opieraj na kroku 1.
Krok 5. Pomiar odroczony: czy wiedza się utrzymała?
Wynik tuż po szkoleniu pokazuje przede wszystkim, co uczestnicy zapamiętali na chwilę. Dla praktyki ważniejsze jest, ile zostało po kilku tygodniach. Dlatego warto zaplanować pomiar odroczony i z góry ustalić jego termin, np. przy najbliższej wizycie kontrolnej.
Najpierw braki: kto nie przyszedł?
Na pomiar po trzech miesiącach przyszło 50 z 64 osób. Zanim cokolwiek policzysz, porównaj osoby obecne i nieobecne. W przykładzie średni wynik przed szkoleniem wynosił 6.56 u osób obecnych i 6.71 u nieobecnych, a bezpośrednio po szkoleniu – 8.84 i 8.86. Nie ma więc śladu, że odpadły osoby o mniejszej wiedzy. Taki wynik nie dowodzi jednak, że braki są losowe, bo osoby mogły odpaść z powodów, których nie zmierzyłeś. W pracy podaj liczbę osób w każdym pomiarze i powody nieobecności, jeśli je znasz. Hasło utrata uczestników wyjaśnia, dlaczego to ważne, a hasło braki danych MCAR, MAR i MNAR – jakie założenia stoją za każdą analizą.
Trzy pomiary u tych samych osób
Dla 50 osób z kompletem pomiarów średnie wynosiły 6.56 (T1), 8.84 (T2) i 7.90 (T3). Test Friedmana wykazał różnice między pomiarami: χ²(2) = 31.94, p < .001, W Kendalla = .32. Porównania parami testem Wilcoxona z korektą Holma pokazały trzy rzeczy. Po pierwsze, wynik wzrósł bezpośrednio po szkoleniu (średnia zmiana 2.28 punktu, p < .001, r = .86). Po drugie, w ciągu trzech miesięcy spadł (−0.94 punktu, p < .001, r = −.63). Po trzecie, mimo tego spadku pozostał wyższy niż przed szkoleniem (1.34 punktu, p < .001, r = .67). Wartości r to korelacje rangowo-dwuseryjne.
Test Friedmana pomija 14 osób, które mają tylko dwa pomiary. Alternatywą jest model mieszany z losowym wyrazem wolnym dla osoby. Wykorzystuje on wszystkie dostępne pomiary i daje poprawne wnioski, jeśli braki zależą od zmierzonych wcześniej wyników (założenie MAR). Wynik: F(2, 114.33) = 38.70, p < .001. Średnie brzegowe z modelu wynoszą 6.59, 95% CI [5.99, 7.20] w T1, 8.84 [8.24, 9.45] w T2 i 7.91 [7.27, 8.56] w T3. Zmiana od T1 do T3 to 1.32 punktu (t(115) = 4.70, p < .001), a spadek od T2 do T3 to 0.93 punktu (t(115) = 3.31, p = .001), obie wartości po korekcie Holma. Kiedy wybrać ANOVA z powtarzanymi pomiarami, a kiedy model mieszany, wyjaśniamy w poradniku ANOVA z powtarzanymi pomiarami czy model mieszany.
Ograniczenia: brak grupy kontrolnej, efekt testowania i regresja do średniej
Istotny wzrost po szkoleniu jest zgodny z hipotezą, że szkolenie działa. Jednak w schemacie jednej grupy co najmniej trzy inne mechanizmy dają ten sam wynik. Opisz je w rozdziale o ograniczeniach.
- Efekt pretestu i testowania. Ten sam test rozwiązany dwa razy daje wyższy wynik nawet bez szkolenia: uczestnicy pamiętają pytania, wiedzą, na co zwrócić uwagę podczas sesji, i szukają odpowiedzi między pomiarami. Willson i Putnam (1982) w metaanalizie 32 badań z losowym przydziałem wykazali, że sam pretest podwyższał średnio wyniki posttestu o 0.22 SD, a w miarach poznawczych o 0.43 SD. Roediger i Karpicke (2006) pokazali z kolei, że rozwiązywanie testu nie tylko mierzy wiedzę, ale także utrwala ją na dłużej (efekt testowania). Dla Twojego badania oznacza to, że pretest jest częścią interwencji. Szerzej piszemy o tym w haśle efekt uczenia się.
- Regresja do średniej. Barnett i in. (2005) wyjaśniają, że po nietypowo niskich lub wysokich pomiarach następują zwykle wyniki bliższe średniej. Efekt jest tym większy, im większy błąd pomiaru, i szczególnie silny, gdy do analizy wybiera się osoby na podstawie wyniku wyjściowego. Jeśli na szkolenie kierowano osoby, które „wypadły słabo” we wstępnym teście, część ich poprawy jest artefaktem. Ta sama mechanika odpowiada częściowo za ujemną korelację na rysunku 3.
- Inne źródła wiedzy. Między T2 a T3 pacjenci rozmawiali z lekarzem, czytali ulotki i sami wstrzykiwali insulinę. Bez grupy porównawczej nie oddzielisz wpływu szkolenia od tych doświadczeń.
Co możesz zrobić? Najlepszym rozwiązaniem jest grupa kontrolna, np. pacjenci objęci standardową opieką albo szkoleni w późniejszym terminie. Takie badanie analizujesz już inaczej, najczęściej przez ANCOVA z pomiarem wyjściowym (zob. poradnik ANCOVA i analiza badania interwencyjnego przed i po). Jeśli grupa kontrolna jest niemożliwa, zastosuj dwa testy równoległe w losowej kolejności albo dodaj pytania niezwiązane ze szkoleniem, które pokażą, ile „rośnie samo”. Raport z badania bez randomizacji uporządkujesz według wytycznych TREND. Des Jarlais i in. (2004) kładą w nich nacisk na opis warunków interwencji i porównania, schematu badania oraz metod korygowania możliwych obciążeń.
Zgoda komisji bioetycznej i zasady prowadzenia badań z udziałem pacjentów zależą od regulaminu uczelni i miejsca badania. Sprawdź je przed rozpoczęciem rekrutacji.
Jak opisać badanie wiedzy przed i po w pracy
Rozdział wyników możesz ułożyć według kroków z tego poradnika. W części metodologicznej opisz:
- test wiedzy: liczbę pytań, sposób punktowania (także odpowiedzi „nie wiem” i braków), rzetelność w pierwszym pomiarze;
- terminy pomiarów, to, czy był to ten sam test, oraz czy uczestnicy znali poprawne odpowiedzi po pierwszym pomiarze;
- liczbę osób w każdym pomiarze i regułę postępowania z brakami;
- analizę główną (test t albo Wilcoxona z wielkością efektu), analizy uzupełniające (McNemar z korektą Holma, poziomy, znormalizowany przyrost) i uzasadnienie progów poziomów.
Jeśli nie wiesz, które z tych analiz są potrzebne w Twojej pracy albo jak odpowiedzieć na uwagi promotora, możesz omówić je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Badanie wiedzy przed i po w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R, bo przepisy 2 i 3 korzystają z obiektów z przepisu 1. Pierwszy przepis zapisuje też plik XLSX do pobrania. Wielkości efektu liczy pakiet effectsize, test Wilcoxona z rangowaniem zer metodą Pratta – pakiet coin, test Stuarta–Maxwella – pakiet DescTools, a model mieszany – pakiety lme4, lmerTest i emmeans.
1. Dane, wynik sumaryczny, test t, test Wilcoxona i znormalizowany przyrost
R
# Badanie wiedzy przed i po szkoleniu – jedna grupa, test wiedzy z 12 pytań punktowanych 0/1 (dane symulowane).
# 64 pacjentów z cukrzycą typu 2 przed rozpoczęciem insulinoterapii; autorski test wiedzy o insulinoterapii
# wypełniony przed sesją edukacyjną (T1), bezpośrednio po niej (T2) i po 3 miesiącach (T3).
suppressPackageStartupMessages({ library(effectsize); library(coin); library(openxlsx) })
set.seed(5501)
n <- 64; k <- 12
theta <- rnorm(n)                                          # wiedza wyjściowa (cecha ukryta)
latwosc <- c(2.3, 1.7, 1.1, 0.5, 0.2, 0.0, -0.3, -0.6, -0.9, -1.2, -1.5, 0.8)   # łatwość pytań przed szkoleniem
przyrost <- 1.15 * c(0.1, 0.4, 1.3, 1.5, 0.2, 1.7, 1.3, 1.8, 0.35, 1.6, 1.1, 0.9) # efekt szkolenia w pytaniach
u <- rnorm(n, 0, 0.6)                                       # indywidualne różnice w korzyści ze szkolenia
odpowiedzi <- function(ile) sapply(1:k, function(j) rbinom(n, 1, plogis(theta + latwosc[j] + ile * (przyrost[j] + u))))
T1 <- odpowiedzi(0); T2 <- odpowiedzi(1); T3 <- odpowiedzi(0.55)   # po 3 miesiącach część wiedzy zanika
odpadl <- rbinom(n, 1, plogis(-1.7 - 0.6 * theta)) == 1               # brak pomiaru T3 (częściej przy niższej wiedzy)
T3[odpadl, ] <- NA
colnames(T1) <- sprintf("T1_p%02d", 1:k); colnames(T2) <- sprintf("T2_p%02d", 1:k); colnames(T3) <- sprintf("T3_p%02d", 1:k)
dane <- data.frame(id = 1:n, T1, T2, T3)
dane$T1_suma <- rowSums(T1); dane$T2_suma <- rowSums(T2); dane$T3_suma <- rowSums(T3)

# Plik do pobrania: dane i opis zmiennych (autor w metadanych: Metodolog.pl)
wb <- createWorkbook(creator = "Metodolog.pl", title = "Badanie wiedzy przed i po szkoleniu – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
addWorksheet(wb, "dane"); writeData(wb, "dane", dane); freezePane(wb, "dane", firstRow = TRUE)
addWorksheet(wb, "opis_zmiennych")
writeData(wb, "opis_zmiennych", data.frame(
  zmienna = c("id", "T1_p01–T1_p12", "T2_p01–T2_p12", "T3_p01–T3_p12", "T1_suma, T2_suma, T3_suma"),
  opis = c("numer pacjenta", "odpowiedzi przed szkoleniem: 1 = zgodna z kluczem, 0 = błędna lub „nie wiem”",
           "odpowiedzi bezpośrednio po szkoleniu (kodowanie jak wyżej)",
           "odpowiedzi po 3 miesiącach; puste komórki = osoba nie przyszła na pomiar odroczony",
           "liczba poprawnych odpowiedzi (0–12)")))
writeData(wb, "opis_zmiennych", "Dane symulowane (R, set.seed(5501)) – metodolog.pl, wpis „Badanie wiedzy przed i po szkoleniu”.",
          startRow = 8)
saveWorkbook(wb, "../badanie-wiedzy-przed-i-po-dane.xlsx", overwrite = TRUE)

# 1. Statystyki opisowe wyniku sumarycznego (0–12) przed i po
opis <- function(x) round(c(n = sum(!is.na(x)), M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE),
                            Me = median(x, na.rm = TRUE), Q1 = unname(quantile(x, .25, na.rm = TRUE)),
                            Q3 = unname(quantile(x, .75, na.rm = TRUE)), proc = round(100 * mean(x, na.rm = TRUE) / k, 1)), 2)
rbind(T1 = opis(dane$T1_suma), T2 = opis(dane$T2_suma))

# 2. Różnice po − przed: kierunek zmian i rozkład
roznica <- dane$T2_suma - dane$T1_suma
round(c(M_roznicy = mean(roznica), SD_roznicy = sd(roznica), r_T1_T2 = cor(dane$T1_suma, dane$T2_suma)), 2)
table(kierunek = sign(roznica))                       # −1 spadek, 0 bez zmian, 1 wzrost
shapiro.test(roznica)

# 3. Test t dla prób zależnych i d_z z 95% CI
t.test(dane$T2_suma, dane$T1_suma, paired = TRUE)
d_z  <- repeated_measures_d(dane$T2_suma, dane$T1_suma, method = "z", adjust = FALSE)
d_av <- repeated_measures_d(dane$T2_suma, dane$T1_suma, method = "av", adjust = FALSE)
round(rbind(d_z = unlist(as.data.frame(d_z)[, c(1, 3, 4)]), d_av = unlist(as.data.frame(d_av)[, c(1, 3, 4)])), 2)

# 4. Test Wilcoxona dla par: zera (brak zmiany) usuwane (Wilcoxon) albo rangowane i pomijane (Pratt)
wilcox.test(dane$T2_suma, dane$T1_suma, paired = TRUE, exact = FALSE)
wilcoxsign_test(T2_suma ~ T1_suma, data = dane, zero.method = "Wilcoxon")
wilcoxsign_test(T2_suma ~ T1_suma, data = dane, zero.method = "Pratt")
rb <- rank_biserial(dane$T2_suma, dane$T1_suma, paired = TRUE)
round(unlist(as.data.frame(rb)[, c(1, 3, 4)]), 2)

# 5. Znormalizowany przyrost: indywidualny g, <g> Hake'a (ze średnich) i znormalizowana zmiana c
g_ind <- ifelse(dane$T1_suma < k, (dane$T2_suma - dane$T1_suma) / (k - dane$T1_suma), NA)
g_klasy <- (mean(dane$T2_suma) - mean(dane$T1_suma)) / (k - mean(dane$T1_suma))
c_zm <- with(dane, ifelse(T2_suma > T1_suma, (T2_suma - T1_suma) / (k - T1_suma),
                   ifelse(T2_suma < T1_suma, (T2_suma - T1_suma) / T1_suma, 0)))
round(c(osoby_z_max_T1 = sum(dane$T1_suma == k), g_klasy = g_klasy, M_g_ind = mean(g_ind, na.rm = TRUE),
        Me_g_ind = median(g_ind, na.rm = TRUE), M_c = mean(c_zm), min_g = min(g_ind, na.rm = TRUE)), 2)
round(c(osoby_z_max_T2 = sum(dane$T2_suma == k), r_zmiana_T1 = cor(roznica, dane$T1_suma),
        r_g_T1 = cor(g_ind, dane$T1_suma, use = "complete.obs")), 2)

# Kontrola pliku do pobrania: ponowny odczyt
spr <- readxl::read_excel("../badanie-wiedzy-przed-i-po-dane.xlsx", sheet = "dane")
c(wiersze = nrow(spr), kolumny = ncol(spr), sumy_zgodne = all(spr$T2_suma == dane$T2_suma), braki_T3 = sum(is.na(spr$T3_suma)))
Wynik w R
    n    M   SD Me Q1 Q3 proc
T1 64 6.59 2.36  7  5  8 54.9
T2 64 8.84 2.57  9  8 11 73.7
 M_roznicy SD_roznicy    r_T1_T2
      2.25       2.26       0.58
kierunek
-1  0  1
 7 10 47

	Shapiro-Wilk normality test

data:  roznica
W = 0.95112, p-value = 0.013


	Paired t-test

data:  dane$T2_suma and dane$T1_suma
t = 7.9619, df = 63, p-value = 4.16e-11
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 1.685275 2.814725
sample estimates:
mean difference
           2.25

      d_z CI_low CI_high
d_z  1.00   0.70    1.29
d_av 0.91   0.69    1.14

	Wilcoxon signed rank test with continuity correction

data:  dane$T2_suma and dane$T1_suma
V = 1394.5, p-value = 1.749e-08
alternative hypothesis: true location shift is not equal to 0


	Asymptotic Wilcoxon Signed-Rank Test

data:  y by x (pos, neg)
	 stratified by block
Z = 5.6395, p-value = 1.706e-08
alternative hypothesis: true mu is not equal to 0


	Asymptotic Wilcoxon-Pratt Signed-Rank Test

data:  y by x (pos, neg)
	 stratified by block
Z = 5.7258, p-value = 1.029e-08
alternative hypothesis: true mu is not equal to 0

r_rank_biserial          CI_low         CI_high
           0.88            0.80            0.93
osoby_z_max_T1        g_klasy        M_g_ind       Me_g_ind            M_c          min_g
          0.00           0.42           0.39           0.50           0.41          -1.00
osoby_z_max_T2    r_zmiana_T1         r_g_T1
          9.00          -0.38          -0.11
    wiersze     kolumny sumy_zgodne    braki_T3
         64          40           1          14
2. Pytania: test McNemara z korektą Holma; poziomy: test Bowkera
R
# Kontynuacja przepisu 1 (obiekty dane, k, T1, T2 w tej samej sesji R).
suppressPackageStartupMessages(library(DescTools))
# 6. Pojedyncze pytania: test McNemara (asymptotyczny bez poprawki i mid-p) z korektą Holma
mcnemar_pytanie <- function(przed, po) {
  b <- sum(przed == 1 & po == 0)                       # pary niezgodne: dobrze → źle
  c <- sum(przed == 0 & po == 1)                       # pary niezgodne: źle → dobrze
  m <- b + c; x <- min(b, c)
  c(proc_T1 = 100 * mean(przed), proc_T2 = 100 * mean(po), b = b, c = c,
    chi2 = (b - c)^2 / m, p_asympt = pchisq((b - c)^2 / m, 1, lower.tail = FALSE),   # asymptotyczny, bez poprawki
    p_mid = 2 * pbinom(x, m, .5) - dbinom(x, m, .5))   # mid-p: dokładny test dwumianowy minus P(X = x)
}
pytania <- as.data.frame(t(sapply(1:k, function(j) mcnemar_pytanie(T1[, j], T2[, j]))))
pytania$p_mid_Holm <- p.adjust(pytania$p_mid, method = "holm")
pytania$p_mid_bez_korekty_lt05 <- pytania$p_mid < .05
rownames(pytania) <- sprintf("p%02d", 1:k)
print(within(round(pytania, 4), { proc_T1 <- round(proc_T1, 1); proc_T2 <- round(proc_T2, 1); chi2 <- round(chi2, 2) }))
c(istotne_bez_korekty = sum(pytania$p_mid < .05), istotne_po_Holmie = sum(pytania$p_mid_Holm < .05))
# Kontrola: funkcja stats::mcnemar.test bez poprawki daje to samo chi-kwadrat (pytanie 4)
mcnemar.test(table(factor(T1[, 4], 0:1), factor(T2[, 4], 0:1)), correct = FALSE)

# 7. Poziomy wiedzy przed i po (umowne progi: < 60%, 60–79%, ≥ 80% poprawnych → 0–7, 8–9, 10–12 pkt)
poziom <- function(s) factor(cut(s, c(-Inf, 7, 9, Inf), labels = c("niski", "średni", "wysoki")),
                             levels = c("niski", "średni", "wysoki"))
tab <- table(T1 = poziom(dane$T1_suma), T2 = poziom(dane$T2_suma))
tab
c(bez_zmiany = sum(diag(tab)), awans = sum(tab[upper.tri(tab)]), spadek = sum(tab[lower.tri(tab)]))
round(100 * rbind(T1 = prop.table(table(poziom(dane$T1_suma))), T2 = prop.table(table(poziom(dane$T2_suma)))), 1)
mcnemar.test(tab)                                       # dla tabeli 3 × 3 R liczy test symetrii Bowkera
StuartMaxwellTest(tab)                                  # jednorodność rozkładów brzegowych
wysoki <- table(T1 = dane$T1_suma >= 10, T2 = dane$T2_suma >= 10)
wysoki
mcnemar.test(wysoki, correct = FALSE)                   # „wysoki poziom” tak/nie
Wynik w R
    proc_T1 proc_T2  b  c  chi2 p_asympt  p_mid p_mid_Holm p_mid_bez_korekty_lt05
p01    89.1    90.6  6  7  0.08   0.7815 0.7905     1.0000                      0
p02    84.4    90.6  3  7  1.60   0.2059 0.2266     0.6797                      0
p03    71.9    84.4  4 12  4.00   0.0455 0.0490     0.2943                      1
p04    53.1    93.8  1 27 24.14   0.0000 0.0000     0.0000                      1
p05    57.8    60.9 13 15  0.14   0.7055 0.7111     1.0000                      0
p06    53.1    78.1  5 21  9.85   0.0017 0.0015     0.0136                      1
p07    57.8    73.4 10 20  3.33   0.0679 0.0708     0.3538                      0
p08    45.3    79.7  1 23 20.17   0.0000 0.0000     0.0000                      1
p09    25.0    46.9  6 20  7.54   0.0060 0.0059     0.0415                      1
p10    28.1    53.1  8 24  8.00   0.0047 0.0046     0.0364                      1
p11    29.7    43.8 10 19  2.79   0.0947 0.0987     0.3949                      0
p12    64.1    89.1  3 19 11.64   0.0006 0.0005     0.0049                      1
istotne_bez_korekty   istotne_po_Holmie
                  7                   6

	McNemar's Chi-squared test

data:  table(factor(T1[, 4], 0:1), factor(T2[, 4], 0:1))
McNemar's chi-squared = 24.143, df = 1, p-value = 8.945e-07

        T2
T1       niski średni wysoki
  niski     13     17     13
  średni     0      8      6
  wysoki     0      0      7
bez_zmiany      awans     spadek
        28         36          0
   niski średni wysoki
T1  67.2   21.9   10.9
T2  20.3   39.1   40.6

	McNemar's Chi-squared test

data:  tab
McNemar's chi-squared = 36, df = 3, p-value = 7.488e-08


	Stuart-Maxwell test

data:  tab
chi-squared = 32.693, df = 2, p-value = 7.957e-08

       T2
T1      FALSE TRUE
  FALSE    38   19
  TRUE      0    7

	McNemar's Chi-squared test

data:  wysoki
McNemar's chi-squared = 19, df = 1, p-value = 1.307e-05
3. Pomiar odroczony: braki, test Friedmana i model mieszany
R
# Kontynuacja przepisów 1–2. Pomiar odroczony T3 (po 3 miesiącach), część osób nie przyszła.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(emmeans) })
kompletni <- !is.na(dane$T3_suma)
c(T3_obecni = sum(kompletni), T3_brak = sum(!kompletni), proc_obecnych = round(100 * mean(kompletni), 1))
round(rbind(obecni_T1 = mean(dane$T1_suma[kompletni]), brak_T1 = mean(dane$T1_suma[!kompletni]),
            obecni_T2 = mean(dane$T2_suma[kompletni]), brak_T2 = mean(dane$T2_suma[!kompletni])), 2)
pelne <- dane[kompletni, c("T1_suma", "T2_suma", "T3_suma")]
round(sapply(pelne, function(x) c(M = mean(x), SD = sd(x), Me = median(x))), 2)

# 8. Test Friedmana z W Kendalla i porównania parami (Wilcoxon, korekta Holma) – tylko osoby z trzema pomiarami
friedman.test(as.matrix(pelne))
W <- kendalls_w(as.matrix(pelne))
round(unlist(as.data.frame(W)[, c(1, 3, 4)]), 2)
pary <- list(T2_T1 = c("T2_suma", "T1_suma"), T3_T2 = c("T3_suma", "T2_suma"), T3_T1 = c("T3_suma", "T1_suma"))
p_pary <- sapply(pary, function(v) suppressWarnings(wilcox.test(pelne[[v[1]]], pelne[[v[2]]], paired = TRUE, exact = FALSE)$p.value))
rb_pary <- sapply(pary, function(v) rank_biserial(pelne[[v[1]]], pelne[[v[2]]], paired = TRUE)$r_rank_biserial)
round(rbind(M_roznicy = sapply(pary, function(v) mean(pelne[[v[1]]] - pelne[[v[2]]])),
            p = p_pary, p_Holm = p.adjust(p_pary, "holm"), r_rb = rb_pary), 4)

# 9. Model mieszany na wszystkich dostępnych pomiarach (osoby bez T3 zostają w analizie)
dl <- reshape(dane[, c("id", "T1_suma", "T2_suma", "T3_suma")], direction = "long", idvar = "id",
              varying = c("T1_suma", "T2_suma", "T3_suma"), v.names = "wynik", timevar = "pomiar", times = c("T1", "T2", "T3"))
dl$pomiar <- factor(dl$pomiar)
mm <- lmer(wynik ~ pomiar + (1 | id), data = dl)
anova(mm)
emm <- emmeans(mm, ~ pomiar)
print(emm, digits = 3)
print(pairs(emm, adjust = "holm"), digits = 3)
Wynik w R
    T3_obecni       T3_brak proc_obecnych
         50.0          14.0          78.1
          [,1]
obecni_T1 6.56
brak_T1   6.71
obecni_T2 8.84
brak_T2   8.86
   T1_suma T2_suma T3_suma
M     6.56    8.84    7.90
SD    2.35    2.76    2.46
Me    7.00    9.00    9.00

	Friedman rank sum test

data:  as.matrix(pelne)
Friedman chi-squared = 31.942, df = 2, p-value = 1.159e-07

Kendalls_W     CI_low    CI_high
      0.32       0.19       1.00
           T2_T1   T3_T2  T3_T1
M_roznicy 2.2800 -0.9400 1.3400
p         0.0000  0.0006 0.0001
p_Holm    0.0000  0.0006 0.0003
r_rb      0.8626 -0.6275 0.6722
Type III Analysis of Variance Table with Satterthwaite's method
       Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
pomiar  163.3   81.65     2 114.33  38.696 1.465e-13 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 pomiar emmean    SE    df lower.CL upper.CL
 T1       6.59 0.306  99.7     5.99     7.20
 T2       8.84 0.306  99.7     8.24     9.45
 T3       7.91 0.326 118.3     7.27     8.56

Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
 contrast estimate    SE  df t.ratio p.value
 T1 - T2    -2.250 0.257 112  -8.762 <0.0001
 T1 - T3    -1.321 0.281 115  -4.703 <0.0001
 T2 - T3     0.929 0.281 115   3.308  0.0013

Degrees-of-freedom method: kenward-roger
P value adjustment: holm method for 3 tests
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), mcnemar.test(), friedman.test() i p.adjust() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizie badania wiedzy przed i po
- Porównanie pomiarów jak dwóch niezależnych grup (test t dla prób niezależnych, test Manna–Whitneya, chi-kwadrat niezależności). Pomija korelację między pomiarami i odpowiada na złe pytanie.
- Zwykły test chi-kwadrat dla pojedynczego pytania zamiast testu McNemara. Sprawdza on związek między odpowiedzią przed i po, a nie zmianę odsetka poprawnych odpowiedzi (Pembury Smith i Ruxton, 2020).
- Dwanaście testów McNemara bez korekty, a potem wniosek oparty na pytaniu z p = .049.
- Brak informacji o wariancie testu: z poprawką na ciągłość czy bez, mid-p czy dokładny; zera w teście Wilcoxona usuwane czy rangowane.
- Analiza poziomów zamiast wyniku ciągłego. Poziomy to opis, a nie główny test hipotezy.
- Średnia z indywidualnych g bez kontroli wartości skrajnych i bez informacji, co zrobiono z osobami z kompletem punktów na starcie.
- Analiza pomiaru odroczonego tylko u osób, które przyszły, bez porównania z osobami nieobecnymi i bez podania liczby osób w każdym pomiarze.
- Wniosek „szkolenie jest skuteczne” w badaniu bez grupy kontrolnej. Bezpieczniej napisać, że wyniki po szkoleniu były wyższe, i wymienić alternatywne wyjaśnienia.
- Raport samego p bez średniej zmiany z 95% CI i wielkości efektu.
Najczęstsze pytania
Jakim testem porównać wyniki testu wiedzy przed i po szkoleniu?
Ponieważ te same osoby rozwiązują test dwa razy, porównujesz różnice wewnątrz osób: testem t dla prób zależnych (z dz i 95% CI) albo – przy małej próbie, krótkim teście i silnie skośnych różnicach – testem Wilcoxona dla par z korelacją rangowo-dwuseryjną. Nie stosuj testu dla prób niezależnych ani testu chi-kwadrat niezależności, bo pomijają powiązanie pomiarów.
Jak sprawdzić, które pytania testu wiedzy poprawiły się po szkoleniu?
Dla każdego pytania zrób test McNemara na tabeli 2 × 2 odpowiedzi przed i po. Test bierze pod uwagę tylko osoby, które zmieniły odpowiedź: z błędnej na poprawną i odwrotnie. Przy kilkunastu pytaniach skoryguj wartości p, np. metodą Holma, i podaj, którego wariantu testu użyłeś (mid-p albo asymptotyczny bez poprawki na ciągłość).
Jak policzyć znormalizowany przyrost dla grupy po szkoleniu?
Od średniego odsetka poprawnych odpowiedzi po szkoleniu odejmij odsetek przed szkoleniem i podziel przez 100 minus odsetek przed szkoleniem. Wynik 0.42 oznacza, że grupa osiągnęła 42% przyrostu, który był jeszcze możliwy. Wersja liczona dla każdej osoby nie działa dla osób z kompletem punktów na starcie i bywa skrajnie ujemna przy spadku wyniku, dlatego zawsze napisz, którą wersję podajesz.
Czy badanie przed i po bez grupy kontrolnej dowodzi skuteczności szkolenia?
Nie w pełni. Wyższy wynik po szkoleniu może wynikać także z ponownego rozwiązywania tego samego testu, regresji do średniej i informacji zdobytych poza szkoleniem. Napisz, że wyniki po szkoleniu były wyższe, wymień te wyjaśnienia w ograniczeniach, a jeśli to możliwe – dodaj grupę porównawczą albo pomiar odroczony.
Jak porównać poziomy wiedzy (niski, średni, wysoki) przed i po szkoleniu?
Ułóż tabelę 3 × 3 z poziomem przed szkoleniem w wierszach i po szkoleniu w kolumnach, a następnie wykonaj test symetrii Bowkera (w R: mcnemar.test() na tej tabeli). Dla jednej granicy, np. „wysoki poziom tak/nie”, wystarczy test McNemara. Poziomy traktuj jako opis uzupełniający, bo główny wniosek opiera się na wyniku punktowym.
Co zrobić z osobami, które nie przyszły na pomiar odroczony?
Podaj liczbę osób w każdym pomiarze i porównaj wyniki osób obecnych i nieobecnych z wcześniejszych pomiarów. Zamiast analizy tylko kompletnych przypadków możesz użyć modelu mieszanego, który wykorzystuje wszystkie dostępne pomiary i daje poprawne wnioski, gdy braki zależą od zmierzonych wcześniej wyników.
Powiązane hasła
Przeczytaj też
Ankieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →Masz wyniki testu wiedzy przed i po szkoleniu?
Pomożemy dobrać testy do schematu badania, policzyć wielkość efektu i porównania pytań oraz wyjaśnić wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bowker, A. H. (1948). A test for symmetry in contingency tables. Journal of the American Statistical Association, 43(244), 572–574. https://doi.org/10.1080/01621459.1948.10483284
- Des Jarlais, D. C., Lyles, C., Crepaz, N., & TREND Group. (2004). Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement. American Journal of Public Health, 94(3), 361–366. https://doi.org/10.2105/ajph.94.3.361 ● Otwarty dostęp: pełny tekst
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Hake, R. R. (1998). Interactive-engagement versus traditional methods: A six-thousand-student survey of mechanics test data for introductory physics courses. American Journal of Physics, 66(1), 64–74. https://doi.org/10.1119/1.18809
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Marx, J. D., & Cummings, K. (2007). Normalized change. American Journal of Physics, 75(1), 87–91. https://doi.org/10.1119/1.2372468
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. https://doi.org/10.1007/BF02295996
- Pembury Smith, M. Q. R., & Ruxton, G. D. (2020). Effective use of the McNemar test. Behavioral Ecology and Sociobiology, 74(11), Article 133. https://doi.org/10.1007/s00265-020-02916-y ● Otwarty dostęp
- Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association, 54(287), 655–667. https://doi.org/10.1080/01621459.1959.10501526
- Roediger, H. L., & Karpicke, J. D. (2006). Test-enhanced learning: Taking memory tests improves long-term retention. Psychological Science, 17(3), 249–255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
- Willson, V. L., & Putnam, R. R. (1982). A meta-analysis of pretest sensitization effects in experimental design. American Educational Research Journal, 19(2), 249–258. https://doi.org/10.3102/00028312019002249
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bowker1948test, author={Bowker, Albert H.}, title={{A test for symmetry in contingency tables}}, journal={Journal of the American Statistical Association}, year={1948}, volume={43}, number={244}, pages={572--574}, doi={10.1080/01621459.1948.10483284}}@article{desjarlais2004improving, author={Des Jarlais, Don C. and Lyles, Cynthia and Crepaz, Nicole and {TREND Group}}, title={{Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement}}, journal={American Journal of Public Health}, year={2004}, volume={94}, number={3}, pages={361--366}, doi={10.2105/ajph.94.3.361}}@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{hake1998interactive, author={Hake, Richard R.}, title={{Interactive-engagement versus traditional methods: A six-thousand-student survey of mechanics test data for introductory physics courses}}, journal={American Journal of Physics}, year={1998}, volume={66}, number={1}, pages={64--74}, doi={10.1119/1.18809}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{marx2007normalized, author={Marx, Jeffrey D. and Cummings, Karen}, title={{Normalized change}}, journal={American Journal of Physics}, year={2007}, volume={75}, number={1}, pages={87--91}, doi={10.1119/1.2372468}}@article{mcnemar1947note, author={McNemar, Quinn}, title={{Note on the sampling error of the difference between correlated proportions or percentages}}, journal={Psychometrika}, year={1947}, volume={12}, number={2}, pages={153--157}, doi={10.1007/bf02295996}}@article{pemburysmith2020effective, author={Pembury Smith, Matilda Q. R. and Ruxton, Graeme D.}, title={{Effective use of the McNemar test}}, journal={Behavioral Ecology and Sociobiology}, year={2020}, volume={74}, number={11}, eid={133}, doi={10.1007/s00265-020-02916-y}}@article{pratt1959remarks, author={Pratt, John W.}, title={{Remarks on zeros and ties in the Wilcoxon signed rank procedures}}, journal={Journal of the American Statistical Association}, year={1959}, volume={54}, number={287}, pages={655--667}, doi={10.1080/01621459.1959.10501526}}@article{roediger2006test, author={Roediger, Henry L. and Karpicke, Jeffrey D.}, title={{Test-enhanced learning: Taking memory tests improves long-term retention}}, journal={Psychological Science}, year={2006}, volume={17}, number={3}, pages={249--255}, doi={10.1111/j.1467-9280.2006.01693.x}}@article{willson1982meta, author={Willson, Victor L. and Putnam, Richard R.}, title={{A meta-analysis of pretest sensitization effects in experimental design}}, journal={American Educational Research Journal}, year={1982}, volume={19}, number={2}, pages={249--258}, doi={10.3102/00028312019002249}}