Co to jest KR-20?
KR-20 (wzór 20 Kudera–Richardsona, ang. Kuder–Richardson Formula 20) to współczynnik spójności wewnętrznej testu, którego pozycje punktuje się 0/1: dobrze – źle albo tak – nie. Kuder i Richardson (1937) wyprowadzili kilka wzorów na rzetelność testu, zależnie od dostępnych informacji i dodatkowych założeń; nazwy KR-20 i KR-21 to po prostu numery wzorów w ich artykule. Stosuje się go w testach wiedzy, egzaminach i listach objawów z odpowiedziami tak/nie. Im wyższa wartość (zwykle od 0 do 1), tym mniejszy udział błędu losowego w wynikach testu.
Wzór KR-20
k to liczba pozycji, pi – odsetek poprawnych odpowiedzi na pozycję i, qi = 1 − pi, a s2X – wariancja wyniku ogólnego. Σpq to suma wariancji pojedynczych pytań. Wariancja wyniku ogólnego zawiera dodatkowo kowariancje między pytaniami, więc im silniej pytania są ze sobą powiązane, tym bardziej przewyższa tę sumę i tym wyższy KR-20. Iloczyn pq to wariancja pozycji 0/1, dlatego Cronbach (1951) mógł pokazać, że KR-20 jest szczególnym przypadkiem alfy: dla tych samych danych obie liczby są identyczne. KR-21 upraszcza wzór, zakładając jednakową trudność wszystkich pytań – wystarczą mu liczba pozycji, średnia i wariancja wyniku.
Przykład
Stu pięćdziesięciu studentów rozwiązało 12-pytaniowy test z metodologii badań (dane symulowane). Suma pq wyniosła 2.25, a wariancja wyniku 8.55, więc KR-20 = 12/11 × (1 − 2.25/8.55) = .80, 95% CI [.75, .85] – dokładnie tyle co alfa Cronbacha. Pytania różniły się trudnością (od 15% do 89% poprawnych odpowiedzi), dlatego KR-21 dał tylko .71.
Na rysunku
Rysunki pokazują symulacje, a nie dane z przykładu: dla każdego punktu losowano odpowiedzi 5000 osób na pytania o tej samej sile związku z wiedzą co w przykładzie (set.seed(731) i set.seed(732)). Duże N ma sprawić, by krzywe pokazywały wartości oczekiwane, a nie błąd losowy jednej próby.
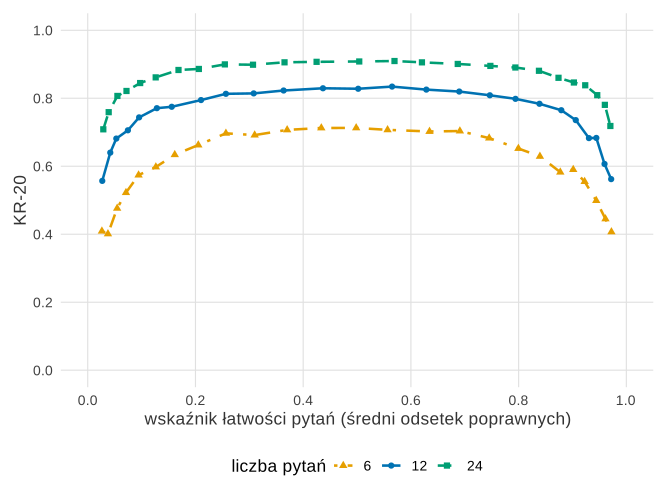
Co widać. We wszystkich wariantach pytania tak samo silnie zależą od wiedzy, a zmienia się tylko ich łatwość. Mimo to KR-20 dla 12 pytań spada z .83 przy łatwości .50 do .56, gdy na każde pytanie dobrze odpowiada 97% osób. Pytanie, na które prawie wszyscy odpowiadają tak samo, ma małą wariancję pq i słabo koreluje z innymi. Dłuższy test podnosi całą krzywą (.71, .83 i .91 przy łatwości .50), ale jej nie spłaszcza.
Na co uważać. Niski KR-20 w teście z samymi łatwymi pytaniami nie musi oznaczać złych pytań – może wynikać z celu testu (sprawdzanie opanowania podstaw). Wpływ samej liczby pozycji na rzetelność przy stałej korelacji między nimi pokazuje wpis Rzetelność i błąd pomiaru – wizualizacja.
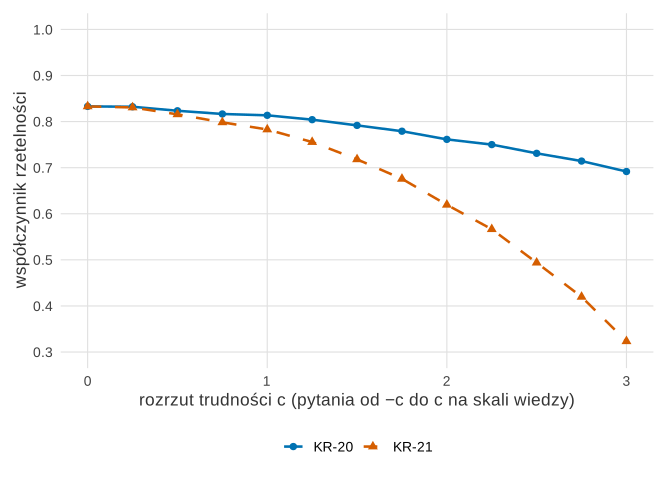
Co widać. Gdy wszystkie pytania są tak samo trudne, oba wzory dają .833 – założenie KR-21 jest wtedy spełnione. Im bardziej pytania różnią się trudnością, tym bardziej KR-21 zaniża wynik: przy pytaniach od −2 do 2 na skali wiedzy KR-20 = .76, a KR-21 = .62. W przykładzie z hasła trudności pytań rozciągały się od −1.8 do 1.4 – stąd różnica .80 wobec .71.
Na co uważać. KR-20 też spada (do .69), bo skrajne pytania słabiej różnicują – to rzeczywista cecha testu, a nie błąd wzoru. Spadek KR-21 jest natomiast artefaktem założenia, którego dane nie spełniają.
Kod poniżej wymaga tylko pakietu ggplot2. Rysunki na stronie różnią się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunków 1 i 2
library(ggplot2)
kol <- c("6" = "#E69F00", "12" = "#0072B2", "24" = "#009E73")       # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
kr <- function(odp) {                                               # KR-20 i KR-21 (wariancja z mianownikiem N)
  k <- ncol(odp); p <- colMeans(odp); X <- rowSums(odp); s2 <- mean((X - mean(X))^2)
  c(p_sr = mean(p), KR20 = k / (k - 1) * (1 - sum(p * (1 - p)) / s2),
    KR21 = k / (k - 1) * (1 - mean(X) * (k - mean(X)) / (k * s2)))
}
test <- function(b, N = 5000) {                                     # b – trudności pytań, a = 1.5 jak w przykładzie
  wiedza <- rnorm(N)
  kr(sapply(b, function(bj) rbinom(N, 1, plogis(1.5 * (wiedza - bj)))))
}
# Rysunek 1: wszystkie pytania tak samo trudne – KR-20 a łatwość i liczba pytań
set.seed(731)
siatka1 <- expand.grid(b = seq(-3, 3, by = 0.25), k = c(6, 12, 24))
w1 <- cbind(siatka1, t(mapply(function(b, k) test(rep(b, k)), siatka1$b, siatka1$k)))
round(w1[w1$b %in% c(-3, -2, 0, 2, 3), c("k", "b", "p_sr", "KR20")], 3)
p1 <- ggplot(w1, aes(p_sr, KR20, colour = factor(k), linetype = factor(k), shape = factor(k))) +
  geom_line(linewidth = 0.9) + geom_point(size = 1.8) +
  scale_colour_manual(values = kol, name = "liczba pytań") +
  scale_linetype_manual(values = c("6" = "dotdash", "12" = "solid", "24" = "dashed"), name = "liczba pytań") +
  scale_shape_manual(values = c("6" = 17, "12" = 16, "24" = 15), name = "liczba pytań") +
  scale_x_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(x = "wskaźnik łatwości pytań (średni odsetek poprawnych)", y = "KR-20") + motyw
# Rysunek 2: 12 pytań o różnej trudności – KR-20 a KR-21 przy rosnącym rozrzucie trudności
set.seed(732)
rozrzut <- seq(0, 3, by = 0.25)                                     # trudności od −c do c
w2 <- data.frame(c = rozrzut, t(sapply(rozrzut, function(c) test(seq(-c, c, length.out = 12)))))
round(w2[, c("c", "p_sr", "KR20", "KR21")], 3)
w2l <- rbind(data.frame(c = w2$c, wsp = "KR-20", wart = w2$KR20), data.frame(c = w2$c, wsp = "KR-21", wart = w2$KR21))
p2 <- ggplot(w2l, aes(c, wart, colour = wsp, linetype = wsp, shape = wsp)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.2) +
  scale_colour_manual(values = c("KR-20" = "#0072B2", "KR-21" = "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("KR-20" = "solid", "KR-21" = "dashed"), name = NULL) +
  scale_shape_manual(values = c("KR-20" = 16, "KR-21" = 17), name = NULL) +
  scale_y_continuous(limits = c(0.3, 1), breaks = seq(0.3, 1, 0.1)) +
  labs(x = "rozrzut trudności c (pytania od −c do c na skali wiedzy)", y = "współczynnik rzetelności") + motyw
# print(p1); print(p2)   # albo: ggsave("rysunek-1.svg", p1, width = 7, height = 5.2)
Wynik w R
    k  b  p_sr  KR20
1   6 -3 0.972 0.407
5   6 -2 0.901 0.590
13  6  0 0.498 0.713
21  6  2 0.094 0.574
25  6  3 0.026 0.409
26 12 -3 0.972 0.562
30 12 -2 0.906 0.736
38 12  0 0.502 0.828
46 12  2 0.095 0.744
50 12  3 0.027 0.557
51 24 -3 0.970 0.718
55 24 -2 0.903 0.846
63 24  0 0.504 0.908
71 24  2 0.097 0.845
75 24  3 0.029 0.709
      c  p_sr  KR20  KR21
1  0.00 0.502 0.833 0.833
2  0.25 0.506 0.832 0.831
3  0.50 0.499 0.823 0.816
4  0.75 0.507 0.817 0.798
5  1.00 0.497 0.814 0.783
6  1.25 0.499 0.804 0.756
7  1.50 0.499 0.792 0.718
8  1.75 0.496 0.779 0.676
9  2.00 0.505 0.761 0.619
10 2.25 0.503 0.750 0.566
11 2.50 0.502 0.731 0.494
12 2.75 0.506 0.714 0.420
13 3.00 0.501 0.692 0.323
Jak zapisać w pracy
Na co uważać
- KR-20 rośnie z liczbą pytań. Krótki test z dobrymi pytaniami może mieć niski współczynnik, a długi – wysoki mimo przeciętnych pytań. Tę zależność opisuje wzór Spearmana–Browna.
- Wysoki KR-20 nie dowodzi jednowymiarowości. Alfa nie mówi nic o wewnętrznej strukturze testu (Sijtsma, 2009). Strukturę sprawdź analizą czynnikową na korelacjach tetrachorycznych. KR-20, tak jak alfa, zakłada też jednakowe ładunki pozycji – omega McDonalda tego nie wymaga.
- KR-21 tylko awaryjnie – gdy nie masz odpowiedzi na poszczególne pytania. Przy różnej trudności pytań zaniża rzetelność.
- Pytania za 0, 1 i 2 punkty albo odpowiedzi na skali Likerta to już nie KR-20 – licz alfę lub omegę.
- Niski wynik? Słabe pytania wskaże analiza pozycji testu. Pełny przykład z testem wiedzy pacjentów znajdziesz w poradniku ankieta wiedzy – analiza krok po kroku.
Przykład w R
Kod tworzy odpowiedzi z przykładu, liczy KR-20 i KR-21 ze wzorów i porównuje wynik z alfą Cronbacha z pakietu psych, razem z 95% przedziałem ufności metodą Feldta. Wariancję wyniku liczymy z mianownikiem N, tak jak iloczyny pq – wtedy KR-20 i alfa są identyczne.
KR-20, KR-21 i alfa dla testu 0/1
R
set.seed(73)
wiedza <- rnorm(150)                                       # poziom wiedzy 150 studentów
odp <- sapply(seq(-1.8, 1.4, length.out = 12), function(b) rbinom(150, 1, plogis(1.5 * (wiedza - b))))   # 12 pytań: 1 = poprawna
k <- ncol(odp); p <- colMeans(odp); X <- rowSums(odp)
s2 <- mean((X - mean(X))^2)                                # wariancja wyniku z mianownikiem N, jak p × q
round(c(k = k, suma_pq = sum(p * (1 - p)), s2 = s2, p_min = min(p), p_max = max(p),
        KR20 = k / (k - 1) * (1 - sum(p * (1 - p)) / s2),
        KR21 = k / (k - 1) * (1 - mean(X) * (k - mean(X)) / (k * s2))), 3)
a <- psych::alpha(odp)                                     # alfa Cronbacha dla tych samych danych
round(c(alfa = a$total$raw_alpha, CI_dolna = a$feldt$lower.ci$raw_alpha, CI_gorna = a$feldt$upper.ci$raw_alpha), 3)   # 95% CI (Feldt)
Wynik w R
      k suma_pq      s2   p_min   p_max    KR20    KR21
 12.000   2.251   8.552   0.153   0.893   0.804   0.712
    alfa CI_dolna CI_gorna
   0.804    0.754    0.847
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet psych); Rysunki 1 i 2 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym różni się KR-20 od KR-21?
KR-21 upraszcza KR-20, zakładając jednakową trudność wszystkich pytań – wystarczą mu średnia i wariancja wyniku. Gdy trudność pytań się różni, KR-21 daje wartość niższą niż KR-20, czyli zaniża rzetelność.
Jak policzyć KR-20 w SPSS?
Wybierz Analyze > Scale > Reliability Analysis, przenieś pytania zakodowane 0/1 i zostaw model Alpha. Dla pozycji dychotomicznych alfa jest równoważna KR-20, więc w pracy możesz podać wynik jako KR-20.
Czy KR-20 można liczyć dla pytań z punktami częściowymi?
Nie – KR-20 wymaga pozycji punktowanych 0/1. Gdy pytanie daje 0, 1 lub 2 punkty albo odpowiedź na skali Likerta, policz alfę Cronbacha lub omegę McDonalda; KR-20 jest szczególnym przypadkiem alfy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikPunktowanie testu wiedzy: „nie wiem” i zgadywanie
„Nie wiem” jako 0 czy brak, poprawka na zgadywanie, próg dla prawda/fałsz i punkty częściowe za kilka poprawnych odpowiedzi – na symulacji w R.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555 ● Otwarty dostęp
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- Sijtsma, K. (2009). On the use, the misuse, and the very limited usefulness of Cronbach's alpha. Psychometrika, 74(1), 107–120. https://doi.org/10.1007/s11336-008-9101-0 ● Otwarty dostęp
Cytowania BibTeX
@article{cronbach1951coefficient, author={Cronbach, Lee J.}, title={{Coefficient alpha and the internal structure of tests}}, journal={Psychometrika}, year={1951}, volume={16}, number={3}, pages={297--334}, doi={10.1007/bf02310555}}@article{kuder1937theory, author={Kuder, G. F. and Richardson, M. W.}, title={{The theory of the estimation of test reliability}}, journal={Psychometrika}, year={1937}, volume={2}, number={3}, pages={151--160}, doi={10.1007/bf02288391}}@article{sijtsma2009use, author={Sijtsma, Klaas}, title={{On the use, the misuse, and the very limited usefulness of Cronbach's alpha}}, journal={Psychometrika}, year={2009}, volume={74}, number={1}, pages={107--120}, doi={10.1007/s11336-008-9101-0}}