Te same odpowiedzi, różne wyniki
Test wiedzy w pracy z pielęgniarstwa czy zdrowia publicznego wygląda niewinnie: kilkanaście pytań, klucz, suma punktów. Zanim jednak policzysz pierwszą średnią, musisz podjąć kilka decyzji. Ile punktów dać za „nie wiem”? Czy karać za zgadywanie? Co zrobić z pytaniem, w którym poprawne są dwie odpowiedzi, a ktoś zaznaczył jedną? Każda z tych decyzji zmienia wynik – czasem o kilka punktów, czasem tak, że osoba ostrożna i osoba zgadująca zamieniają się miejscami.
Domyślną regułę – 1 punkt za odpowiedź zgodną z kluczem, 0 za błędną i za „nie wiem” – podajemy w poradniku ankieta wiedzy – analiza krok po kroku razem z opisem wyniku, KR-20 i porównaniami grup. Tu sprawdzamy, dlaczego ta reguła jest rozsądna, kiedy warto ją zmienić i jak punktować formaty, które sprawiają najwięcej kłopotu: prawda/fałsz i pytania z kilkoma poprawnymi odpowiedziami. Jak zaplanować cały test – od obszarów treści po pilotaż – opisujemy we wpisie jak zbudować test wiedzy.
Przykład (dane symulowane). 160 studentów pielęgniarstwa rozwiązało test z 20 pytań jednokrotnego wyboru (A–D i „nie wiem”) oraz 8 pytań „zaznacz wszystkie poprawne” (pięć opcji, w każdym dwie lub trzy poprawne). Treść pytań pomijamy – to wpis o punktowaniu, nie o medycynie. Symulacja ma jedną przewagę nad prawdziwym badaniem: wiemy, które pytania każda osoba naprawdę zna, a które zgadła. Możemy więc sprawdzić, który sposób punktowania najlepiej oddaje wiedzę. Dane do pobrania: punktowanie-testu-wiedzy-dane.csv (odpowiedzi na 20 pytań, klucz jest w wyniku kodu) i punktowanie-pytania-kilka-poprawnych.csv (zaznaczenia w jednej komórce, tak jak w eksporcie z formularza online). Wszystkie liczby pochodzą z kodu w sekcji Przykład w R.
Reguła 1/0: punkt za poprawną odpowiedź, zero za resztę
Najprostsza i najczęstsza reguła to liczba poprawnych odpowiedzi (ang. number-right scoring). Każdą odpowiedź porównujesz z kluczem odpowiedzi i zamieniasz na 1 albo 0, a suma to wynik surowy. Ma trzy zalety: jest zrozumiała dla promotora i czytelnika, pasuje do współczynnika KR-20 (Kuder i Richardson, 1937), który zakłada pozycje 0/1, i nie wymaga od respondentów żadnej strategii. Budescu i Bar-Hillel (1993), analizując punktowanie testów z perspektywy teorii decyzji, rekomendują właśnie ją: zniechęca do pomijania pytań i jest odporna na to, że ludzie różnią się motywacją i oceną własnej niepewności.
Wadę ma jedną: nagradza zgadywanie. Przy czterech opcjach strzał na ślepo daje średnio 0.25 punktu, a „nie wiem” – zero. Problem zaczyna się wtedy, gdy jedni zgadują, a inni uczciwie zaznaczają „nie wiem”.
„Nie wiem”: zero czy brak danych?
Opcja „nie wiem” w kafeterii testu wiedzy ma sens: zmniejsza liczbę strzałów i daje osobną informację o lukach w wiedzy. Luskin i Bullock (2011) pokazali, że gdy zniechęca się respondentów do tej odpowiedzi, przybywa poprawnych odpowiedzi w pytaniach zamkniętych, ale w większości pozornie – dzięki zgadywaniu. Jak jednak liczyć tę odpowiedź? Są dwie drogi:
- „Nie wiem” = 0 punktów. Wynik to liczba poprawnych odpowiedzi na wszystkie pytania.
- „Nie wiem” = brak danych. Wynik to odsetek poprawnych odpowiedzi wśród pytań, na które osoba odpowiedziała merytorycznie.
Druga droga kusi, bo przypomina zasadę z pytań o opinie, gdzie odpowiedź „nie wiem” zamienia się na brak danych. W teście wiedzy prowadzi jednak do absurdu. W przykładzie „nie wiem” stanowiło 25.0% wszystkich odpowiedzi, a tylko 13 ze 160 osób ani razu go nie wybrało. Weźmy dwie osoby, które znają dokładnie po 10 pytań:
| Osoba | Zna pytań | Poprawne | Błędne | „Nie wiem” | Wynik 1/0 | % z udzielonych | Z poprawką R − W/3 |
|---|---|---|---|---|---|---|---|
| ostrożna (nr 1) | 10 | 10 | 0 | 10 | 10 | 100.0% | 10.00 |
| zgadująca (nr 59) | 10 | 12 | 6 | 2 | 12 | 66.7% | 10.00 |
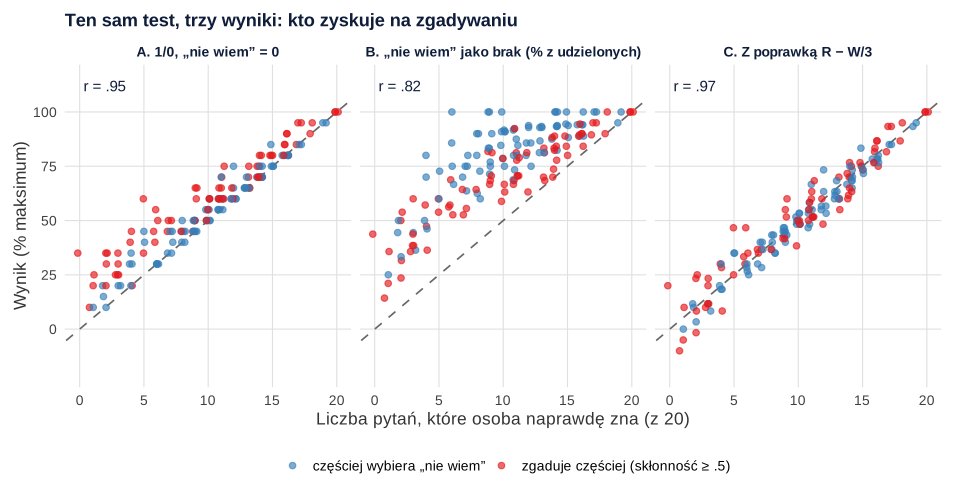
Osoba ostrożna odpowiedziała tylko na to, co wiedziała, a na resztę zaznaczyła „nie wiem”. Gdy potraktujesz „nie wiem” jak brak, dostaje 100% – jak najlepszy student w grupie – choć zna połowę materiału. W całej grupie korelacja wyniku z liczbą naprawdę znanych pytań wyniosła .82 dla odsetka z udzielonych odpowiedzi i .95 dla reguły 1/0.
Jest też koszt dla rzetelności. Przy „nie wiem” = 0 KR-20 wyniósł .81 dla wszystkich 160 osób. Jeśli „nie wiem” to brak, a program liczy rzetelność tylko na kompletnych wierszach (tak robi domyślnie wiele procedur), zostaje 13 osób bez żadnego „nie wiem” – z wynikiem średnio 17.46 punktu wobec 11.46 w całej grupie. Otrzymane KR-20 = .74 opisuje więc wąską grupę najlepszych, a nie Twoją próbę. Takie braki nie są losowe (zob. braki danych MCAR, MAR, MNAR), bo zależą właśnie od wiedzy.
Wniosek: w teście wiedzy „nie wiem” to 0 punktów. Odsetek „nie wiem” pokaż osobno przy analizie pozycji testu, bo odróżnia lukę w wiedzy od błędnego przekonania. Brakiem danych zostaje tylko puste pole – i dla niego ustal regułę przed analizą (ile pominiętych pytań wyklucza osobę), jak w kroku 1 poradnika o ankiecie wiedzy.
Zgadywanie i poprawka na zgadywanie
Wróćmy do tabeli. Przy regule 1/0 osoba zgadująca ma 12 punktów, ostrożna – 10, choć wiedzą tyle samo. Zgadująca trafiła 2 z 8 strzałów, czyli mniej więcej tyle, ile daje rachunek prawdopodobieństwa. W całej grupie wynik 1/0 przewyższał liczbę znanych pytań średnio o 1.23 punktu, a ta nadwyżka korelowała ze skłonnością do zgadywania, r = .50. Część różnic między osobami to więc różnice w skłonności do ryzyka, a nie w wiedzy (rysunek 1).
Klasyczną odpowiedzią jest poprawka na zgadywanie (ang. formula scoring):
gdzie R to liczba poprawnych odpowiedzi, W – liczba błędnych (bez „nie wiem” i pustych), a k – liczba opcji w pytaniu. Przy czterech opcjach każda błędna odpowiedź odejmuje 1/3 punktu. Strzał na ślepo daje wtedy średnio zero: 1/4 szansy na +1 i 3/4 szansy na −1/3. W przykładzie obie osoby z tabeli mają po 10.00 punktu, średnia nadwyżka nad liczbą znanych pytań spadła z 1.23 do 0.04, a jej korelacja ze skłonnością do zgadywania – z .50 do .18. Korelacja wyniku z wiedzą wzrosła z .95 do .97.
Dlaczego więc nie stosować poprawki zawsze? Frary (1988) zwraca uwagę, że działa ona uczciwie tylko z właściwą instrukcją: badani mają pomijać pytanie wyłącznie wtedy, gdy zgadywaliby zupełnie na ślepo. Kto odrzuci choć jedną opcję, powinien odpowiadać, a osoby z częściową wiedzą, które mimo to pomijają pytania, zwykle tracą punkty. Autor uznaje taką punktację za nieodpowiednią dla większości testów w nauczaniu. Budescu i Bar-Hillel (1993) dodają, że racjonalnemu badanemu odpowiedź nigdy się nie opłaca mniej niż pominięcie, a ludziom, którzy nie liczą wartości oczekiwanej, trudno dać dobrą instrukcję. Burton (2005) omawia z kolei dwanaście błędnych lub wątpliwych przekonań o wpływie długości testu, zgadywania i punktów ujemnych na rzetelność; część z nich wzięła się z danych ze źle napisanych testów.
W przykładzie poprawka nie zwiększyła też rzetelności: α = .80 wobec KR-20 = .81 przy regule 1/0. Każdy strzał ma przy niej większy rozrzut punktów (+1 albo −1/3 zamiast +1 albo 0), co zjada część zysku.
Co z tego wynika dla pracy dyplomowej? W ankiecie wiedzy pacjentów albo studentów, w której nikt niczego nie zalicza, zostań przy regule 1/0 z „nie wiem” = 0 i instrukcją: „jeśli nie znasz odpowiedzi, zaznacz »nie wiem«”. Nie wprowadzaj punktów ujemnych po fakcie, jeśli respondenci nie wiedzieli o nich, wypełniając test – reguła punktowania i instrukcja muszą do siebie pasować. Jeśli zależy Ci na sprawdzeniu, czy zgadywanie zmienia wnioski, policz wynik z poprawką jako analizę dodatkową i napisz, czy wyniki się różnią. W modelach teorii reagowania na pozycje testowe (IRT) zgadywanie można modelować wprost osobnym parametrem pozycji, ale w pracy licencjackiej to zwykle za dużo.
Prawda/fałsz: połowa punktów to jeszcze nie wiedza
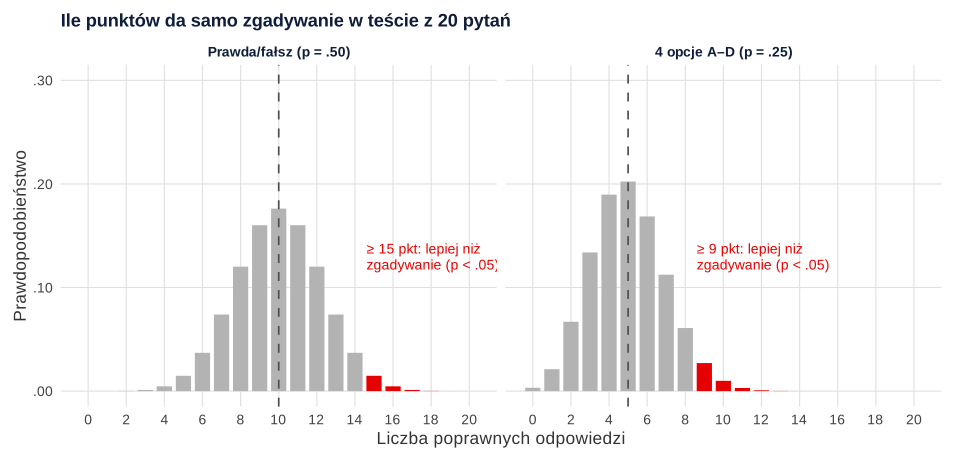
W pytaniach prawda/fałsz strzał daje 50% szans. Test z 20 takich pytań rozwiązany rzutami monetą da średnio 10 punktów, a 95% wyników zgadującego mieści się między 6 a 14 punktami. Liczba trafień przy samym zgadywaniu ma rozkład dwumianowy, więc łatwo policzyć, od jakiego wyniku osoba odpowiada istotnie lepiej niż przypadkowo (test jednostronny, α = .05). Przy 20 pytaniach to 15 punktów: szansa, że zgadujący uzyska co najmniej 15, wynosi .021, a co najmniej 14 – .058.
| Liczba pytań | P/F: średnio przy zgadywaniu | P/F: istotnie lepiej od | A–D: średnio przy zgadywaniu | A–D: istotnie lepiej od |
|---|---|---|---|---|
| 10 | 5 | 9 (90.0%) | 2.5 | 6 (60.0%) |
| 20 | 10 | 15 (75.0%) | 5 | 9 (45.0%) |
| 30 | 15 | 20 (66.7%) | 7.5 | 13 (43.3%) |
| 40 | 20 | 26 (65.0%) | 10 | 16 (40.0%) |
Tabela pokazuje dwie rzeczy. Po pierwsze, w krótkim teście prawda/fałsz nawet 70% poprawnych odpowiedzi nie odróżnia osoby od zgadującej. Osoba z wynikiem 14/20 ma 70.0% poprawnych odpowiedzi, ale 95% przedział ufności dla proporcji (Cloppera–Pearsona) to [45.7%, 88.1%] i obejmuje 50%; jednostronne p = .058. Po drugie, im dłuższy test, tym bliżej poziomu przypadku leży próg – dłuższy test lepiej oddziela wiedzę od szczęścia.
Jeśli chcesz porównać wynik prawda/fałsz z wynikiem z pytań A–D albo z innym badaniem, przelicz go na wynik skorygowany o zgadywanie:
gdzie p to odsetek poprawnych odpowiedzi, a k – liczba opcji. Dla 70% w teście prawda/fałsz: (70% − 50%) / (100% − 50%) = 40%. To ważne przy progach: „co najmniej 60% poprawnych” w teście prawda/fałsz oznacza coś zupełnie innego niż w teście z czterema opcjami. Dlaczego progi typu 60% są umowne i jak ustalić je metodą sędziów, wyjaśnia wpis próg dobrej wiedzy – metoda Angoffa.
Pytania z kilkoma poprawnymi odpowiedziami
Pytanie „zaznacz wszystkie poprawne odpowiedzi” wygląda podobnie do pytania wielokrotnego wyboru w ankiecie („z jakich źródeł czerpiesz wiedzę?”), ale liczy się je inaczej. W ankiecie nie ma dobrych odpowiedzi – każdą opcję zamieniasz na zmienną 0/1 i podajesz odsetek osób, które ją zaznaczyły (zob. pytania wielokrotnego wyboru w ankiecie – jak zakodować i policzyć). W teście jest klucz, a z zaznaczeń trzeba zrobić punkty za całe pytanie. Rozbicie komórki z eksportu („A, C, D”) na opcje jest w obu przypadkach takie samo.
Najczęściej spotkasz trzy reguły (c to liczba poprawnych opcji w pytaniu):
- Wszystko albo nic. 1 punkt tylko za dokładnie poprawny zestaw, inaczej 0.
- Punkty częściowe z karą. +1/c za każdą zaznaczoną poprawną opcję, −1/c za każdą zaznaczoną błędną, wynik pytania nie mniejszy niż 0.
- Każda opcja jak prawda/fałsz. Odsetek opcji ocenionych trafnie: zaznaczonych poprawnych i niezaznaczonych błędnych.
| Zaznaczono (poprawne: A, C) | Wszystko albo nic | Częściowe z karą | Opcje jak prawda/fałsz |
|---|---|---|---|
| A, C | 1 | 1.0 | 1.0 |
| A | 0 | 0.5 | 0.8 |
| A, C, D | 0 | 0.5 | 0.8 |
| A, B, C, D, E | 0 | 0.0 | 0.4 |
| (nic) | 0 | 0.0 | 0.6 |
| B, D | 0 | 0.0 | 0.2 |
Już ta mała tabela pokazuje pułapkę trzeciej reguły: osoba, która nie zaznaczyła niczego, dostaje 0.6 punktu, więcej niż za zaznaczenie wszystkiego. Kara w regule częściowej sprawia z kolei, że „zaznacz wszystko na wszelki wypadek” się nie opłaca.
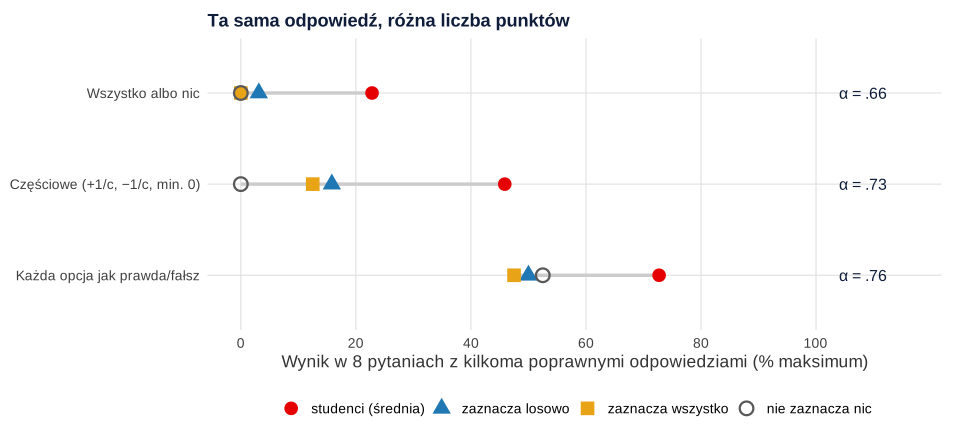
W przykładzie te same odpowiedzi 160 studentów na 8 pytań dały trzy różne obrazy wiedzy:
| Reguła | M (% maks.) | SD | α | r z wiedzą | Losowe zaznaczanie | Zaznacza wszystko | Nie zaznacza nic |
|---|---|---|---|---|---|---|---|
| wszystko albo nic | 22.8 | 22.6 | .66 | .77 | 3.1% | 0.0% | 0.0% |
| częściowe z karą | 45.9 | 21.7 | .73 | .86 | 15.8% | 12.5% | 0.0% |
| opcje jak prawda/fałsz | 72.7 | 12.6 | .76 | .86 | 50.0% | 47.5% | 52.5% |
Reguła „wszystko albo nic” jest najsurowsza (średnio 22.8% maksimum) i wyrzuca informację o częściowej wiedzy: osoba, która zaznaczyła dwie z trzech poprawnych opcji, dostaje tyle samo co ktoś, kto nie trafił żadnej. Dlatego ma najniższą rzetelność (α = .66). Reguła częściowa z karą podniosła rzetelność do α = .73 i korelację z prawdziwą wiedzą z .77 do .86. To nie efekt jednego losowania: w 200 powtórzeniach symulacji średnia α wyniosła .68 dla reguły „wszystko albo nic” i .76 dla reguły częściowej, a reguła częściowa wygrała w 100.0% powtórzeń. Podobny wynik w danych studentów nauk o zdrowiu i medycyny, dla pytań typu wielokrotne prawda/fałsz, opisali Albanese i Sabers (1988): sposoby punktowania uwzględniające częściową wiedzę były rzetelniejsze i trafniejsze niż sposoby ograniczające szansę trafienia przypadkiem. Tsai i Suen (1993) nie znaleźli jednak istotnych różnic w rzetelności między sześcioma metodami punktowania takich pytań – metody różniły się za to średnimi, co trzeba uwzględnić przy ustalaniu progu zaliczenia.
Reguła „opcje jak prawda/fałsz” ma podobną rzetelność (α = .76), ale wysoki poziom przypadku: losowe zaznaczanie daje 50.0% maksimum, a pusta odpowiedź – 52.5%. Średnie 72.7% wygląda więc dobrze tylko na pierwszy rzut oka. Schmidt i in. (2021) w przeglądzie metod punktowania takich pytań podkreślają, że nie ma zgody co do najlepszej metody, a metody różnią się właśnie oczekiwanym wynikiem przy losowym zgadywaniu. Kanzow i in. (2023) zastosowali 41 reguł do tych samych odpowiedzi egzaminacyjnych i otrzymali wyniki od 0.02 do 0.98. Przy takiej rozpiętości od reguły może zależeć, czy wynik przekroczy próg.
Praktyczne zalecenia:
- Wybierz regułę częściową z karą i dolną granicą 0, chyba że pytanie naprawdę wymaga kompletu (np. wszystkie kroki procedury).
- Rzetelność licz na wynikach pytań, a nie na pojedynczych opcjach. Albanese i Sabers (1988) pokazali, że opcje tego samego pytania korelują ze sobą od 2.6 do 7.0 razy silniej niż opcje różnych pytań, więc nie można ich traktować jak niezależnych pozycji – a tak właśnie robi KR-20 liczony na opcjach. Przy punktach częściowych pozycje nie są już 0/1, więc zamiast KR-20 podaj alfę Cronbacha (dla pozycji 0/1 to ta sama liczba).
- Napisz w instrukcji testu, że pytanie może mieć więcej niż jedną poprawną odpowiedź i że błędne zaznaczenia obniżają wynik.
- Jeśli test łączy pytania jednokrotnego wyboru i pytania z kilkoma poprawnymi, każde pytanie warte jest najwyżej 1 punkt – inaczej pytania wielokrotne niepostrzeżenie dostają większą wagę.
Wagi pytań: zwykle niepotrzebne
Promotorzy i studenci często chcą dać trudniejszym albo „ważniejszym” pytaniom więcej punktów. W praktyce zmienia to niewiele. W przykładzie suma ważona trudnością (od 1 do 3 punktów, im trudniejsze pytanie, tym więcej) korelowała z sumą zwykłą na poziomie r = .994, a suma z arbitralnymi wagami 1–3 – na poziomie .985. Kolejność osób prawie się nie zmienia, a KR-20 traci sens, bo pozycje nie są już 0/1.
Ważność obszarów treści lepiej uwzględnić przy budowie testu – w tabeli specyfikacji dać ważnemu obszarowi więcej pytań (zob. budowa testu wiedzy) i sprawdzić to w ocenie ekspertów.
Wynik w procentach i jego opis
Gdy pytania mają różne formaty, najprościej podać wynik jako odsetek maksymalnej liczby punktów, czyli POMP. Dla testu z przykładu: suma punktów z 20 pytań jednokrotnego wyboru i 8 pytań z punktami częściowymi, podzielona przez 28 i pomnożona przez 100. Do opisu wyniku dołącz:
- średnią, odchylenie standardowe, medianę i rozstęp (zob. poradnik o ankiecie wiedzy);
- odsetek odpowiedzi „nie wiem”;
- regułę punktowania każdego formatu, a przy pytaniach prawda/fałsz – poziom przypadku (50%).
Uważaj też na efekt sufitu: łagodna reguła punktowania (np. „opcje jak prawda/fałsz”) łatwo spycha wyniki pod 100% i zaciera różnice między osobami. Jeśli mierzysz wiedzę przed i po szkoleniu, zachowaj tę samą regułę w obu pomiarach – zmiana reguły między pomiarami zmienia wynik bardziej niż niejedno szkolenie (zob. badanie wiedzy przed i po szkoleniu).
Jak opisać punktowanie w pracy
Opis reguł należy do rozdziału metodologicznego, przy opisie narzędzia. Wzór dla testu z przykładu (uzupełnij nawiasy kwadratowe):
Jeśli policzysz wynik z poprawką na zgadywanie jako analizę dodatkową, dodaj w wynikach jedno zdanie, na przykład:
Najczęstsze błędy
- „Nie wiem” jako brak danych w teście wiedzy. Osoby, które uczciwie przyznają się do niewiedzy, dostają zawyżone wyniki, a rzetelność liczysz na garstce kompletnych odpowiedzi.
- Punkty ujemne bez uprzedzenia respondentów. Poprawka na zgadywanie ma sens tylko wtedy, gdy instrukcja mówi, że za błędną odpowiedź traci się punkty.
- Interpretowanie 60% w teście prawda/fałsz jak w teście A–D. Połowę punktów da sam rzut monetą.
- Liczenie KR-20 na opcjach pytań z kilkoma poprawnymi odpowiedziami. Opcje tego samego pytania są zależne; licz rzetelność na wynikach pytań.
- Reguła „opcje jak prawda/fałsz” bez komentarza. Pusta odpowiedź daje przy niej ponad połowę punktów.
- Zmiana reguły po zobaczeniu wyników – na przykład przejście z „wszystko albo nic” na punkty częściowe, bo wyniki wyszły niskie. Regułę zapisz przed zebraniem danych.
Przy budowie testu przydadzą się też wpisy o pisaniu pytań testowych i dystraktorów oraz o statystyce w pracy z pielęgniarstwa. Jeśli chcesz, żeby ktoś sprawdził punktowanie, klucz i rzetelność Twojego testu, zanim oddasz rozdział, zobacz pomoc w analizie dla studentów.
Przykład w R: punktowanie testu wiedzy
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy odpowiedzi 160 osób na 20 pytań A–D z „nie wiem”, zapisuje je do pliku CSV w folderze nadrzędnym (../), punktuje je trzema sposobami, liczy KR-20, progi dla testów prawda/fałsz i wpływ wag. Drugi punktuje 8 pytań z kilkoma poprawnymi odpowiedziami trzema regułami i powtarza symulację 200 razy. Rysunki powstały w osobnym skrypcie na tych samych danych. Pliki: punktowanie-testu-wiedzy-dane.csv i punktowanie-pytania-kilka-poprawnych.csv.
„Nie wiem”, poprawka na zgadywanie, prawda/fałsz i wagi
R
# B422 – punktowanie testu wiedzy: „nie wiem”, zgadywanie, prawda/fałsz (dane symulowane)
# Test: 20 pytań jednokrotnego wyboru (A–D) z odpowiedzią „nie wiem”, 160 studentów pielęgniarstwa.
# Uruchom z folderu kod/; plik CSV trafia do folderu strony (../).
options(width = 100)
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))  # zapis APA: .50
set.seed(422)
N <- 160; k <- 20; opcje <- 4
pozycje <- paste0("P", 1:k)

# --- symulacja: kto zna odpowiedź, kto zgaduje, a kto zaznacza „nie wiem” ---------------
wiedza <- rnorm(N)                                  # cecha ukryta (wiedza)
sklonnosc <- rbeta(N, 2, 2)                         # gdy nie zna: P(zgaduje) zamiast „nie wiem”
trudnosc <- seq(-1.5, 1.5, length.out = k)
zna <- matrix(rbinom(N * k, 1, plogis(1.5 * outer(wiedza, trudnosc, "-"))), N, k)
klucz <- sample(LETTERS[1:opcje], k, replace = TRUE)
odp <- matrix(NA_character_, N, k, dimnames = list(NULL, pozycje))
for (j in 1:k) for (i in 1:N) {
  odp[i, j] <- if (zna[i, j] == 1) klucz[j] else
    if (runif(1) < sklonnosc[i]) sample(LETTERS[1:opcje], 1) else "nie wiem"
}
write.csv(data.frame(id = 1:N, odp), "../punktowanie-testu-wiedzy-dane.csv", row.names = FALSE)
cat("Klucz:", paste0(pozycje, "=", klucz, collapse = " "), "\n\n")

# --- punktowanie ---------------------------------------------------------------------
poprawna <- sweep(odp, 2, klucz, "==") * 1          # 1 = zgodna z kluczem
nie_wiem <- (odp == "nie wiem") * 1
bledna   <- 1 - poprawna - nie_wiem
R <- rowSums(poprawna); W <- rowSums(bledna); O <- rowSums(nie_wiem)
wyniki <- data.frame(
  zero_jeden   = R,                                 # 1/0, „nie wiem” = 0
  proc_udziel  = 100 * R / (R + W),                 # „nie wiem” jako brak: % poprawnych z udzielonych
  formula      = R - W / (opcje - 1))               # poprawka na zgadywanie
znane <- rowSums(zna)                               # ile pytań osoba naprawdę zna

cat("ODPOWIEDZI „NIE WIEM”\n")
cat(sprintf("Odsetek wszystkich odpowiedzi: %.1f%%; osoby bez żadnego „nie wiem”: %d z %d\n",
            100 * mean(nie_wiem), sum(O == 0), N))
cat(sprintf("Liczba „nie wiem” na osobę: M = %.2f, min = %d, max = %d\n\n", mean(O), min(O), max(O)))

cat("TRZY SPOSOBY PUNKTOWANIA (N = 160)\n")
opis <- data.frame(sposob = c("1/0, nie wiem = 0 (pkt 0-20)", "nie wiem = brak (% z udzielonych)",
                              "poprawka R - W/3 (pkt)"),
                   M = sapply(wyniki, mean), SD = sapply(wyniki, sd),
                   r_ze_znanymi = sapply(wyniki, cor, y = znane))
print(opis, row.names = FALSE, digits = 3)
cat(sprintf("Liczba pytań, które osoby naprawdę znały: M = %.2f, SD = %.2f\n", mean(znane), sd(znane)))
cat(sprintf("Wynik 1/0 minus liczba znanych pytań: M = %.2f; korelacja ze skłonnością do zgadywania r = %s\n",
            mean(R - znane), bz(cor(R - znane, sklonnosc))))
cat(sprintf("Wynik z poprawką minus liczba znanych: M = %.2f; korelacja ze skłonnością r = %s\n\n",
            mean(wyniki$formula - znane), bz(cor(wyniki$formula - znane, sklonnosc))))

cat("DWIE OSOBY, KTÓRE ZNAJĄ TYLE SAMO PYTAŃ\n")
kand <- which(znane == 10)
para <- c(kand[which.min(sklonnosc[kand])], kand[which.max(sklonnosc[kand])])
print(data.frame(osoba = para, znane = znane[para], sklonnosc = round(sklonnosc[para], 2),
                 poprawne = R[para], bledne = W[para], nie_wiem = O[para],
                 wynik_1_0 = R[para], proc_udziel = round(wyniki$proc_udziel[para], 1),
                 formula = round(wyniki$formula[para], 2)), row.names = FALSE)

cat("\nRZETELNOŚĆ (KR-20 = alfa dla pozycji 0/1)\n")
alfa <- function(X) { C <- cov(X); ncol(X) / (ncol(X) - 1) * (1 - sum(diag(C)) / sum(C)) }
kompletne <- O == 0
cat(sprintf("„Nie wiem” = 0, wszyscy (n = %d): KR-20 = %.3f\n", N, alfa(poprawna)))
cat(sprintf("„Nie wiem” = brak, usunięte osoby z brakami (zostaje n = %d): KR-20 = %.3f\n",
            sum(kompletne), alfa(poprawna[kompletne, ])))
cat(sprintf("  średni wynik tych osób: %.2f pkt wobec %.2f w całej grupie\n",
            mean(R[kompletne]), mean(R)))
pkt_formula <- poprawna - bledna / (opcje - 1)
cat(sprintf("Punktacja z poprawką (1 / 0 / -1/3), wszyscy: alfa = %.3f\n\n", alfa(pkt_formula)))

cat("PRAWDA/FAŁSZ I 4 OPCJE: JAKI WYNIK JEST LEPSZY OD ZGADYWANIA? (test jednostronny, alfa = .05)\n")
prog <- function(n, p) { x <- 0:n; min(x[pbinom(x - 1, n, p, lower.tail = FALSE) <= .05]) }
tab <- do.call(rbind, lapply(c(10, 20, 30, 40), function(n) data.frame(
  pytan = n,
  PF_oczekiwany = n * .5, PF_prog = prog(n, .5), PF_prog_proc = round(100 * prog(n, .5) / n, 1),
  ABCD_oczekiwany = n * .25, ABCD_prog = prog(n, .25), ABCD_prog_proc = round(100 * prog(n, .25) / n, 1))))
print(tab, row.names = FALSE)
cat("\n20 pytań P/F – rozkład wyniku przy samym zgadywaniu:\n")
x <- 12:16
print(data.frame(wynik = x, P_co_najmniej = round(pbinom(x - 1, 20, .5, lower.tail = FALSE), 4)),
      row.names = FALSE)
cat(sprintf("95%% wyników zgadującego mieści się w przedziale %d-%d pkt\n",
            qbinom(.025, 20, .5), qbinom(.975, 20, .5)))
bt <- binom.test(14, 20, p = .5, alternative = "greater")
ci <- binom.test(14, 20)$conf.int
cat(sprintf("Osoba z 14/20 P/F: p = %s (jednostronny), 95%% CI Cloppera-Pearsona [%.1f%%, %.1f%%]\n",
            bz(bt$p.value, 3), 100 * ci[1], 100 * ci[2]))
cat(sprintf("Wynik skorygowany o zgadywanie: (70%% - 50%%) / (100%% - 50%%) = %.0f%%\n\n",
            100 * (0.70 - 0.5) / (1 - 0.5)))

cat("WAGI PYTAŃ: czy zmieniają uporządkowanie osób?\n")
p_lat <- colMeans(poprawna)
wagi_trud <- 1 + 2 * (1 - p_lat)                    # trudniejsze pytania warte więcej (1-3 pkt)
wagi_los <- sample(1:3, k, replace = TRUE)          # wagi „według ważności” ustalone arbitralnie
cat(sprintf("r(suma, suma ważona trudnością) = %s; r(suma, wagi 1-3) = %s\n",
            bz(cor(R, poprawna %*% wagi_trud), 3), bz(cor(R, poprawna %*% wagi_los), 3)))
Wynik w R
Klucz: P1=D P2=B P3=B P4=D P5=C P6=B P7=B P8=C P9=D P10=B P11=A P12=C P13=D P14=A P15=C P16=A P17=A P18=C P19=C P20=B

ODPOWIEDZI „NIE WIEM”
Odsetek wszystkich odpowiedzi: 25.0%; osoby bez żadnego „nie wiem”: 13 z 160
Liczba „nie wiem” na osobę: M = 4.99, min = 0, max = 15

TRZY SPOSOBY PUNKTOWANIA (N = 160)
                            sposob    M    SD r_ze_znanymi
      1/0, nie wiem = 0 (pkt 0-20) 11.5  4.21        0.954
 nie wiem = brak (% z udzielonych) 75.7 19.50        0.818
            poprawka R - W/3 (pkt) 10.3  4.82        0.968
Liczba pytań, które osoby naprawdę znały: M = 10.23, SD = 4.78
Wynik 1/0 minus liczba znanych pytań: M = 1.23; korelacja ze skłonnością do zgadywania r = .50
Wynik z poprawką minus liczba znanych: M = 0.04; korelacja ze skłonnością r = .18

DWIE OSOBY, KTÓRE ZNAJĄ TYLE SAMO PYTAŃ
 osoba znane sklonnosc poprawne bledne nie_wiem wynik_1_0 proc_udziel formula
     1    10      0.07       10      0       10        10       100.0      10
    59    10      0.87       12      6        2        12        66.7      10

RZETELNOŚĆ (KR-20 = alfa dla pozycji 0/1)
„Nie wiem” = 0, wszyscy (n = 160): KR-20 = 0.807
„Nie wiem” = brak, usunięte osoby z brakami (zostaje n = 13): KR-20 = 0.735
  średni wynik tych osób: 17.46 pkt wobec 11.46 w całej grupie
Punktacja z poprawką (1 / 0 / -1/3), wszyscy: alfa = 0.799

PRAWDA/FAŁSZ I 4 OPCJE: JAKI WYNIK JEST LEPSZY OD ZGADYWANIA? (test jednostronny, alfa = .05)
 pytan PF_oczekiwany PF_prog PF_prog_proc ABCD_oczekiwany ABCD_prog ABCD_prog_proc
    10             5       9         90.0             2.5         6           60.0
    20            10      15         75.0             5.0         9           45.0
    30            15      20         66.7             7.5        13           43.3
    40            20      26         65.0            10.0        16           40.0

20 pytań P/F – rozkład wyniku przy samym zgadywaniu:
 wynik P_co_najmniej
    12        0.2517
    13        0.1316
    14        0.0577
    15        0.0207
    16        0.0059
95% wyników zgadującego mieści się w przedziale 6-14 pkt
Osoba z 14/20 P/F: p = .058 (jednostronny), 95% CI Cloppera-Pearsona [45.7%, 88.1%]
Wynik skorygowany o zgadywanie: (70% - 50%) / (100% - 50%) = 40%

WAGI PYTAŃ: czy zmieniają uporządkowanie osób?
r(suma, suma ważona trudnością) = .994; r(suma, wagi 1-3) = .985
Pytania z kilkoma poprawnymi odpowiedziami: trzy reguły i 200 powtórzeń
R
# B422 – pytania z kilkoma poprawnymi odpowiedziami: trzy sposoby punktowania (dane symulowane)
# 8 pytań „zaznacz wszystkie poprawne”, po 5 opcji (A–E), 2 lub 3 poprawne; 160 studentów.
# Uruchom z folderu kod/; plik CSV (zaznaczenia w jednej komórce, jak w eksporcie z formularza) trafia do ../
options(width = 100)
set.seed(4220)
m <- 5; opc <- LETTERS[1:m]; n_poz <- 8
klucz <- list(c("A","C"), c("B","D","E"), c("A","B"), c("C","E"), c("A","D","E"),
              c("B","C"), c("A","B","D"), c("D","E"))
names(klucz) <- paste0("W", 1:n_poz)

# Reguły punktowania jednego pytania (zaznaczone = wektor liter)
pkt_aon <- function(zazn, kl) as.numeric(setequal(zazn, kl))                 # wszystko albo nic
pkt_czesc <- function(zazn, kl) {                                            # +1/c za trafne, -1/c za błędne, min. 0
  c_ <- length(kl); max(0, (sum(zazn %in% kl) - sum(!zazn %in% kl)) / c_) }
pkt_pf <- function(zazn, kl) mean((opc %in% zazn) == (opc %in% kl))          # każda opcja jak prawda/fałsz
reguly <- list(wszystko_albo_nic = pkt_aon, czesciowe = pkt_czesc, opcje_jak_PF = pkt_pf)

cat("PRZYKŁAD: pytanie z poprawnymi A i C\n")
wzorce <- list("A, C", "A", "A, C, D", "A, B, C, D, E", "", "B, D")
rozbij <- function(s) if (is.na(s) || s == "") character(0) else strsplit(s, ", ")[[1]]
print(data.frame(zaznaczono = sapply(wzorce, function(s) if (s == "") "(nic)" else s),
                 t(sapply(wzorce, function(s) sapply(reguly, function(f) round(f(rozbij(s), c("A","C")), 2))))),
      row.names = FALSE)

# Symulacja odpowiedzi: przy każdej opcji osoba wie, czy jest poprawna, albo zaznacza „na wyczucie”
symuluj <- function(N = 160) {
  wiedza <- rnorm(N); sklon <- rbeta(N, 2, 3)          # sklon: P(zaznaczy opcję, której nie zna)
  trud <- matrix(seq(-1.2, 1.2, length.out = n_poz * m)[sample(n_poz * m)], n_poz, m)
  zazn <- matrix("", N, n_poz, dimnames = list(NULL, names(klucz)))
  for (j in 1:n_poz) {
    popr <- opc %in% klucz[[j]]
    zna <- matrix(rbinom(N * m, 1, plogis(1.3 * outer(wiedza, trud[j, ], "-"))), N, m)
    strzal <- matrix(rbinom(N * m, 1, sklon), N, m)
    X <- ifelse(zna == 1, rep(popr, each = N), strzal)
    zazn[, j] <- apply(X, 1, function(w) paste(opc[w == 1], collapse = ", "))
  }
  list(zazn = zazn, wiedza = wiedza)
}
punktuj <- function(zazn, f) sapply(seq_along(klucz), function(j)
  sapply(zazn[, j], function(s) f(rozbij(s), klucz[[j]])))
alfa <- function(X) { C <- cov(X); ncol(X) / (ncol(X) - 1) * (1 - sum(diag(C)) / sum(C)) }

d <- symuluj()
write.csv(data.frame(id = seq_len(nrow(d$zazn)), d$zazn), "../punktowanie-pytania-kilka-poprawnych.csv",
          row.names = FALSE)
cat("\nPierwsze odpowiedzi (format jak w eksporcie z formularza):\n"); print(head(d$zazn, 3))

cat("\nTRZY REGUŁY NA TYCH SAMYCH ODPOWIEDZIACH (N = 160, wynik w % maksimum)\n")
# Losowe zaznaczanie (każda opcja z p = .5) – wartość oczekiwana z 32 możliwych wzorców
wzory <- lapply(0:(2^m - 1), function(v) opc[bitwAnd(v, 2^(0:(m - 1))) > 0])
oczekiwany <- function(f) 100 * mean(sapply(klucz, function(kl) mean(sapply(wzory, f, kl = kl))))
wszystko <- function(f) 100 * mean(sapply(klucz, function(kl) f(opc, kl)))
nic <- function(f) 100 * mean(sapply(klucz, function(kl) f(character(0), kl)))
tab <- do.call(rbind, lapply(names(reguly), function(r) {
  P <- punktuj(d$zazn, reguly[[r]]); w <- 100 * rowMeans(P)
  data.frame(regula = r, M = mean(w), SD = sd(w), alfa = alfa(P), r_z_wiedza = cor(w, d$wiedza),
             losowo = oczekiwany(reguly[[r]]), wszystko = wszystko(reguly[[r]]), nic = nic(reguly[[r]]))
}))
print(transform(tab, M = round(M, 1), SD = round(SD, 1), alfa = round(alfa, 3), r_z_wiedza = round(r_z_wiedza, 3),
                losowo = round(losowo, 1), wszystko = round(wszystko, 1), nic = round(nic, 1)), row.names = FALSE)

cat("\nCZY TO WYNIK TEGO JEDNEGO LOSOWANIA? 200 powtórzeń symulacji\n")
pow <- replicate(200, {
  s <- symuluj()
  sapply(reguly, function(f) { P <- punktuj(s$zazn, f); c(alfa(P), cor(rowMeans(P), s$wiedza)) })
})
for (r in names(reguly)) {
  a <- pow[1, r, ]; rr <- pow[2, r, ]
  cat(sprintf("%-18s alfa: średnio %.3f (95%% wyników %.3f-%.3f); r z wiedzą: średnio %.3f (%.3f-%.3f)\n",
              r, mean(a), quantile(a, .025), quantile(a, .975), mean(rr), quantile(rr, .025), quantile(rr, .975)))
}
cat(sprintf("Alfa reguły częściowej wyższa niż wszystko-albo-nic w %.1f%% powtórzeń\n",
            100 * mean(pow[1, "czesciowe", ] > pow[1, "wszystko_albo_nic", ])))
Wynik w R
PRZYKŁAD: pytanie z poprawnymi A i C
    zaznaczono wszystko_albo_nic czesciowe opcje_jak_PF
          A, C                 1       1.0          1.0
             A                 0       0.5          0.8
       A, C, D                 0       0.5          0.8
 A, B, C, D, E                 0       0.0          0.4
         (nic)                 0       0.0          0.6
          B, D                 0       0.0          0.2

Pierwsze odpowiedzi (format jak w eksporcie z formularza):
     W1     W2        W3     W4           W5           W6  W7        W8
[1,] "A, C" "D, E"    "B"    "A, C, E"    "A, B, D"    "C" "B, D"    "C"
[2,] "A, C" "D, E"    "A, B" "B, C, D, E" "A, C, D, E" "E" "B, C, D" "B, D, E"
[3,] "C, D" "B, D, E" "D"    "E"          "B, D"       ""  "A, B"    "B"

TRZY REGUŁY NA TYCH SAMYCH ODPOWIEDZIACH (N = 160, wynik w % maksimum)
            regula    M   SD  alfa r_z_wiedza losowo wszystko  nic
 wszystko_albo_nic 22.8 22.6 0.656      0.768    3.1      0.0  0.0
         czesciowe 45.9 21.7 0.732      0.855   15.8     12.5  0.0
      opcje_jak_PF 72.7 12.6 0.758      0.859   50.0     47.5 52.5

CZY TO WYNIK TEGO JEDNEGO LOSOWANIA? 200 powtórzeń symulacji
wszystko_albo_nic  alfa: średnio 0.679 (95% wyników 0.590-0.753); r z wiedzą: średnio 0.790 (0.735-0.831)
czesciowe          alfa: średnio 0.757 (95% wyników 0.693-0.812); r z wiedzą: średnio 0.860 (0.821-0.888)
opcje_jak_PF       alfa: średnio 0.760 (95% wyników 0.706-0.812); r z wiedzą: średnio 0.866 (0.824-0.896)
Alfa reguły częściowej wyższa niż wszystko-albo-nic w 100.0% powtórzeń
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy w teście wiedzy odejmować punkty za błędne odpowiedzi?
Tylko wtedy, gdy respondenci wiedzą o tym z instrukcji. Poprawka na zgadywanie odejmuje 1/(k − 1) punktu za każdą błędną odpowiedź (przy czterech opcjach 1/3), więc strzał na ślepo daje średnio zero. W ankiecie wiedzy do pracy dyplomowej zwykle wystarczy reguła 1/0 z odpowiedzią „nie wiem” za 0 punktów, a wynik z poprawką możesz policzyć jako analizę dodatkową.
Ile poprawnych odpowiedzi w teście prawda/fałsz to więcej niż zgadywanie?
Zależy od długości testu. Przy 20 pytaniach zgadujący ma średnio 10 punktów, a wynik istotnie lepszy od przypadku (test jednostronny, α = .05) zaczyna się od 15 punktów, czyli 75%. Przy 40 pytaniach próg to 26 punktów (65%). Granice policzysz z rozkładu dwumianowego, np. funkcją binom.test w R.
Jak punktować pytanie, w którym jest kilka poprawnych odpowiedzi?
Najczęściej poleca się punkty częściowe: +1/c za każdą zaznaczoną poprawną opcję i −1/c za każdą zaznaczoną błędną (c – liczba poprawnych opcji), z wynikiem pytania nie niższym niż 0. Reguła „wszystko albo nic” traci informację o częściowej wiedzy, a ocenianie każdej opcji jak pytania prawda/fałsz daje około połowy punktów nawet za pustą odpowiedź.
Czy liczyć odsetek poprawnych odpowiedzi tylko z pytań, na które ktoś odpowiedział?
W teście wiedzy nie. Osoba, która zna połowę pytań i na resztę zaznacza „nie wiem”, dostałaby wtedy 100%, a rzetelność liczyłbyś na garstce osób bez żadnego „nie wiem”. Licz odsetek z wszystkich pytań, a liczbę odpowiedzi „nie wiem” pokaż osobno.
Czy trudniejsze pytania w teście wiedzy powinny mieć więcej punktów?
Zwykle nie warto. W naszej symulacji suma ważona trudnością korelowała ze zwykłą sumą na poziomie r = .994, więc kolejność osób prawie się nie zmieniła, a opis wyniku i KR-20 stały się trudniejsze. Ważniejszym obszarom treści daj raczej więcej pytań w planie testu.
Powiązane hasła
Przeczytaj też
Ankieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikJak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikPytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →Budujesz test wiedzy do pracy z pielęgniarstwa lub zdrowia publicznego?
Pomożemy ustalić reguły punktowania przed zebraniem danych, sprawdzimy klucz i rzetelność testu w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Albanese, M. A., & Sabers, D. L. (1988). Multiple true-false items: A study of interitem correlations, scoring alternatives, and reliability estimation. Journal of Educational Measurement, 25(2), 111–123. https://doi.org/10.1111/j.1745-3984.1988.tb00296.x
- Budescu, D., & Bar-Hillel, M. (1993). To guess or not to guess: A decision-theoretic view of formula scoring. Journal of Educational Measurement, 30(4), 277–291. https://doi.org/10.1111/j.1745-3984.1993.tb00427.x
- Burton, R. F. (2005). Multiple-choice and true/false tests: Myths and misapprehensions. Assessment & Evaluation in Higher Education, 30(1), 65–72. https://doi.org/10.1080/0260293042003243904
- Frary, R. B. (1988). Formula scoring of multiple-choice tests (correction for guessing). Educational Measurement: Issues and Practice, 7(2), 33–38. https://doi.org/10.1111/j.1745-3992.1988.tb00434.x
- Kanzow, P., Schmidt, D., Herrmann, M., Wassmann, T., Wiegand, A., & Raupach, T. (2023). Use of multiple-select multiple-choice items in a dental undergraduate curriculum: Retrospective study involving the application of different scoring methods. JMIR Medical Education, 9, Article e43792. https://doi.org/10.2196/43792 ● Otwarty dostęp
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- Luskin, R. C., & Bullock, J. G. (2011). “Don't know” means “don't know”: DK responses and the public's level of political knowledge. The Journal of Politics, 73(2), 547–557. https://doi.org/10.1017/s0022381611000132
- Schmidt, D., Raupach, T., Wiegand, A., Herrmann, M., & Kanzow, P. (2021). Relation between examinees’ true knowledge and examination scores: Systematic review and exemplary calculations on Multiple-True-False items. Educational Research Review, 34, Article 100409. https://doi.org/10.1016/j.edurev.2021.100409
- Tsai, F.-J., & Suen, H. K. (1993). A brief report on a comparison of six scoring methods for multiple true-false items. Educational and Psychological Measurement, 53(2), 399–404. https://doi.org/10.1177/0013164493053002008
Cytowania BibTeX
@article{albanese1988multiple, author={Albanese, Mark A. and Sabers, Darrell L.}, title={{Multiple true-false items: A study of interitem correlations, scoring alternatives, and reliability estimation}}, journal={Journal of Educational Measurement}, year={1988}, volume={25}, number={2}, pages={111--123}, doi={10.1111/j.1745-3984.1988.tb00296.x}}@article{budescu1993guess, author={Budescu, David and Bar-Hillel, Maya}, title={{To guess or not to guess: A decision-theoretic view of formula scoring}}, journal={Journal of Educational Measurement}, year={1993}, volume={30}, number={4}, pages={277--291}, doi={10.1111/j.1745-3984.1993.tb00427.x}}@article{burton2005multiple, author={Burton, Richard F.}, title={{Multiple-choice and true/false tests: Myths and misapprehensions}}, journal={Assessment \& Evaluation in Higher Education}, year={2005}, volume={30}, number={1}, pages={65--72}, doi={10.1080/0260293042003243904}}@article{frary1988formula, author={Frary, Robert B.}, title={{Formula scoring of multiple-choice tests (correction for guessing)}}, journal={Educational Measurement: Issues and Practice}, year={1988}, volume={7}, number={2}, pages={33--38}, doi={10.1111/j.1745-3992.1988.tb00434.x}}@article{kanzow2023use, author={Kanzow, Philipp and Schmidt, Dennis and Herrmann, Manfred and Wassmann, Torsten and Wiegand, Annette and Raupach, Tobias}, title={{Use of multiple-select multiple-choice items in a dental undergraduate curriculum: Retrospective study involving the application of different scoring methods}}, journal={JMIR Medical Education}, year={2023}, volume={9}, eid={e43792}, doi={10.2196/43792}}@article{kuder1937theory, author={Kuder, G. F. and Richardson, M. W.}, title={{The theory of the estimation of test reliability}}, journal={Psychometrika}, year={1937}, volume={2}, number={3}, pages={151--160}, doi={10.1007/bf02288391}}@article{luskin2011dont, author={Luskin, Robert C. and Bullock, John G.}, title={{“Don't know” means “don't know”: DK responses and the public's level of political knowledge}}, journal={The Journal of Politics}, year={2011}, volume={73}, number={2}, pages={547--557}, doi={10.1017/s0022381611000132}}@article{schmidt2021relation, author={Schmidt, Dennis and Raupach, Tobias and Wiegand, Annette and Herrmann, Manfred and Kanzow, Philipp}, title={{Relation between examinees’ true knowledge and examination scores: Systematic review and exemplary calculations on Multiple-True-False items}}, journal={Educational Research Review}, year={2021}, volume={34}, eid={100409}, doi={10.1016/j.edurev.2021.100409}}@article{tsai1993brief, author={Tsai, Fu-Ju and Suen, Hoi K.}, title={{A brief report on a comparison of six scoring methods for multiple true-false items}}, journal={Educational and Psychological Measurement}, year={1993}, volume={53}, number={2}, pages={399--404}, doi={10.1177/0013164493053002008}}