Pytania testowe i dystraktory: dlaczego forma pytania zmienia wynik
Test wiedzy w pracy z pielęgniarstwa, położnictwa czy zdrowia publicznego składa się zwykle z kilkunastu pytań z jedną poprawną odpowiedzią i kilkoma błędnymi. Te błędne odpowiedzi to dystraktory. Jeśli są źle napisane, test mierzy nie tylko wiedzę, ale też spryt w rozpoznawaniu wskazówek: która odpowiedź jest najdłuższa, która pasuje gramatycznie, której nie da się obronić. Downing (2005) nazywa to wariancją niezwiązaną z konstruktem: wynik zależy od czegoś, czego test nie miał mierzyć, a to osłabia trafność wniosków.
W czterech egzaminach z nauk podstawowych dla studentów medycyny od 36 do 65% pytań łamało co najmniej jedną zasadę pisania pytań, a pytania wadliwe były o 0–15 punktów procentowych trudniejsze od poprawnych pytań o to samo (Downing, 2005). W dziesięciu testach zaliczeniowych na studiach pielęgniarskich wadliwe było 47.3% pytań; wady nie szkodziły osobom bliskim progu zaliczenia, za to częściej karały najlepszych studentów (Tarrant i Ware, 2008).
Jak zaplanować cały test – cel, tabelę specyfikacji, liczbę pytań, pilotaż – opisujemy we wpisie głównym serii: jak zbudować test wiedzy do pracy z pielęgniarstwa. Tutaj zajmujemy się pojedynczym pytaniem: jak je napisać i jak po pilotażu sprawdzić, czy każda błędna odpowiedź działa. Łatwości pytania i mocy różnicującej nie powtarzamy – są opisane w haśle analiza pozycji testu i w poradniku ankieta wiedzy – analiza krok po kroku.
Budowa pytania: trzon, klucz i dystraktory
Pytanie zamknięte z wyborem odpowiedzi ma trzy części:
- trzon (ang. stem) – pytanie albo niedokończone zdanie, które stawia problem;
- klucz – odpowiedź poprawna, zapisana w kluczu odpowiedzi;
- dystraktory (ang. distractors) – odpowiedzi błędne, ale wiarygodne dla osoby, która nie ma potrzebnej wiedzy.
Klucz i dystraktory razem tworzą kafeterię odpowiedzi. W testach nazywa się je „pytaniami wielokrotnego wyboru” (ang. multiple choice), ale w ankietach ta sama nazwa oznacza pytanie „zaznacz wszystkie, które pasują”. To inny format, z innym kodowaniem – opisujemy go we wpisie o pytaniach wielokrotnego wyboru w ankiecie. Tu chodzi o pytania z jedną najlepszą odpowiedzią.
Dobry dystraktor nie jest „podchwytliwy”. Odpowiada typowemu błędowi albo błędnemu przekonaniu, więc wybierają go osoby bez wiedzy, a omijają osoby z wiedzą. Częsty wybór jednego dystraktora mówi więc, czego dotyczyć powinna edukacja.
Zasady pisania trzonu pytania
Zasad pisania pytań z wyborem odpowiedzi jest dużo: Haladyna i in. (2002) uporządkowali zalecenia z 27 podręczników pomiaru i 27 badań w taksonomię 31 zasad. Poniżej te, które w teście wiedzy do pracy dyplomowej najczęściej decydują o jakości pytania – to kanon powtarzany w podręcznikach pomiaru.
- Jeden problem w jednym pytaniu. Pytanie sprawdza jedną rzecz z tabeli specyfikacji testu. Trzon, który łączy dwie informacje, nie ma dobrej odpowiedzi dla osoby znającej tylko jedną.
- Zakryj odpowiedzi i sprawdź, czy da się odpowiedzieć. Dobry trzon zawiera całe pytanie. „Skala Bradena:” z czterema luźnymi zdaniami do wyboru to w praktyce cztery pytania prawda/fałsz.
- Bez zbędnej treści. Opis przypadku dawaj tylko wtedy, gdy jest potrzebny do odpowiedzi.
- Formułuj pozytywnie. Pytania z „nie” są trudniejsze z powodów językowych. Jeśli przeczenie jest konieczne, wyróżnij je („Który parametr NIE…”). Podwójnego przeczenia nie używaj nigdy.
- Prosty język i terminy znane badanym. W teście dla pacjentów zamień „hipoglikemia” na „za niski poziom cukru we krwi”, jeśli celem nie jest sprawdzenie znajomości terminu. Wywiad poznawczy w pilotażu pokaże, które słowa sprawiają kłopot (wywiad poznawczy krok po kroku).
- Bez sugestii. Trzon nie może podpowiadać odpowiedzi ani oceniać („Czy wiesz, że…”) – to klasyczne pytanie sugerujące.
- Jedna poprawna odpowiedź, co do której zgodzą się eksperci. Jeśli dwie odpowiedzi da się obronić, pytanie trzeba przepisać. Sprawdza to ocena ekspertów – patrz trafność treściowa testu: ocena ekspertów i CVI.
Zasady pisania odpowiedzi i dystraktorów
- Dystraktory z typowych błędów. Najlepsze źródło to błędne odpowiedzi prawdziwych osób: zadaj w pilotażu część pytań jako otwarte i zrób dystraktory z najczęstszych błędów. Warto się do tego przyłożyć: Gierl i in. (2017) zauważają w przeglądzie literatury, że tworzeniu dystraktorów poświęcono znacznie mniej uwagi niż innym zagadnieniom testów wyboru.
- Wszystkie odpowiedzi podobne w formie. Podobna długość i ten sam poziom szczegółowości. Poprawna odpowiedź nie może być najdłuższa ani jedyna „z zastrzeżeniem”.
- Zgodność gramatyczna z trzonem. Po polsku to szczególnie łatwy błąd: trzon kończy się na „służy do oceny:”, a tylko poprawna odpowiedź stoi w dopełniaczu.
- Bez „wszystkie powyższe”. Wystarczy rozpoznać dwie poprawne odpowiedzi, żeby wskazać tę opcję bez znajomości trzeciej. „Żadne z powyższych” stosuj ostrożnie: nie wiesz wtedy, czy osoba zna poprawną odpowiedź, czy tylko odrzuciła błędne.
- Bez słów absolutnych. „Zawsze”, „nigdy”, „wyłącznie” zdradzają dystraktor, bo w praktyce klinicznej prawie nic nie jest bezwarunkowe.
- Odpowiedzi rozłączne. Przedziały liczbowe nie mogą na siebie nachodzić („18–25” i „25–30”), a jedna odpowiedź nie może zawierać drugiej.
- Logiczna kolejność i różne pozycje klucza. Liczby ustaw rosnąco, a położenie poprawnej odpowiedzi rozłóż mniej więcej po równo między A, B, C i D, żeby pozycja niczego nie zdradzała. O tym, że samo miejsce odpowiedzi na liście może wpływać na wybór, przeczytasz w haśle efekt kolejności odpowiedzi.
- „Nie wiem” to nie dystraktor. Tę opcję (odpowiedź „nie wiem”) pokaż w analizie osobno; jak ją punktować, wyjaśnia wpis o punktowaniu testu wiedzy.
Pięć typowych błędów: przykłady źle i lepiej
Przykłady są celowo proste i dotyczą definicji oraz skal, a nie zaleceń terapeutycznych – treść Twojego testu musi wynikać z aktualnych wytycznych i podręczników dla danego obszaru, a jej poprawność potwierdzają eksperci.
| Błąd | Źle | Lepiej |
|---|---|---|
| wskazówka gramatyczna | Skala Glasgow (GCS) służy do oceny: A. stanu świadomości, B. natężenie bólu, C. ryzyko odleżyn | Do oceny czego służy skala Glasgow (GCS)? A. stanu świadomości, B. natężenia bólu, C. ryzyka odleżyn – wszystkie odpowiedzi w tym samym przypadku |
| najdłuższa odpowiedź poprawna | Skala Bradena służy do oceny: A. upadków, B. bólu, C. ryzyka odleżyn na podstawie sześciu czynników, m.in. percepcji czucia, wilgotności skóry i odżywiania | Skala Bradena służy do oceny ryzyka: A. upadków, B. odleżyn, C. niedożywienia – odpowiedzi tej samej długości i z tej samej dziedziny |
| „wszystkie powyższe” | Co należy do podstawowych parametrów życiowych? A. tętno, B. częstość oddechów, C. ciśnienie tętnicze, D. wszystkie powyższe | Który parametr podaje się w mmHg? A. ciśnienie tętnicze, B. tętno, C. częstość oddechów – albo pytanie „zaznacz wszystkie” punktowane według zasad z wpisu o punktowaniu |
| podwójne przeczenie | Która odpowiedź nie jest nieprawidłowym opisem liczby 130 w zapisie 130/85 mmHg? | W zapisie ciśnienia 130/85 mmHg liczba 130 oznacza: A. ciśnienie skurczowe, B. ciśnienie rozkurczowe, C. ciśnienie tętna |
| absurdalne dystraktory i słowa absolutne | Wynik w skali Glasgow wynosi: A. od 3 do 15 punktów, B. zawsze 100 punktów, C. nigdy mniej niż 50 punktów | Jaki jest zakres wyniku w skali Glasgow? A. 3–12, B. 0–15, C. 3–15 – dystraktory to typowe pomyłki (start od zera, inna górna granica), liczby w kolejności |
W ostatnim przykładzie „0–15” wybierze ktoś, kto nie wie, że najniższy wynik to 3, a „3–12” – ktoś, kto pomylił górną granicę. Takie odpowiedzi mówią coś o niepełnej wiedzy; „zawsze 100 punktów” nie mówi nic.
Ile odpowiedzi do wyboru: trzy zamiast czterech?
Zwyczaj każe dawać cztery albo pięć odpowiedzi, a badania wskazują, że to zwykle za dużo. Haladyna i Downing (1993) w danych z trzech programów egzaminacyjnych rzadko znajdowali pytania z więcej niż trzema użytecznymi odpowiedziami. Metaanaliza Rodrigueza (2005), obejmująca 80 lat badań, prowadzi do wniosku, że trzy odpowiedzi są optymalne: w tym samym czasie badani rozwiążą więcej pytań, test lepiej pokryje treść, a właściwości psychometryczne wyników się nie pogorszą.
Studia pielęgniarskie nie są wyjątkiem. W 514 czteroodpowiedziowych pytaniach z testów przygotowanych przez nauczycieli pielęgniarstwa tylko 52.2% dystraktorów działało, a pytanie miało średnio 1.54 działającego dystraktora (Tarrant i in., 2009). Autorzy zalecają tyle odpowiedzi, ile da się napisać wiarygodnych – w większości przypadków trzy.
Praktyczna reguła: napisz tyle dystraktorów, ile masz sensownych typowych błędów, zwykle dwa. Pamiętaj tylko, że przy trzech odpowiedziach szansa trafienia przez zgadywanie wynosi 1/3, a przy czterech 1/4 – jak to uwzględnić w wyniku, opisujemy we wpisie o punktowaniu.
Analiza dystraktorów po pilotażu: co policzyć
Po badaniu pilotażowym masz dla każdego pytania surowe odpowiedzi (A, B, C, D), a nie tylko punkty 0/1. Właśnie z nich zrobisz analizę dystraktorów. Dla każdej opcji każdego pytania policz cztery rzeczy:
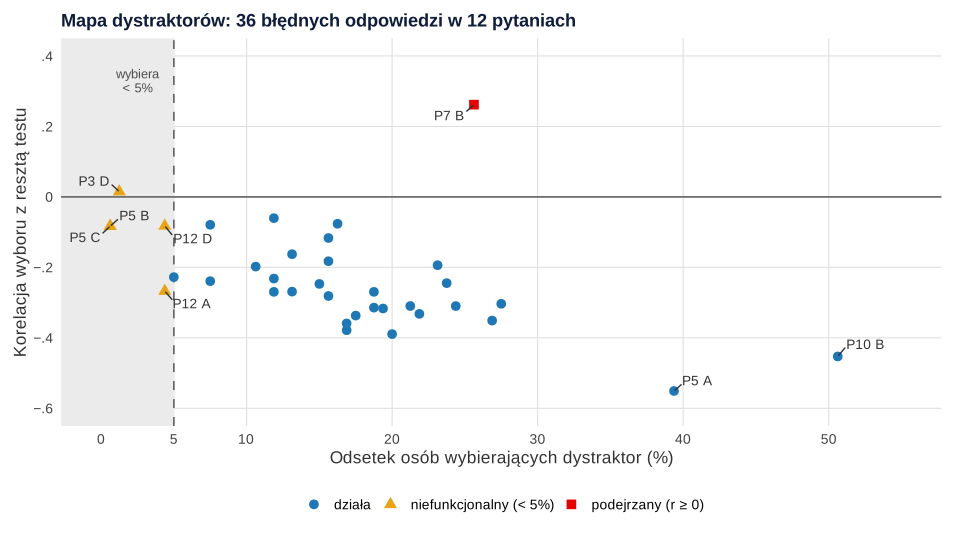
- Odsetek wyboru w całej próbie. Dystraktor, który wybiera mniej niż 5% osób, nazywa się niefunkcjonalnym – nikogo nie „łapie”, więc niczego nie mierzy. Taki próg (mniej niż 5% wyborów) przyjęli Tarrant i in. (2009).
- Odsetek wyboru w grupie dolnej i górnej. Grupy to po 27% osób z najniższym i najwyższym wynikiem testu – podział, który uzasadnił Kelley (1939). Dobry dystraktor częściej wybierają osoby z grupy dolnej.
- Korelację wyboru z wynikiem testu. Zakoduj wybór danej opcji jako 1, pozostałe jako 0 i policz korelację punktowo-dwuseryjną z wynikiem pozostałych pytań (bez pytania, które analizujesz). Dla klucza ma być dodatnia, dla dystraktora – ujemna. Dystraktor z korelacją dodatnią przyciąga lepszych i Tarrant i in. (2009) także zaliczają go do niefunkcjonalnych; my nazywamy go „podejrzanym”, bo często oznacza dwie obronne odpowiedzi albo błąd w kluczu.
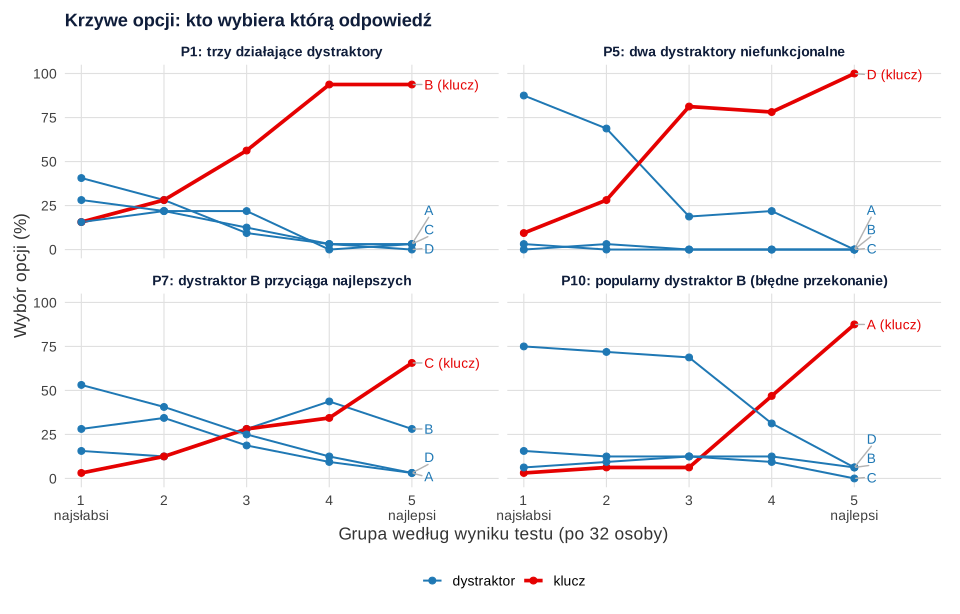
- Krzywe opcji. Podziel badanych na 4–5 grup według wyniku i narysuj, jaki odsetek w każdej grupie wybrał każdą opcję. Krzywa klucza powinna rosnąć, krzywe dystraktorów – opadać.
Modele teorii reagowania na pozycje testowe (IRT) potrafią opisać wybór każdej opcji, ale w pracy dyplomowej wystarczą odsetki i korelacje.
Przykład: 12 pytań, 160 studentów pielęgniarstwa
Test wiedzy z 12 pytań z czterema odpowiedziami (A–D) rozwiązało 160 studentów pielęgniarstwa. Dane są symulowane: każde pytanie ma inny „charakter” – większość działa poprawnie, ale kilka ma typowe wady. Klucz rozłożono równo: po trzy poprawne odpowiedzi na każdej pozycji A, B, C i D. Średni wynik wyniósł 6.06 punktu na 12 (SD = 3.62), a grupy skrajne liczyły po 43 osoby. Liczby pochodzą z kodu na końcu wpisu; dane: test-wiedzy-odpowiedzi-abcd.csv (160 osób, kolumny P1–P12 z literami odpowiedzi).
| Pytanie | Opcja | Wszyscy | Grupa dolna | Grupa górna | r z resztą testu | Ocena |
|---|---|---|---|---|---|---|
| P1 | B (klucz) | 57.5% | 14.0% | 95.3% | .57 | klucz |
| A / C / D | 16.9% / 15.0% / 10.6% | 39.5% / 25.6% / 20.9% | 2.3% / 2.3% / 0.0% | −.36 / −.25 / −.20 | trzy działają | |
| P3 | D | 1.3% | 0.0% | 2.3% | .01 | niefunkcjonalny |
| P5 | A | 39.4% | 81.4% | 4.7% | −.55 | działa |
| B / C | 0.6% / 0.6% | 2.3% / 2.3% | 0.0% / 0.0% | −.08 / −.08 | niefunkcjonalne | |
| P7 | C (klucz) | 28.7% | 4.7% | 55.8% | .36 | klucz |
| B | 25.6% | 11.6% | 34.9% | .26 | podejrzany | |
| P10 | A (klucz) | 30.0% | 4.7% | 74.4% | .58 | klucz |
| B | 50.6% | 74.4% | 11.6% | −.45 | działa (najczęstszy wybór) | |
| D | 11.9% | 14.0% | 14.0% | −.06 | działa, ale prawie nie różnicuje | |
| P12 | C (klucz) | 86.2% | 62.8% | 100.0% | .35 | klucz |
| A / B / D | 4.4% / 5.0% / 4.4% | 14.0% / 16.3% / 7.0% | 0.0% / 0.0% / 0.0% | −.27 / −.23 / −.08 | dwa niefunkcjonalne |
- P1 – tak powinno wyglądać pytanie. Każdy dystraktor wybiera ponad 10% osób, wyraźnie częściej w grupie dolnej, i każdy ma ujemną korelację z resztą testu.
- P3 – jeden dystraktor niefunkcjonalny. Odpowiedź D wybrały 2 osoby na 160 (1.3%). Pytanie działa jak pytanie z trzema odpowiedziami; D zastąp lepszym błędem albo usuń.
- P5 – w praktyce pytanie z dwiema odpowiedziami. B i C wybrała po jednej osobie. Zostaje wybór między kluczem a A, czyli szansa zgadnięcia bliska 50%, a nie 25%. Działający dystraktor A jest za to bardzo dobry: wybrało go 81.4% grupy dolnej i 4.7% górnej.
- P7 – dystraktor, który przyciąga najlepszych. Odpowiedź B wybrało 34.9% grupy górnej i tylko 11.6% dolnej, a korelacja z resztą testu jest dodatnia (r = .26). Na rysunku 1 widać, że w czwartej grupie wyników B (43.75%) wybierano częściej niż klucz (34.38%). Tak wygląda pytanie z dwiema obronnymi odpowiedziami albo z błędem w kluczu.
- P10 – popularny dystraktor to nie wada. Odpowiedź B wybrała połowa badanych (50.6%), więcej niż klucz (30.0%). Ale wybierały ją głównie osoby słabsze (74.4% grupy dolnej, 11.6% górnej), a korelacja jest wyraźnie ujemna (−.45). To dystraktor oparty na rozpowszechnionym błędnym przekonaniu – cenna informacja do dyskusji. Inaczej dystraktor D: wybiera go 14.0% w obu grupach skrajnych (r = −.06). Formalnie działa, ale prawie nie różnicuje.
- P12 – łatwe pytanie, z natury mało błędnych wyborów. Poprawnie odpowiedziało 86.2% osób, więc na dystraktory zostało mniej niż 14% wyborów. A i D spadły poniżej 5% (po 4.4%), B jest dokładnie na progu (5.0%, czyli 8 osób). Tu niefunkcjonalne dystraktory są skutkiem łatwości, nie złego pisania.
Rysunek 2 zbiera wszystkie 36 dystraktorów na jednej mapie. Działające leżą w prawej dolnej części: wybiera je co najmniej 5% osób i mają ujemną korelację z resztą testu. W szarym pasie po lewej są niefunkcjonalne, a nad poziomą linią zera – podejrzane. W naszym teście działało 30 z 36 dystraktorów (83.3%), średnio 2.5 na pytanie; osiem pytań miało trzy działające dystraktory, dwa – dwa (P3, P7) i dwa – jeden (P5, P12).
Ile osób potrzeba do analizy dystraktorów
Pilotaż w pracy dyplomowej bywa mały – kilkadziesiąt osób. Do sprawdzenia zrozumiałości pytań to wystarczy, do analizy dystraktorów – zwykle nie. Próg 5% przy 30 osobach to różnica między jedną a dwiema osobami, a grupa skrajna 27% liczy 8 osób. Rachunek z rozkładu dwumianowego pokazuje skalę problemu:
| n | Grupa skrajna 27% | Dystraktor wybierany naprawdę przez 8% wygląda na niefunkcjonalny | Dystraktor wybierany naprawdę przez 2% wygląda na działający |
|---|---|---|---|
| 30 | 8 | .296 | .121 |
| 60 | 16 | .132 | .119 |
| 100 | 27 | .090 | .051 |
| 160 | 43 | .053 | .016 |
| 300 | 81 | .016 | .001 |
Przy 30 osobach prawie co trzeci przyzwoity dystraktor (8% wyborów w populacji) wypadnie poniżej 5%. Ten sam odsetek z próby jest też bardzo niepewny: 2 wybory na 30 osób to 6.7%, 95% CI [1.8, 21.3], a 11 na 160 to 6.9%, 95% CI [3.9, 11.9] (przedział Wilsona – zob. przedział ufności dla proporcji). W małym pilotażu traktuj więc analizę dystraktorów jako wskazówkę, a nie wyrok; pełną analizę zrób na danych z badania głównego.
Co zrobić z wynikami: poprawić, usunąć, zostawić
| Co widzisz | Możliwa przyczyna | Co zrobić |
|---|---|---|
| dystraktor < 5% | odpowiedź absurdalna albo pytanie bardzo łatwe | zastąp typowym błędem z pilotażu albo usuń (pytanie z trzema odpowiedziami jest w porządku) |
| dystraktor z dodatnią korelacją | dwie obronne odpowiedzi, błąd w kluczu, niejasny trzon | sprawdź klucz, pokaż pytanie ekspertom, przepisz; nie zmieniaj klucza tylko dlatego, że „tak wyszło w danych” |
| dystraktor wybierany po równo w obu grupach | odpowiedź zgadywana losowo albo niezrozumiała | przeczytaj ją z kilkoma osobami z grupy docelowej (wywiad poznawczy) |
| dystraktor częstszy niż klucz, ale z ujemną korelacją | rozpowszechnione błędne przekonanie | zostaw; opisz w wynikach jako lukę w wiedzy |
| prawie wszyscy wybierają klucz | pytanie o podstawy, bardzo łatwe | zostaw, jeśli tak miało być według tabeli specyfikacji; inaczej utrudnij dystraktory |
Po każdej zmianie przelicz wynik testu i rzetelność (KR-20). Decyzję uzasadnij treścią pytania, a nie tylko liczbą; zmiany po badaniu głównym opisz w pracy. Jaki wynik oznacza „dobrą wiedzę”, wyjaśnia wpis o progu dobrej wiedzy i metodzie Angoffa.
Jak opisać pisanie pytań i analizę dystraktorów w pracy
W rozdziale metodologicznym opisz, jak powstały pytania i jak je sprawdzano. Wzór dla autorskiego testu:
W wynikach (albo w podrozdziale o właściwościach narzędzia) podaj liczby z analizy:
Zdanie o przeformułowaniu pytania 7 to przykład – wpisz to, co naprawdę zrobiłeś(-aś). Jeśli przy analizie albo opisie potrzebujesz kogoś, kto sprawdzi obliczenia i wyjaśni wyniki, zobacz pomoc w analizie dla studentów.
Najczęstsze błędy
- Dystraktory „dla żartu”. Odpowiedź, której nikt nie wybierze, zamienia pytanie z czterema odpowiedziami w pytanie z trzema albo dwiema – i zwiększa szansę zgadnięcia.
- Poprawna odpowiedź najdłuższa i najdokładniejsza. Autor pilnuje, żeby klucz był bezbłędny, i dopisuje zastrzeżenia, a dystraktory zostawia krótkie.
- Usuwanie pytania po pilotażu na 30 osobach. Przy tak małej próbie jedna osoba zmienia ocenę dystraktora.
- Zmiana klucza „pod dane”. Dodatnia korelacja dystraktora to sygnał do sprawdzenia, a nie dowód, że to on jest poprawny.
- W bazie tylko punkty 0/1. Bez liter odpowiedzi nie zrobisz analizy dystraktorów – zapisuj literę, a punkty licz z klucza.
Analiza dystraktorów w R: kod i wynik
Pierwszy przepis tworzy dane przykładu (160 osób, 12 pytań A–D), zapisuje je w pliku CSV w folderze nadrzędnym (../), punktuje test według klucza i dla każdej odpowiedzi liczy odsetek wyboru w całej próbie i w grupach skrajnych 27% oraz korelację wyboru z wynikiem pozostałych pytań. Jeśli masz własne dane, wczytaj je read.csv() do macierzy odp z literami odpowiedzi, wpisz swój klucz i uruchom kod od części 2. Drugi przepis liczy tabelę o liczebności próby z rozkładu dwumianowego. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane przykładu: test-wiedzy-odpowiedzi-abcd.csv.
Analiza dystraktorów: odsetki, grupy skrajne 27% i korelacja z resztą testu
R
# B420 – analiza dystraktorów w teście wiedzy (dane symulowane)
# 160 studentów pielęgniarstwa, 12 pytań jednokrotnego wyboru z opcjami A–D.
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b420-1-analiza-dystraktorow.R > b420-1-analiza-dystraktorow-wynik.txt

# 1. Dane symulowane: model odpowiedzi nominalnych – im większa wiedza (theta),
#    tym częściej poprawna odpowiedź; każdy dystraktor ma własną „atrakcyjność”.
set.seed(420)
N <- 160
theta <- rnorm(N)
klucz <- c(P1 = "B", P2 = "D", P3 = "A", P4 = "C", P5 = "D", P6 = "A",
           P7 = "C", P8 = "B", P9 = "D", P10 = "A", P11 = "B", P12 = "C")
# Parametry: nachylenie (a) i wyraz wolny (c) dla klucza i trzech dystraktorów
typowe <- list(a = c(1.5, -0.5, -0.5, -0.5), c = c(1.3, 0.0, -0.3, -0.6))
param <- rep(list(typowe), 12); names(param) <- names(klucz)
param$P2  <- list(a = c(1.3, -0.4, -0.6, -0.4), c = c(0.6, 0.1, -0.2, -0.4))
param$P3  <- list(a = c(1.5, -0.5, -0.5, -0.5), c = c(1.2, 0.2, -0.2, -3.5))   # jeden dystraktor „dla nikogo”
param$P5  <- list(a = c(1.5, -0.5, -0.5, -0.5), c = c(1.0, 0.3, -3.5, -3.8))   # dwa dystraktory „dla nikogo”
param$P7  <- list(a = c(1.2, -0.6, 1.0, -0.6), c = c(0.4, -0.4, 0.3, -0.5))    # dystraktor częściowo poprawny
param$P9  <- list(a = c(1.6, -0.4, -0.6, -0.7), c = c(0.4, 0.1, 0.0, -0.3))
param$P10 <- list(a = c(1.6, -1.1, -0.6, -0.6), c = c(0.2, 0.9, -0.4, -0.6)) # błędne przekonanie
param$P12 <- list(a = c(1.4, -0.5, -0.5, -0.5), c = c(4.0, 0.2, 0.0, -0.3))   # bardzo łatwe pytanie
opcje <- c("A", "B", "C", "D")
odp <- sapply(names(klucz), function(j) {
  kolej <- c(klucz[j], setdiff(opcje, klucz[j]))   # klucz, potem dystraktory w kolejności liter
  eta <- outer(theta, param[[j]]$a) + matrix(param[[j]]$c, N, 4, byrow = TRUE)
  pr <- exp(eta) / rowSums(exp(eta))
  apply(pr, 1, function(p) sample(kolej, 1, prob = p))
})
dane <- data.frame(id = 1:N, odp)
write.csv(dane, "../test-wiedzy-odpowiedzi-abcd.csv", row.names = FALSE)

# 2. Punktacja i wynik testu
pkt <- sweep(odp, 2, klucz, "==") * 1
wynik <- rowSums(pkt)
cat("Wynik testu (0-12): M =", round(mean(wynik), 2), " SD =", round(sd(wynik), 2), "\n")
cat("Klucz – liczba poprawnych odpowiedzi na każdej pozycji A-D:\n"); print(table(klucz))

# 3. Analiza dystraktorów: odsetki w całej próbie i w grupach skrajnych 27%,
#    korelacja wyboru opcji z wynikiem pozostałych pytań (reszta testu)
n27 <- round(0.27 * N)
kolejnosc <- order(wynik, decreasing = TRUE)        # remisy na granicy: kolejność wierszy
gorna <- kolejnosc[1:n27]; dolna <- rev(kolejnosc)[1:n27]
analiza_opcji <- function(j) {
  reszta <- wynik - pkt[, j]
  do.call(rbind, lapply(opcje, function(k) {
    wybor <- as.numeric(odp[, j] == k)
    r <- if (sd(wybor) > 0) cor(wybor, reszta) else NA
    data.frame(pytanie = j, opcja = k, klucz = k == klucz[j],
               proc = 100 * mean(wybor), dolna = 100 * mean(wybor[dolna]),
               gorna = 100 * mean(wybor[gorna]), r_reszta = r)
  }))
}
tab <- do.call(rbind, lapply(names(klucz), analiza_opcji))
tab$ocena <- ifelse(tab$klucz, "klucz",
              ifelse(tab$proc < 5 - 1e-9, "niefunkcjonalny (<5%)",
              ifelse(tab$r_reszta >= 0, "podejrzany (r >= 0)", "działa")))
cat("\nGrupy skrajne po 27%:", n27, "osób\n")
cat("\nANALIZA OPCJI – wybrane pytania (odsetki w %)\n")
pokaz <- tab[tab$pytanie %in% c("P1", "P3", "P5", "P7", "P10", "P12"), ]
pokaz[, 4:6] <- round(pokaz[, 4:6], 1); pokaz$r_reszta <- round(pokaz$r_reszta, 2)
print(pokaz[, c("pytanie", "opcja", "klucz", "proc", "dolna", "gorna", "r_reszta", "ocena")], row.names = FALSE)

# 4. Podsumowanie dla wszystkich 12 pytań
dys <- tab[!tab$klucz, ]
podsum <- data.frame(
  pytanie = names(klucz),
  latwosc = round(100 * colMeans(pkt), 1),
  dzialajace = sapply(names(klucz), function(j) sum(dys$pytanie == j & dys$ocena == "działa")),
  niefunkcjonalne = sapply(names(klucz), function(j) sum(dys$pytanie == j & dys$ocena == "niefunkcjonalny (<5%)")),
  podejrzane = sapply(names(klucz), function(j) sum(dys$pytanie == j & dys$ocena == "podejrzany (r >= 0)")))
cat("\nPODSUMOWANIE: liczba dystraktorów według oceny\n")
print(podsum, row.names = FALSE)
cat("\nDystraktory działające:", sum(dys$ocena == "działa"), "z", nrow(dys),
    sprintf("(%.1f%%)", 100 * mean(dys$ocena == "działa")), "\n")
cat("Średnio działających dystraktorów na pytanie:", round(mean(podsum$dzialajace), 2), "\n")
cat("Pytania z 0, 1, 2, 3 działającymi dystraktorami:\n"); print(table(factor(podsum$dzialajace, levels = 0:3)))
write.csv(tab, "b420-tabela-opcji.csv", row.names = FALSE)
Wynik w R
Wynik testu (0-12): M = 6.06  SD = 3.62
Klucz – liczba poprawnych odpowiedzi na każdej pozycji A-D:
klucz
A B C D
3 3 3 3

Grupy skrajne po 27%: 43 osób

ANALIZA OPCJI – wybrane pytania (odsetki w %)
 pytanie opcja klucz proc dolna gorna r_reszta                 ocena
      P1     A FALSE 16.9  39.5   2.3    -0.36                działa
      P1     B  TRUE 57.5  14.0  95.3     0.57                 klucz
      P1     C FALSE 15.0  25.6   2.3    -0.25                działa
      P1     D FALSE 10.6  20.9   0.0    -0.20                działa
      P3     A  TRUE 49.4   7.0  83.7     0.54                 klucz
      P3     B FALSE 27.5  46.5   9.3    -0.30                działa
      P3     C FALSE 21.9  46.5   4.7    -0.33                działa
      P3     D FALSE  1.3   0.0   2.3     0.01 niefunkcjonalny (<5%)
      P5     A FALSE 39.4  81.4   4.7    -0.55                działa
      P5     B FALSE  0.6   2.3   0.0    -0.08 niefunkcjonalny (<5%)
      P5     C FALSE  0.6   2.3   0.0    -0.08 niefunkcjonalny (<5%)
      P5     D  TRUE 59.4  14.0  95.3     0.57                 klucz
      P7     A FALSE 18.8  37.2   2.3    -0.31                działa
      P7     B FALSE 25.6  11.6  34.9     0.26   podejrzany (r >= 0)
      P7     C  TRUE 28.7   4.7  55.8     0.36                 klucz
      P7     D FALSE 26.9  46.5   7.0    -0.35                działa
     P10     A  TRUE 30.0   4.7  74.4     0.58                 klucz
     P10     B FALSE 50.6  74.4  11.6    -0.45                działa
     P10     C FALSE  7.5   7.0   0.0    -0.08                działa
     P10     D FALSE 11.9  14.0  14.0    -0.06                działa
     P12     A FALSE  4.4  14.0   0.0    -0.27 niefunkcjonalny (<5%)
     P12     B FALSE  5.0  16.3   0.0    -0.23                działa
     P12     C  TRUE 86.2  62.8 100.0     0.35                 klucz
     P12     D FALSE  4.4   7.0   0.0    -0.08 niefunkcjonalny (<5%)

PODSUMOWANIE: liczba dystraktorów według oceny
 pytanie latwosc dzialajace niefunkcjonalne podejrzane
      P1    57.5          3               0          0
      P2    36.2          3               0          0
      P3    49.4          2               1          0
      P4    54.4          3               0          0
      P5    59.4          1               2          0
      P6    53.8          3               0          0
      P7    28.7          2               0          1
      P8    51.2          3               0          0
      P9    40.6          3               0          0
     P10    30.0          3               0          0
     P11    58.1          3               0          0
     P12    86.2          1               2          0

Dystraktory działające: 30 z 36 (83.3%)
Średnio działających dystraktorów na pytanie: 2.5
Pytania z 0, 1, 2, 3 działającymi dystraktorami:

0 1 2 3
0 2 2 8
Czy próg 5% da się ocenić w małej próbie?
R
# B420 – czy próg 5% da się ocenić w małym pilotażu? (rozkład dwumianowy, bez losowania)
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b420-2-ile-osob.R > b420-2-ile-osob-wynik.txt
n <- c(30, 60, 100, 160, 300)
# Liczba wyborów poniżej progu 5%: mniej niż 0.05 * n osób
prog <- ceiling(0.05 * n) - 1                       # największa liczba wyborów, która daje < 5%
tab <- data.frame(
  n = n,
  grupa_27 = round(0.27 * n),                       # liczebność grupy dolnej i górnej
  P_wyglada_na_martwy_gdy_8 = round(pbinom(prog, n, 0.08), 3),   # prawdziwy odsetek 8%
  P_wyglada_na_dzialajacy_gdy_2 = round(1 - pbinom(prog, n, 0.02), 3))  # prawdziwy odsetek 2%
print(tab, row.names = FALSE)
# 95% przedział Wilsona dla 2 wyborów na 30 osób (6.7%) i 11 wyborów na 160 osób (6.9%)
wilson <- function(x, n) round(100 * prop.test(x, n, correct = FALSE)$conf.int[1:2], 1)
cat("2/30:", round(100 * 2 / 30, 1), "% , 95% CI", wilson(2, 30), "\n")
cat("11/160:", round(100 * 11 / 160, 1), "% , 95% CI", wilson(11, 160), "\n")
Wynik w R
   n grupa_27 P_wyglada_na_martwy_gdy_8 P_wyglada_na_dzialajacy_gdy_2
  30        8                     0.296                         0.121
  60       16                     0.132                         0.119
 100       27                     0.090                         0.051
 160       43                     0.053                         0.016
 300       81                     0.016                         0.001
2/30: 6.7 % , 95% CI 1.8 21.3
11/160: 6.9 % , 95% CI 3.9 11.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów stats i utils); rysunki przygotowano w pakietach ggplot2, ggrepel i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed pilotażem sprawdź każde pytanie
- Czy pytanie dotyczy jednego zagadnienia z tabeli specyfikacji?
- Czy da się na nie odpowiedzieć po zakryciu odpowiedzi?
- Czy trzon jest pozytywny, a odpowiedzi pasują do niego gramatycznie i mają podobną długość?
- Czy każdy dystraktor to typowy błąd, który ktoś naprawdę mógłby popełnić?
- Czy nie ma „wszystkie powyższe”, słów „zawsze” i „nigdy” ani nachodzących na siebie przedziałów?
- Czy eksperci zgadzają się co do klucza, a poprawne odpowiedzi są rozłożone równo między pozycje?
- Czy baza danych zapisze literę odpowiedzi, a nie tylko punkt?
Najczęstsze pytania
Co to jest dystraktor w pytaniu testowym?
Dystraktor to błędna odpowiedź w pytaniu zamkniętym, która ma wyglądać wiarygodnie dla osoby bez potrzebnej wiedzy. Dobry dystraktor opiera się na typowym błędzie albo błędnym przekonaniu, więc częściej wybierają go osoby o niższym wyniku testu. Odpowiedź, której nikt nie wybiera, niczego nie mierzy i tylko wydłuża pytanie.
Ile odpowiedzi do wyboru powinno mieć pytanie testowe?
Zwykle trzy: poprawną i dwa dobre dystraktory. Metaanaliza Rodrigueza (2005) wskazuje, że przy trzech odpowiedziach można w tym samym czasie zadać więcej pytań bez pogorszenia właściwości wyników, a w testach na studiach pielęgniarskich pytania z czterema odpowiedziami miały średnio tylko 1.54 działającego dystraktora (Tarrant i in., 2009). Kolejną odpowiedź dodawaj tylko wtedy, gdy masz następny wiarygodny błąd.
Kiedy dystraktor jest niefunkcjonalny?
Najczęściej wtedy, gdy wybiera go mniej niż 5% badanych; Tarrant i in. (2009) zaliczali do niefunkcjonalnych także dystraktory częściej wybierane przez osoby z wyższym wynikiem. W małej próbie ta ocena jest niepewna: przy 30 osobach dystraktor wybierany naprawdę przez 8% ludzi wypadnie poniżej progu 5% z prawdopodobieństwem .296.
Dlaczego w teście nie stosować odpowiedzi „wszystkie powyższe”?
Bo podpowiada: wystarczy rozpoznać dwie poprawne odpowiedzi, żeby wybrać „wszystkie powyższe” bez znajomości trzeciej. Jeśli kilka odpowiedzi jest poprawnych, zapytaj o jedną najlepszą albo użyj formatu „zaznacz wszystkie, które pasują” i punktuj każdą opcję osobno, jak opisujemy we wpisie o punktowaniu testu wiedzy.
Co oznacza dodatnia korelacja dystraktora z wynikiem testu?
Że ten błędny wybór częściej robią osoby z wyższym wynikiem. Najczęstsze przyczyny to dwie obronne odpowiedzi, niejasny trzon albo błąd w kluczu. Sprawdź klucz, pokaż pytanie ekspertom i przepisz je – nie zmieniaj klucza tylko dlatego, że tak wyszło w danych.
Powiązane hasła
Przeczytaj też
Jak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikPunktowanie testu wiedzy: „nie wiem” i zgadywanie
„Nie wiem” jako 0 czy brak, poprawka na zgadywanie, próg dla prawda/fałsz i punkty częściowe za kilka poprawnych odpowiedzi – na symulacji w R.
Czytaj →PoradnikTrafność treściowa testu wiedzy
Ocena ekspertów dla testu wiedzy: I-CVI, CVR z wartościami krytycznymi, klucz, tabela specyfikacji i druga runda – przykład w R z gotowym opisem.
Czytaj →Budujesz test wiedzy do pracy i nie wiesz, czy pytania działają?
Przejrzymy z Tobą analizę pytań i dystraktorów po pilotażu, policzymy rzetelność w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Downing, S. M. (2005). The effects of violating standard item writing principles on tests and students: The consequences of using flawed test items on achievement examinations in medical education. Advances in Health Sciences Education, 10(2), 133–143. https://doi.org/10.1007/s10459-004-4019-5
- Gierl, M. J., Bulut, O., Guo, Q., & Zhang, X. (2017). Developing, analyzing, and using distractors for multiple-choice tests in education: A comprehensive review. Review of Educational Research, 87(6), 1082–1116. https://doi.org/10.3102/0034654317726529
- Haladyna, T. M., & Downing, S. M. (1993). How many options is enough for a multiple-choice test item? Educational and Psychological Measurement, 53(4), 999–1010. https://doi.org/10.1177/0013164493053004013
- Haladyna, T. M., Downing, S. M., & Rodriguez, M. C. (2002). A review of multiple-choice item-writing guidelines for classroom assessment. Applied Measurement in Education, 15(3), 309–333. https://doi.org/10.1207/s15324818ame1503_5
- Kelley, T. L. (1939). The selection of upper and lower groups for the validation of test items. Journal of Educational Psychology, 30(1), 17–24. https://doi.org/10.1037/h0057123
- Rodriguez, M. C. (2005). Three options are optimal for multiple-choice items: A meta-analysis of 80 years of research. Educational Measurement: Issues and Practice, 24(2), 3–13. https://doi.org/10.1111/j.1745-3992.2005.00006.x
- Tarrant, M., & Ware, J. (2008). Impact of item-writing flaws in multiple-choice questions on student achievement in high-stakes nursing assessments. Medical Education, 42(2), 198–206. https://doi.org/10.1111/j.1365-2923.2007.02957.x
- Tarrant, M., Ware, J., & Mohammed, A. M. (2009). An assessment of functioning and non-functioning distractors in multiple-choice questions: A descriptive analysis. BMC Medical Education, 9(1), Article 40. https://doi.org/10.1186/1472-6920-9-40 ● Otwarty dostęp
Cytowania BibTeX
@article{downing2005effects, author={Downing, Steven M.}, title={{The effects of violating standard item writing principles on tests and students: The consequences of using flawed test items on achievement examinations in medical education}}, journal={Advances in Health Sciences Education}, year={2005}, volume={10}, number={2}, pages={133--143}, doi={10.1007/s10459-004-4019-5}}@article{gierl2017developing, author={Gierl, Mark J. and Bulut, Okan and Guo, Qi and Zhang, Xinxin}, title={{Developing, analyzing, and using distractors for multiple-choice tests in education: A comprehensive review}}, journal={Review of Educational Research}, year={2017}, volume={87}, number={6}, pages={1082--1116}, doi={10.3102/0034654317726529}}@article{haladyna1993how, author={Haladyna, Thomas M. and Downing, Steven M.}, title={{How many options is enough for a multiple-choice test item?}}, journal={Educational and Psychological Measurement}, year={1993}, volume={53}, number={4}, pages={999--1010}, doi={10.1177/0013164493053004013}}@article{haladyna2002review, author={Haladyna, Thomas M. and Downing, Steven M. and Rodriguez, Michael C.}, title={{A review of multiple-choice item-writing guidelines for classroom assessment}}, journal={Applied Measurement in Education}, year={2002}, volume={15}, number={3}, pages={309--333}, doi={10.1207/s15324818ame1503_5}}@article{kelley1939selection, author={Kelley, Truman L.}, title={{The selection of upper and lower groups for the validation of test items}}, journal={Journal of Educational Psychology}, year={1939}, volume={30}, number={1}, pages={17--24}, doi={10.1037/h0057123}}@article{rodriguez2005three, author={Rodriguez, Michael C.}, title={{Three options are optimal for multiple-choice items: A meta-analysis of 80 years of research}}, journal={Educational Measurement: Issues and Practice}, year={2005}, volume={24}, number={2}, pages={3--13}, doi={10.1111/j.1745-3992.2005.00006.x}}@article{tarrant2008impact, author={Tarrant, Marie and Ware, James}, title={{Impact of item-writing flaws in multiple-choice questions on student achievement in high-stakes nursing assessments}}, journal={Medical Education}, year={2008}, volume={42}, number={2}, pages={198--206}, doi={10.1111/j.1365-2923.2007.02957.x}}@article{tarrant2009assessment, author={Tarrant, Marie and Ware, James and Mohammed, Ahmed M.}, title={{An assessment of functioning and non-functioning distractors in multiple-choice questions: A descriptive analysis}}, journal={BMC Medical Education}, year={2009}, volume={9}, number={1}, eid={40}, doi={10.1186/1472-6920-9-40}}