Trafność treściowa testu wiedzy: o co pytasz ekspertów
Własny test wiedzy do pracy z pielęgniarstwa, położnictwa czy zdrowia publicznego ma zwykle tabelę specyfikacji: obszary treści, poziomy wymagań i liczbę pytań w każdym polu. Jak ją przygotować, opisuje wpis jak zbudować test wiedzy krok po kroku. Zanim test trafi do pilotażu, trzeba sprawdzić, czy pytania naprawdę realizują ten plan. To jest ocena trafności treściowej, a jej podstawowe wskaźniki (I-CVI i S-CVI) wyjaśnia hasło trafność treściowa (CVI).
Downing (2003) przypomina, że w edukacji medycznej każdy test wymaga dowodów trafności z kilku źródeł, a treść testu jest jednym z nich. Trafny albo nietrafny nie jest sam test, tylko konkretna interpretacja wyniku, np. „osoba ma dobrą wiedzę o profilaktyce upadków”. Ocena ekspertów to dowód z treści. Pozostałe źródła porządkuje wpis rodzaje trafności – mapa dowodów.
Przy skali postaw eksperci oceniają głównie, czy pozycja pasuje do konstruktu. Pytanie testowe ma jeszcze poprawną odpowiedź i miejsce w tabeli specyfikacji, dlatego tu każde pytanie przechodzi przez pięć kryteriów:
- Trafność: czy pytanie dotyczy wiedzy, którą test ma mierzyć (I-CVI).
- Niezbędność: czy ta wiedza jest niezbędna, czy tylko przydatna (CVR Lawshe'a).
- Jasność: czy osoba z grupy docelowej zrozumie treść pytania i odpowiedzi.
- Klucz: czy zaznaczona odpowiedź jest jedyną poprawną według aktualnej wiedzy.
- Obszar: do którego obszaru tabeli specyfikacji ekspert przypisuje pytanie, gdy nie widzi Twojego przypisania.
Do tego dochodzi ocena kompletności całych obszarów. Almanasreh i in. (2019) opisują ocenę trafności treściowej jako proces w trzech etapach: opracowanie narzędzia, ocena ekspertów z ilościowym podsumowaniem oraz poprawki i przebudowa. Ten wpis prowadzi przez dwa ostatnie. Przegląd ekspercki skal i kwestionariuszy (lista QAS-99, zgodność ekspertów, paradoks kappy) omawia wpis ocena ekspercka kwestionariusza.
Kogo zaprosić i ilu ekspertów
Ekspertem od treści testu wiedzy dla pielęgniarek czy pacjentów jest osoba, która tę wiedzę stosuje albo jej uczy: pielęgniarka z doświadczeniem w danym obszarze opieki, dydaktyk przedmiotu, czasem przedstawiciel innego zawodu (fizjoterapeuta, dietetyk, ratownik). Przy teście dla pacjentów dodaj osobę, która prowadzi edukację pacjentów. W pracy opisujesz kwalifikacje, nie nazwiska.
Grant i Davis (1997) zwracają uwagę, że błędy w ocenie trafności treściowej biorą się z nieprzemyślanego doboru ekspertów i ich słabego przygotowania. W teście wiedzy oznacza to jedno: każdy ekspert musi dostać cel testu, opis grupy docelowej i tabelę specyfikacji z definicjami obszarów i poziomów. Bez tego nie oceni, czy pytanie jest niezbędne ani do którego obszaru należy.
Liczba. Polit i in. (2007) proponują próg I-CVI ≥ .78 przy co najmniej trzech ekspertach. W pracy dyplomowej celuj w 5–8 osób. Pamiętaj jednak, że przy małym panelu każda ocena mocno zmienia wynik. Przy sześciu ekspertach I-CVI może przyjąć tylko siedem wartości (0, .17, .33, .50, .67, .83, 1.00), a współczynnik CVR wymaga wtedy jednomyślności, co pokazujemy niżej. Jeśli chcesz, by eksperci doszli do wspólnego stanowiska w kilku rundach z informacją zwrotną, sięgnij po metodę delficką i zdefiniuj z góry konsensus ekspertów.
Formularz oceny: pięć pytań o każde pytanie testu
Formularz przygotuj jako arkusz albo ankietę online z tym samym blokiem ocen przy każdym pytaniu. Pytania pokaż z zaznaczoną odpowiedzią poprawną, ale bez informacji, do którego obszaru je przypisałeś. Inaczej sprawdzisz tylko, czy eksperci zgadzają się z Twoją etykietą.
| Kryterium | Pytanie do eksperta | Skala | Wskaźnik i próg w przykładzie |
|---|---|---|---|
| Trafność | Na ile pytanie dotyczy wiedzy opisanej w celu testu? | 1 – nietrafne, 2 – wymaga dużych zmian, 3 – trafne, wymaga drobnych zmian, 4 – trafne | I-CVI (odsetek ocen 3–4) ≥ .78 |
| Niezbędność | Czy ta wiedza jest niezbędna dla osoby z grupy docelowej? | niezbędna / przydatna, ale nie niezbędna / zbędna | CVR ≥ wartość krytyczna (przy 6 ekspertach 1.00); przy niższym pytanie zostaje, ale jest pierwszym kandydatem do wymiany |
| Jasność | Czy treść pytania i odpowiedzi jest zrozumiała dla grupy docelowej? | 1–4 | odsetek ocen 3–4 ≥ .78 |
| Klucz | Czy zaznaczona odpowiedź jest jedyną poprawną? | tak / nie + komentarz | mniej niż 2 ekspertów odpowiada „nie” |
| Obszar | Do którego obszaru tabeli specyfikacji należy pytanie? | wybór jednego obszaru (A–D) | co najmniej 4 z 6 ekspertów wskazuje obszar zamierzony |
Pytanie może być trafne, niezbędne i jasne, a mimo to mieć dwie odpowiedzi, których da się bronić, albo odpowiedź poprawną według starszych zaleceń. Takie pytanie zaniży wynik osób o najlepszej wiedzy i wypadnie źle dopiero w analizie pozycji po pilotażu. Szerzej o konstrukcji klucza odpowiedzi i dystraktorów piszemy we wpisie jak pisać pytania testowe i dystraktory.
Na końcu formularza dodaj ocenę całych obszarów: „Czy pytania z obszaru D wystarczająco pokrywają ten obszar? Jeśli nie, czego brakuje?”. To jedyne miejsce, w którym eksperci mogą zgłosić lukę, czyli brak pytania, a nie wadę istniejącego.
I-CVI, S-CVI i kappa zmodyfikowana w skrócie
Ilościowe ujęcie trafności treściowej przez oceny ekspertów ma w naukach o zdrowiu długą tradycję (Lynn, 1986). I-CVI to odsetek ekspertów, którzy dali pytaniu ocenę 3 lub 4. S-CVI/Ave to średnia I-CVI wszystkich pytań, a S-CVI/UA – odsetek pytań ocenionych na 3–4 przez wszystkich ekspertów. Polit i Beck (2006) pokazali, że autorzy często nie piszą, którą wersję S-CVI policzyli, choć obie dają inne wartości. Podawaj więc obie z nazwą. Polit i in. (2007) przeliczyli I-CVI na kappę zmodyfikowaną (κ*), która uwzględnia zgodę przypadkową:
Tu N to liczba ekspertów, a A – liczba ocen 3–4. Przy sześciu ekspertach pięć ocen „trafne” daje I-CVI = .83 i κ* = .82, a sześć – I-CVI = 1.00 i κ* = 1.00. Więcej o samym wskaźniku i jego progach mówi hasło o CVI, a o miarach zgodności ekspertów – wpis zgodność sędziów: kappa, ICC i alfa Krippendorffa.
I-CVI z sześciu ocen to odsetek z bardzo małej próby. Jeśli potraktować ekspertów jak próbę z większej grupy podobnych specjalistów, 95% przedział ufności Wilsona dla I-CVI = .83 (5 z 6) wynosi [.44, .97], a dla I-CVI = 1.00 – [.61, 1.00]. Próg .78 odsiewa więc pytania wyraźnie złe, ale nie odróżni pewnie dobrego od przeciętnego.
CVR Lawshe'a i wartości krytyczne z rozkładu dwumianowego
Współczynnik CVR (ang. content validity ratio) zaproponował Lawshe (1975) jako ilościowy sposób oceny, czy pozycja testu jest niezbędna. Ekspert wybiera jedną z trzech odpowiedzi: „niezbędna”, „przydatna, ale nie niezbędna” albo „zbędna”, a CVR liczy się z liczby odpowiedzi „niezbędna” (ne):
CVR przyjmuje wartości od −1 do 1, a 0 oznacza, że za niezbędną uznała pytanie dokładnie połowa panelu. Definicję i prosty przykład znajdziesz w haśle współczynnik CVR Lawshe'a. Tu ważniejsza jest wartość krytyczna, czyli najmniejszy CVR, przy którym zgoda ekspertów jest większa, niż dałby przypadek.
Lawshe podał tabelę takich wartości, ale Ayre i Scally (2014) zauważyli, że nigdy nie opisano, jak je policzono. Zaproponowali obliczanie wartości krytycznych z dokładnych prawdopodobieństw rozkładu dwumianowego. Wcześniej Wilson i in. (2012) przeliczyli i rozszerzyli tabelę dla kolejnych liczebności panelu i kilku poziomów alfa. Zamiast przepisywać tabele z drugiej ręki, policz wartość krytyczną sam: przy hipotezie zerowej każdy ekspert wybiera „niezbędna” z prawdopodobieństwem 0.5, a szukasz najmniejszej liczby głosów, której prawdopodobieństwo w teście jednostronnym nie przekracza .05.
| Liczba ekspertów N | Najmniej głosów „niezbędna” | p jednostronne | CVR krytyczny | Najmniej ocen 3–4 dla I-CVI ≥ .78 |
|---|---|---|---|---|
| 5 | 5 | .031 | 1.00 | 4 |
| 6 | 6 | .016 | 1.00 | 5 |
| 7 | 7 | .008 | 1.00 | 6 |
| 8 | 7 | .035 | .75 | 7 |
| 9 | 8 | .020 | .78 | 8 |
| 10 | 9 | .011 | .80 | 8 |
| 11 | 9 | .033 | .64 | 9 |
| 12 | 10 | .019 | .67 | 10 |
| 13 | 10 | .046 | .54 | 11 |
| 14 | 11 | .029 | .57 | 11 |
| 15 | 12 | .018 | .60 | 12 |
Tabela pokazuje coś, co łatwo przeoczyć: przy 5–7 ekspertach CVR jest istotny tylko przy jednomyślności, a I-CVI ≥ .78 dopuszcza jedną ocenę negatywną. Od ośmiu ekspertów progi są podobne. Rysunek 1 pokazuje, co to oznacza w praktyce. W modelu z przykładu niżej dobre pytanie dostaje od pojedynczego eksperta ocenę „niezbędna” z prawdopodobieństwem .849. Przy sześciu ekspertach przekroczy wartość krytyczną CVR tylko z prawdopodobieństwem .374, a próg I-CVI z prawdopodobieństwem .978. Pytanie przydatne, ale nie niezbędne, przechodzi próg I-CVI w 82.2% przypadków, a progu CVR praktycznie nigdy.
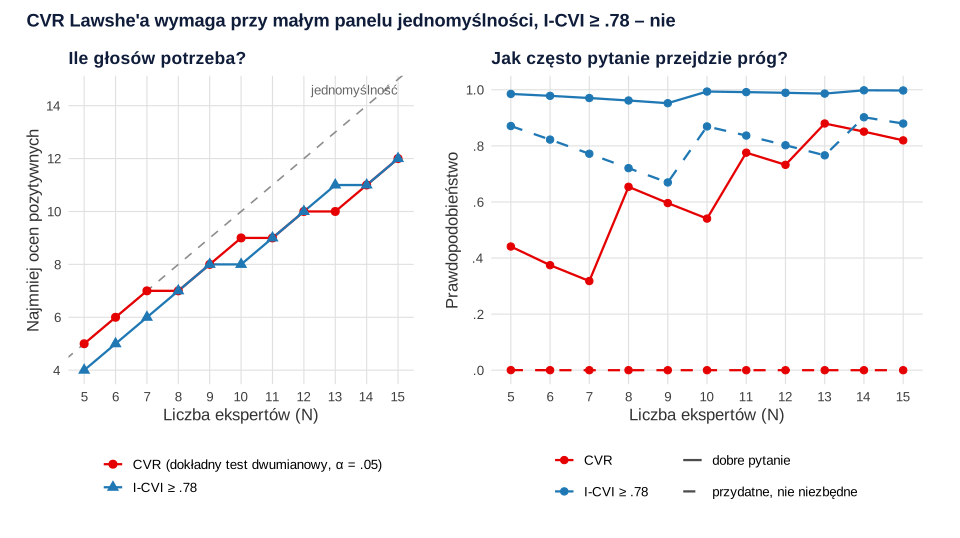
Wniosek dla małego panelu: nie usuwaj pytania tylko dlatego, że CVR nie osiągnął wartości krytycznej. Traktuj CVR jako informację o niezbędności, przydatną, gdy musisz zdecydować, które pytanie wymienić. Problem słabnie dopiero przy większym panelu: przy 10 ekspertach (9 głosów) dobre pytanie z naszego modelu przechodzi próg w 54.1% przypadków, a przy 13 (10 głosów) w 88.0%.
Uwaga na nazwy: u Lawshe'a „CVI” oznacza średni CVR pytań zachowanych w teście, a nie wskaźnik w ujęciu Polit i Beck.
Przykład: 6 ekspertów ocenia 20 pytań
Studentka pielęgniarstwa przygotowała test wiedzy o profilaktyce upadków u osób starszych w szpitalu (20 pytań jednokrotnego wyboru, test fikcyjny). Tabela specyfikacji ma cztery obszary po pięć pytań: A – czynniki ryzyka, B – ocena ryzyka, C – bezpieczne otoczenie i przemieszczanie, D – edukacja pacjenta i rodziny. Ma też trzy poziomy wymagań: zapamiętanie (6 pytań), zrozumienie (7) i zastosowanie (7). Sześcioro ekspertów (trzy pielęgniarki z doświadczeniem w opiece geriatrycznej, dwoje dydaktyków pielęgniarstwa i fizjoterapeuta) oceniło każde pytanie według pięciu kryteriów z tabeli wyżej.
Oceny są symulowane, więc znamy prawdę. P7 wykracza poza zakres testu, P14 jest zbyt specjalistyczne dla grupy docelowej, a P19 jest przydatne, ale nie niezbędne. P3 ma dwie odpowiedzi, których da się bronić, P12 mierzy w praktyce obszar B zamiast C, a P17 jest niejasno sformułowane. Pozostałe 14 pytań jest dobrych. Reguła decyzji została zapisana przed rozesłaniem formularza i działa po kolei: najpierw trafność, potem klucz, obszar i jasność. Pytanie, które spełnia wszystkie cztery warunki, zostaje, a niski CVR tylko je oznacza.
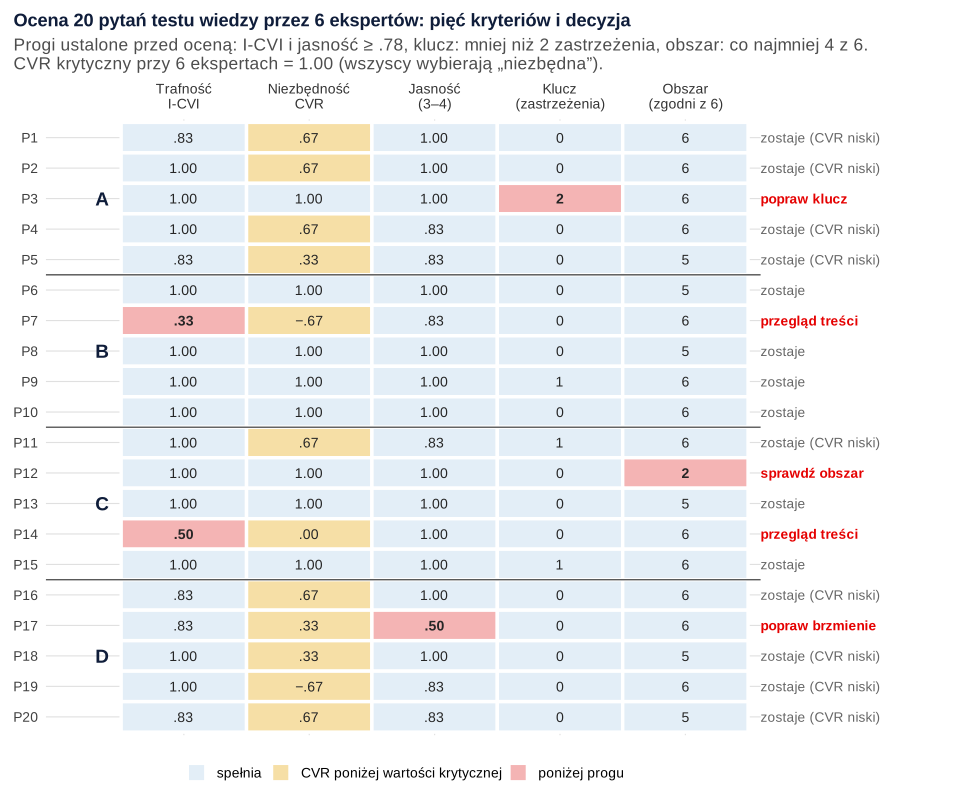
Reguła wskazała dokładnie pięć wadliwych pytań, każde z właściwego powodu:
- P7 i P14 – przegląd treści: I-CVI = .33 (κ* = .13) i .50 (κ* = .27), CVR = −.67 i .00.
- P3 – popraw klucz: I-CVI = 1.00 i CVR = 1.00, ale dwoje ekspertów wskazało drugą poprawną odpowiedź. Bez pytania o klucz P3 przeszłoby do pilotażu.
- P12 – sprawdź obszar: tylko dwoje ekspertów przypisało je do obszaru C, większość do B.
- P17 – popraw brzmienie: jasność = .50 przy trafności .83.
Dziewięć pytań, które przeszły wszystkie progi, ma CVR poniżej wartości krytycznej 1.00. Tylko jedno z nich jest naprawdę „nie niezbędne”: P19, które wszyscy eksperci uznali za trafne (I-CVI = 1.00), a za niezbędne tylko jeden (CVR = −.67). Pozostałe osiem to dobre pytania, którym zabrakło jednego–dwóch głosów do jednomyślności, z CVR = .67 albo .33. Tu widać różnicę między wskaźnikami. I-CVI nie odróżnił P19 od dobrych pytań, a CVR wskazał je wyraźnie, ale razem z ośmioma dobrymi.
Ziarno symulacji wybraliśmy tak, by przykład był czytelny, więc sprawdziliśmy 1000 powtórzeń tego samego panelu. Reguła wskazała jednocześnie P7 i P14 w 91.0% paneli, klucz P3 w 89.9%, obszar P12 w 88.9%, a P17 w 95.1%. Wśród 14 dobrych pytań zgłaszała jednak średnio 1.00 fałszywy alarm na panel, bo przy sześciu ekspertach wystarczy jedna przypadkowa ocena. Każde zgłoszenie sprawdź więc z komentarzami ekspertów. CVR poniżej wartości krytycznej miało średnio 8.1 z 14 dobrych pytań (90% paneli: od 5 do 11).
Co zrobić z pytaniem o niskim I-CVI
Niski I-CVI to sygnał, a nie automatyczny wyrok. Zanim usuniesz pytanie, przejdź przez cztery kroki:
- Przeczytaj komentarze. Ustal, czy eksperci kwestionują temat pytania (wykracza poza cel testu, jest zbyt specjalistyczny), czy jego wykonanie (niejasne słowo, zły dystraktor). To dwa różne problemy.
- Zły temat – usuń, ale nie zostawiaj luki. Usunięcie pytania zmienia tabelę specyfikacji. W przykładzie po usunięciu P7 i P14 w obszarze B zabrakło pytania na poziomie zrozumienia, a w obszarze C – na poziomie zastosowania (rysunek 3). Napisz nowe pytanie do tego samego pola tabeli.
- Złe wykonanie – przeredaguj. Jeśli eksperci zgadzają się co do tematu, a mają zastrzeżenia do formy, popraw pytanie zgodnie z uwagami.
- Nowe i poprawione pytania oceń w drugiej rundzie. Wyślij ekspertom tylko te pytania, z tym samym formularzem. Pytania niezmienione nie wymagają ponownej oceny.
Nie oceniaj tego samego pytania „do skutku”. Jeśli po drugiej rundzie nadal ma niski I-CVI, zastąp je innym. Każdą zmianę zapisz w tabeli zmian (pytanie, powód, decyzja, runda) – przyda się w rozdziale metodologicznym i na obronie. Zakwestionowany klucz zawsze wymaga poprawy, a niezgodność obszaru rozwiąż przez przeredagowanie pytania albo zmianę opisu obszaru.
Kompletność obszarów, tabela specyfikacji i druga runda
Wskaźniki dla całego testu w pierwszej rundzie wyniosły S-CVI/Ave = .90 i S-CVI/UA = .65. W obszarach S-CVI/Ave wahało się od .87 (B) do .93 (A), a S-CVI/UA od .40 (D) do .80 (B i C). Po usunięciu P7 i P14 osiemnaście pytań miało S-CVI/Ave = .95 i S-CVI/UA = .72. Te liczby nie mówią jednak, czy test pokrywa cały zakres wiedzy – to widać dopiero w tabeli specyfikacji i ocenie kompletności.
Obszary A, B i C uznało za kompletne wszystkich sześcioro ekspertów, a obszar D tylko dwoje. W komentarzach wskazali brakujący temat. Studentka miała więc do napisania trzy nowe pytania (zastępstwa P7 i P14 oraz pytanie z brakującego tematu w obszarze D) przy teście, który miał zostać przy 20 pytaniach. Do wymiany wybrała P19. Pytanie było trafne, ale tylko jeden ekspert uznał je za niezbędne, a nowe pytanie trafiło w to samo pole tabeli (D, zastosowanie). To dobre zastosowanie CVR: nie jako progu usuwania, tylko jako podpowiedzi, z którego pytania zrezygnować.
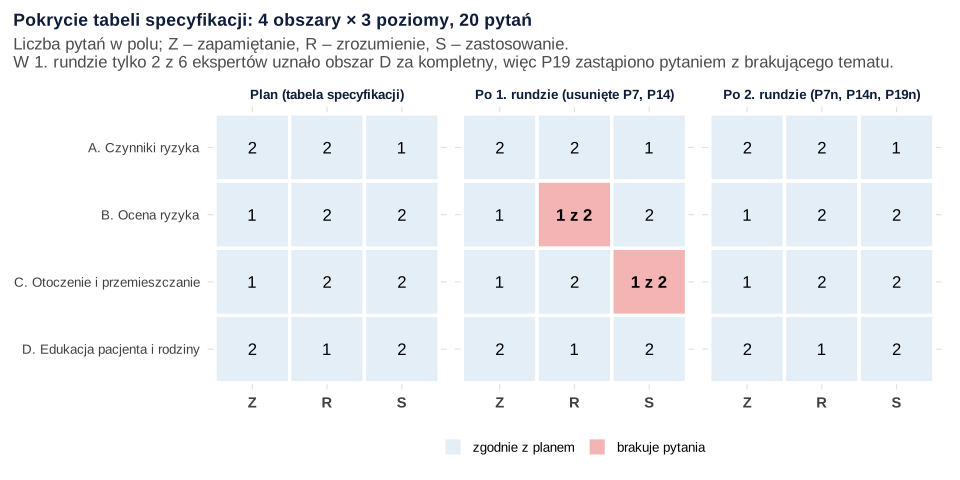
W drugiej rundzie sześcioro ekspertów oceniło sześć pytań: trzy nowe (P7n, P14n, P19n) i trzy poprawione (P3, P12, P17). Pięć z nich uzyskało I-CVI = 1.00, a P19n – .83. Klucz P3 nie budził już zastrzeżeń, P12 przypisało do obszaru C czworo ekspertów (dokładnie na progu), a jasność P17 wzrosła do .83. Obszar D uznali za kompletny wszyscy eksperci. Końcowa wersja 20 pytań ma S-CVI/Ave = .96 i S-CVI/UA = .75. Jedenaście z 20 pytań nadal ma CVR poniżej wartości krytycznej, co przy sześciu ekspertach jest normalne.
Ocena ekspertów to dopiero pierwszy krok. Eksperci nie wiedzą, jak pytanie zrozumie pacjent czy student pierwszego roku. Dlatego następny etap to wywiad poznawczy z kilkoma osobami z grupy docelowej, a potem badanie pilotażowe z analizą łatwości, mocy różnicującej i KR-20, opisaną we wpisie ankieta wiedzy – analiza krok po kroku. Ocena trafności przez samych respondentów to osobne zagadnienie: trafność fasadowa. Sposób liczenia punktów i próg dobrej wiedzy omawiają wpisy punktowanie testu wiedzy i próg dobrej wiedzy metodą Angoffa. Ten drugi też korzysta z panelu ekspertów, więc często możesz zaprosić te same osoby.
Jak opisać ocenę ekspertów w pracy
W części o narzędziu opisz: kto oceniał, ile było rund, jakie kryteria i skale zastosowano, jaką regułę decyzji przyjęto przed oceną, wskaźniki przed zmianami i po nich oraz co zmieniono. Ogólny układ opisu narzędzia pokazuje wpis opis narzędzia badawczego – wzór. Tabelę wskaźników dla pytań umieść w aneksie.
Jeśli przygotowujesz własny test wiedzy i chcesz sprawdzić plan oceny ekspertów albo obliczenia, możemy pomóc w ramach analiz statystycznych dla studentów. Wyniki musisz jednak rozumieć i umieć samodzielnie obronić. Inne typowe analizy w pracach z tej dziedziny zbiera wpis statystyka w pracy z pielęgniarstwa.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (trzeci korzysta z funkcji i obiektów z pierwszego). Pierwszy zapisuje oceny ekspertów w formacie długim (pytanie × ekspert) do pliku oceny-ekspertow-test-wiedzy.csv (możesz go pobrać tutaj). Wystarczy bazowy R, bez dodatkowych pakietów.
1. Wskaźniki i decyzja dla każdego pytania
R
# Krok 1. Sześciu ekspertów ocenia 20 pytań testu wiedzy o profilaktyce upadków (dane symulowane)
# Każdy ekspert przy każdym pytaniu: trafność 1–4, niezbędność (Lawshe), jasność 1–4,
# czy zaznaczona odpowiedź jest jedyną poprawną (klucz) i do którego obszaru tabeli specyfikacji należy pytanie.
pytania <- data.frame(
  pytanie = paste0("P", 1:20),
  obszar  = rep(c("A", "B", "C", "D"), each = 5),   # A ryzyko, B ocena ryzyka, C otoczenie, D edukacja
  poziom  = c("Z", "Z", "R", "R", "S",  "Z", "R", "R", "S", "S",
              "Z", "R", "R", "S", "S",  "Z", "Z", "R", "S", "S"))  # Z zapamiętanie, R zrozumienie, S zastosowanie
# Prawda znana tylko w symulacji: P7 wykracza poza konstrukt, P14 jest zbyt specjalistyczne,
# P19 jest przydatne, ale nie niezbędne, P3 ma dwie bronione odpowiedzi, P12 mierzy obszar B zamiast C, P17 jest niejasne.
typ <- setNames(rep("dobre", 20), pytania$pytanie)
typ[c("P7", "P14", "P19")] <- c("poza", "specjalistyczne", "przydatne")
p_traf <- list(dobre = c(.01, .03, .18, .78), przydatne = c(.03, .10, .62, .25),
               poza = c(.25, .45, .22, .08), specjalistyczne = c(.15, .40, .30, .15))
p_niezb <- list(dobre = c(`3` = .60, `4` = .95), przydatne = c(`3` = .15, `4` = .45))

panel <- function(K = 6, typ, p_klucz = c(P3 = .45), p_jasne = c(P17 = .35),
                  zly_obszar = c(P12 = "B"), obszary = pytania$obszar) {
  I <- length(typ)
  traf <- t(sapply(typ, function(x) sample(1:4, K, replace = TRUE, prob = p_traf[[x]])))
  pn <- t(sapply(seq_len(I), function(i) {                # P(„niezbędna”) zależy od oceny trafności
    pr <- p_niezb[[if (typ[i] == "przydatne") "przydatne" else "dobre"]]
    sapply(traf[i, ], function(r) if (r >= 3) pr[[as.character(r)]] else 0)
  }))
  niezb <- ifelse(runif(I * K) < pn, "niezbedna", ifelse(traf <= 2 & runif(I * K) < .7, "zbedna", "przydatna"))
  pj <- setNames(rep(.95, I), names(typ)); pj[names(p_jasne)] <- p_jasne
  jasn <- t(sapply(pj, function(p) ifelse(runif(K) < p, sample(3:4, K, TRUE, c(.3, .7)), sample(1:2, K, TRUE, c(.4, .6)))))
  pk <- setNames(rep(.97, I), names(typ)); pk[names(p_klucz)] <- p_klucz
  klucz_ok <- t(sapply(pk, function(p) runif(K) < p))
  obsz <- t(sapply(seq_len(I), function(i) {
    zam <- obszary[i]; inne <- setdiff(c("A", "B", "C", "D"), zam)
    if (names(typ)[i] %in% names(zly_obszar)) {
      alt <- zly_obszar[[names(typ)[i]]]
      sample(c(zam, alt, setdiff(inne, alt)), K, TRUE, c(.30, .60, rep(.05, 2)))
    } else sample(c(zam, inne), K, TRUE, c(.93, rep(.07 / 3, 3)))
  }))
  dimnames(traf) <- dimnames(jasn) <- dimnames(klucz_ok) <- dimnames(obsz) <- dimnames(niezb) <-
    list(names(typ), paste0("E", 1:K))
  list(traf = traf, niezb = niezb, jasn = jasn, klucz_ok = klucz_ok, obsz = obsz)
}

wskazniki <- function(o, obszary = pytania$obszar) {
  K <- ncol(o$traf)
  A <- rowSums(o$traf >= 3)                               # ile ocen 3–4 (trafne)
  pc <- choose(K, A) * 0.5^K                              # zgoda przypadkowa (Polit i in., 2007)
  ne <- rowSums(o$niezb == "niezbedna")
  ne_kryt <- qbinom(0.95, K, 0.5) + 1                     # dokładny test dwumianowy, jednostronnie, α = .05
  z <- qnorm(.975); p <- A / K                           # 95% przedział Wilsona dla I-CVI
  srodek <- (p + z^2 / (2 * K)) / (1 + z^2 / K)
  pol <- z * sqrt(p * (1 - p) / K + z^2 / (4 * K^2)) / (1 + z^2 / K)
  data.frame(pytanie = rownames(o$traf), obszar = obszary, A = A,
             I_CVI = round(A / K, 2), CI_dol = round(srodek - pol, 2), CI_gor = round(srodek + pol, 2),
             kappa = round((A / K - pc) / (1 - pc), 2),
             ne = ne, CVR = round((ne - K / 2) / (K / 2), 2), CVR_ok = ne >= ne_kryt,
             jasnosc = round(rowMeans(o$jasn >= 3), 2),
             klucz_zle = rowSums(!o$klucz_ok),
             obszar_zgodny = rowSums(o$obsz == obszary), row.names = NULL)
}

decyzja <- function(w) {
  with(w, ifelse(I_CVI < .78, "przegląd treści",
          ifelse(klucz_zle >= 2, "popraw klucz",
          ifelse(obszar_zgodny < 4, "sprawdź obszar",
          ifelse(jasnosc < .78, "popraw brzmienie",
          ifelse(!CVR_ok, "zostaje, CVR < próg", "zostaje"))))))
}

options(width = 110)
set.seed(4275)
oceny <- panel(K = 6, typ = typ)
tab <- wskazniki(oceny)
tab$decyzja <- decyzja(tab)
print(tab[, c("pytanie", "obszar", "A", "I_CVI", "CI_dol", "CI_gor", "kappa", "ne", "CVR", "jasnosc",
              "klucz_zle", "obszar_zgodny", "decyzja")], row.names = FALSE)
table(tab$decyzja)

# Plik do pobrania: format długi (pytanie × ekspert)
dl <- expand.grid(ekspert = colnames(oceny$traf), pytanie = rownames(oceny$traf), stringsAsFactors = FALSE)[, 2:1]
idx <- cbind(match(dl$pytanie, rownames(oceny$traf)), match(dl$ekspert, colnames(oceny$traf)))
dl$obszar_tabela <- pytania$obszar[idx[, 1]]
dl$poziom_tabela <- pytania$poziom[idx[, 1]]
dl$trafnosc_1_4 <- oceny$traf[idx]
dl$niezbednosc <- oceny$niezb[idx]
dl$jasnosc_1_4 <- oceny$jasn[idx]
dl$klucz_poprawny <- as.integer(oceny$klucz_ok[idx])
dl$obszar_wg_eksperta <- oceny$obsz[idx]
write.csv(dl, "oceny-ekspertow-test-wiedzy.csv", row.names = FALSE)
cat("Zapisano oceny-ekspertow-test-wiedzy.csv:", nrow(dl), "wierszy\n")
Wynik w R
 pytanie obszar A I_CVI CI_dol CI_gor kappa ne   CVR jasnosc klucz_zle obszar_zgodny             decyzja
      P1      A 5  0.83   0.44   0.97  0.82  5  0.67    1.00         0             6 zostaje, CVR < próg
      P2      A 6  1.00   0.61   1.00  1.00  5  0.67    1.00         0             6 zostaje, CVR < próg
      P3      A 6  1.00   0.61   1.00  1.00  6  1.00    1.00         2             6        popraw klucz
      P4      A 6  1.00   0.61   1.00  1.00  5  0.67    0.83         0             6 zostaje, CVR < próg
      P5      A 5  0.83   0.44   0.97  0.82  4  0.33    0.83         0             5 zostaje, CVR < próg
      P6      B 6  1.00   0.61   1.00  1.00  6  1.00    1.00         0             5             zostaje
      P7      B 2  0.33   0.10   0.70  0.13  1 -0.67    0.83         0             6     przegląd treści
      P8      B 6  1.00   0.61   1.00  1.00  6  1.00    1.00         0             5             zostaje
      P9      B 6  1.00   0.61   1.00  1.00  6  1.00    1.00         1             6             zostaje
     P10      B 6  1.00   0.61   1.00  1.00  6  1.00    1.00         0             6             zostaje
     P11      C 6  1.00   0.61   1.00  1.00  5  0.67    0.83         1             6 zostaje, CVR < próg
     P12      C 6  1.00   0.61   1.00  1.00  6  1.00    1.00         0             2      sprawdź obszar
     P13      C 6  1.00   0.61   1.00  1.00  6  1.00    1.00         0             5             zostaje
     P14      C 3  0.50   0.19   0.81  0.27  3  0.00    1.00         0             6     przegląd treści
     P15      C 6  1.00   0.61   1.00  1.00  6  1.00    1.00         1             6             zostaje
     P16      D 5  0.83   0.44   0.97  0.82  5  0.67    1.00         0             6 zostaje, CVR < próg
     P17      D 5  0.83   0.44   0.97  0.82  4  0.33    0.50         0             6    popraw brzmienie
     P18      D 6  1.00   0.61   1.00  1.00  4  0.33    1.00         0             5 zostaje, CVR < próg
     P19      D 6  1.00   0.61   1.00  1.00  1 -0.67    0.83         0             6 zostaje, CVR < próg
     P20      D 5  0.83   0.44   0.97  0.82  5  0.67    0.83         0             5 zostaje, CVR < próg

   popraw brzmienie        popraw klucz     przegląd treści      sprawdź obszar             zostaje
                  1                   1                   2                   1                   6
zostaje, CVR < próg
                  9
Zapisano oceny-ekspertow-test-wiedzy.csv: 120 wierszy
2. Wartości krytyczne CVR i szansa przejścia progu
R
# Krok 2. Wartości krytyczne CVR z dokładnego rozkładu dwumianowego i porównanie z progiem I-CVI ≥ .78
# H0: każdy ekspert wybiera „niezbędna” z prawdopodobieństwem 0.5; test jednostronny, α = .05.
N <- 5:15
ne_kryt <- qbinom(0.95, N, 0.5) + 1                     # najmniejsze ne, dla którego P(X ≥ ne) ≤ .05
p_kryt <- pbinom(ne_kryt - 1, N, 0.5, lower.tail = FALSE)
A_cvi <- ceiling(0.78 * N)                              # najmniej ocen 3–4, by I-CVI ≥ .78
krytyczne <- data.frame(N, ne_kryt, p = round(p_kryt, 3), CVR_kryt = round((ne_kryt - N / 2) / (N / 2), 2),
                        A_dla_ICVI_78 = A_cvi, ICVI_min = round(A_cvi / N, 2))
print(krytyczne, row.names = FALSE)

# Jak często pytanie przejdzie każdy próg? Prawdopodobieństwa dla jednego eksperta z modelu z kroku 1:
# dobre pytanie: ocena 3–4 z p = .96, „niezbędna” z p = .78 × .95 + .18 × .60;
# pytanie przydatne, ale nie niezbędne (jak P19): ocena 3–4 z p = .87, „niezbędna” z p = .25 × .45 + .62 × .15.
pr_traf <- c(dobre = .96, przydatne = .87)
pr_niezb <- c(dobre = .78 * .95 + .18 * .60, przydatne = .25 * .45 + .62 * .15)
round(pr_niezb, 3)
szansa <- data.frame(N,
  dobre_ICVI = pbinom(A_cvi - 1, N, pr_traf["dobre"], lower.tail = FALSE),
  dobre_CVR = pbinom(ne_kryt - 1, N, pr_niezb["dobre"], lower.tail = FALSE),
  przydatne_ICVI = pbinom(A_cvi - 1, N, pr_traf["przydatne"], lower.tail = FALSE),
  przydatne_CVR = pbinom(ne_kryt - 1, N, pr_niezb["przydatne"], lower.tail = FALSE))
print(round(szansa, 3), row.names = FALSE)
Wynik w R
  N ne_kryt     p CVR_kryt A_dla_ICVI_78 ICVI_min
  5       5 0.031     1.00             4     0.80
  6       6 0.016     1.00             5     0.83
  7       7 0.008     1.00             6     0.86
  8       7 0.035     0.75             7     0.88
  9       8 0.020     0.78             8     0.89
 10       9 0.011     0.80             8     0.80
 11       9 0.033     0.64             9     0.82
 12      10 0.019     0.67            10     0.83
 13      10 0.046     0.54            11     0.85
 14      11 0.029     0.57            11     0.79
 15      12 0.018     0.60            12     0.80
    dobre przydatne
    0.849     0.206
  N dobre_ICVI dobre_CVR przydatne_ICVI przydatne_CVR
  5      0.985     0.441          0.871             0
  6      0.978     0.374          0.822             0
  7      0.971     0.318          0.772             0
  8      0.962     0.654          0.721             0
  9      0.952     0.596          0.670             0
 10      0.994     0.541          0.869             0
 11      0.992     0.776          0.837             0
 12      0.989     0.732          0.802             0
 13      0.986     0.880          0.766             0
 14      0.998     0.851          0.902             0
 15      0.998     0.820          0.880             0
3. S-CVI, tabela specyfikacji, druga runda i powtórzenia
R
# Krok 3. Wskaźniki dla całego testu i obszarów, pokrycie tabeli specyfikacji, druga runda i powtórzenia
# (wymaga obiektów z kroku 1: pytania, typ, panel(), wskazniki(), decyzja(), tab)
s_cvi <- function(w) c(S_CVI_Ave = mean(w$I_CVI), S_CVI_UA = mean(w$I_CVI == 1))
round(s_cvi(tab), 3)
round(sapply(split(tab, tab$obszar), s_cvi), 3)
usun <- tab$decyzja == "przegląd treści"
round(s_cvi(tab[!usun, ]), 3)                           # po usunięciu P7 i P14

# Kompletność obszarów: „czy pytania obszaru wystarczająco go pokrywają?” (tak/nie)
set.seed(4282)
kompletny <- sapply(c(A = .9, B = .9, C = .9, D = .3), function(p) rbinom(6, 1, p))
colSums(kompletny)                                      # ilu z 6 ekspertów uznało obszar za kompletny

# Tabela specyfikacji: plan i stan po pierwszej rundzie
plan <- table(pytania$obszar, factor(pytania$poziom, levels = c("Z", "R", "S")))
po_1 <- table(pytania$obszar[!usun], factor(pytania$poziom[!usun], levels = c("Z", "R", "S")))
plan
plan - po_1                                             # luki do uzupełnienia nowymi pytaniami

# Druga runda: nowe P7n i P14n w miejsce usuniętych, poprawione P3, P12 i P17,
# P19 (przydatne, ale nie niezbędne) zastąpione pytaniem z brakującego tematu obszaru D
set.seed(4285)
typ2 <- c(P3 = "dobre", P7n = "dobre", P12 = "dobre", P14n = "dobre", P17 = "dobre", P19n = "dobre")
o2 <- panel(K = 6, typ = typ2, p_klucz = numeric(0), p_jasne = numeric(0), zly_obszar = character(0),
            obszary = c("A", "B", "C", "C", "D", "D"))
tab2 <- wskazniki(o2, obszary = c("A", "B", "C", "C", "D", "D"))
tab2$decyzja <- decyzja(tab2)
print(tab2[, c("pytanie", "obszar", "A", "I_CVI", "ne", "CVR", "jasnosc", "klucz_zle", "obszar_zgodny", "decyzja")],
      row.names = FALSE)
koncowy <- rbind(tab[!tab$pytanie %in% c("P3", "P7", "P12", "P14", "P17", "P19"), names(tab2)], tab2)
round(s_cvi(koncowy), 3)
sum(!koncowy$CVR_ok)                                    # ile z 20 pytań końcowej wersji ma CVR poniżej progu
sum(rbinom(6, 1, .9))                                   # kompletność obszaru D w drugiej rundzie

# Powtórzenia: 1000 paneli z tego samego modelu (jak bardzo przykład zależy od ziarna?)
set.seed(4277)
czyste <- setdiff(pytania$pytanie, c("P3", "P7", "P12", "P14", "P17", "P19"))
mc <- t(replicate(1000, {
  w <- wskazniki(panel(K = 6, typ = typ)); d <- setNames(decyzja(w), w$pytanie)
  c(P7_i_P14_ponizej_78 = all(d[c("P7", "P14")] == "przegląd treści"),
    P3_klucz = d[["P3"]] == "popraw klucz", P12_obszar = d[["P12"]] == "sprawdź obszar",
    P17_jasnosc = d[["P17"]] == "popraw brzmienie",
    czyste_falszywy_alarm = sum(!d[czyste] %in% c("zostaje", "zostaje, CVR < próg")),
    czyste_CVR_ponizej = sum(d[czyste] == "zostaje, CVR < próg"),
    P19_CVR_ponizej = d[["P19"]] == "zostaje, CVR < próg")
}))
round(colMeans(mc), 3)
quantile(mc[, "czyste_CVR_ponizej"], c(.05, .5, .95))
Wynik w R
S_CVI_Ave  S_CVI_UA
    0.899     0.650
              A     B   C     D
S_CVI_Ave 0.932 0.866 0.9 0.898
S_CVI_UA  0.600 0.800 0.8 0.400
S_CVI_Ave  S_CVI_UA
    0.953     0.722
A B C D
6 6 6 2

    Z R S
  A 2 2 1
  B 1 2 2
  C 1 2 2
  D 2 1 2

    Z R S
  A 0 0 0
  B 0 1 0
  C 0 0 1
  D 0 0 0
 pytanie obszar A I_CVI ne  CVR jasnosc klucz_zle obszar_zgodny             decyzja
      P3      A 6  1.00  5 0.67    1.00         0             4 zostaje, CVR < próg
     P7n      B 6  1.00  6 1.00    1.00         0             6             zostaje
     P12      C 6  1.00  6 1.00    0.83         0             4             zostaje
    P14n      C 6  1.00  5 0.67    0.83         0             5 zostaje, CVR < próg
     P17      D 6  1.00  6 1.00    0.83         0             4             zostaje
    P19n      D 5  0.83  5 0.67    1.00         0             6 zostaje, CVR < próg
S_CVI_Ave  S_CVI_UA
    0.958     0.750
[1] 11
[1] 6
  P7_i_P14_ponizej_78              P3_klucz            P12_obszar           P17_jasnosc czyste_falszywy_alarm
                0.910                 0.899                 0.889                 0.951                 1.001
   czyste_CVR_ponizej       P19_CVR_ponizej
                8.115                 0.771
 5% 50% 95%
  5   8  11
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Eksperci oceniają tylko trafność. W teście wiedzy pytanie o klucz jest równie ważne. W przykładzie P3 miało I-CVI = 1.00 i CVR = 1.00, a i tak wymagało poprawy.
- Eksperci widzą Twoje przypisanie do obszaru. Wtedy tylko je potwierdzają. Pokaż pytania bez etykiet i porównaj ich przypisania z tabelą specyfikacji.
- CVR jako próg usuwania przy małym panelu. Przy 5–7 ekspertach wartość krytyczna wymaga jednomyślności i odrzuca większość dobrych pytań. Przy sześciu ekspertach dobre pytanie przechodzi ją w 37% przypadków.
- Usunięcie pytania bez uzupełnienia tabeli specyfikacji. Wysoki S-CVI po usunięciu pytań może ukryć lukę w treści testu. Sprawdź liczbę pytań w każdym polu tabeli.
- Brak pytania o kompletność. Eksperci oceniają tylko to, co im pokażesz. O brakujący temat musisz zapytać osobno.
- Ocena ekspertów zamiast pilotażu. Eksperci nie sprawdzą łatwości, mocy różnicującej ani rzetelności. Po ich ocenie zawsze przeprowadź pilotaż.
Najczęstsze pytania
Czy sześciu ekspertów wystarczy do oceny trafności treściowej testu wiedzy?
Do I-CVI tak: próg .78 zaproponowano dla paneli od trzech ekspertów, a przy sześciu oznacza on co najmniej 5 ocen 3–4. Gorzej z CVR Lawshe'a. Przy sześciu ekspertach wartość krytyczna wymaga jednomyślności, więc dobre pytanie z naszego przykładu przechodzi ją tylko w 37.4% przypadków. Przy takim panelu traktuj CVR pomocniczo albo zaproś więcej osób.
Jaka jest wartość krytyczna CVR przy 6, 8 i 10 ekspertach?
Z dokładnego testu dwumianowego (jednostronnie, α = .05): przy 6 ekspertach potrzeba 6 głosów „niezbędna” (CVR = 1.00), przy 8 – 7 głosów (CVR = .75), a przy 10 – 9 głosów (CVR = .80). W R najmniejszą liczbę głosów policzysz jako qbinom(0.95, N, 0.5) + 1.
Czym różni się I-CVI od CVR w ocenie pytań testu?
I-CVI mówi, jaki odsetek ekspertów uznał pytanie za trafne (ocena 3–4 na skali 1–4). CVR mówi, ilu uznało zawartą w nim wiedzę za niezbędną, i może być ujemny. W przykładzie pytanie P19 miało I-CVI = 1.00, ale CVR = −.67, bo tylko jeden z sześciu ekspertów uznał je za niezbędne. Dlatego to ono zostało wymienione, gdy w teście zabrakło miejsca.
Co zrobić, gdy ekspert twierdzi, że w pytaniu testowym są dwie poprawne odpowiedzi?
Sprawdź źródło, na którym oparłeś klucz, i aktualne zalecenia. Jeśli zastrzeżenie zgłasza dwóch lub więcej ekspertów, popraw pytanie: zmień dystraktor albo doprecyzuj treść tak, by tylko jedna odpowiedź była poprawna. Poprawione pytanie oceń ponownie. Pytanie z dwiema poprawnymi odpowiedziami zaniża wyniki osób o najlepszej wiedzy, nawet gdy ma I-CVI = 1.00.
Czy po poprawieniu pytań trzeba ponownie pytać ekspertów?
Tak, ale tylko o pytania nowe i zmienione, z tym samym formularzem. W przykładzie druga runda objęła sześć pytań, które uzyskały I-CVI od .83 do 1.00, a obszar uznany wcześniej za niekompletny ocenili jako kompletny wszyscy eksperci. Nie oceniaj jednego pytania wiele razy, aż przekroczy próg – po drugiej rundzie zastąp je innym.
Powiązane hasła
Przeczytaj też
Jak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikOcena ekspercka kwestionariusza
Panel ekspertów jako pretest: lista QAS-99, I-CVI z kappą zmodyfikowaną, zgodność ekspertów, reguła decyzji i liczba ekspertów w R.
Czytaj →PoradnikJak pisać pytania testowe i dystraktory
Zasady pisania pytań jednokrotnego wyboru, przykłady źle i lepiej z pielęgniarstwa, trzy czy cztery odpowiedzi i analiza dystraktorów po pilotażu w R.
Czytaj →Budujesz własny test wiedzy do pracy dyplomowej?
Pomożemy zaplanować ocenę ekspertów, policzyć CVI i CVR i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Almanasreh, E., Moles, R., & Chen, T. F. (2019). Evaluation of methods used for estimating content validity. Research in Social and Administrative Pharmacy, 15(2), 214–221. https://doi.org/10.1016/j.sapharm.2018.03.066
- Ayre, C., & Scally, A. J. (2014). Critical values for Lawshe's content validity ratio: Revisiting the original methods of calculation. Measurement and Evaluation in Counseling and Development, 47(1), 79–86. https://doi.org/10.1177/0748175613513808
- Downing, S. M. (2003). Validity: On the meaningful interpretation of assessment data. Medical Education, 37(9), 830–837. https://doi.org/10.1046/j.1365-2923.2003.01594.x
- Grant, J. S., & Davis, L. L. (1997). Selection and use of content experts for instrument development. Research in Nursing & Health, 20(3), 269–274. https://doi.org/10.1002/(sici)1098-240x(199706)20:3<269::aid-nur9>3.0.co;2-g
- Lawshe, C. H. (1975). A quantitative approach to content validity. Personnel Psychology, 28(4), 563–575. https://doi.org/10.1111/j.1744-6570.1975.tb01393.x
- Lynn, M. R. (1986). Determination and quantification of content validity. Nursing Research, 35(6), 382–386. https://doi.org/10.1097/00006199-198611000-00017
- Polit, D. F., & Beck, C. T. (2006). The content validity index: Are you sure you know what’s being reported? Critique and recommendations. Research in Nursing & Health, 29(5), 489–497. https://doi.org/10.1002/nur.20147
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459–467. https://doi.org/10.1002/nur.20199
- Wilson, F. R., Pan, W., & Schumsky, D. A. (2012). Recalculation of the critical values for Lawshe's content validity ratio. Measurement and Evaluation in Counseling and Development, 45(3), 197–210. https://doi.org/10.1177/0748175612440286
Cytowania BibTeX
@article{almanasreh2019evaluation, author={Almanasreh, Enas and Moles, Rebekah and Chen, Timothy F.}, title={{Evaluation of methods used for estimating content validity}}, journal={Research in Social and Administrative Pharmacy}, year={2019}, volume={15}, number={2}, pages={214--221}, doi={10.1016/j.sapharm.2018.03.066}}@article{ayre2014critical, author={Ayre, Colin and Scally, Andrew John}, title={{Critical values for Lawshe's content validity ratio: Revisiting the original methods of calculation}}, journal={Measurement and Evaluation in Counseling and Development}, year={2014}, volume={47}, number={1}, pages={79--86}, doi={10.1177/0748175613513808}}@article{downing2003validity, author={Downing, Steven M.}, title={{Validity: On the meaningful interpretation of assessment data}}, journal={Medical Education}, year={2003}, volume={37}, number={9}, pages={830--837}, doi={10.1046/j.1365-2923.2003.01594.x}}@article{grant1997selection, author={Grant, Joan S. and Davis, Linda L.}, title={{Selection and use of content experts for instrument development}}, journal={Research in Nursing \& Health}, year={1997}, volume={20}, number={3}, pages={269--274}, doi={10.1002/(sici)1098-240x(199706)20:3<269::aid-nur9>3.0.co;2-g}}@article{lawshe1975quantitative, author={Lawshe, C. H.}, title={{A quantitative approach to content validity}}, journal={Personnel Psychology}, year={1975}, volume={28}, number={4}, pages={563--575}, doi={10.1111/j.1744-6570.1975.tb01393.x}}@article{lynn1986determination, author={Lynn, Mary R.}, title={{Determination and quantification of content validity}}, journal={Nursing Research}, year={1986}, volume={35}, number={6}, pages={382--386}, doi={10.1097/00006199-198611000-00017}}@article{polit2006content, author={Polit, Denise F. and Beck, Cheryl Tatano}, title={{The content validity index: Are you sure you know what’s being reported? Critique and recommendations}}, journal={Research in Nursing \& Health}, year={2006}, volume={29}, number={5}, pages={489--497}, doi={10.1002/nur.20147}}@article{polit2007cvi, author={Polit, Denise F. and Beck, Cheryl Tatano and Owen, Steven V.}, title={{Is the CVI an acceptable indicator of content validity? Appraisal and recommendations}}, journal={Research in Nursing \& Health}, year={2007}, volume={30}, number={4}, pages={459--467}, doi={10.1002/nur.20199}}@article{wilson2012recalculation, author={Wilson, F. Robert and Pan, Wei and Schumsky, Donald A.}, title={{Recalculation of the critical values for Lawshe's content validity ratio}}, journal={Measurement and Evaluation in Counseling and Development}, year={2012}, volume={45}, number={3}, pages={197--210}, doi={10.1177/0748175612440286}}