Kiedy metoda delficka ma sens
Metoda delficka powstała w RAND Corporation jako sposób na uzyskanie możliwie wiarygodnej opinii grupy ekspertów: serię kwestionariuszy przeplata się kontrolowaną informacją zwrotną o odpowiedziach grupy (Dalkey i Helmer, 1963; Williamson i in., 2017). Podsumowanie ocen wraca do ekspertów anonimowo, a każdy może zmienić swoją ocenę po zapoznaniu się z opiniami innych (Williamson i in., 2017). Eksperci nie muszą się spotykać, więc wynik mniej zależy od tego, kto mówi najgłośniej. Hasson i in. (2000) opisują ją jako proces wieloetapowy, który ma przekształcić rozproszone opinie w konsensus grupy.
Sięgnij po nią, gdy danych empirycznych brakuje albo nie wystarczają do decyzji. Typowe zastosowania to zestawy podstawowych wyników do badań klinicznych (core outcome sets), wskaźniki jakości opieki, wytyczne i listy kontrolne, a w psychometrii ocena pozycji nowej skali, uzupełniająca trafność treściową. Pamiętaj o granicy: konsensus mówi, co eksperci uznają za ważne, a nie co jest prawdą. Przy ocenie skuteczności interwencji opinia panelu nie zastąpi badań ani oceny pewności danych w GRADE.
Protokół: decyzje przed pierwszą rundą
Częstym problemem są decyzje podejmowane dopiero w trakcie badania. W przeglądzie 100 badań delfickich definicję konsensusu podano w 72, a tylko 42 z 86 badań, które ogłosiły konsensus, określiły go z góry z wartością progu. Siedemdziesiąt badań kończyło się po ustalonej liczbie rund, a nie po osiągnięciu konsensusu (Diamond i in., 2014). Zapisz więc w protokole, najlepiej prerejestrowanym, odpowiedzi na pytania z tabeli.
| Decyzja | Co ustalić | Wskazówka ze źródeł |
|---|---|---|
| Kto jest ekspertem | kryteria włączenia, grupy interesariuszy, sposób rekrutacji | Liczebność panelu nie wynika z analizy mocy, tylko z dostępności ekspertów i potrzeby reprezentacji grup (Williamson i in., 2017). |
| Lista pozycji | skąd pochodzą (przegląd, wywiady, otwarta runda 1), jak je sformułować | Kwestionariusz każdej rundy warto sprawdzić w pilotażu. |
| Skala ocen | np. 1–9 z kategoriami 1–3, 4–6, 7–9; opcja „nie potrafię ocenić” | Skala 1–9 jest zgodna z oceną znaczenia wyników w GRADE (Schünemann i in., 2013). |
| Kryterium konsensusu | próg i warunek „włączyć” oraz „wyłączyć” | Najczęściej odsetek zgody; mediana progu w przeglądzie wynosiła 75% (Diamond i in., 2014). |
| Liczba rund i zatrzymanie | maksymalna liczba rund, co przechodzi do kolejnej rundy | Co najmniej dwie rundy, czyli jedna z informacją zwrotną; zwykle dwie lub trzy (Williamson i in., 2017). |
| Informacja zwrotna | co zobaczy ekspert po rundzie | Mediana lub średnia, miara rozproszenia, odsetek ocen powyżej progu albo cały rozkład; często też własna ocena z poprzedniej rundy (Williamson i in., 2017). |
Panele bywają małe. W przeglądzie 80 badań wybierających wskaźniki jakości opieki mediana liczebności panelu wynosiła 17 osób (Q1 = 11, Q3 = 31), a 63% badań stosowało procedurę zmodyfikowaną, ze spotkaniem panelu (Boulkedid i in., 2011). Określenie „zmodyfikowana metoda delficka” bywa jednak rozumiane różnie, podobnie jak sama „runda”, dlatego opisz dokładnie, co zrobiłeś (Jünger i in., 2017). Dobór ekspertów to zwykle dobór celowy; uzasadnij go tak samo starannie jak dobór próby w badaniu ankietowym.
Kryterium konsensusu: dwie popularne reguły
W przykładzie stosujemy regułę „70/15” opisanej w podręczniku COMET do tworzenia zestawów podstawowych wyników (Williamson i in., 2017). Pozycja osiąga konsensus „włączyć”, gdy co najmniej 70% ekspertów oceni ją na 7–9, a najwyżej 15% na 1–3. Konsensus „wyłączyć” to sytuacja odwrotna: co najmniej 70% ocen 1–3 i najwyżej 15% ocen 7–9. Pozostałe pozycje nie mają konsensusu. Idea jest prosta: większość uważa wynik za krytyczny, a tylko niewielka mniejszość za mało ważny.
Prostsza reguła to sam odsetek zgody, np. co najmniej 75% ocen 7–9, co odpowiada medianie progów w przeglądzie Diamonda i in. (2014). Ta reguła nie pilnuje jednak mniejszości, która ocenia pozycję nisko. Którąkolwiek wybierzesz, uzasadnij ją w protokole. Podręcznik COMET zauważa, że zbyt łagodne kryteria dają długą listę pozycji, a zbyt surowe mogą wykluczyć pozycje kluczowe (Williamson i in., 2017).
Obok odsetków podawaj medianę i rozstęp ćwiartkowy (IQR). Oceny 1–9 są danymi na skali porządkowej, więc średnia i SD łatwo wprowadzają w błąd. IQR pokazuje rozproszenie opinii, ale sam w sobie nie jest kryterium konsensusu, dopóki nie zapiszesz progu w protokole.
Przykład: trzy rundy, 16 wyników, 32 ekspertów
Zespół tworzy zestaw podstawowych wyników do badań nad terapią bezsenności u studentów (dane symulowane). Panel 32 osób – klinicyści, badacze i osoby z doświadczeniem bezsenności – ocenia 16 wyników na skali 1–9 w trzech rundach. Po rundzie 1 i 2 każdy widzi medianę grupy i własną poprzednią ocenę. W rundzie 2 odpowiedziało 29 osób (90.6% panelu), a w rundzie 3 – 27 (84.4%). Podręcznik COMET podaje, że odsetek odpowiedzi około 80% w każdej grupie zwykle uznaje się za zadowalający (Williamson i in., 2017). Oceny możesz pobrać: metoda-delficka-oceny-dane.csv (format długi: runda, ekspert, wynik, ocena).
Po rundzie 3 osiem wyników spełniło kryterium „włączyć”, jeden („koszty terapii”: 100% ocen 1–3) kryterium „wyłączyć”, a siedem pozostało bez konsensusu. Liczba wyników z konsensusem „włączyć” rosła: 4 po rundzie 1, 7 po rundzie 2, 8 po rundzie 3. Mediana IQR dla wszystkich pozycji spadła z 2 w rundzie 1 do 1 w rundach 2 i 3, co pokazuje zbliżanie się opinii.
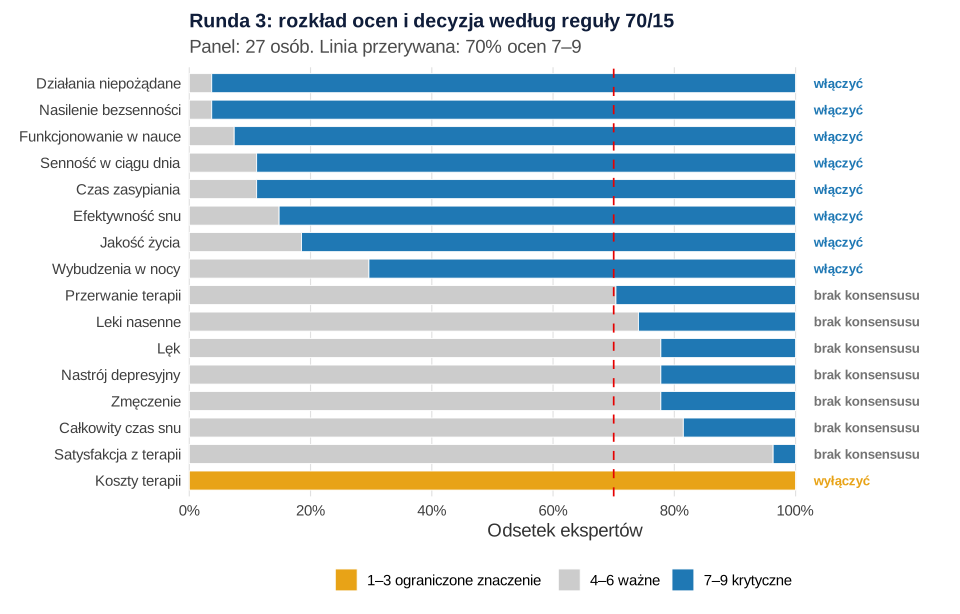
| Wynik | Me | IQR | % ocen 7–9 | % ocen 1–3 | Status |
|---|---|---|---|---|---|
| Nasilenie bezsenności | 8 | 0.0 | 96.3 | 0.0 | włączyć |
| Funkcjonowanie w nauce | 8 | 1.0 | 92.6 | 0.0 | włączyć |
| Jakość życia | 7 | 1.0 | 81.5 | 0.0 | włączyć |
| Wybudzenia w nocy | 7 | 1.0 | 70.4 | 0.0 | włączyć |
| Przerwanie terapii | 6 | 1.0 | 29.6 | 0.0 | brak konsensusu |
| Całkowity czas snu | 6 | 0.0 | 18.5 | 0.0 | brak konsensusu |
| Koszty terapii | 2 | 1.0 | 0.0 | 100.0 | wyłączyć |
Zwróć uwagę na dwie rzeczy. „Wybudzenia w nocy” i „jakość życia” mają tę samą medianę (7) i ten sam IQR (1), ale różnią się odsetkiem ocen 7–9: 81.5% i 70.4%. Z kolei „całkowity czas snu” ma IQR = 0, a mimo to nie ma konsensusu, bo prawie wszyscy zgodnie dali 6, czyli „ważne, ale nie krytyczne”. Mała rozpiętość ocen oznacza zgodność, ale nie zgodę na włączenie. Dlatego decyzję opieraj na kryterium z protokołu, a medianę i IQR traktuj jako opis.
Stabilność, wrażliwość i rezygnacje
Konsensus po rundzie 3 to nie koniec analizy. Sprawdź trzy rzeczy.
Stabilność między rundami. Mediana bezwzględnej zmiany odsetka ocen 7–9 między rundą 2 a 3 wyniosła 2.95 punktu procentowego, ale dwa wyniki zmieniły się wyraźnie: „całkowity czas snu” o −22.9 pp, a „wybudzenia w nocy” o 11.8 pp i dopiero w rundzie 3 przekroczyły próg. Taki wynik wymaga ostrożności: kolejna runda mogłaby go odwrócić.
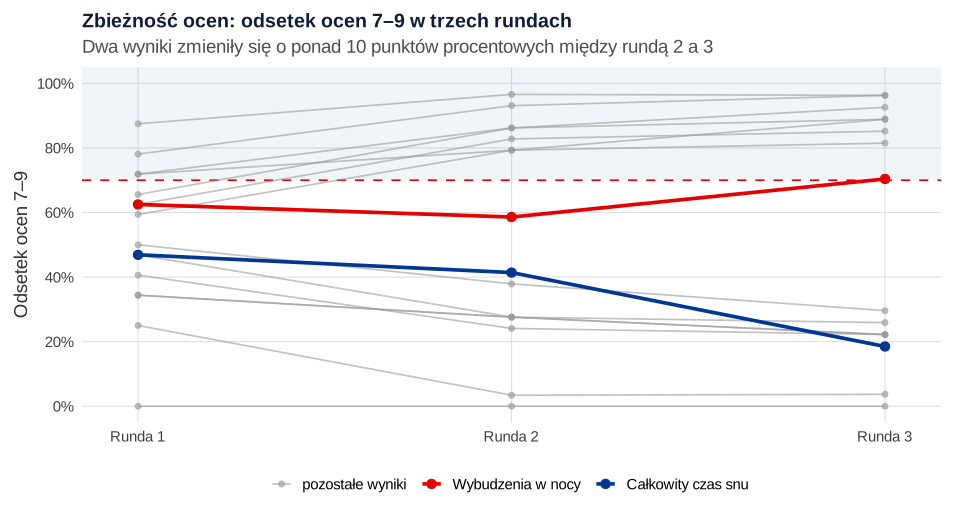
Wrażliwość na definicję. Przy regule „co najmniej 75% ocen 7–9” konsensus „włączyć” ma 7 wyników zamiast 8. Odpada tylko „wybudzenia w nocy” (19 z 27 ocen 7–9, czyli 70.4%). Pozycje leżące tuż przy progu opisz w wynikach osobno albo przekaż do dyskusji na spotkaniu panelu, jeśli protokół to przewiduje.
Rezygnacje. Osoby, które nie dotrwały do rundy 3, odbiegały w rundzie 1 od mediany grupy średnio o 1.49 punktu, a osoby, które zostały – o 1.16. Odpadali więc częściej ci o odmiennych poglądach. Podręcznik COMET ostrzega, że taka utrata uczestników może zawyżać stopień konsensusu (Williamson i in., 2017). Raportuj odsetek odpowiedzi w każdej rundzie i porównaj oceny z rundy 1 u osób, które zostały i które odpadły. Tylko 39% przeglądanych badań podawało odsetek odpowiedzi we wszystkich rundach (Boulkedid i in., 2011).
Jeśli eksperci szeregują pozycje zamiast je oceniać, zgodność rang opiszesz współczynnikiem W Kendalla. Nie myl jednak konsensusu ze zgodnością niezależnych sędziów, mierzoną kappą lub ICC (zob. zgodność sędziów): w metodzie delfickiej eksperci znają opinię grupy i mają ją brać pod uwagę.
Jak opisać badanie delfickie w artykule
Do raportowania użyj listy ACCORD, pierwszej wytycznej dla wszystkich metod konsensusu w biomedycynie. Ma 35 punktów, z czego 21 dotyczy metod (Gattrell i in., 2024). W opiece paliatywnej i pokrewnych dziedzinach przydaje się też standard CREDES (Jünger i in., 2017). Opis powinien zawierać co najmniej: kryteria doboru i skład panelu, źródło pozycji, skalę, treść informacji zwrotnej, kryterium konsensusu ustalone z góry, regułę przechodzenia pozycji między rundami, odsetek odpowiedzi w każdej rundzie i listę pozycji z ich statusem.
Badanie delfickie bywa częścią większego projektu, np. przeglądu systematycznego i metaanalizy, z których pochodzi lista pozycji. Jak zaplanować cały cykl publikacji, opisuje przewodnik doktorat i publikacje, a ankietę dla panelu przygotujesz z pomocą wpisu o narzędziach do ankiet online. Jeśli chcesz, by ktoś sprawdził protokół i analizę rund, zajrzyj do oferty analiz statystycznych dla badaczy.
Metoda delficka w R: mediana, IQR, odsetek zgody i reguła 70/15
Kod tworzy dane trzech rund, liczy dla każdego wyniku medianę, kwartyle, IQR i odsetki ocen 7–9 oraz 1–3, przypisuje status według reguły 70/15, sprawdza stabilność między rundami, wrażliwość na inną definicję konsensusu i różnice między osobami, które zostały i odpadły. Wystarczy podstawowy R, bez dodatkowych pakietów. Kwartyle liczy domyślna metoda quantile(type = 7); inne programy mogą dawać nieco inne IQR, więc podaj w raporcie, jak je liczyłeś.
Trzy rundy delfickie: statystyki, konsensus, stabilność i rezygnacje
R
# Przykład: trzy rundy badania delfickiego – wybór wyników (outcomes) do zestawu podstawowego
# dla badań nad terapią bezsenności u studentów. Panel 32 ekspertów (klinicyści, badacze, osoby z doświadczeniem
# bezsenności), 16 wyników ocenianych na skali 1–9 (1–3 ograniczone znaczenie, 4–6 ważne, 7–9 krytyczne).
# Dane symulowane, set.seed(1220).
set.seed(1220)
wyniki <- c("Nasilenie bezsenności", "Czas zasypiania", "Wybudzenia w nocy", "Całkowity czas snu",
            "Efektywność snu", "Senność w ciągu dnia", "Zmęczenie", "Nastrój depresyjny", "Lęk",
            "Funkcjonowanie w nauce", "Jakość życia", "Leki nasenne", "Działania niepożądane",
            "Satysfakcja z terapii", "Przerwanie terapii", "Koszty terapii")
waga <- c(8.1, 7.3, 6.6, 6.4, 7.0, 7.2, 6.3, 6.0, 5.6, 7.3, 7.6, 6.2, 7.3, 5.2, 5.9, 2.9)   # „prawdziwe” znaczenie
n_eksp <- 32; J <- length(wyniki)
ogranicz <- function(x) { x[] <- pmin(9, pmax(1, round(x))); x }   # skala 1–9
styl <- rnorm(n_eksp, 0, 0.6)                                   # skłonność eksperta do wyższych ocen
r1 <- ogranicz(outer(styl, waga, "+") + matrix(rnorm(n_eksp * J, 0, 1.6), n_eksp))
med1 <- apply(r1, 2, median)
odchylenie <- rowMeans(abs(sweep(r1, 2, med1)))                   # jak bardzo ekspert odbiega od grupy
# rezygnacja po rundzie: częstsza u osób o odmiennych poglądach (źródło błędu z utraty uczestników)
zostaje2 <- runif(n_eksp) > plogis(-2.6 + 1.4 * as.numeric(scale(odchylenie)))
# runda 2: ekspert widzi medianę grupy i swoją ocenę, część osób zbliża się do grupy
r2 <- ogranicz(r1 + 0.45 * sweep(-r1, 2, med1, "+") + matrix(rnorm(n_eksp * J, 0, 0.5), n_eksp))
r2[!zostaje2, ] <- NA
med2 <- apply(r2, 2, median, na.rm = TRUE)
zostaje3 <- zostaje2 & runif(n_eksp) > 0.08
r3 <- ogranicz(r2 + 0.35 * sweep(-r2, 2, med2, "+") + matrix(rnorm(n_eksp * J, 0, 0.4), n_eksp))
r3[!zostaje3, ] <- NA
dane <- do.call(rbind, lapply(1:3, function(r) {
  m <- list(r1, r2, r3)[[r]]
  data.frame(runda = r, ekspert = rep(1:n_eksp, J), wynik = rep(wyniki, each = n_eksp), ocena = as.vector(m))
}))
dane <- dane[!is.na(dane$ocena), ]
write.csv(dane, "../metoda-delficka-oceny-dane.csv", row.names = FALSE)   # plik do pobrania
odp <- sapply(1:3, function(r) length(unique(dane$ekspert[dane$runda == r])))
cat("Odpowiedzi w rundach:", odp, "; odsetek panelu z rundy 1:", round(100 * odp / odp[1], 1), "\n")

# Statystyki dla każdej pozycji w rundzie: mediana, kwartyle, IQR, odsetek ocen 7–9 i 1–3
# Kryterium konsensusu ustalone w protokole (reguła 70/15 opisana w COMET Handbook):
# „konsensus – włączyć”: ≥ 70% ocen 7–9 i ≤ 15% ocen 1–3; „konsensus – wyłączyć”: ≥ 70% ocen 1–3 i ≤ 15% ocen 7–9.
podsumuj <- function(r) {
  d <- dane[dane$runda == r, ]
  do.call(rbind, lapply(wyniki, function(w) {
    x <- d$ocena[d$wynik == w]
    q <- quantile(x, c(.25, .75), type = 7)
    p79 <- 100 * mean(x >= 7); p13 <- 100 * mean(x <= 3)
    status <- if (p79 >= 70 & p13 <= 15) "włączyć" else if (p13 >= 70 & p79 <= 15) "wyłączyć" else "brak konsensusu"
    data.frame(runda = r, wynik = w, n = length(x), Me = median(x), Q1 = q[[1]], Q3 = q[[2]], IQR = q[[2]] - q[[1]],
               proc_7_9 = round(p79, 1), proc_1_3 = round(p13, 1), status = status)
  }))
}
tab <- do.call(rbind, lapply(1:3, podsumuj)); rownames(tab) <- NULL
print(tab[tab$runda == 3, -1][order(-tab$proc_7_9[tab$runda == 3]), ], row.names = FALSE)
cat("\nLiczba pozycji według statusu w kolejnych rundach:\n")
print(table(runda = tab$runda, status = tab$status))

# Zbieżność opinii: mediana IQR w rundach
cat("\nMediana IQR (wszystkie pozycje) w rundach 1–3:", tapply(tab$IQR, tab$runda, median), "\n")
# Stabilność: zmiana odsetka ocen 7–9 między rundą 2 a 3 (w punktach procentowych)
zm <- tab$proc_7_9[tab$runda == 3] - tab$proc_7_9[tab$runda == 2]
cat("Zmiana odsetka 7–9 (runda 3 − runda 2): mediana", median(abs(zm)), "pp, maksimum", max(abs(zm)), "pp\n")
print(data.frame(wynik = wyniki, zmiana_pp = round(zm, 1))[order(-abs(zm)), ][1:3, ], row.names = FALSE)
# odsetek ocen 7–9 w kolejnych rundach (dane do informacji zwrotnej i do rysunku 2)
szer <- reshape(tab[, c("runda", "wynik", "proc_7_9")], idvar = "wynik", timevar = "runda", direction = "wide")
print(szer[order(-szer$proc_7_9.3), ], row.names = FALSE)

# Wrażliwość na definicję konsensusu: próg 75% ocen 7–9 – mediana progów w przeglądzie (Diamond i in., 2014)
t3 <- tab[tab$runda == 3, ]
cat("Runda 3 – włączone wg 70/15:", sum(t3$status == "włączyć"), "; wg ≥ 75% ocen 7–9:", sum(t3$proc_7_9 >= 75), "\n")
print(t3$wynik[t3$status == "włączyć" & t3$proc_7_9 < 75])
cat("Wybudzenia w nocy, runda 3 – oceny 7–9:", sum(dane$ocena[dane$runda == 3 & dane$wynik == "Wybudzenia w nocy"] >= 7), "z", t3$n[1], "\n")

# Błąd z utraty uczestników: czy osoby, które odpadły, oceniały inaczej w rundzie 1?
round(c(odchylenie_zostali = mean(odchylenie[zostaje3]), odchylenie_odpadli = mean(odchylenie[!zostaje3])), 2)
p79_r1_wszyscy <- 100 * colMeans(r1 >= 7)
p79_r1_zostali <- 100 * colMeans(r1[zostaje3, ] >= 7)
cat("Pozycje z ≥ 70% ocen 7–9 w rundzie 1 – wszyscy:", sum(p79_r1_wszyscy >= 70),
    "; tylko osoby obecne w rundzie 3:", sum(p79_r1_zostali >= 70), "\n")
Wynik w R
Odpowiedzi w rundach: 32 29 27 ; odsetek panelu z rundy 1: 100 90.6 84.4
                  wynik  n Me Q1  Q3 IQR proc_7_9 proc_1_3          status
  Nasilenie bezsenności 27  8  8 8.0 0.0     96.3        0         włączyć
  Działania niepożądane 27  8  7 8.0 1.0     96.3        0         włączyć
 Funkcjonowanie w nauce 27  8  7 8.0 1.0     92.6        0         włączyć
        Czas zasypiania 27  8  7 8.0 1.0     88.9        0         włączyć
   Senność w ciągu dnia 27  8  7 8.0 1.0     88.9        0         włączyć
        Efektywność snu 27  7  7 7.5 0.5     85.2        0         włączyć
           Jakość życia 27  7  7 8.0 1.0     81.5        0         włączyć
      Wybudzenia w nocy 27  7  6 7.0 1.0     70.4        0         włączyć
     Przerwanie terapii 27  6  6 7.0 1.0     29.6        0 brak konsensusu
           Leki nasenne 27  6  5 6.5 1.5     25.9        0 brak konsensusu
              Zmęczenie 27  6  6 6.0 0.0     22.2        0 brak konsensusu
     Nastrój depresyjny 27  6  6 6.0 0.0     22.2        0 brak konsensusu
                    Lęk 27  6  5 6.0 1.0     22.2        0 brak konsensusu
     Całkowity czas snu 27  6  6 6.0 0.0     18.5        0 brak konsensusu
  Satysfakcja z terapii 27  5  5 6.0 1.0      3.7        0 brak konsensusu
         Koszty terapii 27  2  2 3.0 1.0      0.0      100        wyłączyć

Liczba pozycji według statusu w kolejnych rundach:
     status
runda brak konsensusu włączyć wyłączyć
    1              11       4        1
    2               8       7        1
    3               7       8        1

Mediana IQR (wszystkie pozycje) w rundach 1–3: 2 1 1
Zmiana odsetka 7–9 (runda 3 − runda 2): mediana 2.95 pp, maksimum 22.9 pp
                wynik zmiana_pp
   Całkowity czas snu     -22.9
    Wybudzenia w nocy      11.8
 Senność w ciągu dnia       9.6
                  wynik proc_7_9.1 proc_7_9.2 proc_7_9.3
  Nasilenie bezsenności       87.5       96.6       96.3
  Działania niepożądane       78.1       93.1       96.3
 Funkcjonowanie w nauce       65.6       86.2       92.6
        Czas zasypiania       71.9       86.2       88.9
   Senność w ciągu dnia       71.9       79.3       88.9
        Efektywność snu       62.5       82.8       85.2
           Jakość życia       59.4       79.3       81.5
      Wybudzenia w nocy       62.5       58.6       70.4
     Przerwanie terapii       50.0       37.9       29.6
           Leki nasenne       46.9       27.6       25.9
              Zmęczenie       40.6       24.1       22.2
     Nastrój depresyjny       34.4       27.6       22.2
                    Lęk       34.4       27.6       22.2
     Całkowity czas snu       46.9       41.4       18.5
  Satysfakcja z terapii       25.0        3.4        3.7
         Koszty terapii        0.0        0.0        0.0
Runda 3 – włączone wg 70/15: 8 ; wg ≥ 75% ocen 7–9: 7
[1] "Wybudzenia w nocy"
Wybudzenia w nocy, runda 3 – oceny 7–9: 19 z 27
odchylenie_zostali odchylenie_odpadli
              1.16               1.49
Pozycje z ≥ 70% ocen 7–9 w rundzie 1 – wszyscy: 4 ; tylko osoby obecne w rundzie 3: 4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje median(), quantile(), reshape() z pakietów base i stats). Rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje pakietów, których faktycznie użyłeś (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w badaniach delfickich
- Kryterium konsensusu ustalone po zobaczeniu wyników. Wtedy łatwo „dopasować” próg do pożądanej listy. Zapisz próg, skalę i liczbę rund przed rundą 1.
- Jedna runda nazwana badaniem delfickim. Bez co najmniej jednej rundy z informacją zwrotną to zwykła ankieta ekspercka (Williamson i in., 2017).
- Średnia i SD zamiast mediany i odsetków. Oceny 1–9 są porządkowe, a rozkłady często skośne. Podawaj medianę, IQR i odsetki ocen w kategoriach.
- Brak odsetka odpowiedzi w każdej rundzie. Bez niego czytelnik nie oceni, czy konsensus nie wynika z odejścia osób o odmiennych poglądach.
- Utożsamianie konsensusu z prawdą. Zgoda ekspertów nie dowodzi skuteczności ani trafności. Opisuje, co panel uznał za ważne w danym czasie i składzie.
- Niejasne „zmodyfikowane” procedury. Jeśli dodałeś spotkanie, rundę otwartą albo zmieniłeś listę pozycji między rundami, opisz to krok po kroku (Jünger i in., 2017).
Najczęstsze pytania
Jak liczyć konsensus w metodzie delfickiej na skali 1–9?
Dla każdej pozycji policz odsetek ocen 7–9 i 1–3 i porównaj je z regułą zapisaną w protokole. Często stosowana reguła 70/15 uznaje pozycję za uzgodnioną do włączenia, gdy co najmniej 70% ekspertów daje 7–9, a najwyżej 15% daje 1–3; odwrotny układ oznacza wyłączenie. Medianę i IQR podaj jako opis rozkładu.
Co pokazać ekspertom między rundami badania delfickiego?
Dla każdej pozycji pokaż podsumowanie ocen grupy: medianę, miarę rozproszenia, odsetek ocen powyżej progu albo cały rozkład, a obok własną ocenę eksperta z poprzedniej rundy. Jeśli w panelu są różne grupy interesariuszy, rozważ wyniki osobno dla każdej z nich. Sposób informacji zwrotnej opisz w protokole i w raporcie.
Czy IQR może być kryterium konsensusu w badaniu delfickim?
Może, jeśli próg zapiszesz w protokole, ale sam IQR mierzy zgodność ocen, a nie zgodę na włączenie. Gdy prawie wszyscy eksperci dają 6, IQR wynosi 0, a pozycja i tak nie jest „krytyczna”. Dlatego IQR łącz z regułą opartą na odsetku ocen w kategoriach.
Co zrobić, gdy eksperci rezygnują w kolejnych rundach?
Raportuj odsetek odpowiedzi w każdej rundzie i porównaj oceny z pierwszej rundy u osób, które zostały i które odpadły. Jeśli odchodzą głównie osoby o odmiennych poglądach, konsensus może być zawyżony. Zapobiegaj temu przypomnieniami, krótkimi kwestionariuszami i rozsądnym czasem na odpowiedź.
Jak opisać badanie delfickie w artykule?
Skorzystaj z listy ACCORD (35 punktów) i opisz: kryteria doboru i skład panelu, źródło pozycji, skalę ocen, treść informacji zwrotnej, kryterium konsensusu ustalone z góry, liczbę rund, odsetek odpowiedzi w każdej rundzie oraz pełną listę pozycji z ich statusem. Pozycje tuż przy progu opisz osobno.
Powiązane hasła
Przeczytaj też
GRADE – pewność danych naukowych
Pięć dziedzin GRADE na przykładzie metaanalizy: ryzyko błędu, niespójność, nieprecyzyjność z progiem i OIS, tabela wyników i gotowy opis.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →Planujesz badanie delfickie?
Pomożemy ustalić kryterium konsensusu i plan rund, przygotować informację zwrotną dla panelu oraz przeanalizować i opisać wyniki zgodnie z ACCORD.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Boulkedid, R., Abdoul, H., Loustau, M., Sibony, O., & Alberti, C. (2011). Using and reporting the Delphi method for selecting healthcare quality indicators: A systematic review. PLoS ONE, 6(6), Article e20476. https://doi.org/10.1371/journal.pone.0020476 ● Otwarty dostęp
- Dalkey, N., & Helmer, O. (1963). An experimental application of the DELPHI method to the use of experts. Management Science, 9(3), 458–467. https://doi.org/10.1287/mnsc.9.3.458
- Diamond, I. R., Grant, R. C., Feldman, B. M., Pencharz, P. B., Ling, S. C., Moore, A. M., & Wales, P. W. (2014). Defining consensus: A systematic review recommends methodologic criteria for reporting of Delphi studies. Journal of Clinical Epidemiology, 67(4), 401–409. https://doi.org/10.1016/j.jclinepi.2013.12.002
- Gattrell, W. T., Logullo, P., van Zuuren, E. J., Price, A., Hughes, E. L., Blazey, P., Winchester, C. C., Tovey, D., Goldman, K., Hungin, A. P., & Harrison, N. (2024). ACCORD (ACcurate COnsensus Reporting Document): A reporting guideline for consensus methods in biomedicine developed via a modified Delphi. PLOS Medicine, 21(1), Article e1004326. https://doi.org/10.1371/journal.pmed.1004326 ● Otwarty dostęp
- Hasson, F., Keeney, S., & McKenna, H. (2000). Research guidelines for the Delphi survey technique. Journal of Advanced Nursing, 32(4), 1008–1015. https://doi.org/10.1046/j.1365-2648.2000.t01-1-01567.x
- Jünger, S., Payne, S. A., Brine, J., Radbruch, L., & Brearley, S. G. (2017). Guidance on Conducting and REporting DElphi Studies (CREDES) in palliative care: Recommendations based on a methodological systematic review. Palliative Medicine, 31(8), 684–706. https://doi.org/10.1177/0269216317690685 ● Otwarty dostęp: pełny tekst
- Schünemann, H., Brożek, J., Guyatt, G., & Oxman, A. (Red.). (2013). GRADE handbook for grading quality of evidence and strength of recommendations (updated October 2013). The GRADE Working Group. https://gdt.gradepro.org/app/handbook/handbook.html ● Otwarty dostęp
- Williamson, P. R., Altman, D. G., Bagley, H., Barnes, K. L., Blazeby, J. M., Brookes, S. T., Clarke, M., Gargon, E., Gorst, S., Harman, N., Kirkham, J. J., McNair, A., Prinsen, C. A. C., Schmitt, J., Terwee, C. B., & Young, B. (2017). The COMET Handbook: Version 1.0. Trials, 18(S3), Article 280. https://doi.org/10.1186/s13063-017-1978-4 ● Otwarty dostęp
Cytowania BibTeX
@article{boulkedid2011using, author={Boulkedid, Rym and Abdoul, Hendy and Loustau, Marine and Sibony, Olivier and Alberti, Corinne}, title={{Using and reporting the Delphi method for selecting healthcare quality indicators: A systematic review}}, journal={PLoS ONE}, year={2011}, volume={6}, number={6}, eid={e20476}, doi={10.1371/journal.pone.0020476}}@article{dalkey1963experimental, author={Dalkey, Norman and Helmer, Olaf}, title={{An experimental application of the DELPHI method to the use of experts}}, journal={Management Science}, year={1963}, volume={9}, number={3}, pages={458--467}, doi={10.1287/mnsc.9.3.458}}@article{diamond2014defining, author={Diamond, Ivan R. and Grant, Robert C. and Feldman, Brian M. and Pencharz, Paul B. and Ling, Simon C. and Moore, Aideen M. and Wales, Paul W.}, title={{Defining consensus: A systematic review recommends methodologic criteria for reporting of Delphi studies}}, journal={Journal of Clinical Epidemiology}, year={2014}, volume={67}, number={4}, pages={401--409}, doi={10.1016/j.jclinepi.2013.12.002}}@article{gattrell2024accord, author={Gattrell, William T. and Logullo, Patricia and van Zuuren, Esther J. and Price, Amy and Hughes, Ellen L. and Blazey, Paul and Winchester, Christopher C. and Tovey, David and Goldman, Keith and Hungin, Amrit Pali and Harrison, Niall}, title={{ACCORD (ACcurate COnsensus Reporting Document): A reporting guideline for consensus methods in biomedicine developed via a modified Delphi}}, journal={PLOS Medicine}, year={2024}, volume={21}, number={1}, eid={e1004326}, doi={10.1371/journal.pmed.1004326}}@article{hasson2000research, author={Hasson, Felicity and Keeney, Sinead and McKenna, Hugh}, title={{Research guidelines for the Delphi survey technique}}, journal={Journal of Advanced Nursing}, year={2000}, volume={32}, number={4}, pages={1008--1015}, doi={10.1046/j.1365-2648.2000.t01-1-01567.x}}@article{junger2017guidance, author={Jünger, Saskia and Payne, Sheila A. and Brine, Jenny and Radbruch, Lukas and Brearley, Sarah G.}, title={{Guidance on Conducting and REporting DElphi Studies (CREDES) in palliative care: Recommendations based on a methodological systematic review}}, journal={Palliative Medicine}, year={2017}, volume={31}, number={8}, pages={684--706}, doi={10.1177/0269216317690685}}@misc{schunemann2013grade, author={Schünemann, Holger and Brożek, Jan and Guyatt, Gordon and Oxman, Andrew}, title={{GRADE handbook for grading quality of evidence and strength of recommendations (updated October 2013)}}, year={2013}, publisher={The GRADE Working Group}, url={https://gdt.gradepro.org/app/handbook/handbook.html}}@article{williamson2017comet, author={Williamson, Paula R. and Altman, Douglas G. and Bagley, Heather and Barnes, Karen L. and Blazeby, Jane M. and Brookes, Sara T. and Clarke, Mike and Gargon, Elizabeth and Gorst, Sarah and Harman, Nicola and Kirkham, Jamie J. and McNair, Angus and Prinsen, Cecilia A. C. and Schmitt, Jochen and Terwee, Caroline B. and Young, Bridget}, title={{The COMET Handbook: Version 1.0}}, journal={Trials}, year={2017}, volume={18}, number={S3}, eid={280}, doi={10.1186/s13063-017-1978-4}}