Co ocenia GRADE, a czego nie
GRADE (Grading of Recommendations Assessment, Development and Evaluation) odpowiada na pytanie, na ile możesz ufać oszacowaniu efektu z przeglądu systematycznego. Nie ocenia pojedynczych artykułów. Ocenia zbiór danych dla jednego wyniku, np. „lęk po interwencji” albo „rezygnacja z terapii”, w czterech kategoriach: wysoka, umiarkowana, niska i bardzo niska (Balshem i in., 2011). Powstał, bo wytyczne kliniczne niespójnie oceniały jakość danych i siłę zaleceń, i przyjmuje go coraz więcej organizacji na świecie (Guyatt i in., 2008).
Podręcznik GRADE opisuje każdy poziom słowami, które warto przenieść do pracy (Schünemann i in., 2013). Część jego rozdziałów zaktualizowano w nowszej wersji online, GRADE Book, więc przed pisaniem protokołu sprawdź aktualne brzmienie.
| Pewność | Co oznacza |
|---|---|
| Wysoka | Prawdziwy efekt jest bardzo prawdopodobnie bliski oszacowaniu. |
| Umiarkowana | Prawdziwy efekt jest prawdopodobnie bliski oszacowaniu, ale może się od niego istotnie różnić. |
| Niska | Zaufanie jest ograniczone: prawdziwy efekt może się istotnie różnić od oszacowania. |
| Bardzo niska | Zaufanie jest bardzo małe: prawdziwy efekt prawdopodobnie istotnie różni się od oszacowania. |
Dwie rzeczy GRADE trzyma osobno. Po pierwsze, pewność danych to nie ryzyko błędu w pojedynczym badaniu. To ocenia się wcześniej narzędziami takimi jak RoB 2 czy ROBINS-I; ich domeny opisuje wpis o ocenie ryzyka błędu. Po drugie, pewność danych to nie siła zalecenia. Siła zalecenia zależy także od bilansu korzystnych i niekorzystnych skutków porównywanych opcji (Guyatt i in., 2011, część 1 serii). Autor przeglądu systematycznego ocenia pewność osobno dla każdego wyniku i nie formułuje zaleceń; łączną ocenę dla wszystkich wyników krytycznych wydaje panel tworzący wytyczne (Schünemann i in., 2013).
Ocena pewności krok po kroku
- Ustal wyniki i ich znaczenie przed zebraniem danych. Podręcznik proponuje skalę 1–9: 7–9 to wyniki krytyczne, 4–6 ważne, 1–3 o ograniczonym znaczeniu (Schünemann i in., 2013). Taką listę często ustala się metodą delficką.
- Określ punkt startu. Dane z badań z randomizacją zaczynają od pewności wysokiej, a dane z badań obserwacyjnych, np. kohortowych, od niskiej (Balshem i in., 2011).
- Przejdź przez pięć dziedzin obniżających pewność. Każda może obniżyć ocenę o jeden poziom (problem poważny) albo o dwa (bardzo poważny).
- Rozważ trzy czynniki podwyższające. Duży efekt może podnieść ocenę o jeden lub dwa poziomy, a gradient dawka–odpowiedź i wiarygodne zakłócanie działające przeciw obserwowanemu efektowi – o jeden. Rozważ je dopiero po dziedzinach obniżających i rzadko wtedy, gdy w którejś z nich są poważne ograniczenia (Schünemann i in., 2013).
- Zapisz wynik z uzasadnieniem w tabeli podsumowania wyników (summary of findings) albo w profilu danych, który pokazuje ocenę każdej dziedziny (Guyatt i in., 2011, część 1 serii).
| Dziedzina | Pytanie kontrolne | Co sprawdzić w analizie |
|---|---|---|
| Ryzyko błędu | Czy duża część wagi pochodzi z badań o wysokim ryzyku błędu? | udział wagi takich badań; analiza wrażliwości bez nich |
| Niespójność | Czy wyniki badań wskazują na różne wnioski? | nakładanie się przedziałów, I² i τ, przedział predykcji |
| Pośredniość | Czy populacja, interwencja, porównanie i wynik odpowiadają pytaniu? | ocena merytoryczna, bez testu statystycznego |
| Nieprecyzyjność | Czy decyzja byłaby inna przy dolnej i górnej granicy 95% CI? | przedział ufności względem progu; optymalna liczebność (OIS) |
| Błąd publikacji | Czy mogą brakować badań z wynikami nieistotnymi? | wykres lejkowy, test Eggera, rejestry badań |
Podręcznik ostrzega przed mechanicznym sumowaniem punktów. Dziedziny nie są niezależnymi „karami”, tylko pomocą w uporządkowaniu osądu, który ostatecznie dotyczy jednego pytania: na ile ufasz oszacowaniu (Schünemann i in., 2013).
Przykład: program uważności online a lęk u studentów
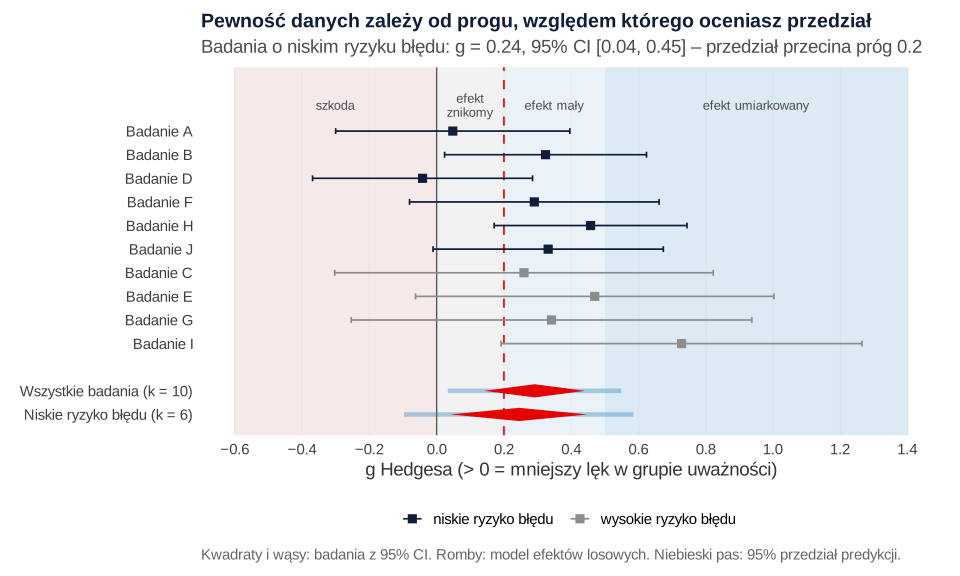
Przegląd systematyczny objął dziesięć badań z randomizacją, w których program uważności online porównano z listą oczekujących (dane symulowane). Wynikiem jest nasilenie lęku po interwencji. Efekt opisuje g Hedgesa (odmiana standaryzowanej różnicy średnich), z dodatnim znakiem dla mniejszego lęku w grupie uważności. Badania obejmowały łącznie 1088 osób. Cztery z nich, wszystkie małe (44–57 osób), oceniono w RoB 2 jako badania o wysokim ryzyku błędu. Dane możesz pobrać: grade-przyklad-dane.csv.
Model efektów losowych (REML z poprawką Knappa–Hartunga, jak we wpisie metaanaliza krok po kroku) dla wszystkich badań dał g = 0.29, 95% CI [0.14, 0.44], t(9) = 4.41, p = .002. Sama istotność nie mówi jednak nic o pewności. Tę ocenisz dopiero po przejściu przez dziedziny.
Pięć dziedzin na danych z przykładu
Ryzyko błędu
Badania o wysokim ryzyku błędu wnoszą 21.4% wagi modelu i dają wyraźnie większe efekty. Seria GRADE odradza uśrednianie ryzyka błędu między badaniami. Gdy część badań ma niskie, a część wysokie ryzyko, zaleca rozważyć oparcie wniosku na badaniach o niższym ryzyku (Guyatt i in., 2011, część 4 serii). Model tylko dla sześciu takich badań (882 osoby) dał g = 0.24, 95% CI [0.04, 0.45]. Test różnicy między podgrupami był nieistotny: różnica 0.21, 95% CI [−0.14, 0.57], F(1, 8) = 1.93, p = .202, ale przy dziesięciu badaniach ma on małą moc. Wniosek opieramy więc na sześciu badaniach i nie obniżamy za ryzyko błędu. Gdybyśmy raportowali efekt ze wszystkich badań, trzeba by tę dziedzinę obniżyć.
Niespójność
W badaniach o niskim ryzyku błędu I² = 29.05%, τ = 0.11, Q(5) = 6.87, p = .231. Przedziały ufności się nakładają, ale przedział predykcji sięga od −0.10 do 0.59. Seria GRADE wskazuje, że obniżenie jest najbardziej uzasadnione, gdy niespójność jest duża i niewyjaśniona, zwłaszcza gdy jedne badania pokazują wyraźną korzyść, a inne brak efektu (Guyatt i in., 2011, część 7 serii). Tu dwa badania mają efekt bliski zeru, a reszta mały. To decyzja graniczna: nie obniżamy, ale piszemy to wprost, by recenzent mógł ją ocenić.
Pośredniość
Pytanie dotyczyło studentów, programu online i lęku mierzonego kwestionariuszem. Badania odpowiadały temu pytaniu, więc nie obniżamy. Podręcznik wymienia cztery źródła pośredniości: inną populację, inną interwencję, inny wynik (np. zastępczy) oraz brak bezpośredniego porównania interesujących cię opcji (Schünemann i in., 2013).
Nieprecyzyjność
Tu decyduje próg. Według GRADE pewność dotyczy tego, że prawdziwy efekt leży po jednej stronie progu albo w wybranym zakresie, a autor przeglądu powinien ten próg podać (Hultcrantz i in., 2017). W protokole przyjęliśmy zakresy z konwencji Cohena (1992): poniżej 0.2 efekt znikomy, 0.2–0.5 mały, powyżej 0.5 umiarkowany. Przedział [0.04, 0.45] wyklucza zero, ale obejmuje efekt znikomy i mały, więc decyzja przy jego dolnej i górnej granicy byłaby inna. To podstawowe kryterium obniżenia za nieprecyzyjność (Guyatt i in., 2011, część 6 serii).
Drugim kryterium jest optymalna liczebność (OIS), czyli liczba osób w jednym badaniu o odpowiedniej mocy. Dla d = 0.2, α = .05 i mocy .80 to 394 osoby na grupę, czyli 788 łącznie (to samo policzysz w kalkulatorze liczebności próby). Badania o niskim ryzyku objęły 882 osoby, więc kryterium OIS jest spełnione. Przedział przecina jednak próg, dlatego obniżamy o jeden poziom. Gdyby próg wynosił zero („czy program w ogóle działa”), tej dziedziny nie trzeba by obniżać. Ten sam przedział daje więc różną pewność dla różnych pytań.
W punktach skali lęku (mediana SD w grupach kontrolnych: 4.55) efekt odpowiada różnicy 1.11 punktu, 95% CI [0.19, 2.03]. Czy to dużo, zależy od minimalnej istotnej klinicznie różnicy dla użytego narzędzia. Podręcznik zaleca właśnie przy SMD liczyć OIS dla konkretnego narzędzia z ustaloną minimalną ważną różnicą (Schünemann i in., 2013).
Błąd publikacji
Test Eggera dla dziesięciu badań: t(8) = 0.93, p = .382. Przy tak małej liczbie badań test ma małą moc, a wykres lejkowy i podobne metody mają poważne ograniczenia (Guyatt i in., 2011, część 5 serii). Ta sama seria zaleca podejrzewać błąd publikacji, gdy dane pochodzą z wielu małych badań finansowanych komercyjnie. Małe badania z przykładu wyłączyliśmy już z wniosku z powodu ryzyka błędu, a w rejestrach nie znaleziono niepublikowanych badań (założenie przykładu). Nie obniżamy.
Tabela podsumowania wyników i opis w artykule
Wynik: start od pewności wysokiej (RCT), jedno obniżenie za nieprecyzyjność, czyli pewność umiarkowana. W tabeli podsumowania wyników podaj dla każdego wyniku liczbę badań i osób, efekt z przedziałem, pewność i przypisy z powodami obniżeń (Guyatt i in., 2011, część 1 serii).
| Wynik | Badania (osoby) | Efekt, 95% CI | Pewność | Uzasadnienie |
|---|---|---|---|---|
| Lęk po interwencji (kwestionariusz samoopisowy) | 6 RCT (882) | g = 0.24 [0.04, 0.45]; ok. 1.11 pkt mniej [0.19, 2.03] | Umiarkowana | −1 nieprecyzyjność: przedział obejmuje efekt znikomy i mały; wyłączono 4 badania o wysokim ryzyku błędu |
W streszczeniu i dyskusji dopasuj język do poziomu pewności: przy pewności umiarkowanej piszesz, że program „prawdopodobnie” zmniejsza lęk, a przy niskiej – że „może” go zmniejszać. Jak przygotować cały artykuł z przeglądem do publikacji, opisuje przewodnik doktorat i publikacje. Jeśli potrzebujesz pomocy w metaanalizie i ocenie GRADE, zajrzyj do oferty analiz statystycznych dla badaczy.
GRADE w R: dane do pięciu dziedzin z jednego skryptu
Kod liczy wszystkie liczby z tekstu, tabeli i rysunku: metaanalizę wszystkich badań i badań o niskim ryzyku błędu, I², τ i przedział predykcji, optymalną liczebność, test Eggera i efekt w punktach skali. Rysunek powstaje w osobnym skrypcie z tymi samymi danymi. Samą ocenę dziedzin wpisujesz ręcznie: R dostarcza liczby, a osąd należy do ciebie.
Metaanaliza i liczby do oceny GRADE
R
# Przykład: ocena pewności danych GRADE dla jednego wyniku przeglądu systematycznego
# Pytanie: czy program uważności online zmniejsza nasilenie lęku u studentów w porównaniu z listą oczekujących?
# 10 badań RCT (dane symulowane, set.seed(1210)); wynik: lęk po interwencji, niższy = lepiej.
# g > 0 oznacza mniejszy lęk w grupie uważności (różnica: kontrolna − interwencja).
suppressPackageStartupMessages(library(metafor))
set.seed(1210)
k <- 10
badania <- data.frame(
  badanie = paste0("Badanie ", LETTERS[1:k]),
  rob     = c("niskie", "niskie", "wysokie", "niskie", "wysokie", "niskie", "wysokie", "niskie", "wysokie", "niskie"),
  n_i     = c(62, 85, 24, 70, 30, 58, 22, 95, 28, 66))
badania$n_k <- badania$n_i + sample(-4:4, k, replace = TRUE)
# prawdziwe efekty: mniejsze w badaniach o niskim ryzyku błędu, większe w małych badaniach o wysokim ryzyku
delta <- ifelse(badania$rob == "niskie", 0.22, 0.60) + rnorm(k, 0, 0.12)
sd_k <- round(runif(k, 4.0, 5.2), 1); sd_i <- round(sd_k * runif(k, 0.9, 1.05), 1)
m_k  <- round(runif(k, 11, 13), 1)
badania$m_k <- m_k; badania$sd_k <- sd_k; badania$sd_i <- sd_i
badania$m_i <- round(m_k - (delta + rnorm(k, 0, 1 / sqrt(badania$n_i))) * sd_k, 1)
write.csv(badania, "../grade-przyklad-dane.csv", row.names = FALSE)   # plik do pobrania
# g Hedgesa: kontrolna − interwencja, żeby korzyść miała znak dodatni
dane <- escalc(measure = "SMD", m1i = m_k, sd1i = sd_k, n1i = n_k, m2i = m_i, sd2i = sd_i, n2i = n_i, data = badania)
print(data.frame(badanie = dane$badanie, rob = dane$rob, N = dane$n_i + dane$n_k,
                 g = round(dane$yi, 2), SE = round(sqrt(dane$vi), 2)))
cat("Łączna liczba osób:", sum(dane$n_i + dane$n_k), "\n")

# 1. Model efektów losowych (REML, poprawka Knappa–Hartunga) – wszystkie badania
m_all <- rma(yi, vi, data = dane, method = "REML", test = "knha")
print(m_all)
pr_all <- predict(m_all, digits = 2); print(pr_all)

# 2. Ryzyko błędu: analiza wrażliwości tylko na badaniach o niskim ryzyku błędu
m_low <- rma(yi, vi, data = dane, subset = rob == "niskie", method = "REML", test = "knha")
print(m_low)
pr_low <- predict(m_low, digits = 2); print(pr_low)
cat("Liczba osób w badaniach o niskim ryzyku błędu:", sum((dane$n_i + dane$n_k)[dane$rob == "niskie"]), "\n")
# test różnicy między podgrupami (moderator: ryzyko błędu)
print(rma(yi, vi, mods = ~ rob, data = dane, method = "REML", test = "knha"))

# 3. Niespójność: I², τ, przedział predykcji (z modelu dla wszystkich badań i dla niskiego ryzyka)
round(c(I2_wszystkie = m_all$I2, tau_wszystkie = sqrt(m_all$tau2), I2_niskie = m_low$I2, tau_niskie = sqrt(m_low$tau2)), 2)

# 4. Nieprecyzyjność: przedział ufności względem progu małego efektu (g = 0.2) i optymalna liczebność (OIS)
prog <- 0.2
cat("CI (niskie ryzyko) obejmuje próg 0.2:", m_low$ci.lb < prog & m_low$ci.ub > prog, "\n")
ois <- power.t.test(delta = prog, sd = 1, sig.level = .05, power = .80)
print(ois)
cat("OIS (łącznie, dwie grupy):", 2 * ceiling(ois$n), "\n")

# 5. Błąd publikacji: test Eggera (przy 10 badaniach ma małą moc)
eg <- regtest(m_all, model = "rma", predictor = "sei")
round(c(t = eg$zval, df = eg$dfs, p = eg$pval), 3)

# 6. Efekt w punktach skali: g × mediana SD w grupach kontrolnych (badania o niskim ryzyku)
sd_med <- median(dane$sd_k[dane$rob == "niskie"])
round(c(SD_mediana = sd_med, roznica_pkt = m_low$b[1] * sd_med,
        CI_dolna = m_low$ci.lb * sd_med, CI_gorna = m_low$ci.ub * sd_med), 2)

# 7. Udział badań o wysokim ryzyku błędu w wadze modelu dla wszystkich badań
round(tapply(weights(m_all), dane$rob, sum), 1)

# 8. Ocena GRADE dla wniosku z badań o niskim ryzyku błędu: start z RCT (wysoka),
#    obniżenie o 1 poziom za każdą dziedzinę ocenioną jako „poważny problem” (decyzje opisane w tekście)
poziomy <- c("bardzo niska", "niska", "umiarkowana", "wysoka")
ocena <- c(ryzyko_bledu = 0, niespojnosc = 0, posredniosc = 0, nieprecyzyjnosc = 1, blad_publikacji = 0)
cat("Pewność danych:", poziomy[max(1, 4 - sum(ocena))], "\n")
Wynik w R
     badanie     rob   N     g   SE
1  Badanie A  niskie 127  0.05 0.18
2  Badanie B  niskie 173  0.32 0.15
3  Badanie C wysokie  49  0.26 0.29
4  Badanie D  niskie 144 -0.04 0.17
5  Badanie E wysokie  56  0.47 0.27
6  Badanie F  niskie 113  0.29 0.19
7  Badanie G wysokie  44  0.34 0.30
8  Badanie H  niskie 192  0.46 0.15
9  Badanie I wysokie  57  0.73 0.27
10 Badanie J  niskie 133  0.33 0.17
Łączna liczba osób: 1088

Random-Effects Model (k = 10; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0086 (SE = 0.0213)
tau (square root of estimated tau^2 value):      0.0928
I^2 (total heterogeneity / total variability):   18.35%
H^2 (total variability / sampling variability):  1.22

Test for Heterogeneity:
Q(df = 9) = 10.2749, p-val = 0.3287

Model Results:

estimate      se    tval  df    pval   ci.lb   ci.ub
  0.2907  0.0660  4.4079   9  0.0017  0.1415  0.4399  **

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


 pred   se ci.lb ci.ub pi.lb pi.ub
 0.29 0.07  0.14  0.44  0.03  0.55


Random-Effects Model (k = 6; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0114 (SE = 0.0247)
tau (square root of estimated tau^2 value):      0.1065
I^2 (total heterogeneity / total variability):   29.05%
H^2 (total variability / sampling variability):  1.41

Test for Heterogeneity:
Q(df = 5) = 6.8667, p-val = 0.2307

Model Results:

estimate      se    tval  df    pval   ci.lb   ci.ub
  0.2440  0.0790  3.0880   5  0.0272  0.0409  0.4472  *

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


 pred   se ci.lb ci.ub pi.lb pi.ub
 0.24 0.08  0.04  0.45 -0.10  0.59

Liczba osób w badaniach o niskim ryzyku błędu: 882

Mixed-Effects Model (k = 10; tau^2 estimator: REML)

tau^2 (estimated amount of residual heterogeneity):     0.0075 (SE = 0.0212)
tau (square root of estimated tau^2 value):             0.0864
I^2 (residual heterogeneity / unaccounted variability): 16.90%
H^2 (unaccounted variability / sampling variability):   1.20
R^2 (amount of heterogeneity accounted for):            13.20%

Test for Residual Heterogeneity:
QE(df = 8) = 8.4673, p-val = 0.3892

Test of Moderators (coefficient 2):
F(df1 = 1, df2 = 8) = 1.9329, p-val = 0.2019

Model Results:

            estimate      se    tval  df    pval    ci.lb   ci.ub
intrcpt       0.2453  0.0706  3.4734   8  0.0084   0.0824  0.4081  **
robwysokie    0.2137  0.1537  1.3903   8  0.2019  -0.1407  0.5680

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

 I2_wszystkie tau_wszystkie     I2_niskie    tau_niskie
        18.35          0.09         29.05          0.11
CI (niskie ryzyko) obejmuje próg 0.2: TRUE

     Two-sample t test power calculation

              n = 393.4067
          delta = 0.2
             sd = 1
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

OIS (łącznie, dwie grupy): 788
    t    df     p
0.926 8.000 0.382
 SD_mediana roznica_pkt    CI_dolna    CI_gorna
       4.55        1.11        0.19        2.03
 niskie wysokie
   78.6    21.4
Pewność danych: umiarkowana
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja power.t.test() z pakietu stats). Rysunek przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje pakietów, których faktycznie użyłeś (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy przy ocenie GRADE
- Jedna ocena dla całego przeglądu. Pewność ocenia się osobno dla każdego wyniku. Ten sam zbiór badań może dać wysoką pewność dla lęku i niską dla rezygnacji z terapii.
- Ocena nieprecyzyjności bez progu. „Przedział wyklucza zero” to tylko jeden z możliwych progów. Podaj w protokole, względem jakiego progu lub zakresu oceniasz (Hultcrantz i in., 2017).
- Uśrednianie ryzyka błędu. Sześć dobrych i cztery słabe badania to nie „średnio umiarkowane ryzyko”. Sprawdź, ile wagi mają słabe badania i jak zmienia się wynik bez nich.
- Obniżanie za samo I². I² zależy od precyzji badań. Patrz na τ, przedział predykcji i na to, czy różnice prowadzą do innych wniosków.
- Podwójne karanie. Ten sam problem obniżaj tylko raz. Gdy niespójność wynika z badań o wysokim ryzyku błędu, a wniosek opierasz na pozostałych, nie obniżaj już za niespójność.
- Mylenie GRADE z oceną przeglądu. Jakość metodologiczną całego przeglądu ocenia AMSTAR 2, a nie GRADE.
Najczęstsze pytania
Kiedy obniżyć pewność danych za nieprecyzyjność w GRADE?
Gdy decyzja byłaby inna, gdyby prawdą była dolna, a inna, gdyby górna granica 95% przedziału ufności. Dlatego najpierw ustal w protokole próg lub zakresy efektu (np. efekt znikomy poniżej g = 0.2). Drugim kryterium jest optymalna liczebność: łączna liczba osób powinna odpowiadać co najmniej jednemu badaniu o odpowiedniej mocy.
Co to jest optymalna liczebność (OIS) w GRADE?
To liczba osób, jakiej potrzebowałoby jedno badanie o odpowiedniej mocy, by wykryć przyjęty efekt. Liczysz ją jak zwykłą analizę mocy, np. dla d = 0.2, α = .05 i mocy .80 wychodzi 394 osoby na grupę. Jeśli łączna liczebność badań w metaanalizie jest mniejsza, rozważ obniżenie pewności, nawet gdy przedział ufności wygląda dobrze.
Czym różni się pewność danych od siły zalecenia?
Pewność danych mówi, na ile ufasz oszacowaniu efektu. Siła zalecenia (silne albo słabe, warunkowe) zależy także od bilansu korzyści i szkód. Autor przeglądu systematycznego ocenia tylko pewność, osobno dla każdego wyniku; zalecenia formułuje panel tworzący wytyczne.
Czy wysokie I² zawsze oznacza obniżenie pewności za niespójność?
Nie. I² rośnie wraz z precyzją badań, więc przy dużych badaniach bywa wysokie nawet przy małych różnicach efektów. Sprawdź, czy wyniki prowadzą do różnych wniosków: czy część badań pokazuje wyraźną korzyść, a część brak efektu, jak szeroki jest przedział predykcji i czy różnice wyjaśniają hipotezy zapisane w protokole.
Jak opisać ocenę GRADE w artykule?
W metodach napisz, że pewność oceniano w systemie GRADE osobno dla każdego wyniku, i podaj próg decyzji. W wynikach podaj efekt z 95% CI, poziom pewności i powód każdego obniżenia, najlepiej w tabeli podsumowania wyników z przypisami. W streszczeniu dopasuj język do pewności, np. „prawdopodobnie zmniejsza” przy pewności umiarkowanej.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikOcena ryzyka błędu: RoB 2, ROBINS-I
Które narzędzie do jakiego badania, domeny i ocena ogólna RoB 2 i ROBINS-I, skala NOS, zgodność oceniających i analiza wrażliwości – z kodem R.
Czytaj →PoradnikPrzegląd zakresu (scoping review)
Kiedy wybrać scoping review, pytanie według PCC, selekcja z pilotażem kappa, formularz ekstrakcji, mapa dowodów i raport PRISMA-ScR – z kodem R.
Czytaj →Oceniasz pewność danych w przeglądzie systematycznym?
Pomożemy przygotować metaanalizę, analizy wrażliwości i tabelę podsumowania wyników GRADE tak, by każda decyzja miała uzasadnienie w danych.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Balshem, H., Helfand, M., Schünemann, H. J., Oxman, A. D., Kunz, R., Brozek, J., Vist, G. E., Falck-Ytter, Y., Meerpohl, J., Norris, S., & Guyatt, G. H. (2011). GRADE guidelines: 3. Rating the quality of evidence. Journal of Clinical Epidemiology, 64(4), 401–406. https://doi.org/10.1016/j.jclinepi.2010.07.015
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Guyatt, G. H., Oxman, A. D., Kunz, R., Brozek, J., Alonso-Coello, P., Rind, D., Devereaux, P. J., Montori, V. M., Freyschuss, B., Vist, G., Jaeschke, R., Williams, J. W., Jr., Murad, M. H., Sinclair, D., Falck-Ytter, Y., Meerpohl, J., Whittington, C., Thorlund, K., Andrews, J., & Schünemann, H. J. (2011). GRADE guidelines 6. Rating the quality of evidence—imprecision. Journal of Clinical Epidemiology, 64(12), 1283–1293. https://doi.org/10.1016/j.jclinepi.2011.01.012
- Guyatt, G. H., Oxman, A. D., Kunz, R., Woodcock, J., Brozek, J., Helfand, M., Alonso-Coello, P., Glasziou, P., Jaeschke, R., Akl, E. A., Norris, S., Vist, G., Dahm, P., Shukla, V. K., Higgins, J., Falck-Ytter, Y., & Schünemann, H. J. (2011). GRADE guidelines: 7. Rating the quality of evidence—inconsistency. Journal of Clinical Epidemiology, 64(12), 1294–1302. https://doi.org/10.1016/j.jclinepi.2011.03.017
- Guyatt, G. H., Oxman, A. D., Montori, V., Vist, G., Kunz, R., Brozek, J., Alonso-Coello, P., Djulbegovic, B., Atkins, D., Falck-Ytter, Y., Williams, J. W., Jr., Meerpohl, J., Norris, S. L., Akl, E. A., & Schünemann, H. J. (2011). GRADE guidelines: 5. Rating the quality of evidence—publication bias. Journal of Clinical Epidemiology, 64(12), 1277–1282. https://doi.org/10.1016/j.jclinepi.2011.01.011
- Guyatt, G. H., Oxman, A. D., Vist, G. E., Kunz, R., Falck-Ytter, Y., Alonso-Coello, P., & Schünemann, H. J. (2008). GRADE: An emerging consensus on rating quality of evidence and strength of recommendations. BMJ, 336(7650), 924–926. https://doi.org/10.1136/bmj.39489.470347.ad ● Otwarty dostęp
- Guyatt, G. H., Oxman, A. D., Vist, G., Kunz, R., Brozek, J., Alonso-Coello, P., Montori, V., Akl, E. A., Djulbegovic, B., Falck-Ytter, Y., Norris, S. L., Williams, J. W., Jr., Atkins, D., Meerpohl, J., & Schünemann, H. J. (2011). GRADE guidelines: 4. Rating the quality of evidence—study limitations (risk of bias). Journal of Clinical Epidemiology, 64(4), 407–415. https://doi.org/10.1016/j.jclinepi.2010.07.017
- Guyatt, G., Oxman, A. D., Akl, E. A., Kunz, R., Vist, G., Brozek, J., Norris, S., Falck-Ytter, Y., Glasziou, P., DeBeer, H., Jaeschke, R., Rind, D., Meerpohl, J., Dahm, P., & Schünemann, H. J. (2011). GRADE guidelines: 1. Introduction—GRADE evidence profiles and summary of findings tables. Journal of Clinical Epidemiology, 64(4), 383–394. https://doi.org/10.1016/j.jclinepi.2010.04.026
- Hultcrantz, M., Rind, D., Akl, E. A., Treweek, S., Mustafa, R. A., Iorio, A., Alper, B. S., Meerpohl, J. J., Murad, M. H., Ansari, M. T., Katikireddi, S. V., Östlund, P., Tranæus, S., Christensen, R., Gartlehner, G., Brozek, J., Izcovich, A., Schünemann, H., & Guyatt, G. (2017). The GRADE Working Group clarifies the construct of certainty of evidence. Journal of Clinical Epidemiology, 87, 4–13. https://doi.org/10.1016/j.jclinepi.2017.05.006 ● Otwarty dostęp
- Schünemann, H., Brożek, J., Guyatt, G., & Oxman, A. (Red.). (2013). GRADE handbook for grading quality of evidence and strength of recommendations (updated October 2013). The GRADE Working Group. https://gdt.gradepro.org/app/handbook/handbook.html ● Otwarty dostęp
Cytowania BibTeX
@article{balshem2011grade, author={Balshem, H. and Helfand, M. and Schünemann, H. J. and Oxman, A. D. and Kunz, R. and Brozek, J. and Vist, G. E. and Falck-Ytter, Y. and Meerpohl, J. and Norris, S. and Guyatt, G. H.}, title={{GRADE guidelines: 3. Rating the quality of evidence}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={4}, pages={401--406}, doi={10.1016/j.jclinepi.2010.07.015}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{guyatt2011imprecision, author={Guyatt, Gordon H. and Oxman, Andrew D. and Kunz, Regina and Brozek, Jan and Alonso-Coello, Pablo and Rind, David and Devereaux, P. J. and Montori, Victor M. and Freyschuss, Bo and Vist, Gunn and Jaeschke, Roman and Williams, John W., Jr. and Murad, Mohammad Hassan and Sinclair, David and Falck-Ytter, Yngve and Meerpohl, Joerg and Whittington, Craig and Thorlund, Kristian and Andrews, Jeff and Schünemann, Holger J.}, title={{GRADE guidelines 6. Rating the quality of evidence—imprecision}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={12}, pages={1283--1293}, doi={10.1016/j.jclinepi.2011.01.012}}@article{guyatt2011inconsistency, author={Guyatt, Gordon H. and Oxman, Andrew D. and Kunz, Regina and Woodcock, James and Brozek, Jan and Helfand, Mark and Alonso-Coello, Pablo and Glasziou, Paul and Jaeschke, Roman and Akl, Elie A. and Norris, Susan and Vist, Gunn and Dahm, Philipp and Shukla, Vijay K. and Higgins, Julian and Falck-Ytter, Yngve and Schünemann, Holger J.}, title={{GRADE guidelines: 7. Rating the quality of evidence—inconsistency}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={12}, pages={1294--1302}, doi={10.1016/j.jclinepi.2011.03.017}}@article{guyatt2011publication, author={Guyatt, Gordon H. and Oxman, Andrew D. and Montori, Victor and Vist, Gunn and Kunz, Regina and Brozek, Jan and Alonso-Coello, Pablo and Djulbegovic, Ben and Atkins, David and Falck-Ytter, Yngve and Williams, John W., Jr. and Meerpohl, Joerg and Norris, Susan L. and Akl, Elie A. and Schünemann, Holger J.}, title={{GRADE guidelines: 5. Rating the quality of evidence—publication bias}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={12}, pages={1277--1282}, doi={10.1016/j.jclinepi.2011.01.011}}@article{guyatt2008grade, author={Guyatt, Gordon H. and Oxman, Andrew D. and Vist, Gunn E. and Kunz, Regina and Falck-Ytter, Yngve and Alonso-Coello, Pablo and Schünemann, Holger J.}, title={{GRADE: An emerging consensus on rating quality of evidence and strength of recommendations}}, journal={BMJ}, year={2008}, volume={336}, number={7650}, pages={924--926}, doi={10.1136/bmj.39489.470347.ad}}@article{guyatt2011study, author={Guyatt, G. H. and Oxman, A. D. and Vist, G. and Kunz, R. and Brozek, J. and Alonso-Coello, P. and Montori, V. and Akl, E. A. and Djulbegovic, B. and Falck-Ytter, Y. and Norris, S. L. and Williams, J. W. and Atkins, D. and Meerpohl, J. and Schünemann, H. J.}, title={{GRADE guidelines: 4. Rating the quality of evidence—study limitations (risk of bias)}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={4}, pages={407--415}, doi={10.1016/j.jclinepi.2010.07.017}}@article{guyatt2011introduction, author={Guyatt, G. and Oxman, A. D. and Akl, E. A. and Kunz, R. and Vist, G. and Brozek, J. and Norris, S. and Falck-Ytter, Y. and Glasziou, P. and DeBeer, H. and Jaeschke, R. and Rind, D. and Meerpohl, J. and Dahm, P. and Schünemann, H. J.}, title={{GRADE guidelines: 1. Introduction—GRADE evidence profiles and summary of findings tables}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={4}, pages={383--394}, doi={10.1016/j.jclinepi.2010.04.026}}@article{hultcrantz2017grade, author={Hultcrantz, Monica and Rind, David and Akl, Elie A. and Treweek, Shaun and Mustafa, Reem A. and Iorio, Alfonso and Alper, Brian S. and Meerpohl, Joerg J. and Murad, M. Hassan and Ansari, Mohammed T. and Katikireddi, Srinivasa Vittal and Östlund, Pernilla and Tranæus, Sofia and Christensen, Robin and Gartlehner, Gerald and Brozek, Jan and Izcovich, Ariel and Schünemann, Holger and Guyatt, Gordon}, title={{The GRADE Working Group clarifies the construct of certainty of evidence}}, journal={Journal of Clinical Epidemiology}, year={2017}, volume={87}, pages={4--13}, doi={10.1016/j.jclinepi.2017.05.006}}@misc{schunemann2013grade, author={Schünemann, Holger and Brożek, Jan and Guyatt, Gordon and Oxman, Andrew}, title={{GRADE handbook for grading quality of evidence and strength of recommendations (updated October 2013)}}, year={2013}, publisher={The GRADE Working Group}, url={https://gdt.gradepro.org/app/handbook/handbook.html}}