Co to jest wykres lejkowy?
Wykres lejkowy (ang. funnel plot) to wykres rozrzutu, na którym każdy punkt to jedno badanie z metaanalizy. Na osi poziomej leży wielkość efektu, a na pionowej jego precyzja, najczęściej błąd standardowy na odwróconej osi, tak by najdokładniejsze badania były na górze. Gdy nic nie zniekształca literatury, punkty tworzą symetryczny, odwrócony lejek: duże badania skupiają się blisko efektu łącznego, a małe rozrzucają się szerzej po obu jego stronach.
Jak go czytać?
- Szukaj asymetrii. Brak małych badań po jednej stronie, zwykle przy słabych lub ujemnych wynikach, to sygnał tzw. efektu małych badań.
- Asymetria to nie dowód. Może wynikać z błędu publikacji, ale też z heterogeniczności, słabszej jakości małych badań albo przypadku (Sterne i in., 2011).
- Dodaj kontury istotności. Jeśli brakujące badania leżałyby w strefie wyników nieistotnych, przemawia to za błędem publikacji. Jeśli w strefie istotnej, przyczyna jest raczej inna (Peters i in., 2008).
- Oceń asymetrię formalnie. Służy do tego test Eggera, a korektę pokazuje metoda trim-and-fill.
Przykład
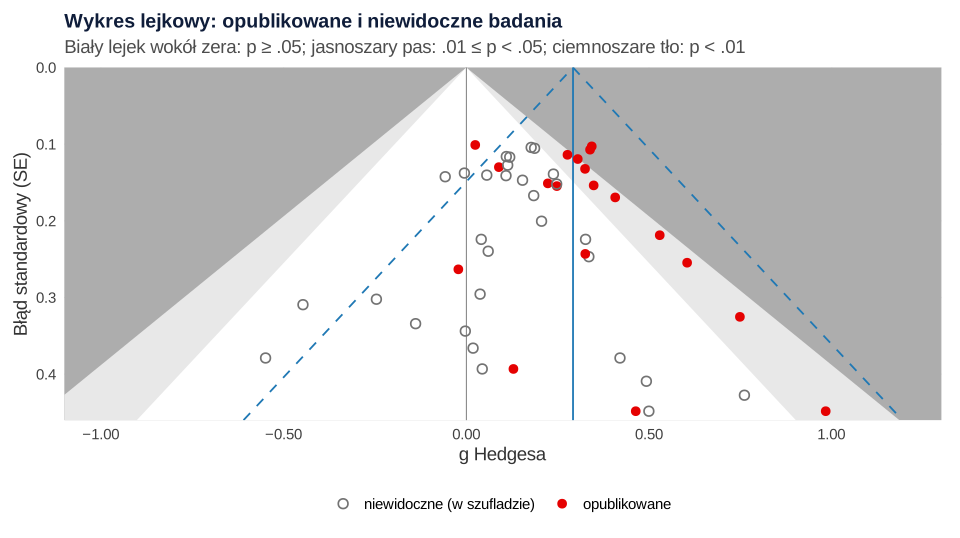
W symulacji przeprowadzono 50 badań o tym samym prawdziwym efekcie g = 0.20. Do literatury trafiły wszystkie wyniki istotne i dodatnie, a z pozostałych losowo mniej więcej co czwarty – razem 20 badań. Metaanaliza wszystkich 50 daje g = 0.21, 95% CI [0.16, 0.26], a samych opublikowanych już g = 0.29, 95% CI [0.21, 0.37]. Lejek jest wyraźnie asymetryczny: z 19 małych badań (SE > 0.25) opublikowano 7, ze średnim g = 0.63, a pominięte miały średnio g = 0.07. Lewy dolny róg wykresu jest prawie pusty.
Jak opisać w pracy
Na co uważać
- Mało badań to mało informacji. Egger i in. (1997) ostrzegają, że gdy metaanaliza obejmuje niewiele małych badań, zdolność wykrycia błędu jest ograniczona.
- Na osi pionowej daj błąd standardowy, a nie liczebność próby, bo to on wyznacza kształt lejka.
- Symetria nie oczyszcza wyników. Brak asymetrii nie wyklucza błędu publikacji.
Jak włączyć wykres lejkowy do całej analizy, pokazuje wpis Metaanaliza krok po kroku.
Wykres lejkowy w R
Kod symuluje 50 badań, „publikuje” część z nich według istotności wyniku i porównuje metaanalizę wszystkich i opublikowanych badań. Rysunek 1 powstał w ggplot2 w dalszej części skryptu; szybki wykres daje też funnel() z pakietu metafor.
Opublikowane badania i strefy istotności
R
suppressPackageStartupMessages(library(metafor))
set.seed(3011)
k   <- 50
n   <- round(exp(runif(k, log(10), log(200))))                         # osób w grupie
vi  <- 2 / n + 0.2^2 / (4 * n)                          # wariancja g przy dwóch równych grupach
yi  <- rnorm(k, 0.20, sqrt(vi))                         # prawdziwy efekt g = 0.20 we wszystkich badaniach
p   <- 2 * pnorm(-abs(yi / sqrt(vi)))
publ <- (p < .05 & yi > 0) | runif(k) < 0.25           # wynik istotny albo 25% szans dla pozostałych
c(wszystkie = k, opublikowane = sum(publ))
wszystkie <- rma(yi, vi, method = "REML")
opubl     <- rma(yi, vi, method = "REML", subset = publ)
round(rbind(wszystkie = c(g = wszystkie$b[1], lo = wszystkie$ci.lb, hi = wszystkie$ci.ub),
            opublikowane = c(g = opubl$b[1], lo = opubl$ci.lb, hi = opubl$ci.ub)), 2)
se <- sqrt(vi)
# ile opublikowanych badań leży w każdej strefie istotności (kontury wokół zera)
z  <- yi[publ] / se[publ]
table(cut(abs(z), c(0, 1.96, 2.576, Inf), right = FALSE,
          labels = c("p >= .05", ".01 <= p < .05", "p < .01")))
male <- se > 0.25                                       # małe badania (SE > 0.25, ok. 30 osób w grupie i mniej)
round(tapply(yi, list(ifelse(male, "male", "duze"), ifelse(publ, "opublikowane", "pominiete")), mean), 2)  # średnie g
table(ifelse(male, "male", "duze"), publ)
Wynik w R
   wszystkie opublikowane
          50           20
                g   lo   hi
wszystkie    0.20 0.15 0.24
opublikowane 0.29 0.21 0.37

      p >= .05 .01 <= p < .05        p < .01
             8              9              3
     opublikowane pominiete
duze         0.29      0.14
male         0.63      0.07
      publ
       FALSE TRUE
  duze    18   13
  male    12    7
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety metafor i ggplot2).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Co oznacza asymetria wykresu lejkowego?
Że małe badania dają inne wyniki niż duże, najczęściej większe efekty. Przyczyną może być błąd publikacji, ale też heterogeniczność, słabsza jakość małych badań albo przypadek.
Co jest na osiach wykresu lejkowego?
Na osi poziomej wielkość efektu (np. g Hedgesa albo logarytm OR), a na pionowej błąd standardowy na odwróconej skali, tak że najprecyzyjniejsze badania są na górze.
Od ilu badań ma sens wykres lejkowy?
Przy kilku badaniach kształtu lejka nie da się ocenić. Egger i in. (1997) ostrzegają, że przy niewielu małych badaniach zdolność wykrycia błędu jest ograniczona.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Egger, M., Davey Smith, G., Schneider, M., & Minder, C. (1997). Bias in meta-analysis detected by a simple, graphical test. BMJ, 315(7109), 629–634. https://doi.org/10.1136/bmj.315.7109.629 ● Otwarty dostęp: pełny tekst
- Peters, J. L., Sutton, A. J., Jones, D. R., Abrams, K. R., & Rushton, L. (2008). Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry. Journal of Clinical Epidemiology, 61(10), 991–996. https://doi.org/10.1016/j.jclinepi.2007.11.010
- Sterne, J. A. C., Sutton, A. J., Ioannidis, J. P. A., Terrin, N., Jones, D. R., Lau, J., Carpenter, J., Rücker, G., Harbord, R. M., Schmid, C. H., Tetzlaff, J., Deeks, J. J., Peters, J., Macaskill, P., Schwarzer, G., Duval, S., Altman, D. G., Moher, D., & Higgins, J. P. T. (2011). Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ, 343, Article d4002. https://doi.org/10.1136/bmj.d4002 ● Otwarty dostęp
Cytowania BibTeX
@article{egger1997bias, author={Egger, Matthias and Davey Smith, George and Schneider, Martin and Minder, Christoph}, title={{Bias in meta-analysis detected by a simple, graphical test}}, journal={BMJ}, year={1997}, volume={315}, number={7109}, pages={629--634}, doi={10.1136/bmj.315.7109.629}}@article{peters2008contour, author={Peters, Jaime L. and Sutton, Alex J. and Jones, David R. and Abrams, Keith R. and Rushton, Lesley}, title={{Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={10}, pages={991--996}, doi={10.1016/j.jclinepi.2007.11.010}}@article{sterne2011recommendations, author={Sterne, Jonathan A. C. and Sutton, Alex J. and Ioannidis, John P. A. and Terrin, Norma and Jones, David R. and Lau, Joseph and Carpenter, James and Rücker, Gerta and Harbord, Roger M. and Schmid, Christopher H. and Tetzlaff, Jennifer and Deeks, Jonathan J. and Peters, Jaime and Macaskill, Petra and Schwarzer, Guido and Duval, Sue and Altman, Douglas G. and Moher, David and Higgins, Julian P. T.}, title={{Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials}}, journal={BMJ}, year={2011}, volume={343}, eid={d4002}, doi={10.1136/bmj.d4002}}