Ryzyko błędu to nie „jakość badania”
Ocena ryzyka błędu odpowiada na pytanie, czy wynik badania może systematycznie przeszacowywać albo niedoszacowywać prawdziwy efekt. Nie jest oceną staranności autorów, jakości raportowania ani precyzji (szerokości przedziału ufności). Badanie może być świetnie opisane i nadal mieć wysokie ryzyko błędu, np. gdy uczestnicy wiedzą, w jakiej są grupie, a wynik jest samoopisowy. Ocena ryzyka błędu to niezbędny element przeglądu systematycznego efektów interwencji (Sterne i in., 2019), a PRISMA 2020 wymaga opisu jej metod i wyników (Page i in., 2021).
Dlaczego nie wystarczy jedna liczba „jakości”? Suma punktów traktuje jako równoważne problemy o bardzo różnej wadze: brak opisu zaślepienia i utrata połowy uczestników mogą „kosztować” po jednym punkcie. Dlatego RoB 2 i ROBINS-I oceniają osobne domeny, a ocenę każdej uzasadnia się fragmentami tekstu. W RoB 2 ryzyko błędu oznacza ryzyko istotnego błędu: zastrzeżenia zgłasza się tylko wtedy, gdy problem może wpłynąć na wiarygodność wniosków z badania (Higgins i in., 2024).
Które narzędzie do jakiego badania
| Schemat badania | Narzędzie | Kategorie oceny |
|---|---|---|
| badanie z randomizacją | RoB 2 | niskie, pewne zastrzeżenia, wysokie |
| nierandomizowane badanie interwencji (np. porównanie kohort leczonych różnie) | ROBINS-I | niskie, umiarkowane, poważne, krytyczne |
| badanie kohortowe lub kliniczno-kontrolne (np. czynniki ryzyka) | skala Newcastle–Ottawa (NOS) | gwiazdki w trzech obszarach |
| przegląd systematyczny (w przeglądzie przeglądów) | AMSTAR 2 | zob. hasło AMSTAR 2 |
Wybór narzędzia zapisz w protokole przeglądu, osobno dla każdego schematu. Poniżej omawiamy zasady każdego z trzech pierwszych narzędzi. Samych narzędzi nie przedrukowujemy, bo pytania, algorytmy i instrukcje są dostępne na stronach autorów.
RoB 2: badania z randomizacją
RoB 2 zastąpił pierwotne narzędzie Cochrane (Sterne i in., 2019). Zasady opisuje rozdział 8 podręcznika Cochrane (Higgins i in., 2024):
- Oceniasz wynik, a nie badanie. Jedna ocena dotyczy konkretnego wyniku, np. stresu po 8 tygodniach. Ten sam artykuł może mieć różne oceny dla różnych wyników.
- Najpierw ustal efekt, który Cię interesuje. Chodzi o efekt przydziału do interwencji, szacowany analizą ITT, albo efekt przestrzegania protokołu (per protocol). Wybór zapisz w protokole przeglądu, bo od niego zależy ocena domeny 2.
- Pięć obowiązkowych domen, bez dodawania innych:
- proces randomizacji;
- odstępstwa od zamierzonych interwencji;
- brakujące dane wyniku;
- pomiar wyniku;
- wybór raportowanego wyniku.
- Pytania sygnalizacyjne i algorytm. Na pytania odpowiadasz: tak, raczej tak, raczej nie, nie albo brak informacji. Algorytm proponuje ocenę domeny. Możesz od niej odstąpić, ale musisz podać uzasadnienie.
- Ocena ogólna to najmniej korzystna ocena domen. Jest niska, gdy wszystkie domeny mają niskie ryzyko, i wysoka, gdy choć jedna domena ma ryzyko wysokie. W pozostałych przypadkach ocena to „pewne zastrzeżenia”. Także zastrzeżenia w wielu domenach mogą uzasadniać ocenę wysoką, jeśli istotnie obniżają zaufanie do wyniku.
W badaniach interwencji psychologicznych zwróć szczególną uwagę na domeny 3 i 4. Utrata uczestników bywa duża (zob. braki danych: MCAR, MAR, MNAR), a wyniki samoopisowe zbiera się od osób, które wiedzą, jaką interwencję otrzymały. Domena 5 dotyczy wybiórczego raportowania wyników, czyli zjawisk bliskich p-hackingowi.
ROBINS-I: nierandomizowane badania interwencji
ROBINS-I ocenia oszacowania skuteczności lub szkodliwości interwencji z badań, w których grupy nie powstały losowo (Sterne i in., 2016). Punktem odniesienia jest hipotetyczne „badanie docelowe” (target trial): pragmatyczne badanie z randomizacją na tych samych osobach i z tymi samymi interwencjami, które nie musiałoby być wykonalne ani etyczne. Rozdział 25 podręcznika Cochrane (Sterne i in., 2024) opisuje siedem domen ułożonych według czasu:
- przed interwencją: zakłócanie (zmienne zakłócające) i dobór uczestników do badania;
- w chwili interwencji: klasyfikacja interwencji;
- po interwencji: odstępstwa od zamierzonych interwencji, brakujące dane, pomiar wyniku i wybór raportowanego wyniku.
Oceny mają pięć poziomów: niskie, umiarkowane, poważne, krytyczne ryzyko błędu i brak informacji. „Niskie” oznacza, że w danej domenie badanie jest porównywalne z dobrze przeprowadzonym RCT. Ocena ogólna jest krytyczna, gdy krytyczna jest choć jedna domena, i poważna, gdy choć jedna domena ma ryzyko poważne. Umiarkowane ryzyko w wielu domenach może uzasadniać ocenę poważną. Ważne czynniki zakłócające wypisz w protokole przeglądu, zanim zaczniesz czytać badania, bo bez tej listy ocena domeny 1 jest dowolna.
Na stronie zespołu narzędzi jest wersja robocza ROBINS-I V2 z 20 listopada 2025 r., przeznaczona dla badań kohortowych (Risk of Bias Tools, 2025). Ma algorytmy proponujące oceny, część triażową i sześć domen, bo zrezygnowano w niej z osobnej domeny odstępstw od interwencji. Wersja ta może się jeszcze zmienić, więc w protokole podaj, której wersji używasz, i datę dostępu (stan na 26.10.2026).
Skala Newcastle–Ottawa: badania kohortowe i kliniczno-kontrolne
NOS powstała do oceny jakości nierandomizowanych badań (kohortowych i kliniczno-kontrolnych) włączanych do przeglądów (Wells i in., b.d.). Ocenia trzy obszary:
- dobór grup;
- porównywalność grup;
- ustalenie ekspozycji (w badaniach kliniczno-kontrolnych) albo wyniku (w kohortowych).
Za spełnione kryteria przyznaje się gwiazdki. Oficjalna strona nie podaje progów „dobra – słaba jakość”, a progi spotykane w artykułach są ustaleniami autorów przeglądów. Strona podaje też, że trafność kryterialna i rzetelność wewnątrzoceniającego są wciąż badane.
Skala ma znane słabości. Lo i in. (2014) porównali oceny recenzentów przeglądu z ocenami autorów 65 badań kohortowych. Recenzenci oceniali badania wyżej (mediana 6 wobec 5), a zgodność dla wyniku ogólnego była praktycznie zerowa (κ = −.004). Wniosek autorów: przy stosowaniu NOS warto pytać autorów badań o informacje, których nie opublikowano. Jeśli pytasz o efekt interwencji, a nie o czynnik ryzyka, lepiej sprawdzi się ROBINS-I. Sumy gwiazdek nie traktuj jak wyniku testu: łączy różne problemy w jedną liczbę, a przy tak niskiej zgodności oceniających jej wartość zależy od tego, kto ocenia.
Procedura oceny w zespole
- Protokół: narzędzie dla każdego schematu, interesujący Cię efekt (RoB 2), lista czynników zakłócających (ROBINS-I), wyniki, które będą oceniane.
- Szkolenie i pilotaż: dwie osoby oceniają te same kilka badań i omawiają różnice, zanim przejdą do reszty.
- Niezależna ocena przez dwie osoby i rozstrzyganie rozbieżności przez dyskusję albo trzecią osobę.
- Uzasadnienia: przy każdej ocenie domeny cytat lub odwołanie do fragmentu artykułu, protokołu albo rejestru badania.
- Zgodność: raportuj zgodność oceniających, np. kappę ważoną, bo kategorie są uporządkowane. Szczegóły znajdziesz we wpisie o zgodności sędziów.
- Wykorzystanie w syntezie: analiza wrażliwości lub moderator w metaanalizie oraz ocena pewności dowodów.
Przykład: 14 badań z randomizacją i ich oceny
W przykładzie (dane symulowane) przegląd obejmuje 14 RCT, w których porównywano trening uważności z kontrolą. Wynikiem jest odczuwany stres u studentów, a miarą efektu g Hedgesa (wartość dodatnia oznacza mniej stresu). Dwie osoby niezależnie oceniły każde badanie narzędziem RoB 2, co dało 70 ocen domen.
Plik do pobrania: ocena-ryzyka-bledu-dane.csv – oceny domen po konsensusie, ocena ogólna, liczebność i g z wariancją dla każdego badania.
Zgodność. Oceniający zgodzili się w 74.3% ocen domen. Zwykła kappa wyniosła κ = .55, 95% CI [.36, .73], a kappa ważona κ = .75, 95% CI [.62, .88]. Różnica wynika z tego, że większość rozbieżności dotyczyła sąsiednich kategorii. Najmniej zgodne były oceny domeny 4, pomiaru wyniku (57.1%), i domeny 3, brakujących danych (64.3%). Do rozstrzygnięcia zostało 18 rozbieżności.
Oceny po konsensusie. Tylko 1 badanie miało ogólnie niskie ryzyko błędu, 6 – pewne zastrzeżenia, a 7 – ryzyko wysokie. To typowy obraz, bo o ocenie ogólnej decyduje najsłabsza domena. Najwięcej problemów dotyczyło pomiaru wyniku: niskie ryzyko miało tam tylko 28.6% badań, a wysokie 28.6%. W 3 badaniach ocenionych na „pewne zastrzeżenia” zastrzeżenia dotyczyły co najmniej dwóch domen. Właśnie przy takich badaniach zespół musi zdecydować i uzasadnić, czy podnieść ocenę ogólną do wysokiej.
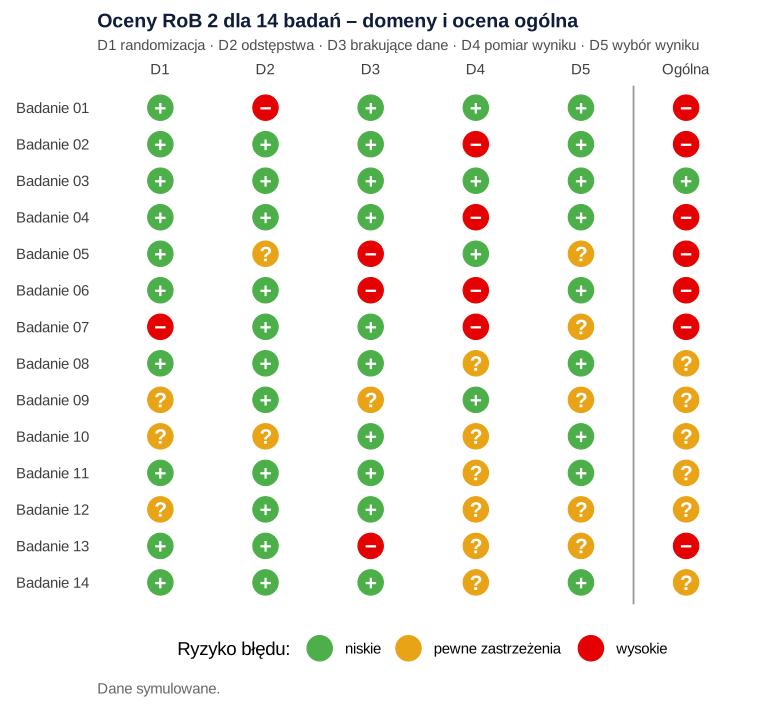
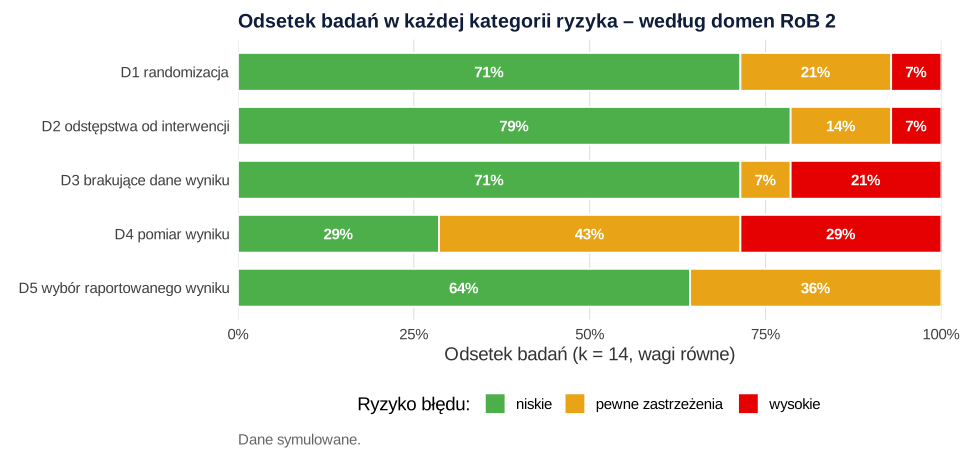
Rysunki tego typu tworzy pakiet robvis (McGuinness i Higgins, 2021). Tutaj narysowaliśmy je w ggplot2, a kod jest w sekcji ocena ryzyka błędu w R.
Jak użyć oceny w metaanalizie
Ocena ryzyka błędu ma znaczenie dopiero wtedy, gdy wpływa na wnioski. W przykładzie średni efekt ze wszystkich 14 badań wyniósł g = 0.50, 95% CI [0.36, 0.64], I² = 38.8% (model efektów losowych z poprawką Knappa–Hartunga, jak w poradniku metaanaliza krok po kroku). Wyniki analizy wrażliwości zależały od oceny ryzyka:
- bez 7 badań o wysokim ryzyku: g = 0.36, 95% CI [0.16, 0.57];
- w samych badaniach o wysokim ryzyku: g = 0.63, 95% CI [0.46, 0.80];
- w metaregresji efekt był w nich większy o 0.27, 95% CI [0.03, 0.51], F(1, 12) = 5.93, p = .031.
Dane symulowano tak, by prawdziwy efekt wynosił 0.25, a badania obciążone dawały wyniki zawyżone. Analiza ograniczona do badań bez wysokiego ryzyka przybliżyła się do prawdy, choć nadal jest wyższa. Wynik ten podaj obok głównego, a różnicę uwzględnij przy ocenie pewności dowodów (zob. GRADE – ocena pewności danych naukowych). Ocenę ryzyka możesz też dodać jako kolumnę do wykresu lasu.
Pamiętaj, że to porównanie jest obserwacyjne na poziomie badań. Badania o wysokim ryzyku mogą różnić się też populacją albo długością interwencji. Dlatego analizę wrażliwości według ryzyka błędu zaplanuj w protokole, a nie po obejrzeniu wyników.
Jak opisać ocenę w artykule
PRISMA 2020 wymaga w metodach podania narzędzia, liczby osób oceniających każde badanie i tego, czy pracowały niezależnie (pozycja 11), a w wynikach przedstawienia ocen dla każdego włączonego badania (pozycja 18; Page i in., 2021). Wzór akapitu dla przykładu:
Pełne oceny, z uzasadnieniem każdej domeny, umieść w suplemencie. Jak zaplanować przegląd jako część doktoratu, piszemy w przewodniku doktorat i publikacje. Jeśli przegląd ma tylko zmapować literaturę, ocena ryzyka błędu nie jest obowiązkowa (zob. przegląd zakresu krok po kroku).
Ocena ryzyka błędu w R
Kod symuluje oceny dwóch osób i po konsensusie, liczy zgodność, wyznacza ocenę ogólną według reguły „najsłabsza domena”, zapisuje plik CSV do pobrania i przeprowadza analizę wrażliwości w pakiecie metafor. Przy prawdziwych danych wczytasz plik z ocenami (read.csv()) i zaczniesz od kroku z funkcją psych::cohen.kappa().
1. Zgodność, ocena ogólna i analiza wrażliwości
R
# Ocena ryzyka błędu RoB 2 w przeglądzie 14 badań z randomizacją (dane symulowane):
# zgodność dwóch oceniających, ocena ogólna, analiza wrażliwości metaanalizy.
# Pytanie przeglądu: trening uważności (mindfulness) a odczuwany stres u studentów; efekt: g Hedgesa (dodatni = mniej stresu).
options(width = 110)
suppressPackageStartupMessages(library(metafor))
set.seed(120)
k <- 14
domeny <- c("D1 randomizacja", "D2 odstępstwa od interwencji", "D3 brakujące dane wyniku",
            "D4 pomiar wyniku", "D5 wybór raportowanego wyniku")
poziomy <- c("niskie", "pewne zastrzeżenia", "wysokie")
# „prawdziwe” oceny domen (po konsensusie); D4 częściej problematyczna – wynik samoopisowy, uczestnicy wiedzą o przydziale
p_dom <- rbind(c(.85, .12, .03), c(.75, .20, .05), c(.75, .15, .10), c(.50, .35, .15), c(.80, .18, .02))
konsensus <- sapply(1:5, function(j) sample(1:3, k, TRUE, prob = p_dom[j, ]))
colnames(konsensus) <- domeny
# oceny dwóch niezależnych osób: z prawdopodobieństwem .80 zgodne z konsensusem, inaczej o jeden poziom obok
ocen <- function(x) { z <- runif(length(x)) > .80; x[z] <- pmin(3, pmax(1, x[z] + sample(c(-1, 1), sum(z), TRUE))); x }
A <- apply(konsensus, 2, ocen); B <- apply(konsensus, 2, ocen)
cat("Zgodność procentowa A i B we wszystkich", length(A), "ocenach domen:", round(100 * mean(A == B), 1), "%\n")
kw <- psych::cohen.kappa(cbind(as.vector(A), as.vector(B)))
cat(sprintf("kappa = %.2f, 95%% CI [%.2f, %.2f]; kappa ważona = %.2f, 95%% CI [%.2f, %.2f]\n",
            kw$kappa, kw$confid[1, 1], kw$confid[1, 3], kw$weighted.kappa, kw$confid[2, 1], kw$confid[2, 3]))
print(round(sapply(1:5, function(j) mean(A[, j] == B[, j])) * 100, 1))
cat("Rozbieżności do rozstrzygnięcia:", sum(A != B), "\n")

# ocena ogólna: najmniej korzystna ocena domeny (tabela 8.2.b podręcznika Cochrane)
ogolna <- apply(konsensus, 1, max)
oceny <- data.frame(badanie = sprintf("Badanie %02d", 1:k), matrix(poziomy[konsensus], k), ogolna = poziomy[ogolna])
names(oceny)[2:6] <- paste0("D", 1:5)
skrot <- c("N", "Z", "W")   # N = niskie, Z = pewne zastrzeżenia, W = wysokie
print(data.frame(badanie = oceny$badanie, matrix(skrot[konsensus], k, dimnames = list(NULL, paste0("D", 1:5))),
                 ogolna = skrot[ogolna]), row.names = FALSE)
print(table(factor(oceny$ogolna, levels = poziomy)))
cat("Odsetek ocen domen (wiersze = domeny):\n")
print(round(100 * t(apply(konsensus, 2, function(x) table(factor(x, levels = 1:3)) / k)), 1))
cat("Badania z >= 2 domenami 'pewne zastrzeżenia' i bez 'wysokie':",
    sum(rowSums(konsensus == 2) >= 2 & ogolna == 2), "\n")

# efekty: badania o wyższym ryzyku błędu dają zawyżone efekty (prawdziwy efekt 0.25)
n <- round(runif(k, 40, 160))
delta <- 0.25 + c(0, 0.15, 0.35)[ogolna] + rnorm(k, 0, 0.08)
g <- rnorm(k, delta, sqrt(4 / n))
vi <- 4 / n + g^2 / (2 * n)
dane <- data.frame(oceny, n = n, yi = round(g, 3), vi = round(vi, 4))
write.csv(dane, "../ocena-ryzyka-bledu-dane.csv", row.names = FALSE)
dane$ogolna <- factor(dane$ogolna, levels = poziomy)

wszystkie <- rma(yi, vi, data = dane, method = "REML", test = "knha")
bez_wys <- rma(yi, vi, data = dane, subset = ogolna != "wysokie", method = "REML", test = "knha")
pods <- function(m, et) cat(sprintf("%-28s k = %2d  g = %.2f, 95%% CI [%.2f, %.2f], I2 = %.1f%%\n",
                                    et, m$k, m$b[1], m$ci.lb, m$ci.ub, m$I2))
pods(wszystkie, "Wszystkie badania"); pods(bez_wys, "Bez ryzyka wysokiego")
dane$wysokie <- as.numeric(dane$ogolna == "wysokie")
mr <- rma(yi, vi, mods = ~ wysokie, data = dane, method = "REML", test = "knha")
cat(sprintf("Moderator (wysokie vs pozostałe): różnica = %.2f, 95%% CI [%.2f, %.2f], F(%d, %d) = %.2f, p = %s\n",
            mr$b[2], mr$ci.lb[2], mr$ci.ub[2], mr$QMdf[1], mr$QMdf[2], mr$QM, sub("^0", "", sprintf("%.3f", mr$QMp))))
wys <- rma(yi, vi, data = dane, subset = ogolna == "wysokie", method = "REML", test = "knha")
pods(wys, "Tylko ryzyko wysokie")
saveRDS(list(oceny = oceny, konsensus = konsensus, dane = dane, poziomy = poziomy, domeny = domeny), "b120-dane.rds")
Wynik w R
Zgodność procentowa A i B we wszystkich 70 ocenach domen: 74.3 %
kappa = 0.55, 95% CI [0.36, 0.73]; kappa ważona = 0.75, 95% CI [0.62, 0.88]
[1] 85.7 85.7 64.3 57.1 78.6
Rozbieżności do rozstrzygnięcia: 18
    badanie D1 D2 D3 D4 D5 ogolna
 Badanie 01  N  W  N  N  N      W
 Badanie 02  N  N  N  W  N      W
 Badanie 03  N  N  N  N  N      N
 Badanie 04  N  N  N  W  N      W
 Badanie 05  N  Z  W  N  Z      W
 Badanie 06  N  N  W  W  N      W
 Badanie 07  W  N  N  W  Z      W
 Badanie 08  N  N  N  Z  N      Z
 Badanie 09  Z  N  Z  N  Z      Z
 Badanie 10  Z  Z  N  Z  N      Z
 Badanie 11  N  N  N  Z  N      Z
 Badanie 12  Z  N  N  Z  Z      Z
 Badanie 13  N  N  W  Z  Z      W
 Badanie 14  N  N  N  Z  N      Z

            niskie pewne zastrzeżenia            wysokie
                 1                  6                  7
Odsetek ocen domen (wiersze = domeny):
                                 1    2    3
D1 randomizacja               71.4 21.4  7.1
D2 odstępstwa od interwencji  78.6 14.3  7.1
D3 brakujące dane wyniku      71.4  7.1 21.4
D4 pomiar wyniku              28.6 42.9 28.6
D5 wybór raportowanego wyniku 64.3 35.7  0.0
Badania z >= 2 domenami 'pewne zastrzeżenia' i bez 'wysokie': 3
Wszystkie badania            k = 14  g = 0.50, 95% CI [0.36, 0.64], I2 = 38.8%
Bez ryzyka wysokiego         k =  7  g = 0.36, 95% CI [0.16, 0.57], I2 = 34.9%
Moderator (wysokie vs pozostałe): różnica = 0.27, 95% CI [0.03, 0.51], F(1, 12) = 5.93, p = .031
Tylko ryzyko wysokie         k =  7  g = 0.63, 95% CI [0.46, 0.80], I2 = 0.0%
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki 1 i 2 przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
Najczęstsze błędy w ocenie ryzyka błędu
- Jedna ocena na badanie zamiast oceny dla każdego wyniku. W RoB 2 i ROBINS-I oceniasz wynik.
- Suma punktów jako „jakość” i progi wymyślone ad hoc, np. „NOS ≥ 7 = dobra jakość”, bez źródła w protokole.
- Dodawanie własnych domen do RoB 2, np. konfliktu interesów albo wielkości próby. Narzędzie ma pięć obowiązkowych domen i nie przewiduje innych.
- Mylenie ryzyka błędu z precyzją. Mała próba daje szeroki przedział ufności, a nie systematyczne obciążenie. Precyzję opisuj osobno.
- Ocena przez jedną osobę bez uzasadnień albo uzasadnienia typu „nie podano”, bez sprawdzenia protokołu i rejestru badania.
- Ocena, która nic nie zmienia. Wykres sygnalizacji świetlnej w suplemencie, a metaanaliza i wnioski tak, jakby wszystkie badania były równie wiarygodne.
- ROBINS-I bez listy czynników zakłócających ustalonej przed oceną.
Jeśli przygotowujesz przegląd systematyczny i chcesz omówić ocenę ryzyka błędu, analizy wrażliwości lub odpowiedź na uwagi recenzentów, zajrzyj do oferty analiz statystycznych dla badaczy.
Najczęstsze pytania
Jaka jest różnica między RoB 2 a ROBINS-I?
RoB 2 służy do badań z randomizacją i ma pięć domen z trzema poziomami oceny: niskie ryzyko, pewne zastrzeżenia, wysokie ryzyko. ROBINS-I służy do nierandomizowanych badań interwencji, ma siedem domen, w tym zakłócanie i dobór uczestników, oraz poziomy od niskiego do krytycznego. Punktem odniesienia w ROBINS-I jest hipotetyczne badanie z randomizacją (target trial).
Jak ustala się ogólną ocenę ryzyka błędu w RoB 2?
Ocena ogólna to najmniej korzystna ocena domen: niskie ryzyko tylko wtedy, gdy wszystkie domeny mają niskie ryzyko, wysokie, gdy choć jedna domena ma ryzyko wysokie. W pozostałych przypadkach ocena brzmi „pewne zastrzeżenia”, chyba że zastrzeżenia w wielu domenach istotnie obniżają zaufanie do wyniku – wtedy zespół może uznać ryzyko za wysokie i musi to uzasadnić.
Czy skala Newcastle–Ottawa ma progi dobrej i słabej jakości?
Oficjalna strona autorów skali nie podaje progów „dobra – słaba jakość”. Progi spotykane w artykułach są ustaleniami autorów przeglądów, więc jeśli ich używasz, zapisz je w protokole i podaj źródło. Bezpieczniej opisywać oceny w trzech obszarach skali osobno niż sumę gwiazdek.
Ile osób powinno oceniać ryzyko błędu w przeglądzie?
Standardem są dwie osoby oceniające niezależnie, z rozstrzyganiem rozbieżności w dyskusji lub przez trzecią osobę. PRISMA 2020 wymaga podania, ile osób oceniało każde badanie i czy pracowały niezależnie. Warto też policzyć zgodność, np. kappę ważoną, bo kategorie ryzyka są uporządkowane.
Co zrobić z badaniami o wysokim ryzyku błędu w metaanalizie?
Nie usuwaj ich automatycznie. Zaplanuj w protokole analizę wrażliwości bez badań o wysokim ryzyku albo metaregresję z oceną ryzyka jako moderatorem i podaj oba wyniki. Jeśli wnioski się zmieniają, uwzględnij to przy ocenie pewności dowodów i w dyskusji.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikGRADE – pewność danych naukowych
Pięć dziedzin GRADE na przykładzie metaanalizy: ryzyko błędu, niespójność, nieprecyzyjność z progiem i OIS, tabela wyników i gotowy opis.
Czytaj →PoradnikPrzegląd zakresu (scoping review)
Kiedy wybrać scoping review, pytanie według PCC, selekcja z pilotażem kappa, formularz ekstrakcji, mapa dowodów i raport PRISMA-ScR – z kodem R.
Czytaj →Oceniasz ryzyko błędu w przeglądzie systematycznym?
Pomożemy zaplanować ocenę i analizy wrażliwości, policzyć zgodność oceniających i przygotować rysunki oraz opis tak, by przeszły recenzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Higgins, J. P. T., Savović, J., Page, M. J., Elbers, R. G., & Sterne, J. A. C. (2024). Chapter 8: Assessing risk of bias in a randomized trial. In J. P. T. Higgins, J. Thomas, J. Chandler, M. Cumpston, T. Li, M. J. Page, & V. A. Welch (Eds.), Cochrane handbook for systematic reviews of interventions (Version 6.5). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-08 ● Otwarty dostęp
- Lo, C. K.-L., Mertz, D., & Loeb, M. (2014). Newcastle-Ottawa Scale: Comparing reviewers' to authors' assessments. BMC Medical Research Methodology, 14(1), Article 45. https://doi.org/10.1186/1471-2288-14-45 ● Otwarty dostęp
- McGuinness, L. A., & Higgins, J. P. T. (2021). Risk-of-bias VISualization (robvis): An R package and Shiny web app for visualizing risk-of-bias assessments. Research Synthesis Methods, 12(1), 55–61. https://doi.org/10.1002/jrsm.1411 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Risk of Bias Tools. (2025). ROBINS-I V2. riskofbias.info. https://www.riskofbias.info/welcome/robins-i-v2 ● Otwarty dostęp
- Sterne, J. A. C., Hernán, M. A., McAleenan, A., Reeves, B. C., & Higgins, J. P. T. (2024). Chapter 25: Assessing risk of bias in a non-randomized study. In J. P. T. Higgins, J. Thomas, J. Chandler, M. Cumpston, T. Li, M. J. Page, & V. A. Welch (Eds.), Cochrane handbook for systematic reviews of interventions (Version 6.5). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-25 ● Otwarty dostęp
- Sterne, J. A. C., Hernán, M. A., Reeves, B. C., Savović, J., Berkman, N. D., Viswanathan, M., Henry, D., Altman, D. G., Ansari, M. T., Boutron, I., Carpenter, J. R., Chan, A.-W., Churchill, R., Deeks, J. J., Hróbjartsson, A., Kirkham, J., Jüni, P., Loke, Y. K., Pigott, T. D., . . . Higgins, J. P. T. (2016). ROBINS-I: A tool for assessing risk of bias in non-randomised studies of interventions. BMJ, 355, Article i4919. https://doi.org/10.1136/bmj.i4919 ● Otwarty dostęp
- Sterne, J. A. C., Savović, J., Page, M. J., Elbers, R. G., Blencowe, N. S., Boutron, I., Cates, C. J., Cheng, H.-Y., Corbett, M. S., Eldridge, S. M., Emberson, J. R., Hernán, M. A., Hopewell, S., Hróbjartsson, A., Junqueira, D. R., Jüni, P., Kirkham, J. J., Lasserson, T., Li, T., . . . Higgins, J. P. T. (2019). RoB 2: A revised tool for assessing risk of bias in randomised trials. BMJ, 366, Article l4898. https://doi.org/10.1136/bmj.l4898 ● Otwarty dostęp
- Wells, G. A., Shea, B., O'Connell, D., Peterson, J., Welch, V., Losos, M., & Tugwell, P. (b.d.). The Newcastle-Ottawa Scale (NOS) for assessing the quality of nonrandomised studies in meta-analyses. Ottawa Hospital Research Institute. https://www.ohri.ca/en/who-we-are/core-facilities-and-platforms/ottawa-methods-centre/newcastle-ottawa-scale ● Otwarty dostęp
Cytowania BibTeX
@incollection{higgins2024rozdzial8, author={Higgins, Julian P. T. and Savović, Jelena and Page, Matthew J. and Elbers, Roy G. and Sterne, Jonathan A. C.}, title={{Chapter 8: Assessing risk of bias in a randomized trial}}, booktitle={Cochrane handbook for systematic reviews of interventions (Version 6.5)}, year={2024}, publisher={Cochrane}, url={https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-08}}@article{lo2014newcastle, author={Lo, Carson Ka-Lok and Mertz, Dominik and Loeb, Mark}, title={{Newcastle-Ottawa Scale: Comparing reviewers' to authors' assessments}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={45}, doi={10.1186/1471-2288-14-45}}@article{mcguinness2021robvis, author={McGuinness, Luke A. and Higgins, Julian P. T.}, title={{Risk-of-bias VISualization (robvis): An R package and Shiny web app for visualizing risk-of-bias assessments}}, journal={Research Synthesis Methods}, year={2021}, volume={12}, number={1}, pages={55--61}, doi={10.1002/jrsm.1411}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@misc{riskofbias2025robinsiv2, author={{Risk of Bias Tools}}, title={{ROBINS-I V2}}, howpublished={riskofbias.info}, year={2025}, url={https://www.riskofbias.info/welcome/robins-i-v2}}@incollection{sterne2024rozdzial25, author={Sterne, Jonathan A. C. and Hernán, Miguel A. and McAleenan, Alexandra and Reeves, Barnaby C. and Higgins, Julian P. T.}, title={{Chapter 25: Assessing risk of bias in a non-randomized study}}, booktitle={Cochrane handbook for systematic reviews of interventions (Version 6.5)}, year={2024}, publisher={Cochrane}, url={https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-25}}@article{sterne2016robinsi, author={Sterne, Jonathan A. C. and Hernán, Miguel A. and Reeves, Barnaby C. and Savović, Jelena and Berkman, Nancy D. and Viswanathan, Meera and Henry, David and Altman, Douglas G. and Ansari, Mohammed T. and Boutron, Isabelle and Carpenter, James R. and Chan, An-Wen and Churchill, Rachel and Deeks, Jonathan J. and Hróbjartsson, Asbjørn and Kirkham, Jamie and Jüni, Peter and Loke, Yoon K. and Pigott, Theresa D. and others}, title={{ROBINS-I: A tool for assessing risk of bias in non-randomised studies of interventions}}, journal={BMJ}, year={2016}, volume={355}, eid={i4919}, doi={10.1136/bmj.i4919}}@article{sterne2019rob2, author={Sterne, Jonathan A. C. and Savović, Jelena and Page, Matthew J. and Elbers, Roy G. and Blencowe, Natalie S. and Boutron, Isabelle and Cates, Christopher J. and Cheng, Hung-Yuan and Corbett, Mark S. and Eldridge, Sandra M. and Emberson, Jonathan R. and Hernán, Miguel A. and Hopewell, Sally and Hróbjartsson, Asbjørn and Junqueira, Daniela R. and Jüni, Peter and Kirkham, Jamie J. and Lasserson, Toby and Li, Tianjing and McAleenan, Alexandra and Reeves, Barnaby C. and Shepperd, Sasha and Shrier, Ian and Stewart, Lesley A. and Tilling, Kate and White, Ian R. and Whiting, Penny F. and Higgins, Julian P. T.}, title={{RoB 2: A revised tool for assessing risk of bias in randomised trials}}, journal={BMJ}, year={2019}, volume={366}, eid={l4898}, doi={10.1136/bmj.l4898}}@misc{wellsndnos, author={Wells, G. A. and Shea, B. and O'Connell, D. and Peterson, J. and Welch, V. and Losos, M. and Tugwell, P.}, title={{The Newcastle-Ottawa Scale (NOS) for assessing the quality of nonrandomised studies in meta-analyses}}, howpublished={Ottawa Hospital Research Institute}, year={b.d.}, url={https://www.ohri.ca/en/who-we-are/core-facilities-and-platforms/ottawa-methods-centre/newcastle-ottawa-scale}}