Dla kogo jest ten przewodnik i jak z niego korzystać
Przewodnik jest dla doktorantek i doktorantów, osób przygotowujących pierwszy wniosek grantowy i badaczy, którzy chcą uporządkować drogę od planu badania do opublikowanego artykułu. Nie opisuje od nowa ani statystyki, ani procedur wydawniczych. Prowadzi po wpisach, hasłach ze słownika i kalkulatorach z metodolog.pl i przy każdym etapie mówi, którą stronę przeczytać i kiedy.
Ścieżka ma osiem etapów (rysunek 1). Pierwsze dwa dzieją się, zanim zbierzesz dane, i od nich najbardziej zależy, jak potem przebiegnie recenzja: większości zarzutów statystycznych łatwiej zapobiec planem niż odpowiedzią. Ostatnie etapy wracają do początku. Uwagi recenzentów często wymagają dodatkowych analiz, a w doktoracie z cyklu artykułów kolejny tekst powstaje z tego samego zbioru danych, więc reguły ustalone na początku muszą wystarczyć na kilka lat.
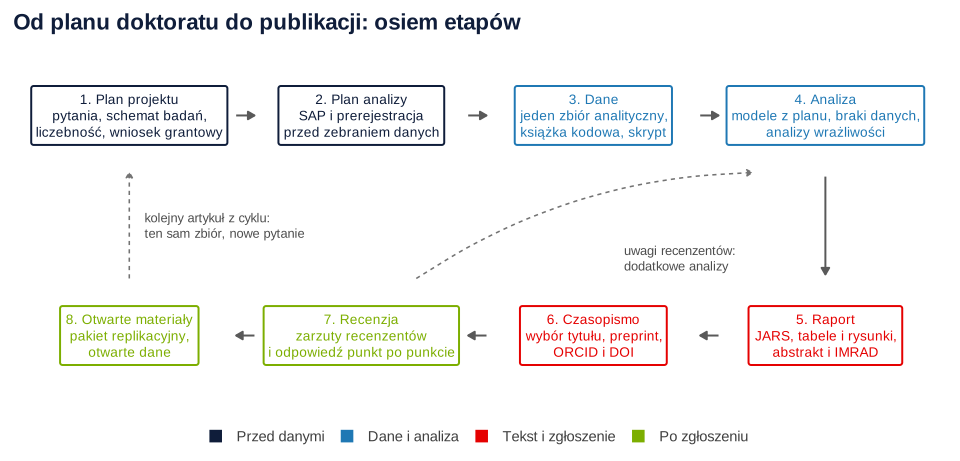
Jeśli jesteś na początku doktoratu, przejdź etapy po kolei. Jeśli masz już recenzję albo wybierasz czasopismo, zacznij od tabeli „mam problem → przeczytaj”. Hasła ze słownika na końcu porządkują pojęcia z obszaru publikacji i otwartej nauki.
Ścieżka krok po kroku: osiem etapów
Przy każdym etapie jest krótka instrukcja i lista stron. Wpisy prowadzą przez procedurę z przykładami, wzorami tekstu i kodem R, a hasła wyjaśniają pojedyncze pojęcia.
Etap 1. Zaplanuj projekt i jego część empiryczną
Rozpisz pytania badawcze na badania, a badania – na planowane artykuły. Dla każdego badania ustal schemat, główny wynik i liczebność z uzasadnieniem, najlepiej opartym na najmniejszym interesującym efekcie, a nie na wyniku pilotażu. Harmonogram dopasuj do indywidualnego planu badawczego i oceny śródokresowej. Jeśli projekt ma finansowanie zewnętrzne, ten sam plan staje się argumentem za wykonalnością we wniosku grantowym. Zgodę komisji etycznej i zasady ochrony danych uzgodnij, zanim zaczniesz rekrutację.
- Analiza statystyczna w doktoracie – plan części empirycznej, harmonogram i rozpisanie pytań na cykl publikacji.
- Plan analiz do wniosku grantowego – hipotezy z przypisanymi modelami, moc z jawnymi parametrami, braki danych i analizy wrażliwości.
- Badanie podłużne w doktoracie – liczba i rozkład pomiarów, retencja, moc dla różnicy trajektorii i analiza w modelu mieszanym.
- Dobór liczebności próby – analiza mocy, planowanie precyzji, SESOI i analiza wrażliwości jako sposoby uzasadnienia próby.
- Najmniejszy interesujący efekt (SESOI) – jak ustalić i uzasadnić efekt, od którego zależy analiza mocy.
- Zgoda komisji bioetycznej – kiedy jest potrzebna i co podać w opisie metody.
- Świadoma zgoda i RODO – co musi wiedzieć uczestnik i dlaczego zgoda na badanie to nie to samo co podstawa przetwarzania danych.
Etap 2. Zapisz plan analizy i prerejestruj badanie
Plan analizy statystycznej spisany przed obejrzeniem danych to najprostsza ochrona przed zarzutem dopasowywania analizy do wyniku. Simmons i in. (2011) pokazali w symulacjach i eksperymentach, że nieujawniona elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Prerejestracja pozwala odróżnić testowanie przewidywań od wyjaśnień dopisanych po fakcie (Nosek i in., 2018). Nie zakazuje zmian ani eksploracji – wymaga, żeby je jawnie opisać.
- Plan analizy statystycznej i prerejestracja – co zapisać w planie, gdzie go złożyć i jak opisać odstępstwa.
- Prerejestracja badań – jak sformułować plan, żeby naprawdę ograniczał elastyczność analizy.
- Registered report – format, w którym plan przechodzi recenzję przed zebraniem danych.
- HARKing – czym grozi przedstawianie hipotez sformułowanych po wynikach jako postawionych z góry.
- P-hacking – jak decyzje podejmowane po obejrzeniu wyniku zawyżają liczbę fałszywych odkryć.
- Rejestracja badania klinicznego – gdzie i kiedy zarejestrować badanie interwencyjne.
Etap 3. Przygotuj dane, które wystarczą na cały cykl publikacji
Jeden projekt doktorski to często kilka artykułów z tego samego zbioru. Zbuduj więc jeden zbiór analityczny jednym skryptem, z tymi samymi regułami wykluczeń, liczenia wyników skal i postępowania z brakami. Książkę kodową prowadź od pierwszego dnia, a dane identyfikujące oddziel od reszty. Jeśli korzystasz z cudzych danych, zanim postawisz im nowe pytanie, sprawdź licencję i spróbuj odtworzyć kilka opublikowanych liczb.
- Doktorat z cyklu artykułów a spójna analiza – zamrożony zbiór analityczny, mapa cyklu i porównywanie liczb przed każdym zgłoszeniem.
- Jak przygotować bazę danych do analizy – układ bazy, nazwy zmiennych, kody braków i szablon do pobrania.
- Książka kodowa – co powinna zawierać i kiedy ją tworzyć.
- Anonimizacja i pseudonimizacja – różnica w świetle RODO i pułapka kombinacji cech pośrednich.
- Reanaliza i wtórna analiza cudzych danych – licencje, odtworzenie wyników i analiza wieloświatowa.
- Braki danych i imputacja wielokrotna w R – MCAR, MAR i MNAR oraz imputacja wielokrotna ze zmiennymi pomocniczymi.
Etap 4. Analizuj zgodnie z planem i sprawdź odporność wniosków
Wykonaj analizy w kolejności z planu i oddziel je wyraźnie od eksploracyjnych. W badaniach doktorskich częste są dane zagnieżdżone i powtarzane pomiary, a wtedy zwykła regresja czy ANOVA na osobach z kompletem pomiarów potrafi wprowadzić w błąd. Ustal rodzinę testów i metodę korekty przed analizą. Wynik nieistotny opisz z wielkością efektu i przedziałem ufności, a odporność kluczowych wniosków pokaż analizami wrażliwości.
- Model wielopoziomowy krok po kroku w R – od modelu pustego z ICC do interakcji międzypoziomowej.
- ANOVA z powtarzanymi pomiarami czy model mieszany? – kiedy model mieszany lepiej radzi sobie z odpadaniem osób i nierównymi odstępami.
- Modele cross-lagged: CLPM i RI-CLPM – logika, założenia i interpretacja zależności wzajemnych w danych podłużnych.
- Poprawki na wielokrotne porównania – Bonferroni, Holm i FDR oraz wybór metody przed analizą.
- Analiza wrażliwości – sprawdzenie, czy wniosek nie zmienia się przy innych rozsądnych decyzjach analitycznych.
- Hipoteza się nie potwierdziła – co zrobić z wynikiem nieistotnym, w tym test równoważności i czynnik Bayesa.
- Metaanaliza krok po kroku – synteza wyników z modelem efektów losowych, przydatna także przy łączeniu badań z cyklu.
Etap 5. Przygotuj raport: wyniki, tabele, abstrakt
Standardy JARS-Quant dzielą hipotezy, analizy i wnioski na pierwszorzędowe, drugorzędowe i eksploracyjne i mają moduły m.in. dla badań podłużnych, replikacji i SEM (Appelbaum i in., 2018). Wykorzystaj je jako listę kontrolną metody i wyników, a w czasopismach medycznych – wytyczne właściwe dla schematu badania, np. STROBE lub CONSORT. Tabele i rysunki generuj z tego samego skryptu co liczby w tekście. Abstrakt pisz na końcu i porównaj każdą liczbę z tabelami.
- Wytyczne APA i JARS-Quant – co raportować w metodzie i wynikach badań ilościowych.
- Statystyka w publikacji medycznej – STROBE, CONSORT, Tabela 1 bez wartości p, regresja logistyczna i ROC.
- Tabele i rysunki do artykułu – wymogi czasopism, rysunki w R, kolory i materiały uzupełniające.
- Wielkość efektu – interpretacja – dobór miary, przedział ufności i porównanie z najmniejszym ważnym efektem.
- Abstrakt strukturalny i IMRAD – wzory abstraktów, słowa kluczowe i kontrola zgodności z wynikami.
- IMRAD – układ artykułu empirycznego i podział między wynikami a dyskusją.
- Abstrakt strukturalny – co podać pod nagłówkami Cel, Metoda, Wyniki i Wnioski.
- Materiały uzupełniające – co przenieść poza tekst główny i jak się do tego odwołać.
Etap 6. Wybierz czasopismo, udostępnij preprint i uporządkuj identyfikatory
Czasopismo wybieraj, zanim skończysz pisać, bo od niego zależą długość tekstu, układ i wymagania raportowania. Przed zgłoszeniem sprawdź wiarygodność tytułu. W porównaniu Shamseera i in. (2017) strony czasopism potencjalnie drapieżnych znacznie częściej niż strony czasopism legalnych zawierały błędy ortograficzne, a wiele z nich promowało fałszywy wskaźnik i podawało członków redakcji o niepotwierdzonej afiliacji. Zanim umieścisz preprint na serwerze, sprawdź politykę wybranego czasopisma. Profil ORCID uzupełnij raz i podawaj przy każdym zgłoszeniu.
- Jak wybrać czasopismo i rozpoznać drapieżne – krótka lista tytułów, kolejność zgłoszeń i kontrola wiarygodności.
- Czasopismo drapieżne – sygnały ostrzegawcze przed wysłaniem tekstu.
- Recenzja podwójnie ślepa – jak zamaskować manuskrypt i materiały uzupełniające.
- Konflikt interesów – co ujawnić, jak to zapisać i jak oddzielić finansowanie od roli sponsora.
- Preprint, open access i ORCID – serwery preprintów, licencje i identyfikator autora w praktyce doktoranta.
- Preprint – jak udostępnić tekst przed recenzją i połączyć go z wersją ostateczną.
- ORCID – trwały identyfikator badacza i pełny format jego zapisu.
- DOI – trwały identyfikator publikacji i poprawny zapis w bibliografii.
Etap 7. Odpowiedz recenzentom i wprowadź poprawki
Najczęstsze zarzuty statystyczne powtarzają się w kolejnych recenzjach: brak uzasadnienia liczebności, brak korekty na wielokrotne porównania, efekty bez przedziałów ufności, język przyczynowy przy danych korelacyjnych i niespójne liczby. Na każdą uwagę odpowiedz punkt po punkcie. Najpierw wykonaj dodatkowe analizy, potem napisz odpowiedź, a niezgodę uzasadnij źródłem. Nie powołuj się na moc post hoc ani na test Harmana jako dowód braku błędu wspólnej metody – żaden z nich nie odpowiada na takie zarzuty.
- Najczęstsze zarzuty recenzentów do statystyki – lista zarzutów i sposoby, by zapobiec im przed wysłaniem tekstu.
- Odpowiedź recenzentom – wzory PL i EN – gotowe sformułowania odpowiedzi w sprawach statystycznych.
- Analiza mocy post hoc – dlaczego moc obserwowana nic nie dodaje do wartości p i co podać zamiast niej.
- Wspólna wariancja metody i test Harmana – dlaczego test słabo wykrywa problem i nie dowodzi jego braku.
- Korelacja a przyczynowość – jak pisać o związkach, gdy schemat badania nie pozwala na wnioski przyczynowe.
- Test równoważności (TOST) – jak odpowiedzieć na pytanie, czy efektu praktycznie nie ma.
Etap 8. Udostępnij dane, kod i materiały
Udostępnione dane i kod pozwalają innym odtworzyć liczby z artykułu, a Tobie – wrócić do nich przy kolejnym tekście z cyklu. Zasady FAIR mówią, że dane mają być łatwe do znalezienia, dostępne, interoperacyjne i nadające się do ponownego użycia – także przez maszyny, a nie tylko ludzi (Wilkinson i in., 2016). W praktyce oznacza to repozytorium z DOI, książkę kodową, licencję i plik README. Przed publikacją rozpakuj pakiet w pustym folderze i uruchom skrypty od zera.
- Pakiet replikacyjny: dane i kod do artykułu – zawartość pakietu, repozytorium z DOI i deklaracja dostępności danych.
- Otwarte dane – jak udostępnić dane z książką kodową, licencją i identyfikatorem.
- Open science – praktyki otwartej nauki, które najwięcej dają, gdy zaplanujesz je przed zebraniem danych.
- Replikowalność – czym różni się od odtwarzalności i odporności wyniku.
- Kryzys replikacyjny w psychologii – skąd się wziął i co zmienić we własnym badaniu.
Mam problem → przeczytaj
Typowe sytuacje z doktoratu i procesu publikacji, z odesłaniem do strony, od której warto zacząć.
| Problem | Co przeczytać |
|---|---|
| Muszę uzasadnić liczebność próby w indywidualnym planie badawczym albo we wniosku. | Plan analiz do wniosku grantowego i analiza mocy a priori |
| Nie wiem, jaką wielkość efektu przyjąć do analizy mocy. | SESOI |
| Chcę prerejestrować badanie, ale boję się, że plan mnie ograniczy. | Plan analizy i prerejestracja |
| Z jednego zbioru danych powstaną trzy artykuły. | Doktorat z cyklu artykułów |
| Liczby N, M i SD różnią się między moimi artykułami. | Spójna analiza w cyklu, potem pakiet replikacyjny |
| Chcę przeanalizować dane z publicznego repozytorium. | Reanaliza i wtórna analiza |
| Osoby odpadają z kolejnych pomiarów. | ANOVA czy model mieszany i braki danych |
| Główna hipoteza się nie potwierdziła. | Hipoteza się nie potwierdziła |
| Nie wiem, które wytyczne raportowania obowiązują mój typ badania. | JARS-Quant albo STROBE i CONSORT |
| Czasopismo ogranicza liczbę tabel. | Tabele i rysunki i materiały uzupełniające |
| Przyszło zaproszenie do publikacji z obietnicą szybkiej akceptacji. | Czasopismo drapieżne |
| Nie wiem, czy mogę wrzucić preprint przed zgłoszeniem. | Preprint, open access i ORCID |
| Recenzent żąda analizy mocy post hoc. | Analiza mocy post hoc i wzory odpowiedzi |
| Recenzent pisze o błędzie wspólnej metody. | Wspólna wariancja metody |
| Recenzent zarzuca brak korekty na wielokrotne porównania. | Poprawki na wielokrotne porównania |
| Czasopismo wymaga deklaracji dostępności danych. | Pakiet replikacyjny i anonimizacja |
| Planuję badanie „nie gorszy niż” standard. | Non-inferiority i równoważność |
| Randomizuję oddziały, szkoły albo przychodnie, a nie osoby. | Randomizacja klastrowa |
| Przed grantem chcę zrobić pilotaż. | Pilotaż wykonalności |
| Każdy uczestnik dostaje obie interwencje. | Schemat naprzemienny |
| Recenzent pyta o wiarygodność badania jakościowego. | Badanie jakościowe w rozdziale metodologicznym |
| Czasopismo wymaga listy COREQ. | COREQ – lista kontrolna |
| Recenzent prosi o analizę wrażliwości. | Analiza wrażliwości w artykule |
| Recenzent pyta, dlaczego kontrolowałem(-am) te zmienne. | Grafy przyczynowe (DAG) |
| Mam dane z badania dzienniczkowego (ESM/EMA). | Badania dzienniczkowe i EMA |
| Chcę policzyć zmienność regulacji emocji. | Zmienność regulacji emocji w ESM |
| Model autoregresyjny i braki w ESM. | Wielopoziomowy model autoregresyjny |
| Eksperyment z wieloma bodźcami. | Efekty skrzyżowane |
| Przydział według progu albo naturalny eksperyment. | RDD i zmienne instrumentalne |
| Recenzent pyta o nieliniowość. | Splajny i GAM |
| Chcę użyć lasu losowego. | Drzewa decyzyjne i lasy losowe |
| Analizuję dane z ESS albo PGSS. | Dane z dużych badań sondażowych |
| Recenzent pyta, co wyjaśnia heterogeniczność w metaanalizie. | Metaregresja i moderatory |
| Chcę pokazać, że wynik nie zależy od arbitralnych decyzji analitycznych. | Multiverse i krzywa specyfikacji |
| Czasopismo wymaga listy kontrolnej zgodnej z EQUATOR. | Wytyczne raportowania |
| Mam dane panelowe firm albo gmin z kilku lat. | Dane panelowe i test Hausmana |
| Recenzent kwestionuje ANCOVA w badaniu bez randomizacji. | Paradoks Lorda |
| Szukam klas osób o odmiennym przebiegu zmian w czasie. | Trajektorie: LCGA i GMM |
| Kilka obserwacji zmienia znak współczynnika regresji. | Regresja odporna M i MM |
| Recenzent prosi o porównanie modelu z alternatywnym. | Analiza ścieżek w lavaan |
| Grantodawca wymaga planu zarządzania danymi. | DMP i zasady FAIR |
| Recenzent pyta o błąd publikacji w mojej metaanalizie. | Błąd publikacji w metaanalizie |
| Porównuję wiele interwencji w jednej metaanalizie. | Metaanaliza sieciowa |
Najważniejsze hasła ze słownika
Hasła z obszaru publikacji i otwartej nauki zebrane w grupy. Część z nich pojawiła się już na ścieżce – tu masz je w jednym miejscu.
Artykuł i proces wydawniczy
IMRAD · abstrakt strukturalny · czasopismo drapieżne · preprint · ORCID · DOI · recenzja podwójnie ślepa · otwarte dane · materiały uzupełniające · konflikt interesów · styl APA
Wiarygodność wyników
Prerejestracja · registered report · HARKing · p-hacking · replikowalność · błąd I i II rodzaju
Planowanie i analiza
Moc testu · analiza mocy a priori · przedział ufności · model wielopoziomowy · efekty stałe i losowe · czynnik Bayesa
Synteza badań
Metaanaliza · przegląd systematyczny i PRISMA 2020
Odporność wyników i metaanaliza
Metaregresja · krzywa specyfikacji · zmienna zderzeniowa · frakcja brakującej informacji (FMI)
Kalkulatory przydatne przy planowaniu i recenzji
- Kalkulator liczebności próby – szybka kontrola liczebności dla testu t, korelacji i ankiety przed wpisaniem jej do planu.
- Konwerter wielkości efektu – przeliczenia d, r, OR, η² i NNT, gdy porównujesz swój wynik z literaturą albo przygotowujesz dane do metaanalizy.
- Kalkulator przedziału ufności – przedziały dla średniej, proporcji, korelacji i różnicy średnich, gdy recenzent prosi o CI.
- Kalkulator wartości p – dokładne p ze statystyki i stopni swobody, przydatne przy sprawdzaniu spójności liczb w tekście.
- Kalkulator ICC i efektu schematu – ICC i efekt schematu przy planowaniu badania wieloośrodkowego albo klastrowego.
- Kalkulator AVE, CR i HTMT – trafność zbieżna i różnicowa przed wysłaniem artykułu z modelem SEM.
- Kalkulator metaanalizy – model losowy, I², przedział predykcji i wykres lasu do pobrania.
- Kalkulator efektu pośredniego – przedział Monte Carlo z a, b i ich błędów standardowych.
- Kalkulator efektów prostych i Johnsona–Neymana – sondowanie interakcji z wykresem efektu warunkowego.
- Generator opisu wyników APA – gotowe zdanie z p i wielkością efektu oraz kontrola zgodności p ze statystyką.
Inne przewodniki
Jeśli artykuł dotyczy nowego lub adaptowanego narzędzia, przejdź też przewodnik po psychometrii i budowie skal. Modele strukturalne, które często pojawiają się w doktoratach, omawia przewodnik po SEM, a wybór testu do hipotezy – przewodnik po testach statystycznych.
Kiedy warto skorzystać z pomocy
Najwięcej zyskujesz na konsultacji na początku i w trakcie recenzji. Na początku – gdy plan analiz, analiza mocy i harmonogram pomiarów mają trafić do indywidualnego planu badawczego albo wniosku grantowego. W trakcie recenzji – gdy uwagi wymagają nowych analiz, a termin odpowiedzi jest krótki. W ramach analiz statystycznych dla badaczy sprawdzamy plan i modele, wykonujemy dodatkowe analizy i wyjaśniamy ich wyniki tak, by autor mógł je samodzielnie opisać i obronić. Pomoc w analizie ujawnij zgodnie z zasadami czasopisma i uczelni.
Najczęstsze pytania
Od czego zacząć planowanie analiz w doktoracie?
Od rozpisania pytań badawczych na badania i planowane artykuły. Dla każdego badania ustal schemat, główny wynik i liczebność z uzasadnieniem, a potem zapisz plan analizy przed zebraniem danych. Szczegóły opisuje wpis analiza statystyczna w doktoracie.
Czy po prerejestracji badania można jeszcze zmienić analizę?
Tak, ale każde odstępstwo opisz jawnie: co zmieniono, kiedy, dlaczego i jak wpłynęło to na wynik. Analizy, których nie było w planie, przedstaw jako eksploracyjne. Prerejestracja nie zakazuje zmian – pozwala czytelnikowi odróżnić to, co zaplanowano, od tego, co dodano po obejrzeniu danych.
Ile artykułów można napisać z jednego zbioru danych w doktoracie?
Nie ma sztywnej liczby, ale każdy artykuł powinien odpowiadać na inne pytanie i jawnie wymieniać wcześniejsze publikacje z tego samego zbioru. Wszystkie teksty licz z jednego zamrożonego zbioru analitycznego, z tymi samymi regułami wykluczeń i liczenia wyników. Wyników z tej samej próby nie łącz w metaanalizie tak, jakby pochodziły z niezależnych badań.
Co dołączyć do artykułu, żeby inni mogli powtórzyć analizę?
Dane po anonimizacji, książkę kodową, skrypty, opis środowiska obliczeniowego, licencję i plik README, umieszczone w repozytorium z DOI. W artykule podaj deklarację dostępności danych z identyfikatorem i warunkami dostępu. Instrukcję znajdziesz we wpisie pakiet replikacyjny.
Co odpowiedzieć recenzentowi, który prosi o moc post hoc?
Wyjaśnij uprzejmie, że moc obliczona z efektu uzyskanego w próbie jest prostą funkcją wartości p i nie dodaje nowej informacji. Zamiast niej podaj wielkość efektu z 95% przedziałem ufności i analizę wrażliwości, czyli najmniejszy efekt, który badanie mogło wykryć. Gotowe sformułowania znajdziesz we wzorach odpowiedzi recenzentom.
Powiązane hasła
Przeczytaj też
Analiza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →PoradnikDoktorat z cyklu artykułów a spójna analiza
Jeden zbiór danych w kilku artykułach: wspólny potok, mapa cyklu, kontrola liczb, hipotezy rozprawy i minimetaanaliza w omówieniu – z kodem R.
Czytaj →PoradnikOdpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →Planujesz część empiryczną doktoratu albo odpowiadasz na recenzję?
Sprawdzimy plan analiz i analizę mocy, wykonamy dodatkowe analizy, o które proszą recenzenci, i wyjaśnimy wyniki tak, żeby można je było samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Shamseer, L., Moher, D., Maduekwe, O., Turner, L., Barbour, V., Burch, R., Clark, J., Galipeau, J., Roberts, J., & Shea, B. J. (2017). Potential predatory and legitimate biomedical journals: Can you tell the difference? A cross-sectional comparison. BMC Medicine, 15(1), Article 28. https://doi.org/10.1186/s12916-017-0785-9 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., . . . Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), Article 160018. https://doi.org/10.1038/sdata.2016.18 ● Otwarty dostęp
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{shamseer2017potential, author={Shamseer, Larissa and Moher, David and Maduekwe, Onyi and Turner, Lucy and Barbour, Virginia and Burch, Rebecca and Clark, Jocalyn and Galipeau, James and Roberts, Jason and Shea, Beverley J.}, title={{Potential predatory and legitimate biomedical journals: Can you tell the difference? A cross-sectional comparison}}, journal={BMC Medicine}, year={2017}, volume={15}, number={1}, eid={28}, doi={10.1186/s12916-017-0785-9}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wilkinson2016fair, author={Wilkinson, Mark D. and Dumontier, Michel and Aalbersberg, IJsbrand Jan and Appleton, Gabrielle and Axton, Myles and Baak, Arie and Blomberg, Niklas and Boiten, Jan-Willem and da Silva Santos, Luiz Bonino and Bourne, Philip E. and Bouwman, Jildau and Brookes, Anthony J. and Clark, Tim and Crosas, Mercè and Dillo, Ingrid and Dumon, Olivier and Edmunds, Scott and Evelo, Chris T. and Finkers, Richard and Gonzalez-Beltran, Alejandra and Gray, Alasdair J.G. and Groth, Paul and Goble, Carole and Grethe, Jeffrey S. and Heringa, Jaap and ’t Hoen, Peter A.C and Hooft, Rob and Kuhn, Tobias and Kok, Ruben and Kok, Joost and Lusher, Scott J. and Martone, Maryann E. and Mons, Albert and Packer, Abel L. and Persson, Bengt and Rocca-Serra, Philippe and Roos, Marco and van Schaik, Rene and Sansone, Susanna-Assunta and Schultes, Erik and Sengstag, Thierry and Slater, Ted and Strawn, George and Swertz, Morris A. and Thompson, Mark and van der Lei, Johan and van Mulligen, Erik and Velterop, Jan and Waagmeester, Andra and Wittenburg, Peter and Wolstencroft, Katherine and Zhao, Jun and Mons, Barend}, title={{The FAIR Guiding Principles for scientific data management and stewardship}}, journal={Scientific Data}, year={2016}, volume={3}, number={1}, eid={160018}, doi={10.1038/sdata.2016.18}}