robustbase::lmrob) wytrzymuje do połowy wadliwych obserwacji i przy czystych danych traci tylko około 5% efektywności. Nie myl go z błędami HC3, które poprawiają tylko błędy standardowe, ani z naprawą źle określonego modelu.Kiedy metoda najmniejszych kwadratów zawodzi
Metoda najmniejszych kwadratów (MNK, ang. ordinary least squares, OLS) minimalizuje sumę kwadratów reszt. Kwadrat sprawia, że reszta 30 punktów „waży” dziewięć razy więcej niż reszta 10 punktów. Prosta przesuwa się więc w stronę kilku najbardziej nietypowych osób. Yu i Yao (2017) przypominają, że nawet jedna nietypowa obserwacja może silnie zmienić oszacowania MNK.
Rousseeuw i van Zomeren (1990) odróżniają trzy rodzaje nietypowych obserwacji:
- Odstające w pionie. Typowe wartości predyktorów, ale wynik daleko od prostej, np. osoba odpowiadająca nieuważnie, która zaznaczyła skrajne odpowiedzi. Przesuwają głównie wyraz wolny i zawyżają błędy.
- Dobre punkty dźwigni. Skrajne wartości predyktora, ale wynik zgodny z trendem. Zwiększają precyzję i nie są problemem.
- Złe punkty dźwigni. Skrajny predyktor i wynik sprzeczny z resztą danych, np. skala policzona z odwróconym kluczem. To one potrafią odwrócić znak nachylenia.
Jak takie obserwacje wykryć (reszty, dźwignia, odległość Cooka, odporna odległość Mahalanobisa), opisujemy w poradniku wartości odstające: jak je wykryć. Kiedy wolno je usunąć, wyjaśnia wpis czy można usunąć obserwacje odstające. Tutaj zajmujemy się trzecią drogą: modelem, który sam ogranicza wpływ takich obserwacji. Regresja odporna nie wymaga decyzji „zostawić czy usunąć” i przy czystych danych daje prawie te same wyniki co MNK.
Estymatory M: Huber i bisquare Tukeya
Huber (1964) zaproponował estymatory pośrednie między średnią a medianą dla danych, w których niewielki ułamek obserwacji pochodzi z innego rozkładu, np. z grubych błędów. W regresji estymator M zastępuje kwadrat reszty funkcją ρ, która dla dużych reszt rośnie wolniej. W praktyce działa to jak iteracyjnie ważona MNK: model liczy reszty, dzieli je przez odporną miarę skali (np. opartą na MAD), nadaje każdej osobie wagę i dopasowuje model ponownie, aż wagi przestaną się zmieniać. Hasło estymator M pokazuje wzór krok po kroku.
| Funkcja | Waga dla reszty standaryzowanej u | Stała (95% efektywności) | Duże reszty |
|---|---|---|---|
| Huber | 1, gdy |u| ≤ k; k/|u| powyżej | k = 1.345 | waga maleje, ale nigdy nie spada do zera |
| Bisquare (Tukey) | (1 − (u/c)²)², gdy |u| < c; 0 powyżej | c = 4.685 | obserwacja dalej niż c traci głos całkowicie |
Stałe dobiera się tak, by przy normalnych błędach estymator miał 95% efektywności MNK. Za odporność płacisz więc niewiele. Estymatory M mają jednak dwie słabości. Po pierwsze, waży się tylko resztę, a nie wartości predyktorów. Zły punkt dźwigni przyciąga prostą tak mocno, że jego własna reszta staje się mała i dostaje wagę bliską 1. Dlatego zwykły estymator M nie jest odporny na złe punkty dźwigni. Po drugie, bisquare ma wiele lokalnych minimów. Algorytm startujący z MNK może utknąć przy rozwiązaniu, które MNK już „zepsuła”.
Estymator MM: wysoki punkt załamania i wysoka efektywność
Punkt załamania to najmniejszy odsetek obserwacji, który po dowolnej zmianie może przesunąć oszacowania dowolnie daleko. Dla MNK wynosi 0: wystarczy jedna obserwacja. Yohai (1987) zaproponował estymator MM, który łączy punkt załamania 0.5 z wysoką efektywnością przy normalnych błędach. Liczy się go w trzech krokach:
- odporny estymator startowy o wysokim punkcie załamania (w
lmrobestymator S), który nie musi być efektywny; - odporna skala reszt (M-estymator skali) z reszt tego startu;
- estymator M współczynników z funkcją bisquare, startujący z kroku 1, przy skali z kroku 2 trzymanej na stałe.
Dobry start rozwiązuje problem lokalnych minimów, a stała skala nie pozwala, by wadliwe obserwacje „rozdęły” miarę rozrzutu. W R estymator MM daje robustbase::lmrob (domyślnie bisquare, 95% efektywności) albo MASS::rlm(..., method = "MM"). Koller i Stahel (2011) pokazali, że przy małej liczbie obserwacji na parametr (n < 5p) przedziały ufności z MM bywają zbyt wąskie. Zaproponowali poprawioną skalę i wolniej opadającą funkcję wag. Odpowiada im ustawienie setting = "KS2014" w lmrob.
Przykład: stres w pracy a wypalenie
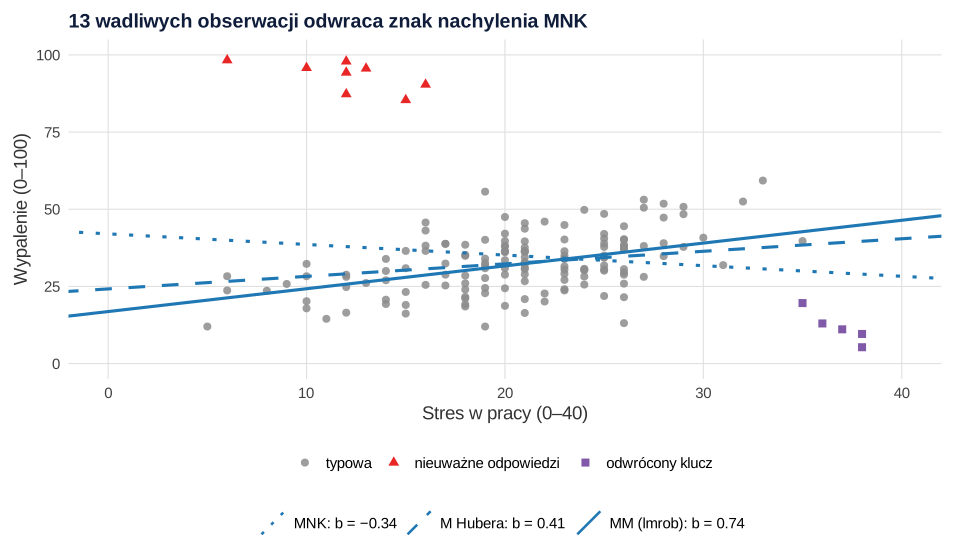
W ankiecie wzięło udział 160 osób z personelu pielęgniarskiego. Model przewiduje wypalenie (0–100) na podstawie stresu w pracy (0–40) i wsparcia przełożonych (1–5). Dane są symulowane (set.seed(2381)), a prawdziwe nachylenie dla stresu wynosi 1.2 pkt. Do danych dodaliśmy dwa typowe kłopoty. Osiem osób odpowiadało nieuważnie (zob. nieuważne odpowiedzi) i ma wypalenie 85–100 pkt przy niskim stresie. Pięciu osobom skalę stresu policzono bez odwrócenia pozycji odwróconych, więc mają 35–39 pkt stresu przy niskim wypaleniu. Plik możesz pobrać jako CSV (kolumna typ zdradza, kto jest „wadliwy” – w prawdziwych danych tej informacji nie masz).
| Estymator | b stres (SE) | 95% CI | p | b wsparcie (SE) |
|---|---|---|---|---|
| MNK | −0.34 (0.21) | [−0.75, 0.06] | .098 | 0.21 (1.72) |
| MNK + błędy HC3 | −0.34 (0.31) | [−0.96, 0.27] | .270 | 0.21 (1.79) |
M Hubera (rlm) | 0.41 (0.13) | [0.15, 0.66] | .002 | −1.56 (1.07) |
M bisquare ze startem z MNK (rlm) | 0.75 (0.11) | [0.53, 0.97] | < .001 | −2.22 (0.94) |
MM (lmrob, domyślne) | 0.74 (0.20) | [0.35, 1.13] | < .001 | −2.22 (0.93) |
MM (lmrob, KS2014) | 0.74 (0.12) | [0.49, 0.98] | < .001 | −2.24 (0.92) |
Trzynaście wadliwych obserwacji (8% próby) odwróciło znak nachylenia MNK: więcej stresu miałoby oznaczać mniej wypalenia. Estymator Hubera poprawił kierunek, ale złe punkty dźwigni nadal ściągają prostą w dół (0.41). Estymator MM dał 0.74. Dla porównania: MNK policzona tylko na 147 poprawnych obserwacjach daje 0.87. MM nie odtwarza więc „czystego” wyniku idealnie, bo osoby z odwróconym kluczem leżą od 2.5 do 4 odpornych SD od prostej i zachowują niewielkie wagi. Jest jednak nieporównanie bliżej niż MNK. Tu bisquare ze startem z MNK też zadziałał. W symulacji niżej, przy skupisku złych punktów dźwigni, już nie.
Wagi obserwacji: co model „wyciszył”
Każdy estymator M i MM zwraca wagi z przedziału od 0 do 1 (weights(m, type = "robustness") w lmrob, m$w w rlm). W przykładzie MM nadał wszystkim ośmiu osobom odpowiadającym nieuważnie wagę 0.00. Osoby z odwróconym kluczem dostały średnio 0.22 (od 0.08 do 0.50), a typowe obserwacje – 0.94. Estymator Hubera dał odpowiednio 0.17, 0.42 i 0.95. Złe punkty dźwigni zachowały u niego dwa razy większy wpływ.
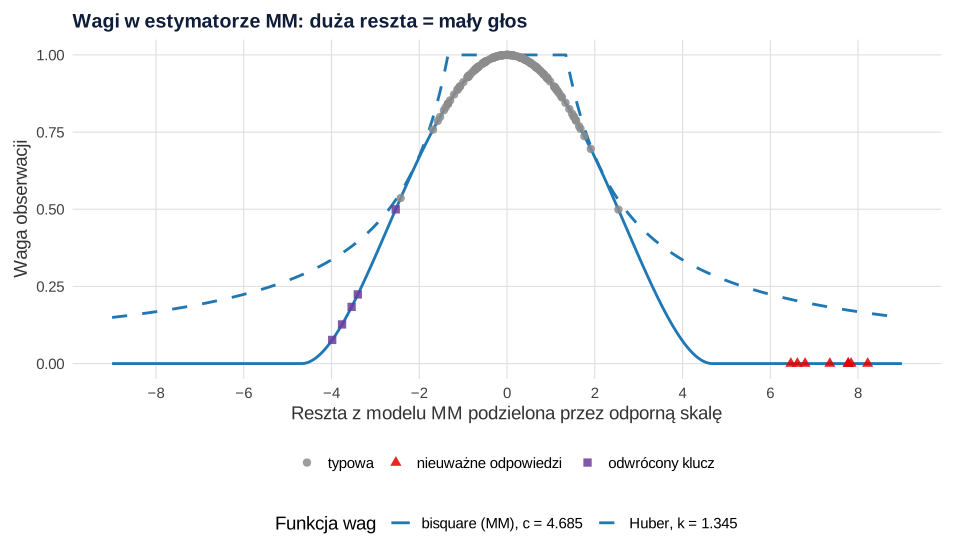
Wagi są świetnym narzędziem diagnostycznym. Lista osób z wagą poniżej 0.5 to lista do sprawdzenia w danych źródłowych. W przykładzie trafiło na nią 14 osób: wszystkie 13 wadliwych i jedna typowa. Nie jest to jednak reguła usuwania. Model już ograniczył wpływ tych osób. Usunięcie ich i powtórzenie MNK zaniżyłoby niepewność, bo decyzja zależna od danych udawałaby ustaloną z góry. Odporna skala reszt (9.27 pkt przy prawdziwym SD = 8) służy do standaryzacji reszt i jest dobrą miarą rozrzutu typowych obserwacji.
Regresja odporna a błędy HC3: dwie różne odporności
Słowo „odporny” oznacza w regresji dwie różne rzeczy:
- Odporne błędy standardowe HC3 zostawiają współczynniki MNK bez zmian. Poprawiają tylko błędy standardowe, gdy wariancja reszt nie jest stała. Long i Ervin (2000) zalecają HC3 przy N ≤ 250.
- Regresja odporna zmienia same współczynniki: ogranicza wpływ obserwacji, które nie pasują do modelu.
W tabeli wyżej HC3 poszerzył przedział ufności dla stresu, ale zostawił błędny znak −0.34. Na obserwacje wpływowe HC3 nic nie poradzi. Odwrotnie: MM nie naprawi heteroskedastyczności, która wynika z natury danych (np. rozrzut rośnie z predyktorem). Błędy standardowe w lmrob liczy się z kowariancji asymptotycznej, która uwzględnia wagi, ale nie jest sama w sobie poprawką HC. Gdy masz oba problemy, opisz w planie analizy, który jest główny. Pierwszy możesz sprawdzić diagnostyką regresji, a drugi – wykresem wag i reszt.
Zwróć też uwagę na dwa wiersze MM w tabeli. Współczynniki są niemal identyczne, ale błąd standardowy nachylenia wynosi 0.20 przy ustawieniach domyślnych i 0.12 przy KS2014. Estymator kowariancji to decyzja, którą trzeba zapisać, tak jak wariant HC.
Kiedy regresja odporna nie pomaga
Trzy małe symulacje z drugiego przepisu w R pokazują granice metody.
A. Skupisko złych punktów dźwigni. Do 100 obserwacji z nachyleniem 1 dodaliśmy 15 osób ze skrajną wartością predyktora i sprzecznym wynikiem. MNK dała −0.65, M Hubera −0.69, a bisquare ze startem z MNK −0.69. Dopiero MM, startujący z estymatora o wysokim punkcie załamania, dał 0.89. Estymatory M bez dobrego startu nie chronią przed błędami w predyktorach o wysokiej dźwigni. Nie pomoże też żaden estymator, gdy wadliwa jest ponad połowa danych.
B. Zła specyfikacja modelu. Prawdziwa zależność była logarytmiczna, a model liniowy. MM nadał wagę poniżej 0.5 jedenastu osobom, wszystkim z najniższych lub najwyższych 10% wartości predyktora. W modelu z log(x) takich osób były dwie. Regresja odporna potraktowała krzywiznę jak „obserwacje odstające” i wyciszyła prawdziwe dane, zamiast ujawnić błąd modelu. Skupisko małych wag na końcu zakresu predyktora to sygnał, by sprawdzić postać zależności (zob. regresja krzywoliniowa), interakcje albo pominiętą podgrupę.
C. Cena i zysk. W 1000 powtórzeń z n = 50 policzyliśmy rozrzut (SD) oszacowań nachylenia:
| Rozkład błędów | MNK | M Hubera | MM |
|---|---|---|---|
| normalny | 0.145 | 0.149 | 0.150 |
| normalny z 10% zanieczyszczeń (SD = 10) | 0.478 | 0.172 | 0.159 |
| t z 3 stopniami swobody | 0.242 | 0.189 | 0.188 |
Przy normalnych błędach MM traci ok. 7% efektywności (0.145² / 0.150² = 0.93), przy zanieczyszczonych daje trzy razy mniejszy rozrzut niż MNK. Field i Wilcox (2017) pokazują, że dane psychologiczne często naruszają założenia modelu liniowego, a metody odporne bywają przy tym dokładniejsze i mają większą moc. Te same argumenty rozwija podręcznik Wilcoxa (2021). Regresja odporna nie rozwiąże jednak problemów innych niż odstające reszty: błędu pomiaru predyktora, zależnych obserwacji (klasy, pomiary powtarzane) ani pytania o kwantyl zamiast średniej, do którego służy regresja kwantylowa.
Jak opisać regresję odporną
W metodach podaj estymator (MM, funkcja bisquare, 95% efektywności), program i pakiet z wersją, estymator kowariancji i powód wyboru. Najlepiej zapisz ten wybór w planie analizy, zanim zobaczysz dane. Jeśli analizą główną jest MNK, pokaż MM jako analizę wrażliwości (zob. analiza wrażliwości w artykule) i opisz rozbieżności. Podaj też liczbę obserwacji z małymi wagami i to, co o nich wiesz.
Tabelę współczynników przygotujesz jak dla zwykłej regresji (zob. tabela regresji w APA), z dopiskiem o estymatorze w uwadze pod tabelą. Ogólny przebieg modelu opisuje poradnik regresja wieloraka krok po kroku. Jeśli recenzent kwestionuje wybór estymatora albo wpływ kilku obserwacji, możemy pomóc w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei. Pierwszy tworzy dane, zapisuje plik regresja-odporna-dane.csv (możesz go pobrać tutaj) i liczy wszystkie wyniki przykładu. Drugi zawiera trzy symulacje granic metody. Potrzebne są pakiety MASS, robustbase, sandwich i lmtest.
1. MNK, HC3, estymatory M i MM oraz wagi
R
# Dane symulowane: ankieta 160 pielęgniarek i pielęgniarzy. wypalenie – wynik skali wypalenia (0–100),
# stres – stres w pracy (0–40), wsparcie – wsparcie przełożonych (1–5).
# Prawdziwy model: wypalenie = 20 + 1.2 × stres − 4 × wsparcie + błąd (SD = 8).
# Zanieczyszczenie: 8 osób odpowiadających nieuważnie (bardzo wysokie wypalenie niezależnie od stresu)
# i 5 osób, którym skalę stresu policzono z odwróconym kluczem (skrajny stres przy niskim wypaleniu).
suppressPackageStartupMessages({ library(MASS); library(robustbase); library(sandwich); library(lmtest) })
set.seed(2381)
n <- 160
stres <- round(pmin(pmax(rnorm(n, 20, 6), 0), 40))
wsparcie <- round(pmin(pmax(rnorm(n, 3.2, 0.8), 1), 5), 1)
wypalenie <- 20 + 1.2 * stres - 4 * wsparcie + rnorm(n, 0, 8)
typ <- rep("typowa", n)
niewazni <- 1:8                                          # odstające w pionie
wypalenie[niewazni] <- runif(8, 85, 100)
stres[niewazni] <- round(runif(8, 6, 16))
typ[niewazni] <- "nieuważne odpowiedzi"
klucz <- 9:13                                            # złe punkty dźwigni
stres[klucz] <- 40 - round(runif(5, 1, 5))               # odwrócony klucz: prawdziwy stres 1–5
wypalenie[klucz] <- 20 + 1.2 * (40 - stres[klucz]) - 4 * wsparcie[klucz] + rnorm(5, 0, 4)
typ[klucz] <- "odwrócony klucz"
wypalenie <- round(pmin(pmax(wypalenie, 0), 100), 1)
dane <- data.frame(id = sprintf("o%03d", 1:n), stres, wsparcie, wypalenie, typ)
write.csv(dane, "regresja-odporna-dane.csv", row.names = FALSE)

# 1. Cztery estymatory na tych samych danych
m_ols   <- lm(wypalenie ~ stres + wsparcie, data = dane)
m_huber <- rlm(wypalenie ~ stres + wsparcie, data = dane, psi = psi.huber)            # M Hubera, k = 1.345
m_bisq  <- rlm(wypalenie ~ stres + wsparcie, data = dane, psi = psi.bisquare, maxit = 100)  # M Tukeya startujące z MNK
m_mm    <- lmrob(wypalenie ~ stres + wsparcie, data = dane)                          # MM: start S, bisquare, 95% efektywności
m_ks    <- lmrob(wypalenie ~ stres + wsparcie, data = dane, setting = "KS2014")      # ustawienia Kollera i Stahela

wiersz <- function(nazwa, b, se, df) {
  data.frame(estymator = nazwa, b_stres = b[["stres"]], SE_stres = se[["stres"]],
             dolny95 = b[["stres"]] - qt(.975, df) * se[["stres"]], gorny95 = b[["stres"]] + qt(.975, df) * se[["stres"]],
             p_stres = 2 * pt(-abs(b[["stres"]] / se[["stres"]]), df), b_wsparcie = b[["wsparcie"]], SE_wsparcie = se[["wsparcie"]],
             p_wsparcie = 2 * pt(-abs(b[["wsparcie"]] / se[["wsparcie"]]), df))
}
se <- function(m) sqrt(diag(vcov(m)))
df <- n - 3
tab <- rbind(
  wiersz("MNK (OLS)", coef(m_ols), se(m_ols), df),
  wiersz("MNK + HC3", coef(m_ols), sqrt(diag(vcovHC(m_ols, type = "HC3"))), df),
  wiersz("M Hubera (rlm)", coef(m_huber), se(m_huber), df),
  wiersz("M bisquare z MNK (rlm)", coef(m_bisq), se(m_bisq), df),
  wiersz("MM (lmrob)", coef(m_mm), se(m_mm), df),
  wiersz("MM KS2014 (lmrob)", coef(m_ks), se(m_ks), df))
print(cbind(tab[1], round(tab[-1], 3)), row.names = FALSE)

# Te same estymatory bez 13 wadliwych obserwacji (punkt odniesienia; w realnych danych go nie znasz)
czyste <- dane$typ == "typowa"
round(rbind(MNK_czyste = coef(lm(wypalenie ~ stres + wsparcie, data = dane[czyste, ])),
            MM_czyste = coef(lmrob(wypalenie ~ stres + wsparcie, data = dane[czyste, ]))), 3)

# 2. Wnioskowanie w MM: testy Walda dla współczynników
summary(m_mm)$coefficients |> round(4)
summary(m_mm)$scale |> round(2)                      # odporna skala reszt

# 3. Wagi obserwacji: kto został „wyciszony”
dane$w_huber <- m_huber$w
dane$w_mm <- weights(m_mm, type = "robustness")
aggregate(cbind(w_huber, w_mm) ~ typ, data = dane, FUN = function(x) round(mean(x), 2))
c(wagi_mm_ponizej_0.1 = sum(dane$w_mm < .1), wagi_mm_ponizej_0.5 = sum(dane$w_mm < .5),
  typowe_z_waga_ponizej_0.5 = sum(dane$w_mm < .5 & czyste))
Wynik w R
              estymator b_stres SE_stres dolny95 gorny95 p_stres b_wsparcie
              MNK (OLS)  -0.344    0.206  -0.751   0.064   0.098      0.214
              MNK + HC3  -0.344    0.310  -0.957   0.269   0.270      0.214
         M Hubera (rlm)   0.406    0.128   0.153   0.660   0.002     -1.560
 M bisquare z MNK (rlm)   0.750    0.113   0.528   0.973   0.000     -2.215
             MM (lmrob)   0.739    0.197   0.351   1.128   0.000     -2.215
      MM KS2014 (lmrob)   0.735    0.124   0.489   0.980   0.000     -2.235
 SE_wsparcie p_wsparcie
       1.719      0.901
       1.791      0.905
       1.070      0.147
       0.938      0.019
       0.934      0.019
       0.922      0.016
           (Intercept) stres wsparcie
MNK_czyste      21.840 0.873   -2.414
MM_czyste       21.371 0.877   -2.310
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  23.6573     4.3414  5.4493   0.0000
stres         0.7394     0.1965  3.7621   0.0002
wsparcie     -2.2154     0.9337 -2.3727   0.0189
[1] 9.27
                   typ w_huber w_mm
1 nieuważne odpowiedzi    0.17 0.00
2      odwrócony klucz    0.42 0.22
3               typowa    0.95 0.94
      wagi_mm_ponizej_0.1       wagi_mm_ponizej_0.5 typowe_z_waga_ponizej_0.5
                        9                        14                         1
2. Granice: złe punkty dźwigni, zła specyfikacja i efektywność
R
# Granice regresji odpornej na trzech małych symulacjach (kontynuacja przepisu 1: pakiety MASS i robustbase)
suppressPackageStartupMessages({ library(MASS); library(robustbase) })

# A. Skupisko złych punktów dźwigni (15% próby): start z MNK nie wystarcza
set.seed(2382)
n <- 100
x <- rnorm(n, 0, 1)
y <- 2 + 1 * x + rnorm(n, 0, 1)
zle <- 1:15
x[zle] <- rnorm(15, 5, 0.3)                      # nietypowe wartości predyktora...
y[zle] <- rnorm(15, -3, 0.5)                     # ...i wynik sprzeczny z resztą danych
d_a <- data.frame(x, y)
round(rbind(MNK = coef(lm(y ~ x, d_a)),
            M_Huber = coef(rlm(y ~ x, d_a, psi = psi.huber)),
            M_bisquare_start_MNK = coef(rlm(y ~ x, d_a, psi = psi.bisquare, maxit = 100)),
            MM_lmrob = coef(lmrob(y ~ x, d_a))), 3)

# B. Zła specyfikacja: prawdziwa zależność jest logarytmiczna (np. godziny treningu w miesiącu a wynik testu)
set.seed(2383)
x <- round(exp(rnorm(150, 3, 0.8)), 1)
y <- 10 + 8 * log(x) + rnorm(150, 0, 2)
d_b <- data.frame(x, y)
mm_lin <- lmrob(y ~ x, d_b)                      # model liniowy: zła postać zależności
mm_log <- lmrob(y ~ log(x), d_b)                 # model z log(x): poprawna postać
w_lin <- weights(mm_lin, type = "robustness"); w_log <- weights(mm_log, type = "robustness")
skraj <- x < quantile(x, .1) | x > quantile(x, .9)
c(waga_ponizej_0.5_liniowy = sum(w_lin < .5), w_tym_skrajne_10proc_x = sum(w_lin < .5 & skraj),
  waga_ponizej_0.5_log = sum(w_log < .5))
round(rbind(MNK_liniowy = coef(lm(y ~ x, d_b)), MM_liniowy = coef(mm_lin)), 3)

# C. Efektywność: ile kosztuje odporność, gdy danych nic nie psuje, i ile daje, gdy ogony są ciężkie
set.seed(2384)
symuluj <- function(bledy, R = 1000, n = 50) {
  b <- replicate(R, {
    x <- rnorm(n); y <- 1 + 0.5 * x + bledy(n)
    c(MNK = coef(lm(y ~ x))[[2]], Huber = coef(rlm(y ~ x, psi = psi.huber, maxit = 100))[[2]],
      MM = coef(lmrob(y ~ x, k.max = 2000))[[2]])
  })
  round(apply(b, 1, sd), 3)
}
rbind(normalne = symuluj(function(n) rnorm(n)),
      zanieczyszczone_10proc = symuluj(function(n) ifelse(runif(n) < .10, rnorm(n, 0, 10), rnorm(n))),
      t_3 = symuluj(function(n) rt(n, 3)))
Wynik w R
                     (Intercept)      x
MNK                        1.514 -0.650
M_Huber                    1.537 -0.689
M_bisquare_start_MNK       1.518 -0.693
MM_lmrob                   1.892  0.887
waga_ponizej_0.5_liniowy   w_tym_skrajne_10proc_x     waga_ponizej_0.5_log
                      11                       11                        2
            (Intercept)     x
MNK_liniowy      27.125 0.236
MM_liniowy       26.284 0.295
                         MNK Huber    MM
normalne               0.145 0.149 0.150
zanieczyszczone_10proc 0.478 0.172 0.159
t_3                    0.242 0.189 0.188
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), rlm(), lmrob(), vcovHC()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- robustbase (wersja 0.99.7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L. T., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Regresja odporna” bez nazwy estymatora. Huber, bisquare i MM dały w przykładzie 0.41, 0.75 i 0.74. Podaj estymator, funkcję wag, efektywność i pakiet.
- Estymator M Hubera przy nietypowych wartościach predyktorów. Nie chroni przed złymi punktami dźwigni. Do analizy głównej wybierz MM.
- HC3 jako lekarstwo na obserwacje wpływowe. Błędy HC3 nie zmieniają współczynników.
- Usuwanie osób z małą wagą i ponowne MNK. Wagi to lista do sprawdzenia, a nie reguła wykluczania.
- Wybór estymatora po obejrzeniu p. Zapisz go w prerejestracji lub planie analizy, a drugi pokaż jako analizę wrażliwości.
- Regresja odporna zamiast poprawienia modelu. Małe wagi skupione na końcach zakresu predyktora częściej oznaczają złą postać zależności niż wadliwe dane.
Najczęstsze pytania
Czym różni się estymator M od estymatora MM?
Estymator M (np. Hubera) zastępuje sumę kwadratów reszt funkcją, która rośnie wolniej dla dużych reszt, i liczy wagi obserwacji iteracyjnie. Chroni przed odstającymi wartościami zmiennej zależnej, ale już jedna obserwacja o skrajnej wartości predyktora może go zepsuć. Estymator MM (Yohai, 1987) zaczyna od estymatora o punkcie załamania 0.5, ustala z niego odporną skalę reszt, a dopiero potem liczy M z funkcją bisquare. Dlatego radzi sobie także ze złymi punktami dźwigni.
Czy regresja odporna zastępuje odporne błędy standardowe HC3?
Nie, bo rozwiązują różne problemy. HC3 zostawia współczynniki MNK bez zmian i tylko poprawia ich błędy standardowe przy niestałej wariancji reszt. Regresja odporna zmienia same współczynniki, ograniczając wpływ obserwacji niepasujących do modelu. W przykładzie z tego wpisu HC3 poszerzył przedział dla nachylenia, ale zostawił błędny znak −0.34, a MM dał 0.74.
Który estymator wybrać w R: rlm czy lmrob?
Do analizy głównej wybierz robustbase::lmrob, czyli estymator MM z punktem załamania 0.5 i efektywnością 95%. MASS::rlm z domyślną funkcją Hubera nie chroni przed nietypowymi wartościami predyktorów. Z funkcją bisquare i startem z MNK może utknąć w złym rozwiązaniu, a do MM trzeba go przełączyć opcją method = "MM". Przy małej liczbie obserwacji na parametr rozważ ustawienie setting = "KS2014", oparte na pracy Kollera i Stahela (2011).
Czy po regresji odpornej mogę usunąć obserwacje z wagą bliską zera?
Wagi wskazują, które osoby warto sprawdzić w danych źródłowych, ale nie są regułą usuwania. Model już je wyciszył, więc ich usunięcie i ponowne dopasowanie MNK nie poprawia analizy. Zaniża też niepewność, bo traktuje decyzję zależną od danych jak ustaloną z góry. Usuń obserwację tylko wtedy, gdy znajdziesz niezależny od wyniku powód, np. błąd kodowania.
Kiedy regresja odporna nie pomoże?
Gdy model ma złą postać, a odstające reszty wynikają z pominiętej nieliniowości, interakcji lub podgrupy. MM wyciszy wtedy prawdziwe obserwacje zamiast poprawić model. Nie pomoże też przy błędzie pomiaru predyktora, zależnych obserwacjach (np. klasy, powtarzane pomiary) ani gdy wadliwe są ponad połowa danych. Gdy celem jest kwantyl, a nie średnia warunkowa, właściwym narzędziem jest regresja kwantylowa.
Powiązane hasła
Przeczytaj też
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikCzy można usunąć obserwacje odstające?
Kiedy usunięcie wyniku jest uzasadnione, a kiedy staje się manipulacją: tabela decyzji, analiza wrażliwości w R i gotowy opis do pracy.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →Recenzent pyta o obserwacje wpływowe w Twojej regresji?
Pomożemy sprawdzić diagnostykę, dopasować regresję odporną jako analizę główną albo analizę wrażliwości i opisać wyniki tak, żebyś mógł(a) samodzielnie obronić wybór estymatora.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38. https://doi.org/10.1016/j.brat.2017.05.013 ● Otwarty dostęp: pełny tekst
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732 ● Otwarty dostęp
- Koller, M., & Stahel, W. A. (2011). Sharpening Wald-type inference in robust regression for small samples. Computational Statistics & Data Analysis, 55(8), 2504–2515. https://doi.org/10.1016/j.csda.2011.02.014
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Rousseeuw, P. J., & van Zomeren, B. C. (1990). Unmasking multivariate outliers and leverage points. Journal of the American Statistical Association, 85(411), 633–639. https://doi.org/10.1080/01621459.1990.10474920
- Wilcox, R. R. (2021). Introduction to robust estimation and hypothesis testing (5th ed.). Academic Press.
- Yohai, V. J. (1987). High breakdown-point and high efficiency robust estimates for regression. The Annals of Statistics, 15(2), 642–656. https://doi.org/10.1214/aos/1176350366 ● Otwarty dostęp
- Yu, C., & Yao, W. (2017). Robust linear regression: A review and comparison. Communications in Statistics – Simulation and Computation, 46(8), 6261–6282. https://doi.org/10.1080/03610918.2016.1202271 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{field2017robust, author={Field, Andy P. and Wilcox, Rand R.}, title={{Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={19--38}, doi={10.1016/j.brat.2017.05.013}}@article{huber1964robust, author={Huber, Peter J.}, title={{Robust estimation of a location parameter}}, journal={The Annals of Mathematical Statistics}, year={1964}, volume={35}, number={1}, pages={73--101}, doi={10.1214/aoms/1177703732}}@article{koller2011sharpening, author={Koller, Manuel and Stahel, Werner A.}, title={{Sharpening Wald-type inference in robust regression for small samples}}, journal={Computational Statistics \& Data Analysis}, year={2011}, volume={55}, number={8}, pages={2504--2515}, doi={10.1016/j.csda.2011.02.014}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{rousseeuw1990unmasking, author={Rousseeuw, Peter J. and van Zomeren, Bert C.}, title={{Unmasking multivariate outliers and leverage points}}, journal={Journal of the American Statistical Association}, year={1990}, volume={85}, number={411}, pages={633--639}, doi={10.1080/01621459.1990.10474920}}@book{wilcox2021introduction, author={Wilcox, Rand R.}, title={{Introduction to robust estimation and hypothesis testing (5th ed.)}}, year={2021}, publisher={Academic Press}}@article{yohai1987high, author={Yohai, Victor J.}, title={{High breakdown-point and high efficiency robust estimates for regression}}, journal={The Annals of Statistics}, year={1987}, volume={15}, number={2}, pages={642--656}, doi={10.1214/aos/1176350366}}@article{yu2017robust, author={Yu, Chun and Yao, Weixin}, title={{Robust linear regression: A review and comparison}}, journal={Communications in Statistics – Simulation and Computation}, year={2017}, volume={46}, number={8}, pages={6261--6282}, doi={10.1080/03610918.2016.1202271}}