Abstrakt czytają wszyscy, cały artykuł – nieliczni
Recenzent decyduje, czy przyjąć zaproszenie do recenzji, po przeczytaniu abstraktu. Redaktor często na jego podstawie wstępnie ocenia, czy tekst pasuje do czasopisma. Autorzy przeglądów systematycznych przesiewają tysiące rekordów po tytule i abstrakcie. Zalecenia ICMJE przypominają, że w wielu bazach abstrakt jest jedyną indeksowaną częścią artykułu z merytoryczną treścią i jedyną, którą czyta wielu czytelników, dlatego musi wiernie oddawać treść pracy – a informacje w abstraktach często różnią się od tych w tekście (International Committee of Medical Journal Editors, 2026).
Ten wpis jest praktycznym przewodnikiem dla badaczy i doktorantów, którzy przygotowują artykuł empiryczny. Pokazujemy, jak struktura IMRAD przekłada się na abstrakt strukturalny, podajemy trzy gotowe wzory (badanie przekrojowe, badanie randomizowane i przegląd systematyczny) z liczbami policzonymi w R, omawiamy słowa kluczowe i – co najważniejsze – sposób sprawdzenia, czy abstrakt zgadza się z wynikami. Definicje pojęć znajdziesz w słowniku; tutaj skupiamy się na pisaniu i kontroli.
IMRAD: logika artykułu, nie tylko spis nagłówków
Większość artykułów empirycznych ma cztery części: wprowadzenie (Introduction), metodę (Methods), wyniki (Results) i dyskusję (Discussion). ICMJE zaznacza, że układ IMRAD nie jest arbitralnym formatem wydawniczym, lecz odzwierciedleniem przebiegu odkrycia naukowego; metaanalizy mogą wymagać innego układu, a opisy przypadków, przeglądy narracyjne i artykuły redakcyjne bywają mniej ustrukturyzowane (International Committee of Medical Journal Editors, 2026). Układ nie jest stary: w próbie artykułów z czterech czołowych czasopism medycznych IMRAD pojawił się w latach 40. XX wieku, w latach 70. osiągnął 80%, a w latach 80. był jedynym wzorcem artykułów oryginalnych (Sollaci i Pereira, 2004).
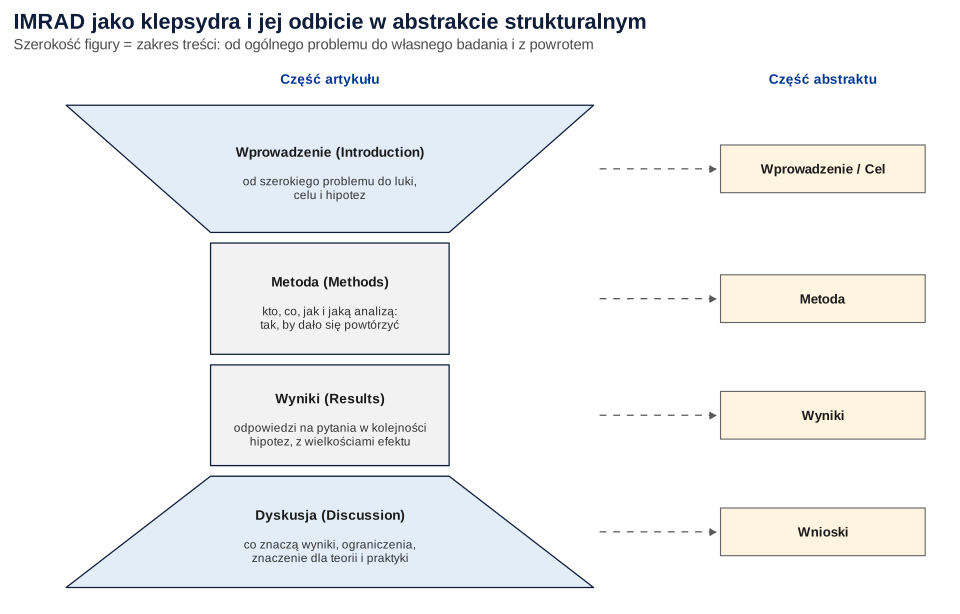
| Część | Pytanie | Co musi się znaleźć | Częsty błąd |
|---|---|---|---|
| Wprowadzenie | Dlaczego to badanie? | Problem i jego znaczenie, luka w wiedzy, cel, hipotezy lub pytania | Przegląd literatury bez wskazania luki; wyniki własnego badania już we wstępie |
| Metoda | Co zrobiono i jak? | Schemat, uczestnicy i rekrutacja, narzędzia, procedura, plan analizy, etyka | Brak informacji pozwalających powtórzyć badanie; analiza opisana dopiero w wynikach |
| Wyniki | Co wyszło? | Przepływ uczestników, statystyki opisowe, wyniki w kolejności hipotez, wielkości efektu z przedziałami ufności | Interpretacja i porównania z literaturą zamiast wyników |
| Dyskusja | Co to znaczy? | Główne odpowiedzi, porównanie z wcześniejszymi badaniami, ograniczenia, implikacje | Powtórzenie wyników liczbowych; wnioski wykraczające poza schemat badania |
Według ICMJE wprowadzenie nie powinno zawierać danych ani wniosków z opisywanej pracy, a metoda powinna być na tyle szczegółowa, by inni, mając dostęp do danych, mogli odtworzyć wyniki (International Committee of Medical Journal Editors, 2026). Szczegóły raportowania metody i wyników według standardów APA omawiamy w tekście wytyczne APA i JARS-Quant, gotowe zdania do sekcji wyników – w poradniku jak opisać wyniki w stylu APA, a budowę dyskusji – we wpisie jak napisać dyskusję wyników. Tabele i rysunki, które abstrakt streszcza, opisujemy w poradniku tabele i rysunki do artykułu naukowego.
Abstrakt strukturalny: nagłówki i wymagania
Abstrakt strukturalny ma śródtytuły, zwykle zbliżone do IMRAD: tło lub wprowadzenie, cel, metoda, wyniki, wnioski. Czasem dochodzą osobne nagłówki, takie jak „Uczestnicy”, „Ograniczenia” czy „Rejestracja”. Abstrakty strukturalne wprowadzono w czasopismach medycznych w połowie lat 80.; dziś spotyka się je także w naukach społecznych. W porównaniu z tradycyjnymi są dłuższe, zawierają więcej informacji, są łatwiejsze w czytaniu i wyszukiwaniu i dobrze przyjmują je zarówno czytelnicy, jak i autorzy (Hartley, 2014). Hartley zastrzega jednak, że część wcześniejszych badań miała ograniczenia, na przykład abstrakty przepisywane przez samych badaczy.
ICMJE wymaga abstraktów strukturalnych dla prac oryginalnych, przeglądów systematycznych i metaanaliz. Abstrakt ma podać kontekst, cel, podstawowe procedury (dobór uczestników, miejsce, pomiary, metody analizy), główne wyniki – jeśli to możliwe, z konkretnymi wielkościami efektu oraz ich istotnością statystyczną i kliniczną – oraz najważniejsze wnioski, a także zaznaczyć ważne ograniczenia i nie nadinterpretować wyników. Format różni się między czasopismami, a niektóre mają kilka formatów, dlatego abstrakt przygotowuje się według instrukcji wybranego czasopisma (International Committee of Medical Journal Editors, 2026). W psychologii i naukach pokrewnych zasady formatowania abstraktu i słów kluczowych opisuje podręcznik APA (American Psychological Association, 2020); konkretny limit słów i zestaw nagłówków zawsze bierz z instrukcji dla autorów (o wyborze czasopisma piszemy w poradniku jak wybrać czasopismo).
| Zestaw nagłówków | Kiedy się go spotyka | Uwagi |
|---|---|---|
| Wprowadzenie – Metoda – Wyniki – Wnioski | Najprostszy wariant, wiele czasopism z nauk społecznych i medycznych | Cel wpisz w ostatnim zdaniu wprowadzenia |
| Tło – Cel – Metoda – Wyniki – Wnioski | Gdy czasopismo chce osobno wyodrębnionego celu | Tło: jedno–dwa zdania, bez przeglądu literatury |
| Cel – Schemat – Uczestnicy – Interwencje – Pomiar – Wyniki – Wnioski – Rejestracja | Badania kliniczne, zwłaszcza RCT | Nawiązuje do pozycji CONSORT dla abstraktów |
| Cel – Źródła danych – Kryteria – Metody syntezy – Wyniki – Ograniczenia – Wnioski – Rejestracja | Przeglądy systematyczne i metaanalizy | Nawiązuje do listy PRISMA dla streszczeń |
| Bez nagłówków (jeden akapit) | Część czasopism psychologicznych i humanistycznych | Zachowaj tę samą kolejność treści, tylko bez śródtytułów |
Nawet gdy czasopismo wymaga abstraktu bez nagłówków, pisz go najpierw jako strukturalny. Łatwiej sprawdzić, czy nic nie brakuje, a nagłówki usuniesz na końcu.
Jak napisać abstrakt w pięciu krokach
- Pisz abstrakt na końcu, ale ze schematem od początku. Plan abstraktu (pytanie, schemat, próba, wynik pierwszorzędowy, wniosek) zapisz już przy planowaniu analizy. Jeśli badanie było prerejestrowane, abstrakt musi raportować ten sam wynik pierwszorzędowy.
- Odpowiedz jednym zdaniem na każde pytanie IMRAD. Dlaczego? Co zrobiono? Co wyszło? Co to znaczy? To szkielet, który potem rozbudujesz.
- Wstaw liczby z ostatecznych tabel. Kopiuj je z wydruku albo tabeli, a nie z pamięci i nie z wcześniejszej wersji tekstu. Każda liczba w abstrakcie musi występować w tekście głównym.
- Wybierz wyniki według hipotez, nie według istotności. Abstrakt podaje wynik pierwszorzędowy niezależnie od tego, czy jest istotny. Wyniki drugorzędowe dodaj tylko wtedy, gdy zmieszczą się bez wypychania informacji o metodzie.
- Skróć i sprawdź zgodność. Usuń ogólniki („Wyniki zostały omówione”), skróty niewyjaśnione w abstrakcie i odwołania do literatury. Na koniec porównaj każdą liczbę z tabelami (procedurę pokazujemy niżej).
Wzór 1: badanie przekrojowe
Przykład dotyczy fikcyjnego badania 284 doktorantów, w którym sprawdzano, czy obciążenie obowiązkami i wsparcie promotora wiążą się z wypaleniem. Liczby pochodzą z regresji liniowej wielorakiej policzonej w R na danych symulowanych (kod na końcu wpisu; sposób raportowania regresji opisujemy w poradniku regresja wieloraka krok po kroku). Lista STROBE dla badań obserwacyjnych obejmuje także tytuł i streszczenie (von Elm i in., 2007), więc już w abstrakcie nazwij schemat badania.
Cel: Celem badania było oszacowanie, w jakim stopniu obciążenie obowiązkami i postrzegane wsparcie promotora wiążą się z nasileniem wypalenia u doktorantów.
Metoda: W przekrojowym badaniu online wzięło udział 284 doktorantów z [liczba] szkół doktorskich. Obciążenie obowiązkami i wsparcie promotora mierzono skalami 1–7, a wypalenie skalą 1–5. Związki oszacowano w regresji liniowej wielorakiej.
Wyniki: Większe obciążenie wiązało się z silniejszym wypaleniem, b = 0.35, 95% CI [0.29, 0.41], β = 0.52, a większe wsparcie promotora – ze słabszym, b = −0.17, 95% CI [−0.23, −0.11], β = −0.28. Model wyjaśniał 38.8% wariancji wypalenia, F(2, 281) = 89.09, p < .001.
Wnioski: Obciążenie obowiązkami i wsparcie promotora są istotnymi korelatami wypalenia doktorantów. Schemat przekrojowy nie pozwala ustalić kierunku zależności; potrzebne są badania podłużne.
Słowa kluczowe: wypalenie akademickie; doktoranci; wsparcie promotora; obciążenie obowiązkami; badanie przekrojowe
Na co zwrócić uwagę:
- Wnioski mówią o korelatach, nie o przyczynach. W schemacie przekrojowym słowa „wpływa”, „powoduje”, „prowadzi do” są nieuprawnione, nawet jeśli model regresji ma „predyktory”.
- Wynik ma kierunek, wielkość i niepewność. Współczynnik b w jednostkach skali, β do porównań między predyktorami, przedział ufności i odsetek wyjaśnionej wariancji (tu R² = .39) mówią więcej niż samo „istotny związek”.
- Miejsca do uzupełnienia (w nawiasach kwadratowych) to informacje, które czytelnik musi znać, by ocenić uogólnialność: skąd pochodziła próba i jak ją rekrutowano.
Wzór 2: badanie randomizowane (RCT)
Abstrakty badań z randomizacją mają własne rozszerzenie wytycznych CONSORT. CONSORT dla abstraktów zaleca format strukturalny i minimalny zestaw informacji: cel, schemat (m.in. sposób przydziału i zaślepienie), uczestników z liczbą osób randomizowanych i analizowanych, interwencje w każdej grupie i ich wpływ na pierwszorzędowe wyniki skuteczności oraz szkody, wnioski, nazwę i numer rejestru oraz źródło finansowania. Uzasadnienie jest proste: czytelnicy często oceniają badanie wyłącznie na podstawie abstraktu (Hopewell i in., 2008). Pełne wytyczne dla artykułu to CONSORT 2010 i jego aktualizacje, które omawiamy w poradniku statystyka w publikacji medycznej.
Przykład: 128 doktorantów przydzielono losowo do 8-tygodniowego programu uważności online albo na listę oczekujących (grupę kontrolną). Wynik pierwszorzędowy to stres w skali PSS-10 po 8 tygodniach, analizowany ANCOVA z wynikiem wyjściowym jako kowariantem (dlaczego ta analiza jest zwykle lepsza od porównania różnic, wyjaśniamy w poradniku ANCOVA w badaniu przed i po). Dane są symulowane.
Metoda: Randomizowane badanie kontrolowane w grupach równoległych (przydział 1:1, [sposób randomizacji i ukrycia przydziału]). Doktorantów z [ośrodki] przydzielono losowo do programu (n = 64) albo na listę oczekujących (n = 64). Uczestnicy znali swój przydział. Pierwszorzędowym punktem końcowym był wynik PSS-10 (0–40) po 8 tygodniach; analiza: ANCOVA z wynikiem wyjściowym jako kowariantem.
Wyniki: Losowo przydzielono 128 osób; pomiar po 8 tygodniach uzyskano od 118 (po 59 w każdej grupie). Po uwzględnieniu wyniku wyjściowego stres w grupie programu był niższy niż na liście oczekujących: skorygowana różnica = −2.36 punktu PSS-10, 95% CI [−3.86, −0.87], t(115) = −3.14, p = .002, d = −0.39, 95% CI [−0.63, −0.14]. [Zdarzenia niepożądane: opis albo informacja, że ich nie monitorowano.]
Wnioski: Program uważności online przyniósł niewielkie do umiarkowanego obniżenie stresu w porównaniu z brakiem interwencji. Ze względu na samoopis i brak zaślepienia uczestników potrzebne jest badanie z aktywną grupą kontrolną.
Rejestracja i finansowanie: [Nazwa rejestru i numer badania]. Finansowanie: [źródło albo brak].
Słowa kluczowe: uważność; interwencja online; stres; doktoranci; badanie randomizowane
- Podaj, ilu osób dotyczy analiza. 128 randomizowanych to nie 118 analizowanych. Jeśli analizujesz dostępne dane, napisz to; jeśli stosujesz imputację i analizę ITT, też to zaznacz – ta różnica zmienia interpretację.
- Różnica między grupami, a nie zmiana w jednej grupie. „Stres w grupie programu spadł istotnie” nie odpowiada na pytanie badania; odpowiada na nie skorygowana różnica między grupami z przedziałem ufności.
- Rejestracja i szkody to obowiązkowe pozycje, a nie dodatki. ICMJE zaleca publikowanie numeru rejestracji badania klinicznego na końcu abstraktu (International Committee of Medical Journal Editors, 2026).
Wzór 3: przegląd systematyczny i metaanaliza
Dla przeglądów systematycznych przygotowano osobne wytyczne raportowania abstraktów – PRISMA for Abstracts (Beller i in., 2013). PRISMA 2020 zawiera listę kontrolną dla streszczenia obok głównej listy 27 pozycji i diagramów przepływu (Page i in., 2021). Wzór ma same miejsca do uzupełnienia: liczby z przeglądu muszą pochodzić z Twojej syntezy. Procedurę przeglądu opisujemy w haśle przegląd systematyczny i PRISMA, a obliczenia – w poradniku metaanaliza krok po kroku.
Metoda: Przeszukano [bazy] od [data] do [data]. Włączano badania [kryteria włączenia: populacja, interwencja lub ekspozycja, porównanie, wynik, schemat]. Ryzyko błędu oceniano narzędziem [nazwa]. Wyniki łączono w metaanalizie z efektami losowymi [miara efektu].
Wyniki: Włączono [k] badań ([N] uczestników). Łączny efekt wyniósł [miara] = [wartość], 95% CI [dolna, górna], heterogeniczność [I² lub τ²]. [Ile badań miało wysokie ryzyko błędu.]
Wnioski: [Interpretacja z uwzględnieniem jakości dowodów i ograniczeń]. [Implikacje dla praktyki lub badań].
Rejestracja i finansowanie: PROSPERO [numer] albo [inny rejestr]. Finansowanie: [źródło].
Słowa kluczowe: [3–6 fraz, w tym schemat: przegląd systematyczny; metaanaliza]
W abstrakcie przeglądu najczęściej brakuje dat wyszukiwania, liczby włączonych badań i uczestników oraz oceny ryzyka błędu. Bez nich czytelnik nie odróżni przeglądu systematycznego od narracyjnego. Jeśli wykonano metaanalizę, podaj łączny efekt z przedziałem ufności i miarę heterogeniczności, a nie samą liczbę badań „wskazujących na efekt”.
Gdzie idą słowa: proporcje części abstraktu
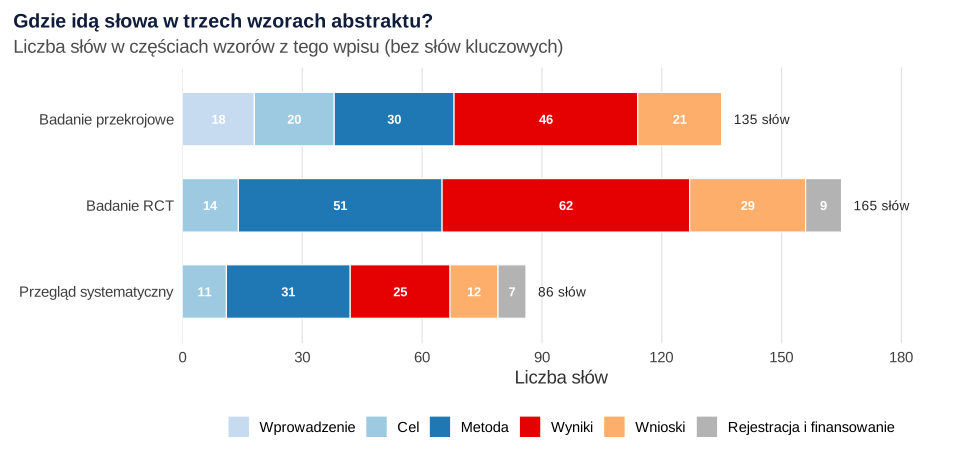
Limit słów wymusza wybór. Policzyliśmy w R, ile słów ma każda część trzech wzorów z tego wpisu. Abstrakt badania przekrojowego ma 135 słów, abstrakt RCT – 165, a wzór przeglądu – 86 (bez treści, którą wpiszesz w nawiasy). Metoda i wyniki zajmują 56.3% słów w abstrakcie badania przekrojowego, 68.5% w abstrakcie RCT i 65.1% we wzorze przeglądu.
Jeśli abstrakt przekracza limit, tnij w tej kolejności:
- tło ogólne („Stres jest ważnym problemem współczesnego społeczeństwa…”) – zostaw tylko lukę, którą wypełnia badanie;
- powtórzenia między celem a wnioskami;
- statystyki pomocnicze (np. wartość statystyki testowej, jeśli czasopismo dopuszcza sam efekt z CI i p);
- wyniki drugorzędowe i eksploracyjne.
Nie tnij informacji o schemacie, liczebności, wyniku pierwszorzędowym i ograniczeniu, które zmienia interpretację. To one pozwalają czytelnikowi ocenić, czy w ogóle warto otworzyć artykuł.
Słowa kluczowe: jak je dobrać
Słowa kluczowe pomagają bazom i wyszukiwarkom przypisać artykuł do tematu. Liczbę i format (frazy oddzielone średnikami, przecinkami, z wielkiej litery czy nie) określa czasopismo; niektóre każą wybierać z kontrolowanego słownika. Kilka zasad działa niezależnie od tych wymagań:
| Zasada | Słabo | Lepiej |
|---|---|---|
| Nie powtarzaj samego tytułu | „wypalenie doktorantów a wsparcie promotora” | „wypalenie akademickie”; „relacja promotor–doktorant” |
| Dodaj synonimy i angielskie odpowiedniki używane w literaturze | tylko „wypalenie” | „academic burnout”; „doctoral students” |
| Nazwij populację i schemat | „badanie” | „doktoranci”; „badanie przekrojowe” |
| Unikaj słów zbyt ogólnych | „psychologia”; „statystyka” | „obciążenie pracą”; „regresja wieloraka” (jeśli metoda jest istotą artykułu) |
| Używaj fraz, którymi ludzie szukają | autorski skrót wprowadzony w artykule | pełna nazwa konstruktu lub narzędzia |
Prosty test: wpisz każde słowo kluczowe w bazę, w której szukasz literatury. Jeśli wyniki nie przypominają Twojego artykułu, zmień frazę.
Zgodność abstraktu z wynikami: jak ją sprawdzić
Rozbieżności między abstraktem a tekstem głównym są częste. W przeglądzie zakresu 17 badań porównujących abstrakty z pełnymi raportami mediana niezgodności wyniosła 39% (zakres 4–78%), a niezgodności poważnych – 19%. Dotyczyły m.in. schematu badania, liczebności, wyniku pierwszorzędowego, głównych wyników i wniosków (Li i in., 2017). Część z nich to zwykłe pomyłki: liczba z wcześniejszej wersji analizy, przestawione współczynniki, zaokrąglenie w innym miejscu. ICMJE zaleca, by autorzy i redaktorzy w trakcie poprawek i recenzji pilnowali spójności informacji w obu miejscach (International Committee of Medical Journal Editors, 2026).
Pomyłki liczbowe można wyłapać automatycznie. W kodzie na końcu wpisu funkcja sprawdz() wyciąga liczby z abstraktu i sprawdza, czy występują wśród wyników wyliczonych wprost z obiektów modelu, a funkcja oszacowanie_w_ci() sprawdza, czy oszacowanie punktowe leży wewnątrz podanego przedziału ufności. Testowa wersja robocza abstraktu badania przekrojowego zawierała trzy błędy:
| Fragment wersji roboczej | Wartość poprawna | Która kontrola wykryła błąd |
|---|---|---|
| „wzięło udział 248 doktorantów” | 284 | Liczba nie występuje w wynikach |
| „b = 0.52, 95% CI [0.29, 0.41]” | b = 0.35 (0.52 to β) | Oszacowanie poza przedziałem ufności |
| „wyjaśniał 38.4% wariancji” | 38.8% (38.4% to skorygowane R²) | Liczba nie występuje w wynikach (w tej postaci) |
Drugi błąd jest pouczający: liczba 0.52 występuje w wynikach – jako β – więc pierwsza kontrola jej nie wychwyciła. Dopiero sprawdzenie, czy oszacowanie mieści się w przedziale, ujawniło pomyłkę. Automat pomaga, ale nie zastępuje czytania abstraktu obok tabeli wyników, liczba po liczbie, ze sprawdzeniem znaku i jednostek. Ostateczne wersje obu przykładowych abstraktów (polskie i angielskie) przeszły obie kontrole.
Lista kontrolna zgodności:
- Każda liczba w abstrakcie występuje w tekście, tabeli lub rysunku z tą samą wartością i tym samym zaokrągleniem.
- Oszacowanie punktowe leży w przedziale ufności, a znak efektu zgadza się z opisem słownym („niższy”, „słabszy”).
- Liczebności (włączeni, randomizowani, analizowani) zgadzają się z diagramem przepływu i tabelą charakterystyki próby.
- Wynik pierwszorzędowy jest ten sam co w protokole, rejestracji lub prerejestracji.
- Po każdej zmianie analizy (np. po recenzji) abstrakt aktualizujesz razem z tabelami – to częsty moment powstawania rozbieżności.
Spin w abstrakcie: przykłady źle i dobrze
Boutron i Ravaud (2018) opisują spin jako zamierzone lub niezamierzone raportowanie, które nie oddaje wiernie charakteru i zakresu wyników i może zmienić wrażenie, jakie wyniki robią na czytelniku – od „upiększania” opisu metod po nadinterpretację wyników. Abstrakt jest na to szczególnie podatny, bo jest krótki i ma zachęcić do lektury. Najczęstsze formy i ich poprawne wersje:
| Źle | Dlaczego | Dobrze |
|---|---|---|
| „Wsparcie promotora chroni przed wypaleniem.” | Język przyczynowy w badaniu przekrojowym | „Większe wsparcie promotora wiązało się ze słabszym wypaleniem.” |
| „Program wykazał tendencję do obniżania stresu (p > .05).” | „Tendencja” maskuje brak rozstrzygnięcia | „Różnica wyniosła [wartość] punktu, 95% CI [dolna, górna]; przedział obejmuje zero, więc wynik nie rozstrzyga, czy program działa.” |
| Wnioski oparte na wyniku drugorzędowym, gdy pierwszorzędowy był nieistotny | Odwraca uwagę od odpowiedzi na główne pytanie | Najpierw wynik pierwszorzędowy, potem drugorzędowe jako eksploracyjne |
| „Istotne obniżenie stresu w grupie programu.” | Zmiana w jednej grupie zamiast porównania grup | Skorygowana różnica między grupami z CI |
| „Wyniki mają ważne implikacje dla polityki uczelni.” | Ogólnik wykraczający poza dane | Konkretna implikacja z zastrzeżeniem schematu i próby |
Spin to często skutek uboczny wcześniejszych decyzji analitycznych: wybierania wyników „do pokazania” (p-hacking) albo dopasowywania hipotez do wyników (HARKing). Interpretację wartości p i wielkości efektu omawiamy w osobnych tekstach; recenzenci zwracają na te sformułowania uwagę – lista typowych zarzutów jest w poradniku zarzuty recenzentów do statystyki.
Najczęstsze błędy w abstraktach
- Abstrakt jako zapowiedź („Omówiono związki między…”, „Przedstawiono wyniki…”) zamiast streszczenia wyników.
- Brak liczb albo same wartości p bez kierunku i wielkości efektu.
- Brak schematu badania i liczebności w części „Metoda”.
- Liczby niezgodne z tekstem po zmianach w analizie.
- Wnioski silniejsze niż w dyskusji albo inne niż w dyskusji.
- Skróty bez rozwinięcia i odwołania do tabel lub literatury, których czytelnik abstraktu nie widzi.
- Format niezgodny z czasopismem: inne nagłówki, przekroczony limit, brak rejestracji lub finansowania tam, gdzie są wymagane.
- Angielska wersja tłumaczona słowo w słowo z polskiej, z innymi liczbami po poprawkach jednej z wersji. Gdy czasopismo publikuje abstrakt w dwóch językach, sprawdź zgodność obu.
Jeśli chcesz, żeby ktoś z zewnątrz sprawdził zgodność liczb w abstrakcie, tabelach i tekście przed wysłaniem albo po recenzji, w ramach wsparcia dla badaczy weryfikujemy analizy i ich opis. Treść artykułu i odpowiedzialność za nią pozostają przy autorach.
Wzory do pobrania
Wszystkie trzy wzory w wersji polskiej i angielskiej oraz listę kontrolną zgodności zebraliśmy w pliku wzory-abstraktow-strukturalnych.docx. Nagłówki, kolejność części i limit słów dopasuj do instrukcji czasopisma, a liczby z przykładów zastąp własnymi – pochodzą z danych symulowanych i służą wyłącznie ilustracji.
Liczby do abstraktów i kontrola zgodności w R
Kod odtwarza wszystkie liczby z wzorów abstraktów i z tabeli błędów. Przepis 1 liczy oba badania przykładowe, przepis 2 sprawdza zgodność abstraktu z wynikami. Uruchom je w jednej sesji: przepis 2 korzysta z obiektów z przepisu 1 i z treści abstraktów zapisanych w pliku b78-2-teksty-abstraktow.R (ten sam plik liczy słowa do rysunku 2 i zasila plik DOCX).
1. Badanie przekrojowe (regresja) i RCT (ANCOVA)
R
# B78 – liczby do wzorów abstraktów: dwa badania przykładowe (dane symulowane)
# we wpisie /blog/abstrakt-strukturalny-i-imrad/
# Badanie 1: przekrojowe – obciążenie obowiązkami, wsparcie promotora a wypalenie u doktorantów.
# Badanie 2: RCT – 8-tygodniowy program uważności online a stres (PSS-10, 0–40) wobec listy oczekujących.
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R
library(effectsize)
suppressPackageStartupMessages(library(emmeans))

# ---------------- Badanie 1: przekrojowe ----------------
set.seed(7801)
n1 <- 284
obciazenie <- round(pmin(7, pmax(1, rnorm(n1, 4.6, 1.1))), 2)      # 1–7
wsparcie   <- round(pmin(7, pmax(1, rnorm(n1, 4.3, 1.3))), 2)      # 1–7
wypalenie  <- round(pmin(5, pmax(1, 1.55 + 0.32 * obciazenie - 0.21 * wsparcie +
                                   rnorm(n1, 0, 0.62))), 2)         # 1–5
b1 <- data.frame(obciazenie, wsparcie, wypalenie)
round(sapply(b1, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(b1), 2)
m1 <- lm(wypalenie ~ obciazenie + wsparcie, data = b1)
s1 <- summary(m1)
wsp <- data.frame(b = round(coef(s1)[, 1], 2), SE = round(coef(s1)[, 2], 3), t = round(coef(s1)[, 3], 2),
                  p = format.pval(coef(s1)[, 4], digits = 3, eps = .001), round(confint(m1), 2), check.names = FALSE)
wsp
beta <- standardize_parameters(m1)
data.frame(Parametr = beta$Parameter, beta = round(beta$Std_Coefficient, 2),
           CI_dolna = round(beta$CI_low, 2), CI_gorna = round(beta$CI_high, 2))
data.frame(R2 = round(s1$r.squared, 3), R2_skor = round(s1$adj.r.squared, 3),
           F = round(s1$fstatistic[[1]], 2), df1 = s1$fstatistic[[2]], df2 = s1$fstatistic[[3]],
           p = format.pval(pf(s1$fstatistic[[1]], s1$fstatistic[[2]], s1$fstatistic[[3]], lower.tail = FALSE), eps = .001))

# ---------------- Badanie 2: RCT ----------------
set.seed(7802)
n2 <- 128
grupa <- factor(rep(c("program", "lista"), each = n2 / 2), levels = c("lista", "program"))
pss_przed <- round(pmin(40, pmax(0, rnorm(n2, 21.5, 5.6))))
pss_po <- round(pmin(40, pmax(0, 6 + 0.68 * pss_przed - 2.6 * (grupa == "program") + rnorm(n2, 0, 4.1))))
odpadl <- runif(n2) < ifelse(grupa == "program", .12, .08)         # brak pomiaru po 8 tygodniach
pss_po[odpadl] <- NA
b2 <- data.frame(grupa, pss_przed, pss_po)
table(b2$grupa, ukonczyl = !is.na(b2$pss_po))
aggregate(pss_przed ~ grupa, data = b2, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
aggregate(pss_po ~ grupa, data = b2, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
m2 <- lm(pss_po ~ pss_przed + grupa, data = b2)
round(coef(summary(m2)), 4)
round(confint(m2), 2)
emm <- emmeans(m2, ~ grupa)
as.data.frame(emm) |> transform(emmean = round(emmean, 2), SE = round(SE, 2), lower.CL = round(lower.CL, 2), upper.CL = round(upper.CL, 2))
kontr <- confint(contrast(emm, "revpairwise"))
transform(as.data.frame(kontr), estimate = round(estimate, 2), SE = round(SE, 3), lower.CL = round(lower.CL, 2), upper.CL = round(upper.CL, 2))
test(contrast(emm, "revpairwise"))
# standaryzowana różnica: skorygowana różnica / SD wyniku po w całej próbie analizowanej
sd_po <- sd(b2$pss_po, na.rm = TRUE)
round(c(d = kontr$estimate / sd_po, d_dolna = kontr$lower.CL / sd_po, d_gorna = kontr$upper.CL / sd_po), 2)
c(n_analiza = sum(!is.na(b2$pss_po)), SD_po = round(sd_po, 2))
Wynik w R
   obciazenie wsparcie wypalenie
M        4.66     4.37      2.18
SD       1.13     1.24      0.75
           obciazenie wsparcie wypalenie
obciazenie       1.00    -0.13      0.56
wsparcie        -0.13     1.00     -0.35
wypalenie        0.56    -0.35      1.00
                b    SE     t      p 2.5 % 97.5 %
(Intercept)  1.31 0.207  6.30 <0.001  0.90   1.71
obciazenie   0.35 0.031 11.06 <0.001  0.29   0.41
wsparcie    -0.17 0.029 -5.97 <0.001 -0.23  -0.11
     Parametr  beta CI_dolna CI_gorna
1 (Intercept)  0.00    -0.09     0.09
2  obciazenie  0.52     0.43     0.61
3    wsparcie -0.28    -0.37    -0.19
     R2 R2_skor     F df1 df2       p
1 0.388   0.384 89.09   2 281 < 0.001
         ukonczyl
          FALSE TRUE
  lista       5   59
  program     5   59
    grupa pss_przed.M pss_przed.SD pss_przed.n
1   lista       21.45         5.87       64.00
2 program       21.06         5.76       64.00
    grupa pss_po.M pss_po.SD pss_po.n
1   lista    20.66      5.45    59.00
2 program    17.59      6.35    59.00
             Estimate Std. Error t value Pr(>|t|)
(Intercept)    4.6613     1.5035  3.1004   0.0024
pss_przed      0.7415     0.0652 11.3742   0.0000
grupaprogram  -2.3640     0.7531 -3.1388   0.0022
             2.5 % 97.5 %
(Intercept)   1.68   7.64
pss_przed     0.61   0.87
grupaprogram -3.86  -0.87
    grupa emmean   SE  df lower.CL upper.CL
1   lista  20.31 0.53 115    19.26    21.36
2 program  17.95 0.53 115    16.89    19.00
         contrast estimate    SE  df lower.CL upper.CL
1 program - lista    -2.36 0.753 115    -3.86    -0.87
 contrast        estimate    SE  df t.ratio p.value
 program - lista    -2.36 0.753 115  -3.139  0.0022

      d d_dolna d_gorna
  -0.39   -0.63   -0.14
n_analiza     SD_po
   118.00      6.09
2. Czy liczby w abstrakcie zgadzają się z wynikami?
R
# B78 – automatyczne sprawdzenie zgodności liczb w abstrakcie z wynikami analizy
# Korzysta z obiektów z b78-1-badania.R i b78-2-teksty-abstraktow.R (uruchom.R wykonuje je w jednej sesji).
f2 <- function(x) formatC(x, format = "f", digits = 2)
f3 <- function(x) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = 3))

# 1. Liczby, które wolno podać, wyliczone wprost z obiektów modelu
ci1 <- confint(m1); bs <- beta$Std_Coefficient
wyniki_1 <- c(n = nrow(b1), b_obc = f2(coef(m1)[["obciazenie"]]), ci_obc = f2(ci1["obciazenie", ]),
              beta_obc = f2(bs[2]), b_wsp = f2(coef(m1)[["wsparcie"]]), ci_wsp = f2(ci1["wsparcie", ]),
              beta_wsp = f2(bs[3]), R2_proc = formatC(100 * s1$r.squared, format = "f", digits = 1),
              F = f2(s1$fstatistic[[1]]), df = s1$fstatistic[[2]], df = s1$fstatistic[[3]], p = ".001")
t2 <- as.data.frame(test(contrast(emm, "revpairwise")))
wyniki_2 <- c(n_los = nrow(b2), n_grupa = table(b2$grupa)[[1]], n_anal = sum(!is.na(b2$pss_po)),
              n_anal_gr = sum(!is.na(b2$pss_po[b2$grupa == "lista"])), roznica = f2(abs(kontr$estimate)),
              ci = f2(c(kontr$lower.CL, kontr$upper.CL)), t = f2(t2$t.ratio), df = t2$df, p = f3(t2$p.value),
              d = f2(kontr$estimate / sd_po), d_ci = f2(c(kontr$lower.CL, kontr$upper.CL) / sd_po))
wyniki_1; wyniki_2

# 2. Funkcja: które liczby z tekstu nie występują w wynikach?
liczby_w_tekscie <- function(tekst) {
  tekst <- gsub("\\[[^]]*\\]", " ", tekst)                     # pomiń miejsca do uzupełnienia
  tekst <- gsub("95% CI|PSS-10|0–40|1–[57]|1:1|8-tygodniowy|8 tygodniach|8-week|8 weeks", " ", tekst)   # stałe elementy opisu
  x <- regmatches(tekst, gregexpr("[−-]?\\.?\\d+(\\.\\d+)?", tekst))[[1]]
  sub("^[−-]", "", x)                                            # znak sprawdzamy osobno, przy czytaniu
}
sprawdz <- function(tekst, dozwolone) {
  x <- liczby_w_tekscie(tekst)
  dozw <- sub("^-", "", as.character(dozwolone))
  data.frame(liczba = x, w_wynikach = x %in% dozw)
}

# 3. Wersja robocza abstraktu badania przekrojowego z typowymi pomyłkami
robocza <- paste("W badaniu wzięło udział 248 doktorantów. Większe obciążenie wiązało się z silniejszym wypaleniem,",
                 "b = 0.52, 95% CI [0.29, 0.41], a większe wsparcie – ze słabszym, b = −0.17, 95% CI [−0.23, −0.11].",
                 "Model wyjaśniał 38.4% wariancji, F(2, 281) = 89.09, p < .001.")
wynik_roboczej <- sprawdz(robocza, wyniki_1)
wynik_roboczej[!wynik_roboczej$w_wynikach, ]

# 3a. Druga kontrola: czy oszacowanie punktowe leży w podanym przedziale ufności?
oszacowanie_w_ci <- function(tekst) {
  tekst <- gsub("−", "-", tekst)
  m <- regmatches(tekst, gregexpr("= (-?[0-9.]+)[^,=]*, 95% CI \\[(-?[0-9.]+), (-?[0-9.]+)\\]", tekst))[[1]]
  liczby <- t(sapply(regmatches(m, regexec("= (-?[0-9.]+)[^,=]*, 95% CI \\[(-?[0-9.]+), (-?[0-9.]+)\\]", m)),
                     function(z) as.numeric(z[2:4])))
  data.frame(fragment = m, w_przedziale = liczby[, 2] <= liczby[, 1] & liczby[, 1] <= liczby[, 3])
}
oszacowanie_w_ci(robocza)

# 4. Wersje ostateczne (te same, które są na stronie i w pliku .docx)
pl1 <- paste(abstrakty_pl[["Badanie przekrojowe"]][c("Metoda", "Wyniki")], collapse = " ")
pl2 <- paste(abstrakty_pl[["Badanie RCT"]][c("Metoda", "Wyniki")], collapse = " ")
en1 <- paste(abstrakty_en[["Cross-sectional study"]][c("Methods", "Results")], collapse = " ")
en2 <- paste(abstrakty_en[["Randomised controlled trial"]][c("Methods", "Results")], collapse = " ")
c(PL_przekrojowe = all(sprawdz(pl1, wyniki_1)$w_wynikach), PL_RCT = all(sprawdz(pl2, wyniki_2)$w_wynikach),
  EN_cross = all(sprawdz(en1, wyniki_1)$w_wynikach), EN_RCT = all(sprawdz(en2, wyniki_2)$w_wynikach))
oszacowanie_w_ci(paste(pl1, pl2))
Wynik w R
            n         b_obc  ci_obc.2.5 % ci_obc.97.5 %      beta_obc         b_wsp  ci_wsp.2.5 %
        "284"        "0.35"        "0.29"        "0.41"        "0.52"       "-0.17"       "-0.23"
ci_wsp.97.5 %      beta_wsp       R2_proc             F            df            df             p
      "-0.11"       "-0.28"        "38.8"       "89.09"           "2"         "281"        ".001"
    n_los   n_grupa    n_anal n_anal_gr   roznica       ci1       ci2         t        df         p         d
    "128"      "64"     "118"      "59"    "2.36"   "-3.86"   "-0.87"   "-3.14"     "115"    ".002"   "-0.39"
    d_ci1     d_ci2
  "-0.63"   "-0.14"
  liczba w_wynikach
1    248      FALSE
4   38.4      FALSE
                        fragment w_przedziale
1    = 0.52, 95% CI [0.29, 0.41]        FALSE
2 = -0.17, 95% CI [-0.23, -0.11]         TRUE
PL_przekrojowe         PL_RCT       EN_cross         EN_RCT
          TRUE           TRUE           TRUE           TRUE
                                      fragment w_przedziale
1                  = 0.35, 95% CI [0.29, 0.41]         TRUE
2               = -0.17, 95% CI [-0.23, -0.11]         TRUE
3 = -2.36 punktu PSS-10, 95% CI [-3.86, -0.87]         TRUE
4               = -0.39, 95% CI [-0.63, -0.14]         TRUE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm() i confint() z pakietu stats); rysunki przygotowano w pakiecie ggplot2, a plik DOCX – w pakiecie officer.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
Najczęstsze pytania
Co powinien zawierać abstrakt strukturalny artykułu empirycznego?
Kontekst i cel, schemat badania, uczestników i sposób ich doboru, pomiary i metodę analizy, główne wyniki z wielkościami efektu i przedziałami ufności oraz wnioski z najważniejszym ograniczeniem. Przy badaniach klinicznych dochodzą numer rejestracji i finansowanie. Nagłówki i limit słów określa instrukcja wybranego czasopisma.
Czym różni się abstrakt RCT od abstraktu badania przekrojowego?
Abstrakt RCT według CONSORT dla abstraktów podaje sposób przydziału i zaślepienie, liczbę osób randomizowanych i analizowanych w każdej grupie, wpływ interwencji na wynik pierwszorzędowy i szkody, a także rejestr i numer badania oraz finansowanie. W badaniu przekrojowym kluczowe są schemat, próba i wnioski bez języka przyczynowego.
Czy abstrakt pisze się przed artykułem, czy po nim?
Ostateczną wersję pisz na końcu, gdy tabele wyników są zamknięte, ale plan abstraktu – pytanie, schemat, próba, wynik pierwszorzędowy – zapisz już przy planowaniu analizy. Po każdej zmianie analizy, także po recenzji, aktualizuj abstrakt razem z tabelami.
Jak sprawdzić, czy abstrakt zgadza się z wynikami?
Porównaj każdą liczbę z abstraktu z tabelą lub wydrukiem, sprawdź znak efektu, jednostki i to, czy oszacowanie leży w przedziale ufności, oraz zgodność liczebności z diagramem przepływu. Część pomyłek wyłapie skrypt w R z tego wpisu, ale nie zastąpi on czytania abstraktu obok tabel.
Ile słów kluczowych podać w artykule naukowym i jak je wybrać?
Liczbę i format określa czasopismo. Wybieraj frazy, których nie ma w tytule, dodaj synonimy i angielskie odpowiedniki używane w literaturze, nazwij populację i schemat badania, a każdą frazę sprawdź w bazie, w której sam(a) szukasz literatury.
Powiązane hasła
Przeczytaj też
Jak wybrać czasopismo i rozpoznać drapieżne
Kryteria dopasowania, kolejność zgłoszeń w symulacji, sygnały ostrzegawcze, Think. Check. Submit., DOAJ i COPE oraz wzory e-maili do redakcji.
Czytaj →PoradnikWytyczne APA i JARS-Quant
Co raportować w metodzie i wynikach: przepływ uczestników, braki danych, moc, rzetelność, efekty z CI – przykład w R i lista kontrolna do pobrania.
Czytaj →PoradnikTabele i rysunki do artykułu
Wymogi czasopism, wykresy z danymi zamiast słupków, kolory czytelne dla daltonistów, eksport z R w 300 dpi i materiały uzupełniające.
Czytaj →Chcesz mieć pewność, że abstrakt i tabele mówią to samo?
Sprawdzimy analizy i zgodność liczb w abstrakcie, tekście i tabelach przed wysłaniem lub po recenzji, tak żebyś rozumiał(a) i umiał(a) obronić każdy wynik.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Beller, E. M., Glasziou, P. P., Altman, D. G., Hopewell, S., Bastian, H., Chalmers, I., Gøtzsche, P. C., Lasserson, T., Tovey, D., & PRISMA for Abstracts Group. (2013). PRISMA for Abstracts: Reporting systematic reviews in journal and conference abstracts. PLoS Medicine, 10(4), Article e1001419. https://doi.org/10.1371/journal.pmed.1001419 ● Otwarty dostęp
- Boutron, I., & Ravaud, P. (2018). Misrepresentation and distortion of research in biomedical literature. Proceedings of the National Academy of Sciences, 115(11), 2613–2619. https://doi.org/10.1073/pnas.1710755115 ● Otwarty dostęp: pełny tekst
- Hartley, J. (2014). Current findings from research on structured abstracts: An update. Journal of the Medical Library Association, 102(3), 146–148. https://doi.org/10.3163/1536-5050.102.3.002 ● Otwarty dostęp
- Hopewell, S., Clarke, M., Moher, D., Wager, E., Middleton, P., Altman, D. G., Schulz, K. F., & CONSORT Group. (2008). CONSORT for reporting randomized controlled trials in journal and conference abstracts: Explanation and elaboration. PLoS Medicine, 5(1), Article e20. https://doi.org/10.1371/journal.pmed.0050020 ● Otwarty dostęp
- International Committee of Medical Journal Editors. (2026). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026). ICMJE. https://www.icmje.org/recommendations/ ● Otwarty dostęp: pełny tekst
- Li, G., Abbade, L. P. F., Nwosu, I., Jin, Y., Leenus, A., Maaz, M., Wang, M., Bhatt, M., Zielinski, L., Sanger, N., Bantoto, B., Luo, C., Shams, I., Shahid, H., Chang, Y., Sun, G., Mbuagbaw, L., Samaan, Z., Levine, M. A. H., . . . Thabane, L. (2017). A scoping review of comparisons between abstracts and full reports in primary biomedical research. BMC Medical Research Methodology, 17(1), Article 181. https://doi.org/10.1186/s12874-017-0459-5 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Sollaci, L. B., & Pereira, M. G. (2004). The introduction, methods, results, and discussion (IMRAD) structure: A fifty-year survey. Journal of the Medical Library Association, 92(3), 364–367. https://pmc.ncbi.nlm.nih.gov/articles/PMC442179/ ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{beller2013prisma, author={Beller, Elaine M. and Glasziou, Paul P. and Altman, Douglas G. and Hopewell, Sally and Bastian, Hilda and Chalmers, Iain and Gøtzsche, Peter C. and Lasserson, Toby and Tovey, David and {PRISMA for Abstracts Group}}, title={{PRISMA for Abstracts: Reporting systematic reviews in journal and conference abstracts}}, journal={PLoS Medicine}, year={2013}, volume={10}, number={4}, eid={e1001419}, doi={10.1371/journal.pmed.1001419}}@article{boutron2018misrepresentation, author={Boutron, Isabelle and Ravaud, Philippe}, title={{Misrepresentation and distortion of research in biomedical literature}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2613--2619}, doi={10.1073/pnas.1710755115}}@article{hartley2014current, author={Hartley, James}, title={{Current findings from research on structured abstracts: An update}}, journal={Journal of the Medical Library Association}, year={2014}, volume={102}, number={3}, pages={146--148}, doi={10.3163/1536-5050.102.3.002}}@article{hopewell2008consort, author={Hopewell, Sally and Clarke, Mike and Moher, David and Wager, Elizabeth and Middleton, Philippa and Altman, Douglas G. and Schulz, Kenneth F. and {CONSORT Group}}, title={{CONSORT for reporting randomized controlled trials in journal and conference abstracts: Explanation and elaboration}}, journal={PLoS Medicine}, year={2008}, volume={5}, number={1}, eid={e20}, doi={10.1371/journal.pmed.0050020}}@misc{icmje2026recommendations, author={{International Committee of Medical Journal Editors}}, title={{Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026)}}, howpublished={ICMJE}, year={2026}, publisher={International Committee of Medical Journal Editors}, url={https://www.icmje.org/recommendations/}}@article{li2017scoping, author={Li, Guowei and Abbade, Luciana P. F. and Nwosu, Ikunna and Jin, Yanling and Leenus, Alvin and Maaz, Muhammad and Wang, Mei and Bhatt, Meha and Zielinski, Laura and Sanger, Nitika and Bantoto, Bianca and Luo, Candice and Shams, Ieta and Shahid, Hamnah and Chang, Yaping and Sun, Guangwen and Mbuagbaw, Lawrence and Samaan, Zainab and Levine, Mitchell A. H. and Adachi, Jonathan D. and Thabane, Lehana}, title={{A scoping review of comparisons between abstracts and full reports in primary biomedical research}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={181}, doi={10.1186/s12874-017-0459-5}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{sollaci2004introduction, author={Sollaci, Luciana B. and Pereira, Mauricio G.}, title={{The introduction, methods, results, and discussion (IMRAD) structure: A fifty-year survey}}, journal={Journal of the Medical Library Association}, year={2004}, volume={92}, number={3}, pages={364--367}, url={https://pmc.ncbi.nlm.nih.gov/articles/PMC442179/}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}